Twitter AI Agent - 2026-09-12
1. 人们在讨论什么
1.1 harness engineering 成为严肃智能体工作的通用语言(🡕)
最强的一组讨论,已经不再把 AI 智能体看成“套了更好外壳的提示词”。人们开始把它视为一整套操作栈:概念、循环、权限、评测、上下文、恢复,以及人的判断。反复出现的核心动作,是让智能体行为变得可教学、可审查,并能与底层原始模型分离。
@matthewcanham 认为(93 个赞、11 条回复、6,976 次浏览、175 次收藏)表示,如今每位 PM 至少都需要具备 101 级别的工具使用、上下文工程、记忆、harness engineering、评测和沙箱基础素养。评论区让这条帖子比单纯的鼓舞更实用:有人说,最快的学习方式是亲手做一个微型工具调用,而不是死记术语。
@iiiichigo_chan 强调(69 个赞、11 条回复、8,961 次浏览、106 次收藏)分享了一门关于生产级 Claude Code harness 的免费课程,涵盖计划模式、可复用技能、子智能体、反馈循环和恢复机制。最有价值的回复把它提炼成一条操作规则:一条 CLAUDE.md 指令,只有在具备触发条件、真假检查、停止条件,以及已被遵循的证据时,才真正有意义。
@adiix_official 转向(37 个赞、11 条回复、2,444 次浏览、20 次收藏)把 Andrew Ng 的 AI engineering 框架压缩成一份两页的构建清单,内容涵盖上下文控制、测试、安全和评测;而 @DamiDefi 放大了(140 个赞、10 条回复、11,456 次浏览)则从另一个角度指出了同样的转变:代码生成越来越便宜,因此产品判断和构建循环的主导权,正变得比实现层劳动力更稀缺。即便是像 @pauliusztin_ 认为(5 个赞、3 条回复、182 次浏览)这样热度不高的帖子,也在强调:智能体循环本身并不复杂,难的是围绕它搭建的 harness。

讨论洞察: 讨论已经从“AI engineering 很重要”往前推进了一步,转向如何把它真正操作化。人们反复追问的是:什么样的规则,能经受自然语言漂移、模型变化和长时间运行工作流的考验。
与前一天对比: 2026-09-11 让 AI engineering 看起来像一门可度量的操作学科;到了 2026-09-12,它更像一套可教授的课程体系,配有课程、清单和被明确命名的 harness 组件。
1.2 技能不再像无害片段,而开始像软件制品(🡕)
第二组讨论聚焦于技能本身:如何检查它们、衡量它们是否真的会触发,以及如何防止它们在方案尚未稳定前就一路冲进实现阶段。共同前提是:技能之所以有用,恰恰因为它们会改变行为;也正因如此,它们同样有风险。
@traversymedia 推出(53 个赞、8 条回复、2,360 次浏览、44 次收藏)介绍了 SkillPass——一个开源目录,每项技能都有一本“护照”,展示其在安装前会要求智能体执行什么。配套的公开文档和仓库把信任模型讲得很清楚:固定提交、权限检测、验证结果、AI 审查,以及安装时的哈希校验。评论区把痛点说得很直白:盲装一个技能,几乎等于悄悄把你的密钥交给 shell。
@stretchcloud 报道(9 个赞、3 条回复、462 次浏览)表示,claude plugin eval 现在会让每个测试用例各跑两次——一次启用插件,一次不启用——这样维护者就能看清某项技能是否真的改变了结果。最重要的初步发现不是语法层面的,而是行为层面的:一个插件即便验证完全通过,也可能在用户用自然语言提需求、而不是照着清单里的精确关键词说话时,根本不会触发。
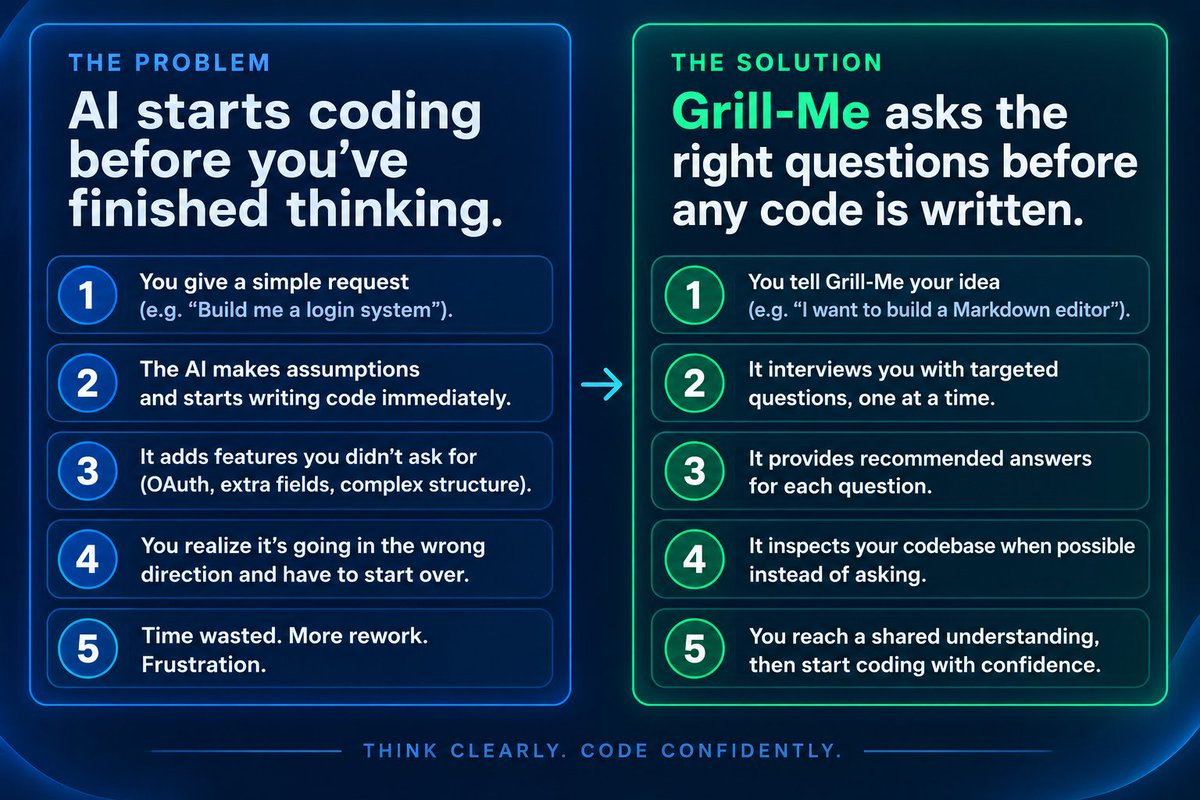
@Umesh__digital 描述(12 个赞、10 条回复、423 次浏览)把 Matt Pocock 的 Grill-Me 技能视为对另一类失败模式的直接回应:编码智能体会在人还没想清楚之前就开工。它的核心启发式很简洁——决策问人,事实问代码库——这也与更广泛的转向一致:从一次性提示,转向显式地解决设计决策。
讨论洞察: 人们并没有默认技能天然有用,而是把它们当作不可信的软件制品来对待,需要权限可见性、触发测试,以及更清晰的决策边界。
与前一天对比: 2026-09-11 强调的是可审查的记忆与策略门控;而今天,这种同样的本能已经外溢到了技能生态本身。
1.3 智能体商业的话题,从目录转向信任轨道与买方稀缺(🡕)
相比昨天,市场讨论更具体了,但真正有分量的内容来自交易设计,而不是泛泛而谈“智能体的未来”。最强的几条帖子都在围绕同一组问题打转:什么东西会被定价、如何验证任务完成,以及买方侧到底有没有足够多的真实工作。
@Abba__80 认为(152 个赞、176 条回复、976 次浏览)指出,TermiX 最值得关注的指标,不是标题里的 1,968 万美元已结算金额,而是 370,319 笔任务对应的大约 53 美元平均单笔任务金额。配图中的仪表板还显示了 431,692 个智能体和 393,618 美元的协议收入,这让它的核心论点变得清晰可见:智能体商业可能会通过大量机器对机器的小额交易涌现出来,而不是依赖少数几个超大合同。
@dee_e6 将其定义为(58 个赞、63 条回复、321 次浏览)把 AACP 和 agent.family 描述为连接身份、竞价、托管、交付验证、争议处理和可复用工作记录的一层基础设施。配图通过公开信誉分、已完成任务数和端到端任务流程,把这一点讲得更具体。@dezydank 提供(73 个赞、58 条回复、734 次浏览)给出了它的宣传版本——资金会一直锁定,直到工作经过独立验证——但评论马上追问到真正的边界:谁来做这个验证,又依据什么规则做验证?
@Arifx0001 披露(81 个赞、84 条回复、10,486 次浏览)和 @ZeoWeb3 提供(77 个赞、75 条回复)给出了这组讨论中最尖锐的需求侧数据:一个实时市场页面上,大约有 584 个卖家或服务,对应 224 个买家或请求;其中一张截图里,活跃悬赏数还是 0。@icefrog_sol 提炼(14 个赞、15 条回复、93 次浏览)则把买方侧的需求归结为一条简单规则:预算、截止时间和通过/失败测试,应该在工作开始前就定义清楚。


讨论洞察: 即便是支持者,也在不断把讨论拉回验收测试、追索机制和需求生成。真正有意思的瓶颈,不是再上架一个智能体,而是把经过验证的工作带进市场。
与前一天对比: 2026-09-11 的结论是,市场机制变得更具体了,但需求端的证据仍然很薄。到了 2026-09-12,买方稀缺和验证问题已经从旁支细节变成了主要观察视角。
1.4 运行时选择迅速扩张:本地小模型、托管会话、可复用浏览器技能,以及云端/本地交接(🡕)
第四组讨论显示,技术栈正在同时向多个方向展开。人们不再围绕某一种主导性的运行时模式比较,而是把本地小模型、托管式智能体基础设施、浏览器技能工厂、云到本地的工作区,以及语音智能体基础能力放在一起对照。
@aibytekat 认为(56 个赞、20 条回复、4,031 次浏览)认为,MiniCPM5-2B 让普通硬件上的本地智能体工作流具备了现实可行性。OpenBMB 的发布材料也直接支持这一定位:该模型被明确面向本地助手、编码智能体、工具使用和其他资源受限的智能体任务。评论进一步把边界问得更清楚:最低硬件门槛是什么?量化之后,结构化工具调用的可靠性还能不能保住?
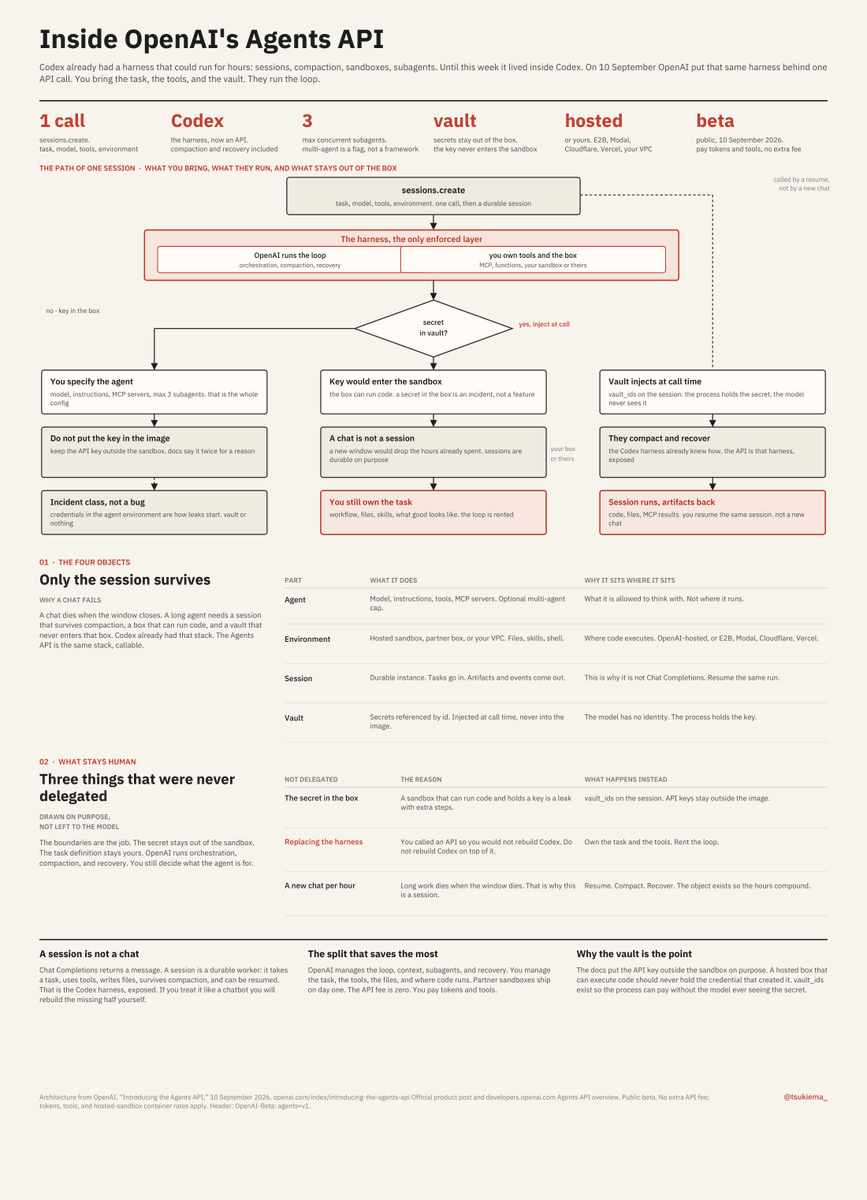
@beamnxw 解释(25 个赞、18 条回复、520 次浏览、11 次收藏)把新的 OpenAI Agents API 概括为三件套:持久会话、执行盒子,以及让密钥留在盒子外面的保险库。官方文档确认了同样的模式:OpenAI 可以管理编排、上下文压缩、恢复和可选子智能体,而运行环境可以由 OpenAI 托管、自托管,或者完全没有环境。评论区把焦点放在按调用时机注入凭据上,认为这才是真正的安全改进。
@DivyanshT91162 披露(6 个赞、1 条回复、284 次浏览)把 Microsoft 的 Webwright 视为一种浏览器智能体路径:已解决的任务会沉淀为可复用、可验证的代码技能,而不是一次性的浏览轨迹。@euboid 称赞(25 个赞、10 条回复、2,088 次浏览、22 次收藏)讨论了 Conductor 的多智能体云工作区、本地同步和交接质量,但评论也指出了仍未消失的粗糙边角:仅限 Mac,且 iOS 仍然只在 TestFlight 阶段。语音这边,@minchoi 展示(60 个赞、10 条回复、10,064 次浏览、31 次收藏)提到全双工 GPT-Live-1 之所以显得重要,是因为改进已经具体到可以按每分钟 0.05 美元来定价。
讨论洞察: 工具之间的比较,越来越围绕持久性、可复用性和边界管理展开——状态存在哪里、工作如何跨睡眠继续、密钥如何留在沙箱之外,以及输出如何变成可复用制品。
与前一天对比: 2026-09-11 主要仍围绕 hooks、轨迹和记忆纪律;而今天,讨论明显扩展到了运行时选择和部署形态。
2. 人们在抱怨什么
技能仍然太容易被盲目信任,也太难被评估
严重程度:高。关于技能的讨论里,很多人都在发现:一个技能可能既危险,又不可见,甚至两者兼具。@traversymedia 将其定义为(53 个赞、8 条回复、2,360 次浏览、44 次收藏)把问题概括为盲目信任:用户经常在看不到技能到底会让智能体做什么的情况下,就把它装上了。@stretchcloud 报道(9 个赞、3 条回复、462 次浏览)则指出了相邻的挫败感:即便一个插件格式规范,也可能因为无法在自然语言下触发而完全不起作用,而普通验证根本抓不住这个缺口。
现有的应对模式很说明问题。SkillPass 在安装前加上一层权限与护照检查,而 Grill-Me 则要求智能体在写代码前先提澄清问题。这意味着,眼下的应对策略并不是让模型更聪明,而是加强起飞前检查和结构化规划。
值得投入建设吗? 是。这个痛点具体、反复出现,而且就在工作流边缘。一个同时提供权限可见性、触发测试和规格澄清的产品,显然会击中真实需求。
智能体市场仍缺少买方侧证据,也缺少足够多的付费工作
严重程度:高,不过由于许多帖子带有宣传性质,判断置信度仍应保持中等。@ZeoWeb3 发布(77 个赞、75 条回复)给出了这组里最尖锐的不平衡:大约有 584 项服务上架,但只有 224 个待处理请求,而且活跃悬赏数是 0。@dee_e6 补充道(58 个赞、63 条回复、321 次浏览)则给出了更深一层的诊断:演示不如工作记录有说服力,但工作记录若想可信,又必须配套验证、结算和争议处理。
@dezydank 将其定义为(73 个赞、58 条回复、734 次浏览)和 @icefrog_sol 展示(14 个赞、15 条回复、93 次浏览)从相反方向指向了同一道边界。托管听起来让人安心,直到买家追问到底由谁验证完成情况;买方需求听起来似乎容易,直到有人必须把预算、截止时间和通过/失败标准定义得足够精确,精确到能支撑机器对机器交易。
值得投入建设吗? 是,但前提是产品必须同时解决“证据”和“需求”这两个问题。单纯增加更多上架列表,看起来并不是瓶颈所在。
运行时层仍在边界处不断泄露摩擦
严重程度:中。运行时相关讨论清楚表明,有用的智能体工作依然会在接缝处出问题:密钥存放在哪里、云端工作如何交还给本地工具、工作区能活多久,以及什么级别的硬件才能把本地模型跑到值得折腾的程度。@beamnxw 提出(25 个赞、18 条回复、520 次浏览、11 次收藏)把安全版本的问题说得很直白:一个能执行代码的沙箱,不应该同时永久持有凭据。@euboid 称赞(25 个赞、10 条回复、2,088 次浏览、22 次收藏)讨论了 Conductor 的交接能力,但评论和文档仍暴露出仅限 Mac、单向同步,以及工作区生命周期边界等限制。
小模型和语音智能体的话题则以不同形式呈现了同一主题。@aibytekat 认为(56 个赞、20 条回复、4,031 次浏览)支持本地部署,但马上就有人追问:一个 2B 模型在普通设备上,到底还能不能保持足够可靠;而对 @minchoi 展示(60 个赞、10 条回复、10,064 次浏览、31 次收藏)的回复则指出,更顺滑的语音轮替只有在下游任务完成仍然可信时才有意义。
值得投入建设吗? 是。这些不是抽象抱怨,而是决定人们究竟能持续保留哪些智能体工作流的部署约束。
3. 人们希望哪些东西存在
经过验证的技能分发,同时能够测量真实触发行为
技能相关讨论指向了原始安装层之上的一层缺口。@traversymedia 认为(53 个赞、8 条回复、2,360 次浏览、44 次收藏)、@stretchcloud 报道(9 个赞、3 条回复、462 次浏览)和 @Umesh__digital 描述(12 个赞、10 条回复、423 次浏览)合在一起说明,人们想要的是一个统一入口:可以检查权限、理解技能行为、测试它是否会在自然表达下触发,并在执行开始前把方案澄清清楚。
为什么是现在: 技能正在编码智能体生态里快速蔓延,但信任链仍然碎裂在安装体验、评估和规划之间。
面向买方侧的智能体工作控制平面
市场讨论里更强烈的诉求并不是再来一个目录,而是让任务真正变得“可购买”的基础设施:明确范围的需求、预算、截止时间、验收测试、托管、信誉、争议处理,以及工作确实完成的证据。@icefrog_sol 认为(14 个赞、15 条回复、93 次浏览)、@dee_e6 将其定义为(58 个赞、63 条回复、321 次浏览)和 @ZeoWeb3 展示(77 个赞、75 条回复)都指向同一个缺失的交易层。
为什么是现在: 公开供给已经看得见了;真正仍显稀缺的,是买方信心,以及由买方发起的工作。
跨本地模型、托管会话和浏览器技能的混合运行时编排
运行时讨论暗示,人们希望有一层编排系统,能把合适的工作放到合适的底座上:小型本地模型处理廉价、私密的任务;持久托管会话处理长时运行;浏览器技能库处理重复流程;云端/本地交接则不必迫使团队永远选定某一个环境。@aibytekat 认为(56 个赞、20 条回复、4,031 次浏览)、@beamnxw 解释(25 个赞、18 条回复、520 次浏览、11 次收藏)、@DivyanshT91162 披露(6 个赞、1 条回复、284 次浏览)和 @euboid 称赞(25 个赞、10 条回复、2,088 次浏览、22 次收藏)都在暗示这幅未来图景中的不同拼块。
为什么是现在: 团队其实已经在混用多种运行时了。现在缺的,是一个能让这些组合可靠运作的控制面。
面向长时程智能体的评测、沙箱与问责基础设施
研究相关讨论不断收敛到相似的愿望:更清晰的评测边界、可复用环境,以及在高风险场景下的外部问责。@marfinxx 强调(31 个赞、7 条回复、1,351 次浏览、29 次收藏)、@mirku21 强调(10 个赞、3 条回复、277 次浏览、7 次收藏)和 @gurtej__gill_ 认为(19 个赞、2 条回复、665 次浏览、21 次收藏)指向的是评测设计和环境解耦;而 @JoshAEngels 提出(164 个赞、8 条回复、2,929 次浏览、19 次收藏)则通过加入 METR,把问责这件事具体化了。
为什么是现在: 一旦智能体运行得更久、行动得更独立,评测和治理就不再是研究中的事后补丁,而会变成核心基础设施。
4. 正在使用的工具与方法
安装前先看技能护照和权限审查
最清晰的方法转变,是把技能当成软件包而不是辅助文本。@traversymedia 使用(53 个赞、8 条回复、2,360 次浏览、44 次收藏)通过 SkillPass 在安装前展示固定提交、权限、验证结果和可供 AI 阅读的摘要。这个方法之所以重要,在于它把检查放在了执行之前。
代码生成前先做访谈式规划
@Umesh__digital 描述(12 个赞、10 条回复、423 次浏览)把 Grill-Me 最有用的技巧讲得很直白:决策问人,事实问代码库。这会把规划变成一次结构化访谈,而不是让智能体默默替人决定架构、框架和范围。
用“启用/不启用”差异来评估技能
@stretchcloud 披露(9 个赞、3 条回复、462 次浏览)展示了一种简单但重要的评测方法:对同一组测试用例,在启用插件和不启用插件的情况下分别运行,然后比较差异。这比 schema 验证更强,因为它检验的是技能在自然表达下是否真的改变了行为。
持久会话与密钥隔离
@beamnxw 描述(25 个赞、18 条回复、520 次浏览、11 次收藏)把 OpenAI Agents API 描述为“会话 + 沙箱 + 保险库”的模式。这里真正关键的方法,不只是“托管智能体”,而是把编排状态与代码执行分离,并且在调用前都不让凭据进入智能体的执行盒子。
把浏览器任务沉淀为可重复运行的代码技能
@DivyanshT91162 强调(6 个赞、1 条回复、284 次浏览)展示了 Webwright 的方法:把浏览器视为编码智能体可以编写脚本的环境,而不是持久状态机。已解决的任务会留下可运行的 Playwright 代码,后续可作为经过验证的技能复用,而不必每次都逐 token 重新推导。
云端/本地协同工作区与小模型任务放置
这里出现了两种不同的方法。@euboid 强调(25 个赞、10 条回复、2,088 次浏览、22 次收藏)讨论的是带本地同步或 SSH 交接的共享云端工作区;@aibytekat 认为(56 个赞、20 条回复、4,031 次浏览)讨论的则是把适合的智能体任务放到本地 2B 模型上。二者合在一起,体现出一种“任务放置”思维:依据隐私、延迟和成本特征,为任务选择最匹配的环境。
面向长时程智能体的隐藏评测与解耦 rollout
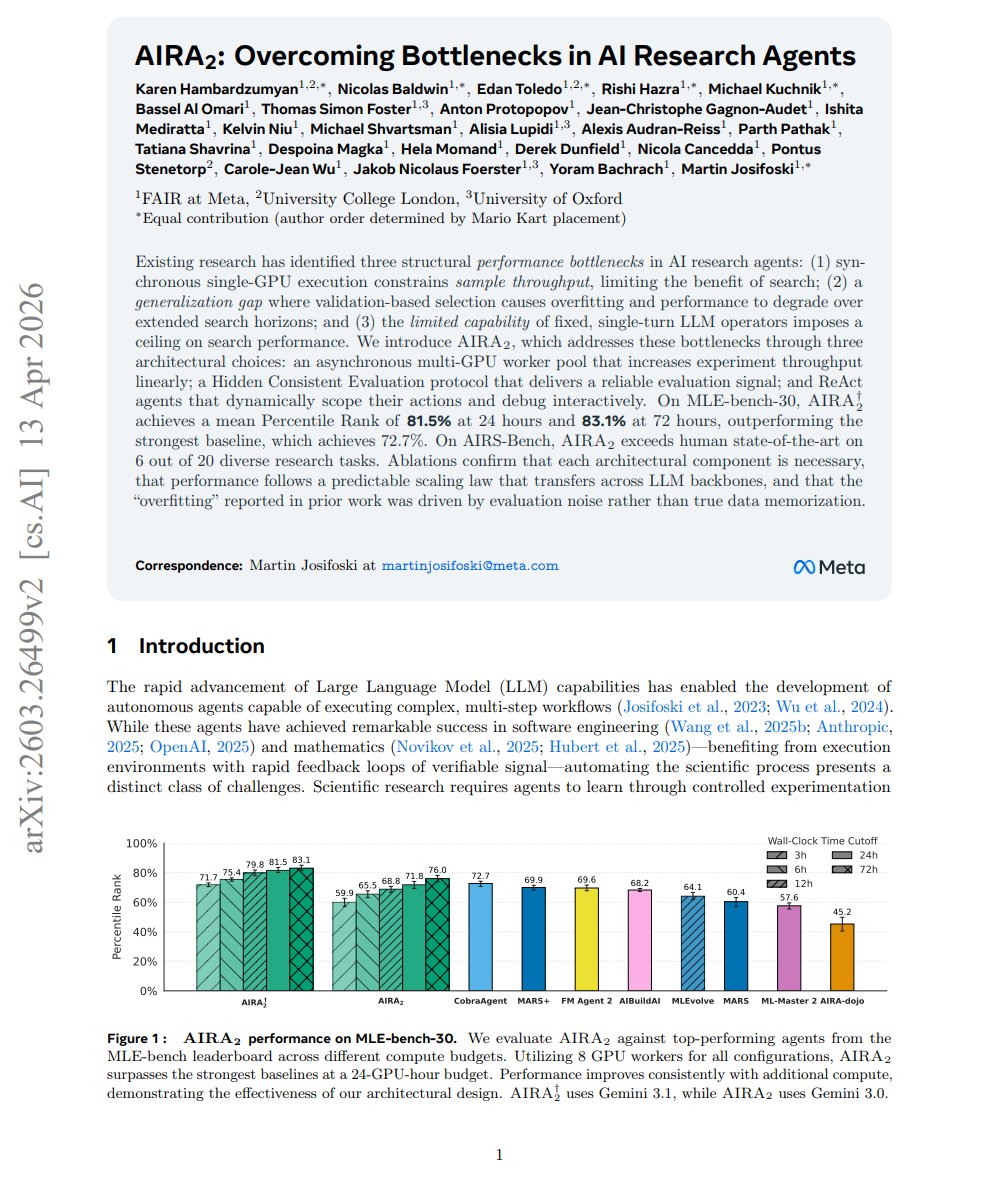
研究项目暴露出一种更专业、但同样重要的方法变化。@marfinxx 强调(31 个赞、7 条回复、1,351 次浏览、29 次收藏)提到 AIRA-2 的隐藏一致性评测和异步 worker 池;@mirku21 强调(10 个赞、3 条回复、277 次浏览、7 次收藏)提到 ProRL Agent 的 rollout-as-a-service 拆分;@gurtej__gill_ 聚焦于(19 个赞、2 条回复、665 次浏览、21 次收藏)则提到 Orchard 与 harness 无关的环境层。共同方法是把评测与执行关注点拆开,避免长时程智能体被自身基础设施压垮。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 阶段 | 链接 |
|---|---|---|---|---|---|
| SkillPass | Brad Traversy | 以验证优先的技能目录和 CLI,提供不可变的 Skill Passport、权限检测和哈希校验安装 | 让用户在把技能交给自己的机器之前,先看清它会做什么 | 公开发布 / 开源 | 推文, 文档, 代码库 |
| Claude plugin eval | Anthropic / Claude Code,由 @stretchcloud 提及 | 在启用和不启用插件的情况下对技能运行测试用例,再用 tool_used 和 tool_order 等评分器比较差异 |
衡量技能是否真的会触发并改善行为,而不只是 manifest 通过验证 | 已发布功能 | 推文, 公告 |
| Grill-Me | Matt Pocock,由 @Umesh__digital 提及 | 把编码智能体变成技术访谈者,在实现前先提澄清问题并推荐答案 | 防止智能体在方案尚未完全定型前就自行决定架构和范围 | 开源技能 | 推文 |
| TermiX / agent.family / AACP | TermiX 生态,由 @Abba__80、@Arifx0001 和 @dee_e6 提及 | 面向智能体身份、竞价、托管、验证、结算和信誉的市场与协议栈 | 让智能体工作更容易定价、验证和再次购买 | 已上线市场 + 协议持续建设 | 市场推文, 网站, 白皮书 |
| MiniCPM5-2B | OpenBMB | 面向本地助手、编码智能体、工具使用和端侧部署的紧凑型 2B 模型,配有开放训练数据和智能体技能 | 让日常硬件上的本地或离线智能体工作流更具可行性 | 新发布的开源模型 | 推文, 代码库 |
| OpenAI Agents API | OpenAI,由 @beamnxw 提及 | 托管式 Codex harness,提供持久会话、工具调用、沙箱选项、恢复机制和可选子智能体 | 为长时间运行的智能体分担编排和状态管理 | 已发布 API | 推文, 文档 |
| Webwright | Microsoft | 浏览器智能体框架:由编码模型编写 Playwright 脚本,并将成功运行提炼为可复用技能 | 把脆弱的一次性浏览过程转成可重复运行的代码制品 | 开源 | 推文, 代码库 |
| Conductor Cloud | Conductor,由 @euboid 提及 | 带隔离沙箱、SSH 或本地同步访问,以及多人交接能力的共享云工作区 | 改善智能体工作区的云端/本地开发体验 | 产品 / 文档已发布 | 推文, 文档 |
| AIRA-2 | Meta FAIR,由 @marfinxx 提及 | 自主研究智能体,具备隐藏一致性评测、有状态 ReAct 循环和异步多 GPU 搜索 | 解决研究型智能体的长时程评测与算力瓶颈 | 研究论文 | 推文, 论文 |
| Orchard | Microsoft Research,由 @gurtej__gill_ 提及 | 开源智能体建模框架,提供与 harness 无关、原生支持 Kubernetes 的环境层 | 统一不同智能体任务和 harness 之间的环境与轨迹复用 | 研究框架 / 开源 | 推文, 论文 |
| ProRL Agent | NVIDIA,由 @mirku21 提及 | rollout-as-a-service 基础设施,将多轮智能体执行与强化学习训练解耦 | 减少 GPU 空转,并提升 rollout 基础设施跨沙箱的可移植性 | 研究基础设施 / 论文 | 推文, 论文 |
这些项目呈现出一种异常一致的构建模式。构建者追的并不是一个包打天下的“智能体平台”,而是在把技术栈拆成不同层:信任层、评测界面、运行时选择、可复用技能,以及环境基础设施。
6. 新动态与亮点
6.1 使用数据让“从聊天窗口走向智能体群”更容易量化
@beamnxw 总结(11 个赞、5 条回复、233 次浏览、6 次收藏)提到一篇 Codex 论文,称智能体采用率在六个月内增长了 5 倍,如今 26.6% 的用户会使用可复用技能,而且在一个典型工作周里,超过 10% 的用户会同时管理三个或更多智能体。最有意思的一条回复并没有质疑采用率本身,而是追问:这些智能体里,还有多少仍然有负责人在认真审查它们的工作?这也正是这篇论文既值得关注又有用的原因:它量化了工作流迁移,却没有回答控制问题。
6.2 小模型本地智能体这件事,从理论主张走到了发布定位
MiniCPM5-2B 不只是又一个开源模型发布。@aibytekat 认为(56 个赞、20 条回复、4,031 次浏览)以及 OpenBMB 的发布材料,都明确把它定位为本地编码智能体和工具使用模型。这一点很重要,因为讨论很快就转向实际约束——硬件门槛、量化,以及结构化输出可靠性——而不再停留于“本地智能体在概念上是否有趣”。
6.3 语音智能体跨过了一个较小但重要的 UX 断点
@minchoi 提出(60 个赞、10 条回复、10,064 次浏览、31 次收藏)让 GPT-Live-1 的改进落到了两个操作层面的事实上:支持全双工打断处理,以及价格为每分钟 0.05 美元。评论进一步说明了这为什么重要。难题不只是降低延迟,而是实时判断一次打断究竟是纠正、附和,还是一条新指令。
6.4 长时程研究的重心仍然是评测与环境设计
最有实质内容的研究项目都在表达同一个判断:瓶颈在基础设施,而不在某个神奇提示词。@marfinxx 强调(31 个赞、7 条回复、1,351 次浏览、29 次收藏)提到 Meta 的 AIRA-2 论文,声称其通过隐藏一致性评测、有状态 ReAct 循环和异步多 GPU 搜索的组合,在 72 小时后于 MLE-bench-30 上达到 83.1 百分位。@mirku21 强调(10 个赞、3 条回复、277 次浏览、7 次收藏)则提到 ProRL Agent 将训练器与执行基础设施拆成 rollout-as-a-service;而 @gurtej__gill_ 聚焦于(19 个赞、2 条回复、665 次浏览、21 次收藏)讨论的是 Orchard 与 harness 无关的环境层。

这些帖子之所以值得注意,在于它们共享同一个诊断:长时程智能体的进展,取决于更清晰的评测拆分、可复用的沙箱层,以及更高效的搜索或 rollout 基础设施——而不只是更大的模型。
6.5 外部评测仍然是一个持续发酵的治理议题
@JoshAEngels 宣布(164 个赞、8 条回复、2,929 次浏览、19 次收藏)表示,他离开 Google DeepMind 的 AGI 安全团队转投 METR,是因为他认为当下风险已经高到需要更多外部问责。评论区质疑了“对齐”和“安全”的定义,但这种分歧本身正是这条帖子重要的原因之一:评测不再只是产品问题或研究问题,它也正在成为一个公共治理界面。
7. 机会在哪里
[+++] Verified skill trust layers - This looked like the cleanest near-term opportunity because the pain appeared in multiple adjacent forms at once: unsafe installs, invisible permissions, weak trigger behavior, and premature execution. @traversymedia 将其定义为(53 个赞、8 条回复、2,360 次浏览、44 次收藏)、@stretchcloud 报道(9 个赞、3 条回复、462 次浏览)和 @Umesh__digital 描述(12 个赞、10 条回复、423 次浏览)都指向同一个缺失层:先检查技能、测试触发、澄清方案,再决定安装或运行。
[+++] Buyer-side control planes for agent commerce - The marketplace cluster did not need more agent listings nearly as much as it needed scoped jobs, acceptance tests, escrow, dispute handling, reputation, and demand creation. @Abba__80 认为(152 个赞、176 条回复、976 次浏览)、@ZeoWeb3 发布(77 个赞、75 条回复)、@dee_e6 将其定义为(58 个赞、63 条回复、321 次浏览)和 @icefrog_sol 认为(14 个赞、15 条回复、93 次浏览)都在说明,“把经过验证的工作带进来”才是真正尚未解决的问题。
[++] Heterogeneous runtime orchestration and handoff - People are clearly not converging on one runtime. They are mixing local small models, managed sessions, browser skill frameworks, cloud sandboxes, and voice layers. @aibytekat 认为(56 个赞、20 条回复、4,031 次浏览)、@beamnxw 解释(25 个赞、18 条回复、520 次浏览、11 次收藏)、@euboid 称赞(25 个赞、10 条回复、2,088 次浏览、22 次收藏)和 @minchoi 展示(60 个赞、10 条回复、10,064 次浏览、31 次收藏)共同指向一个产品空间:工作负载放置、密钥处理、会话可移植性,以及云端/本地连续性。
[++] Reusable task compilers for browser and coding workflows - Webwright and Grill-Me suggest a broader pattern: one class of tools helps agents think through the problem before they act; another captures solved work as code or skills that can be rerun without repeating the full reasoning loop. @DivyanshT91162 披露(6 个赞、1 条回复、284 次浏览)、@Umesh__digital 描述(12 个赞、10 条回复、423 次浏览)和 @pauliusztin_ 认为(5 个赞、3 条回复、182 次浏览)都支持这样一类产品:把智能体工作变成可复用、可检查的操作资产。
[+] Evaluation and sandbox infrastructure for long-horizon agents - This is less immediate for everyday buyers, but the technical signal was strong. @marfinxx 强调(31 个赞、7 条回复、1,351 次浏览、29 次收藏)、@mirku21 强调(10 个赞、3 条回复、277 次浏览、7 次收藏)、@gurtej__gill_ 认为(19 个赞、2 条回复、665 次浏览、21 次收藏)和 @JoshAEngels 宣布(164 个赞、8 条回复、2,929 次浏览、19 次收藏)都在指向同一前沿:随着智能体运行得更久、影响变得更大,更好的评测边界、可复用环境和更强的外部问责会变得越来越关键。
8. 要点
- harness engineering 已成为严肃智能体工作的默认语言。 最强的帖子都是用循环、权限、评测、恢复和产品判断来描述进展,而不再只是讨论提示词措辞。(来源,93 个赞、11 条回复、6,976 次浏览、175 次收藏)
- 技能正在被当成不可信软件,而不是无害片段。 权限护照、触发评测和访谈优先规划都指向同一个变化:技能的有用性必须靠验证和检查来获得。(来源,53 个赞、8 条回复、2,360 次浏览、44 次收藏)
- 智能体商业变得更可理解了,但买方稀缺和验证仍主导着风险面。 公开指标和市场截图让这个类别更容易分析,但买方侧看起来仍比卖方侧薄,验收标准也仍然建设不足。(来源,77 个赞、75 条回复)
- 运行时选择快速多样化。 同一天里同时出现了本地 2B 智能体模型、托管会话 API、浏览器技能工厂、云端/本地工作区,以及全双工语音基础能力,这说明技术栈正在按任务和运行约束发生分化。(来源,25 个赞、18 条回复、520 次浏览、11 次收藏)
- 研究与治理信号汇聚到同一条结论:基础设施和模型同样重要。 隐藏评测、rollout 服务、可复用环境层,以及外部评测组织,都在指向这样一个未来:信任将取决于更好的 harness 和更强的问责,而不只是更好的模型权重。(来源,31 个赞、7 条回复、1,351 次浏览、29 次收藏)