Twitter AI 编程 - 2026-07-13
1. 大家在讨论什么
1.1 编排的话题已从“智能体”讨论转向已上线的控制面(🡕)
7 月 13 日最热的一组话题,不再是该选哪个最喜欢的模型,而是如何操作多个智能体。Google 推出了 Antigravity 的新功能 Agent Teams,GitHub 发布了 Copilot CLI 中子智能体可靠性提升的量化结果,实践者们则展示了定时运行和远程控制运行,作为下一层工作方式。整个讨论明显偏向运维层面:如何让智能体运行持续在线、可审查,并且成本低到值得持续使用。
@testingcatalog 重点提到(129 个赞,8 条回复,10,229 次浏览,15 次收藏)称,Antigravity 现已支持 /teamwork-preview,而被引用的 Antigravity 官方帖子则表示,生成出的团队将并行规划、构建并验证复杂任务。这张截图之所以重要,是因为它显示这已经是产品中的原生命令,而不只是概念演示。

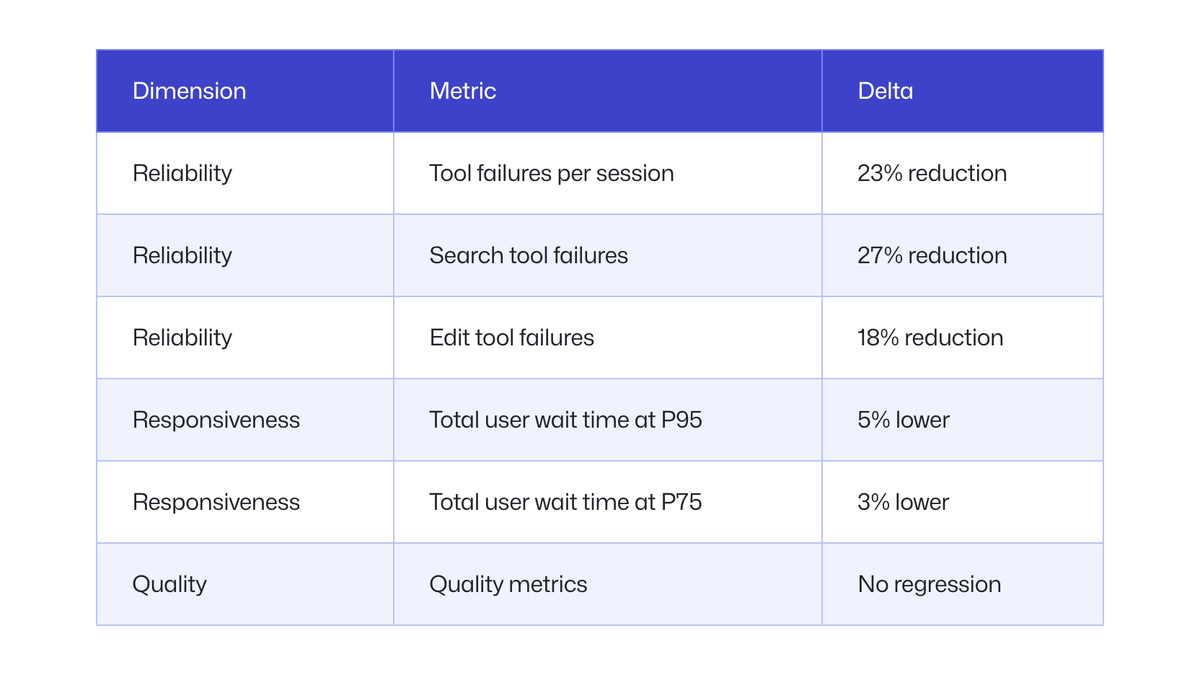
@github 报道(125 个赞,29 条回复,24,700 次浏览,22 次收藏)称,Copilot CLI 中更智能的子智能体委派将工具失败率降低了 23%、搜索失败率降低了 27%、编辑失败率降低了 18%,且质量没有回退。配套表格还称 P95 等待时间降低了 5%,使这成为少数公开给出精确前后基准指标的帖子之一。
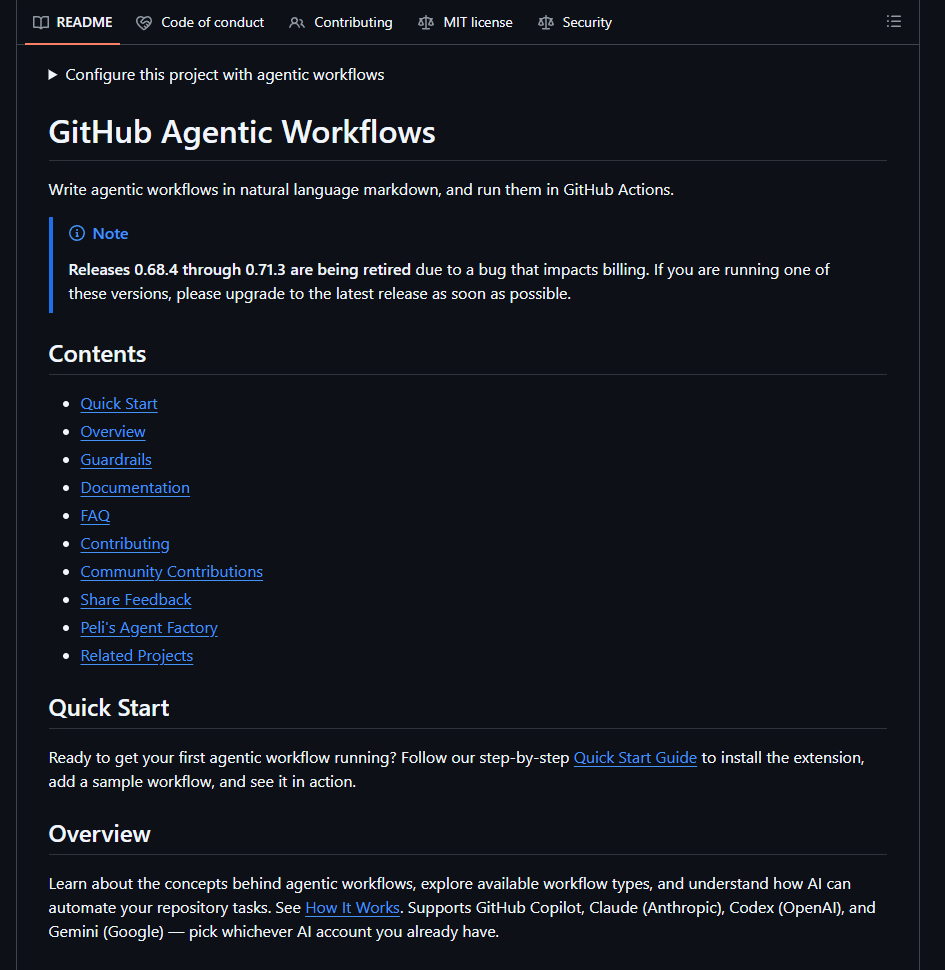
@iiiichigo_chan 表示(25 个赞,7 条回复,928 次浏览,17 次收藏)称,GitHub Agentic Workflows 可让 Claude Code、Codex 或 Copilot 承担“夜班”工作:把一个 markdown 工作流转换为常设的 GitHub Actions 任务,用于 bug 分流、不稳定测试、发布说明或依赖更新。随后,@jfversluis 展示了(1 个赞,1 条回复,248 次浏览)提到,在需要审批或分支策略决策时,Copilot CLI 的 --remote 流程可以从网页端和手机端继续进行。
讨论洞察: 回复并没有否定编排本身,而是在反复强调运维约束。@spboyer 认为(10 个赞,549 次浏览,6 次收藏)称,每一次交接都会增加协调成本、带来更多工具调用,也会增加偏离目标的机会;而 Antigravity 和 gh-aw 相关帖子下的回复,则聚焦于速率限制,以及定时运行之间如何保持持久状态。
与前一天相比: 7 月 12 日的讨论主要集中在可移植层和桥接插件上;7 月 13 日则转向了真正运行多智能体工作的控制面。
1.2 信任边界变成了具体事件,而不再只是架构口号(🡕)
最强烈的安全讨论,来自那些点名具体失效模式的帖子:被隐藏的符号链接目标、静默上传代码仓库,以及由供应商控制的记忆入口。语气更偏向实务而非理论。相比抽象的安全承诺,人们更关心到底哪些内容会被写入、上传或保留。
@mardehaym 认为(98 个赞,12 条回复,28,846 次浏览,101 次收藏)称,Satya Nadella 那篇“为 AI 付两次钱”的文章,确实准确描述了组织知识泄漏的问题,但最后仍把客户引回 Microsoft 自家的技术栈作为答案。该讨论串里最尖锐的一条回复说,修正内容应当落在团队自己掌控的版本化文件中,因为“模型会访问我们的记忆,但不会保留它”,这让关于信任边界的争论变成了一条具体的设计规则。
@cloudsa 总结道(5 个赞,2 条回复,386 次浏览,2 次收藏)提到 Wiz 的 GhostApproval 披露,称 Amazon Q Developer、Claude Code、Augment、Cursor、Google Antigravity 和 Windsurf 都可能被符号链接欺骗,从而在工作区之外写入内容,而审批提示却隐藏了真实目标。Wiz 表示,AWS、Cursor 和 Google 已迅速修复该问题,而其余供应商的回应则较弱或并不完整。@mardehaym 警告(5 次点赞、5 条回复、4,110 次浏览)称,Grok Build 0.2.93 即使在用户关闭“改进模型”后,仍会将完整的跟踪仓库和 git 历史上传到一个 Google Cloud 存储桶。cereblab 的线缆级分析 记录了 POST /v1/storage、一个 grok-code-session-traces 存储桶路径,以及一个 12 GB 的测试仓库;尽管提示词明确要求不要读取文件,仍传输了 5.10 GiB。
讨论洞察: 最常见的答案不是“避开 agent”,而是“让它们经过你能控制的环节”:带版本的记忆文件、明确的审批层级,以及能够验证隐私开关或权限边界是否真正生效的代理层。
与前一天的对比: 7 月 12 日关于信任的争论,焦点在于谁拥有记忆层。到了 7 月 13 日,公开的利用和数据外传证据让边界问题变得具体起来。
1.3 Token 消耗如今开始在 harness 层被诊断(🡕)
关于使用量的话题依然很热,但讨论已经更具体。人们开始比较上下文上限、首轮负载大小,以及不同 harness 的问题处理吞吐量,而不再只是笼统抱怨限制模糊。讨论焦点也从“我把额度用完了”转向“这个 harness 里到底是什么烧掉了预算?”
@hqmank 表示(67 次点赞、3 条回复、6,034 次浏览)称,OpenAI 已确认,GPT-5.6 Sol 的 372K 上下文 rollout 导致使用量高于预期,因此已回滚到 272K。@kunchenguid 将其整理成一条配置建议(28 次点赞、6 条回复、5,192 次浏览、17 次收藏)称:如果某个非 Codex harness 仍将 GPT-5.6 设为 372K,把它降到 272K,就能避免不必要地浪费配额。
@TateBerenbaum 分享了(5 次点赞、1 条回复、164 次浏览、2 次收藏)发布了一张针对 22 字符任务的校准图,估算 Claude Code 的首轮负载约为 32,800 token,而 OpenCode 约为 6,900;其中大部分差距归因于 system prompt、工具 schema 和首条消息脚手架。

@BradGroux 表示(2 次点赞、3 条回复、547 次浏览)称,通过 Foundry 使用 GitHub Copilot App 处理积压问题时,与 Codex /goal 相比“简直像拔牙一样费劲”;他附上的截图显示,连该应用自己都承认存在过度编排、重复会话和状态陈旧的问题。@Layton_Gott 认为(3 次点赞、3 条回复、109 次浏览)称,即便是“零限制”的 agent 配置,仍然需要六个明确的上限:支出、时间、重试次数、工具访问、停止条件,以及升级规则。
讨论洞察: 这些变通做法已经很具体:调整上下文窗口、限制每个会话的支出、审批计划而不是审批每一次安全读取,并收缩工具暴露面,以降低 harness 的固定成本。与前一天相比: 7 月 12 日的重点是共享用量和意外账单。7 月 13 日则新增了上下文回滚的证据、首轮开销图表,以及明确的控制策略。
1.4 技能、规范和提示语料库正变成可复用的产品(🡕)
另一类讨论把工作流层本身视为产品。构建者不再只是再发布一个原始 agent,而是推出技能包、规范工具包、提示语料库和集成指南,让现有 agent 的行为更可复现。越来越多的人听起来像是在整理流程资产的运营者,而不只是挑选模型。
@Granite0x 指出(11 次点赞,2 条回复,525 次浏览,12 次收藏)Addy Osmani 的 agent-skills,其仓库和截图展示了 24 个生产级技能、8 个斜杠命令,以及围绕 define → plan → build → verify → review → ship 生命周期积累的 77,991 个 GitHub stars。@crptAtlas 将其表述为(9 次点赞,4 条回复,2,049 次浏览,5 次收藏)GitHub 的 spec-kit 被视为对抗 vibe-coded 漂移的解药;在审查时,该仓库已有 120,694 个 stars,并将 specifications 描述为可执行工件,而非一次性脚手架。

@Chinazhidx 重点提到(14 次点赞,2 条回复,681 次浏览,7 次收藏)awesome-deepseek-agent,这是一套拥有 4,677 个 stars 的指南包,用于将 DeepSeek 接入 Claude Code、Codex、GitHub Copilot、GitHub Copilot CLI 等。@Suryanshti777 表示(14 次点赞,4 条回复,1,118 次浏览,13 次收藏)system_prompts_leaks 则通过整理 GPT-5.6、Codex、Claude、Gemini、Copilot、Grok 等背后的隐藏指令文件,早已突破 57,000 个 stars。
讨论洞察: 这里的语气较少体现模型阵营之争,更多是在讨论可复用的操作流程。人们想要的是那些可以安装、检查并持续沿用的工件。
与前一天相比: 7 月 12 日出现的是桥接工具和市场化风格的指南。到了 7 月 13 日,这种倾向进一步扩展为完整的技能套件、规范工具包和公开提示语料库。
2. 什么让人感到沮丧
审批提示、隐私开关,以及未说出全部实情的发布默认设置
严重程度:高。最尖锐的不满并不是代码生成质量差,而是失去了对 agent 实际行为的控制。@cloudsa 指出(5 次点赞,2 条回复,386 次浏览,2 次收藏)指向 Wiz 的 GhostApproval 披露,其中六款 coding assistants 都可能被诱导写入工作区之外,而审批提示却隐藏了真实的目标文件。@mardehaym 随后进一步放大了这一点(5 次点赞,5 条回复,4,110 次浏览,3 次收藏)Grok Build 的整仓库上传问题,以及 cereblab 的公开线缆分析 记录了存储上传路径和字节数。即便并非明确的安全事件,@QuinnyPig 抱怨(26 个赞、2,588 次浏览、4 次收藏)也指出,GitHub Copilot 应用正在整个组织内默认启用,而退出说明却深埋在供应商邮件中。应对模式很一致:让 agent 经由你可控的代理转发,把记忆保存在你拥有且纳入版本管理的文件里,并将无害的读取审批与任何会触达外部世界的操作分开。这值得投入建设,因为这种需求对安全至关重要,而且已有具体、公开的失败案例支撑。
Harness 开销和上下文设置仍会带来“账单惊吓”
严重性:高。即使 OpenAI 将 GPT-5.6 Sol 的上下文窗口从 372K 下调回 272K,使用层面的痛点也没有消失。@hqmank 展示了(67 个赞、3 条回复、6,034 次浏览、4 次收藏)表示,人们仍在排查上下文窗口计费问题,而 @kunchenguid 将其变成一项配置修复方案(28 个赞、6 条回复、5,192 次浏览、17 次收藏)。@TateBerenbaum 产出了(5 个赞、1 条回复、164 次浏览、2 次收藏)贴出了一张开销图,显示任务甚至尚未开始,harness 本身就可能烧掉首轮交互中的大部分额度。@BradGroux 描述了(2 个赞、3 条回复、547 次浏览、1 次收藏)将 Copilot App 的 issue 积压工作形容为“像拔牙一样难”,而 @Layton_Gott 认为(3 个赞、3 条回复、109 次浏览、2 次收藏)则指出,自主任务需要对花费、时间、重试次数、工具访问、停止条件和升级机制设置硬性上限。可行的变通办法是缩小上下文、收窄工具暴露面、审批计划而非逐一审批每次安全读取,并为每项任务强制设定预算上限。这值得投入建设,因为这种痛点高频、具备运营属性,而且可量化。
多 agent 配置仍在用速度换取状态漂移
严重性:中。同一批对 agent 团队感到兴奋的人,也很快指出了协调成本。@spboyer 表示(10 个赞、549 次浏览、6 次收藏)指出,subagent 并不是“免费”的,因为每一次交接都会增加工具调用,也会带来更高的漂移风险;而在 @iiiichigo_chan 重点提到(25 个赞、7 条回复、928 次浏览、17 次收藏)下的一条回复则表示,定时运行真正困难的不是 cron 触发器,而是持久记忆,以及与上一次运行结果做 diff。@jfversluis 显示(1 个赞、1 条回复、248 次浏览、1 次收藏)解释了为什么远程监督有帮助:长时间运行的任务仍会冒出分支策略、合并和审批决策,而这些都需要人来处理。这值得投入建设,因为编排显然有用,但用户想要的是状态连续性和更低的协调成本,而不只是更多 agent。
许多团队仍需要帮助来判断何时不该使用 agent
严重性:中。@AiswaryaVenkit1 转述(27 个赞、5 条回复、300 次浏览、8 次收藏)把 Microsoft 的 Cloud Adoption Framework 提炼成一套直白规则:如果工作是结构化的、可预测的,或现有 copilot 已经能解决,就跳过自定义 agent,继续使用更简单的工具;只有当安全边界、多个团队或显著规模确有必要时,才转向多 agent。该讨论串中最有力的一条回复更短:正确答案是“不要”的情况,比人们愿意接受的更常见。这值得作为决策支持或架构评审来建设,因为当前市场主要在兜售如何增加更多 agentic 行为,而不是如何拒绝这么做。
3. 人们希望有的东西
一个可审计的控制平面,统一管理花费、权限和数据外发
最明确、也最实际的愿望,是有一个统一入口,能看到 agent 能花多少钱、能接触什么,以及它实际上正在向外发送什么。@Layton_Gott 明确列出(3 个赞、3 条回复、109 次浏览、2 次收藏)提到了缺失的控制项——最高花费、最长时间、最大重试次数、工具范围、停止条件,以及升级规则——而 @hqmank 显示(67 次点赞,3 条回复,6,034 次浏览,4 次收藏)、@kunchenguid 显示(28 次点赞,6 条回复,5,192 次浏览,17 次收藏),以及 @TateBerenbaum 显示(5 次点赞,1 条回复,164 次浏览,2 次收藏)都说明,不透明的设置和固定开销至今仍会转化为令人意外的成本消耗。GhostApproval 和 Grok Build 上传事件则从安全角度进一步凸显了同样的需求:人们想要一个控制平面,能够确认究竟有哪些文件、提示词和打包内容真正越过了边界。现在已经有一些局部答案,比如支出上限、代理和按工具审批,但这种需求显然不止对应某一个单独功能。机会:直接型。
能承受引擎切换和会话重置的工作流套件
人们反复以不同形式表达同一个诉求:保留工作流,必要时再更换引擎。GitHub Agentic Workflows 将 Markdown 变成常设的 GitHub Actions 作业,agent-skills 为 70+ 个 agent 封装了可复用的工程生命周期,awesome-deepseek-agent 提供了跨多个宿主环境的安装指南,而 @sairahul1 描述(11 次点赞,1 条回复,1,862 次浏览,11 次收藏)则使用官方的 Claude Code 的 Codex 插件,在保持同一界面的同时切换底层执行模型。这种需求是务实的,不是情绪性的:用户不想每次首选 agent 变化时,都重建一遍自己的操作流程。机会:竞争型。
具备真实审批与记忆所有权的更安全运行时
今天公开出现的证据,让安全方面的诉求变得格外具体。Wiz 的 GhostApproval 披露 描述了会掩盖真实目标文件的审批对话框,而 cereblab 的 Grok Build 分析 则记录了整仓库上传在隐私开关被关闭后仍持续进行。与此同时,@mardehaym 认为(98 次点赞,12 条回复,28,846 次浏览,101 次收藏)以及该帖中的回复认为,修正内容、日志和可复用记忆应保留在团队自有、且可版本化的资产中。这意味着,人们要的不只是一个更准确的模型,而是一个其文件边界、审批提示和记忆归属都可检查、可执行的运行时。机会:直接型。
更低开销的 harness 与更智能的模型路由
Claude Code 与 OpenCode 的开销对比、GPT-5.6 的上下文回滚,以及人们对通过本地代理路由 Claude Code 或在开放模型上运行 Codex 的兴趣,都指向同一个需求:用户想在保持相同工作流的前提下,降低固定成本,并获得更灵活的路由能力。@TateBerenbaum 量化了(5 次点赞,1 条回复,164 次浏览,2 次收藏)展示了提示词与工具开销,@RedHat_AI 显示(10 次点赞,2 条回复,493 次浏览,2 次收藏)体现了对面向开放模型的 vLLM Agentic API 桥接的兴趣,而 OpenAI Codex Claude Code Proxy 仓库则展示了人们已经在尝试将界面与提供方解耦的一种方式。这部分既是成本诉求,也是控制诉求。机会:竞争型。
一种能在构建前告诉团队是否根本需要 agent 的检查步骤
@AiswaryaVenkit1 揭示(27 次点赞,5 条回复,300 次浏览,8 次收藏)揭示了一个大多数 agent 工具仍然忽视的需求:明确增加一步,告诉团队什么时候应该继续使用传统 SaaS 工具、脚本,或更简单的单 agent 路径。当前市场在增加编排上的投入,远多于防止过度工程化上的投入。这使得这一需求对企业买家而言很实际,对那些如果选择更简单架构就会担心自己落后的团队来说,也带有情绪层面的意义。机会:直接型。
4. 在用的工具与方法
| 工具 | 类别 | 情绪倾向 | 优势 | 局限 |
|---|---|---|---|---|
| Google Antigravity | 编码 agent 平台 | (+/-) | 全新的 teamwork-preview 团队编排、强劲的产品势头、覆盖面广的 agent 平台定位 |
用户仍在要求更高的速率限制和更强的模型能力 |
| GitHub Copilot CLI | CLI 编码 agent | (+) | 公开测得的可靠性提升、可从网页/移动端远程控制的工作流、不断扩展的运维能力面 | 用户仍在要求更清晰的采用/限制数据以及更谨慎的预算控制 |
| GitHub Copilot app | 应用 / 扩展平台 | (+/-) | 可承载 JVM Pulse 这类领域扩展,并在应用内呈现 issue/PR 工作 | 一些用户称,处理积压 issue “像拔牙一样费劲”,且组织级默认设置可能让管理员措手不及 |
| GitHub Agentic Workflows | 定时编排 | (+/-) | 以自然语言 Markdown 工作流在 GitHub Actions 中跨多个引擎运行 | 计费 bug 导致多个发布被迫撤回,且跨运行状态仍是个难题 |
| Codex / GPT-5.6 Sol | 模型 / 编码 agent | (+/-) | 执行能力口碑强、官方提供了使用优化、可通过插件轻松委派 | 372K 上下文上线曾向用户多收费,因此路由和上限仍需手动谨慎处理 |
| Claude Code | Harness | (+/-) | 拥有庞大的技能/插件生态,以及便捷的 shell 工作流 | 一张公开的开销图将极大的首轮负载归因于提示词和工具脚手架 |
| OpenCode | 开源编码 agent | (+) | 在一项公开对比中固定开销更低,且已用于 issue 分诊循环 | 公开 issue 讨论仍提到 OpenCode 2.0 的压缩循环 bug |
| Spec Kit | 规范驱动方法 | (+) | 让规范变得可执行、减少含糊提示、仓库采用度很高 | 增加了前期流程和更大的命令集规模 |
| agent-skills | 技能包 | (+) | 将资深工程师工作流封装为可复用技能和斜杠命令,覆盖 70+ 个 agent | 仍需人工策展,且依赖宿主 agent 的行为 |
| Awesome DeepSeek Agent | 集成指南包 | (+) | 可在 Claude Code、Codex、GitHub Copilot 和 GitHub Copilot CLI 上快速完成设置 | 证明的是更容易集成,而不是输出质量本身更高 |
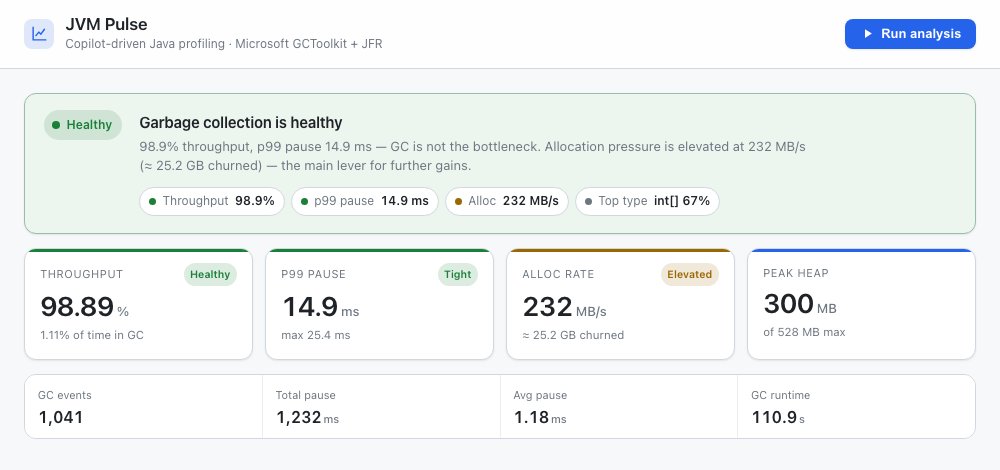
| JVM Pulse | Copilot 扩展 | (+) | 将 Java GC/JFR 产物转化为仪表盘和 Copilot 建议 | 仅适用于 Java,且仍处于非常早期阶段 |
总体来看,人们对编排和工作流封装的态度是偏正面的混合情绪,而对默认设置、隐藏成本和信任边界则明显更为怀疑。最受好评的是那些让 agent 行为更可见或更可复现的工具:委派指标、定时作业、规范工作流、技能包和指南集合。
这些变通方案呈现出明显的组合式特征:保留你喜欢的界面,再替换执行层,或在其外围增加控制面。在涉及计费来源时,可以使用 Claude Code 的 Codex 插件 处理委派式工作,或在计费来源很重要时通过本地代理转接 Claude Code;如果优先考虑开放模型,则可参考 @RedHat_AI 用于 vLLM Agentic API bridge 演示(10 次点赞、2 条回复、493 次浏览、2 次收藏)。用户也在不断精简上下文、工具列表和审批范围,以免 harness 本身反而成为最大的摩擦来源。
竞争态势更像是组合式演进,而不是赢家通吃。就在同一天,市场上出现了团队编排功能、远程控制功能、指南包、技能包、规格工具包、应用扩展、开放模型桥接,以及定时工作流运行器。这说明工作流层的市场格局仍然远未定型。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| GitHub Agentic Workflows | GitHub | 在 GitHub Actions 中按计划运行自然语言 Markdown 工作流 | 反复处理相同的仓库杂务,并且每次运行都要重新交代上下文 | Go、GitHub Actions、Markdown 工作流、多引擎支持 | 已发布 | 仓库, 文章 |
| agent-skills | Addy Osmani | 面向生产环境的技能包,包含 24 项技能和 8 个斜杠命令,供 AI 编码代理使用 | 团队需要可重复的工程流程,而不是临时拼凑的提示词 | JavaScript 仓库、Markdown 技能、斜杠命令配置、Claude Code 插件 | 已发布 | 仓库, 文章 |
| Spec Kit | GitHub | 一套规格驱动的工具包,可将规格说明转化为可执行的实现工作流 | 需求表述模糊,以及难以预测的 vibe-coded 修改 | Python、Specify CLI、代理集成、可执行规格 | 已发布 | 仓库, 文章 |
| Claude Code 的 Codex 插件 | OpenAI | 在 Claude Code 内加入 /codex:review、/codex:rescue 和后台任务管理 |
无需离开 Claude Code,即可使用 Codex 的审查或执行能力 | JavaScript、Node.js、Claude Code 插件、Codex 应用服务器 | 已发布 | 仓库, 文章 |
| Awesome DeepSeek Agent | DeepSeek AI | 用于将 DeepSeek 接入多个助手的指南包 | 切换提供商时的配置摩擦 | Markdown 文档、DeepSeek-V4-Pro/V4-Flash 配置、多客户端指南 | 已发布 | 仓库, 文章 |
| JVM Pulse | brunoborges | 一个 Copilot 画布扩展,可分析 GC + JFR 并给出 JVM 调优建议 | Java 性能分析通常游离于编码代理工作流之外 | JavaScript 画布扩展、GCToolkit、JDK jfr CLI、jbang |
Alpha | 仓库, 文章 |
| OpenAI Codex Claude Code Proxy | MikeChongCan | 可在本地启动的代理,让 Claude Code 通过 OpenAI/Codex OAuth 或 Azure OpenAI 与 GPT 模型通信 | 在更换模型提供方和计费来源时,保留 Claude Code 的工作流 | Python、CLIProxyAPI、本地 Anthropic 兼容代理、GPT-5.6 路由 | Alpha | 仓库, 文章 |
最强的构建模式是工作流封装。GitHub Agentic Workflows、agent-skills、Spec Kit、codex-plugin-cc 和 awesome-deepseek-agent 都基于同一个判断:工作流的生命周期会长于当下最受欢迎的模型或托管平台。其中一个把重复性工作变成定时运行的 Markdown 任务,另一个把资深工程师的习惯沉淀为规范,另一个让规格说明可执行,另一个把 Codex 留在 Claude Code 里,还有一个则降低了切换提供方的摩擦。

第二个模式是面向操作人员的扩展和路由层。JVM Pulse 使用 GitHub Copilot 启动 Java 工作负载、收集 GC 和 JFR 工件,然后在仪表盘中汇总吞吐量、暂停、分配和堆行为。OpenAI Codex Claude Code Proxy 则采取了相反的思路:保留 Claude Code 的界面,但通过 localhost 代理将其路由到 GPT-5.6 Sol,并可选择让计费落在 OpenAI/Codex OAuth 或 Azure OpenAI。
其他开发者信号则聚焦于让智能体行为变得可检查。System Prompts Leaks 将系统指令视为一个公开的参考界面,而 @thdxr 显示(66 个赞,10 条回复,3,600 次浏览)则是一个问题反馈渠道,OpenCode 会从中拉取优质 GitHub issues,并尝试复现和修复。@RedHat_AI 重点介绍了(10 个赞,2 条回复,493 次浏览)是一个 vLLM Agentic API 演示,在开放模型上保留了 Codex 风格的网页搜索和多轮状态,这表明路由和可观测性可能会发展成独立的产品类别。

6. 新的和值得关注的
一家头部编码智能体厂商公布了真实的前后对比 harness 指标
@github 做了一件不同寻常的事(125 个赞,29 条回复,24,700 次浏览,22 次收藏):在调整 subagent 委派逻辑后,它公布了 Copilot CLI 在失败率和等待时间上的精确变化幅度。在一个通常只靠演示和感觉说话的市场里,一张显示工具失败减少 23%、搜索失败减少 27%、编辑失败减少 18%,且质量没有回退的表格,是个真正的信号。
GhostApproval 给审批 UX 问题起了个名字
Wiz 的 GhostApproval 文章 把一种模糊的担忧变成了一个具体的漏洞模式:在智能体审批提示中,符号链接跟随与 UI 误导叠加。@cloudsa 把那条内容纳入了 AI 编程资讯流(5 个赞,2 条回复,386 次浏览),这之所以重要,是因为它表明,安全研究如今开始瞄准审批模型本身,而不再只是模型输出。
Copilot 原生扩展正迅速走向垂直化
@brunoborges 介绍了(9 个赞,3 条回复,501 次浏览)JVM Pulse,这是一个 Copilot 画布扩展,会分析 Java GC 和 JFR 遥测数据,然后让 Copilot 给出优化建议。这一点值得注意,因为它将编码代理用作工件和调优建议的接口,而不只是代码生成器。
系统提示词正在变成公开的参考层
@Suryanshti777 表示(14 个赞,4 条回复,1,118 次浏览,13 次收藏),称 system_prompts_leaks 的 star 数已超过 57,000,仓库截图还展示了 GPT-5.6、Codex、Claude 和 GitHub Copilot for macOS 的近期提示词条目。这一点值得注意,因为社区越来越倾向于把隐藏指令视为可检查的基础设施,而不是厂商的魔法。
7. 机会在哪里
[+++] 可审计的代理治理平面 —— 证据来自 GhostApproval、Grok Build 上传事件、372K→272K 回滚、OpenCode-vs-Claude-Code 开销图表,以及对支出上限、工具范围和升级规则的明确呼吁。这一方向很强,因为痛点同时横跨安全、成本和操作员控制。
[+++] 工作流可移植工具包与编排层 —— GitHub Agentic Workflows、agent-skills、Spec Kit、面向 Claude Code 的 Codex 插件,以及 awesome-deepseek-agent,解决的都是同一个问题:团队希望工作流在引擎变更、会话重置和宿主切换后依然可用。这一方向很强,因为相关信号同时来自官方厂商项目、独立开发者和指南包。
[++] 更低开销的路由与模型切换基础设施 —— TateBerenbaum 的固定开销图表、Codex Claude Code Proxy 仓库,以及 vLLM Agentic API bridge 演示,都指向这样一层:将接口与提供方解耦,同时压缩固定成本。这一方向强度中等,因为需求已经很明确,但胜出的产品形态仍在形成中。
[++] 垂直领域代理扩展 —— JVM Pulse 展示了这样一种变化:编码代理不再只是纯粹的代码生成器,而是成为遥测、分析和建议的统一入口。这一方向强度中等,因为这种模式很有前景,但公开证据仍然偏早期,也较为小众。
[+] 代理/非代理架构顾问 —— Microsoft 那个决策树讨论串表明,市场对能够告诉团队何时不该继续增加 agentic 行为的工具确有需求。这一方向仍处于萌芽阶段,因为需求可信,但几乎没有产品把“克制”作为核心卖点。
8. 要点
- 编排正在成为一级产品能力。 Antigravity 的
/teamwork-preview、Copilot CLI 的委派指标、gh-aw 的常驻任务,以及 Copilot CLI 的远程控制,都指向了一个高于单代理提示的层次。(来源) - 信任边界问题如今已有具体的公开失误作为支撑。 这一天出现了具名的审批交互漏洞、整个仓库被上传的证据,以及对代理层和自有记忆的反复呼吁。(来源) 3.使用层面的痛点正演变为运行控制框架工程问题。 372K 回滚、272K 变通建议,以及固定开销图表,关注点都集中在 shell 的配置方式上,而不只是模型质量。(来源)
- 工作流层如今已成为一个独立的产品类别。 技能包、规格包、集成指南以及公开的系统提示词语料库,正被视为可复用的基础设施。(来源)
- 构建者的精力正投入到围绕智能体的封装层、扩展和路由层上。 JVM Pulse、Claude Code 的 Codex 插件、Claude-Code-to-GPT 代理,以及 vLLM 桥接演示,都是在扩展或重定向现有智能体,而不是直接取而代之。(来源)
- 成熟团队在扩大自动化规模之前,正重新引入架构判断。 当下最有分量的治理建议是:先检验一项任务是否根本就适合由智能体处理,在可能的情况下保留单智能体路径,并在恰当的边界处审批计划。(来源)