Twitter AI - 2026-09-21
1. 人们在讨论什么
1.1 MiMo-V2.6 抬高了多模态智能体开放权重模型的天花板 🡕
MiMo 是信息流里最明显的突围焦点。2026-09-21,MiMo/Xiaomi 相关帖子大约有 10 条,而前一天只有 2 条。讨论既有发布带来的兴奋,也有部署端的现实算账:活跃参数规模、单任务成本、仓库体积,以及这批新权重是否真的适合本地或自托管使用。
@XiaomiMiMo 宣布(1,819 个赞、99 条回复、72,384 次浏览、318 次收藏)将 MiMo-V2.6 Pro 和 Flash 介绍为完全开放的模型,目标覆盖智能体、多模态以及 3D/计算机使用,并称 Pro 在 Artificial Analysis Intelligence Index 上达到 46 分,在许多智能体基准上与 Claude Opus 5 和 GPT-5.6 Sol 表现相当。公开的 发布说明 进一步明确了此次发布背后的主张:Xiaomi 将该模型定位为通过规模化强化学习实现自我改进,而不只是一次静态 checkpoint 的投放;同时表示,该系列提供权重、技术报告、RL 环境和训练代码,且 API 定价与 V2.5 保持不变。

@LuminaBench 标记(106 个赞、6 条回复、3,192 次浏览)点出了部署侧的直接意义:MiMo-V2.6-Pro 以每项任务约 $0.13 的成本进入 Artificial Analysis 前沿梯队,而一则被引用的基准说明将其描述为一个 1.02T 参数、42B 活跃参数的 MoE。这让它的意义不只是一次排行榜事件,也让它成为可与其他开放模型进行真实路由表实验的候选对象。

@TeksEdge 新增(41 个赞、1,711 次浏览)补充了让讨论保持落地的硬件细节:Flash 总参数量为 309B、活跃参数量为 15B,官方仓库体积约 178 GB;Pro 则约为 573 GB。两者都支持 1M 上下文、多模态输入输出、工具使用,并提供了 SGLang/vLLM 的部署文档。这条帖子把讨论从“顶级开放模型”推进到更现实的问题:“如果要本地运行,需要什么级别的内存?这两个版本里,哪个更有可能先跑起来?”

讨论洞察: 最有思考价值的反应,并不是孤立地为那个指数分数喝彩,而是在讨论 MiMo 是否值得在生产路由表里拿到一个实时 A/B 测试席位。因为开放权重、强基准表现和不变的定价,终于足够接近真实使用条件,值得花力气做实际工作负载对比。
与前一天对比: 相比 2026-09-20 当天开放权重领域的注意力主要集中在 Qwen-Image-2.1 和网关份额上,2026-09-21 的讨论则围绕一次旗舰发布集中起来,并进一步深入到成本、存储与部署约束。
1.2 Grok 4.7 传播很快,但引发的是按价格校正后的工程能力之争,而不是一次明确的前沿胜出 🡕
Grok 4.7 的提及量从 2026-09-20 的 1 条帖子跃升至 2026-09-21 的 21 条。关注度确实存在,但整体语气是复杂的:人们喜欢更低的价格和部分基准胜利,同时也立刻质疑这些基准的来源、任务适配性,以及这款新模型是否真的改善了长时运行的工程工作。
@cb_doge 声称(259 个赞、45 条回复、17,697 次浏览)称 Grok 4.7 在 GDPval 和 AA Briefcase 上击败了 GPT-6 Astra,并配图显示其在专业知识工作和多小时办公室工作上的得分分别为 1,695 对 1,542,以及 1,657 对 1,569。这场讨论最有辨识度的部分出现在回复区:人们马上追问样本量、任务组合、各次运行是否相互独立,以及把成本和重试率算进去之后结果会怎样。
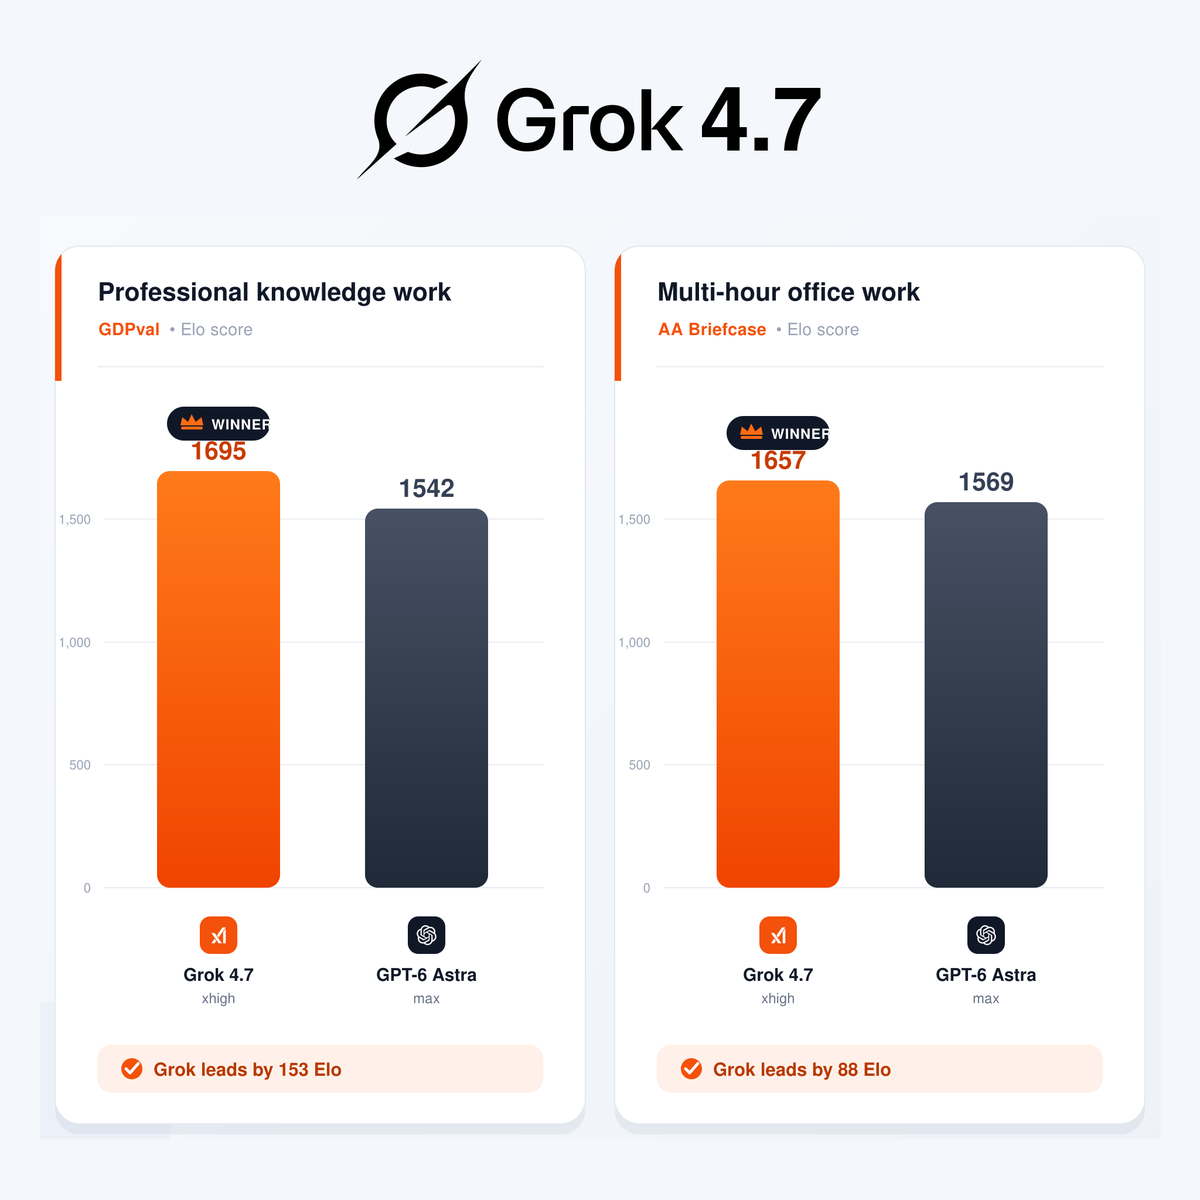
@cognition 将其整合进了 Devin(93 个赞、11 条回复、6,908 次浏览)也在同一天发帖,报告其 FrontierCode 1.1 Extended 得分为 59.4%,并称该模型在高难度后端工程任务上表现非常好。更重要的是,Cognition 自己在后续回复中表示,Grok 4.7 的总体表现仍落后于 Grok 4.6,因为它会把部分任务范围扩得过大。这也让该帖子成为当天最鲜明的例子之一:工具厂商拒绝对一个吸睛的新发布过度吹捧。

@ChrisGPT 总结(29 个赞、9 条回复、5,184 次浏览)以许多小团队开发者都关心的方式呈现了这种权衡:Grok 4.7 的输入/输出 token 定价为每百万 $2 / $6,远低于 GPT-5.6 Sol Max 和 Fable 5.1 Max,同时 DeepSWE 仍拿到 71.0 分。同一组对比也解释了为什么这波庆祝始终带着保留——Terminal Bench 4.0 仍明显落后于 Fable 5.1 Max,因此这款模型对某些工程工作负载很有吸引力,但还没有补齐所有差距。
 讨论洞察: 信息流并没有把 Grok 4.7 视为靠单一数字登顶前沿的“加冕时刻”,而是把它当作一个路由问题:新的价格/性能边界究竟在哪些场景里真的更优,又在哪些场景里会因为范围铺得过大和终端任务能力偏弱而抵消节省下来的成本?
与前一天对比: 相比 2026-09-20 几乎不存在的 Grok 4.7 讨论,2026-09-21 已把它变成一场全栈式辩论,涵盖基准测试截图、实时编程工具集成,以及明确列出的价格表。
1.3 生成与控制继续分化到不同层级 🡕
另一条强势主线更偏向架构,而不是具体某个模型。大约 38 条围绕 Jev/分类器/控制层的帖子,以及远超 100 条基准测试/评估帖子,反复围绕同一个观点:在需要时让大模型负责生成,但把路由、评分、验证和 harness 改进剥离到更便宜或更易验证的层级。
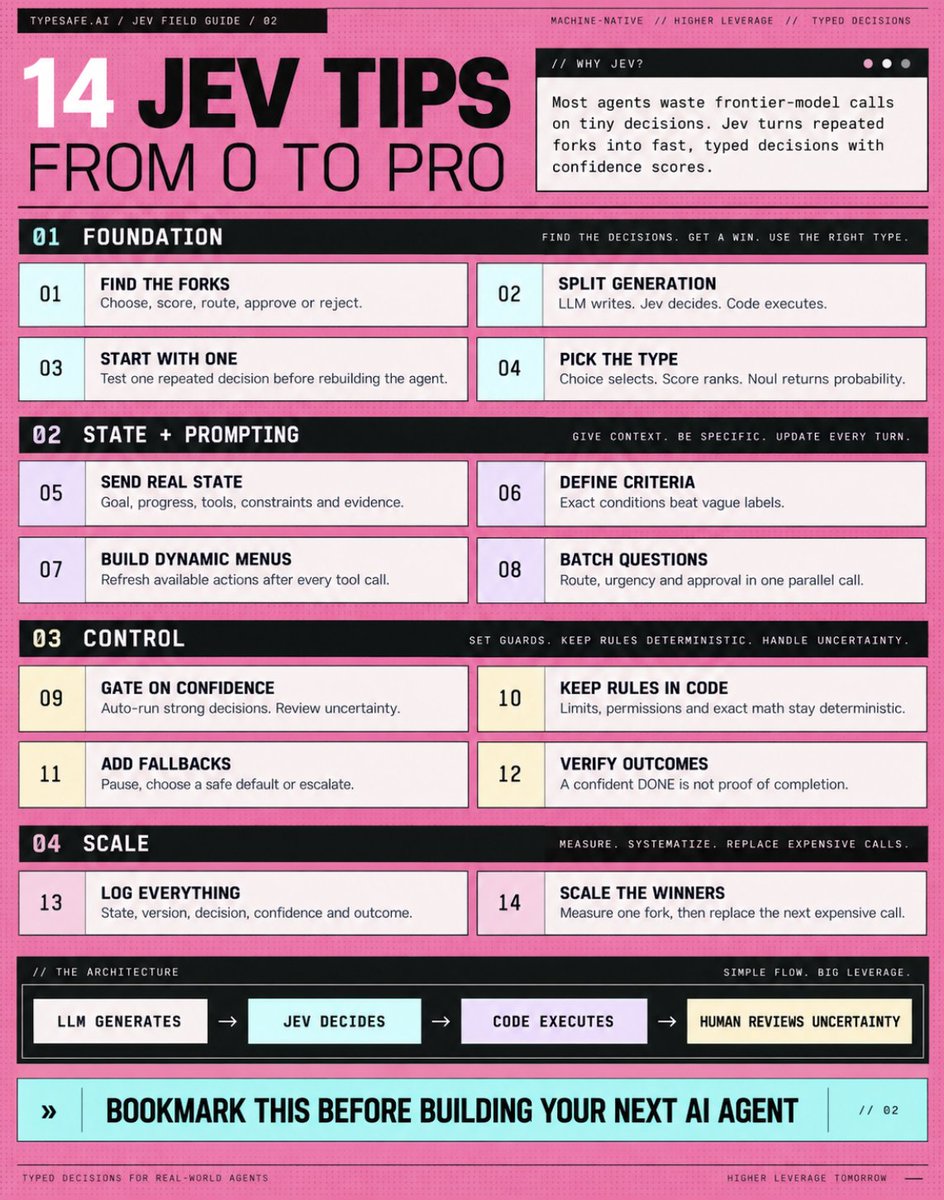
@ClementDelangue 认为(84 个赞、13 条回复、6,554 次浏览、19 个收藏)认为,对于现实世界中的大量 AI 场景,前沿 LLM API 是大材小用:既慢、又贵,还难以控制;该帖引用了一条 Jev 讨论串,称零样本分类是一个值得重新捞起的老思路。@0xwhrrari 明确说明了架构(25 个赞、8 条回复、524 次浏览、21 个收藏)则指出,路由、评分和验证会成为快速决策层,而生成留在别处。
@0xClodex 把它整理成了一套操作手册(8 个赞、1 条回复、216 次浏览、10 个收藏)列出了一份检查清单,涵盖动态菜单、置信度闸门、回退阶梯,以及一条原则:确定性的限制和权限应留在代码里,而不是交给模型。那张图之所以有用,是因为它用一行字展示了这种正在成形的分工:“LLM 生成 → Jev 决策 → 代码执行 → 人类复核不确定项。”
@whitecircle 推出(171 个赞、66 条回复、15,372 次浏览、120 个收藏)则把 Halo 视为同一种思路在技术栈中更底一层的应用:这是一个原生兼容 Hugging Face 的后训练框架,支持异步 RL,以及专家并行、上下文并行和张量并行;其宣称在不放弃标准 checkpoint 格式的前提下,吞吐量最高可达原版 TRL 的 2.8 倍。@dair_ai 重点提到(52 个赞、14 条回复、3,731 次浏览、37 个收藏)提到用于 harness 改进的 ModularRSI,而公开的 仓库 表示,该方法会分别演化五个 harness 模块,并在与基准测试不重叠的演化池上,将 Terminal-Bench 2.0 的准确率从 47.57% 提升到 52.43%。

@OfficialLoganK 直白地说出了管理层版本(37 个赞、8 条回复、2,365 次浏览)指出:如果你在用 AI 做构建,就应该把超过 25% 的时间花在基准测试上,也花在让各家实验室重视这些基准上。这句话很契合整条主线:人们依然想要更大的模型,但信息密度更高的讨论正越来越多地转向类型明确的决策、可复现的评估,以及 harness 行为。
讨论洞察: 真正有意思的变化并不是“智能体火了”,而是社区不断为哪些地方可以容忍不确定性、哪些地方不可以划出边界:规则留在代码里、按置信度设闸、验证结果、给 harness 做版本管理,并在反复分叉的环节使用更便宜的模型。
与前一天对比: 在 2026-09-20,围绕 Jev 的讨论还主要集中在决策原生模型应当放在什么位置;到了 2026-09-21,话题已经扩展到具体的训练框架、harness 自我改进方法,以及明确的基准测试预算。
1.4 Physical-AI 帖子继续聚焦数据引擎、低成本采集和可信赖的世界状态 API 🡒
Physical-AI/数据引擎讨论与前一天相比几乎持平,2026-09-21 大约有 25 条相关帖子,2026-09-20 则是 24 条。不同之处在于,保留下来的帖子里,更多内容开始具体讨论采集接口、验证闭环和 API 形态,而不是泛泛而谈“更多数据”。@itsbac0201 认为(12 个赞,9 条回复)称,Axis Robotics 很有意思,因为它让任何人都能在浏览器中远程操控模拟机器人,并将这些操控会话转化为经过质量校验的轨迹。8 月的数据为:注册用户超 20 万、轨迹超 470 万条、13 种机器人形态,以及 Sim Dataset V1 下载超 16 万次。公开的 AXIS 项目页面 则把这套流程展示得更具体:浏览器端远程操控会进入后端验证、平滑、增强和 VLA 训练,基于一个包含 207 项任务、5 万多条轨迹的数据集。
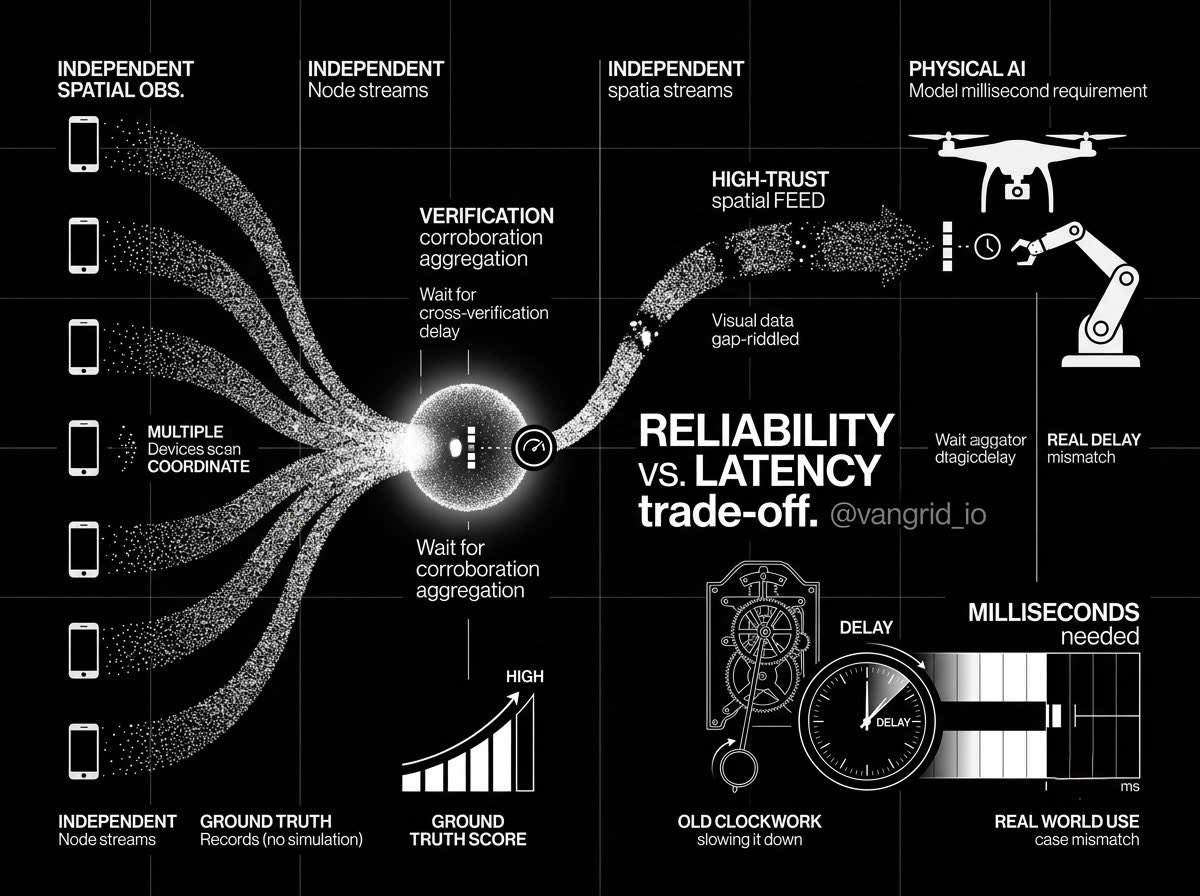
@HuuHoang88 直接提出了低成本采集的论点(22 个赞,24 条回复,205 次浏览)称,空间数据之所以昂贵,是因为它往往需要专用传感器和成规模设备部署,而 Vangrid 的赌注是:传感器其实已经在你的口袋里。公开的 API 概览 也显示,同一套系统正以早期访问产品的形式提供空间查询、数据摄取和实时真值流。
@KaiBGR 补充了最棘手的保留意见(14 个赞,16 条回复,1,206 次浏览)称,Vangrid 的验证设计确实在可信度与速度之间制造了取舍:多次独立扫描和相互印证会提升置信度,但也会带来延迟,而这恰恰发生在无人机和机器人希望得到毫秒级响应的场景中。这种取舍在所附图示中最容易理解。
讨论洞察: 分歧已不再是物理 AI 是否需要更好的数据,而是什么样的数据管道能经得起机器人需求的检验:采集成本要足够低、可查询性要足够强以便集成,而且速度还要足够快,不能让建立信任的过程把信号本身拖到失去价值。
与前一天对比: 相比 2026-09-20 类似的“数据优先”叙事,2026-09-21 提供了更多关于浏览器远程操控的具体数字,也更清楚地提出了实时空间数据流中“延迟 vs 验证”的论点。
2. 让人挫败的是什么
基准测试赢了,依然过不了工作流和损益表这两关
最尖锐的挫败感在于,那些漂亮的图表依旧回答不了实际运营问题。@MatznerJon 提问(26 个赞,9 条回复,4,432 次浏览)追问,任何一个光鲜的新模型、智能体技术栈或记忆系统,是否真的能提升瓶颈环节的贡献毛利,或提升非瓶颈环节任务的按时完成率;@OfficialLoganK 表示(37 个赞,8 条回复,2,365 次浏览)认为,团队不该把超过 25% 的时间花在构建基准测试,以及试图让实验室重视这些测试上;@DataChaz 提升了(22 个赞,1 条回复,1,178 次浏览)则提到 Codos 的一个判断:AI 在基准测试上大杀四方,但企业仍难以看到对损益表的实际影响。即便是对 Grok 4.7 的正面讨论,也撞上了同一堵墙:@cognition 表示 该模型在高难度后端工作上可能很强,但总体仍落后于 Grok 4.6,因为它会把某些任务的范围铺得过大。
严重程度:高。各团队正在通过定制评测、工具集成型基准测试和工作流层面的成功指标来应对,但外界一再要求看到立足业务结果的证据,这清楚表明这里值得投入建设。
用通用 LLM 调用来处理细小决策,成本仍然过高
第二个挫败点是成本错配。@ClementDelangue 认为(84 个赞,13 条回复,6,554 次浏览,19 次收藏)称,对于许多现实世界的用例来说,前沿 LLM API 既大材小用、又慢、又贵,而且难以控制,而 @0xwhrrari 描述了(25 个赞、8 条回复、524 次浏览、21 次收藏)将 Jev 视为路由、评分与验证所缺失的决策层。@0xClodex 详细说明了(8 个赞、1 条回复、216 次浏览、10 次收藏)则展示了这种应对模式:动态菜单、置信度门控、回退阶梯,以及保留在确定性代码中的硬规则,而不是一次次为文本生成买单。
严重程度:高。这种权宜模式已经足够稳定,几乎像是一个产品类别:生成仍由更大的模型负责,而反复出现的是/否判断或排序分叉则被下推到更便宜的类型化决策系统。
一旦团队超出原型阶段,训练与 harness 工具仍会碎裂
信息流也显示,早期实验与严肃的后训练之间,始终存在一道顽固的工具断层。@whitecircle 推出(171 个赞、66 条回复、15,372 次浏览、120 次收藏)正是围绕这一痛点推出 Halo,承诺提供 Hugging Face 原生的分布式训练,并声称在不强迫团队迁移到新 checkpoint 格式的前提下,实现 2.3-2.8 倍于原生 TRL 的吞吐量。@dair_ai 披露了(52 个赞、14 条回复、3,731 次浏览、37 次收藏)则指出了更高一层的同类脆弱性:之所以需要 ModularRSI,是因为对单体式 harness 的改动很容易滑向“为基准而拟合”,而不是形成可复用的改进;回复也立刻要求提供版本化 trace、干净的回滚,以及更好的模块边界处理。
严重程度:中高。构建者正在用 HF 原生并行、模块化 harness 和更多验证关卡来应对,但围绕这些主题出现的大量基础设施工作表明,从原型走向规模化依然痛苦,而且工具支持不足。
物理 AI 数据依然采集昂贵,建立信任的速度也比机器人所需更慢
物理 AI 领域的发帖者不断以不同形式描述同一个上游瓶颈。@itsbac0201 表示(12 个赞、9 条回复)称,Axis 试图通过浏览器遥操作和经过质量检查的上传来扩大操作数据规模;@HuuHoang88 认为(22 个赞、24 条回复、205 次浏览)称,Vangrid 通过把手机当作传感器来降低采集成本;@KaiBGR 警告(14 个赞、16 条回复、1,206 次浏览)则指出,高信任度验证恰恰会在自主系统希望获得毫秒级反馈的环节引入延迟。
严重程度:中高。应对策略是把数据采集转移到大众设备和浏览器上,再在后续补上验证与过滤;但这依然留下了一个尚未解决的“信任 vs. 延迟”权衡,看起来值得围绕它构建产品。
3. 人们希望出现什么
以工作流为锚点、让模型实验室无法忽视的评估
最明确的需求,是能用运营语言而不只是排行榜语言来表达的评估系统。@OfficialLoganK 表示(37 个赞、8 条回复、2,365 次浏览)认为,公司应该把四分之一的时间花在基准测试上,并让模型实验室重视这些测试;@MatznerJon 提问(26 个赞、9 条回复、4,432 次浏览)则追问,任何新的 AI 技术是否会改变贡献毛利,或提升任务按时完成率。@DataChaz 指出(22 个赞、1 条回复、1,178 次浏览)之所以指向 Codos,恰恰是因为基准榜单上的胜利对企业来说远远不够。现实紧迫性很高,Devin 的 FrontierCode 和 Codos 式工作流度量等产品已经给出部分答案,但信息流仍把这一缺口视为明显未被满足的机会。机会:直接。
带日志、置信度和安全回退的类型化决策层
人们希望从 Jev 式系统中得到的,并不是泛泛的“更聪明的智能体”。他们想要的是一个能够路由、评分、批准或拒绝的决策层,能明确给出置信度,同时让所有高风险或确定性规则继续以可审查的代码形式存在。@0xwhrrari 阐述(25 个赞、8 条回复、524 次浏览、21 次收藏)谈的是这种架构,@0xClodex 列出(8 个赞、1 条回复、216 次浏览、10 次收藏)谈的是其运行规则,以及 @ClementDelangue 认为(84 个赞、13 条回复、6,554 次浏览、19 个书签)指出,许多生产环境用例根本不需要完整的 LLM API。这是一个有现实需求、且面临即时 ROI 压力的问题,而不是停留在愿景层面的想法。机会:直接。
保留标准模型格式的后训练与 harness 工具
Halo 和 ModularRSI 相关讨论指向了一个更技术化、但也非常具体的需求:团队想要扩展工具,但不希望因此被迫重写模型、丢失标准 checkpoint,或把真正的 harness 改进与迎合基准测试的优化混为一谈。@whitecircle 定位为(171 个赞、66 条回复、15,372 次浏览、120 个书签)将 Halo 视为连接基础版 TRL 与更重型基础设施的桥梁,而 @dair_ai 强调(52 个赞、14 条回复、3,731 次浏览、37 个书签)提到 ModularRSI,是因为可复用的 harness 收益仍然很难被单独识别。这个需求很实际,但买方会是已经具备一定基础设施成熟度的技术团队。机会:竞争性。
具备可调信任度与延迟的可查询空间真值
Physical-AI 领域的发帖者实际上是在寻求一种世界状态 API:采集便宜、便于查询,而且对机器人来说足够快。@HuuHoang88 想要(22 个赞、24 条回复、205 次浏览)主张用普通设备采集,而不是依赖昂贵的采集车队;@KaiBGR 想要(14 个赞、16 条回复、1,206 次浏览)强调验证不能带来难以承受的延迟;@itsbac0201 强调(12 个赞、9 条回复)则把浏览器远程操控视为当前的权宜之计。Vangrid 和 AXIS 目前都在一定程度上满足了这一需求,但两者看起来仍更像早期基础设施,而非成熟的默认方案。机会:竞争性。
4. 正在使用的工具与方法
| 工具 | 类别 | 评价 | 优势 | 局限 |
|---|---|---|---|---|
| MiMo-V2.6 Pro | 全模态开源模型 | (+) | AA 指数 46,在 DeepSWE/AutomationBench 上表现强劲,提供开放 RL 资产,成本前沿优势明显 | 仓库体量达 573 GB 级别,在 ProgramBench、Toolathlon 和 Terminal Bench 4.0 等部分项目上仍落后于前沿对手 |
| MiMo-V2.6 Flash | 全模态开源模型 | (+) | 15B 活跃参数、1M 上下文、成本更低,在多项智能体任务上与 Pro 差距不大 | 磁盘占用仍约 178 GB,在多项基准测试中落后于 Pro 和部分闭源模型 |
| Grok 4.7 | 前沿模型 | (+/-) | 价格低于 GPT-5.6 Sol Max 和 Fable 5.1 Max,在 DeepSWE 和办公任务方面有较强宣称,并已接入 Devin | 与厂商相关的基准测试结果引发质疑,在部分工程任务上存在范围失控问题,Terminal Bench 4.0 这一项较弱 |
| Jev | 决策 / 分类模型 | (+) | 支持类型化路由、评分和验证;提供置信度分数;重复决策成本更低 | 需要明确标准和日志记录,不能替代文本生成,还会增加组合复杂度 |
| Halo | 训练框架 | (+) | 原生兼容 Hugging Face 的分布式训练、异步 RL,沿用相同 checkpoint 格式;宣称较基础版 TRL 提升 2.3-2.8x | 相比基础原型工具,需要更强的 GPU 资源和基础设施成熟度 |
| TRL | 训练框架 | (+/-) | 适合小规模或早期实验,是团队熟悉的 Hugging Face 起点 | 在更大规模或 MoE 后训练中存在吞吐和内存上限,往往迫使团队后续切换技术栈 |
| Codos | 工作流自动化平台 | (+/-) | 通过 AI 访谈映射真实工作,把落地与可度量的工作流结果绑定,并让公司上下文持续参与其中 | 部署模式高度依赖服务,每个客户都要承担较重的深度集成负担 |
| AXIS | 机器人数据引擎 | (+) | 支持浏览器远程操控、质量优化、数据增强、固定评估快照,且操作数据集持续增长 | 从仿真到现实的迁移,以及后端数据整理,仍是主要负担 |
| Vangrid Enterprise Spatial API | 空间数据 API | (+/-) | 支持对实时真值观测进行查询、接入和流式传输,并可通过普通设备采集 | 产品仍处于早期访问阶段,验证延迟可能与毫秒级机器人场景的需求冲突 |
整体评价因层而异。MiMo 和部分 Grok 帖子之所以受到称赞,是因为它们推动了成本性能前沿,而不只是刷出一个漂亮数字;Jev 的吸引力在于它划出了一个更便宜的决策层,但严肃讨论几乎都会立刻给它套上置信度阈值、日志和硬编码规则;Halo 和 ModularRSI 之所以被看重,则是因为它们减少了重写成本,也让 harness 行为更容易被理解。迁移模式是按任务类别路由:对重复、成本敏感的步骤,采用开放权重模型或类型化决策系统;对更难的生成任务或仍未解决的情况,采用更大的前沿模型;再用自定义基准来决定这条分界线应落在哪里。
5. 人们正在构建的项目
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| MiMo-V2.6 Pro / Flash | @XiaomiMiMo | 面向编程、智能体、3D、研究和计算机操作的开源全模态推理模型 | 缩小开放权重模型在长时程多模态任务中的能力 / 成本差距 | 稀疏 MoE、规模化 RL、多模态 IO、工具使用、1M 上下文 | 已发布 | 推文、发布 |
| Halo | @whitecircle | 原生兼容 Hugging Face 的分布式框架,覆盖从预训练到异步 RL | 避免仅为扩展后训练就重写整个模型家族 | PyTorch、FSDP2、DTensor、DeepEP、FlashAttention、Liger、Ray、vLLM/SGLang | 已发布 | 推文、仓库 |
| ModularRSI | IQuestLab | 面向长时程智能体的模块化 harness 自我改进框架 | 将可复用的 harness 收益与基准拟合及一次性提示词技巧区分开来 | 五个 harness 模块、与基准测试隔离的演化池、对比式轨迹分析、验证门 | Alpha | 推文、仓库、论文 |
| Codos | Codos | 虚拟 Chief AI Officer 平台,映射工作并围绕 AI 重建工作流 | 将基准测试层面的讨论转化为可量化的产能、速度或收入变化 | AI 访谈、公司上下文图谱、嵌入式工程师、工作流应用 | 已发布 | 引述, |
| --- | --- | --- | --- | --- | --- | --- |
| OpenClaw | OpenClaw | 可自托管的助手,可在聊天应用和后台任务之间持续工作 | 即使合上笔记本,智能体也能继续运行,并通过 WhatsApp 或类似渠道执行操作 | Node.js、浏览器控制、Shell 访问、持久化记忆、插件 | 已发布 | 推文、仓库 |
| phantom-kv | @lordx64 | 用于可逆移除拒答的可加载 KV 缓存嫁接层 | 无需永久修改 checkpoint,也无需重新加载模型,即可改变模型行为 | Python、PyTorch、Transformers、逐层 KV 张量 | Alpha | 推文、仓库 |
| AXIS data engine | Axis Robotics | 浏览器遥操作流水线,外加操作数据集与基准 | 无需专用硬件或在本地安装模拟器,即可扩大机器人数据采集规模 | MuJoCo-WASM、后端验证、平滑处理、数据增强、VLA 训练 | Beta | 推文、网站 |
| Vangrid Enterprise Spatial API | Vangrid | 用于空间查询、数据摄取和实时真值流的 API | 为物理 AI 系统提供当前的现实世界状态,而不是静态地图或纯模拟环境 | 边缘采集、验证流水线、REST + 流式传输 | Beta | 推文、API 文档 |
在信息流的软件侧发布中,MiMo 和 Halo 是最清晰的基础设施型上线。MiMo 以足够强的能力与价格压力,把开放模型供给进一步往外推,迫使市场将其与前沿 API 进行实时对比;Halo 则直击从 Hugging Face 原型走向严肃后训练这一路径上的运营成本。
ModularRSI 和 phantom-kv 展示了另一种开发者模式:人们不只是再推出一个聊天界面,而是在改造模型周边的控制底座。前者让测试 harness 的改进更模块化,也不再与基准测试强耦合;后者则让模型行为可以切换,而无需触碰基础权重。
Codos、OpenClaw、AXIS 和 Vangrid 都在解决模型本身之外的瓶颈:公司工作流映射、持久化执行、操作数据采集,以及实时空间真值。这些项目反复指向的触发因素,与报告其他部分的观察一致:确定性脚手架、经验证的状态,以及对工作流的度量,比再增加一次缺乏差异化的模型调用更重要。
6. 新动态与值得关注的项目
高效 LLM 设计正式成为课程主题
@aminkarbasi 宣布(63 个赞、4 条回复、5,685 次浏览、64 次收藏)斯坦福大学的 MS&E 319 课程《高效生成式语言模型》把计算预算、训练目标、模型架构和推理算法明确纳入同一份课程大纲。之所以重要,是因为它的主题列表几乎与当天的实时争论完全重合:MoE 设计、KV 缓存压缩、量化、推测解码、LoRA、RLHF、DPO 和蒸馏,都与 MiMo 和 Halo 一起被放进了同一讨论框架。
独立评估进入主流治理议程
@Yoshua_Bengio 欢迎(148 个赞、16 条回复、4,764 次浏览)呼吁强制开展部署前测试、独立评估、制定通用标准,并成立一个面向前沿 AI 的政府间组织。这一点之所以重要,是因为评估不仅是 2026-09-21 开发者讨论中的抱怨,也出现在信息流顶端,成为政策优先事项。
又一款巨型稀疏开放权重模型已经开始为本地部署争论预热
@TeksEdge 预览(29 个赞、3 条回复、1,775 次浏览、7 次收藏)将“Step 5”描述为一款拥有 600B 参数、27B 激活参数、1M 上下文的开放权重模型,预计于 10 月 15 日发布。值得注意的不只是这则预告,更是其背后的部署问题:如果 Kimi K3 级别的智能可以装进一个小得多的稀疏模型包里,那么本地硬件规划可能会从单纯关注总参数量,转向分层内存和激活参数效率。
7. 机会在哪里
** [+++] Workflow-grounded evaluation and routing control** — Evidence from sections 1-4 kept converging on the same gap: @MatznerJon 提问 适合围绕贡献利润率和任务按时完成率的证据展开,@OfficialLoganK 推进 则适合围绕基准测试预算展开,@cognition 展示 特定任务形态下,基准测试上的提升可能会消失;而 Jev 的帖子则一直在把低成本决策与高成本生成区分开来。这一点之所以有力,是因为这种需求同时出现在吐槽帖、工具发布,以及 Codos 这类已经落地的产品中。
[++] 原生适配 Hugging Face 的后训练与 harness 基础设施 —— Halo 和 ModularRSI 瞄准的是这样一块中间地带:团队已经超出标准 TRL 的适用范围,但又不想把整套东西从头重建。这个机会属于中等水平,因为痛点既尖锐又高度技术化,但买方群体比评估工具更窄,也更成熟。
[++] 在可信度与延迟之间可调的数据管线,用于物理世界数据 —— AXIS、Vangrid 及周边讨论都指向同一个缺失层:以可负担的成本完成采集,并提供足够的验证,让人能信任这条数据流,同时又不会慢到真实机器人来不及使用。这个机会属于中等水平,因为这个瓶颈真实存在且长期持续,但集成方式和商业化路径仍处于早期。
[+] 可热插拔的模型行为层 —— phantom-kv 展示了一种可逆的、按请求叠加能力的方案,而且不改写基础权重;Jev 风格的控制层则展示了另一种路径,即把行为放到主生成器之外。这一方向还谈不上成熟,但这种模式已经清晰到值得关注。
8. 要点
- MiMo,而不是泛泛的开源更新,才是当天模型领域的主要事件。 小米把接近前沿的智能体分数、开放的 RL 资产,以及封闭 API 的成本压力放在了一起,因此讨论很快就从发布热度转向了部署账本。 (源码)
- Grok 4.7 之所以受到关注,是因为按价格调整后的工程价值,而不是因为所有人都认定它成了新的、无可争议的前沿。 Cognition 自己的部署说明也提到,这个模型在高难度后端任务上表现很强,但一旦任务范围铺得过大,整体表现仍可能落后于 Grok 4.6。 (来源)
- 这条信息流越来越倾向于让智能体在不同层分别负责生成、决策和验证。 Jev 的帖子反复强调同一种拆分:LLM 负责创作,类型化决策系统负责路由和评分,确定性代码负责边界限制,人类负责处理不确定性。 (来源)
- 构建者的重心正从聊天表层下移到训练、harness 和工作流观测。 Halo、ModularRSI 和 Codos 针对的都是基础设施或操作模式问题,而不只是再做一个助手封装。 (来源)
- 物理 AI 看起来仍然更受数据约束,而不是模型约束。 AXIS 和 Vangrid 的案例关注的是浏览器遥操作、基于手机的数据采集、验证,以及实时世界状态数据流,而不是新的机器人硬件。 (来源)