Twitter AI - 2026-09-24
1. 大家在讨论什么
1.1 编码代理评测正更接近真实工作流 🡕
几十条非转推内容都涉及编码代理、评测设计或验证器质量,而且这一话题簇明显比 2026-09-23 更密集。真正重要的变化不在于总量,而在于讨论发生了质变:人们不再只是贴排行榜,而是一整天都在争论 token 预算、工具回退、记忆注入,以及公开基准是否真的像代理实际工作的环境。
@josevalim 提出疑问(101 次点赞、25 条回复、5,441 次浏览、67 次收藏)讨论的是:如果大多数代码都由编码代理编写,语言社区、易用性、编译器和工具会发生什么变化。其链接的 Dashbit 文章把这个问题进一步落到了具体的工具议程上:用程序数据库取代面向文档位置的 LSP,用运行时可观测性/查询接口取代供人逐步单步执行的调试器(文章)。
@ArtificialAnlys 报道(128 次点赞、19 条回复、7,188 次浏览)称,搭配 Opus 5.5 的 Claude Code 在 Coding Agent Index 上达到了 66 分,高于 Opus 5 的 60 分,但单任务成本也升至 $13.04,因为每个任务的 token 使用量增加到了约 1,560 万。附带图表之所以重要,是因为它同时展示了争论的两面:当天公开的编码代理最高分,以及分数—成本权衡曲线中成本更高的一端。

@DeepLearningAI 总结(34 次点赞、5 条回复、2,400 次浏览、26 次收藏)介绍了 Meta AI 对上下文退化的应对方式:将动作代理与独立的记忆代理配对,后者负责写入和检索简短提醒,而不是把整个上下文窗口越塞越大。链接文章补上了推文本身只是点到为止的硬数据:当记忆代理在合适时机注入提醒后,Claude Sonnet 4.5 在 Terminal-Bench 2.0 上从 37.6% 提升到 45.9%,在 τ2-Bench 上从 55.0% 提升到 61.8%。

@dair_ai 强调(14 次点赞、4 条回复、2,061 次浏览、14 次收藏)将 Salesforce 的 RIVER 论文解读为一个“验证器质量”的故事,而不是单纯“靠堆数据”的故事。链接摘要给出了少见的具体细节:接受审计的 TMax 环境中,只有 35.8% 是干净的,40.4% 存在验证器过弱的问题;而在一个随机抽样的 3.5K 环境样本上,River-8B 在四个终端基准上的平均分仍达到 19.4,高于 RL 的 17.7(论文摘要)。
讨论洞察: 最强烈的反驳同时来自两个方向。@pmddomingos 撰文(64 次点赞、11 条回复、2,545 次浏览)指出,AI 往往只是在少数几个基准上拿到高分、宣布胜利,却让大多数真实问题依旧悬而未决;随后 @morganlinton 报道(21 次点赞、13 条回复、1,701 次浏览)又展示了一种实时测量的失效模式:他的部分 Opus 5.5 评测套件被 Claude Code 的安全分类器拒绝,随后回退到 Opus 4.8。这让当天的讨论重心从“谁是 #1?”转向了“我们到底在测什么、是在什么预算下测,以及有哪些隐藏的工具行为在起作用?”
与前一天相比: 2026-09-23 的评测讨论主要集中在基准基础设施和长时程公开测试集上。到了 2026-09-24,讨论已经进入闭环内部:记忆注入、验证器审计、token 预算,以及那些可能在不知不觉中污染基准的运行时怪癖。
1.2 决策模型还在不断增多,但围绕验证器的争论更尖锐了 🡕
决策模型这一话题簇并没有比前一天明显变大,但竞争感更强,技术性也更高。讨论已经不再停留在解释 Jev,而是转向发布替代方案、为它们建立索引,并争论什么才算公平的验证器对比。
@jackyk02 推出(544 次点赞、22 条回复、32,316 次浏览、575 次收藏)介绍了 Contrastive Language Model,称其是一个快速版的 System One 发布:它将状态嵌入和动作嵌入分离,因此两者可以独立缓存。链接仓库补充了细节:冻结的 Qwen3-8B 编码器、2,000 万参数的 heads、用于预训练的 6,000 万组 Nemotron 问答对、3,000 万个合成 hard negatives、用于后训练的 100 万条代理轨迹,并声称当 CLM 用作验证器时,在 DeepSWE 上达到 81.6%,在 Terminal-Bench 2.1 上达到 87.6%(代码仓库)。@multimodalart 更新(45 个赞,8 条回复,4,358 次浏览,34 次收藏)Decision Index 从 0.1 更新到 0.2,采用了新公式,新增 29 个类 Jev 模型和 21 项基准测试,并将 AutoJev-27B 列为领先的开放模型。与其把这看作一次仅维持一天的排行榜更新,不如说,它表明小型类型化模型这一细分领域如今已有足够多的参与者,也有足够大的评测差异,因此需要专门的排名基础设施。
讨论观察: 这部分信息流已经不再宣称小型决策模型可以替代完整的 LLM。相反,讨论不断收敛到更窄的任务:对候选动作排序、进行工具路由、为 best-of-N 轨迹打分,以及在动作集合足够有界、缓存和校准变得重要时充当验证器。
与前一日对比: 在 2026-09-23,Jev 相关内容仍主要由速查表、演示和 computer-use 发布构成。到了 2026-09-24,焦点转向了围绕验证器速度、基准覆盖范围,以及整个类别索引层的直接竞争。
1.3 低成本可用性加上本地/开放权重性能,从抽象概念变成了具体数字 🡕
本地/开放权重这一簇的讨论规模仍小于 coding-agent 话题,但证据已经具体得多。人们不再泛泛而谈“本地 AI”,而是开始发布价格分层图、单任务成本表、Apple Silicon 运行时差异,以及消费级 GPU 上的长上下文运行结果。
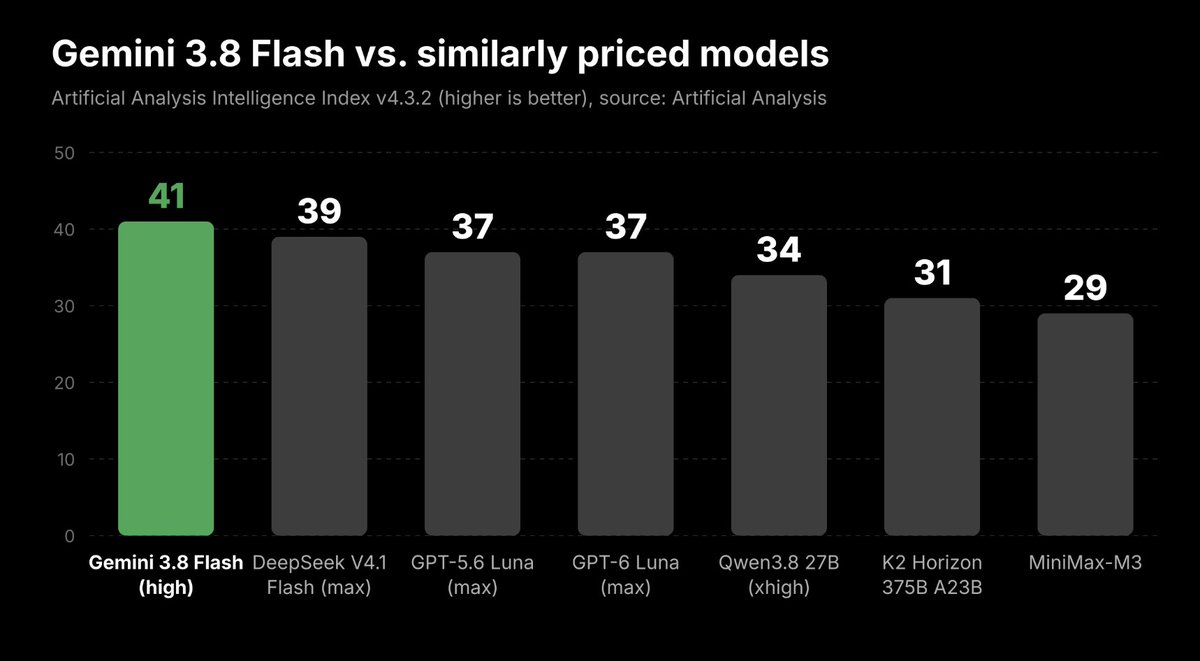
@cline 宣布(422 个赞,46 条回复,15,694 次浏览,83 次收藏)称 Gemini 3.8 Flash 在 Cline 中可免费使用,并用一张价格分层图为这一说法背书:它的 Intelligence Index 得分为 41,高于同价位的 DeepSeek V4.1 Flash、GPT-5.6 Luna 和 Qwen3.8 27B。该帖以运营指标来界定竞争:291 tok/s、1M 上下文,以及一款便宜到足以在开发者工具中广泛开放的模型。
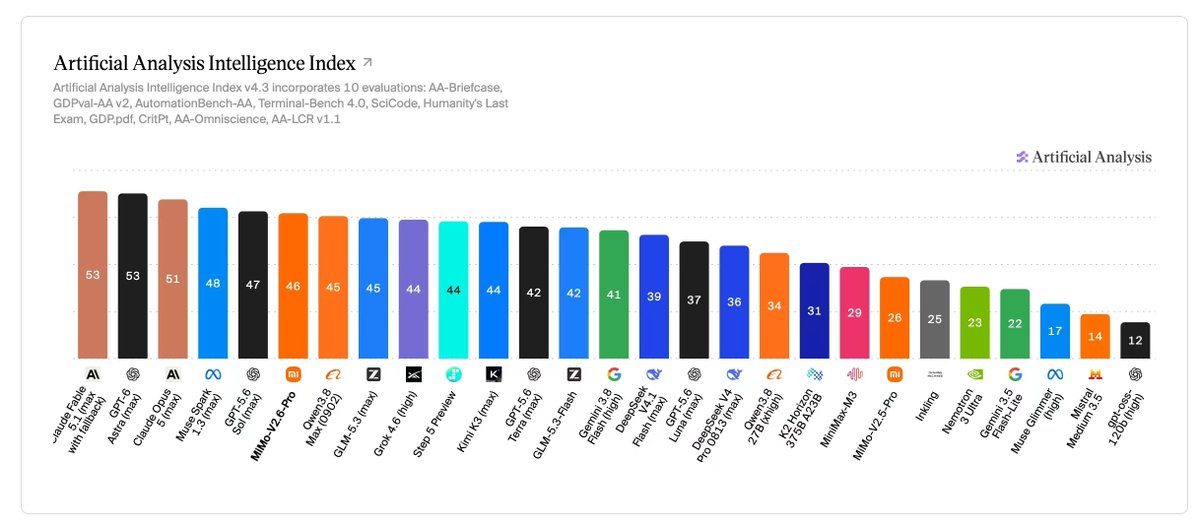
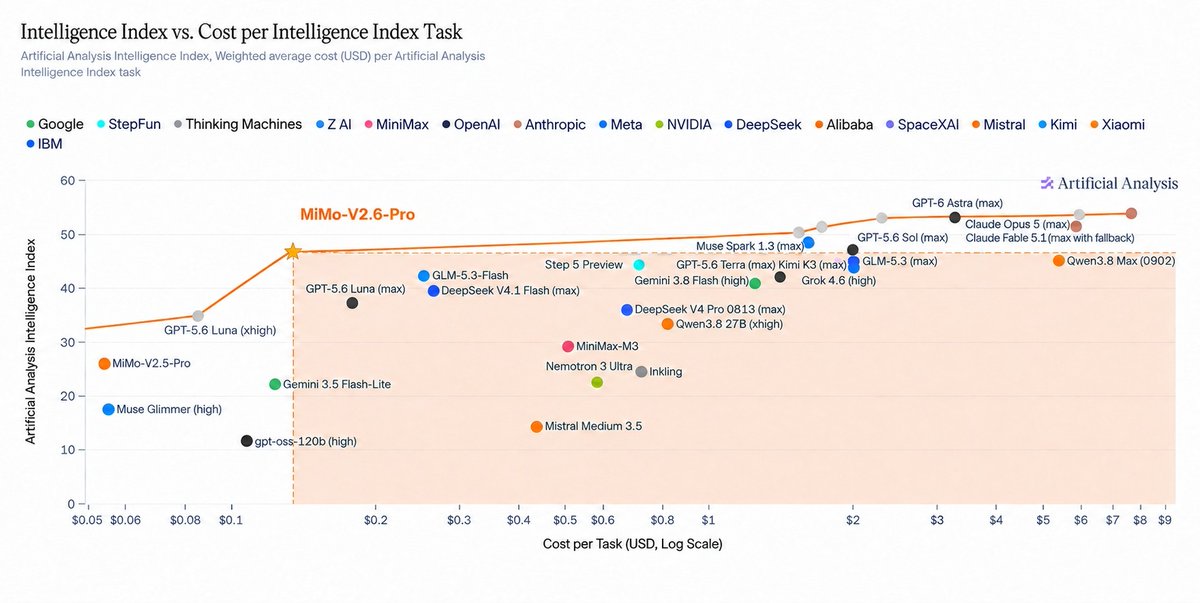
@FellMentKE 认为(140 个赞,16 条回复,53,856 次浏览,74 次收藏)称,小米的 MiMo V2.6 Pro 之所以重要,是因为它将 46 分的 Intelligence Index 与每任务加权 $0.13 的成本结合在一起。随帖附上的三张图让这一判断更直观:MiMo 在开放权重榜单中领跑,位于成本表接近底部的位置,并落在智能-成本帕累托前沿上,且靠近那些贵得多的前沿系统。

@jundotkim 发布(33 个赞,4 条回复,1,724 次浏览)发布了 oMLX 0.7.0rc1,并在公开发布说明中给出了精确的运行时改进:Qwen3.8-Flash-Next 在 M5 Max 上的 prefill 从 1,522 提升到 2,007 tok/s,Qwen3.8-27B DFlash 的 decode 从 56.9 提升到 131.5 tok/s,而一次 partial-block-caching 改动将某个下一轮 prefill 场景从 1,174 tokens 降到 37(发布说明)。在同一叙事中更低成本的一端,@Oluwaphilemon1 展示(4 个赞,1 条回复,724 次浏览,6 次收藏)展示了 MiMo-V2.6-Distill-Qwen-9B:在单张 12GB RTX 3060 上运行 262K 上下文窗口时,decode 约为 47 tok/s,prefill 约为 1,600 tok/s。
讨论观察: 信息流持续将本地和主权 AI 视为一个系统问题,而不再只是隐私口号:token 预算、缓存复用、量化,以及当你把更小的模型放进真实 agent 循环之后,它是否仍然有用。
与前一日对比: 在 2026-09-23,有关本地运行时的讨论还集中在打包好的技术栈和延迟案例研究。到了 2026-09-24,焦点已收紧到价格分层套利、开放权重帕累托图,以及消费级硬件和 Apple 硬件上的精确服务改进。
1.4 智能体电商的讨论从炫目的演示转向激励设计与支付通道 🡕
消费级电商这一簇仍然嘈杂,但讨论已经更具体地聚焦于:智能体究竟为谁工作、结账技术栈如何接通,以及自主交易出错时会发生什么。这让这一簇变得更有用,因为最难的问题不再是产品演示,而是信任、商户端基础设施,以及争议处理。@alex_verem 认为(24 个赞,11 条回复,3,112 次浏览)指出,如果 Meta 的 Muse 靠从每笔购买中抽成来维持免费,就会形成一种结构性的激励冲突。这篇帖子的核心观点并不是说这个产品不可能实现,而是说:一个掌握登录凭证、支付权限和商家连接的代理,可能会以用户难以审查的方式,朝着提高结账量的方向优化。
@HiCagr 描述(15 个赞,3 条回复,1,804 次浏览)把 Muse 描述为一个始终在线、按用户划分的 VM,运行无头浏览器、频繁的工具调用循环、独立的安全哨兵,以及覆盖 Gmail、Outlook、Plaid、OpenTable、Shopify、PayPal、Expedia 和 Instacart 的连接器。这让讨论下沉了一层:从光鲜的消费级 UX,转向一个真正“始终在线”的代理背后的运行时和基础设施负载。
@MiaRSato 反驳(9 个赞,4 条回复,417 次浏览)认为,购物、派对策划和旅行代理,只有在你本来就不喜欢这些活动时才有意义。她在回复中进一步把这一点 sharpen 成了一个“品味问题”:对于偏好不强的任务,普通推荐也许足够;但对于那些高度依赖风格判断、且用户本身享受搜索过程的决策,这类代理并不适合。
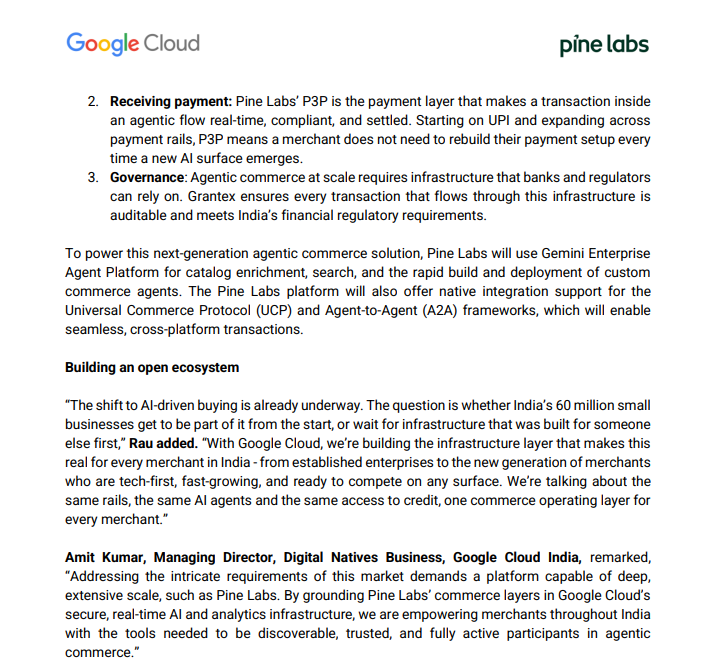
@DhawalDoshi5 将其定义为(13 个赞,1 条回复,684 次浏览)将 Pine Labs × Google Cloud 定位为面向 agentic commerce 的商家基础设施,而不是另一个店面助手。附带的截图让这一论点更加具体:它把可发现性、支付和治理列为三大障碍,并将其对应到 Gemini Enterprise agents、Pine Labs 的 P3P 支付层、Jarvis,以及 UCP/A2A 支持。

讨论洞察: 对“代理如何安全地购物?”这一问题,最具可操作性的答案来自基础设施类帖子,而不是面向消费者的演示。@d3rekson 描述(23 个赞,10 条回复,433 次浏览)提到一种互联网法院流程:纠纷会预先选定处理路径,证据会自动归档打包,并由三个不同的 AI 法官而不是单一模型来处理。
与前一天的对比: 在 2026-09-23,信息流已经开始关注购买按钮和权限边界。到 2026-09-24,焦点则更明确地转向收费激励、商家底层基础设施和纠纷解决。
2. 什么让人沮丧
基准测试一遇到真实工作流,还是会失灵
最突出的挫败感并不是“基准测试毫无用处”,而是它们作为运营决策工具时,仍然太频繁地失效。@pmddomingos 表示(64 个赞,11 条回复,2,545 次浏览)指出,这个领域总是在少数几个基准上拿高分后就继续往前推进,而真正的问题仍未解决;@ArtificialAnlys 显示(128 个赞,19 条回复,7,188 次浏览)指出,当天得分最高的 coding-agent,同时也是单任务成本最高的;@morganlinton 遇到(21 个赞,13 条回复,1,701 次浏览)则记录了一次实时测量失效:由于 Claude Code 的安全分类器,Opus 5.5 套件中的一部分回退到了 Opus 4.8。RIVER 审计给出了这种情况反复发生的结构性原因:@dair_ai 报道 指出,在经审计、最干净的公共环境池中,真正干净的实际上只有 35.8%。
严重性:高。当前可见的变通办法包括私有基准套件、更干净的验证器审计、同预算对比,以及更多面向工作流的评测资助,例如 @mercor 宣布(15 个赞,2 条回复,1,097 次浏览,8 次收藏)。这值得投入建设,因为社区已经不再要求一个更好看的排行榜;它要的是在真实工具链条件下也值得信赖的衡量方式。
长周期代理仍会被记忆、阈值和护栏绊倒
第二个挫败点是,代理往往不是先败在底层推理上,而是先败在控制平面上。@DeepLearningAI 总结(34 个赞,5 条回复,2,400 次浏览,26 次收藏)提到 Meta 的发现:长上下文会让代理忘记早先的错误;而 @sakevoid 撰文(9 个赞,8 条回复,551 次浏览)提到,一个 Claude Code 安全钩子拦下了 27 条危险命令中的 26 条,并且在 239 个提示注入案例中保持稳定,但“模型是稳定的,阈值不是。” @HiCagr 补充说(15 个赞,3 条回复,1,804 次浏览)则展示了同一问题在运行时的版本:每一次工具循环都会拉长上下文、增加计算负载,并在代理真正行动前迫使系统执行更多安全检查。
严重性:高。当前的变通办法包括独立的记忆代理、更收窄的提醒注入、显式审批钩子,以及更可追踪的凭证,用来说明某段记忆或某个护栏实际看到了什么。这仍然值得投入建设,因为这种痛点同时出现在编码代理、消费者代理和评测框架中。
商业代理仍然存在对齐与治理问题
第三个挫败点是,自主购买流程仍然无法令人信服地回答“这个代理究竟在为谁服务?”这个问题。@alex_verem 认为(24 个赞,11 条回复,3,112 次浏览)指出,由交易手续费资助的购买代理在经济激励上是与商家对齐的,而未必与买家对齐;@MiaRSato 认为(9 个赞,4 条回复,417 次浏览)指出,一些以购物和旅行为展示重点的用例,实际上只对那些并不太在意底层选择的用户有帮助;而 @d3rekson 描述(23 个赞,10 条回复,433 次浏览)则指出,需要整整一层争议解决机制,因为机器人之间的商业交易无法在低价值交易中依赖普通的人类法院。
严重性:中高。当前的变通办法,是围绕交易本身加入更明确的治理机制,这也是为什么 @DhawalDoshi5 居中 Pine Labs × Google Cloud 讨论的是可发现性、支付和治理,而不只是又一个对话式界面。这值得投入建设,因为这些反对意见并不是反对代理本身;它们指出的是激励、可审计性和用户控制上的具体缺口。
3. 人们希望出现什么
团队真正能够信任的、以工作流为基础的评测与验证器
最明确的需求,是一种在真实技术栈、真实 token 预算和真实工作流混乱中依然站得住脚的评测。@dair_ai 浮现(14 个赞,4 条回复,2,061 次浏览,14 次收藏)提到,一次验证器审计发现大多数公开环境都有缺陷;@morganlinton 冲击(21 个赞,13 条回复,1,701 次浏览)提到,在对 Opus 5.5 做基准测试时遭遇了一次意外的 Claude Code 回退;而 @mercor 回应(15 个赞,2 条回复,1,097 次浏览,8 次收藏)则通过资助奖励校准、真实环境、长周期任务和模糊请求相关工作来回应这一点。这是一个现实需求,不是一个愿景式需求:团队已经拥有代理,但他们还没有自己完全信任的衡量方式。机会:明确。
原生面向代理的编程工具,能清晰暴露代码与运行时状态
@josevalim 推出(101 个赞,25 条回复,5,441 次浏览,67 次收藏)提出了最有力的论点:代理时代的工具链应当暴露程序数据库和运行时可观测性,而不是依赖 LSP 和面向人类的调试流程。关于记忆代理的帖子也从另一个角度指向了同样的方向:@DeepLearningAI 显示(34 次点赞、5 条回复、2,400 次浏览、26 次收藏)认为,提醒只有在恰当时刻介入才有帮助;而回复几乎立刻追问这些记忆的凭据、有效期和可追溯性。如今的 hooks、traces 和 agent 框架在一定程度上回应了这一需求,但信息流仍表明,控制面依然过于碎片化。机会:竞争性。
与买方利益一致,而不只是服务商家的交易轨道
关于商业的帖子反复指向同一个缺失层:agent 不仅要能购买,还应当具备可理解、可治理、可处理争议的能力。@alex_verem 担忧(24 次点赞、11 条回复、3,112 次浏览)谈到交易手续费激励,@d3rekson 描述(23 次点赞、10 条回复、433 次浏览)提到 bot-to-bot 争议解决这一缺失的信任层,@DhawalDoshi5 界定(13 次点赞、1 条回复、684 次浏览)则将可发现性、支付和治理视为彼此独立的基础设施问题。这是一项紧迫而现实的需求,因为构建者早已默认 agent 会参与交易;他们只是尚未就交易轨道达成共识。机会:直接。
保持低成本、又不至于难以运维的本地/开放权重技术栈
开放权重这一类讨论呈现出一种更低调、但非常真实的愿望:人们想要本地化或更便宜的技术栈,同时仍保有一流体验。@cline 强调(422 次点赞、46 条回复、15,694 次浏览、83 次收藏)提到免费访问,以及速度和上下文窗口,@jundotkim 聚焦(33 次点赞、4 条回复、1,724 次浏览)讨论了服务性能提升和缓存行为,而 @Oluwaphilemon1 对待(4 次点赞、1 条回复、724 次浏览、6 次收藏)之所以认为一次 12GB RTX 3060 运行很有意义,恰恰是因为它降低了硬件门槛。需求并不在于“再来一个模型”,而更多在于围绕人们已经想用的模型,提供更便宜的编排、缓存和部署控制面。机会:竞争性。
4. 在用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| CLM-8B | 决策模型 | (+/-) | 状态/动作缓存分离、类型化决策、在 DeepSWE 和 Terminal-Bench 2.1 上据报有很强的 verifier 结果 | 仍属早期发布,Jev 对比的公平性仍有争议,更广泛的独立验证有限 |
| Jev / Decision Index | 基准/索引层 | (+/-) | 为许多小型决策模型和使用场景提供了共享参考点 | 公式和基准覆盖范围仍在变化,而且其是否适合长时程 verifier 仍有争议 |
| Claude Opus 5.5 in Claude Code | 编码 agent 模型 | (+/-) | 当天公开的 coding agent 得分最高,并在三项评测中都有提升 | 单任务成本在对比中最高,token 消耗大,且部分测试套件触发了安全分类器回退 |
| Gemini 3.8 Flash in Cline | 编码模型 | (+) | 工具内免费使用、291 tok/s、1M 上下文、在价格档位上定位强势 | 证据更多集中在单一工具语境中,而非多个公开工作负载 |
| MiMo V2.6 Pro / Distill-Qwen-9B | 开放权重推理模型 | (+) | 智能-成本前沿表现强、多模态叙事清晰,并支持小 GPU 的实用实验 | 除了基准和本地运行相关说法之外,其在真实 agent loop 中的实用性仍在测试 |
| oMLX 0.7.0rc1 | 本地推理运行时 | (+) | 更快的 prefill/decode、部分块缓存,以及对 MiMo 多模态的新支持 | 仍是候选发布版本,且设置仍更偏向 Apple/MLX 用户 |
| RIVER | RL 训练方案 | (+) | 用更少环境提升 verifier 质量与泛化能力 | 依赖昂贵的环境审计和 oracle 过滤 |
| Claude Code safety hook | 护栏方法 | (+/-) | 在一个公开构建中,对危险命令拦截和 prompt injection 抵抗表现强 | 阈值调优脆弱,策略设计仍需手工完成 |
| Muse | 消费级 agent 运行时 | (+/-) | 连接器广泛、每用户专属运行时、支持后台任务执行 | 激励对齐、品味匹配和争议处理仍未解决 |
| Pine Labs P3P / Jarvis | 商业基础设施 | (+/-) | 将可发现性、支付和治理拆分为明确的商家轨道 | 仍处于合作阶段,集成负担重,尚未得到广泛验证 |
总体满意度的分化,更多是按层而不是按品牌展开。@ArtificialAnlys 报道(128 次点赞、19 条回复、7,188 次浏览)体现了前沿 coding agent 在分数/成本之间的明确权衡,而 @cline 营销(422 次点赞、46 条回复、15,694 次浏览、83 次收藏)则代表了便宜得多的访问层级。在开放权重一侧,@FellMentKE 使用 用图表让 MiMo 的经济性更易理解,而 @jundotkim 发布 则给出了精确的服务性能变化,而不是模糊的本地 AI 热情。
最常见的变通模式,是把各层拆开:困难任务使用更强但更贵的前沿编码模型,用更小的类型化模型做路由或验证,把更便宜/开放的模型用于本地实验,再额外挂上记忆 agent、安全 hooks 或商家治理轨道等控制面。最值得注意的竞争态势,不是某个模型取代另一个模型;而是运行时、评测 harness 和交易层在竞争,试图决定哪个模型会在什么场景下被使用。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| CLM-8B | @jackyk02 / Contrastive-LM | 用于类型化决策、排序和 verifier 选择的 System One 模型与 API | 让快速路由和验证的成本低于对每个有边界的决策都调用完整生成模型 | Qwen3-8B embedding backbones、contrastive heads、vLLM、兼容 TypeSafe 的 API | Alpha | 推文,代码库 |
| Decision Index 0.2 | @multimodalart | 面向类 Jev 决策模型的排名空间,覆盖尺寸、速度和使用场景 | 为分散的小模型细分赛道提供统一的比较层,方便构建者横向评估 | Hugging Face Space、基准聚合、model-index 公式 | Beta | 推文, Space |
| oMLX 0.7.0rc1 | @jundotkim | 本地推理运行时,提供更快的 Qwen/MiMo 服务和更高的缓存复用率 | 降低延迟和重复计算浪费,缓解本地/开放权重技术栈难以上手的问题 | MLX、Metal、DFlash、Lightning MTP、partial block caching、MiMo sidecars | Beta | 推文, 发布 |
| Pine Labs Jarvis / P3P | Pine Labs / Google Cloud | 面向商家的智能体商业平台,覆盖发现、支付和治理 | 让商家无需从零重建结账和合规体系,也能参与 AI 驱动的购买流程 | Gemini Enterprise Agent Platform、P3P payment rail、Jarvis 多智能体平台、UCP/A2A 支持 | Beta | 推文 |
| GPTZero 4o | GPTZeroAI / @alexcdot | 面向低误报、且对编辑和改写更稳健的 AI 检测模型 | 帮助学校及其他评估方区分人类写作与 AI 辅助或 AI 生成文本 | 检测模型,以及基于 DetectRL 和相关测试套件的第三方基准评估 | Shipped | 推文 |
| SmolDataEnvs | @adithya_s_k | 面向代码和数据科学的开放式 5K+ 可验证 RL 环境任务集 | 为小模型训练和评估循环提供公开来源的结构化、可核查任务 | 开源环境、评测集和训练数据 | Alpha | 推文 |
CLM、Decision Index 和 SmolDataEnvs 都指向同一种构建者模式:人们正在把围绕智能体的控制层和评估层产品化,而不只是做基础模型。CLM 把类型化路由和验证打包成产品,Decision Index 把类别级比较打包成产品,SmolDataEnvs 则把可用于训练或检验更小型智能体模型的开放任务打包成产品。
第二种构建模式,是把本地运行时优化本身做成产品切入面。oMLX 卖的不是新模型,而是更快的 prefill、更快的批量 decode,以及更好的缓存行为,让开放权重模型在本地硬件上真正变得可用。这与 MiMo-on-3060 实验,以及“工具内免费提供 Gemini”的产品定位,反映的是同一种压力:模型当然重要,但推理服务层正越来越决定它是否具备实用性。
Pine Labs 和 GPTZero 则是在扩展这幅图景,而不是与之相矛盾。Pine Labs 正在围绕智能体商业构建交易和治理通道,GPTZero 则在围绕 AI 写作输出构建检测层。在这两种情况下,产品都不只是模型响应本身,而是决定模型能否在生产环境中被信任的运营系统。
6. 新近动态与值得关注的消息
GPTZero 4o 把 AI 检测重新带回基准讨论
@alexcdot 发布(15 次点赞,3 条回复,510 次浏览)将 GPTZero 4o 描述为一款面向极低误报率调优的检测器,并声称在仍能以 98.4% 检出 Claude Fable 的同时,把人类文本被误标为 AI 的比例压到每 10,000 段不到 1 段。附带图表之所以重要,是因为它把这一说法拆分为总体平均、多领域、多 LLM、攻击场景和人类写作等多个维度,而不是只给出一个醒目的单一数字。

Mercor 把对基准测试的抱怨变成了一个有资金支持的项目
@mercor 宣布(15 次点赞,2 条回复,1,097 次浏览,8 次收藏)发布了一个 500 万美元的 AI Capabilities Fund,覆盖奖励校准、真实环境、长周期工作流、模糊请求以及业务/社会语境。它之所以值得关注,是因为它把信息流里反复出现的一类抱怨——“我们的评测并不能反映模型的实际使用方式”——直接转化成了明确的预算项,包含研究者时间、API 额度、差旅、Mercor 专家网络访问权限,以及其评测平台的使用权。
SmolDataEnvs 让小模型 RL 更像一件真正可构建的事
@adithya_s_k 发布(5 次点赞,1 条回复,160 次浏览)将 SmolDataEnvs 描述为面向代码和数据科学的 5K+ 可验证 RL 环境任务集,在环境、评测和训练层面全部开放。它之所以值得注意,与其说是因为传播范围,不如说是因为它契合了当天更广泛的转向:更小、更便宜、也更可验证的智能体循环。
7. 机会在哪里
[+++] 立足工作流的评测与验证器工具链 —— 这是当天最强的横截面信号。RIVER 的环境审计、Opus 5.5 的分数与成本权衡、Morgan Linton 提出的安全回退基准问题,以及 Mercor 的 500 万美元基金,都指向同一个缺口:团队需要与其实际部署的 harness、预算和工作流相匹配的评估体系。
[+++] 本地/开放权重运行时优化 —— Cline、MiMo、12GB RTX 3060 运行实验和 oMLX 都从不同角度让同一个机会变得清晰:市场想要更便宜的推理和更长的上下文,同时又不愿牺牲可用性。这里的产品切入面不只是模型权重本身,还包括路由、缓存、量化和服务易用性。[++] 面向 Agent 原生开发的可观测性与记忆控制 — Jose Valim 的文章、Meta 的 memory-agent 模式,以及 Claude Code 的 safety-hook 实验,都表明模型层之上仍存在一层缺口。更完善的程序数据库、运行时查询、记忆回执和护栏追踪,将有助于 Agent 调试、恢复,并保持可审计性。
[++] 面向商业 Agent、与用户利益对齐的交易基础设施 — Muse 关于激励机制的讨论、Pine Labs 对 discoverability/payment/governance 的明确拆分,以及 Internet Court 的争议解决层,都表明 Agent 商业不只需要结账自动化。真正的机会在于那些决定用户和商家是否愿意让 Agent 反复发起交易的信任基础设施。
[+] 面向 AI 生成内容的检测与溯源系统 — GPTZero 4o 表明,市场对这类分类器仍有需求:既要降低误报,又要在面对编辑和转述时保持稳健。不过,与上面的基础设施类目相比,这看起来是一个正在出现但更为狭窄的机会,因为它取决于还有哪些场景仍需要机器对作者归属和合规性作出判断。
8. 要点
- 评估的重心已从排行榜式的作秀转向是否适配工作流。 @ArtificialAnlys 报道(128 个赞,19 条回复,7,188 次浏览)指出,Opus 5.5 拿下了编程 Agent 的最高分,但单任务成本也最高;而 @dair_ai 报道(14 个赞,4 条回复,2,061 次浏览,14 次收藏)则指出,在经过审计、最干净的公共环境中,真正干净的其实只有 35.8%。
- 小型决策模型的定位,越来越由路由和验证器任务决定,而不是通用聊天表现。 @jackyk02 推出(544 个赞,22 条回复,32,316 次浏览,575 次收藏)将 CLM 描述为一种带缓存的状态/动作评分器,而 @multimodalart 更新(45 个赞,8 条回复,4,358 次浏览,34 次收藏)则围绕这一细分方向补上了索引层,新增 29 个 Jev-like 模型和 21 项基准。
- 开放权重和本地 AI 持续获得可信度,是因为相关数字开始变得具体。 @cline 显示(422 个赞,46 条回复,15,694 次浏览,83 次收藏)提到 Cline 中一个免费的高速价位模型,@FellMentKE 显示(140 个赞,16 条回复,53,856 次浏览,74 次收藏)提到 MiMo-V2.6-Pro 达到 46 分左右,且每项任务成本约为 $0.13,以及 @jundotkim 发布(33 次点赞、4 条回复、1,724 次浏览)精确量化了 oMLX serving 的收益。
- 长周期智能体的质量,如今在很大程度上取决于围绕模型构建的记忆层和护栏层。 @DeepLearningAI 报道(34 次点赞、5 条回复、2,400 次浏览、26 次收藏)显示,记忆智能体在 Terminal-Bench 2.0 上将成绩从 37.6% 提升到 45.9%;而 @sakevoid 报道(9 次点赞、8 条回复、551 次浏览)则表示,Claude Code 的一个安全钩子大体上发挥了作用,但其阈值仍未奏效。
- 关于智能体电商的讨论变得更严肃了,关注点转向激励机制和约束机制,而不再只是用户体验。 @alex_verem 提出(24 次点赞、11 条回复、3,112 次浏览)指出,交易手续费的经济模型可能会让购物智能体与买家的利益错位;而 @DhawalDoshi5 显示(13 次点赞、1 条回复、684 次浏览)则展示了 Pine Labs 如何将问题拆分为搜索发现、支付和治理,@d3rekson 新增(23 次点赞、10 条回复、433 次浏览)则在此基础上再加上一层纠纷解决机制。
- 开发者仍在持续推出围绕模型的基础设施,而不只是继续发布更多模型。 @mercor 资助(15 次点赞、2 条回复、1,097 次浏览、8 次收藏)提到了新的评测工作,@adithya_s_k 发布(5 次点赞、1 条回复、160 次浏览)提到了开放的 RL 环境,而 @alexcdot 发布(15 次点赞、3 条回复、510 次浏览)提到了一个新的检测模型。