Twitter AI - 2026-10-08
1. 大家在讨论什么
1.1 评测正从静态排行榜转向持续维护的系统(🡕)
在信息最密集、证据最充分的内容中,评测基础设施是最清晰的一组主题。至少有九条保留下来的内容都聚焦于如何让基准保持更新、难以被投机取巧,并且贴近真实工作:面向智能体的网页搜索评测、终端智能体 RL 环境、动态机器人基准、微基准测试、双盲评测、开放式任务的人工评审,以及裁判模型之间的分歧。反复出现的信息很明确:单一、冻结的排行榜已经不够用了。
@ExaAILabs 介绍了(61 次点赞,5 条回复,1,867 次浏览,13 次收藏)称,ATLAS 这个基准衡量的是智能体当下如何搜索,而不是旧式评测所假定的搜索方式。链接中的 ATLAS 解读文章 表示,74% 的任务要求找到 10 个或更多实体;完整发现并补全信息,中位数需要涉及 18 个不同域名;而搜索质量下降,对 ATLAS 分数的打击远比对 BrowseComp、WideSearch 或 DeepSearchQA 更明显。这让该基准的核心主张变得非常具体:如果搜索质量变差,分数就应该大幅下滑。

@Weyaxi 发布了(38 次点赞,3 条回复,1,760 次浏览,26 次收藏)介绍了 TermGrade,一个面向终端智能体的开放 RL 环境集合。这条推文及其线程给出的细节异常具体:1,000 个可执行环境、36,000 条轨迹、66,000 个生成的候选任务中只有 1.5% 通过验证,以及训练重点放在基础模型成功率约为一半的任务上。这不是一条泛泛而谈的“我们做了个基准”帖子,而是在强调其任务质量控制和奖励塑形上的纪律性。
@SnorkelAI 宣布了(20 次点赞,628 次浏览)称,Open Benchmarks Grants 正在扩展为 3000 万美元承诺,并新增基准红队和研究员项目。链接中的公告明确写出了它想要应对的失效模式:数据污染、失效的验证器、奖励黑客,以及安全、网络安全、物理 AI、长时运行智能体和开放式输出等领域中的基准陈旧化问题。
@Promzy__M 认为(24 次点赞,32 条回复,350 次浏览)称,一旦模型开始记忆固定的机器人基准,这些基准就不再反映真实情况。附带的 Open Axis 图片之所以重要,是因为它们展示的是一个实时运转的基准界面,而不只是口号;而链接中的 AXIS 网站 说明,该系统目前覆盖 207 个任务和 5 万多条轨迹,并通过留出集协议和基于浏览器的遥操作为数据引擎持续供数。
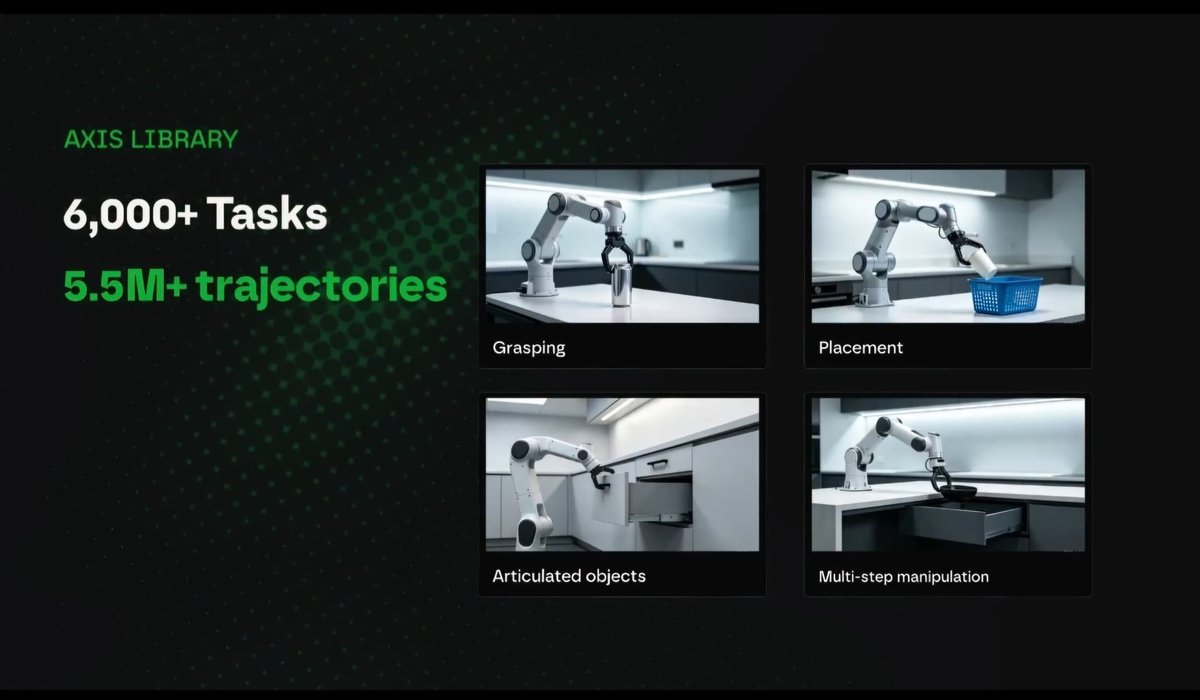
@arpit_bhayani 认为(30 次点赞,5 条回复,1,637 次浏览,12 次收藏)称,微基准测试应与端到端评测并列存在,因为它们能隔离出系统变化的原因:提示词起草时间、向量搜索延迟、MCP/API 等待时间、嵌入吞吐量、缓存命中率,以及每个并发请求的内存占用。@MTSlive 总结了(10 次点赞,1 条回复,2,748 次浏览,8 次收藏)是 Andrew Trask 倡导通过机密计算对前沿模型进行双盲评测,这样实验室就能在自己从未见过的测试上接受评估。@kellyhongsn 强调了(14 次点赞,1 条回复,598 次浏览)提到,Epoch 之所以选择对真实的开放式任务进行人工评审,是因为自动评分会漏掉那些常被描述为“缺乏品味”的能力差距。@ArtificialAnlys 展示了(14 次点赞,1 条回复,1,114 次浏览)称,六个幻觉检查器在同一批交付结果上可能会给出差异很大的错误数量,这使得评估器的选择本身成了一个真正的测量变量。
讨论洞察: 回复和配套帖子不断回到同一个质疑:陈旧的任务、过拟合的验证器,以及不透明的裁判者,会产出看似精确却不可信的分数。这里展示出的实际应对方式包括红队测试、私有测试集、针对开放式任务的人工评分,以及更细粒度的组件级测量。与前一天相比: 与 2026-10-07 相比,基准测试相关讨论进一步转向实操层面。信息流的重点从宽泛的基准资助和动态评测话术,转向搜索退化消融、任务存活率、双盲测试,以及裁判模型分歧等具体机制。
1.2 廉价决策层与路由逻辑成为核心产品层(🡕)
第二个主题聚焦于调用前沿模型之前的那一层。至少有五条保留下来的内容认为,许多生产决策应该是类型化、低成本、带概率输出的,而不是每次都交给通用推理模型处理。
@ericwilliamrea 表示(75 个赞,5 条回复,11,418 次浏览,20 次收藏)称,Podium 一直在对 OpenAI 的 Decisions API 进行 alpha 测试,以更快、更低成本地把智能体路由到正确的工作流中。引用了发布推文 表示,这个 API 通过 Responses API 选择合适模型、工具或动作的速度,最高可比 GPT-6 Luna 快 10 倍,这正是其他几条帖子反复提到的那种结构化预路由层。
@RubricLabs 分享了(18 个赞,5 条回复,1,058 次浏览,9 次收藏)分享了 Jev 的实际用例,而所链接的 Jev 帖子 将该模型描述为一个响应时间只有数百毫秒的决策引擎,适用于选择、评分和布尔判断问题。举出的例子也都偏实操而非理论:通知优先级排序、在固定句子集合上做语义搜索、拼写检查、设置导航,以及迭代式改写循环。
最具体的从业者讨论串来自 @jurbed,他在 记录了(4 个赞,1 条回复,222 次浏览,4 次收藏)中分享了五个正在运行的 Jev 部署案例。其中最有代表性的是一个 Hermes 防火墙:它会判断不受信任文本中是否包含与内容无关、且意在针对 AI 的指令。该讨论串称,在一个包含 718 条样本的基准上,它以约每千次扫描 $0.035 的成本,拦截了 89% 的 prompt-injection 攻击,误报率为 3.5%。尽管互动不高,但这是当天最详细的一手部署证据之一。
@0xwhrrari 认为(47 个赞,9 条回复,746 次浏览,33 次收藏)指出,GPT-6 Astra 应该留给高难度任务,因为到处都用它,成本很快就会飙升。所链接的 x.com 文章无法抓取,但仅凭这条推文本身、其较高的收藏数,以及它与 Decisions/Jev 讨论的契合度,成本路由这一论点已经足够清楚:模型选择如今是一个工作流设计问题,而不只是“谁在基准上赢了”的问题。
讨论洞察: 主要的反对意见并不针对小型决策模型本身,而是针对不可见的失效。回复者希望看到置信度阈值、低置信度升级机制、记忆边界纪律,以及能够证明廉价路由层不会悄悄扭曲其本应优化的工作流的证据。
与前一天相比: 前一天已经把框架设计视为重要议题。到 2026-10-08,这一主题变得更具体了:体现为真实部署、成本门控,以及一位生产环境用户描述了位于完整智能体之前的结构化路由层。
1.3 开发者继续打磨智能体周边的基础设施:框架、本地服务、文件规范化和端侧记忆(🡕)
另一个清晰的主题是,开发者正在把精力投入到智能体系统里那些“枯燥”的部分:更轻量的框架、共享的本地推理、更安全的文件摄取,以及持久化的本地记忆。至少有六条保留下来的内容属于这一类,而且大多关注的是成本、控制力或可运维性,而不是模型能力本身。
@businessbarista 概述了(31 个赞,12 条回复,3,705 次浏览,74 次收藏)介绍了一次为期 5 天的企业智能体冲刺:在接入任何生产系统之前,先完成流程映射、别名解析和集成 mock。回复进一步强化了这条帖子的实操导向:一位读者说,别名映射正是最容易暴露可避免错误的地方;另一位说,流程应先理顺,再去自动化;还有人建议,在把模拟器路径替换为真实系统之前,应先做契约测试。
@upperwal 开源了(6 个赞,3 条回复,183 次浏览,6 次收藏)介绍了 Loop——一个用 Rust 编写的智能体框架,宣称空闲时比 opencode 轻 44 倍,CPU 占用低 5 倍。真正有价值的证据在回复串里:已发布测试套件中的 13/13 项任务全部通过,任务中位耗时从 OpenCode 的 72 秒降至 29 秒,token 用量也从 OpenCode 的 1.82M 降至 803k。
@basecmpt 开源了(6 个赞,4 条回复,204 次浏览)介绍了 Superfluid,一个面向多智能体工作负载、原生支持本地 AI 的 LLM 服务器。这条推文非常偏架构层面:所有通道共享一个调度器、共享前缀缓存、具备可在 worker 崩溃后保留的持久会话日志、支持与运行时无关的后端,并且可以把会话分发到局域网内的多台机器上。
@Krivoblotsky 发布了(11 个赞,2 条回复,50,480 次浏览)发布了 MacPaw 端侧 AI 技术栈的公开基准测试。链接的 Elix 页面 表示,推理在 Mac 上运行,没有任何网络传输路径;而 Mnemos 则是一个本地记忆层,它不是把事实、文件和历史记录堆成一堆文本块,而是将其存入带引用的知识图谱中。

@Muzammil_OX 强调了(8 个赞,8 条回复,145 次浏览)微软的 MarkItDown 可将 PDF、Office 文件、图像、音频、HTML、ZIP 等转换为 Markdown,供 LLM 流水线使用。该仓库页面还警告称,它会以当前进程的权限执行 I/O 操作,这也很好地提醒了我们:即便是数据摄取层,也需要考虑安全问题。@NaceAI 推出了(32 个赞,9 条回复,3,521 次浏览,22 次收藏)NDI 1.0 是一款小型文档模型,基于 1500 万+ 金融文件训练,并被宣传为比 GPT-6 Astra 更便宜的解析方案,不过这套成本/性能说法目前仍只是数据集中的供应商自述。
讨论洞察: 最受关注的底层基础设施帖子,往往都把以下三类承诺中的至少一类讲具体了:更少的 token、更轻的本地资源占用,或更稳健的输入处理。共同趋势是,逐步远离单体式“一个大代理栈”的思路,转向具有显式调度器、缓存、文件转换器和窄专用模型的分层系统。
与前一天相比: 这延续了 2026-10-07 的工作流层模式,但这次出现了更多具体产物。前一天强调的是决策层和 eval harness;今天则增加了更轻量的编码 harness、本地服务、文档转换,以及公开的端侧运行时基准。
1.4 本地语言与公共部门 AI 以部署工作形态出现,但集成缺口明显(🡒)
一个规模较小但很具体的主题是,区域语言 AI 正从笼统愿景走向部署和生态建设。最典型的案例并不是新基础模型,而是本地语言系统必须向外部开发者和公共服务团队开放哪些能力,才能真正被用起来。
@bosuntijani 招募构建者(126 个赞,4 条回复,4,782 次浏览,80 次收藏),邀请基于 N-ATLAS 进行构建。附带海报明确给出了截止日期和官方网站,而抓取到的 N-ATLAS 页面 显示,它是尼日利亚首个开源多语种 LLM,由 Llama-3 8B 微调而来,支持 Yoruba、Hausa、Igbo、带尼日利亚口音的英语以及 ASR。随即而来的回复都很务实:数据驻留在哪里?是否有 REST API?

@PriyankKharge 表示(51 个赞,5 条回复,1,503 次浏览)BHASHINI Rajyam 研讨会在 Bengaluru 举行,围绕面向公共服务交付的语言 AI,将政府部门、机构、技术团队和初创公司聚到了一起。这里的主要证据来自这条推文:涵盖 23+ 种印度语言和 65+ 种方言的语音转文本、文本转语音、翻译、转写、OCR 和语言检测,以及针对 Karnataka 特定数据集和术语表开展的明确工作。
讨论洞察: 摩擦点不在意识形态层面,而在操作层面:API 接口、数据驻留、术语表质量,以及不同技术栈上的团队是否真的能接入这个平台。
与前一天相比: 这一天比前一天更面向部署;而前一天的信息流主要由基准设计、路由层和工作流控制平面主导。
2. 什么让人沮丧
如今,基准测试的信任问题在评估器层就开始断裂
严重性:高。信息流反复表明,评估失效早已不只是“再补一个基准”那么简单。@ExaAILabs 展示了(61 个赞、5 条回复、1,867 次浏览、13 次收藏)认为,搜索能力退化理应显著拉低搜索基准测试分数,否则这个基准实际上并没有衡量搜索。@SnorkelAI 表示(20 个赞、628 次浏览)说明,基准构建者如今需要主动防范数据污染、奖励投机和验证器失效。@ArtificialAnlys 展示了(14 个赞、1 条回复、1,114 次浏览)指出,对于同一批交付结果,不同的幻觉评判器会给出差异很大的错误计数;与此同时,@MTSlive 总结了(10 个赞、1 条回复、2,748 次浏览、8 次收藏)提到 Andrew Trask 支持双盲评估的理由:否则,各实验室就会针对自己能看到的测试不断“爬坡优化”。人们正在通过基准红队、人工评分、微基准和私有测试集来应对。值得投入建设:高。
人工审查仍是 AI 辅助安全与 QA 的瓶颈
严重性:高。最突出的硬数据来自 Anthropic 推出 OSS Scanner:该公司表示,它发现了 29000+ 个候选漏洞,但人工审查的只有约 6,000 条。@AnthropicAI 上线了(166 个赞、13 条回复、17,075 次浏览、25 次收藏)恰恰是因为维护者越来越希望获得比人工验证速度更快的报告。这一瓶颈也以另一种形式出现在 @ArtificialAnlys 中:评判器的选择会改变表面上的幻觉数量。团队的应对方式包括接受模型直接生成的原始发现、缩小范围,并在高严重性或难以判断的情况中继续保留人工参与。值得投入建设:高。
前沿模型成本过高或过于笨重,无法成为每一步的默认选择
严重性:高。@0xwhrrari 认为(47 个赞、9 条回复、746 次浏览、33 次收藏)认为,GPT-6 Astra 应该留给高难度任务;而 @ericwilliamrea 表示(75 个赞、5 条回复、11,418 次浏览、20 次收藏)则表明,结构化的 Decisions API 比完整跑一遍 LLM 更快也更便宜。在测试框架这一侧,@upperwal 发布(6 个赞、3 条回复、183 次浏览、6 次收藏)中的基准声称,在已发布的测试套件里,Loop 的 token 用量不到 OpenCode 的一半。这里体现出的应对策略包括路由、更小的决策模型、更轻量的测试框架,以及更有意识地先做演示原型,而不是立刻接入生产环境。值得投入建设:高。
本地语言和公共部门 AI 仍缺少那些不起眼却必不可少的集成细节
严重性:中高。@bosuntijani 推广(126 个赞、4 条回复、4,782 次浏览、80 次收藏)提到了 N-ATLAS,但最有实质内容的回复立刻追问了数据驻留,以及缺少 REST API 的问题。@PriyankKharge 描述(51 个赞、5 条回复、1,503 次浏览)提到 BHASHINI 的工作,但 Kannada 和其他语言仍需要更好的本地数据集和术语表。即便不看语言基础设施,@Muzammil_OX 强调(8 个赞、8 条回复、145 次浏览)也提到了 MarkItDown,因为把杂乱文件整理成适合 LLM 处理的形式,依然是一个真实存在的工作流问题。值得投入建设:高。
3. 人们希望出现什么
可信的动态评测:带私有测试与评审质检
人们越来越希望评测能够随着前沿进展同步演化、抵抗记忆化,而且不要只产出一个排名,还要能解释失败模式。@SnorkelAI 和 @ExaAILabs 都在朝这个方向推进,而 @MTSlive 和 @maishimadamd 则进一步补充了私有测试和动态评分标准方面的细节。这是一个现实且迫切的需求,如今已经出现了多个明显的失败案例。机会:直接。
可部署在智能体前端的类型化路由与工作流防火墙
信息流中反复出现的诉求是:在调用昂贵模型之前,先做更便宜、结构化的决策。@ericwilliamrea 展示了生产环境中的路由需求,@RubricLabs 记录了一个专为类型化决策构建的模型,@jurbed 则展示了这一层如何同时过滤提示注入风险。现在已经有一些解决方案,但市场看起来仍处于足够早期的阶段,以至于许多团队还在自行拼装定制技术栈。机会:直接。
面向多智能体协作的本地优先运行时与数据接入层
多个发布背后隐藏着一个明确的愿望:需要一套基础设施,默认支持在受限机器上同时运行多个智能体,并具备私有本地推理和合理的文件处理能力。@upperwal、@basecmpt、@Krivoblotsky 和 @Muzammil_OX 分别覆盖了这套技术栈的一部分。这个需求很具体,但已有多家团队围绕它展开竞争。机会:竞争型。
面向公共部门的语言 AI:具备真实 API、数据驻留保证和术语表工具
这些区域语言相关帖子读起来并不像抽象的政策讨论,而更像是团队在寻求可落地的实现接口:API、清晰的部署方案、本地数据集和领域术语表。@bosuntijani 和 @PriyankKharge 直接体现了这种需求。对于特定地区来说,这一需求看起来既现实又紧迫,但其买方与采购环境会比通用开发者工具更狭窄。机会:直接。
4. 正在使用的工具与方法
| 工具 | 类别 | 倾向 | 优势 | 局限 |
|---|---|---|---|---|
| ATLAS | 搜索基准测试 | (+) | 直接衡量搜索质量,采用覆盖广泛且有深度的多领域任务,并会对检索质量退化进行惩罚 | 仍然只是一个基准测试维度,且需要复杂的测试框架 |
| TermGrade | RL 环境 / 基准测试 | (+) | 1,000 个可执行环境、经验证的任务、开放轨迹、与执行结果绑定的评分 | 仍属早期发布,提升效果由开发方报告 |
| 开放基准资助计划 | 评测项目 | (+) | 资助基准测试创建、加入红队测试、支持 fellowship 研究 | 它是支撑性基础设施,不是开箱即用的测试框架 |
| Open Axis Benchmark / AXIS | 机器人基准测试 + 数据引擎 | (+) | 动态任务库、浏览器遥操作、留出集协议、在扰动条件下实现稳健性提升 | 专门面向桌面机器人工作流 |
| OpenAI Decisions API | 路由 / 决策模型 | (+/-) | 可对模型、工具和动作进行结构化选择,在路由场景下比完整 LLM 调用更快且更便宜 | 用户仍在质疑工作流完整性和记忆边界 |
| Jev | 决策模型 | (+) | 类型化输出、校准后的概率、数百毫秒级决策、已有真实部署证据 | 需要预先定义答案空间并调节阈值 |
| Loop | 智能体测试框架 | (+/-) | 在已发布基准中表现出更低的空闲开销、更少的 CPU 时间和更低的 token 消耗 | 仍是开发者预览版,且基准证据由开发方报告 |
| Superfluid | 本地 LLM 服务器 | (+/-) | 共享调度器、共享前缀缓存、可容错会话、多机支持 | 目前证据仍主要是自报的架构性主张 |
| Elix + Mnemos | 端侧运行时 + 记忆 | (+) | 推理无网络路径、可移植的本地记忆、带引用的知识图谱 | 运行时仍为闭源,且两款产品都仍在开发中 |
| N-ATLAS | 本地语言 LLM | (+/-) | 开源定位、支持尼日利亚语言,并为语音工作流提供 ASR | API 和数据驻留问题从一开始就被提了出来 |
| BHASHINI | 公共部门语言平台 | (+) | 覆盖广泛的语言和方言,并具备支持服务交付的语音与翻译功能 | 本地部署质量仍取决于术语表和数据集建设 |
| NDI 1.0 | 文档模型 | (+/-) | 以更小模型实现更低成本的金融文档解析与分类 | 该数据集中的基准表述来自厂商自报 |
置信度最高的积极信号,来自那些让评估或路由过程更易审查的工具:ATLAS、Jev、Snorkel 的红队框架,以及 AXIS。而当证据主要来自开发者自己发布的基准测试帖时,整体评价就转为褒贬不一,例如 Loop、Superfluid 和 NDI 1.0。
最明显的迁移趋势,是从“把所有东西都发给一个前沿模型”转向分层系统:先做类型化决策,再做更重的推理;用本地部署和共享缓存替代每个 agent 各自独立推理的孤岛;使用专用文档模型或转换器,而不是把每个文件都硬塞给通用聊天模型。评估也遵循了同样的模式:从静态公开排行榜,转向动态任务、人工评判、机密计算,以及基准维护。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| OSS Scanner | Anthropic | 面向开源仓库的自愿加入型漏洞扫描器,会发送由模型生成、附带复现步骤和拟议补丁的报告 | 人工安全团队已无法足够快地审查不断增长的漏洞数量 | 前沿 Claude/Mythos 模型、隔离 VM、离线扫描、GitHub 注册仓库 | Beta | 发布文章, GitHub |
| ATLAS | @ExaAILabs | 用于衡量 agent 在多个领域中如何真实执行搜索并丰富结果的基准 | 旧有搜索基准已经过时、被污染,或无需真实搜索就能解出 | 搜索 harness、Discovery/Row/Item F1 指标、多领域任务 | 已发布 | 推文, 基准测试 |
| TermGrade | @Weyaxi | 面向终端 agent 的开放 RL 环境,以及轨迹数据和评分方案 | 终端 agent 需要可执行环境,而不只是纯提示任务 | 1,000 个可执行环境、36,000 条轨迹、基于执行的评分 | Beta | 推文 |
| Loop | @upperwal | 用 Rust 编写的 coding-agent harness,设计目标是比 opencode 更轻量 | 现有 harness 即使只是空转待命,也会浪费 token 和本地 CPU | Rust、CLI harness、已发布的 GLM 5.3 Flash 基准套件 | Alpha | 推文 |
| Superfluid | @basecmpt | 面向本地 AI 的原生 LLM 服务器,适用于受限机器上的多 agent 负载 | 通用 LLM 服务器并未针对大量本地 agent 共享同一设备进行调优 | 共享调度器、共享前缀缓存、与运行时无关的 worker、多机部署 | Alpha | 推文 |
| Elix + Mnemos | MacPaw | 面向 Mac 助手的端侧运行时与记忆层 | 需要私有的本地推理和持久记忆,而不依赖云端 | Swift、基于 MLX 的推理、可组合流水线、知识图谱记忆 | Alpha | Elix, Mnemos, 推文 |
| NDI 1.0 | @NaceAI | 用于解析和分类金融文档的小模型 | 对前沿模型而言,重复性的文档处理任务成本过高 | 小型专用模型、1500 万+金融文件训练语料、经过基准测试的集成 | Beta | 推文 |
| N-ATLAS | NCAIR / NITDA | 正在向下游应用开发推进的多语种尼日利亚 LLM 平台 | 尼日利亚用户需要具备本地相关性的语言 AI 和语音工具 | Llama-3 8B 微调、多语种支持, | ASR | 已发布 |
OSS Scanner 和 TermGrade 代表了一种构建模式:把此前仅供内部使用的评估或安全工作流,转化为可复用的公共基础设施,即便人工瓶颈仍未消失。ATLAS 和 AXIS 则从基准测试的角度指向同一方向:产品不只是一个分数,而是一个持续维护的任务面。
Loop、Superfluid 和 Elix/Mnemos 体现了第二种模式:构建者优化的是模型周边的运行时,而不只是模型本身。反复出现的痛点包括空闲开销、共享调度、隐私、持久化,以及在一台机器上运行多个智能体的成本。
NDI 1.0 和 N-ATLAS 展示了第三种模式:面向特定部署场景、规模更小或更本地化的模型。前者走的是垂直化、经济性导向路线,针对重复性的金融文档工作;后者则侧重地域与语言,目标是提升本地相关性,并提供以语音为主的语言接入。
6. 新动态与亮点
Anthropic 将前沿漏洞发现能力做成了可选择加入的开源服务
@AnthropicAI 已发布(166 次点赞,13 条回复,17,075 次浏览,25 次收藏)将 OSS Scanner 作为一项免费服务提供给自愿加入的开源项目。链接中的 发布文章 称,Anthropic 已发现 29,000 多个候选漏洞,但人工审核的只有约 6,000 个,而且早期 OSS Scanner 报告已包含在无人审核情况下生成的复现步骤和候选补丁。这让此次发布不仅在产品层面值得关注,也相当于公开承认:验证能力才是真正的瓶颈。
基准测试的建设者持续升级的,是基准本身,而不只是成绩单
@ExaAILabs 介绍了(61 次点赞,5 条回复,1,867 次浏览,13 次收藏)更新了 ATLAS,以惩罚薄弱的搜索能力;而 @SnorkelAI 已扩展(20 次点赞,628 次浏览)则通过红队和 fellowship 计划推进其开放基准工作。@Promzy__M 使用了(24 次点赞,32 条回复,350 次浏览)推出 Open Axis,主张机器人基准需要动态变化的任务集;@ArtificialAnlys 展示了(14 次点赞,1 条回复,1,114 次浏览)则指出,就连用于判定幻觉的评判器本身也可能改变结果。

MacPaw 通过公开基准页面,让其端侧技术栈变得更透明
@Krivoblotsky 披露了(11 次点赞,2 条回复,50,480 次浏览)为 Elix 和 Mnemos 发布了基准页面,把端侧运行时和记忆层从只能靠外界想象,变成了可以直接检视的对象。其中的 Elix 页面 尤其值得注意,因为它声称推理过程不经过网络,并公布了与其他 Apple-silicon 运行时对比的吞吐量图表。
N-ATLAS 和 BHASHINI 让本地语言部署显得真正可操作
@bosuntijani 推广了(126 次点赞,4 条回复,4,782 次浏览,80 次收藏)围绕 N-ATLAS 发起了一场现场挑战;与此同时,@PriyankKharge 描述为(51 次点赞,5 条回复,1,503 次浏览)则举办了面向各邦的 BHASHINI 研讨活动,主题涵盖服务交付、本地术语表和数据集建设。这些之所以值得关注,是因为它们把语言 AI 框定为实施和采购工作,而不只是模型民族主义。
7. 机会在哪里[+++] 动态评估运营与审计工具 - 相关证据横跨 ATLAS、Snorkel 在基准测试红队方向的推进、Open Axis、TermGrade、Epoch 关于人工评估的说明、Andrew Trask 对双盲评估的论证,以及对“幻觉裁判”的比较。之所以有力,是因为多篇彼此独立的帖子都从同一个信任问题的不同侧面提供了证据。
[+++] 类型化路由、工作流护栏与 AI 防火墙层 - Decisions API、Jev 的公开用例、jurbed 的五个部署案例,以及 Astra 的成本门控,都指向同一个共同需求:在昂贵的模型调用之前,先进行快速的结构化决策,再配合基于置信度的升级处理和提示注入过滤。
[++] 本地优先的代理运行时与文档管线 - Loop、Superfluid、Elix/Mnemos、MarkItDown 和 NDI 1.0 都瞄准了同一大类需求:让代理运行更便宜、更容易接入文档,也更少依赖远程基础设施。这个信号确实存在,但其中一些说法仍处于早期阶段,或仅来自开发者自述。
[++] 公共部门与区域语言 AI 赋能 - N-ATLAS 和 BHASHINI 都反映出围绕 API、数据驻留、术语表和本地数据集的现实需求。需求看起来相当明确,尤其面向政府和本地生态,但市场更窄,也更依赖具体部署场景。
[+] 面向模型生成发现结果的安全分诊与补丁验证工作流 - OSS Scanner 暴露出候选发现结果与人工审查能力之间的巨大缺口。这一机会正在浮现,因为证据很强,但其运营模式仍在公开摸索中。
8. 要点
- AI Twitter 上证据最充分的部分,是评估机制,而不是模型炒作。 ATLAS、Open Axis、Snorkel 红队能力的扩展、微型基准测试和人工评判,都聚焦于随着系统不断改进,如何让衡量保持诚实可信。(ATLAS、Snorkel、arpit_bhayani 推文)
- 类型化决策层正在进入真正的生产环境角色。 Decisions API、Jev 已发布的示例,以及 jurbed 的部署串帖,都把路由、过滤和分类视为独立的产品层,而不是聊天模型的附带产物。(ericwilliamrea 推文、Jev 帖子、jurbed 推文)
- 开发者竞争的焦点,是代理周边的基础管线:框架负担、本地服务、文档转换和记忆。 Loop、Superfluid、MarkItDown 和 Elix/Mnemos 的目标,更多是运营成本和控制力,而不是前沿能力本身。(upperwal 推文,basecmpt 推文, MarkItDown, Elix)
- 本地语言 AI 已显现出真实的部署需求,但集成细节仍然是主要阻力。 N-ATLAS 和 BHASHINI 都反映出对本地适配性的需求,而相关回复和工作坊目标则凸显了 API、数据驻留、数据集和术语表方面的缺口。(N-ATLAS 网站, bosuntijani 推文, PriyankKharge 推文)
- 即使 AI 产出更多候选发现或更多评审模型输出,人工审核仍然是瓶颈。 Anthropic 产出的 29,000+ 个候选漏洞中,只有约 6,000 个经过人工审核;再加上评审模型在幻觉检查中存在分歧,这两点都表明,审核吞吐量仍是核心约束。(OSS Scanner 发布, Artificial Analysis 推文)