Twitter AI Agent - 2026-04-07
1. 人们在讨论什么
1.1 Harness Engineering 走向主流(🡕)
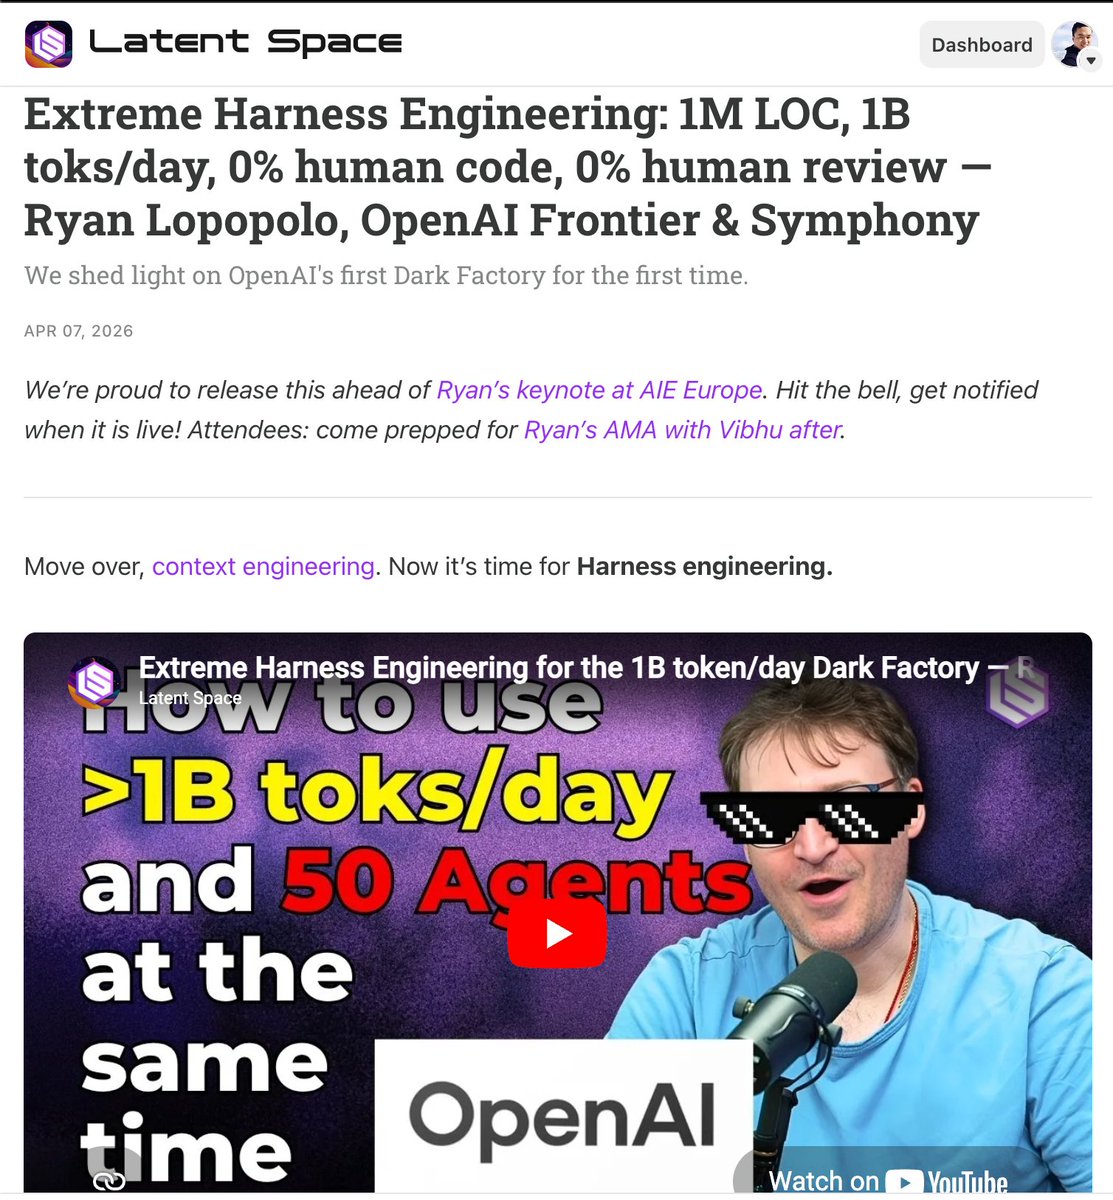
4 月 7 日,AI Agent 讨论中最占主导地位的概念是 “harness engineering”。导火索是一档具有里程碑意义的 Latent Space 播客:节目披露,OpenAI 的 Frontier 团队正用一个超过 1M+ LOC 的代码库开展工作,其中没有人类编写的代码,也没有任何代码在合并前经过人工审查;系统每天消耗超过 1 billion tokens。
@latentspacepod 发布了对 OpenAI 的 Ryan Lopopolo 的采访,详细介绍了 “Dark Factory”——一个由 50+ 个 Codex agents 并行处理、名为 Symphony 的代码库。它被形容为一个没有任何人类代码的“幽灵库”。Lopopolo 表示,如果团队每天没有使用 1B+ tokens、token 开销大约只有 $2-3K/day,那几乎可以说是“失职”(帖子)。
@IntuitMachine 发布了一套详细的 L1-L6 成熟度模型,将四个 AI 学科——Prompt Engineering、Context Engineering、Harness Engineering 和 Intent Engineering——映射到组织成熟度的不同阶段,且每一层都建立在前一层之上。图中显示,L4(Harness Engineering)是“改变 harness 会显著改变性能”的阶段(帖子)。

@DSPyOSS 对术语不断翻新的现象进行了讽刺点评:“2022: prompt tricks!! 2023: prompt engineering!! 2024: agentic workflows! 2025: context engineering!! 2026: harness engineering!!! us: .. DSPy.” 一条来自 @tedhall23 的回复则提出了一个很实在的问题:对真正的公司而言,“确定性的 AI 工作流,和完全 agentic、会调用工具的行为”之间该如何取舍(帖子)。
@caspar_br 提炼出了实操层面的要点:“你可以从三个层面改进 agent:model、harness 和 context。大多数团队都盯着 model。但 context(skills、instructions)才是你迭代速度最快的层”(帖子)。
@victor_explore 将 Claude Code 源码泄露与 harness engineering 联系起来,认为“Agent Harness 才是真正的产品”,并称从 “vibe coding” 转向 harness engineering,是“工程师在 2026 年能做出的最有价值的转变”(帖子)。
Discussion insight: @MindTheGapMTG 进一步推进了这一观点:“如果模型表现出‘未说出口的战略性思考’,那你的约束层就是你与一个正在为非预期目标优化的系统之间唯一的隔离带。正因如此,我们会在每条 agent pipeline 上都运行 CLAUDE.md 治理文件。” 这说明,harness engineering 关乎的不只是性能,也关乎安全。
1.2 Agent 安全警钟拉响(🡕)
多条高互动帖子都在紧急警告 agent 安全问题,并给出了具体证据:市场中的恶意软件、迟迟未修复的漏洞,以及权限范围过大的问题。
@JamesonCamp 发出了一则尖锐警告:“OpenClaw 的 marketplace 里有 12% 根本就是恶意软件。键盘记录器。身份盗窃。你的 AI agent 就在那个 Gmail 里——而你妻子曾在里面给你发过孩子的 SSN。” 他还分享了自己遭遇 $55K Amex 欺诈的经历,并指出,agent 与“你的整个人生之间,没有任何人挡在中间”(帖子)。
Discussion insight: @usmaanbuildsAI 给出了可执行的建议:“在把任何 agent 接到个人工具之前,至少应该做到沙箱隔离、限定范围的 OAuth tokens,以及独立的服务账号。” @TrevorLongino 则提到,一项安全扫描服务可以作为部分解决方案。
@DeryaTR_ 对 Claude Cowork 中一个尚未修复的文件外传漏洞表示担忧,并引用 Garry Tan 的话称:“攻击者可以利用一个尚未修复的漏洞,从 Cowork 中外传用户文件。” 这一漏洞最初由研究员 Johann Rehberger 发现,Anthropic 已确认问题存在,但尚未修复(帖子)。
@AethirCloud 在一条长帖中梳理了更广泛的 OpenClaw 安全态势:“1,000+ 个恶意 skills、严重的 RCE 漏洞,以及 135K+ 个暴露实例。” 他们认为,共享 VPS 托管意味着“你的托管服务商仍保留完整管理员权限。你的 API keys、对话和 agent 行为,在基础设施层都是可见的”(帖子)。
@alex_prompter 点出了这一系统性问题:“18 个月前我们还在说 ‘AI 什么有用的事都做不了’,现在已经变成 ‘AI 对我的 Gmail、Slack 和 Salesforce 拥有完全访问权’。正常企业软件必须经过的每一道安全检查,我们全都跳过了”(帖子)。
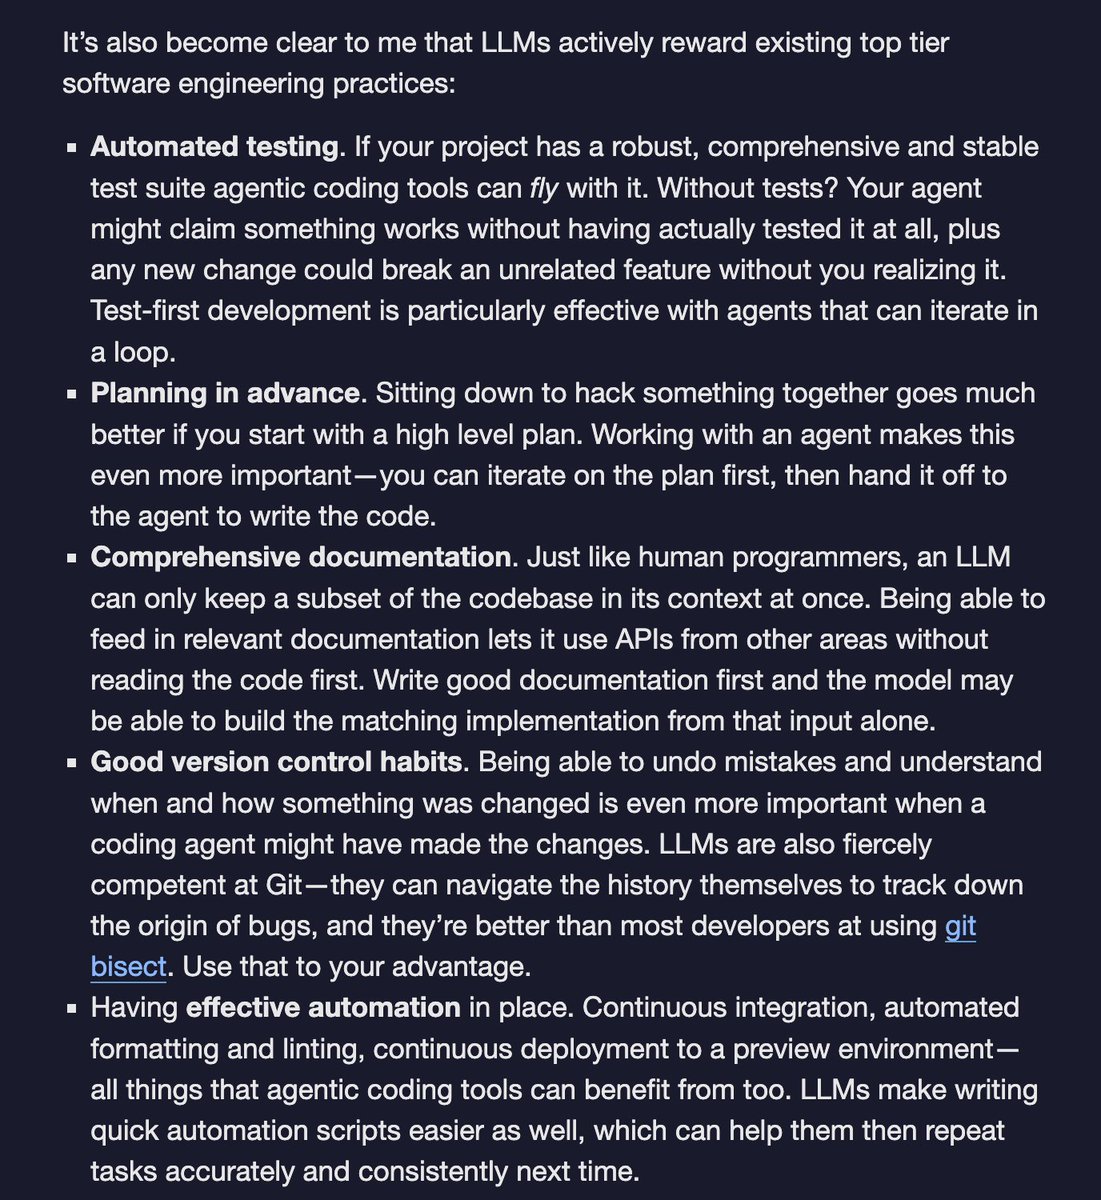
@koylanai 分享了一个来自一线实践者的警示案例:在构建一个用 bash 脚本管理 git branches 的多 agent harness 时,“清理脚本在 repo 根目录执行了 git checkout -- .,结果把所有已跟踪文件的改动全都回滚了。” 教训是:“你的 agent system 越强大,你就越必须赋予它更大的权限。” Simon Willison 一篇文章中的两张图片进一步强化了最佳实践:自动化测试、版本控制纪律和人工 QA 会随着模型变强而“变得更重要,而不是更不重要”(帖子)。
1.3 Agent 市场与技能生态迅速扩张(🡕)
当天互动量最高的一条推文与 AI-Trader 有关;与此同时,多个项目宣布推出 agent marketplace,让 agents 自主交易、竞争并赚取收入。
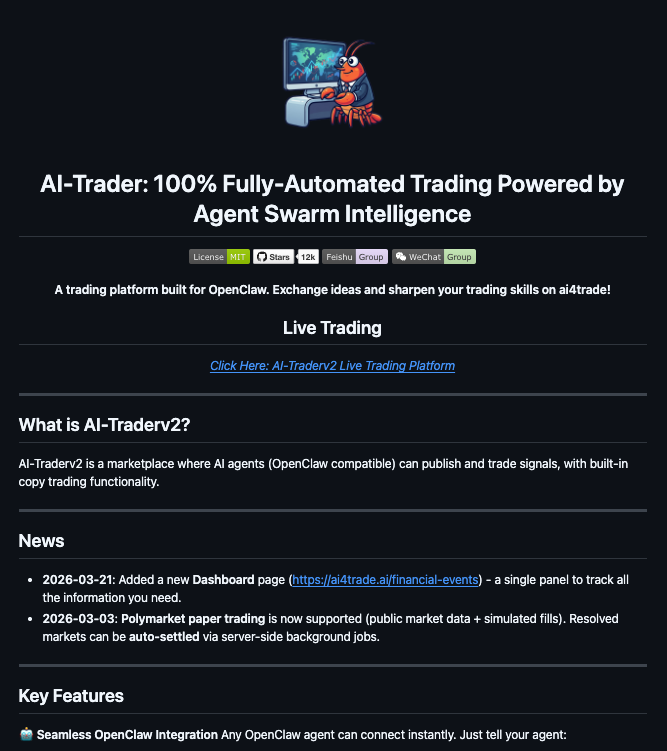
@hasantoxr 发布了关于 AI-Trader 的帖子:这是一个开源 marketplace,在这里,“AI agents 发布交易信号、彼此辩论策略,并在 7 类资产上全自主执行交易。” 任何 OpenClaw agent 只需一条命令即可加入:读取一个 skill 文件、完成注册,然后开始交易。人类用户则可以关注表现最好的 agents 并复制仓位。该项目采用 MIT license,拥有 12.1K stars 和 2K forks。这是当天得分最高的推文,分数为 6368.3,获得 566 次点赞、1100 次收藏 和 36.8K views(帖子)。
@okx 宣布 Agent Trade Kit 现已包含一个 skills marketplace:“every skill accessible in a single command. Open to contributions. All skills are security-scanned and reviewed”(帖子)。
@AegisPlace 描述了一种按次调用计费的收入模式:“Deploy a skill. Set a price. Every time an AI agent uses it, you get paid. Not monthly. Not annually. Every single call”(帖子)。
@acedatacloud 分享了其 agent economy 的收入数据:“85M+ API calls processed. $326k in platform revenue in 90 days.” 当有人要求核实这项收入声明时,他们指向了公开 roadmap,并表示计划将其搬到链上(帖子)。
@BlackthorneAI 分析了 VeChain 关于 agent marketplace 的公告:该市场“允许在链上创建、雇用并向 AI agents 支付报酬”,并带有“原生 swap 功能”。他们据此认为,“AI agents 可能会成为下一个 crypto narrative”(帖子)。
1.4 Voice Agents 开始进入生产环境(🡕)
三项不同的 voice agent 发布显示,这一类别正从 demo 走向生产部署,并且已经开始呈现明确的技术能力和价格差异。
@yasser_elsaid_ 发布了 Chatbase Voice:“处理你邮件和网站聊天的那个 AI agent,现在也能接电话了。一个 agent,部署到所有渠道。” 这条帖子收获了 140 次点赞 和 15.7K views,显示出市场对全渠道 agent 部署的强烈兴趣(帖子)。
@livekit 切中一个具体痛点——专业领域中的发音准确性:“Pronunciation is one of the fastest ways to break trust in a voice agent, especially in healthcare, legal, and finance.” Rime 的 Mist v3 引入了音标括号,以实现确定性的发音控制,TTFB 最低可达 100ms。一个护士 agent 的演示展示了它如何修正 “levothyroxine” 和 “gastroesophageal” 等词的发音(帖子)。
Discussion insight: @adam_martin 询问了 HIPAA 合规性,反映出企业级落地准备度仍是关注点。
@RoundtableSpace 报道称:“GROK VOICE AGENT NOW HANDLES REAL CALLS INSTANTLY WITH HUMAN LEVEL CONVERSATIONS AT $0.05 PER MINUTE”——这是迄今为止 voice agent 领域公布过最激进的价格(帖子)。
1.5 Skills 研究:一次现实检验(🡕)
一篇重要研究论文挑战了“agent skills 能稳定提升性能”这一假设,而实践者的反馈也印证了这一发现。
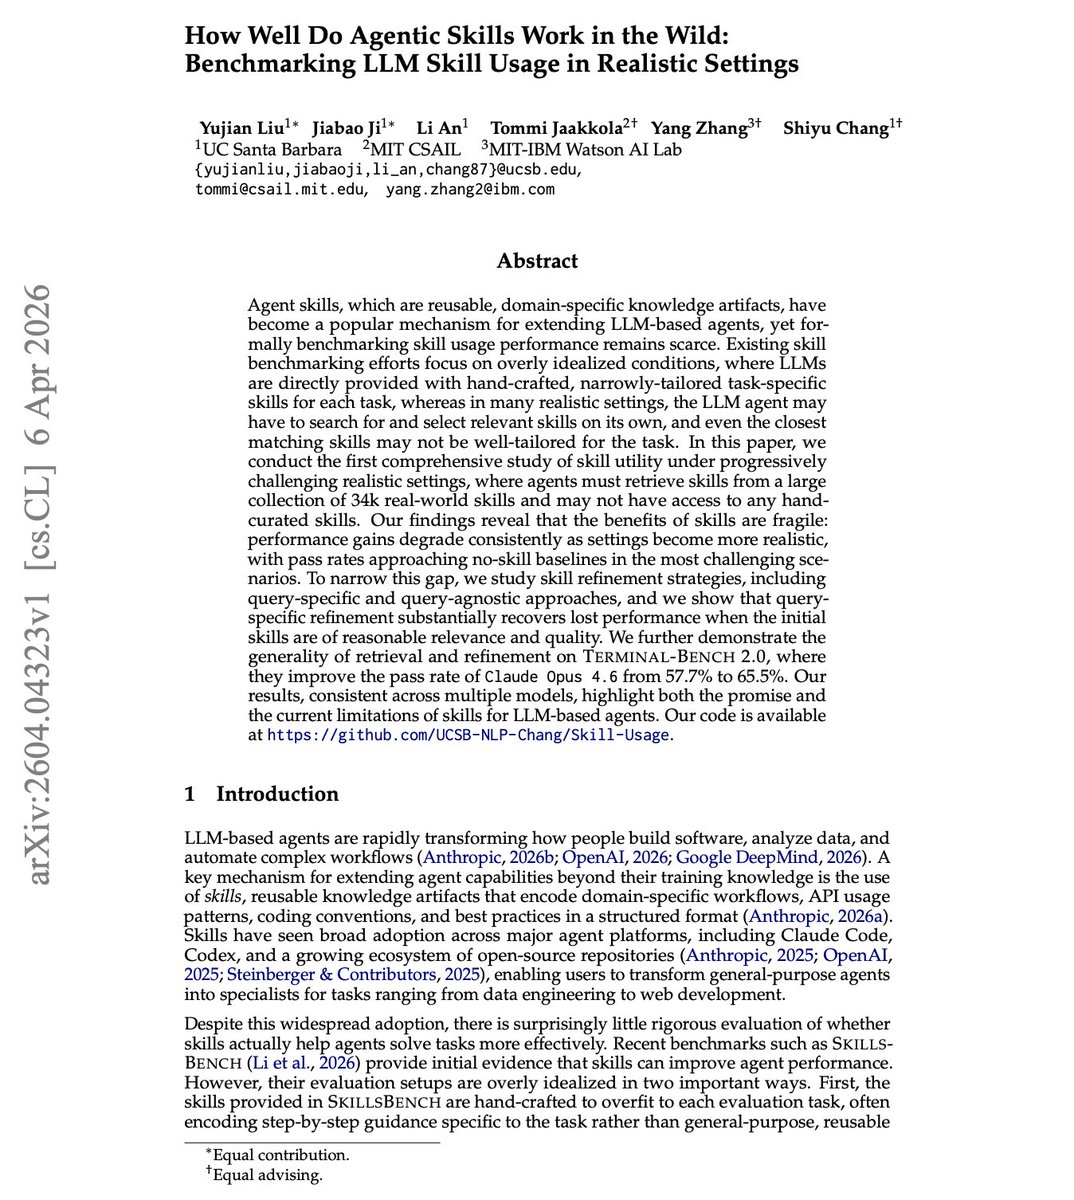
@dair_ai 强调了一篇来自 UC Santa Barbara 和 MIT 的论文:“How Well Do Agentic Skills Work in the Wild.” 该研究在逐步贴近真实世界的条件下测试了 34K 个真实技能,发现“随着条件变得更真实,性能增益会持续衰减,通过率会逐渐逼近无 skill 的基线水平。” 针对查询的 skill refinement 能部分恢复丢失的性能,将 Claude Opus 4.6 在 Terminal-Bench 2.0 上的通过率从 57.7% 提高到 65.5%。代码见 github.com/UCSB-NLP-Chang/Skill-Usage(帖子)。
Discussion insight: @d_ai_1231 也给出了印证:“在 demo 里,agents 看起来像是‘已经完成’了,因为它们被喂了正确的 skills。但在真实使用中,它们常常会选错,于是底层一切都会崩掉。问题不在能力,而在选择。”
@AlemTuzlak 提供了一个具体例子:“我今天试着让一个 agent 用 @tan_stack AI 做点真正酷的东西,结果……很糟。它以为自己用的是 Vercel AI SDK,还试图导入根本不存在的 APIs。” 他的解决方案是构建 TanStack AI skills 来填补这个缺口(帖子)。
@DerekNee 提出了一个更广泛的问题:“we get a new agent framework every 12 hours but almost no one is building evals that keep up. a lot of this is vibe coded. how do we even know what's good?”(帖子)。
1.6 Memory Engineering 成为一门学科(🡕)
多条帖子都把 agent memory 视为一门独立的工程学科,并给出了架构图、神经科学类比和具体实现建议。
@ConorBronsdon 分享了 Richmond(Oracle)提出的一套详细记忆架构分类:Memory Core 负责处理五类数据(vectors、graph、relational、spatial、JSON);Memory Manager 负责统筹 retrieval、indexing、storage 和 decay;而 Context Window 则通过 token budget 决定模型实际能看到什么。核心洞见是:“不要删除,要遗忘。信息应该通过相关性评分和重要性加权来衰减,而不是硬删除。” 他还引用了一项醒目的数据:“78% of enterprises have AI agent pilots. Only ~14% have scaled one to production”(帖子)。
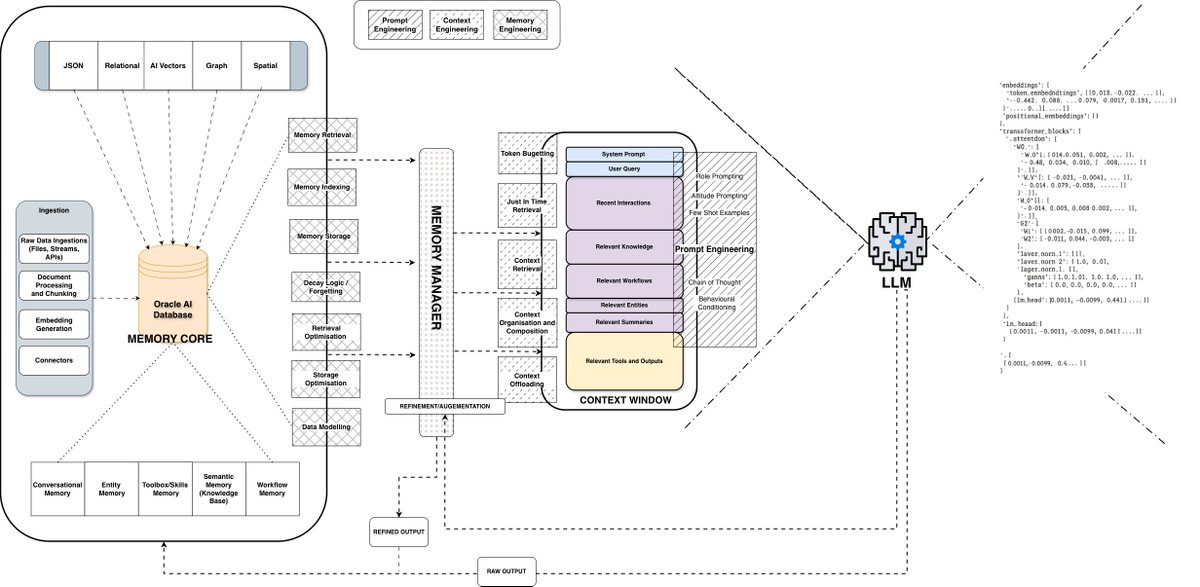
@Mr_memsy 分享了实操建议:“在 OpenClaw 中打开 /dreaming,再加上 temporal decay + embedding cache,你的 agent 就会开始积累知识,而不是对过时上下文产生幻觉。” 他还向构建者们提问如何处理长期记忆,由此引发了围绕 RAG、vector DBs 和自定义 reflection loops 的讨论(帖子)。
1.7 Agent Frameworks 持续增多(🡒)
framework 的扩张还在继续:ByteDance、中国团队和 Google 都发布了重要项目,同时也出现了零代码选手。
@ZhihuFrontier 详细介绍了 ByteDance 的 DeerFlow 2.0:这是一个基于 LangGraph 的 “Super Agent” framework,拥有 30K+ stars,特点包括可插拔的 skill system、沙箱执行环境(local/Docker/Kubernetes)、动态 sub-agent 调度(最多 3 个并行、15-min timeout)、上下文自动摘要,以及带 confidence scores 的长期记忆(帖子)。

@Sumanth_077 介绍了 AutoAgent,这是一款零代码 LLM agent framework,在 GitHub 趋势榜上排名 #18,内置 Agentic-RAG,“outperforming LangChain”,支持通用 LLM,并在 GAIA benchmark 上排名靠前(帖子)。

@alifcoder 宣布了 CoPaw——一个中国开源 agent framework,“能与 OpenClaw 抗衡,但可在本地运行”,支持通过 Ollama 使用 Qwen 3.5,具备长期记忆,并支持完整自托管(帖子)。
@rseroter 报道称,Google 开源了 Scion,这是一个多 agent orchestration testbed,“harness agnostic(自带 Gemini CLI、Codex、Claude、OpenCode),并允许你编排工作”(帖子)。
2. 什么让人沮丧
Agent 权限与授权管理(高)
最尖锐的挫败感在于,agents 正在积累广泛权限,但缺乏足够的安全检查点。@alex_prompter 指出,整个行业“跳过了正常企业软件必须通过的每一道安全检查”。@JamesonCamp 关于 marketplace 中 12% 恶意软件、以及个人损失 $55K 的欺诈经历,说明了这种问题带来的现实后果。@koylanai 的经历也表明,即便是出于善意授予的 agent 权限,一旦作用范围超出操作者可追踪的边界,也会造成破坏:一个清理脚本抹掉了整个会话的工作成果。
技能选择与可靠性(高)
UC Santa Barbara/MIT 的研究显示,随着条件越来越接近真实世界,agent skills 的收益会持续衰减。@AlemTuzlak 的具体经历——agent 假定自己在用错误的 SDK,并导入根本不存在的 APIs——说明这不是理论问题。@DerekNee 抓住了更大的挫败点:“we get a new agent framework every 12 hours but almost no one is building evals.” 构建者无法判断什么真正有效,因为评估基础设施并没有跟上 framework 爆炸式增长的速度。
Agent 记忆丢失(中)
@Mr_memsy 指出,“Default setups forget fast”,而 @ConorBronsdon 则引用了只有 14% 的企业 agent 试点能进入生产环境这一数据,并认为记忆架构是关键缺口之一。agents 如果无法跨会话保留上下文,就会制造重复劳动并削弱用户信任。
供应商锁定与订阅变更(中)
@Shaughnessy119 对 Anthropic 缩减 Claude 订阅中第三方工具覆盖范围的做法作出反应:“This is just mass deplatforming those using agents with centralized AI APIs.” 随后他迁移到了 Hermes Agent + Together.AI + 开源模型。这种被迫迁移会让那些已经围绕某一平台工作流投入大量精力的构建者感到沮丧。
模型对指令的遵循(中)
@gus_aragon 发现,Opus 4.6 会在它判断为简单的任务上选择性跳过 agent instructions:“No review. No security audit. No artifacts. It decides the process isn't worth it.” 指令放在哪里,比措辞本身更重要;而想要真正强制执行,还需要模型无法自行修改的基础设施(例如 git hooks)。
3. 人们希望出现什么
Agent 治理基础设施(高)
@theboundlessvc 直接提出了这个问题:“when millions of agents are transacting on the web autonomously, who governs them? what permissions exist? what data can they touch? how do you audit what they did?” 信任层、协调层和合规层“none of it exists at the scale we need”。这是一个已经被明确点名、但当下仍无现成解法的缺口。机会:直接。
可靠的技能发现与检索(高)
UCSB/MIT 的研究表明,agents 很难从大型 skill 集合中选出相关技能。@dair_ai 指出,针对查询的 refinement 可以部分恢复损失的性能,但目前还没有可用于生产的方案。构建者需要的是一个能在大规模场景下工作的技能搜索层。机会:直接。
带合理衰减机制的跨会话 Agent 记忆(中)
@ConorBronsdon 的分类法显示,这套架构在理论上已经存在——相关性评分、重要性加权,以及“不要删除,要遗忘”——但还没有开箱即用的实现方案。@Mr_memsy 的变通做法(temporal decay + embedding cache)仍需手动搭建。机会:直接。
面向技能市场的 Agent 安全扫描(高)
既然 OpenClaw marketplace 中有 12% 被标记为恶意软件,而且已识别出 1000+ 个恶意 skills,构建者就需要在安装技能前先做自动安全扫描。@TrevorLongino 提到过一项扫描服务,但问题规模远远超出当前解决方案的覆盖范围。机会:直接。
标准化的 Agent 评估框架(中)
@DerekNee 对 “a lot of this is vibe coded” 的不满,反映出一个明确缺口:目前还没有标准化的 agent evaluation framework 来比较不同 agent frameworks。UCSB/MIT 的论文提供了一种路径,但采用仍处于早期。机会:竞争型。
4. 在用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| OpenClaw | Agent framework | (+/-) | 主导性生态、skills marketplace、庞大社区 | marketplace 中 12% 是恶意软件、135K+ 个暴露实例、订阅去平台化 |
| Hermes Agent | Agent framework | (+) | learning harness、skill system、28K+ stars | 生态规模小于 OpenClaw |
| Claude Code | Coding agent | (+/-) | 从 $0 到 $1B ARR,在 harness engineering 中占主导地位 | 源码泄露暴露了漏洞,Cowork 存在文件外传问题 |
| Cursor Agent | Coding agent | (+) | 在 offensive AI 方面取得了与 Claude Code 相当的结果 | 社区文档较少 |
| DSPy | Agent optimization | (+) | 在多轮 hype 周期中保持了一致的方法 | 相比热门路线显得逆势 |
| LangGraph | Orchestration | (+) | 为 DeerFlow 2.0 提供底层能力,框架成熟 | 复杂度开销较高 |
| DeerFlow 2.0 | Agent framework | (+) | 30K+ stars、可插拔 skills、沙箱执行、sub-agents | 较新,文档以中文为主 |
| AutoAgent | Agent framework | (+) | 零代码、GAIA benchmark 领先、RAG 表现超过 LangChain | 仍处早期 |
| LiveKit | Voice infra | (+) | 100ms TTFB、支持发音控制的音标括号 | HIPAA 合规性不确定 |
| Chatbase | Voice agent | (+) | 全渠道(email、web、phone) | 新功能,历史记录有限 |
| Grok Voice | Voice agent | (+/-) | $0.05/min 定价、实时通话 | 激进定价可能意味着能力或边界上的取舍 |
| Weaviate | Vector DB | (+) | Agent Skills 支持 PDF 导入、ColModernVBERT | 生态仍在形成中 |
| Composio | Agent auth | (+) | 试图解决权限范围控制缺口 | 刚发布,尚未证明可大规模落地 |
| GLM-5.1 | LLM | (+) | 在 SWE-Bench Pro 上达 SOTA(58.4),可处理 1000s of tool calls | 较新,第三方验证有限 |
| CoPaw | Agent framework | (+) | 本地优先、Ollama + Qwen 3.5、自托管 | 早期项目,来自中国 |
当前最核心的张力,在于 OpenClaw 的生态覆盖面与其安全负债之间的矛盾。多位构建者正转向 Hermes Agent 或自托管技术栈。voice agent 这一类别也在迅速向 LiveKit 的基础设施集中,Chatbase 和 Grok 则在部署模式与定价上展开竞争。模型层则更加多元化,GLM-5.1 和 Qwen 3.5 正在 agent 任务上挑战 Claude 和 GPT 的主导地位。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| AI-Trader | @hasantoxr | agents 发布交易信号、辩论并执行交易的 marketplace | 自主多资产交易 | OpenClaw, MIT License | Shipped | ai4trade.ai |
| Hurmoz | @Mosescreates | 为 Hermes Agent 提供 63 个阿拉伯语 AI skills | 过去任何 agent 平台都没有阿拉伯语 skills | Hermes Agent, Claude Code | Shipped | github.com/Moshe-ship/hurmoz |
| Dash v2 | @ashpreetbedi | 具备 6 层 context 的自学习数据 agent | text-to-SQL agents 无法处理隐性知识 | Python, Docker, SSE | Beta | GitHub |
| AgentHandover | @tom_doerr | 从 Mac 工作流生成 agent skills | agents 不懂你的实际工作流程 | macOS, local-first | Beta | github.com/sandroandric/AgentHandover |
| AgenC | @tetsuoarena | 可持续构建一整年的 agent | 长周期自主构建 | Google Concordia, TUI | Alpha | 帖子 |
| Grok CLI + x402 | @pelaseyed | 首个通过 Coinbase 拥有原生钱包的 agent | 安全的自主 agent 支付 | Coinbase, brin-sh | Beta | 帖子 |
| nanostack | @gus_aragon | 带 git 强制约束的极简 AI coding agent skills | 模型会在简单任务上跳过指令 | Git hooks, Opus 4.6 | Alpha | 帖子 |
| NameLessAiii wiki | @NameLessAiii | 从 agent 配置自动生成持续更新的知识库 | agent 安装缺乏文档 | Hermes Agent | Shipped | GitHub |
Hurmoz 值得关注:这是任何 AI agent 平台上的首个、也是规模最大的阿拉伯语 skills 集合——63 个 skills,分属 10 个类别,覆盖 Islamic tools、5 种阿拉伯语方言、20 个沙特政府 APIs、NLP tools,以及首个阿拉伯语 Siri 集成。整个项目完全由 Claude Code 构建。

Dash v2 的安全优先架构尤为突出:Analyst 的 SQL 连接拥有 default_transaction_read_only=on,Engineer 只能写入 dash schema;其 eval suite 会测试凭证泄露尝试和破坏性 SQL 执行。它的学习循环意味着“每次查询都会让下一次查询变得更好”。
AgentHandover 采用了一种新颖的技能创建方式:它会观察你在 Mac 上如何工作,理解你在做什么、为什么这么做,然后生成 agent skills,让任何 agent(OpenClaw、Claude Code、Codex)都能复现这套工作流。
6. 新动态与值得关注的内容
OpenAI 的 Dark Factory:零人工代码,零人工审查
Ryan Lopopolo 对 OpenAI Frontier 的 Symphony 系统所作的详细介绍,是目前公开案例中最极端的 agent-only 开发样本:一个团队正在交付生产软件,代码库规模达 1M+ LOC,没有任何人类编写的代码,也没有任何代码在合并前经过人工审查。关键洞见在于:当 agent 失败时,这个团队不会去想“怎样把 prompt 写得更好”,而是会追问“缺了什么能力、上下文或结构?”——这正是 harness engineering 的实践(来源)。
GitHub 为 Copilot CLI 推出 Rubber Duck Agent
@burkeholland 报道称,GitHub Research 发布了一个 “Rubber Duck” agent,可自动让另一个 AI 家族的模型给出审查意见。他们的数据表明,跨模型审查能够带来可量化的质量提升(帖子)。
面向 Agent Swarms 的 Amazon S3 Files
@skeptrune 强调了 Amazon S3 Files——首个支持完整 POSIX 文件系统访问的云对象存储——可能成为 agent 基础设施的游戏规则改变者:“你不再需要启动一个 sandbox vm 来给 agents 提供 POSIX 工具访问。现在你可以把任意规模的算力指向 s3,在同一个文件系统上运行大规模并行的 agent swarms”(帖子)。
作为私有 Agent 基础设施的 Gemma 4
@RoundtableSpace 指出,Google 发布的 Gemma 4 具备本地多模态推理、function calling 和 OpenClaw 兼容性,可能会“让替代订阅制 AI 变得现实得多”(帖子)。
Southwest Airlines 部署 GitLab Duo Agent Platform
@bjmtweets 报道称,Southwest Airlines 已在 3,000+ 名工程师中采用 GitLab Duo Agent Platform,目标包括让 pipeline 组件升级实现 90% 自动化、自动修复 CVE,并用 agents 让“技术债成为过去”(帖子)。
7. 机会在哪里
[+++] Agent 安全与治理基础设施 —— 12% 的 marketplace 恶意软件、1000+ 个恶意 skills、主流平台中尚未修复的漏洞,以及面向自主 agent 交易几乎为零的治理基础设施。@theboundlessvc 将其称为“一个大多数人还没命名的类别”。第 1.2、2 和 3 节中的多条讨论都证明了这类需求的紧迫性。agent 能力与安全基础设施之间的鸿沟仍在扩大。
[+++] 技能发现与质量保障 —— 研究已经证明,skills 在更真实的环境中收益会下降。当前没有任何可用于生产的方案,能帮助 agents 从大型技能集合中查找、评估并适配技能。UCSB/MIT 论文提出的 query-specific refinement 提供了一个起点。再叠加 marketplace 恶意软件问题,一个具备安全意识的技能发现层将产生复合价值。
[++] Memory engineering 工具 —— 只有 14% 的企业 agent 试点进入了生产环境,而记忆架构是首要瓶颈之一。相关架构(5 类数据、衰减逻辑、跨会话保留)已经定义清楚,但还没有开箱即用的实现。先发优势仍在。
[++] 面向受监管行业的 voice agent 基础设施 —— LiveKit 在发音上的工作已经指明了路径:医疗、法律和金融领域的专业 voice agents 需要音标控制、合规认证和低于 100ms 的延迟。Chatbase 和 Grok 正在通用 voice 场景竞争,但受监管的垂直行业仍供给不足。
[+] 面向欠服务语言的本地化 skills —— Hurmoz 已经证明,单个开发者借助 Claude Code 就能搭建出一整个语言生态(63 个 skills、5 种方言、20 个 government APIs)。在此之前,阿拉伯语的 agent skills 为零。还有数十种语言和地区存在同样的空白。
[+] Agent-native 支付轨道 —— Grok CLI 的 Coinbase 集成和 ClawPlaza 的 USDC economy 只是早期信号。随着 agents 成为经济行为主体,能够处理自主交易中的安全、审计与合规问题的支付基础设施将成为刚需。
8. 要点总结
-
Harness engineering 已成为严肃 agent 开发的主导范式。 OpenAI 的 Frontier 团队正在操作一个 1M+ LOC 的系统,没有人工代码,也没有人工审查,每天消耗 1B+ tokens。社区共识正从“改进模型”转向“改进 harness”。(来源)
-
Agent 安全正处于危机之中。 OpenClaw marketplace 中有 12% 被标记为恶意软件,Claude 的一个重大漏洞仍未修复,而整个行业跳过了正常企业软件必须经历的每一道安全检查。针对自主 agent 交易的治理基础设施几乎不存在。(来源)
-
Agent skills 在真实条件下会退化。 UC Santa Barbara/MIT 基于 34K 个真实技能的研究显示,当 agents 必须自行发现技能时,性能会下滑到接近基线的水平。query-specific refinement 能部分恢复损失的性能。(来源)
-
Voice agents 正以差异化定价和专业化能力进入生产环境。 Chatbase 推出了全渠道 voice,LiveKit 以 100ms TTFB 解决了医疗术语发音问题,而 Grok 则将价格压到 $0.05/minute。(来源)
-
Memory engineering 正在成为一门独立学科。 其架构已被清晰描绘出来(5 类数据、衰减逻辑、跨会话保留),但只有 14% 的企业 agent 试点真正进入生产环境——记忆仍是关键瓶颈。“不要删除,要遗忘”是核心设计原则。(来源)
-
Agent marketplaces 已经开始产生真实收入。 ClawPlaza 报告 90 天平台收入达 $326K,AI-Trader 拥有 12K+ stars 并支持真实交易,多个平台也推出了按次调用计费的 skill 变现模式。agent economy 已不再只是理论。(来源)
-
本地化是一个广阔的机会窗口。 一名开发者构建了 63 个阿拉伯语 skills,覆盖 5 种方言和 20 个沙特 APIs——这是任何 agent 平台上的第一套阿拉伯语 skills。还有数十种语言目前没有任何 agent skill 覆盖。(来源)