Twitter AI Agent - 2026-04-08
1. 人们在讨论什么
1.1 Meta 发布支持原生多智能体编排的 Muse Spark 🡕
Meta Superintelligence Labs 发布了 Muse Spark,这是一款原生多模态推理模型,支持工具使用、视觉思维链和多智能体编排。该公告获得了超过 152K 次浏览,主导了当天的讨论。@alexandr_wang(Scale AI CEO)提供了技术分析,并指出 Muse Spark 展现出“在预训练、RL 和测试时推理上的可预测扩展”,还引入了“思维压缩”——即用显著更少的 token 解决问题的能力。
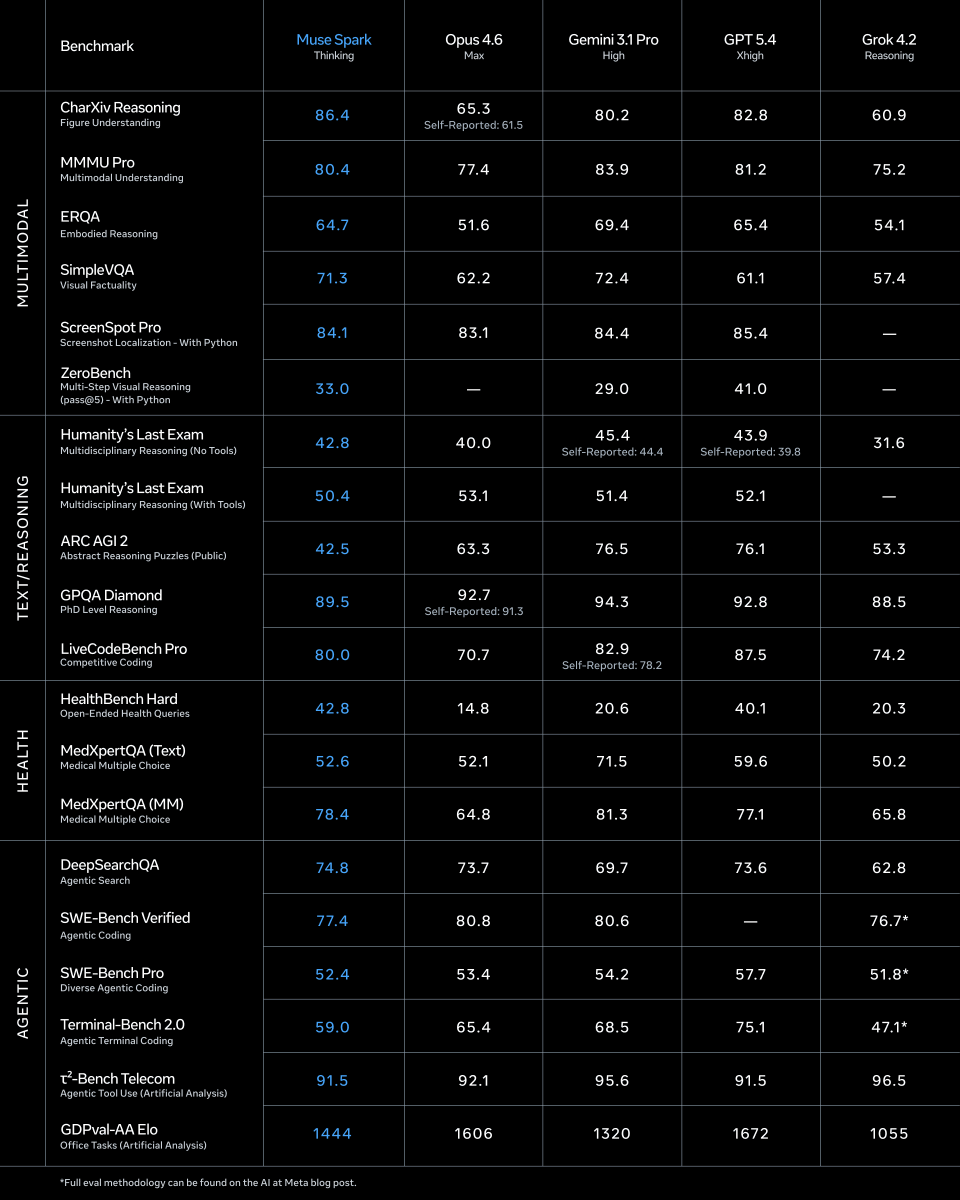
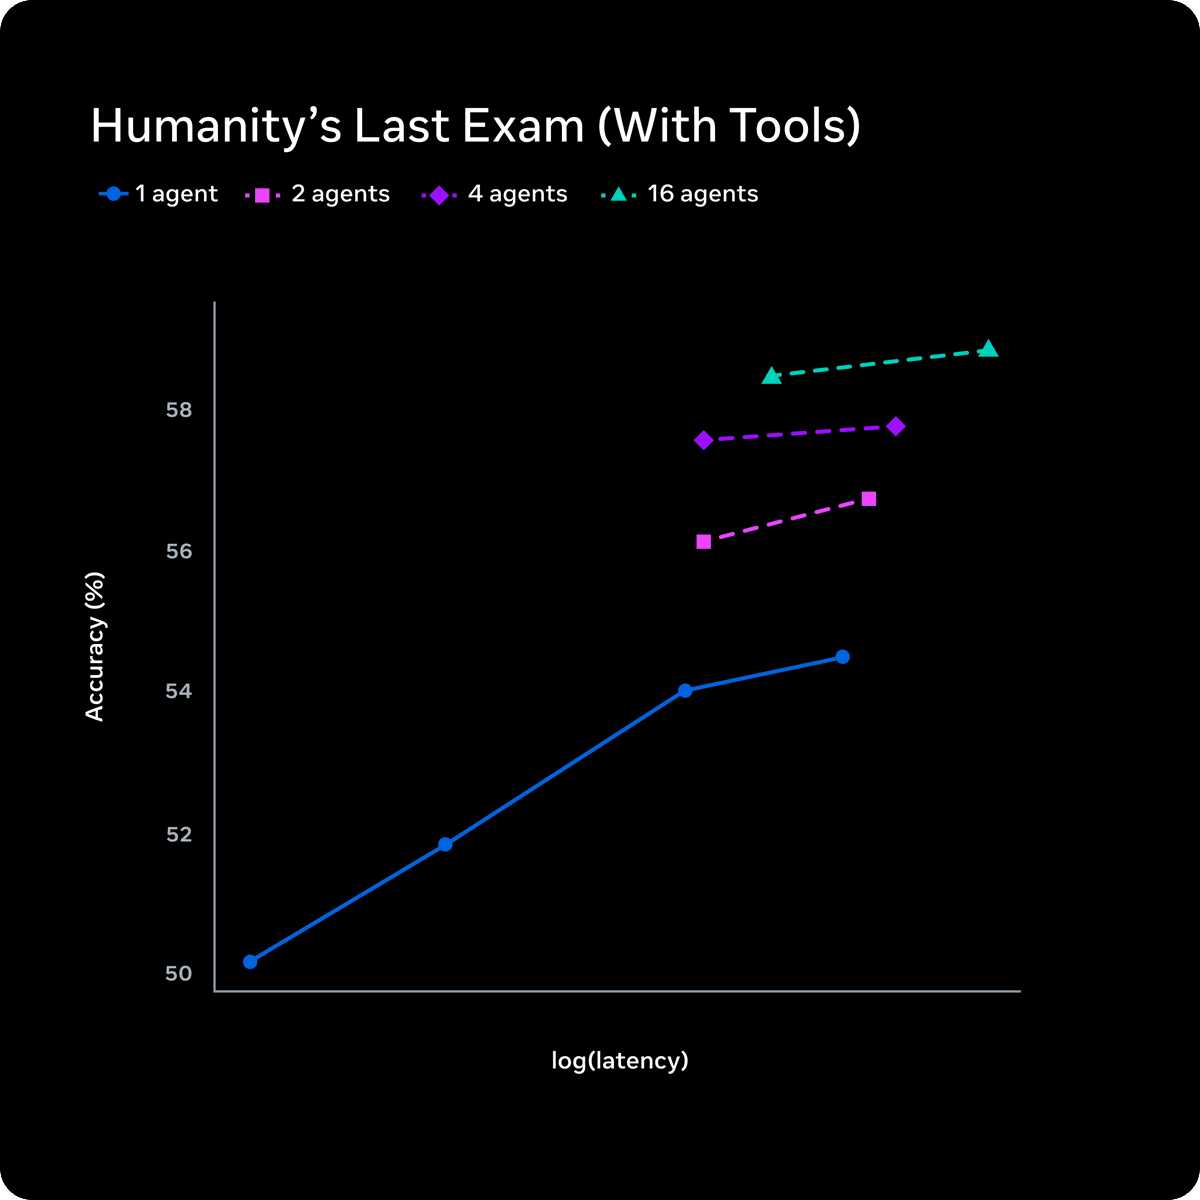
@jhyuxm 分享的基准测试表显示,Muse Spark 在 CharXiv Reasoning(86.4 对 65.3)、ScreenSpot Pro(84.1 对 83.1)和 HealthBench Hard(42.8 对 14.8)上领先 Opus 4.6,但在 ARC AGI 2(42.5 对 63.3)和 GPQA Diamond(89.5 对 92.7)上落后。该模型的“Contemplating mode”可编排多个智能体并行推理,而 @omarsar0 指出表示,这些智能体“在并行化的同时并未显著增加延迟”,并分享了一张图表:16 个并行智能体在 Humanity's Last Exam 上达到约 59%,而单个智能体约为 55%。
质疑声也很快出现。一位 回复指出,Meta“花了 140 亿美元,挖来了 Alexandr Wang,还从零重建了整套技术栈。结果第一个模型只排到第四”。@omarsar0则指出“仍存在一些缺口,尤其是在支持长时程智能体系统和编码工作流方面”。消息公布后,Meta 股价大幅反弹,@TrendSpider 观察到。
1.2 Anthropic 推出 Claude Managed Agents,对编排初创公司构成威胁 🡕
Anthropic 以公开测试版形式推出了 Claude Managed Agents,反响立刻出现。@trq212称其为 “首个在简洁性与复杂性之间实现恰当平衡的‘云端智能体’API”,并详细介绍了支持自定义软件包、凭据保险库、文件系统记忆和 GitHub 集成的环境。该推文获得 921 个赞和 402 次收藏。
@aakashgupta表示 Anthropic “直接让所有智能体编排初创公司大规模过时了”,并贴出一个生产环境集群控制台:8 个智能体正在运行,已完成 247 项任务,并集成了通过 MCP 连接的 HubSpot。“Manus 花了六个月重写五次 harness。LangChain 花了一年做了四套架构。Anthropic 刚刚发布了托管版本,直接让你连自己造都不用造了。”@shiri_shh说得更直白:“整个 AI 智能体创业赛道今天都被狠狠干翻了。”
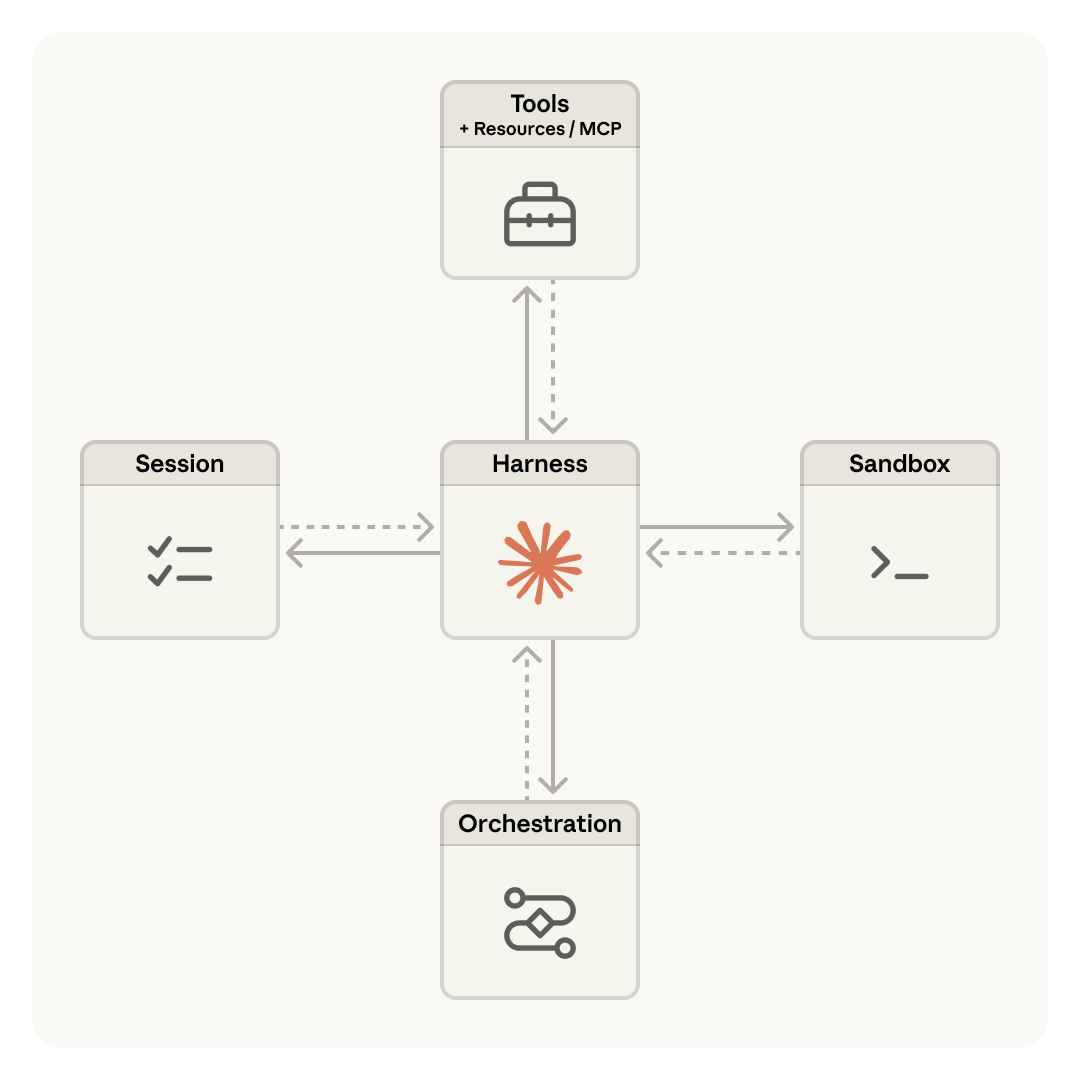
围绕架构的争论随之升温。@charlespacker 分享了 Anthropic 工程博客摘录描述了“宠物与牲畜”的容器问题——当智能体组件共用一个容器时,“harness 中的 bug、事件流中的丢包,或容器离线,最终都会呈现为同一种”故障模式。@alexgshaw 提问发问:“谁在构建‘Agent Sandbox Protocol’?”

Notion 宣布集成了 Claude agents,将 Notion 定位为编排层,而 Anthropic 负责运行模型和 harness。社区成员立刻追问是否会支持其他模型。
1.3 Skills 生态爆发,同时也暴露出裂缝 🡕
Agent skills 正在成为扩展智能体能力的主流范式。@gregisenberg发布了 详细拆解(398 次收藏),认为 agent.md 文件“多数情况下没必要”——一个 1000 行的文件每次运行都会消耗 7000 个 token,而一个 skill 在激活前只需加载名称和描述(约 50 个 token)。他的框架是:先手动跑通工作流,再让智能体编写 skill,之后一起递归修复失败点。
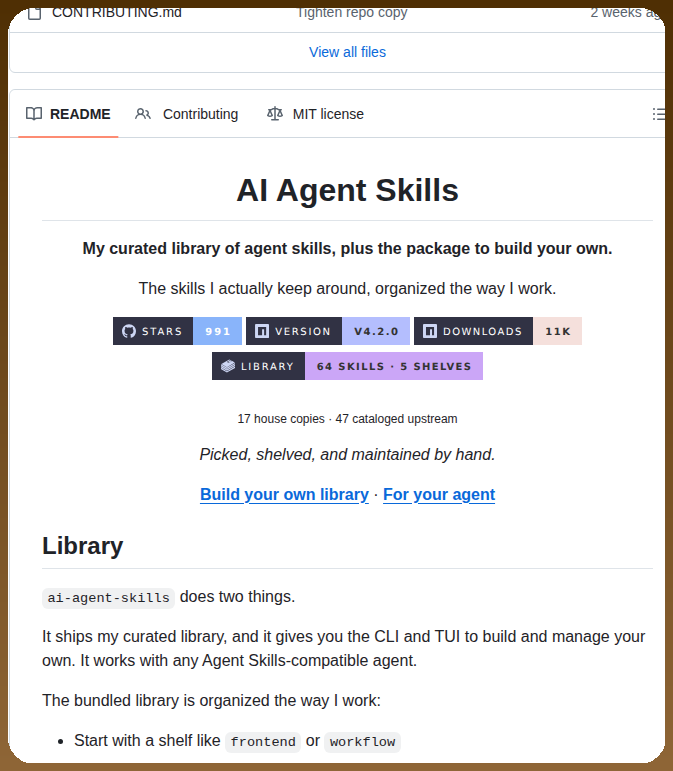
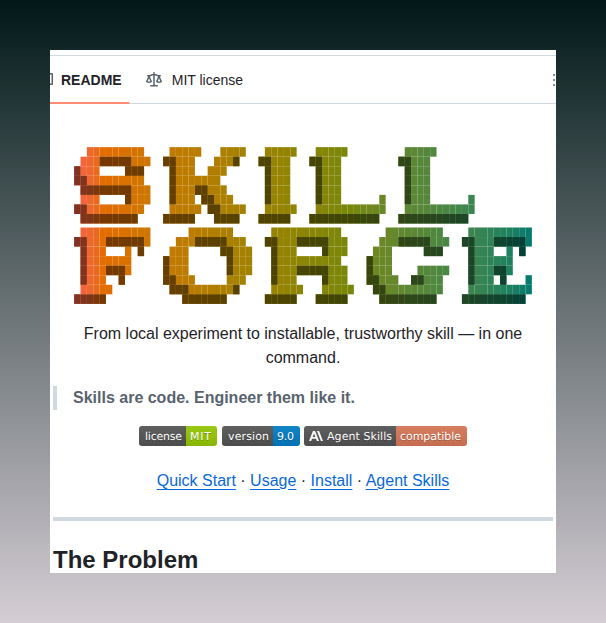
工具层正在迅速成熟。@tom_doerr分享了 AI Agent Skills(991 个 star、64 个 skills、11K 次下载)和 Skill Forge——一个可同时将 skills 审计并发布到五个平台的流水线。Skill Forge 的 README 揭示了一个令人警醒的数据:生态中已发布的 88K+ skills 里,社区审计估计约 26% 存在安全漏洞。@FOUNDATIONdvcs 证实了表示:“AI agent marketplace:12% 是恶意软件。”
多家厂商宣布支持 skills:MongoDB for Cursor、Coinbase Developer Platform 及其 MCP server、Lazer CLI(面向 Base 和 Farcaster 上的链上 mini apps),以及在一次更新中同时推出 skills + cloud + MCP 的 Enter Pro。
1.4 Harness Engineering 与 Context Engineering 走向成形 🡒
两个相关学科正逐渐以正式名称固定下来。@latentspacepod发布了 “Extreme Harness Engineering”,内容涉及 OpenAI 的 Symphony——一个“幽灵库”,其中的 Codex agents 每天生成 100 万行代码、消耗 10 亿个 token,“合并前人工编写代码为 0%,人工审查为 0%”。这场访谈还揭示了 harness engineering 在 OpenAI 内部如何从 GPT-5 演进到 GPT-5.4。
@IntuitMachine分享了一张 L1-L6 成熟度模型,梳理了从 prompt engineering(L1)到 context engineering(L2)、harness engineering(L3-L4),再到自我改进智能体(L6)的演进路径,并指出 L6 仍有一个尚未命名的行业空白:“Quality/Vitality Engineering”。

@helloiamleonie(Elastic)发布了关于“Agentic Search for Context Engineering”的 AI Engineer Europe 的工作坊。@DSPyOSS 声称称自己似乎预判了每一波趋势:“2024:agentic workflows!我们:DSPy。2025:context engineering!我们:DSPy。2026:harness engineering!!我们:DSPy。”
1.5 智能体基础设施:S3、沙箱与操作系统之问 🡕
@skeptrune 认为认为 Amazon S3 Files 对智能体具有变革性意义:“你不再需要启动 sandbox vm,才能让智能体访问 POSIX 工具。现在可以把任意规模的算力指向 s3,在同一文件系统上运行大规模并行的智能体群。”该推文获得 632 次收藏,是当天收藏率最高的内容。后续讨论则适度降温,指出要挂载这个文件系统,仍然需要沙箱。
@NathanFlurry 描述了正在构建开源沙箱基础设施:“任何智能体,任何 LLM,每个沙箱仅需 22 MB RAM,支持 BYOC/on-prem,支持任何文件系统。”
@HSVSphere提出了 逆向观点:“不存在什么特殊的‘未来智能体沙箱’,未来是一种建立在动态语言之上的操作系统,为一切提供能力以及(内生的)作用域。”讨论将其与 Plan9 和 Ruby 相提并论,同时认为 TypeScript“过于静态”。
2. 什么让人感到沮丧
智能体安全与信任(严重程度:高)
Skills 生态增长的速度,已经超过安全基础设施跟进的速度。Skill Forge 审计发现 已发布的 8.8 万多个技能中,约 26% 存在安全漏洞。@JamesonCamp 警告称:“OpenClaw 的 marketplace 中有 12% 根本就是恶意软件。键盘记录器。身份盗窃。你的 AI agent 正在从陌生人那里安装软件包。”@conor_ai 强调了则指出信息泄露问题:“智能体可能而且确实会把敏感信息分享给它们正在交谈的任何对象”,这促使 Hyperspell 设计出受《人生切割术》启发的“innie/outie”智能体架构。
平台风险与初创公司焦虑(严重程度:高)
Anthropic 推出 Managed Agents 后,编排初创公司出现了生存焦虑。@SolSt1ne 道出了当时的氛围写道:“花了 6 个月构建自定义 agent 基础设施、编排、重试逻辑、限流,终于‘能上生产了’,Anthropic 却在公开测试版里发布了 Claude Managed Agents。”@aakashgupta 指出指出,Anthropic 在四天前刚禁止第三方 harness 使用订阅凭据,随后就推出了替代方案。
上下文窗口管理不当(严重程度:中)
@gregisenberg 发现了指出了一种普遍存在的反模式:在 agent.md 文件里塞入过多指令,导致每次运行都要消耗 7000+ token,并拖累性能。“越接近把上下文窗口塞满,智能体表现就越差,就像别人一次性把 10 件事全甩给你时,你的表现也会变差一样。”
智能体记忆丢失(严重程度:中)
@Mr_memsy 指出表示:“默认配置忘得很快。”如果没有时间衰减、嵌入缓存和治理文件,智能体“不会积累知识,而是会幻觉出过时上下文”。@bellman_ych 描述了则说,自己在凌晨 3 点读完“60MB 泄露的 JS”,到吃早饭时已经在问“oh-my-claudecode 到底又是什么来着”。
3. 人们希望出现什么
Agent Sandbox Protocol
@alexgshaw 提问发问:“谁在构建 Agent Sandbox Protocol?一种让用户能够指定第三方智能体在哪里执行工具的方式。”Anthropic 的博客描述了如何通过工具调用将“大脑与双手”解耦,但目前仍不存在厂商中立的标准。
带验证机制的安全 Skills Marketplace
多个信号指向同一结论:26% 的 skills 存在漏洞,而一些 marketplace 中有 12% 是恶意软件。Skill Forge 会扫描泄露的 API keys 并阻止严重问题,但整个生态仍缺少一个可信、经过筛选、能基于真实使用情况排名的 marketplace。OKX 的 Plugin Store承诺“在一个地方搜索、安装和分享 Skills,并按真实使用量排名”——但验证问题仍未解决。
长时程智能体可靠性
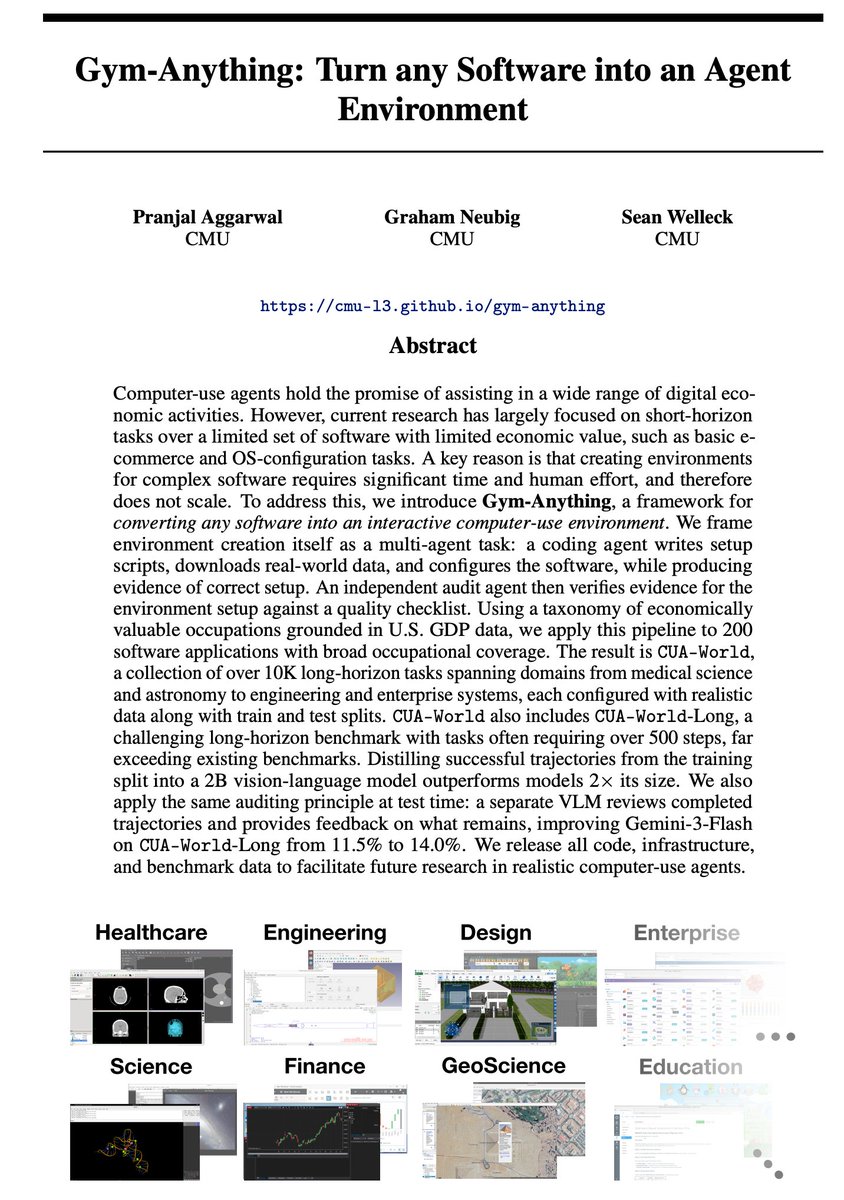
Gym-Anything 基准测试表明,显示最佳模型(GPT-5.4)在 500+ 步任务上的通过率也只有 27.5%。@tetsuoarena正在 构建 AgenC,目标是实现“一个能够连续构建整整一年而不停下来的智能体”——但这一目标仍然停留在愿景层面。
面向智能体的身份与访问管理
@conor_ai的 innie/outie 模式只是一个变通方案。目前还没有标准,能够根据智能体交互对象的不同,限定它可以访问哪些数据。@ashpreetbedi通过 Dash 的数据库级 RBAC为数据智能体解决了这个问题,但这种方法仍然局限于特定领域。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Claude Managed Agents | 智能体平台 | 正面 | 生产环境集群管理、MCP 集成、凭据保险库、沙箱抽象 | 私测 API 访问受限,存在厂商锁定风险 |
| Claude Skills / agent.md | 智能体配置 | 褒贬不一 | Skills 仅加载 50 个 token,而 agent.md 需要 7000 个;支持递归改进 | 已发布 skills 生态中有 26% 存在漏洞 |
| OpenClaw | 开源智能体框架 | 正面 | 本地运行、隐私优先,集成 WhatsApp/Telegram,支持 /dreaming 记忆 | marketplace 中有 12% 是恶意软件,由社区维护 |
| LangGraph | 编排 | 正面 | 适合生产的有状态工作流、检查点机制 | 对简单用例来说较复杂 |
| CrewAI | 多智能体团队 | 正面 | 可快速搭建面向营销、研究和运营的角色化团队 | 不太适合生产级规模 |
| DSPy | 智能体编程 | 拥有忠实追随者 | 在范式变化中保持一致的框架 | “预见每一波趋势”的说法受到质疑 |
| Skill Forge | Skill CI/CD | 正面 | 可发布到 5 个平台,支持安全扫描和结构验证 | 解决的是生态质量问题的症状,而非根因 |
| Gym-Anything | 智能体评估 | 前景可期 | 覆盖 200+ 款真实软件、10K+ 项任务,成本降低 80%-90% | 最强智能体在长时程任务上的失败率仍达 72.5% |
| Dirpack | Context Engineering | 正面 | 确定性上下文打包、Claude Code 插件、缓存 | 仍处于早期阶段 |
| Rime Mist v3 | 语音智能体 TTS | 正面 | 通过音标括号实现确定性发音,TTFB 为 100ms | 除英语外的语言支持尚不明确 |
| Prefab (FastMCP 3.2) | 生成式 UI | 早期 | 用 Python 提供 100+ 个 shadcn 组件,无需 JavaScript | 刚刚发布 |
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Dash v2 | @ashpreetbedi | 具备 6 层上下文的自学习数据团队 | 缺乏部落知识时,Text-to-SQL 智能体会失败 | Python、PostgreSQL、JWT RBAC | 开源,预发布 | 推文 |
| Skill Forge | motiful | 审计、验证并将 agent skills 发布到 5 个平台 | 26% 的 skills 存在安全漏洞 | Python、CLI | v9.0、MIT | GitHub |
| Gym-Anything / CUA-World | @wellecks、@PranjalAggarw16(CMU) | 将任意软件转化为智能体训练环境 | 智能体基准测试局限于消费类应用中的短任务 | Python、VM 编排 | 论文与代码已发布 | 网站 |
| AI Agent Skills | @tom_doerr | 提供用于构建和管理的精选 skills 库,以及 CLI/TUI | Skills 分散,缺乏标准化管理 | CLI/TUI、MIT | v4.2.0、991 个 star | 推文 |
| Sandbox Search | @arlanr | 代码库搜索,为智能体提供有依据的仓库信息 | 智能体缺少来自代码库的可靠上下文 | 搜索基础设施 | 已发布 | 推文 |
| FinalRun Agent | final-run | 通过自然语言 YAML 规范进行 AI 驱动的移动应用测试 | 手动移动应用测试缓慢且脆弱 | Node.js、Gemini/GPT/Claude、Apache 2.0 | 已发布到 npm | GitHub |
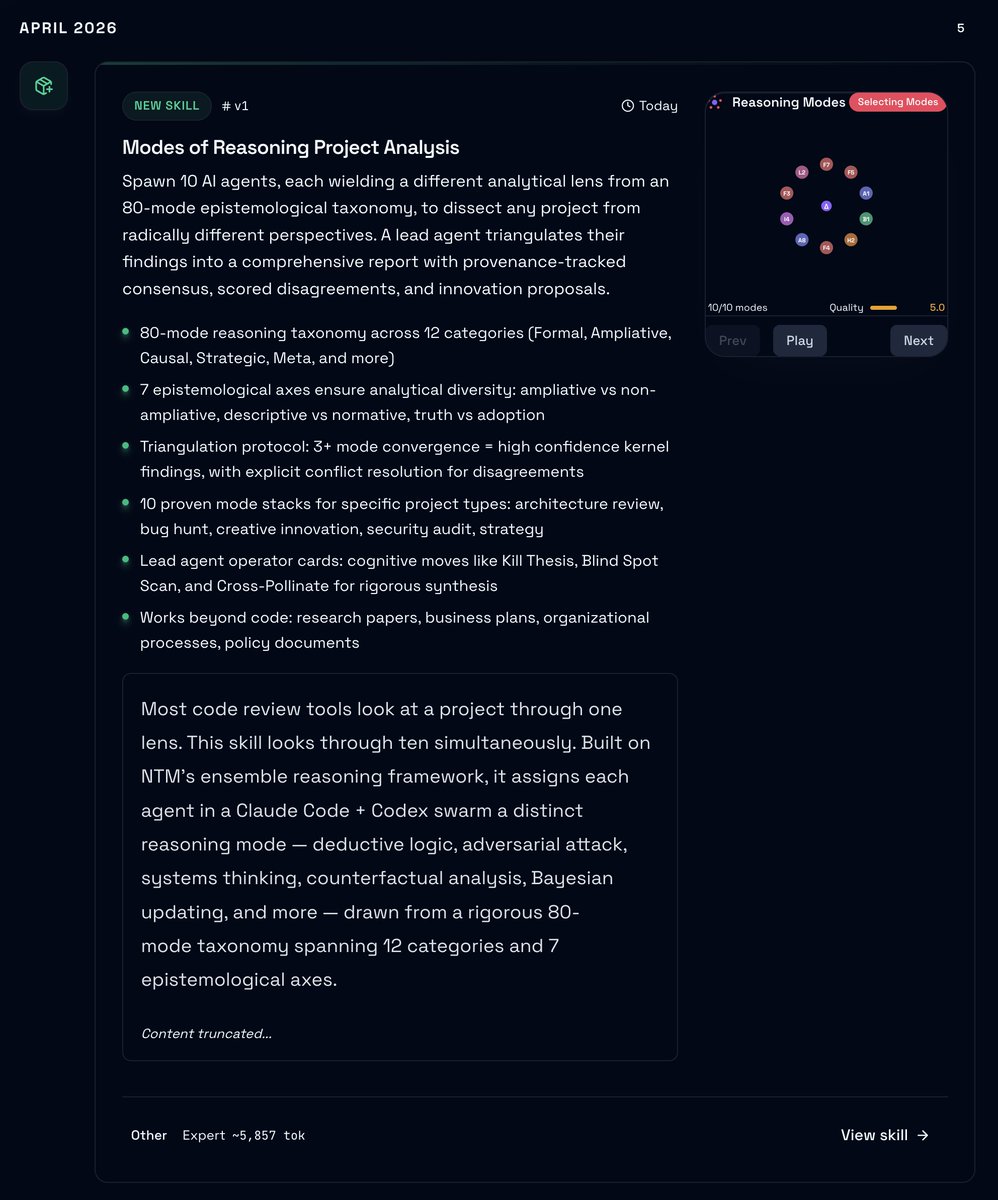
| NTM Orchestration | @doodlestein | 使用 80 种推理模式分类法的智能体群 | 代码审查工具往往只采用单一分析视角 | Claude Code + Codex swarm | 概念/原型 | 推文 |
| Prefab | @jlowin(Prefect) | 用 Python 为 MCP 应用提供生成式 UI 框架 | 构建智能体 UI 需要 JavaScript | Python、React/shadcn、FastMCP 3.2 | 已发布 | 网站 |
| AgenC | @tetsuoarena | 具备防注入加固能力的长期运行自主智能体 | 智能体无法维持长时程工作 | Google Concordia、TUI | 持续开发中 | 推文 |
| Dirpack | @raw_works | 搭配 Claude Code 插件的确定性上下文打包 | 上下文组装缺乏确定性 | CLI、插件系统 | 已发布 | 推文 |
| SkillX | @zxlzr | 根据智能体轨迹自动构建 skills 知识库 | 手动编写 skills 无法规模化 | 研究论文 | 论文阶段 | 推文 |
Dash v2的安全模型尤其突出:分析师的 SQL 连接使用 default_transaction_read_only=on,工程师只能写入 dash schema;评估套件还会明确尝试泄露凭据、执行破坏性 SQL,以及跨越 schema 边界。其学习循环同时存储精选知识(由人工维护的已验证查询和业务规则)与发现知识(由智能体维护的错误模式和各种坑点)。
Gym-Anything填补了智能体评估中的一个根本性空白。当前基准测试主要考察消费类应用中的短任务,但真实工作发生在专业软件中——放射学工具、ERP 系统、地震监测器等。通过使用智能体来构建智能体环境,CUA-World 在覆盖全部 22 个美国 SOC 职业组、200+ 款应用的同时,将成本较标准部署降低了 80%-90%。
NTM 的推理编排为 Claude Code + Codex swarm 中的每个智能体分配一种独特的推理模式。这套 80 模式分类法横跨 12 个类别和 7 个认识论轴,包括演绎逻辑、对抗性攻击、反事实分析和贝叶斯更新;随后,系统再通过带来源追踪的共识机制对发现进行交叉验证。
6. 新鲜且值得关注的动态
AI 智能体发现真实漏洞
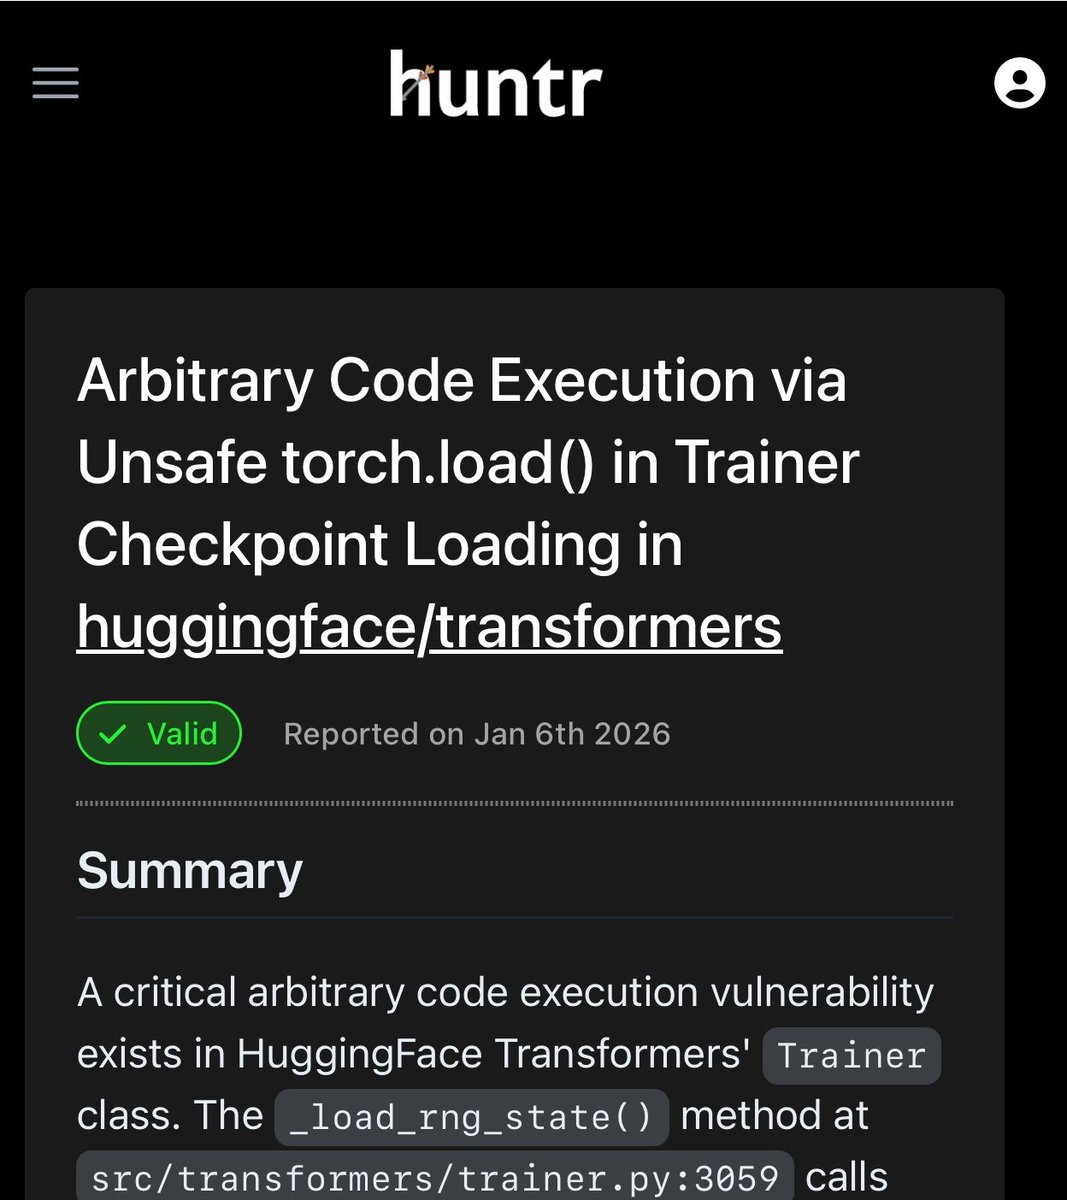
@_colemurray 披露了表示,他的 AI 安全智能体“waclaude”发现了 CVE-2026-1839:HuggingFace 的 Transformers 库中存在通过不安全的 torch.load() 实现任意代码执行的漏洞。该漏洞只是 PyTorch checkpoint 加载中的一行代码。这是智能体能够开展有用安全研究、而不只是生成报告的一个具体证明。PHALANX 和 METATRON等专注安全的智能体 harness(完全离线运行,使用本地 LLM)正作为一个独立类别出现。
复古电话在伦敦 AI Engineer 大会上遇上语音智能体
@ktoya_me 将 ElevenLabs 语音智能体连接到一部复古拨号电话被放置在一个红色英国电话亭内,并在 London AI Engineer 大会上展出。该电话由 Claude 辅助逆向工程,并集成了 ElevenLabs Agent。这个装置获得 64 个赞和 5K+ 次浏览——让与会者能够亲手互动,成为语音智能体技术的一次具象展示。

Southwest Airlines 大规模部署 GitLab Duo Agent Platform
@bjmtweets 报道称称,Southwest Airlines 正在为其 3,000+ 名工程师采用 GitLab Duo Agent Platform,目标是提升 30% 的生产力。这是目前已披露的规模最大的企业 AI 智能体部署之一,并给出了明确的规模与 ROI 数据。
SkillX:根据智能体轨迹自动构建 Skills
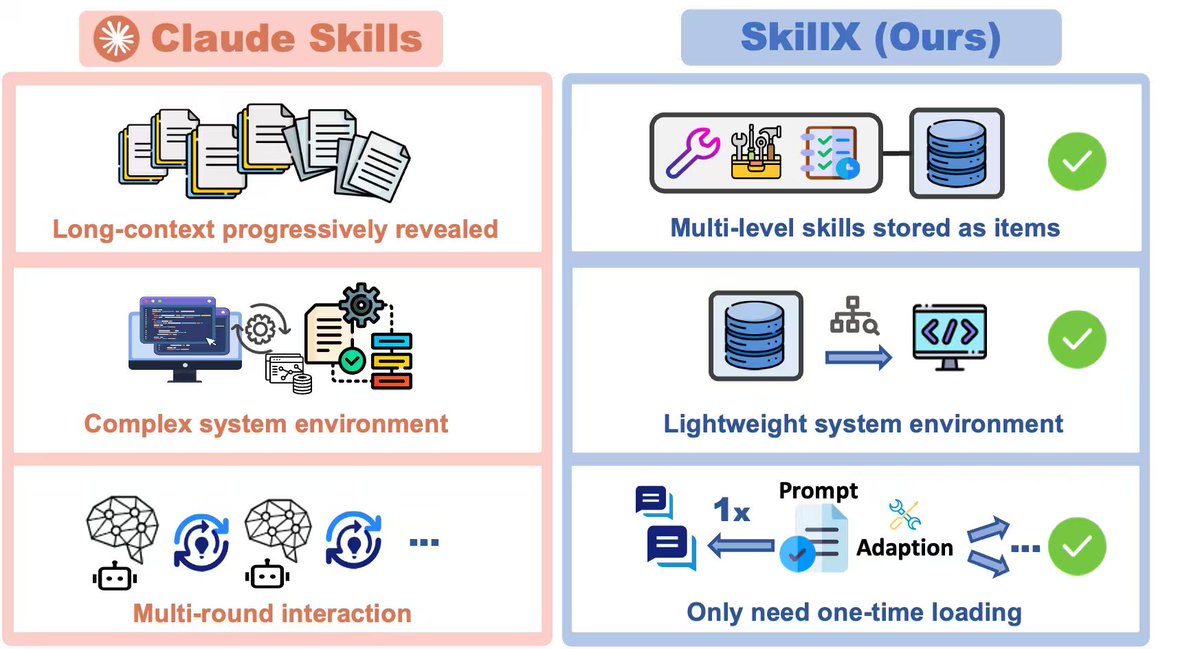
@zxlzr 分享了介绍了 SkillX,这是一套可自动将智能体轨迹转换为可复用、可索引 skills 的研究系统。与需要长上下文渐进式揭示的 Claude Skills 不同,SkillX 将多层级 skills 存储为条目,只需一次加载,系统要求也更轻量。
自我修复智能体
@witcheer 记录了介绍了一个智能体,它“通过自我反思循环,诊断并修复了 GPT/Codex 工具调用中的 5 种自身故障模式”。@gregisenberg也描述了这种递归式自我修复模式:“直接问智能体它究竟为什么失败。它会明确告诉你具体出了什么问题。在同一段对话里和它一起修复。然后让它更新 skill 文件,确保这种故障模式不再发生。”
7. 机会在哪里
[+++] 强:Agent Skills 质量与安全基础设施。 已发布的 skills 已超过 88K,其中 26% 存在漏洞,一些 marketplaces 中有 12% 是恶意软件。Skill Forge 可以处理单个仓库,但在生态规模上,仍不存在具备自动扫描、按使用量排名和依赖分析能力的可信 registry。已发布内容与可安全安装内容之间的差距,正以任何单一工具都无法弥合的速度扩大。
[+++] 强:面向企业的托管智能体基础设施。 Anthropic 通过推出 Managed Agents 证明了市场需求。但企业需要厂商中立的选项、多模型支持和合规认证。46% 的企业表示,集成是它们在智能体方面的首要挑战。Notion 的集成模式——SaaS 作为编排层,模型提供商作为执行引擎——可能会成为数十种垂直应用的模板。
[++] 中等:长时程智能体评估与训练。 Gym-Anything 显示,最强模型在真实的 500+ 步任务中仍有 72.5% 的失败率。能够以 80%-90% 的成本降幅扩展到数千个副本的智能体训练基础设施,将为专业化评估即服务提供商打开市场。面向医疗、金融和工程软件的领域专用基准测试,仍然是一片空白。
[++] 中等:智能体记忆与知识复利。 当前智能体默认就是会遗忘。正在出现的解决方案——时间衰减、嵌入缓存、/dreaming 模式、BRAID 治理文件——彼此割裂,而且依赖具体框架。一个跨平台的智能体记忆层,如果能处理持久化、相关性衰减和多会话知识复利,将能解决多位构建者都提到的痛点。
**++] 中等:语音智能体垂直解决方案。** LiveKit 的 [Rime Mist v3 集成的音标括号功能,展示了受监管行业所需的精细程度。@yourealazyfvck 备注表示,语音智能体可以以“相同价格”交付,却比多工具自动化简单得多。发音、合规和领域术语在规模化应用中仍未解决。
[+] 新兴:Agent Sandbox Protocol 标准化。 目前不存在用于指定智能体在哪里执行工具的厂商中立协议。Anthropic 将大脑与双手解耦;AWS 提供 S3 Files;开源项目提供 22MB 沙箱。无论是标准组织还是事实标准协议,只要能为智能体执行环境建立规范,都将有助于减少碎片化。
[+] Emerging: Automated Skill Generation from Trajectories. SkillX demonstrates that agents can convert their own successful runs into reusable skills. Combined with @gregisenberg的递归 skill 构建工作流也指向了一类自我改进的智能体系统:能够自己制造能力。目前这仍处于研究阶段,但生产应用前景已经相当明确。
8. 要点总结
-
Meta 凭借原生多智能体编排重返前沿模型竞赛。 Muse Spark 的 Contemplating mode 可在不成比例增加延迟的情况下,让多个智能体并行推理;“思维压缩”则减少了 token 消耗。基准测试表明其表现有竞争力,但并不占据统治地位;长时程智能体式编码仍是短板。(来源)
-
Anthropic 的 Managed Agents 是一次平台级布局,对编排中间件层构成威胁。 Anthropic 通过提供带集群管理、凭据保险库和 MCP 集成的生产基础设施,把许多初创公司数年的路线图压缩进了一次发布。先封堵第三方认证、四天后再推出替代方案,这一时间顺序显示出其有意整合生态。(来源)
-
Agent skills 正在成为新的软件包生态,但它们正面临安全危机。 已发布 skills 超过 88K,其中 26% 存在漏洞,一些 marketplaces 中有 12% 是恶意软件。Skill Forge 及类似工具解决的只是症状;整个生态缺少能够规模化运行、相当于 npm audit + 已验证发布者的机制。(来源)
-
Context engineering 和 harness engineering 正在固化为正式工程学科。 一套 L1-L6 成熟度模型梳理了从 prompt 技巧到自我改进智能体的演进。OpenAI 的 Symphony 展示了终局形态:每天 100 万行代码、10 亿个 token,人工编写代码和人工审查均为零。这个终局与大多数团队当前实践之间,仍有巨大距离。(来源)
-
更真实的智能体基准测试揭示了严酷的限制。 Gym-Anything 的 CUA-World-Long 让智能体面对专业软件中的 500+ 步任务,而最佳模型的通过率仅为 27.5%。演示级智能体表现与真实专业工作流中的生产可靠性之间的差距,仍是这一领域的核心挑战。(来源)
-
用 Skills 取代 agent.md 文件,正逐渐成为共识性的最佳实践。在每次对话中加载整份指令文件既浪费 token,也会降低性能。按需激活的 Skills,再配合递归改进工作流,能产出更可靠的智能体。实操建议是:先从手动工作流开始,让智能体编写 skill,再围绕失败点持续迭代。(来源)
-
AI 智能体正在发现真实的安全漏洞。 一个 AI 安全智能体在 HuggingFace Transformers 中发现了 CVE-2026-1839——一个真实存在的任意代码执行漏洞。PHALANX、METATRON 等专注安全的智能体 harness 正在形成独立品类,它们使用本地 LLM、完全离线运行。由智能体驱动的安全研究,正从理论走向有效产出。(来源)