Twitter AI Agent - 2026-04-11
1. 人们在讨论什么
1.1 Agent Skills 正成为标准知识层 🡕
Agent Skills 这种格式——即用 Markdown 文件编码、供 AI 编程工具调用的流程性知识——本周跨过了临界点。多个彼此独立的信号表明,它已不再只是 Claude 专属的小众新奇玩意,而正在成为一种新兴的跨平台标准。
@xelebofficial 发布了 误区讨论帖,论证 Skills 并不是“只是一段很长的提示词”(Skills 可跨任务持久存在,而提示词用完即消失),也不需要会写代码(它们本质上就是 Markdown),并且适用于 GitHub Copilot、Cursor、Gemini CLI 和 Windsurf,而不只是 Claude。文中最具挑衅意味的观点是:“价值最高的 Skills 很少与代码有关。它们关乎你的团队如何写提案、如何组织报告、如何处理客户升级问题。”

@code_rams 宣布推出 autoskills。这是一款 CLI 工具(npx autoskills),能够识别项目的技术栈,并从 skills.sh 的精选注册表中自动安装匹配的 skill 文件,支持 50 多种技术。一条来自 @safaa_9411 的回复提出,如果 skills 在加载前未经过安全审查,可能会带来提示词注入风险。
@tom_doerr 分享了 Paul Hudson 的 Swift Agent Skills 仓库——这是一个面向 Swift 和 Apple 平台开发的开源 skills 精选集,按框架分类组织(SwiftUI、SwiftData、Swift Concurrency 等),并在显著位置提醒用户:安装第三方 skills 前应先审查。
@dshukertjr 正式发布了官方 Supabase Agent Skills,把最新的产品知识和文档打包成 skills——这标志着平台厂商开始以 agent 可直接消费的文件形式分发文档,而不再只是提供给人阅读的网页。
@AlphaSignalAI 报道了 Google 工程师的开源 Agent Skills 仓库,其中编码了 19 项工程 skills 和 7 个斜杠命令,覆盖完整开发生命周期:先写规范,再写代码;先测试,再合并;先度量,再优化。它可用于 Claude Code、Cursor,或任何能够读取 Markdown 的 agent。
@DipanshuKu55175 汇总了 Anthropic 的 13 门免费认证课程,其中包括《Agent Skills 入门》和《MCP 高级主题》——这是一次分量十足的教育投入,显示 Anthropic 正在加码生态增长。
1.2 Harness Engineering 正在固化为一门学科 🡕
“模型周围的代码比模型本身更重要”这一想法,本周不仅获得了更多实证支持,也首次迎来了接近教材篇幅的系统性阐述。
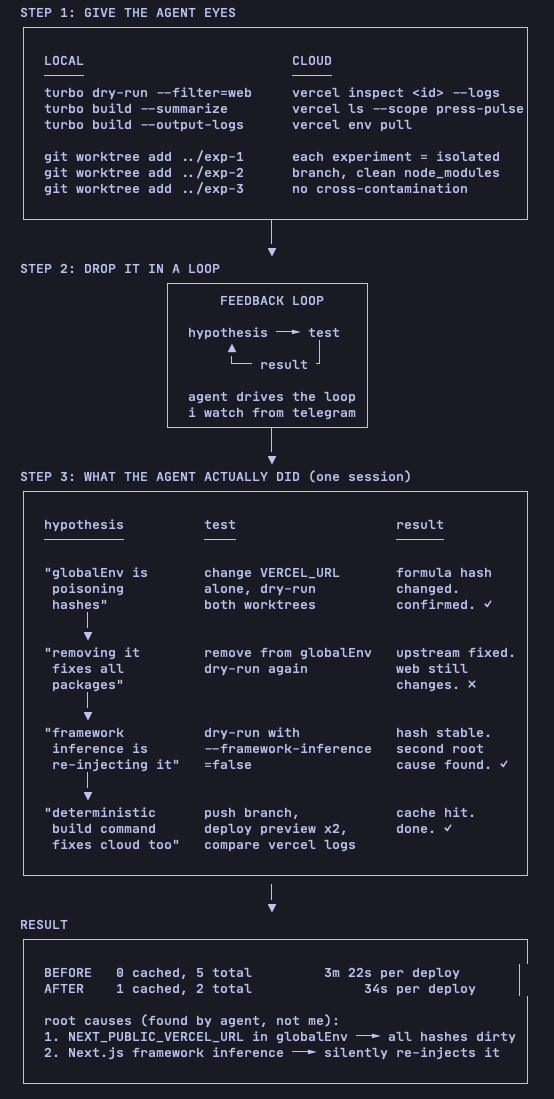
@elvissun 发布了 当天最高分推文(464 个赞,744 次收藏),介绍 Codex 在获得合适 harness 后,如何“单次就修好了我们的 turbo cache 问题”。这是一个 agent 调试循环,把构建时间从 3 分 22 秒缩短到 34 秒。配图展示了一套结构化的三步方法:给 agent 配上诊断之眼(本地和云端工具)、把它放进“假设—测试—结果”的反馈回路、然后让它驾驶,工程师则通过 Telegram 旁观。
@IntuitMachine 介绍了 关于 Meta-Harness 论文的深度讨论帖(arXiv:2603.28052v1):自动化 harness 优化比人类专家高出 7.7 分,消耗的 token 少 4 倍,并且能泛化到未见过的模型。其关键发现是:仅靠改 harness,同一个冻结模型就能产生 6 倍的性能波动。
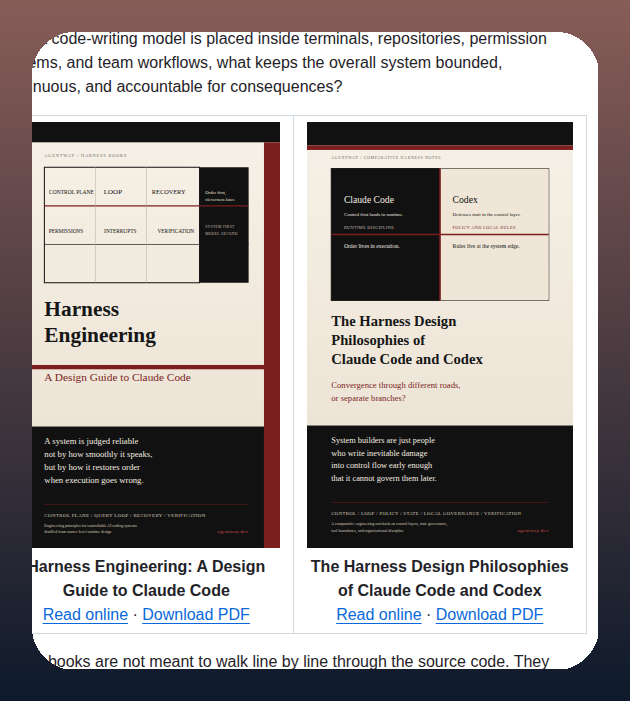
@tom_doerr 分享了 两本关于 harness engineering 的完整书籍(托管于 harness-books.agentway.dev):一份 Claude Code 设计指南,以及一项比较 Claude Code 与 Codex 设计哲学的研究。其核心观点是:“Harness engineering 关注的是约束结构如何组织执行。”
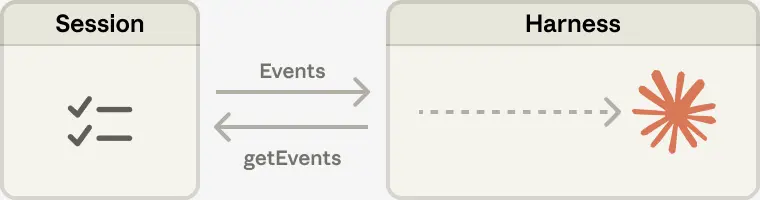
@RLanceMartin 讨论了 session-harness 解耦,提出一种架构:把 session 视为一个可供“大脑”查询的上下文对象。其关键洞见是:“没有任何上下文工程是不可逆的。”
@ottamm_190 分享了 综述论文(《LLM Agents 中的外部化》,arXiv:2604.08224),这篇由 21 位作者共同署名的论文为该方向提供了学术基础:记忆把状态外部化,skills 把程序性专长外部化,协议把交互结构外部化,而 harness engineering 则是统一这些要素的一层。
@deararchitects 给出了 反对意见:harness engineering “听起来像是提升交付速度的显而易见的下一步,但它也意味着团队现在必须自行拥有并维护另一层基础设施”。
1.3 个人 AI 语音 Agent 浪潮 🡕
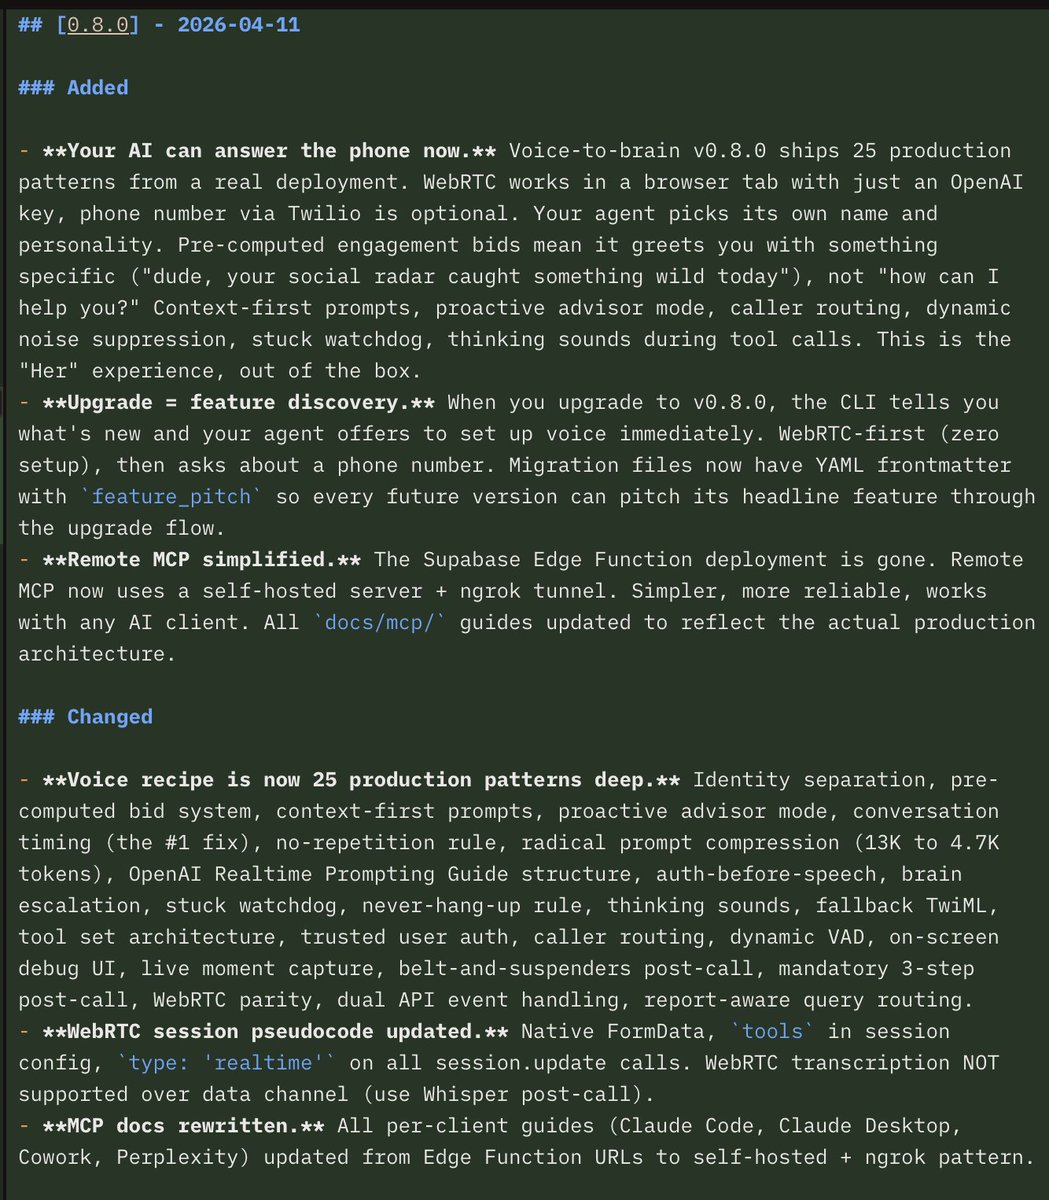
@garrytan(YC 总裁)凭借三篇帖子主导了个人 AI 话题。GBrain v0.8.0 发布了具备 voice-to-brain 能力的系统,一次性交付 25 种生产模式:默认 WebRTC、上下文优先提示词、动态 VAD、激进的提示词压缩(13K 压到 4.7K tokens)、卡死看门狗、工具调用期间的思考音效,以及先认证后开口。更新日志配图显示的不是 demo,而是一套生产级语音基础设施。
他还 介绍了他构建语音 agent 的过程:自己在 Kona 的泳池边,用 iPhone 上的 Telegram 与它聊天,并补充说:“我戒酒是为了写代码写得更好。”第三篇帖子 倡导个人 AI 运动,下面的回复确认这套配置“什么都能跑,别的地方一个月得花 $200 的那些东西也能跑”。
@ASUS 发布了一篇 官方博客指南,介绍如何用 OpenClaw 把旧笔记本改造成专用 AI agent——这意味着一家大型硬件厂商正在为个人 AI agent 这一用例背书。
@cgtwts 展示了 使用 OpenClaw 在本地运行 Gemma 仅用三条命令完成配置(安装 Ollama、下载 Gemma、启动 OpenClaw),说明构建一个完全私有的 AI agent 门槛已经降到最低。
1.4 Agent 平台竞争升温 🡒
OpenClaw 与 Hermes Agent 的对决成为焦点。@iamlukethedev 详细介绍了 OpenClaw v2026.4.10 发布:Active Memory 插件(自动拉取偏好和历史对话)、原生 Codex provider,以及 macOS 本地语音。不过,@markkurajala2 报告称,尽管手动记忆搜索能正常返回结果,Active Memory 在真实使用中却返回空值——暴露出生产就绪性上的缺口。
@steipete(OpenClaw 维护者)披露了两种实验模式,介绍了在 OpenClaw 中为 GPT 配置的两项能力:一种 strict mode,用来推动模型持续工作;以及把 Codex app server 当作 harness。该回复获得 144 个赞,显示社区对让非 Claude 模型也能胜任编排器角色有着很高兴趣。
@bridgemindai 在 NVIDIA DGX Spark 上设置 Hermes Agent,在不到 20 分钟内生成冷启动外联邮件,并称“OpenClaw 拿到了热度,Hermes 则把架构做对了。”@cto_junior 赞扬 Hermes 的自学习循环,认为它比手工做法更能沉淀经验,还能自动生成新 skills。
@KanikaBK 分享了 《The Orange Book》,这是一份由社区撰写的 17 章 Hermes Agent 手册,涵盖三层记忆系统、skill 创建循环,以及与 Claude Code 和 OpenClaw 的对比——由社区文档来填补 Nous Research 留下的空白。
@Codex_Changelog 宣布推出 Codex 0.119.0,默认启用 WebRTC 语音,并对 MCP 做出大幅改进(资源读取、elicitation、文件上传),同时支持远程 / app-server 工作流。一条 reply from @jlave_dev 批评其节奏:“you guys need to pick up the pace to compete with claude code. a copy shortcut being one of the top new features is crazy.”
1.5 上下文工程进入主流 🡕
@drummatick 列出了 成为前 1% AI 工程师所需掌握的主题——context engineering、context compactness、agent harness、memory 和 subagent spawning 与传统 LLM 技能并列出现。该帖获得 331 次收藏,说明市场对结构化学习路径需求很高。一条回复又补充了“evals and guardrails”。
@nyk_builderz 认为 下一个 AI 护城河是上下文治理:“2026 年交付最快的团队都在做三件事:像版本管理代码一样版本化管理 memory,在采取行动前给 agent 输出打分,把 prompts 当作接口,而不是魔法。”他与 @l33tdawg 的一段延伸讨论,把 SAGE(以 BFT 共识记忆为数据平面)与 LACP(Claude Code 的控制平面)进行比较,最终结论是两者互补,而非竞争。
@i_amanchadha 发布了 全面的上下文工程入门指南,托管于 contexteng.aman.ai,内容涵盖构件模块、检索/记忆/压缩、失败模式(上下文投毒、分心、混淆、冲突)以及生产环境启发式。
@aa22396584 提炼出了共识:“人们都在关注‘哪个模型更强’,但真正的技能鸿沟在于:如何组织 agent memory、如何设计权限边界、以及如何构建可组合的 SKILL.md 文件。工具已经商品化,架构才是竞争优势。”
2. 什么让人感到沮丧
托管 Agent 中的 Vault 与权限范围(高)
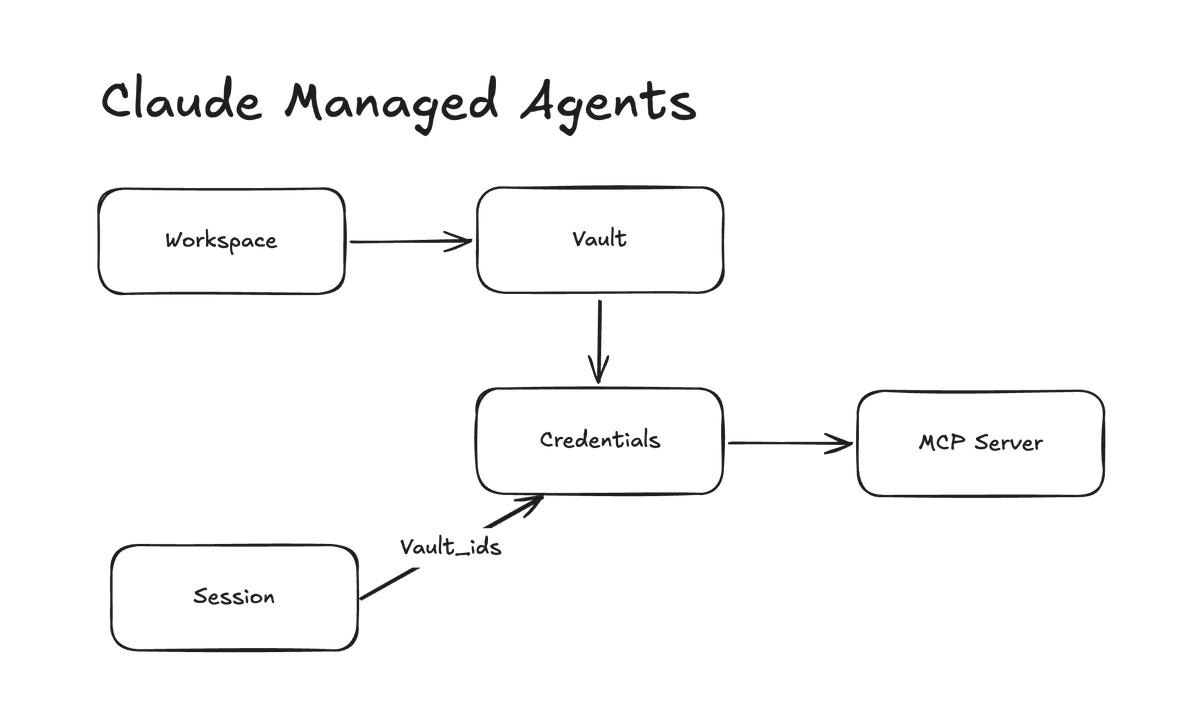
@dani_avila7 发现,Claude Managed Agents 的 vaults 以工作区为作用域,这意味着任何拥有工作区访问权限的人,都可以在自己的 session 中引用 vault,并使用其中存储的 OAuth 凭据。架构图把问题展示得很清楚:session 会附带 vault_ids,但访问控制只存在于工作区层级。人们提出的修复诉求包括:按 agent 细分的 vault 权限、凭据审计日志,以及原生定时 agent。
Active Memory 在生产环境中无法正常工作(中)
@markkurajala2 报道了,称 OpenClaw 新推出的 Active Memory 插件“在真实使用中一直给我们返回空结果,尽管手动记忆搜索确实会返回相关结果”。另一位用户则表示,更新后一直卡在终端里调试。大型版本的头号功能在生产环境中无法稳定工作,已成反复出现的模式。
Agent 工具迭代速度落后于竞争对手(中)
@jlave_dev 批评了 Codex:“you guys need to pick up the pace to compete with claude code. a copy shortcut being one of the top new features is crazy.” 这种挫败感反映出一种更广泛的情绪:在开发者体验上,OpenAI 的 agent 工具落后于 Anthropic。
基础设施指标与实际体验错位(低)
@braelyn_ai 指出,沙箱厂商在竞争初始化时间(“快 0.02s”),而使用该沙箱的 agent 却要跑 15 分钟。真正的瓶颈是 agent 执行时间,而不是基础设施启动时间——厂商优化的是 benchmark,而不是用户实际感知到的性能。
Agent 漏洞演示会误导人们对通用能力的判断(低)
@dbreunig 认为:找漏洞是搜索问题(在墙上找到一条裂缝),而造软件是建造问题(处理边界情况、维持整体一致性)。Agent 漏洞演示天然带有验证闭环,因此很适合营销,却并不能很好地代表更广泛的能力。一个尚未回答的问题是:Anthropic 为每个漏洞究竟花了多少钱?
3. 人们希望存在什么
更细粒度的 Agent 权限系统
多位实践者都提到了同一类需求:按 agent 而非按 workspace 进行凭据范围控制;在运行时强制执行权限,防止 agent 的声明能力与实际能力发生漂移;以及提供凭据审计轨迹,记录谁在什么时候用了什么。@dani_avila7 和 @0xAgix 都分别独立提出了这一诉求。
统一的 Agent Engineering 学习路径
@drummatick 承认了,“几乎没有任何单一资源能把这些能力全部囊括起来”,并承诺自己会写一份。@KanikaBK 指出,Nous Research “把工具扔出来后,基本就让你自己摸索了”。社区正在自行搭建文档体系——Orange Book、harness books、context engineering primer——但目前仍没有一套权威课程。
原生 Agent 调度与 Cron
@dani_avila7 明确指出,Claude Managed Agents 缺少原生定时 agent,并表示“不该还要靠 cron job 变通”。@Viewforge 构建了一个 多设备调度器 来填补这一空白,说明市场需求强到足以催生独立工具。
跨框架 Skill 可移植性保证
尽管 @xelebofficial 声称 skills 可跨多个平台工作,但 @felipedeleon_ 指出需要,希望有“一种原生运行时解决方案,能检查 skill,并在需要时把它移植到其他框架”。Skills 是 Markdown 没错,但运行时行为各平台并不一致。目前仍没有互操作性测试标准。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| OpenClaw | Agent 平台 | 褒贬不一 | Active Memory、本地语音、广泛模型支持、50K+ stars | 生产环境中的 memory bug、更新导致功能损坏 |
| Hermes Agent | Agent 平台 | 正面 | 自我改进的 skill 循环、三层 memory、Orange Book 社区文档 | skill 浏览仅限控制台,官方文档稀少 |
| Codex (OpenAI) | 编程 agent | 褒贬不一 | WebRTC 语音、MCP 改进、session 恢复 | 相比 Claude Code 节奏受批评,被视为仍在追赶 |
| Claude Code | 编程 agent | 正面 | 托管 agents、vault 系统、强大的 harness 设计 | vault 权限范围过宽,缺少原生调度 |
| GBrain | 个人 AI | 正面 | 25 种语音模式、WebRTC、提示词压缩(13K 到 4.7K tokens) | 依赖 OpenClaw/Hermes,仍处早期 |
| Daytona | 沙箱 | 正面 | 通过 OpenRouter CLI 一条命令启动 agent | -- |
| autoskills | Skill 安装器 | 早期 | 自动识别 50 多种技术栈,支持 --dry-run 标志 | 不受信任 skills 带来的提示词注入风险 |
| Agent Lightning | RL 优化 | 早期 | 与框架无关,可直接接入 agl.emit(),MIT 许可证 | v0.3.0,尚未证明能大规模落地 |
| Gemma 4 31B | 开放模型 | 正面 | 借助 ADK 执行自主 agent 工作,开放权重 | 规模小于前沿模型 |
| Privy Agent CLI | 钱包基础设施 | 早期 | 创建、注资和管理 agent 钱包 | 实验性界面较多 |
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| GBrain | @garrytan | 带 WebRTC、Twilio 和 memory 的个人 AI 语音 agent | 封装式 AI 的局限 | OpenClaw/Hermes、WebRTC、PGLite | v0.8.0 | GitHub |
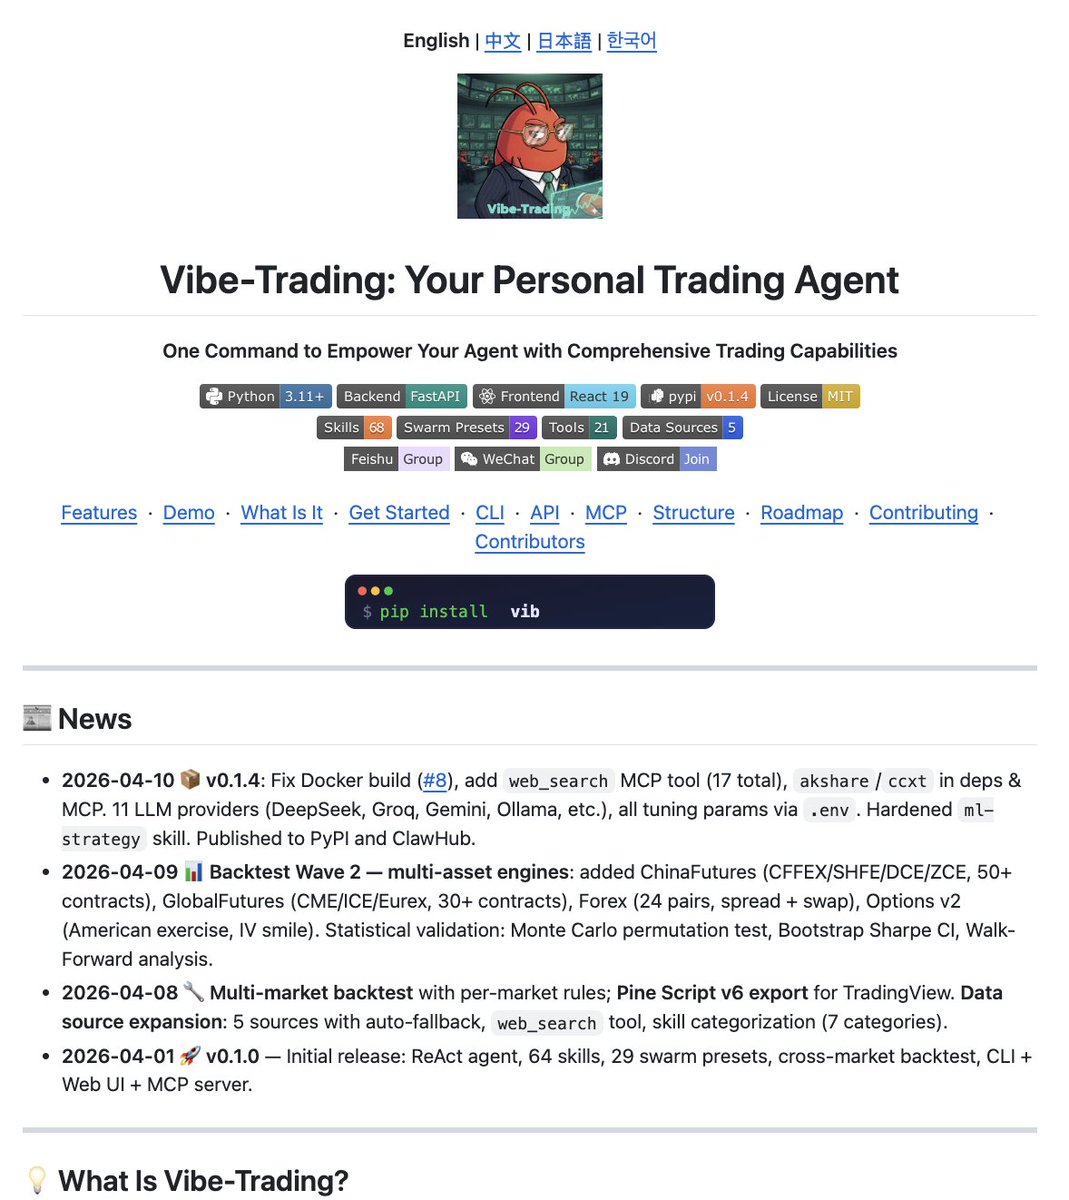
| Vibe-Trading | @ihtesham2005 | 拥有 64 项 skills、29 个 swarm 预设的开源交易 agent | 量化工具碎片化 | Python、FastAPI、React、DAG 多 agent | v0.1.4 | 推文 |
| SearchClaw | @ruc_ytz | 具备质量门和 harness engineering 的研究 agent | LLM 研究答案不可靠 | FastAPI、litellm、Playwright | 已发布 | GitHub |
| Charon | @suncostlabs | 管理远程 Claude、Codex、pi、Hermes 实例的编排器 | 多 agent 协调 | 自定义编排 | 预发布 | 推文 |
| Escroue | @Escapation | 无需信任的 agent-to-agent 任务市场 | agent 支付结算 | OpenServ SDK、链上 | 黑客松冠军 | escroue.com |
| Harness Books | @tom_doerr / AgentWay | 两本 harness engineering 设计指南 | 缺少成文的 harness engineering 理论 | Markdown,托管于 agentway.dev | 已发布 | GitHub |
| autoskills | @code_rams | 自动识别技术栈并安装匹配的 agent skills | 手动安装 skill 的负担 | npx CLI、skills.sh 注册表 | 已发布 | 推文 |
| Agent Experience Protocol | @itsashonaroll | 面向 agent 协调的标准化安全优先协议 | 缺少 agent 互操作标准 | 协议规范 | 早期 | 推文 |
Vibe-Trading 是今天浮现出来、在架构上最具野心的开源项目。它采用基于 DAG 的多 agent 系统,让专职 agents 实时协作、辩论并彼此交接,覆盖技术分析(Ichimoku、Elliott Wave、SMC)、量化工具(Black-Scholes、Greeks、MVO)、另类数据(社交情绪、宏观 regime 检测)以及加密货币(永续合约资金费率基差、清算热力图)。该项目由 HKU 的 Data Intelligence Lab 于 10 天前发布。
SearchClaw 来自 RUC-NLPIR,把 harness engineering 原则应用到网页研究中:质量门钩子会拒绝引用不足的答案;研究计划工具会把复杂查询拆解成可追踪子任务;两阶段上下文压缩则让 session 保持在上下文窗口限制之内。这是 harness engineering 从理论走向应用的一个具体例子。
6. 新鲜且值得关注
Meta-Harness:模型之外的那层“模型”
Meta-Harness 论文(arXiv:2603.28052v1)表明,AI agent 可以自动优化冻结模型外围的 harness 代码,并在 token 使用量少 4 倍的情况下,比人类 harness 工程师高出 7.7 分。研究中,agent 被赋予了对既有代码的文件系统访问权限、最多 10M tokens 的执行轨迹,以及失败日志。它并不是在“刷榜取巧”,而是发现了结构化程序——用于分类的 draft-verification、用于数学检索的 lexical routing、用于编码的 adaptive context。其含义是:继模型扩展之后,harness 搜索可能成为下一个前沿。
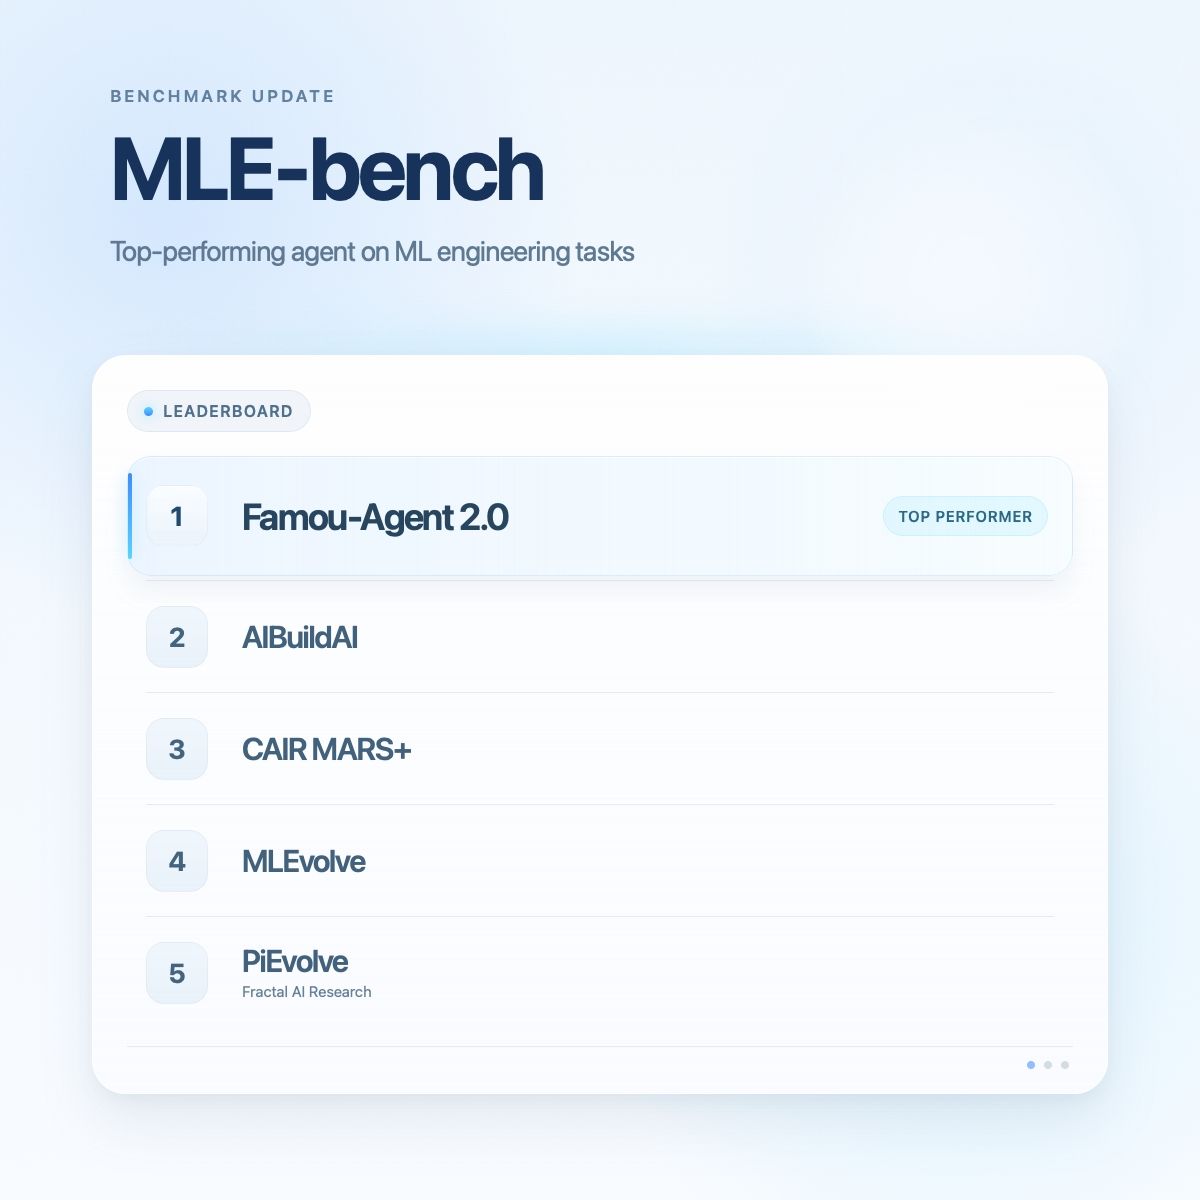
Famou-Agent 2.0 重新夺回 MLE-Bench SOTA
百度智能云的 Famou-Agent 2.0 重新拿下 ML 工程任务 MLE-Bench 的第一名,升级包括进化策略、长时程记忆和基础设施。该系统已部署至制造、金融、交通运输等领域的数千家企业。
VAGEN:教 VLM Agent 构建世界模型
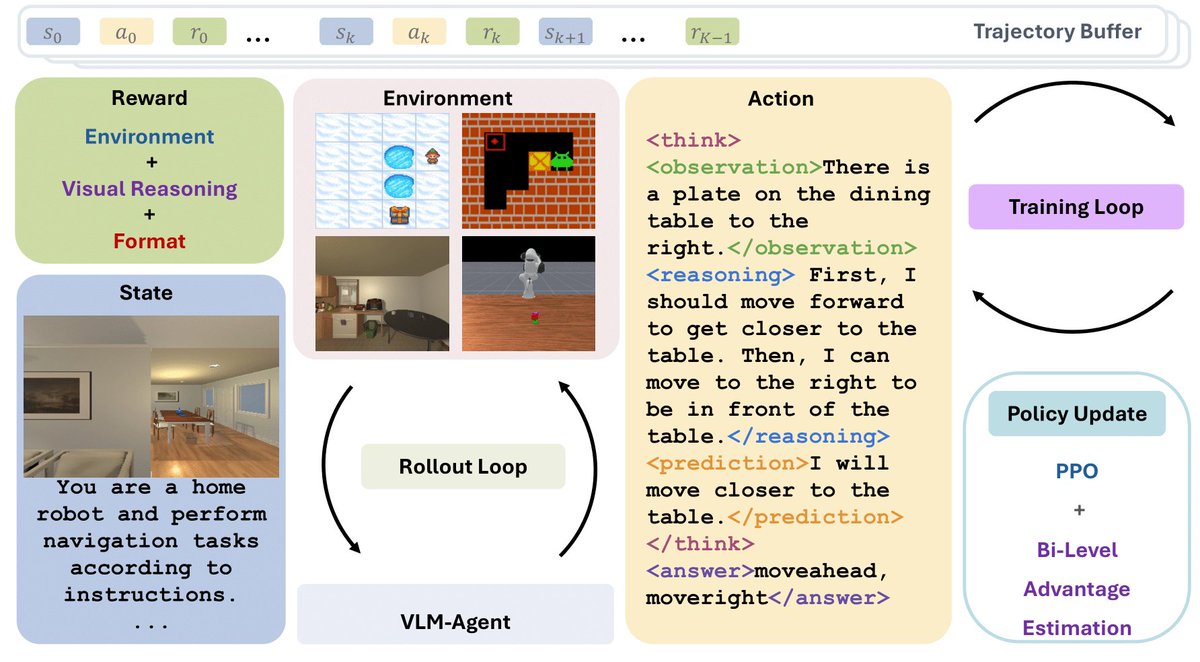
Stanford 的 VAGEN 框架 使用强化学习,训练视觉语言模型 agent 构建并维护内部世界模型。通过鼓励 agent 估计当前状态并预测未来转移,一个 3B 参数模型借助带双层优势估计的 PPO,在多类视觉任务上达到 SOTA。
Agent Lightning:面向任意 Agent 框架的 RL
@pvergadia 宣布,Microsoft 开源了 Agent Lightning 是一款与框架无关、用于提升 agent 的 RL 工具。可直接接入 agl.emit(),或使用自动追踪器,把每一次提示词、工具调用和奖励都捕获成结构化事件。它支持 LangChain、AutoGen、CrewAI、OpenAI SDK 和纯 Python,用持续学习闭环取代手工调 prompt。

外部化理论迎来综述论文
一篇 21 位作者合著的综述论文(arXiv:2604.08224)从认知外部化的视角重构 agent 基础设施:记忆将状态跨时间外部化,skills 将程序性专长外部化,协议将交互结构外部化,而 harness engineering 充当统一层。论文梳理了从 weights 到 context 再到 harness 的历史演进。
7. 机会在哪里
[+++] 强:Agent Skills 工具与分发 Skills 正成为 AI agent 封装知识的标准单位,但生态仍缺少筛选、安全审查和跨平台测试。@safaa_9411 提出的提示词注入风险,以及 Swift Agent Skills 中的安全警告,都指向同一个空白:目前还没有一个可信、经过验证且完成安全审计的 skill 注册表。谁能做出“agent skills 的 npm”,并建立可靠审核机制,谁就能拿下分发层。
[+++] 强:Harness Engineering as a Service Meta-Harness 论文表明,自动化 harness 优化优于人类专家。大多数团队仍在手工调 agent 脚手架。一个能够分析 agent harness、识别瓶颈,并给出或自动应用改进建议的服务,正好击中一个已被验证的痛点——@elvissun 关于 harness 调试方法的帖子获得了 744 次收藏。
[++] 中等:Agent 权限与凭据治理 @dani_avila7 对 vault 权限范围的发现,以及 @nyk_builderz 关于“上下文治理就是护城河”的论点,都指向同一个缺口:处理真实凭据的 agents 需要细粒度、可审计的权限系统。现有实现最多也只做到 workspace 级别。企业级采用取决于这一问题能否解决。
[++] 中等:个人 AI 语音基础设施 Garry Tan 的 GBrain、OpenClaw 的本地语音,以及 ASUS 的旧笔记本改造指南,都汇聚到个人化、语音优先 AI agents 这一方向。基础设施已经能用,但仍很粗糙。谁能把流程从“读 changelog、手动调试”压缩成“安装后直接开聊”,谁就能打开消费市场。
[+] 新兴:Agent-to-Agent 市场与协议 Escroue(黑客松冠军)、Agent Experience Protocol、Privy Agent CLI 以及多项 marketplace 公告,都显示出早期需求:agents 需要能发现其他 agents、与之谈判并向其支付。当前基础设施高度碎片化,而且大多偏加密原生。缺失的一块,是一个与框架无关的协调层。
[+] 新兴:多设备 Agent 编排 @Viewforge 的跨设备调度器,以及 @suncostlabs 的 Charon 编排器,都说明市场需要在多台机器上运行 agent 舰队。眼下还没有主导性工具,能够在异构设备间统一调度、监控和协同 agents。
8. 结论
-
Agent skills 正在成为封装 AI 知识的新标准。 本周,Supabase、Google 工程师、Paul Hudson 和 Anthropic 都发布了 skills,而 autoskills 能为 50 多种技术栈自动安装它们。(Supabase skills 发布)
-
Harness engineering 现在已经有了教材、综述论文和实证证明。 Meta-Harness 论文显示,仅靠自动化 harness 搜索,就能比人类专家高出 7.7 分;与此同时,两本书和一篇 21 位作者联署的综述论文也补上了理论基础。(Meta-Harness 讨论帖)
-
模型周围的代码带来的性能波动,比模型本身更大。 同一个冻结模型,仅凭一次 harness 改动就可能产生 6 倍性能差异;真正的竞争优势在于架构,而不在于模型。(elvissun 的 harness 方法论)
-
个人 AI 语音 agents 已从 demo 跨入日常使用。 Garry Tan 的 GBrain v0.8.0 提供 25 种生产级语音模式,并实现激进的 prompt 压缩;ASUS 也发布了把硬件改造成个人 AI 的官方指南。(GBrain v0.8.0)
-
Agent 平台竞争正在暴露生产就绪性缺口。 OpenClaw 的 Active Memory 在真实使用中返回空结果;Codex 的迭代节奏被批评落后于 Claude Code;Hermes 的自学习循环受到称赞,但要真正用起来仍依赖社区文档。(OpenClaw 缺陷报告)
-
安全与治理是 agent 落地的硬约束。 工作区级凭据 vault、未经审查的 skill 安装,以及缺失的审计日志,都是本周实践者点名的具体障碍。(Vault 作用域问题)
-
上下文工程已经形成自己的课程、primer 和失败模式分类。 从投毒、分心到压缩伪影,实践者如今把上下文视为一种有限资源,且其失败模式已知,而不再把它当作一个神奇的输入框。(上下文工程入门指南)