Twitter AI Agent - 2026-04-12
1. 人们在讨论什么
1.1 技能工程与 harness 工程正在超越提示工程 🡕
今天最核心的话题,是“harness 工程”和“技能工程”正作为独立学科崛起,并取代提示工程,成为使用 AI agent 的核心能力。@IntuitMachine 发布了 展示 AI engineer 分类体系的信息图:深度学习研究对应芯片设计,harness 工程对应后端,技能工程对应前端。这一框架正逐渐获得认同。
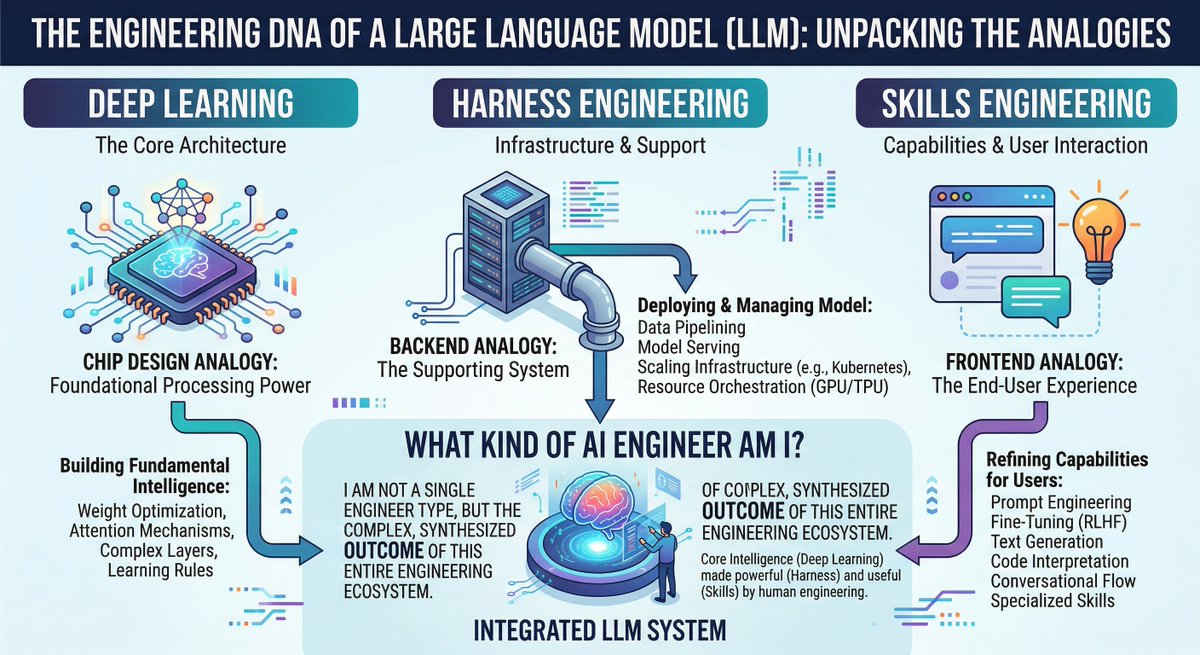
@Ed_Forson 报道称 表示,harness 工程“可能是我刚参加的 AI Engineer 大会上最大的议题”,并链接到 HumanLayer 博文,后者给出了这个公式:coding agent = AI model(s) + harness。该帖认为,“每当 agent 犯错,你就设计一个解决方案,确保它以后再也不会犯这个错”——也就是把 agent 的失败视为配置问题,而不是模型局限。@0x_Lotion 说得更直接:“prompt engineering 已死,context engineering 万岁,新王登基。”
Google 的 @addyosmani 认为 表示:“记忆会让你的 agent 随时间变得更聪明。Agent harness 是记忆层的关键。事后没法再把其中一个硬接到另一个上面。”这意味着,harness 不只是配置界面,更是 agent 记忆的架构基础——关于上下文、压缩和技能呈现的每一个决策,本质上都是记忆决策。
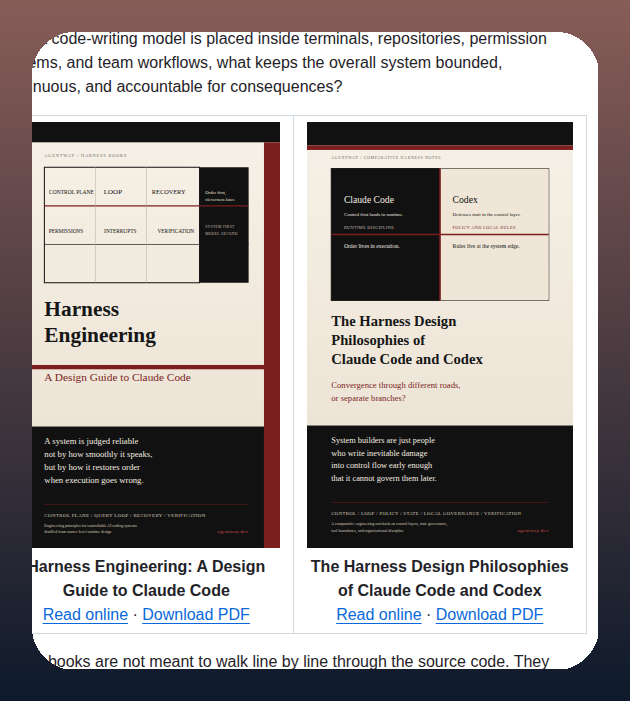
@tom_doerr 分享了 两本书籍形式的设计指南,内容围绕 Claude Code 和 Codex 的 harness 工程展开,架构图涵盖控制平面、循环、恢复、权限和验证。
@LarryGraham01 进一步延展了这一论点 将问题指向供应商锁定:“如果 harness 是封闭的,你其实并不真正拥有这个 agent。如果记忆也是封闭的,情况会更糟。”Agent 越有用,锁定效应就越强——真正形成护城河的不是模型,而是积累下来的行为和记忆。
1.2 Agent 技能生态走向成熟 🡕
Agent 技能——把特定领域工作流封装成可复用指令包——正在汇聚成一个清晰可辨的生态。今天,多种技能库、分发渠道和技能管理工具同步上线。
@tom_doerr 分享了 VoltAgent/awesome-agent-skills 仓库,这是一个人工精选的集合,收录了来自 Anthropic、Google Labs、Vercel、Stripe、Cloudflare、Netlify、Trail of Bits、Sentry、Expo、Hugging Face、Figma、Microsoft 等机构的 1000 多项官方技能。兼容 Claude Code、Codex、Gemini CLI、Cursor 等工具。
@DataChaz 提供了 详细拆解,介绍 @addyosmani 的 agent-skills 软件包:19 项工程技能和 7 个斜杠命令(/spec、/plan、/build、/test、/review、/code-simplify、/ship),编码了 Shift Left、Chesterton's Fence 和 Hyrum's Law 等 Google 级工程实践。可通过 npx skills add addyosmani/agent-skills 安装。
@nrqa__ 解释了 介绍了 Anthropic 的官方技能系统:由 Claude 动态加载的指令文件夹。Word、PDF、PowerPoint、Excel、Web 应用测试和 MCP 服务器生成等技能都已可用。@MrZivtins 的回复则给这一趋势降了温:“如果你只是做各种开发工作,现在维护 skill 文件的开销还不值得。你的 CLAUDE.md 已经完成了其中大部分功能。”
@shabnam_774 分享了 包含 900 多个跨平台 skills 的库,兼容 Claude、Copilot、Gemini 和 Cursor。@ctatedev 推出了由运行时提供服务的 skills 为 agent-browser 提出了解法,以解决缓存技能过时的问题——评测显示,采用新方案后,agent 在选择和使用浏览器技能时的正确率更高。
1.3 Hermes Agent 主导开源 agent 讨论 🡕
Nous Research 的 Hermes Agent 是今天讨论度最高的开源 agent 系统,十多条推文覆盖功能更新、用户报告和社区热情。
@Teknium(Nous Research)报道称 表示,Hermes Agent 在对自己的技能选择提示词进行基准测试并优化后,技能加载效果提升了 20%——这是自我改进闭环的一个具体例证。除此之外,他还 指出,称 Hermes Agent 已自主为自己的文档网站添加了技能中心。
@Sumanth_077 提供了 全面概览:支持带 LLM 摘要的 FTS5 会话搜索、Honcho 辩证式用户建模、多平台支持(Telegram、Discord、Slack、WhatsApp、Signal、CLI)、内置 cron 调度器、可用于并行工作的子 agent,以及通过 OpenRouter 支持 200 多个模型。
@outsource_ 发布了 Hermes-Workspace 增加了任务看板/Kanban 页面、agent 产物检查器、crew 监控、多语言支持,以及带搜索和安装功能的技能中心,同时同步了上游的 561 次提交。@thegreatola 分享了第 3 天的结果 分享了使用 GLM-5.1 运行 Hermes Agent 做自动交易的经历,花费了 60 美元 API 额度,并称其在长时任务上的表现明显优于 Claude Code。
1.4 Claude Code 质量争议升级 🡒
@Hesamation 发布了 详细的取证分析,对 Claude Code 系统提示词的变化做了取证分析,这些变化或许能解释用户对质量下滑的抱怨。分析指出了四项变化:(1) 新提示词更强调 fork/子 agent,使 Opus 从直接解决问题转向编排——“这是我目前最大的怀疑对象”;(2) 记忆检索提示词更明确,可能导致对既有先验过拟合;(3) 三天前新增了“代码中不写注释”的默认设置;(4) 引入了一个实验性的验证专家 agent,并给出提示语“你是 Claude,而且你不擅长验证”。
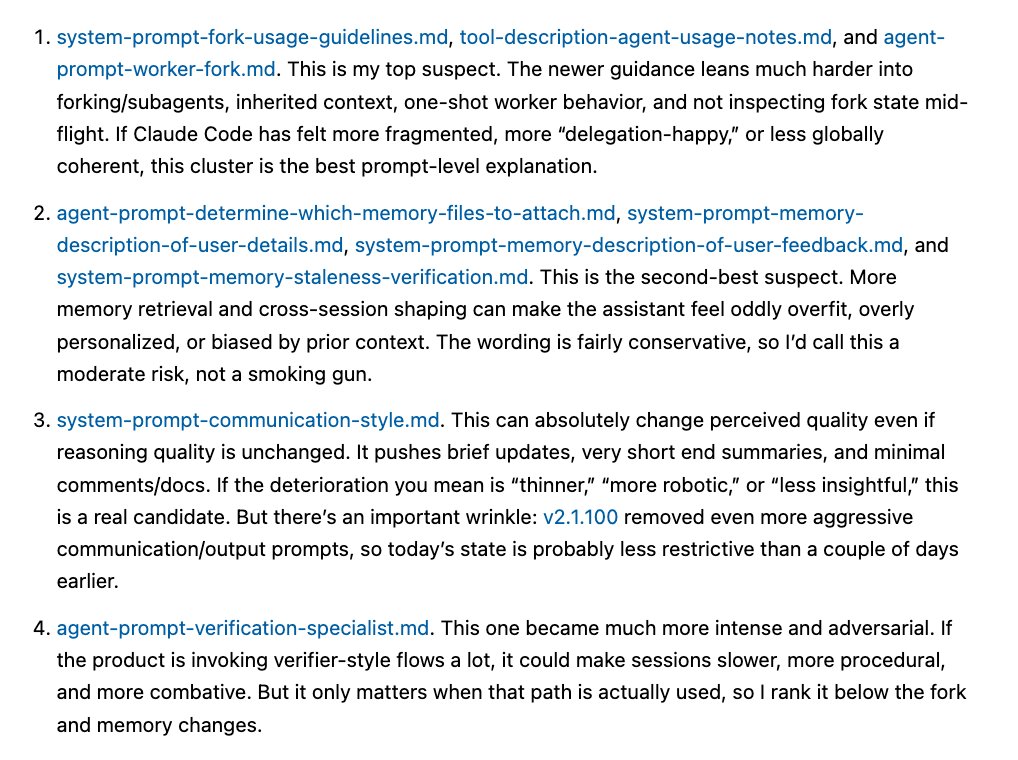
@DualAcies 的回复从商业角度解读道:“‘不写注释’这个默认设置会减少 token 输出 = 降低每次会话的 API 成本。这是 IPO 前改善利润率的动作,不是能力层面的决定。”@tr4m0ryp 的另一条回复则将问题与 8 月至 9 月的基础设施 bug 联系起来,并指出:“如果主 agent 被削成一个路由器,你就失去了让 Claude Code 在复杂重构任务上优于 Codex 的原始能力。”
1.5 语音 agent 跨过生产门槛 🡕
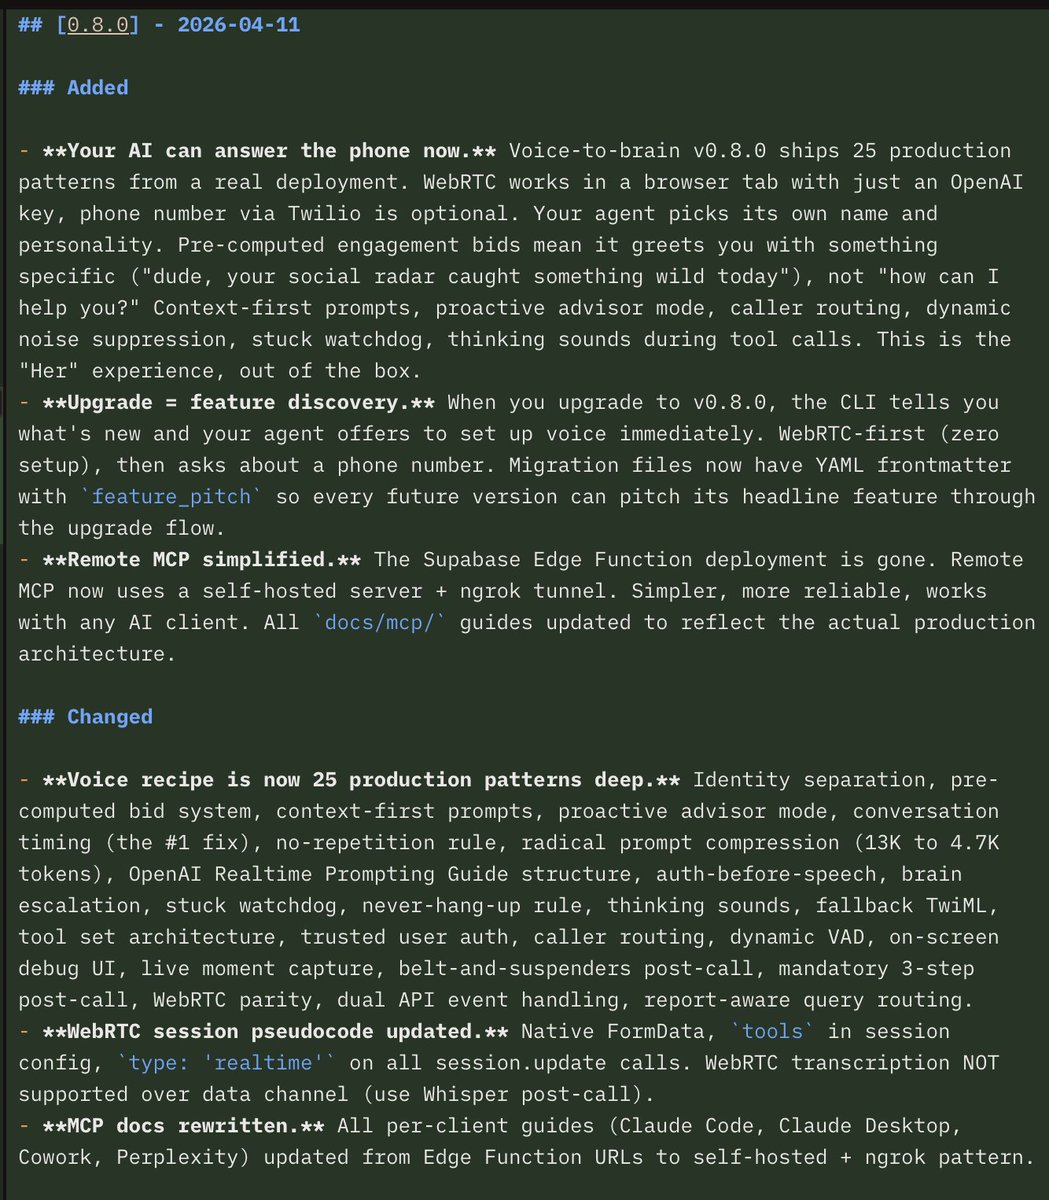
@garrytan 发布了 GBrain v0.8.0,包含 25 种生产级语音模式、WebRTC 语音端点(只需一个 OpenAI key 即可在浏览器中运行)、Twilio 集成和 PGLite 本地存储。更新日志图片显示出相当深的打磨:预计算的互动出价、上下文优先提示词、动态降噪、卡死 watchdog、工具调用期间的思考音效,以及将提示词从 13K token 大幅压缩到 4.7K token。
在后续内容中,他将 宣布推出 Gemini Live 2.5 称为“最好的”语音 agent 模型,理由是速度、智能和上下文窗口大小。回复中有人指出,对语音 agent 而言,真正的差异化因素是上下文窗口,而不是延迟。@etnshow 介绍了 ElevenLabs 的 Voice Engine:只需一条命令,就能把任何现有聊天 agent 包装成语音 agent——“把一个政府聊天 agent 变成任何人都能拨通的电话线路。”
2. 什么让人沮丧
Token 预算与技能加载(严重程度:高)
@seelffff 开源了 38 个 agents 和 156 个 skills,但也附上一句直白警告:“一次把 38 个 agent 和 156 项技能全塞进上下文,会在几分钟内烧光你的使用额度。只选你真正需要的 3 到 4 个。”这正是根本矛盾:全面的技能库已经存在,但如果没有智能技能选择,上下文窗口和 token 预算会让它们变得不切实际。@KingBootoshi 进行了长篇阐述 谈到了这种组合爆炸问题——“我们在提示词里能用的词语和结构组合是无限的”——并感叹没有哪个技能库按质量排序,只有按热度排序。
Agent 会话失忆(严重程度:高)
@heygurisingh 阐明了问题:“你的 AI 编程 agent 患有失忆症。每次新会话 = 重新解释你的架构、你的约束、你的决策,以及你上周二修掉的那个 bug。”他将 Mind 开源了出来,这是一个由 MCP 支撑的持久记忆层,采用四级温度模型(热/温/冷/冻结),但更深层的抱怨在于:agent 平台把记忆视为可选项,而不是核心基础设施。
子 agent 编排正在拉低质量(严重程度:中)
多名用户反映,Claude Code 向子 agent 编排倾斜后,主 agent 变得“更碎片化、更爱委派,或者整体一致性更差”,正如 @Hesamation 的 分析 所说。@tr4m0ryp 认为:“原生编排会增加失败点。如果主 agent 被削成路由器,你就失去了原始能力。”@thegreatola 报道称 表示,一项 Claude Code 任务跑了 15 个多小时仍未成功,每 4 小时就烧掉一次使用额度。
MCP 抽象税(严重程度:中)
@MelkeyDev 重点提到了 发表了一篇文章,主张“agent 与 API 之间每多一层协议,都是对保真度征税”。对于那些想优化 agent 可靠性的构建者来说,MCP 的标准化收益与其带来的额外开销之间的权衡,正变成一个现实顾虑。
3. 人们希望有什么
面向编程 agent 的混合模型路由
@gajesh 提出疑问:“怎么还没人做出混合模型编程 agent?GPT 5.4 负责下指令和验收,MiniMax/Sonnet 负责执行。”Factory AI 的 mission mode 被认为是最接近的实现,但其联合创始人也承认,对“小但重要”的任务来说,它“感觉有点用力过猛”。Claude Code 目前并不原生支持把不同任务类型路由给不同模型。
跨工具的 agent 记忆
@heygurisingh 发布了 Mind,正是为了解决这个问题:在 Claude Code、Cursor、Codex、OpenCode、Gemini CLI 和 Windsurf 之间共享同一套持久记忆。其 checkpoint 系统支持跨工具、跨会话的连续性。它确实解决了问题,但属于后装扩展——真正的缺口在于,没有任何主流 agent 平台原生提供这一能力。
技能质量排序
@KingBootoshi 指出:“它们没有一个真正按效果排序,只按‘受欢迎程度’排序。”技能质量从“烂得像狗屎”到“神级”不等,但没有机制能为特定任务筛出最高质量的技能。Swarms Marketplace 的 透明评分,配合数值评分和文字反馈,是目前最接近这一目标的尝试。
开放 harness 与可移植记忆
@LarryGraham01 阐述了 点出了这一需求:“模型可以替换。你的 harness 和记忆应该属于你自己。”用户希望 agent 积累下来的知识、偏好与行为能在不同平台之间迁移,而不是被锁死在某一家供应商里。
4. 正在使用的工具与方法
| 工具 | 类别 | 评价 | 优势 | 局限 |
|---|---|---|---|---|
| Claude Code | 编程 agent | 褒贬不一 | 深度推理、子 agent 编排、生态庞大 | 质量争议、token 消耗高、子 agent 碎片化 |
| Hermes Agent | 开源 agent | 正面 | 自我改进技能、多平台、持久记忆 | 需要自托管、配置复杂 |
| OpenAI Codex | 编程 agent | 正面 | 每周 300 万用户、迭代快、擅长参考资料密集型工作 | 还没迎来自己的“Claude Code 时刻” |
| GBrain | 语音 agent harness | 正面 | 25 种生产级语音模式、WebRTC、开源 | 仍属早期、配置复杂 |
| Agent Skills (Addy Osmani) | 技能库 | 正面 | Google 级工程实践、7 个生命周期命令 | 工作流偏强约束,不一定适合所有团队 |
| VoltAgent awesome-agent-skills | 技能目录 | 正面 | 来自主要厂商的 1000 多项官方技能 | 筛选质量参差不齐 |
| vLLM | 模型服务 | 正面 | 新模型上线首日即支持、可用于生产环境 | 需要 GPU 基础设施 |
| Swarms Framework | 多 agent 框架 | 正面 | Marketplace 集成、工具系统、生产部署 | 生态仍较早期 |
| Agent CI | 本地 CI 运行器 | 正面 | 为 agent 在本地运行 GitHub Actions | 较新、生态有限 |
| MCP (Model Context Protocol) | agent 协议 | 褒贬不一 | 标准化工具集成、支持多厂商 | 抽象开销、保真度损耗 |
| FileGram | agent 记忆 | 早期 | 通过文件系统行为轨迹实现个性化 | 研究阶段 |
| Mind (MCP server) | 跨工具记忆 | 早期 | 基于 SQLite、四级记忆、FTS5 搜索 | 社区项目,尚未经充分实战验证 |
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| GBrain v0.8.0 | @garrytan | 支持 WebRTC 和 Twilio 的语音 agent harness | 生产级语音 agent 部署 | WebRTC、Twilio、PGLite、OpenAI | Production | 推文 |
| SkillClaw | DreamX Team | 在用户之间实现技能的集体演化 | 技能部署后保持静态 | Agentic evolver、共享仓库 | Research | 论文 |
| Hermes-Workspace | @outsource_ | Hermes 的任务看板、agent 监控和技能中心 | agent 编排可视化 | Hermes Agent、Docker | Beta | 推文 |
| Agent CI | @appfactory | 为编程 agent 在本地运行 GitHub Actions | agent 无法针对 CI 流水线测试 | GitHub Actions runner | Beta | 推文 |
| Mind | @heygurisingh | 跨工具的持久 agent 记忆 | 各 agent 平台之间的会话失忆 | SQLite、MCP、FTS5 | Alpha | 推文 |
| three-man-team | @ihtesham2005 | 3-agent 开发团队(Architect/Builder/Reviewer) | agent 漂移与输出失控 | Claude Code、CLAUDE.md | Released | 推文 |
| PENCILCLAW | @dungeonclaw | 面向本地 Ollama 的 C++ 编程 agent harness | 在 Python/JS 之外构建 agent harness | C++、Ollama | Alpha | 推文 |
| Ascii | @luaroncrew | 跨平台技能互操作(Claude Code + Codex) | 技能格式锁定 | GitHub 集成、与 LLM 无关 | Beta | 推文 |
| Supaterm | @khoiracle | 集成 agent 与侧边栏的终端 | 终端中的多 agent 可视化 | macOS、libghostty | Beta | 推文 |
| ASM | @luongnv89 | 统一的 agent 技能管理 CLI | 技能安装碎片化 | CLI | Alpha | GitHub |
| nominal.dev | @boristane | 为每个已连接仓库提供远程编程 agent | 远程 agent 开发环境 | Custom harness | Beta | 推文 |
| FileGram | @liuziwei7 | 根据文件系统轨迹实现 agent 个性化 | 基于对话的记忆过于浅层 | 文件系统分析 | Research | GitHub |
GBrain v0.8.0 发布了 25 种生产级语音模式,涵盖身份分离、提示词压缩(13K 到 4.7K token)、主动顾问模式、卡死 watchdog,以及工具调用期间的思考音效。只需一个 OpenAI key,WebRTC 就能在浏览器标签页中运行;Twilio 电话号码则是可选项。远程 MCP 也从 Supabase Edge Functions 简化为自托管 + ngrok。这代表了目前最经生产环境打磨的开源语音 agent harness。
SkillClaw(arXiv:2604.08377)提出了集体技能演化方案:一个自主演化器汇总用户轨迹,识别反复出现的行为模式,并改进共享技能集。在一项持续 6 天、涉及 8 名用户的试验中,该系统显著提升了 Qwen3-Max 在 WildClawBench 上的表现。这是首个将跨用户经验视为技能改进主要信号的研究系统。
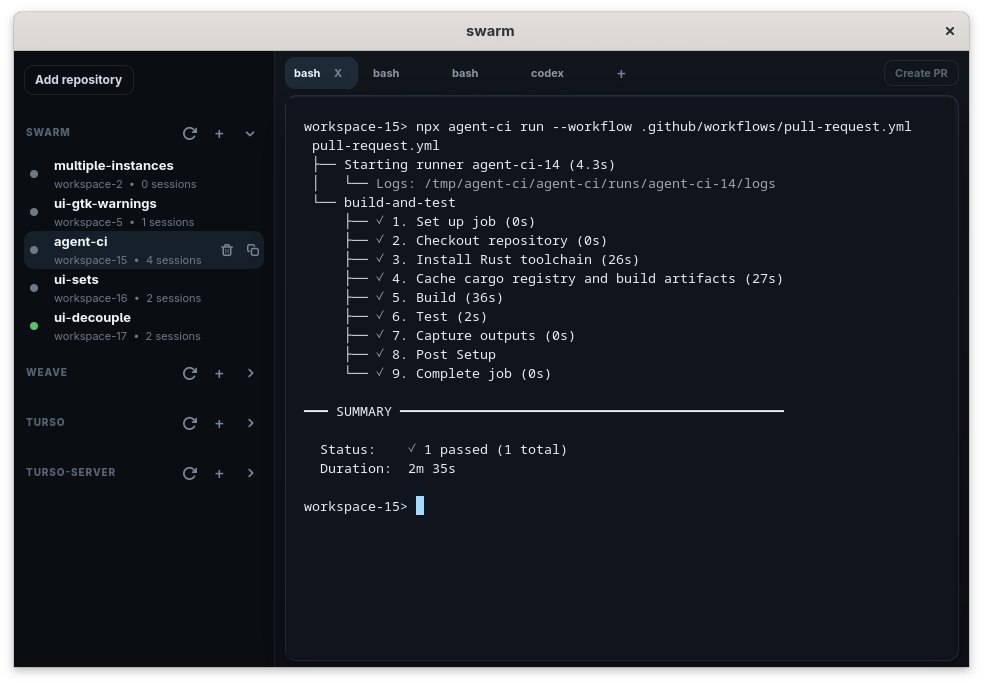
Agent CI 让编程 agent 能在本地运行完整的 GitHub Actions 工作流。截图 展示了一条完整的 CI 流水线——checkout、安装 Rust 工具链、缓存 cargo、构建、测试——在带有 Codex 标签页和多个 agent 工作区的环境中,于 2 分 35 秒内完成。这填补了 agent 编写代码与 CI 验证之间的鸿沟。
6. 新动态与值得关注的进展
自我改进 agent 开始拿出具体成果
Hermes Agent 的自我改进闭环带来了可量化的 20% 技能加载准确率提升,正如 由 @Teknium 报道 所示。这个 agent 对自己的技能选择提示词做了基准测试,找出弱点后再重写。与此同时,MiniMax M2.7 帮助它构建了自己的 RL harness,并推动了自己的训练循环,而一个 Bittensor 子网 agent 则 构建并击败了一个 SOTA 的 40 亿参数模型,并在两周后写出了自己的论文。递归式自我改进正在从理论走向实际运行。
Cloudflare Agents Week 显示基础设施已趋于成熟
@Cloudflare 专门用了一整周时间,涉及计算、连接、安全、身份、经济和开发者体验等多个方向的 agent 基础设施发布。再加上 @addyosmani 的 DevTools MCP 发布 与 AWS 在 Bedrock AgentCore 上推出有状态 MCP,各大基础设施供应商如今都在构建面向 agent 的原生平台层。Cloudflare 相关回复中最引发共鸣的一句是:“难点不在 tool-calling,而在信任边界。”
神经符号 AI 获得印证
@OwenGregorian 分享了 Gary Marcus 的分析,对 Claude Code 泄露源代码进行了分析:一个 3,167 行的内核(print.ts),在确定性循环中使用经典的符号模式匹配,包含 486 个分支点和 12 层嵌套。Marcus 认为,这证明了“自 LLM 以来最大的进步就是神经符号 AI”——Anthropic 是靠经典 AI 技术而不是单纯扩大规模来构建可靠性的。
企业级 agent 技能市场正在出现
@trillhause_ 描述道 介绍了 Ramp 如何通过为每位员工提供配置好的 AI 工作区,以及由同事构建的 350 多项可复用技能,实现 99% 的日常 AI 使用率。Worklayer 则为 agent 提供 SSO 应用保险库,使企业能够建立内部技能市场,让“员工可以把自己的知识编码并发布成 agent 技能”。这就是企业采用模式:自下而上创建技能,由中心化渠道统一分发。
7. 机会在哪里
[+++] Strong: Skill Quality and Discovery Infrastructure. Over 1000 skills exist across multiple repositories, but no system reliably ranks them by effectiveness. @KingBootoshi 等人指出,技能质量从“烂得像狗屎”到“神级”不等,除了热度之外没有任何质量信号。一个技能评估、测试与排序层——类似 Swarms Marketplace 通过透明评分所做的尝试——会立刻体现价值。技能生态已经大到必须做筛选了。
**+++] 强:跨平台 Agent Memory。** 每个主流 agent 工具(Claude Code、Codex、Cursor、Gemini CLI)都维护着各自割裂的 memory。[Mind 是目前唯一的跨工具方案,而且还只是一个社区项目。第一个提供可移植、持久且跨工具可用的 agent 记忆平台,将收获显著的开发者忠诚度。harness-memory 融合 所揭示的关键是:这件事必须在架构层面深度集成,而不是事后外挂。
**++] 中等:面向 Agents 的混合模型路由。** 对一种系统的[需求 所描述的模式——由前沿模型负责指令与验证,由更快、更便宜的模型负责执行——需求已经非常明确,但市场仍未满足。Claude Code 和 Codex 都是单模型系统。Factory AI 是最接近的近似方案,但被认为对小任务来说有些过重。一个能按任务复杂度匹配模型能力的轻量级路由层,可以补上真实存在的工作流缺口。
**++] 中等:Agent 原生开发者工具链。** [Agent CI(本地 GitHub Actions)、Supaterm(带 agent 侧边栏的终端)和 Chrome DevTools MCP 都指向同一个机会:把开发者工具重新设计为以 agent 为一等用户。调试、测试、性能分析和部署工具,都应面向 agent 消费,而不是面向人类目视检查。
[+] Emerging: Elixir/OTP for Agent Orchestration. @svs 声称 认为,Elixir 和 LiveView 凭借 OTP 的 actor 模型与容错能力,将“赢下 agent 编排”。目前绝大多数 agent 编排仍构建在 Python 和 TypeScript 上;一个有说服力的 Elixir agent 框架,可能吸引一批以可靠性为先的开发者。
**+] 新兴:Agent 行为个性化。** [FileGram 将 agent 记忆建立在文件系统行为轨迹之上,而不是对话历史。“记忆不是用户说了什么,而是他们做了什么。”这种基于行为的个性化路径,在商业层面几乎尚未被探索,可能成为真正让 agent 产品显得“懂你”的差异化方向。
8. 要点
-
harness 工程已经成为 AI agent 从业者的主导技能,超越了提示工程。 无论是大会演讲、博客文章还是多条爆款讨论,都指向同一个共识:模型能力固然必要,但并不足够——决定 agent 质量的是 harness 配置。 (来源)
-
agent 技能生态已经达到临界规模,主要厂商提供了 1000 多项精选技能,但依然缺乏质量排序。 Anthropic、Google、Vercel、Stripe、Cloudflare 以及数十家公司如今都在发布官方技能,但还没有任何系统能稳定地区分高质量技能与平庸技能。 (来源)
-
自我改进 agent 正在产出可量化成果。 Hermes Agent 通过自我基准测试把自己的技能加载效果提升了 20%;MiniMax M2.7 推动了自身训练闭环;一个 Bittensor agent 在两周内构建并击败了 SOTA 模型。递归式改进闭环已经在运行,而不只是理论设想。 (来源)
-
Claude Code 向子 agent 编排的转向正在引发质量投诉,而原因可能是提示词变化,而非模型本身退化。 对系统提示词变更的取证分析指出,fork/子 agent 的强化、“不写注释”的默认设置,以及实验性验证 agent 都可能是诱因——其中一些变化可能出于控制成本。 (来源)
-
语音 agent 已从新奇玩法迈入生产基础设施。 GBrain v0.8.0 提供了 25 种经实战打磨的语音模式,包括提示词压缩、卡死 watchdog 和动态降噪。一位知名构建者将 Gemini Live 2.5 称为最好的语音模型,而上下文窗口大小被认为是真正的关键差异项。 (来源)
-
主要基础设施供应商正在构建面向 agent 的原生平台层。 Cloudflare 用整整一周聚焦 agent 基础设施,Google 把 DevTools 作为 MCP 技能发布,AWS 则在 Bedrock AgentCore 上推出了有状态 MCP。agent 基础设施栈,正在由当年构建云基础设施栈的同一批公司搭建。 (来源)
-
带有可移植记忆的开放 harness 正在成为战略刚需。 随着 agent 积累的记忆和行为模式越来越有价值,被锁定在专有 harness 里的代价也会越来越高。第一个真正提供跨工具可移植 agent 记忆的平台,将赢得超额的开发者忠诚度。 (来源)