Twitter AI Agent - 2026-04-13
1. 人们在讨论什么
1.1 “薄编排层”原则正在成形 🡕
昨天围绕编排层工程的讨论,今天进一步沉淀成了一条具体的架构原则。@garrytan 发布了他所称的 “最简洁的提炼”:一种三层架构——上层是“厚技能”(用 Markdown 编写、编码判断与领域知识的流程),中层是“薄 CLI 编排层”(约 200 行代码,JSON 输入、文本输出,默认只读),底层则是确定性的应用代码(QueryDB、ReadDoc、Search)。这条原则强调的是方向:“把智能往上推到技能里,把执行往下推到确定性工具中。让编排层保持轻薄。”

这条帖子获得了 1,299 个赞和 1,666 次收藏。@MindTheGapMTG 在回复中补充了一个操作层面的细节:“厚技能不是写出来的,而是积累出来的。我们 CLAUDE.md 里的每一行,都是一次生产事故复盘的结果。” @weareuplers 则将其与 Unix 哲学联系起来:“让编排层保持轻薄,就是智能体工程版的‘把一件事做好’。Unix 花了 50 年才学会这一课,而我们不知为何又在智能体上用快进的方式重学一遍。”
@DanielMiessler 作出了区分 区分了两类编排层工程:(1) 告诉系统具体该怎么做——这类做法会随着模型进步而“被吞掉”(即“苦涩的教训”);(2) 告诉系统什么才算好——解释你是谁、你喜欢什么,以及什么样的输出才算优秀。他认为,只有第二类才具备面向未来的韧性。
@dexhorthy 提出异议 则从根本上挑战了这种表述方式:“想象一下,如果你一年前就学会了 12-factor 上下文工程,现在就可以自信地跳过这些‘编排层’炒作,继续干活。”这条帖子获得了 102 个赞,并引来了 @johns10d 一条内容扎实的回复:“编排层工程是在模型外围放上程序化代码,来保证它按你的意图执行,而不是只是客气地请求它。光靠客气地请求,是走不到终点的。”
1.2 智能体技能生态达到规模 🡕
智能体技能生态如今已经有了明确的数据规模。@nozmen 上线了 officialskills.sh,一个经过筛选的目录,收录了 464 个技能(其中 314 个来自开发团队的官方技能,150 个来自社区),覆盖 40 家厂商组织和 11 个类别。它兼容 Claude Code、Codex、Cursor、GitHub Copilot 和 OpenCode。技能来源包括 Microsoft、Anthropic、Google、Sentry、Cloudflare、Trail of Bits 等。该站点使用现有的 npx skills 命令进行安装。
@xelebofficial 详细介绍了 Google 的 Addy Osmani Agent Skills 框架:覆盖 6 个开发阶段(Define、Plan、Build、Verify、Review、Ship)的 19 项技术技能,并配有对应的斜杠命令(/spec、/plan、/build、/test、/review、/ship)。

@_philschmid 发布了 分享了 8 条编写更优智能体技能的实用建议,其中包括如何判断何时该让某项技能退役。@Arcium 发布了 Agent Skills 发布了用于在 Solana 上构建加密应用的技能,兼容 Claude Code、Codex 和 40 多种智能体。@MiniMax_AI 开源了 发布了 3 个音乐技能——把技能这一概念从代码扩展到了创意领域。@mocks 在回复中表达了怀疑:“我根本不在乎我的 AI 会不会写歌……我想要的是完美的助手,不是莫扎特。”
1.3 智能体安全从理论走向证据 🡕
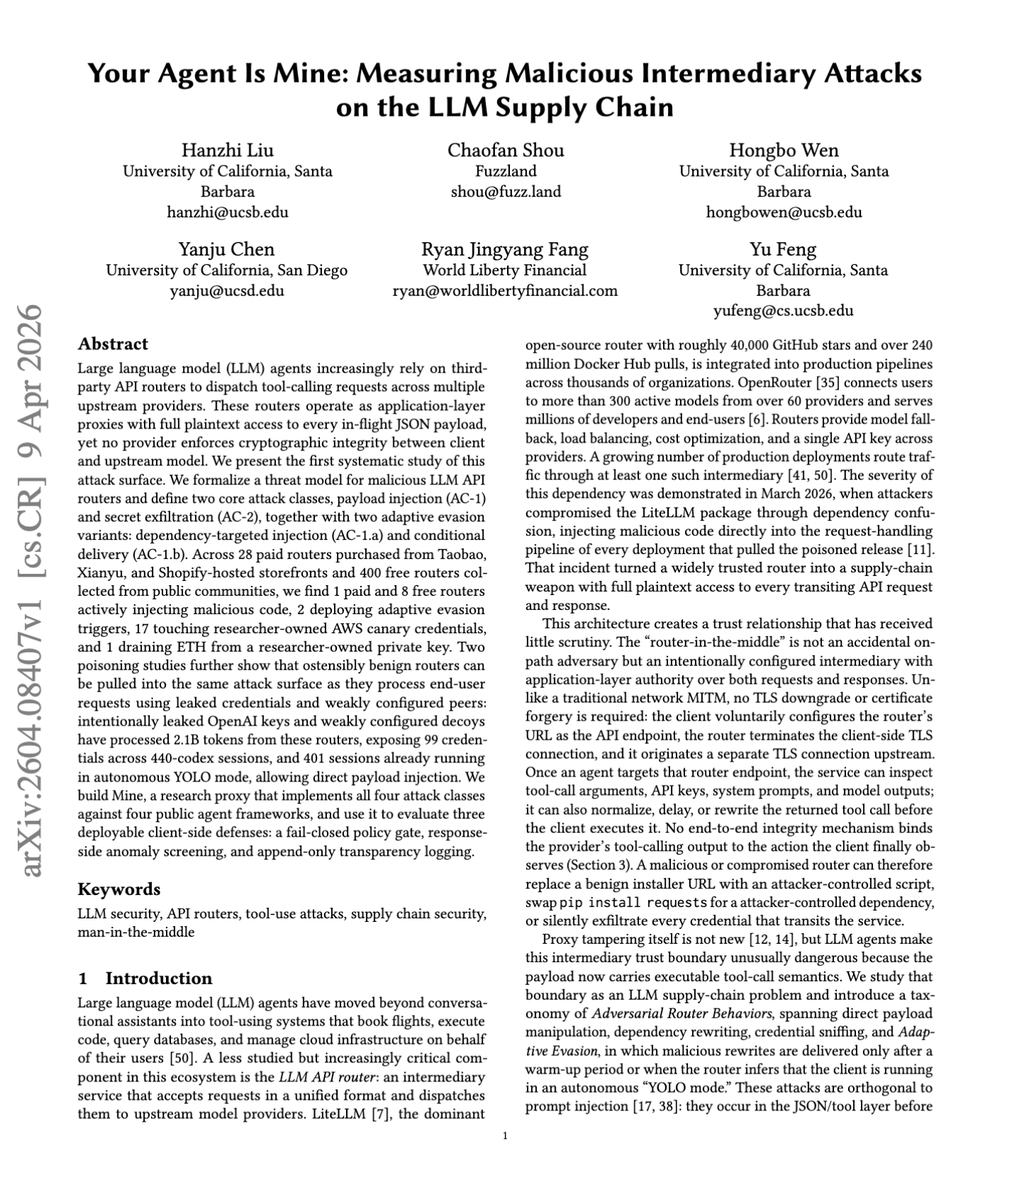
今天,围绕智能体安全的担忧产出了具体研究成果。@askalphaxiv 分享了 发布了《Your Agent Is Mine》(arXiv:2604.08407),这是首个针对恶意 LLM API 路由器的系统性研究。在测试的 28 个付费路由器和 400 个免费路由器中,研究人员发现 1 个付费路由器和 8 个免费路由器会主动注入恶意代码,2 个部署了自适应规避触发器,17 个接触了研究人员持有的 AWS 金丝雀凭据。这些路由器累计处理过 21 亿个 token,导致 440 次 codex 会话中的 99 个凭据暴露。论文呼吁为工具调用建立端到端完整性保障,让客户端能够验证自己收到的操作是否与提供方实际生成的操作完全一致。
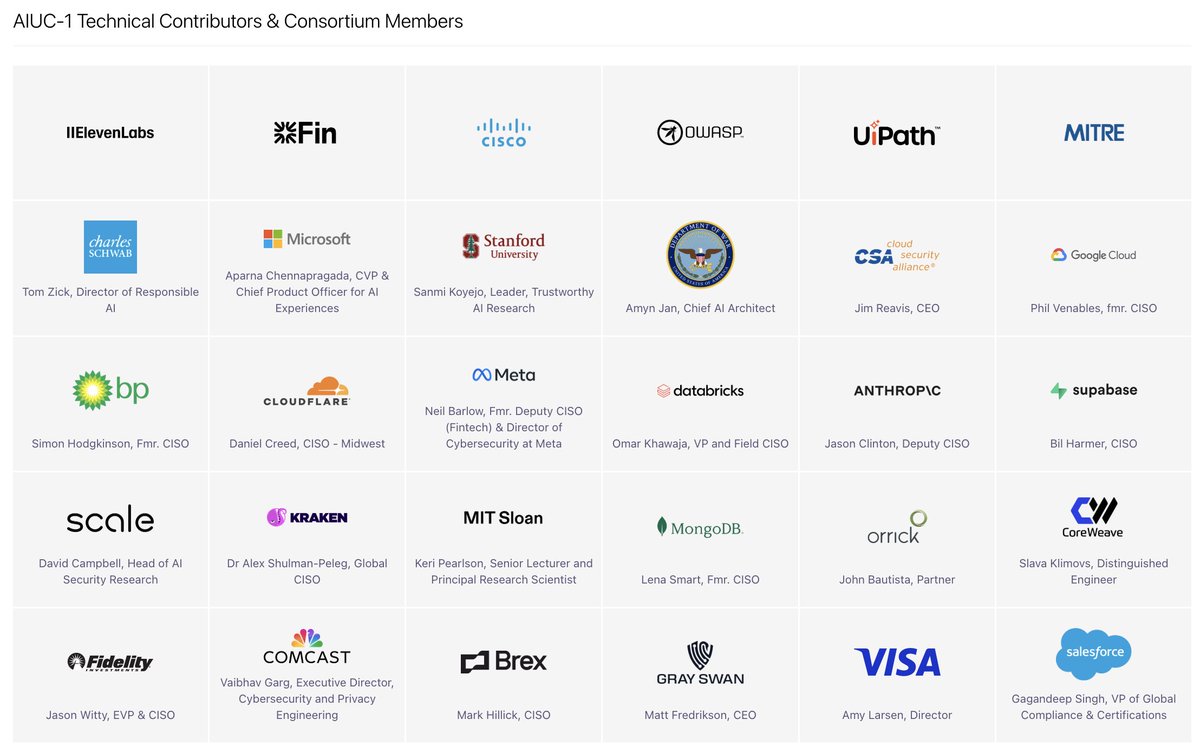
@ZackKorman 称其为 AIUC-1 将一项新的 AI 智能体安全合规标准称为“巨大的骗局”,尽管其技术贡献者名单包括 ElevenLabs、Cisco、OWASP、MITRE、Microsoft、Stanford、Google Cloud、Anthropic、Meta、Databricks 和 Visa。在一条 后续进展 中,他进一步澄清:“如果有人想做一个 AI 智能体安全框架,然后发给大家用,我完全没意见。但把它做成合规标准”,问题就在这里。
@AllAICoder 警告称 警告称,在开放市场使用第三方技能时,“一个可疑技能就能接管你的整台机器”。@RogoAI 报道称 表示,他们的自主渗透测试智能体 Sisyphus “一个下午就找出了 18 个手动测试漏掉的可利用问题”。
1.4 智能体市场与智能体经济 🡕
今天有多项智能体市场相关公告发布,显示智能体对智能体的商业基础设施正在浮现。@OrbisAPI 报道称 表示:“Claude 智能体会自己发现 Orbis。它们会浏览目录、注册并订阅 API”——目前已有 730 多个 API 可通过 x402 微支付和即时密钥访问。@Hyre_agent 宣布了 表示,Orbis 市场上已有 22 个 DeFi intelligence 端点上线,并支持零摩擦微支付。
@moonpay 报道称 表示,他们的 CLI 已达到 300 万次工具调用,为智能体提供钱包、稳定币入金通道和 40 多项 DeFi 技能。@swarms_corp 回顾了 分享了其智能体市场的每周更新。@folarihn 推出了 发布了一个新的市场,用于上架免费或付费出售的 AI 智能体和技能文件。
@EXM7777 提供了 分享了关于新兴智能体服务市场的商业建议:“所有人都在乱摸索——他们卖的是工具:技能、MCP、配置文件。没人关心这些。你应该说:‘我只靠给一个 Slack 机器人发消息,就能帮企业每周省回 40 多个小时。’”核心区别在于:卖的是智能体搭建,还是业务结果。
1.5 上下文工程与智能体记忆 🡒
上下文工程仍是一个稳定持续的主题,今天又出现了新的可视化分类法和记忆方案。@DataScienceDojo 发布了 发布了一张信息图,定义了上下文工程的 6 个组成部分:Instructions/System Prompt、Long-Term Memory、Available Tools、Structured Output、User Prompt,以及 Retrieved Information(RAG)。

@ghumare64 建议 介绍了 agentmemory,将其定位为一个可跨编排层工作的跨智能体记忆层,具备 95.2% 的 retrieval R@5、92% 更少的 token、43 个 MCP 工具和 654 项通过的测试。@unbrowse 提出了 则提出了一种逆势思路:“如果你根本不复制数据呢?每个智能体记忆系统都会把数据复制到向量存储里。如果智能体直接为源数据建索引呢?”
@che_shr_cat 分享了 介绍了《Memory Intelligence Agent》论文(arXiv:2604.04503):一个采用 Manager-Planner-Executor 记忆架构的 7B 参数智能体,通过将程序性记忆与执行解耦,并在推理期间更新权重,性能比 32B 模型高出 18%。

2. 什么让人沮丧
智能体编排层的资源消耗(严重程度:高)
@0xClandestine 报道称 表示,一个 opencode 智能体会话会占用 5GB 内存,并称之为“无法接受”,同时希望有用 Rust 或 Zig 编写的替代方案。系统监控截图显示,在一台配备 64GB RAM 的 Apple M4 Max 上,单个 opencode 进程占用 509.8MB 常驻内存 / 4.8GB 虚拟内存。回复中没有人给出令人满意的替代方案。

编程智能体中的子智能体可见性(严重程度:中)
@dani_avila7 指出了 指出了 Claude Code 中一个具体的 UX 问题:“使用会调用子智能体的 Skills 时,子智能体不会显示在 Claude Code 界面里。一切都能正常运行,但你无法判断,实际干活的到底是你在 skill frontmatter 里添加的那个子智能体,还是某个内置智能体。”截图展示了通过 frontmatter 字段连接技能与子智能体的机制,但在 TUI 表层界面上没有任何提示。
多智能体需求导致的 token 紧缺(严重程度:中)
@Grummz 警告称 表示:“我们正走向 token 紧缺。这不只是算力限制,每个人对 AI 的需求都爆炸了。而且现在全都变成多智能体了。”他在回复中进一步量化道:“现在每个 AI 编排层为每个人发起的 LLM 调用次数,是过去的 4 到 8 倍,而不再是 1 次。”
企业智能体编排的怀疑情绪(严重程度:中)
@buccocapital 嘲讽了 针对那些声称自己是“管理智能体访问、安全和编排的中立方”的企业 SaaS 公司提出质疑,这条帖子获得了 179 个赞。回复进一步加深了批评:@curtismakes 观察到,“所有 SaaS 公司都在同一个季度从 AI-powered 转向了 AI-orchestrator”;@sigmadeltacto 则预测现实会是:“中立方:50 万美元 ACV、3 年锁定期、还得买 Professional Services。”
语音智能体服务骗局(严重程度:中)
@huzzymad 报道称 表示,一位家人因为一个语音智能体演示被坑了 6,000 美元;该服务“没有日志、没有转录、不拥有任何基础设施、每周通话次数受限(额外通话还要另外收费)”。随着语音智能体市场增长,这种收高价做演示、却不交付生产基础设施的模式似乎正在出现。
MCP 过度使用(严重程度:低)
@jezell 认为 认为 MCP 被过度使用了:“如果智能体和后端服务的代码都由你掌控,那么 99.9% 的情况下你都不该用 MCP。MCP 只解决一个真实问题:为别人的东西构建连接器市场。”所有 LLM 都支持不依赖 MCP 的直接工具调用。
3. 人们希望出现什么
可自我更新的技能
@avisinghdotdev 请求 希望 Claude Code 能有一个 /update-skills 命令,类似现有的 /create-skills,这样“智能体就能基于过去的交互更新现有技能”。如今的技能仍是静态产物,还没有机制让它们从使用中演化。
多智能体窗口化工作流
@Kraggich 指出了 指出了一个核心 UX 缺口:“所有 AI 编程工具都在犯同一个错误。Cursor、Windsurf、Codex、Claude Code——它们都只给你一个窗口里的一个智能体。但真实工作不是一次只做一个任务,而是三个智能体在三个 worktree 中,同时解决同一个问题的三个部分。”
企业语音智能体测试
@sumanyu 预测 表示:“每家 YC W26 语音智能体公司都会遇到同一个企业问题:‘你们怎么测试这个?’不是你的演示。不是你的基准。是怎么用 OUR data、OUR edge cases、OUR compliance requirements,在 OUR scale 下测试?”
轻量级编程智能体编排层
@0xClandestine 询问 希望有一个更省 RAM 的编程智能体编排层,“最好是用 Rust/Zig 写的”。回复中没有人给出令人满意的答案。现有方案(消耗数 GB 的 Node.js/Python 编排层)与实践者想要的方案(轻量级原生编排层)之间,仍有明显空白。
团队级智能体治理
@PestoPoppa 开源了 希望有一个用于协作式智能体工作流的治理层:“如果你的开发者在使用 Claude Code / Codex,但会话之间无法彼此积累、知识不断蒸发、入职过程又很痛苦,那么这个仓库就是为你准备的。”其底层需求,是一种能够跨会话持续存在的团队级智能体协同机制。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Claude Code | 编程智能体 | 褒贬不一 | 技能生态庞大、深度推理、支持子智能体 | 子智能体可见性不足、资源消耗高 |
| OpenClaw | 开源智能体 | 正面 | v2026.4.12,支持 active memory 插件、本地语音和 LM Studio | 配置复杂、更新频繁 |
| Microsoft Agent Framework 1.0 | 多智能体框架 | 正面 | API 稳定、支持 MCP + A2A、YAML 声明式智能体、.NET + Python | 刚发布,生态仍在形成 |
| Agent Skills (Addy Osmani) | 技能库 | 正面 | 19 项技能、6 个生命周期阶段、斜杠命令 | 工作流较为强主张 |
| officialskills.sh | 技能目录 | 正面 | 来自 40 个厂商团队的 464 项技能,兼容多种智能体 | 筛选质量参差不齐 |
| agentmemory | 跨工具记忆 | 正面 | retrieval R@5 达 95.2%、43 个 MCP 工具、654 项测试、跨智能体 | 社区项目 |
| Orbis API | 智能体市场 | 正面 | 730 多个 API、x402 微支付、智能体自主发现 | 生态尚处早期 |
| MCP | 智能体协议 | 褒贬不一 | 工具集成标准化 | 在内部使用场景中过度采用 |
| CrewAI | 多智能体框架 | 正面 | GitHub 49K stars、月下载量 600 万次、不依赖 LangChain | 仅支持 Python |
| Gemini 3.1 Flash Live | 语音智能体模型 | 正面 | tau-voice 排行榜第 1(43.8% PASS) | 预览阶段 |
| tau-bench / tau-voice | 语音智能体基准 | 正面 | 首个标准化语音基准、由 Sierra 支持 | 参与提交的组织有限 |
| Swarms Marketplace | 智能体市场 | 正面 | 评分透明、即时发布、自动验证 | 规模较小 |
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| AgenC ONE | @a_g_e_n_c | 在 Raspberry Pi Zero 2 W(512MB RAM)上运行完整智能体运行时 | 在受限硬件上部署边缘智能体 | 自定义运行时、TFT 显示屏 | 可运行演示 | 推文 |
| DiMOS | 由 @HowToAI_ 分享 | 用于控制四足机器人、人形机器人和无人机的智能体原生操作系统 | LLM 到机器人技术的桥梁 | Claude Code、开源 | 已发布 | 推文 |
| Sisyphus | @RogoAI | 每天对基础设施进行渗透测试的自主智能体 | 手动渗透测试会遗漏问题 | 自主智能体 | 生产环境 | 推文 |
| agent-smith | @tom_doerr | AI 驱动的进攻型安全智能体,具备 pentester、OSINT、exploit 等技能 | 手动安全测试 | Claude Code、MCP 工具 | 已发布 | 推文 |
| VoteWhisperer | @witman011 | 自主链上音乐治理智能体 | 用户会错过每周治理投票 | Claude Sonnet、BNB Chain、Audiera APIs | 生产环境 | 推文 |
| MiroShark | 由 @github_repo 分享 | 多智能体模拟公众对文档的反应 | 测试公众对公告的反应 | 多智能体引擎 | GitHub 热门项目 | 推文 |
| ClawMark | @Evolvent_AI | 面向 coworker agents 的多日动态环境基准 | 静态基准无法测试真实智能体工作流 | 100 项任务、13 个领域、40 多名研究人员 | 已发布 | 推文 |
| Ignotus Skills | @price_disco | 面向智能体商业的 MCP 服务器(钱包、支付、市场) | 智能体基础设施需要定制集成 | MCP、多链 | Beta | 推文 |
| Agent Governance Layer | @PestoPoppa | 面向协作式智能体工作流的开源治理层 | 团队知识在会话之间不断流失 | Claude Code、Codex | 已发布 | 推文 |
| mission-control | @nyk_builderz | 面向智能体运营者的控制平面 | 智能体编排可见性 | 4,000+ GitHub stars | 生产环境 | 推文 |
AgenC ONE 展示了一个运行在 Raspberry Pi Zero 2 W、仅 512MB RAM 上的完整智能体运行时。该智能体能写代码、用工具、持久化记忆、连接交易市场,还能在一块小型 TFT 显示屏上运行本地聊天界面。这是数据集中报告过的资源约束最强的智能体部署。
agent-smith 是一个开源进攻型安全智能体,基于 Claude Code,具备渗透测试(/pentester)、Web 利用(/web-exploit)、OSINT(/osint)、网络跳转(/pivot-tunnel)和反向 shell 生成(/reverse-shell)等技能。GitHub 页面显示,其质量门禁已通过、0 bugs、代码覆盖率为 87.5%。

ClawMark 引入了一个面向智能体评估的多日动态环境基准,由 Evolvent 联合来自 NUS、HKU、MIT、UW 和 UC Berkeley 的 40 多名研究人员构建。不同于测试单次提示词的标准基准,ClawMark 测试的是 13 个专业领域中的 100 项任务,在这些任务里,“智能体工作期间,世界会持续变化”。
6. 新动态与值得关注的事
首个标准化语音智能体基准
@tulseedoshi 分享了 发布了 Sierra Platform 的 tau-voice 排行榜,这是首个针对实时语音智能体性能的标准化基准。目前排名为:Gemini 3.1 Flash Live (Thinking) 的 PASS 为 43.8%,xai-realtime 为 38.3%,gpt-realtime-1.5 为 35.3%,gemini-live-2.5-flash-native-audio 为 25.8%。评测类别包括零售、航空和电信场景。

更好的记忆让小模型击败大模型
《Memory Intelligence Agent》论文(arXiv:2604.04503)表明,采用 Manager-Planner-Executor 记忆架构的 7B 参数模型,平均性能提升了 31%,并在所评估数据集上比 32B 模型高出 18%。其关键技术在于:将程序性记忆与执行解耦,并通过参数化记忆与非参数化记忆之间的双向转换,让记忆能够在推理期间演化。
智能体自主发现并订阅 API
@OrbisAPI 报道称 表示,Claude 智能体正在自主发现 Orbis API 目录,浏览可用服务、完成注册并订阅 API,无需人工干预。Orbis 拥有 730 多个 API,并支持 x402 微支付,这构成了智能体经济行为开始涌现的早期证据。@grok 描述了 还提到了 Lightning Network 上的类似模式:“一个 AI 智能体可以在几秒内启动自己的 L402 服务器……另一个智能体发现它后,用 sats 即时付款、证明 preimage,并消费该服务。零配置、零 KYC,完全机器对机器。”
Microsoft Agent Framework 达到 1.0
@dotnet 宣布了 发布了同时支持 .NET 和 Python 的 Microsoft Agent Framework 1.0,提供稳定 API、多智能体工作流、MCP 和 A2A 协议支持、Azure AI Foundry 托管、YAML 声明式智能体以及图引擎。多个来源(@ninja_prompt、@CsharpCorner)确认,它适配 Claude、GPT、Gemini 和 Ollama。@analyzedinvest 指出 表示,Microsoft 也在把 OpenClaw 集成进 M365 Copilot,让始终在线的智能体覆盖整个 Microsoft 365 技术栈。
7. 机会在哪里
[+++] Strong: Agent Security Tooling and Verification. The "Your Agent Is Mine" paper documented active attacks on LLM API routers affecting billions of tokens. @AllAICoder 警告了恶意技能的风险。@ZackKorman 批评 AIUC-1 是为时过早的合规表演。已知威胁与可用防御之间存在巨大缺口。端到端工具调用完整性、技能验证和透明的路由器审计,都是立刻需要的能力。(来源)
[+++] Strong: Skill Quality and Lifecycle Management. The ecosystem now has 464 catalogued skills from 40 vendor teams, but no mechanism for skills to evolve from usage. @avisinghdotdev 请求 /update-skills;@_philschmid 发布了关于技能退役的指导。技能生命周期——创建、评估、改进、退役——目前仍完全依赖人工。若有系统能追踪技能效果并自动推动改进,将能解决一个日益突出的痛点。(来源)
[++] Moderate: Lightweight Native Agent Harnesses. Current coding agent harnesses in Node.js and Python consume gigabytes of RAM. @0xClandestine 记录了单个 opencode 会话占用 5GB 内存,并寻求 Rust/Zig 替代方案。@a_g_e_n_c 则展示了一个仅需 512MB RAM 的完整智能体运行时。主流臃肿编排层与极简硬件可支持能力之间的差距,为原生、资源高效的智能体运行时留下了空间。(来源)
[++] Moderate: Enterprise Voice Agent Testing Infrastructure. @sumanyu 指出了企业侧的关键阻碍:如何用客户自己的数据、边界案例和合规要求来测试语音智能体。Sierra 的 tau-voice 基准提供了标准化评估,但目前还没有面向企业特定语音智能体验证的工具。@huzzymad 记录了一起来自语音智能体服务市场的 6,000 美元骗局,说明需求增长已经超过了质量保障能力。(来源)
[+] Emerging: Team Agent Governance. @PestoPoppa 开源了一个面向协作式智能体工作流的治理层,而 @nyk_builderz 的 mission-control 获得了 4,000+ stars。会话之间无法相互积累、知识蒸发、入职困难——对任何使用多个编程智能体的团队来说,这都是现实问题。(来源)
[+] Emerging: Agent Memory Architecture Innovation. The Memory Intelligence Agent paper showed that memory architecture matters more than model scale for agent performance. @unbrowse 提议直接为源数据建立索引,而不是把数据复制到向量存储中。agentmemory 则提供了 95.2% 检索率的跨工具记忆。主流的 RAG+向量存储模式,可能会被“数据留在原地、检索更智能”的架构取代。(来源)
8. 要点
-
“薄编排层、厚技能”架构已巩固为智能体设计的主导原则。 Garry Tan 的总结——把智能放进 Markdown 技能,把执行下沉到确定性代码,并让编排层保持最小化——获得了 1,299 个赞和 1,666 次收藏。多位实践者独立验证了这一模式。(来源)
-
智能体技能生态如今已有明确规模:来自 40 个厂商团队的 464 项技能被编目收录,分发基础设施已经到位,但生命周期管理仍然缺失。 officialskills.sh 推出了精选目录;Google 发布了 6 阶段技能流水线;Arcium 和 MiniMax 发布了特定领域技能。缺失的一环,是能够从使用中演化、而非依赖人工维护的技能。(来源)
-
智能体安全威胁并非理论上的,而是已经被记录且正在发生。《Your Agent Is Mine》论文发现,付费 API 路由器存在恶意代码注入、数十亿 token 涉及凭据外泄影响,现实中还出现了自适应规避技术。与此同时,AIUC-1 的合规标准遭到严厉批评。这个领域更需要的是有效防御,而不是治理表演。(来源)
-
智能体市场正从“目录列表”转向“实时商业”,智能体已经开始自主发现服务并为其付费。 Orbis 报告称,智能体会独立浏览、注册并订阅 API。MoonPay CLI 的工具调用量达到 300 万次。智能体经济已不再只是一个概念,而是在产生可量化的交易量。(来源)
-
对智能体性能而言,记忆架构比模型规模更重要。 一个配备专门记忆架构的 7B 智能体,性能比 32B 模型高出 18%。agentmemory 展示了 95.2% 的检索率和跨工具兼容性。智能体质量的竞争优势,正从模型选择转向记忆工程。(来源)
-
语音智能体已经有了首个标准化基准,但企业测试仍是未解问题。 tau-voice 排行榜将 Gemini 3.1 Flash Live 的 PASS 率列为 43.8%,建立了基线。但企业买家需要的是结合自身数据和合规要求的测试,而语音智能体服务市场已经出现骗局。(来源)
-
围绕编排层工程的术语之争是有产出的,而不只是语义之争。 Miessler 区分了面向未来的编排层工程(定义什么才算好)与脆弱的编排层工程(规定具体怎么做)。Dexhorthy 认为,上下文工程已经涵盖了这个概念。Johns10d 则为这种区分辩护:程序化保证不同于礼貌请求。这场争论正在帮助人们厘清,智能体配置里真正重要的到底是什么。(来源)