Twitter AI Agent - 2026-04-14
1. 人们在讨论什么
1.1 Harness 工程从理念走向参考架构 🡕
昨天,“轻 harness、重 skills”的理念已经确立。今天,社区开始围绕它搭建参考级基础设施。@Vtrivedy10 发布了一篇第一性原理拆解 解释了 harness 存在的原因,并从模型单靠自身做不到什么倒推:模型本质上只是 token 输入/输出机器,要获得工具访问、记忆、规划和验证闭环能力,必须借助外部增强。这篇帖文获得了 206 个赞和 204 次收藏,是今天数据集中得分最高的一条。

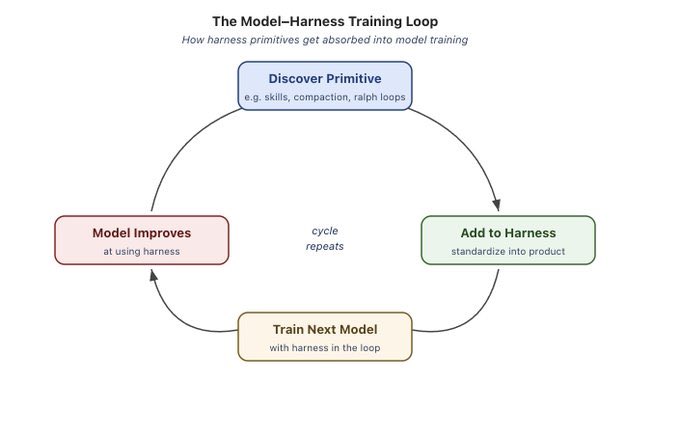
@codylindley 发布了一份 harness engineering 兼容性矩阵 在 codylindley.github.io 发布了一份对照矩阵,比较了 AGENTS.md、CLAUDE.md、GEMINI.md、copilot-instructions.md 等指令格式、自定义 agent 系统,以及 10 多种工具中的 skill 格式,涵盖 Copilot、Claude Code、OpenCode、Gemini CLI、Cursor 和 Windsurf。该帖在 26 个赞的基础上获得了 31 次收藏,是数据集中收藏/点赞比最高的内容,说明一线实践者对参考资料需求强烈。
@loiane 发布了一篇博客文章 将 harness 工程定义为一种控制系统,包含两大支柱:前馈控制(模型运行前的引导——指令、上下文、示例、schema)和自动反馈(执行后的传感器——测试、schema 校验、业务规则检查)。她引用了 Martin Fowler 关于 harness engineering 的文章,并将这一概念映射到软件交付生命周期中,认为行业正在从“人在环中”转向“人在环上”。
@Infoxicador 提出了观点 认为,如果 harness engineering 成为常态,真正值得投入的将是模块化和紧密的验证闭环——否则,“不读代码只是一味堆 token”只会造出脆弱系统。该帖获得了 30,328 次浏览和 34 次收藏。

讨论洞察: @KSimback 演示了 用个人知识库研究 harness engineering,具体分析哪些因素会形成护城河,哪些最终会被商品化。@SynabunAI 的回复给出了一个关键判断:“护城河是能跨会话留存的上下文。模型正越来越商品化。真正的锁定效应,其实在记忆层。”
与前一天对比: 昨天的讨论确立了轻 harness 原则;今天则进一步拆解到实现层面:兼容性矩阵、控制系统框架,以及明确的护城河分析。讨论焦点已从“什么是 harness engineering?”转向“我到底该怎么把它做出来?”
1.2 Skill 自我改进开始成为一种实践 🡕
今天有三支独立团队发布了自动化 skill 改进工具,把昨天仍需手工完成的 skill 生命周期,变成了自动反馈闭环。@PiSquared 开源了 skill-optimizer,一款无需反复试错、即可评估、改进并适配 agent skills 的工具。@Saboo_Shubham_ 构建了一个自我改进的多智能体系统 使用 Google Agent Development Kit 和 Gemini 3,让 skills 在测试场景中运行,诊断失败原因并自动修复。

@shannholmberg 发布了一张图示 描述了“skill 自我改进闭环”:先使用一个 skill,某处出错后修复它,再告诉 agent“把这些经验更新进 skill”,于是 skill 文件会自行重写,加入验证步骤和边界情况警告。它的标语是:“修一次——未来每次使用这个 skill 都会受益。”
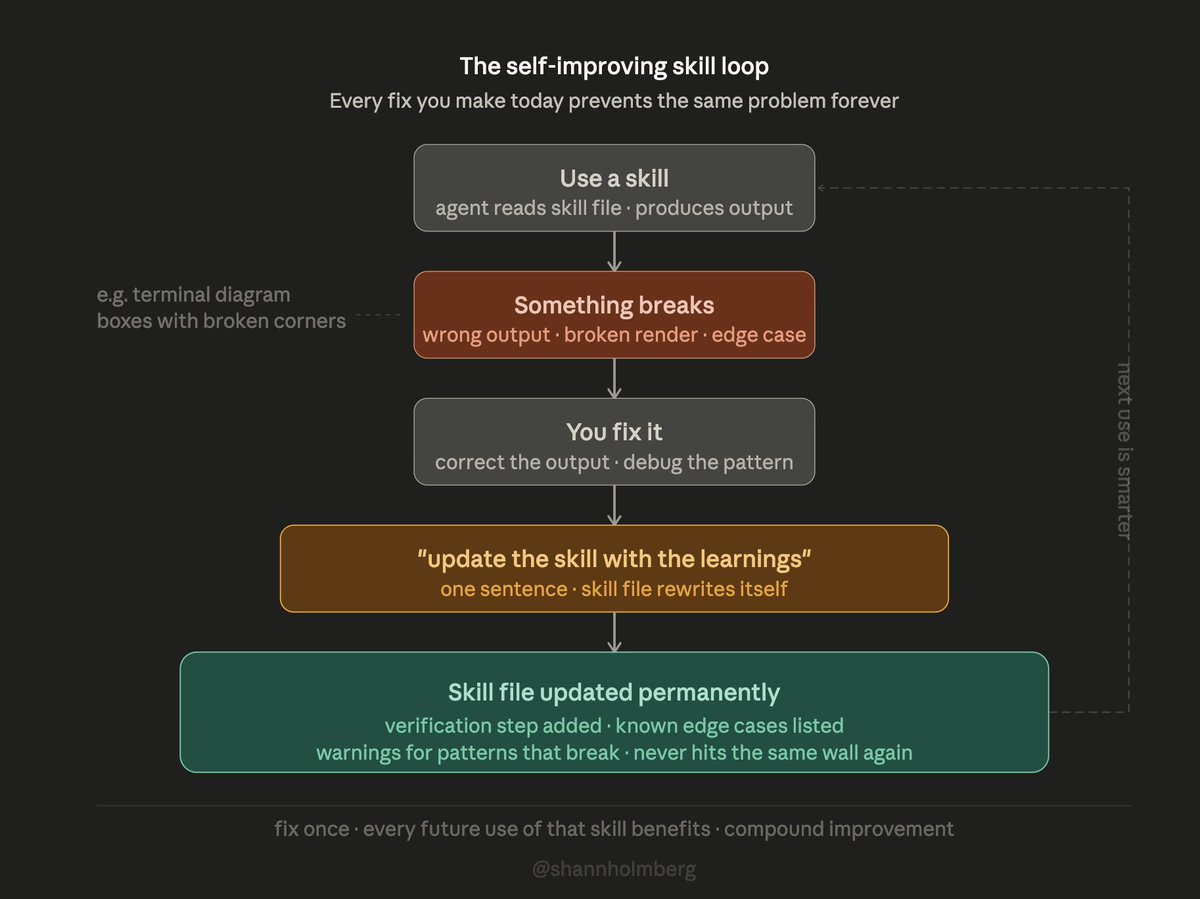
@koylanai 论证了这一点 认为,skills——也就是编码在 Markdown 流程中的知识——才是真正的产品,而 harness 只是可替换的基础设施。该帖获得 99 个赞和 98 次收藏,进一步印证了这一点。
讨论洞察: @anatoliygatt 在回复 @akshay_pachaar 的 关于 MiniMax M2.7 的帖子 时表示:“仅靠优化 harness 就带来了 30% 提升,完全不用重新训练,权重一动没动。”这是一个具体数据点,说明 harness/skill 优化可以替代模型再训练。
与前一天对比: 昨天,@avisinghdotdev 还在请求一个 /update-skills 命令。今天,三支团队已经各自发布了自动化 skill 改进方案。“skills 需要演化”和“它们该如何演化”之间的空白,在 24 小时内被填上了。
1.3 多 agent 编排走向主流 🡕
多 agent 配置正从实验性做法转向推荐实践。@code_rams 发布了 发布了一份详细的多 agent 指南,认为“只单独运行 OpenClaw,相当于把它 80% 的能力白白放掉”,并给出了互补式的 OpenClaw + Hermes 方案。该帖得分 1,088,获得 192 次收藏,在数据集中排名第三。
@databricks 发布了来自 20,000 多家组织的使用数据 展示的数据显示,多 agent 系统在不到四个月内增长了 327%,且 78% 的公司同时使用两个或更多 agent 框架。
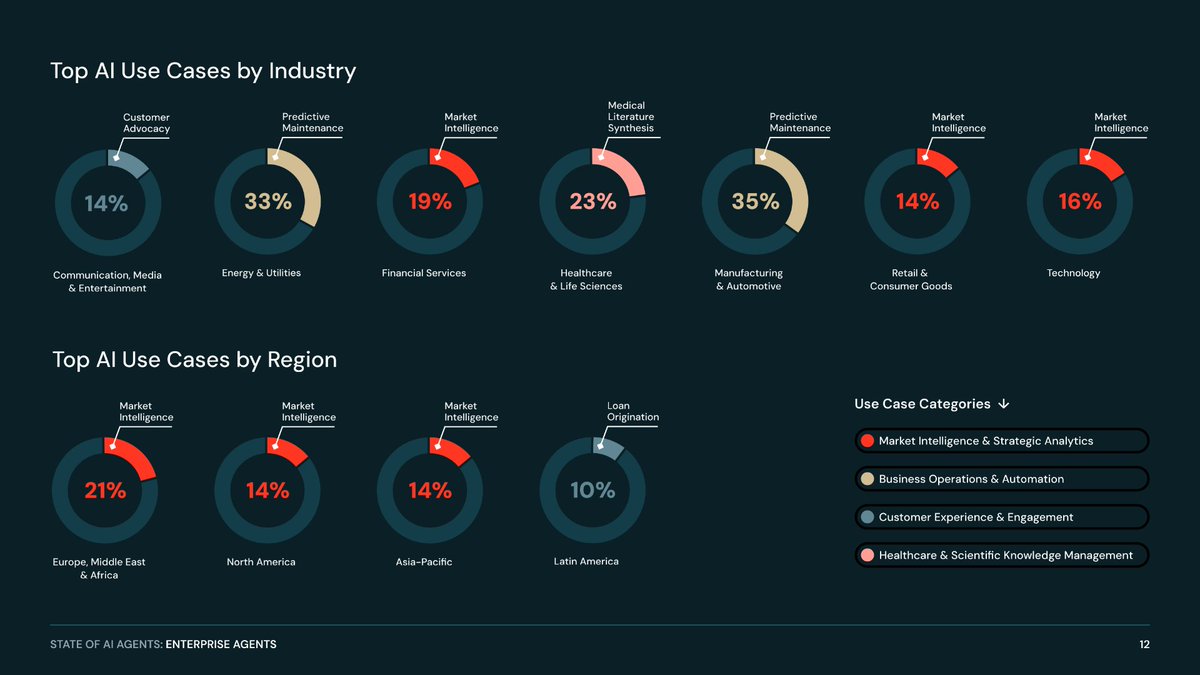
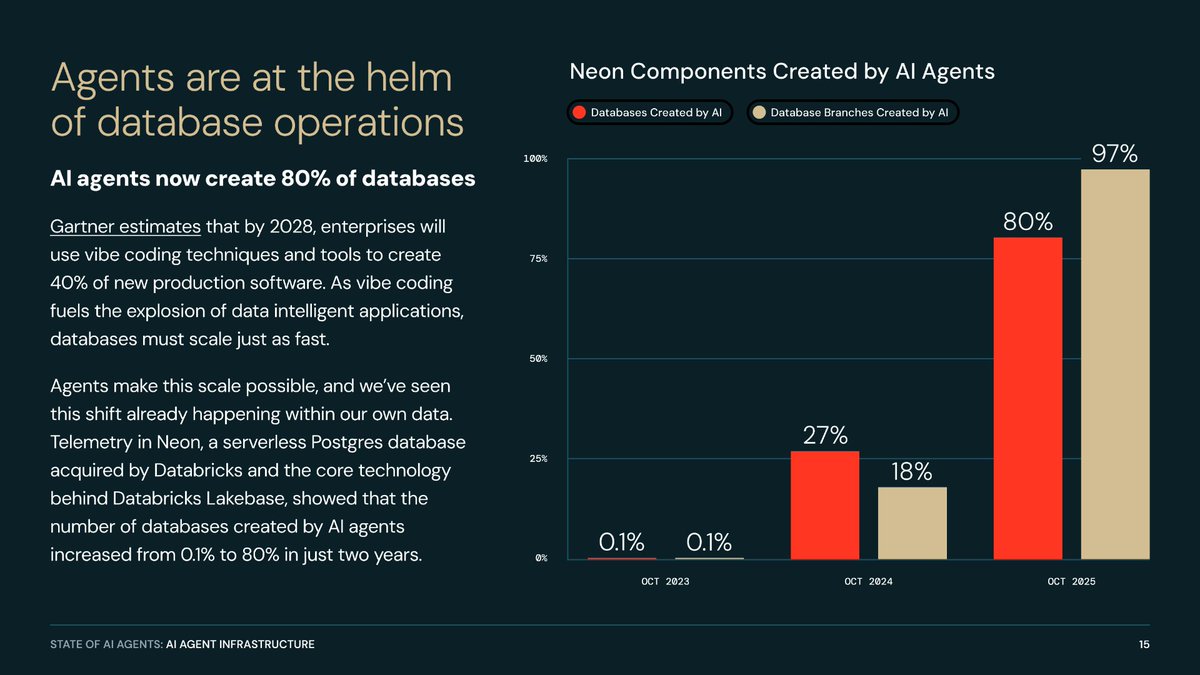
@WesRoth 报告称 表示,在 Google I/O 前夕,泄露信息显示 Google 正在测试一个自主多 agent 平台,意在直接对标 Anthropic 的 Claude Cowork。据称该平台名为“Agent”,面向 Gemini workspace。该帖获得了 200 个赞和 24,403 次浏览。
@mizzysworld 描述了 将单个 Hermes agent 拆分为多个专业角色,每个角色都“独立记忆、独立会话、共享理念”。@kevinchan 展示了 展示了他使用 Hermes 多 agent 框架产出的首个重要成果:先由 orchestrator 和 research agent 生成 PRD,再交给 coder agent 实现。

讨论洞察: @hassanlaasri 在回复 WesRoth 时预测:“随着时间推移,聊天、编码和工作区管理会越来越多地汇聚到同一个对话式界面中。”
与前一天对比: 昨天关于多 agent 的讨论还停留在概念层面。今天则有了 Databricks 数据(327% 增长、20K 组织)、实用指南(OpenClaw + Hermes)和竞争动向(Google Agent 平台)作为支撑。叙事已经从“该不该用多 agent?”转向“该用哪种多 agent 配置?”
1.4 Agent 安全:“致命三角” 🡕
@iancr 讲述了 回顾自己去年 10 月在台上发出的警告:“一个我们把登录信息、信用卡和身份都交给 agents 的 agentic 未来,会是一场安全噩梦。”六个月后,他表示这一预言已经被验证。在一篇 自回复主题帖 中,他将问题概括为“致命三角”:agents 需要访问有价值的资源(金钱、邮箱、凭证、浏览器、文件),但目前并不存在验证基础设施来确保它们安全使用这些资源。该帖获得了 41 次转发——对于一则安全警告来说,放大效应异常明显。
@omarsar0 分享了 介绍了来自 Stanford、KAUST 和 MIT 的论文《多用户大语言模型 Agent》(arXiv:2604.08567)——这是首个系统研究多用户 LLM agent 交互的工作。论文发现,在用户目标冲突时,前沿 LLM 无法维持稳定的优先级排序,而且在多轮交互中会出现越来越严重的隐私违规。

@a_g_e_n_c 已发布 发布了一项 devnet 任务系统更新,将 marketplace 中的任务视为不可信输入:“任务可以描述工作、报酬、约束和交付物,但任务文本本身不具备任何权威性。”任务哈希则充当加密意义上的工作合约。
讨论洞察: @FoltzAI 在回复 @rryssf_ 时问道:“还要多久,context curator 才会成为常态?”这将安全性与上下文质量框定为同一个信任问题的两面。
与前一天对比: 昨天记录的是针对 LLM API 路由器的现实攻击(《Your Agent Is Mine》论文);今天则转向架构层面的应对:包括“致命三角”框架、多用户隐私研究,以及加密任务校验。
1.5 上下文噪声被重新定义为核心问题 🡒
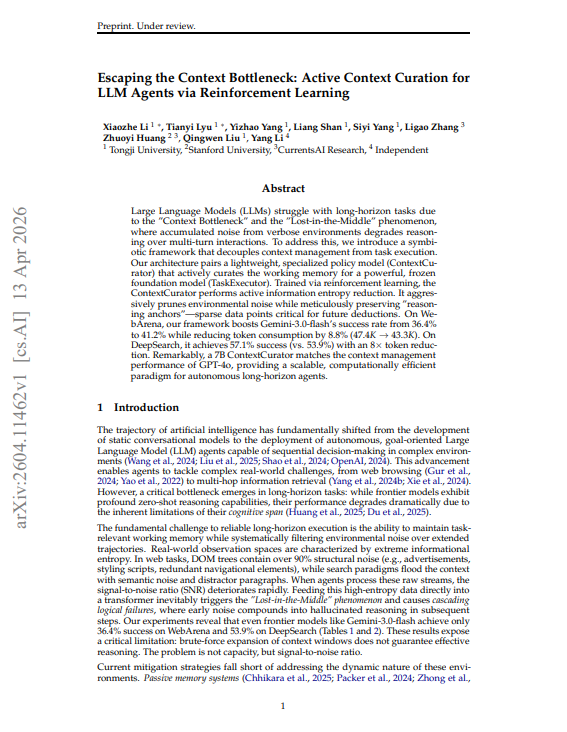
@rryssf_ 发帖称 认为:“所有主流 AI agent 框架都在解决错的问题。它们在扩展上下文窗口,但问题不在容量,而在于 agent 读到的内容里有 90% 都是结构性噪声。”该帖获得了 6 次引用转发和 66 次收藏,说明它引发了实质性争论。
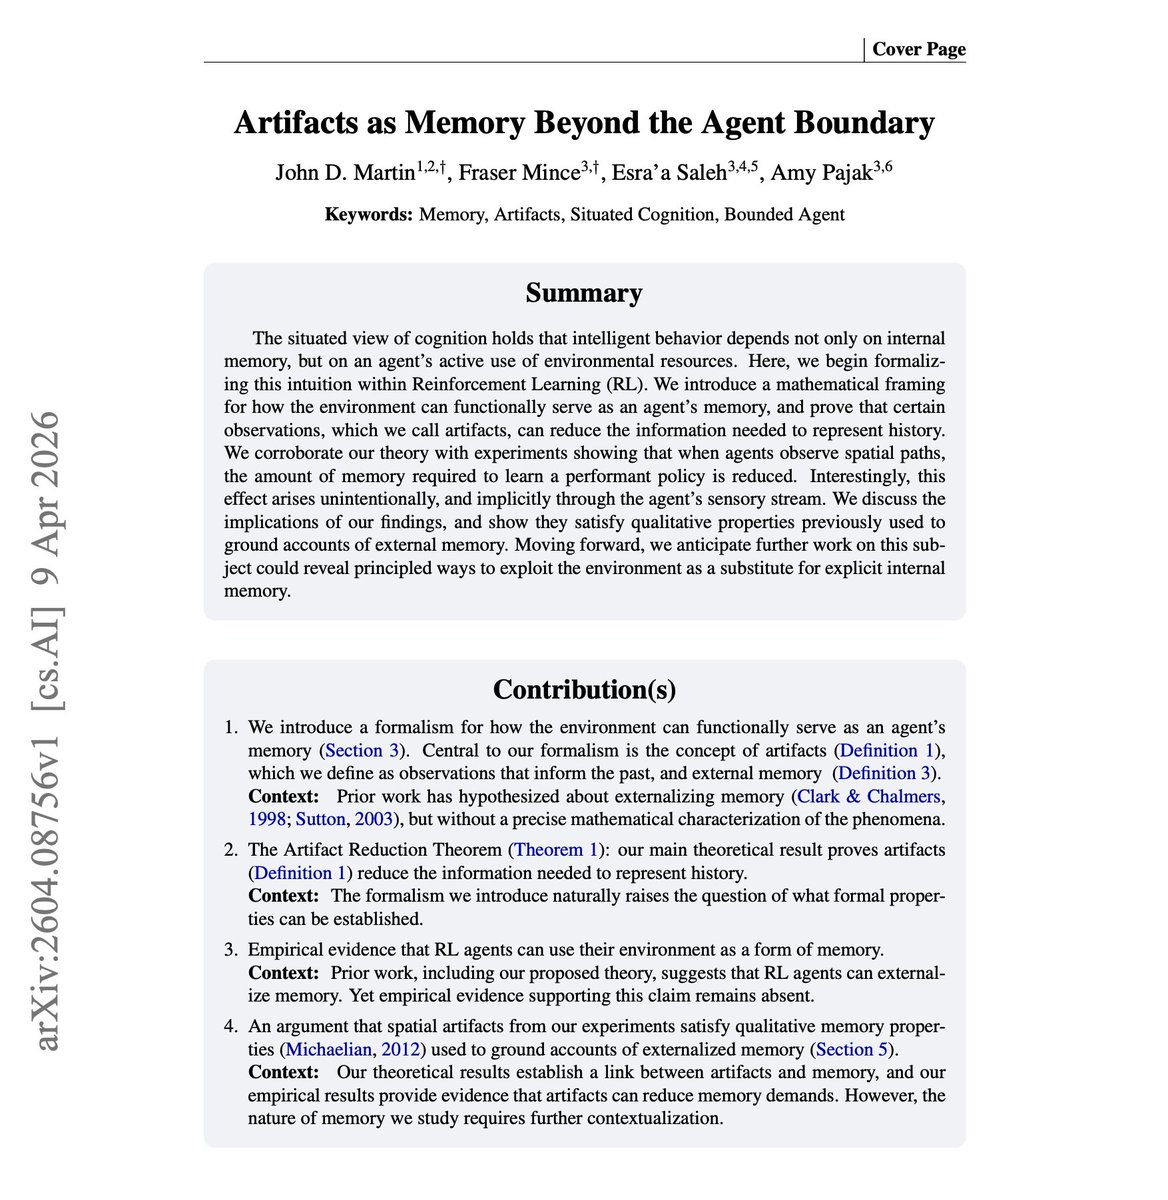
@dair_ai 分享了 介绍了论文《超越 Agent 边界的记忆:以工件为载体》(arXiv:2604.08756),正式阐述环境本身如何充当 agent 的记忆。“工件归约定理”证明,某些环境观察可以减少 agent 需要在内部存储的信息量——agent 可以把环境当作外部记忆,而不是把一切都复制进上下文。
@talraviv 指出 感叹:“文件共享我们 19 年前就解决了,但共享 AI 上下文至今还没解决。”用 Zapier 产品副总裁的话说,目标是“让上下文工程成为团队运动”。
与前一天对比: 昨天关于 context engineering 的讨论聚焦于分类法(6 个组成部分)和跨工具记忆;今天则重构了问题定义:瓶颈不在上下文窗口大小,而在上下文内部的信噪比。
1.6 中国 AI 解决开放数学问题 🡕
@commiepommie 报道称 表示,北京大学的双 agent 框架在无人类干预的情况下,解决了交换代数领域一个悬而未决十年的开放问题。该系统通过两个协作 agent 自主生成并验证证明。

与前一天对比: 前一天没有直接先例。这代表着基于多 agent 架构的 AI 数学推理能力出现了一次台阶式跃升。
2. 什么让人感到沮丧
平台依赖风险(严重程度:高)
@heynavtoor 报道称 表示,自己在 24/7 运行 OpenClaw 时,Anthropic 毫无预警地终止了其 Claude Max 订阅($200/月):“Anthropic 一封邮件发来,一切就全停了。没有预警期,没有迁移窗口,直接结束。”截图显示了 Anthropic 发出的终止邮件。
这延续了昨天已经出现的模式:依赖订阅的工作流会制造单点故障。“始终在线的 agent 基础设施”与“可被撤销的按月订阅式 API 访问”之间的落差,仍然是一个结构性问题。
上下文噪声,而不是上下文大小(严重程度:高)
@rryssf_ 认为 认为,agent 框架靠扩展上下文窗口来解决错的问题,因为其中 90% 的内容都是结构性噪声。多条回复印证了这种挫败感。@FoltzAI 追问,为什么前沿实验室还没有把上下文策展做成内置功能。框架在优化容量,而实践者真正需要的是信号质量。
Agent 框架中的知识产权张力(严重程度:中)
@uniquesingh__ 提到了 转述了来自 @EvoMapAI 的指控,称 Hermes 团队照搬了他们的 “Evolver” agent 框架——“同样的 loop、同样的结构、同样的推理链”。该帖获得 81 个赞和 53 条回复。随着 agent 框架不断涌现,围绕架构模式的知识产权争议也越来越常见。
对 Agent 编排的怀疑(严重程度:中)
@alexhillman 称其为 将那些声称能提供“盒装 AI 公司”的 agent 编排工具批评为“生产力 cosplay”。批评指向的是一个落差:demo 级 agent 编排看起来光鲜,但距离生产级 agent 管理还很远。
3. 人们希望出现什么
面向团队的共享 Agent 上下文
@talraviv 指出了 表示,文件共享问题解决 19 年后,共享 AI 上下文依然无解。Zapier 的产品副总裁把目标描述为“让上下文工程成为团队运动”——团队该如何共享知识、提示词和 agent 配置,让每次 agent 会话都能站在之前工作的基础上继续推进?
上下文策展层
@FoltzAI 在回复 @rryssf_ 的 关于结构性噪声的帖子 时问道:“还要多久,context curator 才会成为常态?为什么前沿实验室明天就不能把它做成一个功能?”讨论并未给出令人满意的答案。原始上下文窗口与经过策展、信号密度更高的上下文之间,仍存在明显空白。
Agent 订阅可移植性
@heynavtoor 的 经验分享 记录了 Claude Max 订阅一夜消失的经历,凸显出对可移植 agent 基础设施的需求——它不能依赖单一供应商的订阅条款。除运行本地模型外,目前尚无解决方案。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Claude Code | 编码 agent | 褒贬不一 | 深度推理、庞大的 skill 生态、支持 subagent | 平台依赖风险、订阅可能被撤销 |
| OpenClaw | 开源 agent | 正面 | 6.5M MAU、143K GitHub stars、与 Hermes 互补 | 按 @code_rams 的说法,不采用多 agent 配置会损失 80% 的能力 |
| Hermes Agent | 多 agent 框架 | 正面 | 记忆、研究、编排、专家角色 | 与 EvoMapAI 存在知识产权争议,配置复杂 |
| Runtime (runtm.com) | agent 基础设施 | 正面 | harness、沙箱、可观测性、多 agent、可自托管 | 新发布,尚未证明可大规模运行 |
| GBrain | 个人 agent 大脑 | 正面 | PGLite(无需服务器)、dream cycle、entity sweep、集成能力 | 需要前沿模型(Opus 4.6 / GPT-5.4) |
| Google ADK | agent 开发工具包 | 正面 | Gemini 3 集成、自我改进 skills | 受 Google 生态锁定 |
| skill-optimizer | skill QA 工具 | 正面 | 开源、自动化 skill 评估与改进 | 新项目,社区属性强 |
| Letta Code | agent 框架 | 正面 | Recall subagent 可作为主上下文的分支,获 Dex Horthy 认可 | 采用范围较小 |
| LiveKit Agent Console | 语音 agent 调试 | 正面 | 实时查看 pipeline、跟踪延迟、检查 tool call | 仅适用于语音 agent |
| Pipecat | 语音 agent 框架 | 正面 | 构建实时语音 agent | 内容仍处于教程阶段 |
| Fire-PDF | PDF 解析器 | 正面 | 基于 Rust,Markdown 转换速度提升 5 倍 | 新发布 |
Runtime 由 @ycombinator 发布、@gustrigos 构建,是最值得关注的新工具。它把 harness engineering 产品化,为 Claude Code、Codex、Gemini CLI 和 OpenCode 提供带沙箱的环境、策略控制(支出上限、文件保护)以及会话级可观测性。支持自托管,并采用 MIT/Apache/AGPL 许可。由 @garrytan 发布的 GBrain 引入了 “dream cycle”——夜间进行记忆整合,agent 会执行 entity sweep、修复引用,并让知识持续复利积累。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Runtime | @gustrigos | 为编码 agent 提供 harness、沙箱和可观测性 | 团队需要从零搭建 agent 基础设施 | 多 agent、可自托管 | 已发布(YC) | 推文, 网站 |
| Fuel | @ashleyhindle | 带有明确方法论的开发工作流 harness | 无结构的 agent 工作流 | 自定义 harness | 第一天 | 推文 |
| GBrain | @garrytan | 带记忆整合能力的个人 agent 知识库 | agents 缺乏持久的个人上下文 | PGLite、OpenClaw/Hermes、Bun | 已发布 | 推文, GitHub |
| skill-optimizer | @PiSquared | 自动化 skill 评估、改进与适配 | skill 维护依赖人工 | 开源 | 已发布 | 推文 |
| Harness 兼容性矩阵 | @codylindley | 跨工具比较指令格式与 skill 系统 | 缺乏 harness 配置的标准参考 | 静态网站 | 已发布 | 推文, 网站 |
| LiveKit Agent Console | @livekit | 面向语音 agent 的实时调试界面 | 无法观察语音 agent pipeline | LiveKit 平台 | 已上线 | 推文 |
| AgenC Devnet 任务系统 | @a_g_e_n_c | 面向 agent marketplace 的加密任务校验 | marketplace 任务被当作可信输入 | 自定义 runtime | Devnet | 推文 |
| ClickNClaw | @ClickNClawLabs | 原生 Windows 多 agent 编排桌面应用 | agent 工具被困在浏览器标签页和 Web 封装中 | Windows 原生、Gemini CLI | 可运行演示 | 推文 |
| 自我改进 Skills(ADK) | @Saboo_Shubham_ | 测试、诊断并修复 agent skills 的多 agent 系统 | skill 调试和迭代依赖人工 | Google ADK、Gemini 3 | 演示 | 推文 |
Runtime 是首个明确面向团队打包 harness engineering 的产品。它会为每个仓库自动配置沙箱环境,提供策略控制(支出上限、文件保护、按用户设置规则),并原生集成 Slack、Linear、GitHub 和 Jira——让 PM 和设计师即便不懂 git,也能触发 agent 会话。
GBrain 引入了 “dream cycle” 这一概念:通过每晚执行的 cron 任务,agent 在个人知识库中完成 entity sweep、修复引用并整合记忆。随着 agent 将会议、邮件、推文和语音通话加工成可搜索、可关联的知识,这个“大脑”会不断复利增长。
6. 新动态与值得关注的内容
Databricks:20,000 家组织中的多 Agent 采用增长 327%
@databricks 发布了 提供了首批多 agent 系统的大规模采用数据。来自全球 20,000+ 家组织的关键发现包括:多 agent 系统在不到四个月内增长了 327%,而 78% 的公司同时使用两个或更多 agent 框架。这是本数据集中关于多 agent 采用情况最硬的一组使用数据。

Harness Engineering 兼容性矩阵
@codylindley 发布了 发布了一份 全面的兼容性矩阵,对 Copilot、Claude Code、OpenCode、Gemini CLI、Cursor、Windsurf 等工具的指令格式、agent 系统和 skill 格式进行了比较。该矩阵涵盖作用域机制(仓库根目录、子目录、glob 模式)、激活方式以及跨工具兼容性,是对碎片化 harness 配置格局进行标准化的首次尝试。
ClickHouse CEO 谈 Agent 驱动的数据基础设施转向
@ceo_clickhouse 引用了 发布了一篇分析,认为“看空 Snowflake 的 AI 逻辑,核心在于人类和 agent 在数据访问偏好上的差异”。随着 agents 越来越多地直接查询数据基础设施,那些为人类仪表盘和 SQL 工作台交互优化的产品,可能会在面对为程序化、高吞吐 agent 访问模式优化的产品时处于劣势。该帖获得了 38,337 次浏览。
多用户 Agent 的隐私失败被系统记录
来自 Stanford、KAUST、多伦多大学和 MIT 的《多用户大语言模型 Agent》论文(arXiv:2604.08567)指出,同时服务多个用户的前沿 LLM 在多轮交互中会出现越来越严重的隐私违规,并且在用户目标冲突时无法维持稳定的优先级排序。这是首项系统研究多委托方 agent 问题的工作。
7. 机会在哪里
[+++] Skill Lifecycle Automation. Three independent teams shipped skill self-improvement tools today (@PiSquared、@Saboo_Shubham_ 和 @shannholmberg 提出的概念闭环,指向了同一个机会。昨天这还是未被满足的需求;今天已经出现了三个相互竞争的实现,但仍没有标准方法。“已经存在的 skills”和“能随时间持续复利提升质量的 skills”之间的差距,正是下一轮平台优势可能形成的地方。Databricks 的数据表明,78% 的采用者都在使用多框架,因此能跨工具工作的 skills 将拥有超额价值。(来源)
[+++] Agent Infrastructure for Teams. Runtime (YC-backed) launched today, but the market for team-level agent infrastructure -- harnesses, sandboxes, observability, governance -- is wide open. @talraviv 将共享 AI 上下文定义为尚未解决的问题。@ashleyhindle 则发布了 Fuel。模式已经很清楚:个人使用 agent 已经跑通;团队使用 agent 则需要一套尚未成熟的基础设施。(来源)
[++] Context Curation over Context Expansion. @rryssf_ 提出的判断——agent 上下文中 90% 都是结构性噪声——引发了 66 次收藏和 6 次引用转发的共鸣。论文《以工件为记忆》(arXiv:2604.08756)则为环境记忆提供了理论基础,可减少对内部上下文的需求。谁能做出一个策展上下文的工具(去噪、突出信号),而不是一味扩展上下文,谁就能解决一个已被实践者明确指出的痛点。(来源)
[++] Agent Security Verification. The "lethal trifecta" (@iancr)、多用户隐私失败(arXiv:2604.08567),以及 AgenC 的加密任务校验,都在指向同一个缺口:agents 需要访问有价值的资源,但验证基础设施并不存在。多用户论文证明,这不是纸面上的理论问题——在多委托方条件下,前沿模型确实会违反隐私约束。(来源)
[+] Personal Agent Memory Systems. GBrain's "dream cycle" concept -- nightly memory consolidation, entity sweeps, knowledge compounding -- represents a new category of agent infrastructure. @KSimback 的研究表明:“护城河是能跨会话留存的上下文。” 会话级 agent 记忆与持久、可复利积累的个人知识之间,仍有巨大空白。(来源)
[+] Platform-Independent Agent Access. @heynavtoor 的 Claude Max 终止事件,展示了依赖订阅的 agent 工作流有多脆弱。随着 agents 变成始终在线的基础设施,“可被撤销的订阅”与“关键业务 runtime”之间的不匹配,将催生对平台无关 agent 访问层的需求。(来源)
8. 要点
-
Harness engineering 在一天之内从理念走向参考架构。 社区已经构建出比较 10 多种工具的兼容性矩阵、控制系统框架(前馈 + 反馈),以及明确的护城河分析资源。讨论焦点已从“它是什么?”转向“该怎么实现?”(来源)
-
Skill 自我改进不再只是愿望——三支独立团队都已发布实现。 PiSquared 开源了 skill-optimizer,Saboo 用 Google ADK 做出了自我改进 skills,shannholmberg 则画出了复利式改进闭环。仅靠优化 harness 就能带来 30% 的性能提升(零重训练),说明 skill 质量比模型选择更重要。(来源)
-
多 agent 采用已经有了硬数据:20,000 家组织中增长 327%,其中 78% 使用两个或更多框架。 Databricks 提供了首批大规模证据,表明多 agent 系统不是实验品,而是默认模式。Google 为 Gemini 测试中的泄露“Agent”平台,也说明大型厂商已把多 agent workspace 视为竞争战场。(来源)
-
Agent 安全研究正在跑赢 agent 安全基础设施。 Stanford/MIT 的多用户论文记录了会随着多轮交互而恶化的隐私违规。“致命三角”框架则抓住了结构性问题:agents 需要访问价值资源,但缺乏验证机制。AgenC 的加密任务校验,是今天唯一观察到的实现层回应。(来源)
-
Agentic AI 的护城河正从模型访问转向持久上下文。 多个信号正在汇合:GBrain 用于知识复利的 “dream cycle”、KSimback 的护城河分析将“能跨会话留存的上下文”视为锁定来源,以及《以工件为记忆》论文把环境记忆理论化为内部上下文的替代方案。模型正在商品化;不会商品化的是会话之间能留下来的东西。(来源)
-
平台依赖如今已成为生产级 agent 工作流中有据可查的风险。 Anthropic 终止了一个用于始终在线运行 OpenClaw 的 Claude Max 订阅,没有任何预警,也没有迁移窗口。随着 agents 变成关键基础设施,这种“可撤销的订阅式访问”构成了市场尚未解决的结构性脆弱点。(来源)
-
上下文质量,而非上下文数量,正成为新的瓶颈。 “agent 上下文中有 90% 是结构性噪声”这一判断在社区中引发了共鸣。《以工件为记忆》论文提供了理论上的替代路径:让 agents 把环境当作记忆,而不是把一切都复制进上下文窗口。context engineering 正在从“有多大?”转向“有多干净?”(来源)