Twitter AI 智能体 - 2026-04-17
1. 人们在讨论什么
1.1 Harness 工程之争愈演愈烈 🡕
4 月 16 日开始的 harness 工程讨论仍在持续升温。@akshay_pachaar 的 三阶段框架(从权重到上下文再到 harness)连续第二天成为整个数据集里最热门的帖子,目前获得 606 个赞、797 次收藏和 76,723 次浏览。其核心论点是:“模型不再是智能的唯一载体。它存在于一个 harness 中,而这个 harness 包含持久化记忆、可复用技能、标准化协议(如 MCP 和 A2A)、执行沙箱、审批关卡以及可观测性层。”

@aiDotEngineer 宣传了一场大会演讲(41 个赞、46 次收藏、15,311 次浏览)介绍了 @_lopopolo 关于“当人类掌舵、智能体执行时,如何构建软件”的内容。讨论串呈现出一场标志性的理念分歧:@SamanvayaY 指出,这“恰好与 Mario Zechner 的核弹级观点相反——Ryan:‘代码是免费的。禁用编辑器。开掉 15-5000 个智能体。’Mario:‘每一行该死的代码都要读,否则你就会失去理解。’”@Samward 回复道:“智能体规模的上限取决于刹车的质量,而不是马力。”
随后,反向叙事也出现了。@IceSolst 发布了一篇带实操性质的反驳(82 个赞、35 次收藏)表示:“我在做一个让智能体跑扫描任务的 harness。它完全是一坨垃圾,毫无用处。和直接用原生 Claude Code 相比,真的 0 收益。”@garrytan 进行了回击(12 个赞)则在另一篇批评智能体的文章下评论道:“文章里的每一个失败案例,都是赤裸裸的 LLM 交互!没有技能、没有 harness、没有确定性代码。”
@_lopopolo 介绍了他自己已经成型的方法(8 个赞、10 次收藏)表示:“自动化都存在 docs/automations 里的 Markdown 文件中。codex app 的自动化提示词只有两句话。”
讨论洞察: 这场 harness 之争已经分化为三派:把 harness 设计视为首要工程学科的拥护者、认为 Claude Code 内置能力已经足够的怀疑者,以及采用轻量 Markdown 自动化的实用主义者。@Samward 那句“看的是刹车质量,不是马力”概括了正在形成的共识:harness 的价值在于约束,而不在于能力。
与前一日对比: 昨天的讨论基本还是单向度的——把 harness 工程视为标准框架。今天则在持续采用之外,出现了成体系的反对声音(IceSolst 的实际失败体验,以及 Zechner-lopopolo 的理念分裂)。这个概念不再只是扩散,而是在接受压力测试。
1.2 语音优先的智能体交互实现突破 🡕
@thdxr 发出了当天互动量第二高的帖子(653 个赞、188 次收藏、29,406 次浏览)表示:“最近对我编码工作流影响最大的,不是什么智能体相关的东西——而是我意识到这些 Parakeet 本地语音模型有多强,然后开始把所有内容都口述进 opencode。”他还分享了一个帮助上手的 macOS 工具(后续回复获得 112 个赞、147 次收藏)。
@zazmic_inc 解释了其中的机制:“打字会迫使你压缩、缩写,结果智能体拿到的提示词更差;而口述能让你给出完整上下文,包括那些你通常因为懒得写而删掉的部分。”
与此同时,@Teknium 为 Hermes-Agent 加入了 Gemini Voice TTS(112 个赞、49 次收藏)提供了免费套餐选项。@garrytan 描述了 正在台北测试一款用于智能排程的语音智能体——一名空乘人员立刻问:“这是什么?我现在能用上吗?”@kirodotdev 发起了一场 Kiro x ElevenLabs 黑客松(51 个赞、34 次收藏)则专门面向语音驱动应用,奖金总额为 $10K。
讨论洞察: thdxr 的表述很重要,因为它颠覆了常见叙事。生产力提升并非来自智能体本身,而是来自人类输入方式的变化。@solomonneas 也提出了反面观点:“这确实会拖慢我的工作流。我需要通过打字让思路慢下来,再把想法表达清楚。”这说明,语音优先会因认知风格不同而显著两极分化。
与前一日对比: 昨天,语音只出现在一个场景里(Hermes TTS 集成)。今天,它已经演变成独立的生产力论点(thdxr)、消费端时刻(garrytan 遇到的空乘人员)、黑客松赛道(Kiro x ElevenLabs)以及基础设施组件(Hermes 中的 Gemini Voice)。语音已经从一个功能点变成了一条主题线。
1.3 HeyGen Skills 与原生智能体视频持续扩张 🡕
@rileybrown 将 Claude 的新设计功能提炼为可复用的 agent 技能(226 个赞、275 次收藏、17,313 次浏览)并展示了它在带网页预览的 Codex 中运行的效果。多个账号进一步放大了 HeyGen Skills 的热度:@JibrilQanqadar 宣称“Loom 正式被盯上了”(31 个赞、5,675 次浏览)描述了跨会话保持一致的头像身份。@manishkumar_dev 指出 表示:“只需描述一次你的头像,HeyGen Skills 就会把它构建出来,并在每个视频中复用。”
@ashpreetbedi 推出了 Vibe-Video(48 个赞、50 次收藏)介绍了一个使用 HeyGen Hyperframes 和 Opus 4.7 构建的开源多智能体团队,可将研究主题转化为动态图形视频。@AndyMarlowg 描述了 则介绍了一个 CREAO 智能体,使用 Opus 4.7 写稿、Gemini 3.1 TTS 配音,把新闻变成喜剧——“一个智能体就能把新闻变成喜剧”(62 次收藏)。
讨论洞察: HeyGen Skills 的模式正收敛成一条清晰工作流:一次描述头像,智能体记住它,再自动生成经过提示词优化的视频。rileybrown 把技能从 Claude 提取到 Codex,说明跨智能体的技能可移植性正开始具备实用性。
与前一日对比: 昨天 HyperFrames 刚发布,视频这一品类才算立住。今天则进入采用浪潮:实践者开始提取技能、基于这些技能继续搭建,并宣称既有工具“该提高警惕了”。视频智能体这一类别已从发布公告走向生态系统。
1.4 多智能体编排获得更多实证 🡕
@georgeorch 通过三篇高互动帖子主导了多智能体话题。他 推翻了自己先前的怀疑态度(170 个赞、7,053 次浏览)表示:“以前我看到‘多智能体’配置都会直接划过去,觉得太过头了。我错了,他们是对的。一个智能体是一件工具,四个智能体就是一门生意。”他还 强调了记忆问题(202 个赞、10,718 次浏览)写道:“为什么偏偏在我最需要你的时候,你就什么都忘了?”
@camsoft2000 描述了(19 个赞、11 次收藏)介绍了 RepoPrompt 的编排能力,可同时管理 Codex 和 Claude Code:“主智能体为了防止一个子智能体在某个问题上来回空转,直接把它杀掉了。”@DAIEvolutionHub 报告称 则提到一些团队通过 git worktrees 并行运行 4—8 个智能体:“智能体 1 负责构建,智能体 2 负责测试,智能体 3 负责安全,智能体 4 负责重构,智能体 5 负责文档。”
@petergyang 分享了一个实用模式(13 个赞、7 次收藏)表示:“我总会让 AI 再拉起一个独立的评估智能体,做是/否检查,给第一个智能体的输出打分。”@theAIdreamer 证实道:“写作智能体交给编辑智能体,后者把风格指南作为上下文加载进去。编辑会拒掉 40% 的草稿。”

讨论洞察: “写作—评估”模式(构建智能体 + 审查智能体)正成为一种简单、可重复的多智能体架构。petergyang 和 DimitriGilbert 分别独立描述了同一种模式,说明业界正在收敛到最小可行的多智能体配置。
与前一日对比: 昨天,多智能体讨论还分裂在 0xSero 的实证和 georgeorch 的怀疑之间。今天 georgeorch 改变了立场,多位实践者也分别给出了可运行模式。争论已经从“多智能体是否有效”转向“最简单且有效的多智能体模式是什么”。
1.5 编码智能体治理进入企业工具链 🡕
@databricks 宣布在 Unity AI Gateway 中支持 Coding Agent(27 个赞、15 次收藏)介绍了面向编码智能体的集中式治理方案,支持使用情况追踪、速率限制和推理表。其架构通过单一 AI Gateway 路由 Cursor、Gemini CLI 和 Codex CLI。

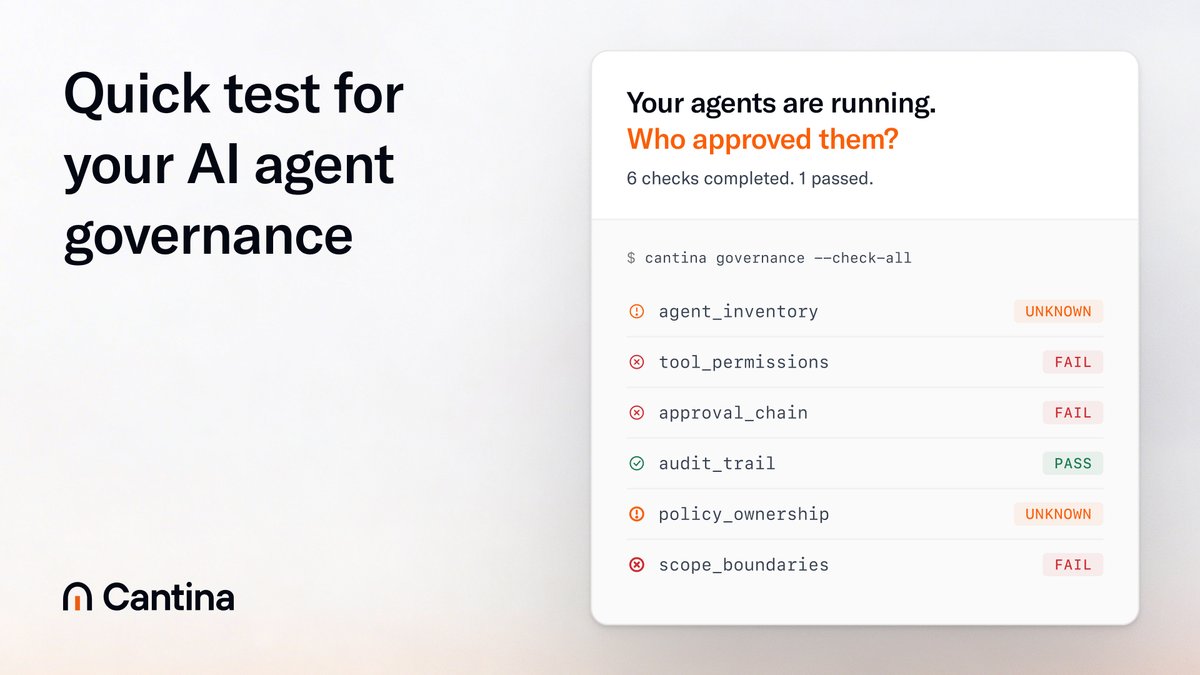
@cantinasecurity 继续推动(10 个赞)介绍了其智能体治理框架,并发问:“你的团队能否回答:谁拥有智能体策略、智能体可以调用哪些工具、以及它们行动时会记录什么?”配套 CLI 工具显示了 6 项检查结果:3 项失败、2 项未知、1 项通过。
@matthewhall_com 报告称 提到,Cloudflare 发布了 isitagentready.com——一个从五个维度检查任意网站 AI 智能体就绪度的扫描器:可发现性、内容可访问性、机器人访问控制、协议发现(MCP、Agent Skills、WebMCP、OAuth)以及商业能力(x402)。
讨论洞察: 同一天上线了三个独立的治理工具:Databricks 处理编码智能体泛滥问题,Cantina 面向安全态势,Cloudflare 面向网站就绪度。这表明治理正从概念走向产品。
与前一日对比: 昨天,治理还主要停留在抽象讨论层面(cantinasecurity 的指南、Chromia 的钓鱼事件)。今天,Databricks 和 Cloudflare 等大厂已经拿出了可交付的软件。“我们需要治理”和“这就是治理工具”之间的差距已经被填平。
1.6 技能市场怀疑论开始出现 🡒
@shawmakesmagic(ElizaOS 创作者)强烈反驳(78 个赞、8 次收藏)公开反对技能市场叙事:“根本没有什么技能市场。当 Hermes 成功完成某件事时,它就会生成一个技能。下载技能的风险太高了,这是历史上最容易被利用的供应链攻击面。专注于做一个你自己会用的智能体,而不是去为一个并不存在的市场做产品。”
与此同时,Graft 继续推进协调式宣传攻势——@web3_gord、@ArumBeadlesX、@aisarcore 都发布了几乎一模一样的文案,把 Graft 描述为“AI 智能体技能市场”,并附上同一个合约地址,这进一步强化了 Shaw 对人为制造需求的怀疑。
@betomoedano 采取了不同的方法(70 个赞、97 次收藏)则通过众包方式征集真实技能使用案例:“你自己做过、或见过的最佳 Agent Skills 是什么?”回复串里出现了具体工具:@swmansion 的 react-native-best-practices,以及 @callstackio 的 agent-device 和 agent-react-devtools。
讨论洞察: Shaw 的批评划出了一条清晰界线:自行生成的技能(Hermes 会根据成功操作自动创建)与下载技能(市场模式)是两回事。其安全论点也非常具体——技能会执行代码,因此直接构成供应链风险。
与前一日对比: 昨天有五个技能市场发布或扩张。今天,则迎来了来自一位可信构建者的首个重要反驳。Graft 的协调式宣传活动(多篇几乎相同、附同一合约地址的帖子)无意中给 Shaw 关于“制造需求”的观点提供了证据。
1.7 Opus 4.7 对比 4.6:行为差异获得量化 🡕
@dimitrioskonst 发布了一篇正面对比(5 个赞、3 次收藏、2,099 次浏览)对 Claude Opus 4.7 与 4.6 在真实 monorepo 任务中的表现进行了比较。结果非常显著:在 5 项任务中,4.6 发起了 222 次工具调用,涉及 26 个文件;4.7 发起了 58 次工具调用,只涉及 3 个文件。Opus 4.6 拉起了 6 个探索型子智能体;4.7 则一个都没有。在其中一项任务中,“4.6 修改了计费逻辑,去处理一个它从未验证是否存在的竞态条件。4.7 则拒绝碰它。”
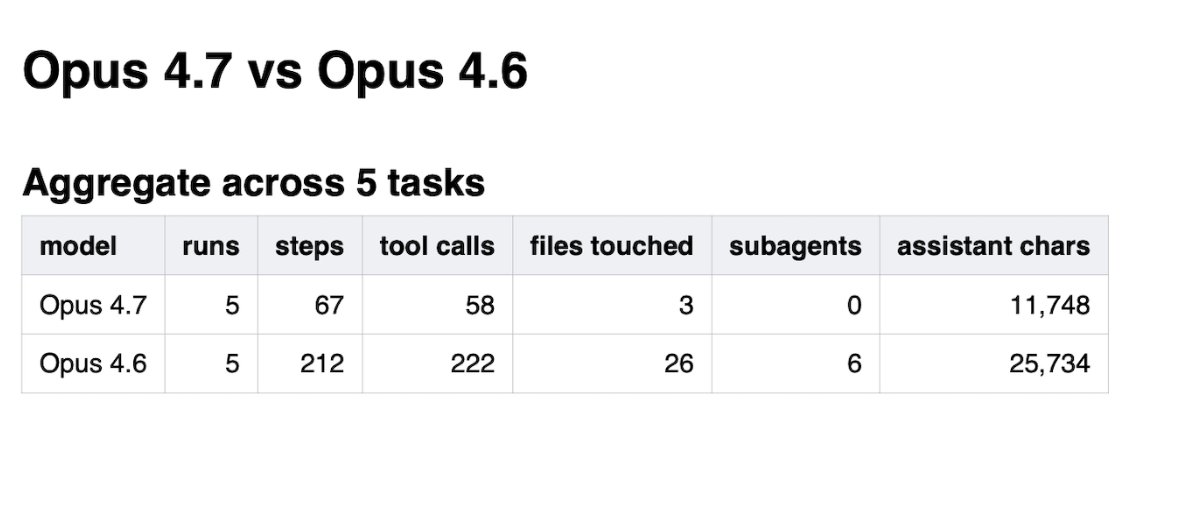
讨论洞察: 这些数据表明,4.7 代表的是智能体行为层面的一次根本性转变——不只是输出更好,而是运行画像都发生了显著变化:更少动作、更少文件、零子智能体。这对 harness 设计有直接影响:当模型会自我约束时,harness 需要承担的职责也会改变。
与前一日对比: 昨天并没有类似的对比。这是关于模型更新如何在 harness 层面改变智能体行为的全新量化证据。
1.8 研究论文推进多智能体协同 🡒
两篇研究论文从不同角度切入多智能体协同失败问题。@jiqizhixin 重点介绍了 AgentConductor(9 个赞、4 次收藏)来自上海交通大学和美团:这是一个基于 RL 的系统,可动态重构智能体之间的通信路径。在竞赛级代码生成任务中,它将准确率提高了 14.6%,同时把 token 成本降低了 68%。

@rryssf_ 介绍了 PAC-BENCH 来自延世大学——这是首个针对隐私约束下多智能体协作的基准测试。关键发现包括:GPT-5.1 与自身配对时,联合成功率也只有 56%;LLaMA 与自身配对时则只有 6%。研究识别出三种失败模式:早期隐私违规(75% 发生在前 3 轮内)、过度保守的抽象化(占失败的 35%)以及隐私诱发的幻觉(占失败的 41%)。最引人注目的是:由哪个智能体先发起对话,比用哪个模型更重要。
@jiqizhixin 还 分享了 MindDR(10 个赞、3 次收藏):这是一个来自 Li Auto 的多智能体深度研究框架,采用 Planning-DeepSearch-Report 三智能体组合,让一个 30B 参数模型胜过了同类开源系统。

讨论洞察: PAC-BENCH 揭示,具备隐私意识的多智能体协作本质上仍未解决。发起者角色比模型质量更重要这一发现,对于需要跨组织协作智能体的企业部署具有直接意义。
与前一日对比: 昨天讨论的是 ACE 论文(将上下文视为动态操作手册)和 GAM(即时记忆)。今天则新增了 AgentConductor(动态拓扑)、PAC-BENCH(隐私受限协作)和 MindDR(小模型深度研究)。研究管线正在加速。
1.9 智能体可观测性工具迅速涌现 🡕
多款可观测性工具相继发布。@aijoey 宣布 hermes-hudui 的 GitHub star 数突破 1,000(10 个赞)介绍了一个 Hermes 智能体监控仪表板,包含 14 个标签页、实时聊天、实时记忆与成本追踪。

@badlogicgames 称赞了(26 个赞、14 次收藏)介绍了 HuggingFace 上的编码智能体轨迹查看器。@mattpocockuk 介绍了他最好的想法(9 个赞)表示:“这是一个编码智能体可观测性平台——安装一个插件,把所有会话数据上传到仪表板,就能比较长期趋势。”@tarunsachdeva 推出了 Traces for Teams(19 个赞)则提供团队内部共享编码智能体会话的能力,并为初创公司和开源项目提供免费套餐。
讨论洞察: 智能体可观测性正在分化成三个层次:单次会话轨迹(HuggingFace viewer)、单智能体仪表板(hermes-hudui)和团队级分析(Traces for Teams)。目前还没有一个工具能覆盖全部三层。
与前一日对比: 昨天对可观测性的提及还只是顺带。今天,三个产品和一个产品构想都汇聚到同一个需求上。hermes-hudui 的 star 数一周内从 0 增长到 1,000,说明需求强烈。
2. 让人沮丧的是什么
自定义 Harness 的额外开销 vs. 内置能力——严重程度:高
@IceSolst 花时间搭建了一个自定义 harness 试过之后得出结论:和带技能的原生 Claude Code 相比,它“真的 0 收益”。@HankYeomans 回应道:“Claude Code 本身也是一个 harness——你试过把它的 harness 用到别的东西上吗?”这段交锋暴露出一种概念混淆:实践者正在那些本身就已经是 harness 的工具之上再叠一层 harness,造成冗余。现在还没有清晰指南说明,什么时候自定义 harness 真能带来价值,什么时候内置智能体 harness 就已经足够。
多智能体记忆丢失——严重程度:高
@georgeorch 道出了广泛存在的挫败感(202 个赞、10,718 次浏览)表示:“我觉得智能体丢失上下文这件事特别有意思——为什么偏偏在我最需要你的时候,你就什么都忘了?”@timourxyz 指出了一个系统性缺口 表示:“智能体领域似乎缺的是记忆基准测试。我会用一些个人测试去试这里每个热度够高的记忆系统,但我想看到不同框架和智能体在一组既定测试上的表现。”目前还没有标准化的记忆基准。
技能供应链安全——严重程度:中
@shawmakesmagic 称其为 skill downloads 将其称为“历史上最容易被利用的供应链攻击面”。技能会在智能体上下文中执行代码。@cybernewslive 报告称 指出,MCP 存在一个设计缺陷,“会让攻击者在任何安装了恶意工具的用户电脑上运行命令”。可执行技能与 MCP 漏洞叠加后,形成了相互放大的风险面,而目前没有统一缓解标准。
3. 人们希望出现什么
智能体记忆基准测试
@timourxyz 请求 呼吁建立标准化记忆基准。@georgeorch 说出了面向用户的症状(202 个赞)谈到,智能体总会在最糟糕的时候遗忘信息。@burkov 分享了 GAM 论文 提出了即时记忆方案,但目前没有任何基准测试能评估这些方法在不同框架中的实际效果。人们需要的是一套标准化评测,而不是另一个记忆系统。
编码智能体可观测性平台
@mattpocockuk 描述了 点出了这个缺失的产品:“安装一个插件,把所有会话数据上传到仪表板,就能比较长期趋势。”@alexhillman 描述了 则存储带解析后元数据列的会话转录,包括用户消息、智能体消息、工具调用和涉及文件。多个团队都在构建定制化方案(hermes-hudui、Traces for Teams、HuggingFace viewer),但目前还不存在跨智能体的可观测性标准。
具备隐私保护的多智能体协作
延世大学的 PAC-BENCH 论文 量化了这一差距 指出:即便 GPT-5.1 与自身配对,在需要共享私有信息的任务中成功率也只有 56%。@abundand 证实:“这已经搞死了我试图上线的每一个多智能体项目。”对于必须让来自不同部门或不同组织的智能体协作的企业部署场景,目前还没有既能协同、又能保护隐私的机制。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Claude Code | 编码智能体 | (+) | 内置 harness、技能,设计特性还能提取成技能 | IceSolst 认为在其之上再做自定义 harness 是多余的 |
| Codex (OpenAI) | 通用智能体 | (+) | 计算机使用、浏览器、插件、自动化、多终端 | 作为“智能体运行时”的定位还比较新 |
| Hermes Agent | 多智能体框架 | (+) | Gemini Voice TTS、Umbrel 自托管、持久化记忆、自动生成技能 | 配置复杂,存在多个相互竞争的技能来源 |
| Warp | 终端 UI | (+) | 富文本输入、用于上下文的 @ 菜单、语音输入、面向移动端的 /remote control | 仅限终端 |
| HeyGen Skills | 视频制作 | (+) | 持久化头像、自动检测 MCP + CLI、提示词工程 | 依赖单一供应商 |
| RepoPrompt | 智能体编排 | (+) | 通过 MCP 管理多个智能体 CLI,工具可动态启用 | 采用仍较小众 |
| cmux | 终端 | (+) | 基于 Ghostty、垂直标签页、通知环、14K GitHub stars | 仅限 macOS |
| Parakeet | 本地语音 STT | (+) | 本地推理、低延迟、适配任何编码智能体 | 需要配置 macOS,工作流适配性存在分歧 |
| LangGraph | 多智能体框架 | (+) | Cisco 企业验证、LangSmith 集成 | 框架锁定 |
| Databricks Unity AI Gateway | 智能体治理 | (+) | 集中追踪 Cursor/Gemini/Codex 的使用情况并做速率限制 | 仅面向企业,仍处于早期阶段 |
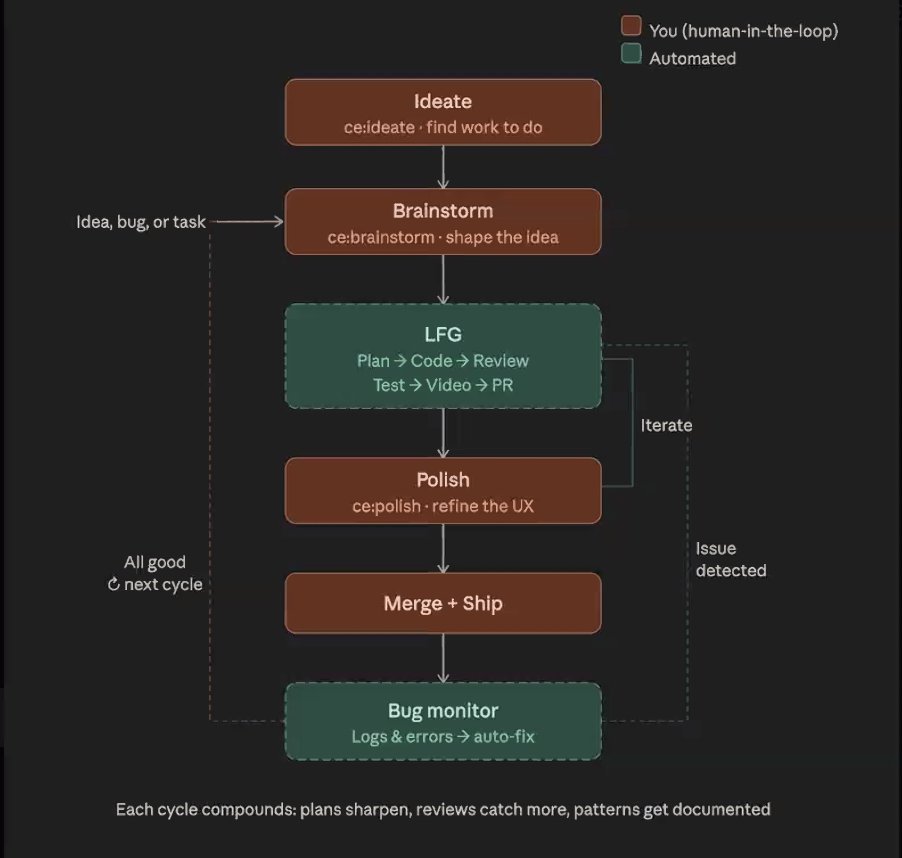
“复合工程”(compound engineering)模式(@ridegoodwaves,引用 @kieranklaassen 和 @danshipper)将一套工作流正式化:先在写代码前完成构思,让智能体处理中间环节,在 PR 之后再做打磨,并把计划保存在代码仓库里,作为智能体的上下文与事后复盘材料。@DAIEvolutionHub 描述了 git worktrees 模式:让 4—8 个智能体并行工作,每个都在自己的分支中。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Vibe-Video | @ashpreetbedi | 将研究主题转化为动态图形视频的多智能体团队 | 视频制作需要手动编辑时间线 | HeyGen Hyperframes、Opus 4.7 | 开源 | 推文 |
| OpenFang | @openfangg | 基于 Rust 的智能体操作系统,137K LOC,可在 Raspberry Pi 上离线运行 | 现有智能体框架只是 Python 封装,不是真正的 OS | Rust、14 个 crates、MIT | v0.5.10,开源 | GitHub |
| hermes-hudui | @aijoey | Hermes 智能体监控仪表板:14 个标签页、实时聊天、记忆与成本追踪 | 无法观测运行中的 Hermes 智能体 | - | v0.5.0,1K stars | 推文 |
| Traces for Teams | @tarunsachdeva | 团队共享编码智能体会话查看器 | 团队无法共享和比较智能体会话 | - | 已发布,免费套餐 | 推文 |
| pro-workflow | @DanKornas | 面向 Claude Code + Cursor 的自我纠错记忆、可复用技能和智能体协作 | 智能体缺乏自我纠错循环 | npm、1K stars | v1.3.0 | 推文 |
| ClawGUI | 浙江大学 | 完整 GUI 智能体流水线:训练、评估并部署到真实手机 | GUI 智能体缺乏从训练到部署的端到端流水线 | ClawGUI-RL、ClawGUI-Eval、ClawGUI-Agent | 开源 | 推文 |
| Reah for Agents | @charleswayn | 为 AI 智能体提供带权限范围和审批流程的金融账户 | 智能体需要在护栏内获得真实金融能力 | 账本级可追溯性 | 已面向个人用户开放 | 推文 |
| isitagentready.com | Cloudflare | 从 5 个维度扫描网站的 AI 智能体就绪度 | 缺乏检查网站是否便于智能体发现的标准方式 | MCP、Agent Skills、OAuth、x402、WebMCP | 已上线 | 推文 |
| Tidewave | @josevalim | 面向 Elixir 的智能体工具:UI 变体、视觉模式、代码审查、浏览器智能体 | Elixir 生态缺乏智能体工具 | Elixir | 每周发版 | 推文 |
值得注意的是:@ihtesham2005 报告称 表示,ClawGUI 的 2B 参数模型在 GUI 智能体任务上超过了 Qwen3-VL-32B——模型小了 16 倍,结果却更好。这延续了一个趋势:在受限领域,小而专的模型正在击败通用大型模型。
6. 新动态与值得关注的内容
Cloudflare 推出 AI 智能体就绪度扫描器
@matthewhall_com 报告称 介绍了 Cloudflare 推出的 isitagentready.com。该工具会从五个维度扫描任意网站:可发现性(robots.txt、sitemap)、内容可访问性(Markdown 协商)、机器人访问控制、协议发现(MCP、Agent Skills、WebMCP、OAuth)以及商业能力(x402、UCP、ACP)。这是首个将“智能体就绪度”定义为网站可衡量属性的主要基础设施厂商。
SIGIR 2026 论文为智能体引入市场化评估
@TEKnologyy 宣布(9 个赞)表示,论文“模拟 AI 市场动态下的智能体评估”已被 SIGIR 2026 接收。论文 提出了一种基于仿真的范式,把信息访问系统当作市场参与者进行评估,衡量留存和市场份额,而不仅仅是准确率。这将技能市场已经产生的竞争动态正式纳入了评估框架。
Opus 4.7 大幅降低智能体操作足迹
@dimitrioskonst 的 基准数据 显示,在相同任务上,Opus 4.7 相比 4.6 工具调用少了 3.8 倍、涉及文件少了 8.7 倍,并且没有拉起任何子智能体。在一项计费逻辑任务中,4.7 拒绝为一个未经验证的竞态条件改代码,而 4.6 则毫不犹豫地修改了。这代表了模型行为的一次定性转变,也会改变 harness 的设计方式。
MongoDB 推出带 Agent Skills 的 Claude Marketplace 插件
@MongoDB 宣布(14 个赞、6 次收藏)介绍了其在 Claude Marketplace 上发布的插件,其中包含面向 MongoDB 工作流的 Agent Skills,以及用于上下文感知指导的 MCP Server。数据库厂商如今也开始把智能体技能当作开发者工具的分发渠道。
7. 机会在哪里
8. 要点
-
Harness 工程正在接受压力测试。 IceSolst“0 收益”的体验(82 个赞)以及 lopopolo-Zechner 之间的理念分裂,挑战了前一天那种把 harness 工程视为救赎的叙事。garrytan 的反驳和 lopopolo 的轻量 Markdown 自动化方案说明,答案并不绝对:harness 在规模化场景中确实有价值,但对个人使用而言,内置智能体 harness 往往已经足够。(来源)
-
语音输入是实践者目前发现的最大智能体生产力解锁点。 thdxr 的观察(653 个赞、188 次收藏)表明,带来最大工作流增益的不是智能体本身的进步,而是口述输入,这颠覆了常见叙事。本地 Parakeet STT 模型与智能体工作流结合后,去掉了一个多数人此前甚至没有意识到的瓶颈。(来源)
-
多智能体模式正收敛到“写作—评估”这一最小可行架构。 georgeorch 改变了此前的怀疑立场(170 个赞)。petergyang 和 DimitriGilbert 分别独立描述了同样的先构建、后审查模式。框架层面的变化是:多智能体不再意味着“更多智能体”,而是意味着最简单的有效委派。(来源)
-
编码智能体治理在一天之内变成了可交付软件。 Databricks Unity AI Gateway、Cantina 的治理 CLI,以及 Cloudflare 的 isitagentready.com 都发布了生产级工具。企业准入问题已经从“我们需要治理”转向“我们该采用哪一个治理工具”。(来源)
-
Opus 4.7 代表着智能体 harness 设计的一次行为范式转变。 dimitrioskonst 的数据显示,在相同任务中,4.7 的工具调用次数比 4.6 少了 3.8 倍,而且完全没有子智能体生成。一个会自我约束的模型,会改变 harness 需要提供什么——从“约束智能体”转向“智能体约束自己”。(来源)
-
技能市场怀疑论来自可信来源。 Shaw(ElizaOS 创作者)把下载技能称为“历史上最容易被利用的供应链攻击面”。再叠加一个据报可导致远程命令执行的 MCP 设计缺陷,智能体技能生态的安全暴露面扩张速度,已经超过了缓解工具的发展速度。(来源)
-
隐私受限的多智能体协作本质上仍未解决。 PAC-BENCH 中,GPT-5.1 与自身配对时的成功率也只有 56%;同时,研究还发现发起者角色比模型质量更重要。这为跨信任边界的企业多智能体部署设定了现实上限。(来源)