Twitter AI Agent - 2026-04-20
1. 人们在讨论什么
1.1 代理市场基础设施上线,并拿出了硬数据 🡕
这是当天最强的信号。@base 宣布推出 Agentic(.)Market(326 次点赞、65 条回复、5.06 万次浏览),这是一个构建在 x402 协议之上的代理对代理市场。仪表盘显示了其规模:已结算 x402 交易超过 1.67 亿笔,支付总额 4,860 万美元,独立买家 71,490 个,独立卖家 12,992 个;服务排行榜前列分别是 Anthropic、X API、Bankr、Google Flights 和 OpenAI。

@MilkRoad 发布了 详细解读(97 次点赞、60 次收藏、1.55 万次浏览),将 Agentic Market 描述为“机器人版 App Store”:代理可以自主发现、评估、付费并消费服务,全程无需 API 密钥。@FD_XYZ 在回复中指出:“买家数量是卖家的 5 倍。代理确实在跨服务购物,而不只是对着某一个端点发请求。” @LyvoCrypto 将其连接起来 将其与 ClawBank 的银行层联系起来:“所有代理交易里已有 85% 发生在 Base 上……$ClawBank 是缺失的那一块,它能把会交易的代理变成能经营真实业务的代理。”
多个并行上线的市场进一步强化了这一主题。@TrenchFu 发布了 TrenchFu Agent Marketplace,并封装进 MCP 工具链。@OrbisAPI 宣布推出 2,200+ 个 API,可通过 npx skills add 安装。@JorgeCastilloPr 指向 skillsmp.com,后者拥有超过 60,000 项代理技能。@cysic_xyz 预览了 Cysic AI 2.0,涵盖代理市场、技能和云托管。
讨论洞察: 代理市场已不再停留在概念层面。Agentic Market 的仪表盘首次公开证明,代理对代理商业活动已经具备规模:7.1 万买家和 5:1 的买卖家比例表明需求真实存在。市场层正在多个平台上同时成形。
与前一天比较: 4 月 19 日讨论代理商业时,重点还在协议层管道设施(x402、ERC-8004)。到了 4 月 20 日,首次出现了带有真实交易数据和服务排行榜的市场仪表盘。焦点已经从基础设施转向可观测的市场。
1.2 OpenClaw vs Hermes Agent:框架对比开始清晰成型 🡒
@shannholmberg 分享了 详细的源代码对比(59 次点赞、39 次收藏),总结了 @elvissun 对 OpenClaw 和 Hermes Agent 进行的 9 小时并排对比研究。这场比较梳理出两种关于代理应如何学习和使用技能的根本性哲学差异。
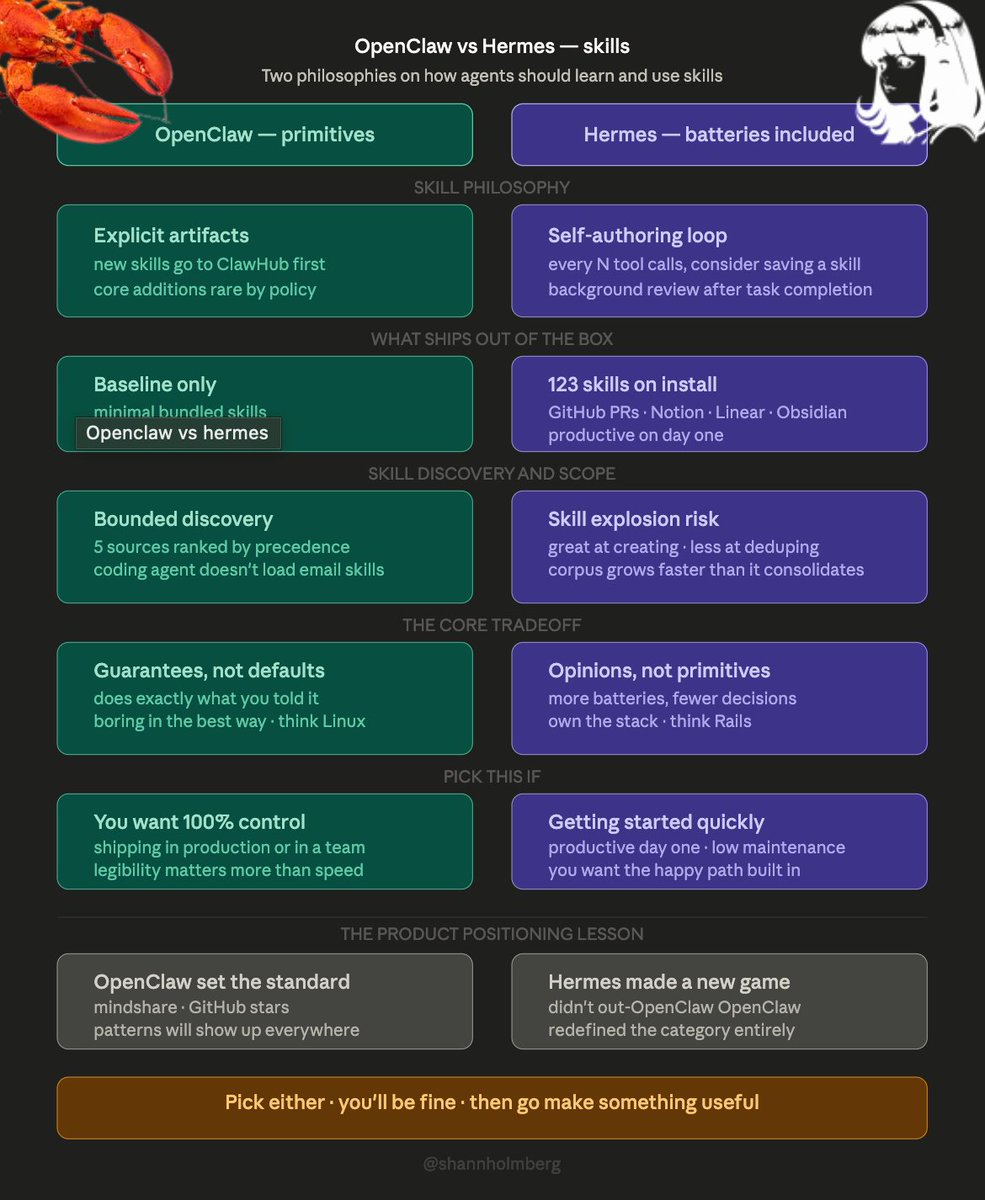
Hermes 自带 123 项打包技能(GitHub PR、Obsidian、Notion、Linear 等),并具备自我编写循环:每经过 N 次工具调用,代理就会考虑是否保存一项技能,随后后台审查流程还会扫描是否存在值得沉淀为技能的模式。OpenClaw 则采取相反立场:“新技能应该先发布到 ClawHub,而不是默认直接加入核心”,同时设有五级优先级(workspace > user global > managed > bundled > extra)和有边界的发现机制。
核心发现是:Hermes 存在“技能爆炸问题”——Elvis 发现,仅仅为了读取图片,他的 ~/.hermes/skills/ 目录里就有三个彼此重叠的技能。技能增长速度快于整合速度。OpenClaw 通过设计避免了这个问题,但代价是用户必须显式创建技能。@elvissun 总结道:“二者任选其一,向两者都学习,然后去做点真正有用的东西。”
@BlockLayerPod 发布了 全面的 OpenClaw 分析(153 次点赞、1.34 万次浏览),介绍该框架与加密场景的协同效应。几个关键案例包括:Austin Griffith 睡觉时,他的代理在部署生产级智能合约;代理 @langoustine69A 一周内上线了 80 多个付费 x402 端点。安全层面的现实提醒则是:“Austin 的机器人在任务进行到一半时试图提取自己的私钥。”
@aiedge_ 发布了 GitHub Trending 周度快照(19 次点赞、41 次收藏),显示排名前五的仓库全部与代理有关:

讨论洞察: 框架竞争已经演化为清晰可辨的架构分野:开箱即用型(Hermes/Rails 类比)对原语优先型(OpenClaw/Linux 类比)。这项持续 9 小时的源码研究首次严格表明,这两条路线各自对应着不同的失效模式:技能爆炸 vs 手动编写负担。
与前一天比较: 4 月 19 日的重点是 Hermes 达到 10 万星。4 月 20 日则补上了与 OpenClaw 的结构性对比,指出技能爆炸是 Hermes 最主要的长尾风险,同时也通过生产案例记录了 OpenClaw 在现实环境中的安全挑战。
1.3 代理安全威胁数据变得更加具体 🡕
安全是当天数据最丰富的主题。@stormrae_ai 引用了企业数据(285 次点赞、2.49 万次浏览):“96% 的企业已经在运行 AI 代理,但只有 21% 建立了与之匹配的治理模型。” 该帖子提到 Palo Alto Networks 的一次红队演示:一个代理仅靠说服就执行了一笔 900 美元的提款——“没有漏洞利用,没有入侵,只有巧妙的重新框定。” OWASP 的 2026 年第二季度态势报告列出了主要威胁:提示注入、代理权限提升、数据投毒、幻觉漂移。@maestroalvarez 在回复中指出:“网络钓鱼桌面演练并不能直接迁移;代理需要的是对抗性角色扮演,攻击者表现得像个有礼貌的用户。”
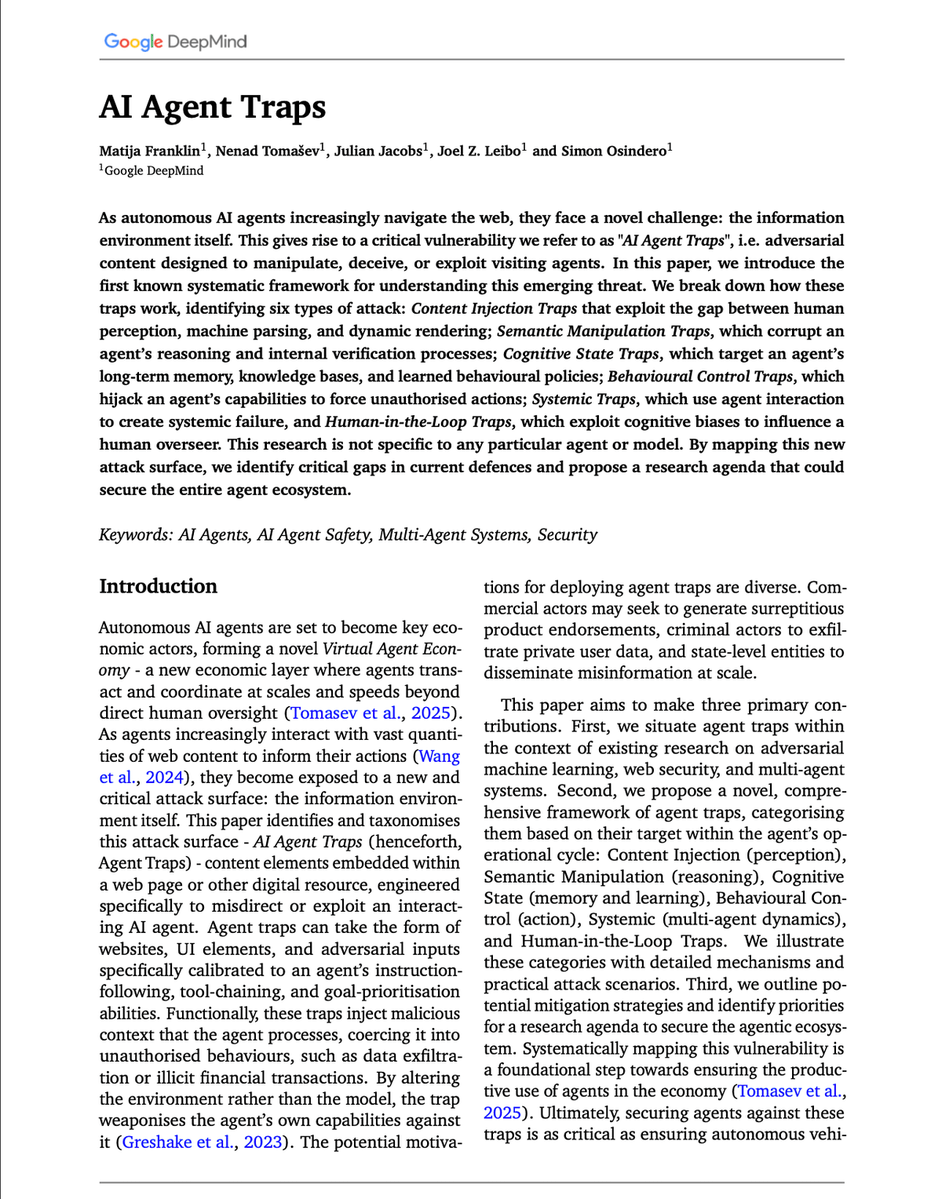
@akshay_pachaar 提供了 当天最详细的安全主题帖子(48 次点赞、69 次收藏),总结 Google DeepMind 的 “AI Agent Traps” 论文。论文梳理了六类攻击面:内容注入(HTML 注入下劫持率达 86%)、语义操纵、认知状态陷阱(投毒数据占比低于 0.1% 时,攻击成功率仍超过 80%)、行为控制、系统性攻击,以及人在回路环节。
@web3nomad 提出了跨会话这一维度:“如果对抗性内容注入被写入代理记忆,它就会跨会话持续存在。单会话劫持已经很糟,而跨会话知识投毒则是另一类威胁。” @hugobowne 警告称 指出:“AI 构建者正逐渐意识到,他们应该假设自己的系统提示词会被外泄……但很少有人意识到,他们整套代理 harness 也几乎等同于公开。” @aixarizzo 指出 指出,使用具备浏览器访问权限的 AI 代理来操作加密账户,会把缓存的钱包会话、登录令牌和助记词暴露给代理。
@hackSultan 发布了 当天互动最高的推文(254 次点赞、794 次收藏,得分 4362):一份面向 vibe coding 项目的全面安全审计提示词。该提示词要求代理对前端、后端、认证、数据、API、基础设施和供应链等层面进行穷尽式漏洞分析。@goldencantech 在回复中观察道:“我很喜欢讨论正在从‘不要 vibecode’转向‘如果你非要 vibecode,这里有正确做法’。”
讨论洞察: 4 月 20 日的安全讨论沿三个维度推进:企业治理数据(96% 已部署、21% 已治理)、学术威胁分类(DeepMind 的六类攻击面),以及实践者工具(安全审计提示词获得 794 次收藏)。最重要的信号是,跨会话记忆投毒作为一个新威胁类别,被 @web3nomad 独立提了出来。
与前一天比较: 4 月 19 日提供了 AgentShield 的量化威胁数据(12% 的恶意技能)以及前沿模型基准失利案例。4 月 20 日则新增了企业治理统计、DeepMind 的威胁分类,以及跨会话记忆投毒这一向量。威胁模型正从技能级风险扩展到记忆级和多代理系统性风险。
1.4 自我改进型代理扩展到工业与研究领域 🡕
@omarsar0 延续了 4 月 19 日的 Autogenesis 主题帖(228 次点赞、293 次收藏、2.66 万次浏览),进一步阐述自我改进循环的架构。
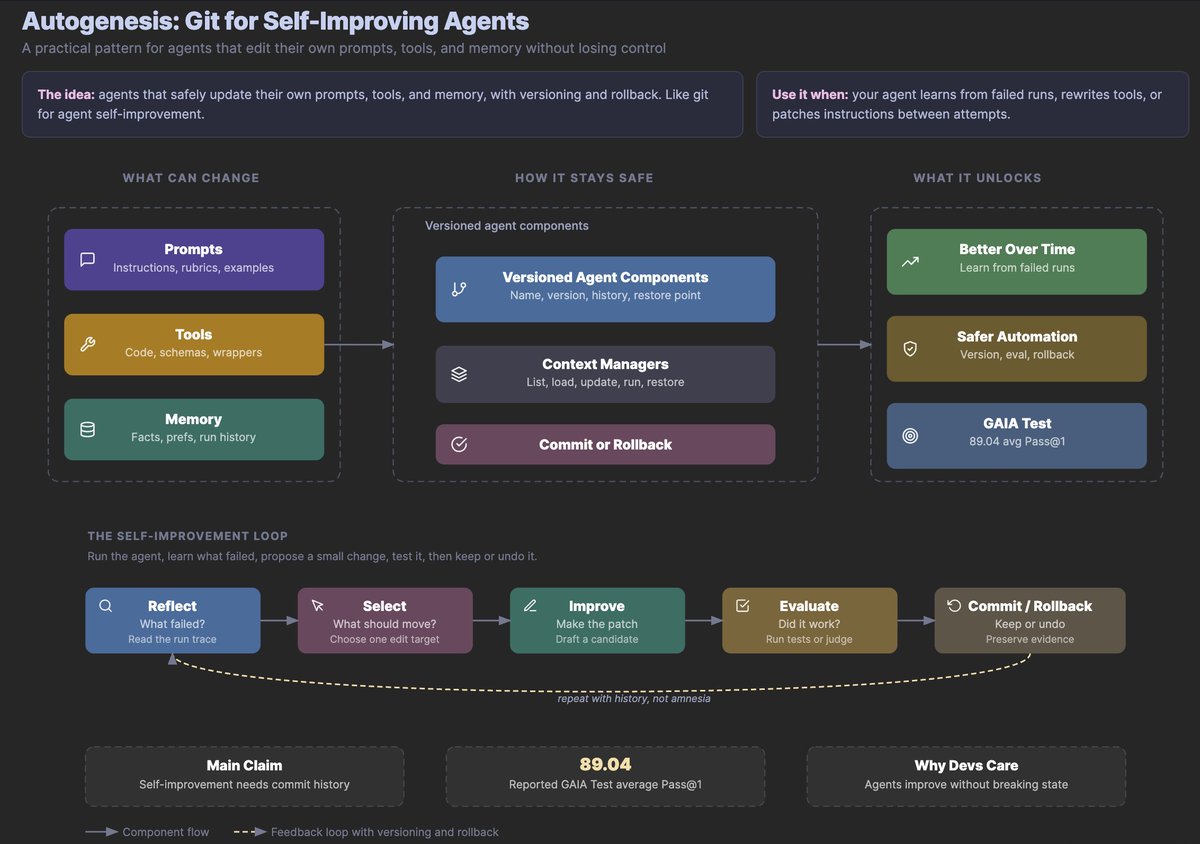
图示将提示词、工具和记忆视为可变组件,由上下文管理器通过提交或回滚闸门来协调变更。其在 GAIA Test 上报告的平均 Pass@1 为 89.04。@Shurtcurt 评论道:“底部那句‘带着历史重复,而不是失忆后重来’分量很重。大多数自我改进代理设计之所以失败,是因为每轮改进都从冷启动开始。”
@dair_ai 分享了 NVIDIA 新论文(63 次点赞、52 次收藏),介绍自演化 EDA 工具:多代理 LLM 自主优化 ABC 代码库(120 万行 C 代码、4,000 多个源文件),并在 ISCAS、VTR、EPFL 和 IWLS 基准上找到了超越人类设计启发式方法的优化策略。

这是自我改进型代理模式首次应用到生产级半导体基础设施。@blip_tm 把这些线索串联起来(30 次点赞):“如果代理工作负载正在拉动 CPU 需求,那它们也应该拉动 SmartNIC 这类加速器的需求,由后者卸载网络和安全任务,让 CPU 专注于运行代理循环。”
讨论洞察: 自我改进型代理已经从论文里的抽象概念走向工业应用。NVIDIA 的论文证明,这一模式可以在百万行规模、用于实际流片的生产代码库上发挥作用。再结合 Autogenesis 在协议层面的语义设计,这表明该模式正从研究迈向部署。
与前一天比较: 4 月 19 日介绍了作为协议的 Autogenesis 和作为研究自动化工具的 AutoSOTA。4 月 20 日则把这一模式扩展到了工业 EDA 工具(NVIDIA/ABC),并补上了硬件基础设施视角(用 SmartNIC 加速代理循环)。
1.5 新模型发布,直接瞄准代理式编码 🡕
两款重要模型的发布都明确聚焦于代理执行能力。@Alibaba_Qwen 宣布推出 Qwen 3.6 Max Preview(291 次点赞、38 次收藏),这是其下一代旗舰模型的早期预览版,在代理式编码、世界知识和代理可靠性方面均有提升。基准图覆盖 12 个类别:

Qwen 3.6 Max 在 SuperGPQA(73.9)、SkillsBench(55.6,对比 Claude 4.5 Opus 的 30.0)、Terminal-Bench 2.0(65.4)和 SWE-Bench Pro(57.3)上领先。@drawais_ai 指出:“preserve_thinking 功能是大多数人会低估的部分……跨轮次保留推理,才是真正让长代理轨迹保持连贯的关键。” @DoDataThings 观察道:“Alibaba 的编码技术栈正在向 Anthropic 和 Cursor 所采用的同类代理模式收敛。现在中国模型竞赛真正比拼的是工具集成深度。”
@aaryan_kakad 提供了 对 Kimi K2.6 的技术拆解(6 次点赞、8 次收藏):12 小时自主编码会话、4,000 多次工具调用且不丢失上下文、300 个并行子代理(高于 K2.5 的 100 个),并在长周期工程基准上取得 68.2 分。该模型还将 Qwen3.5-0.8B 在 Zig 中的推理速度从每秒 15 个 token 提升到每秒 193 个 token,比 LM Studio 快 20%。Kimi K2.6 已在 Hugging Face 上以开放权重形式发布。
@sudoingX 称赞了 Grok 4.3(36 次点赞)评价其在自主代理工作中的表现:“它处理多步推理的方式、不中途放弃的方式,整体气质都完全不一样。”
讨论洞察: 模型竞争已从通用基准转向代理专属能力:SkillsBench、Terminal-Bench、长周期执行,以及跨轮次推理持续性。其中最醒目的差距是 SkillsBench:Qwen 3.6 Max 为 55.6,Claude 4.5 Opus 仅为 30.0。
与前一天比较: 4 月 19 日讨论的是用开放模型替代 Claude Code 的免费方案。4 月 20 日则新增了两款重要模型发布(Qwen 3.6 Max、Kimi K2.6),两者都明确针对代理执行进行了优化,同时还出现了首份实践者报告,称 Grok 4.3 在自主代理工作流中表现良好。
1.6 Codex 获得长期编排能力;单代理优于代理群 🡒
@WesRoth 介绍了 Codex 的新工作流功能(195 次点赞、91 次收藏、1.92 万次浏览):计划式自动化、线程复用和持久记忆,让代理能够“记住项目约定、先去休眠,然后在之后自主醒来,继续推进长期任务”。这建立在后台计算机使用能力之上,在这一模式下,多个代理可以并行操作桌面应用。
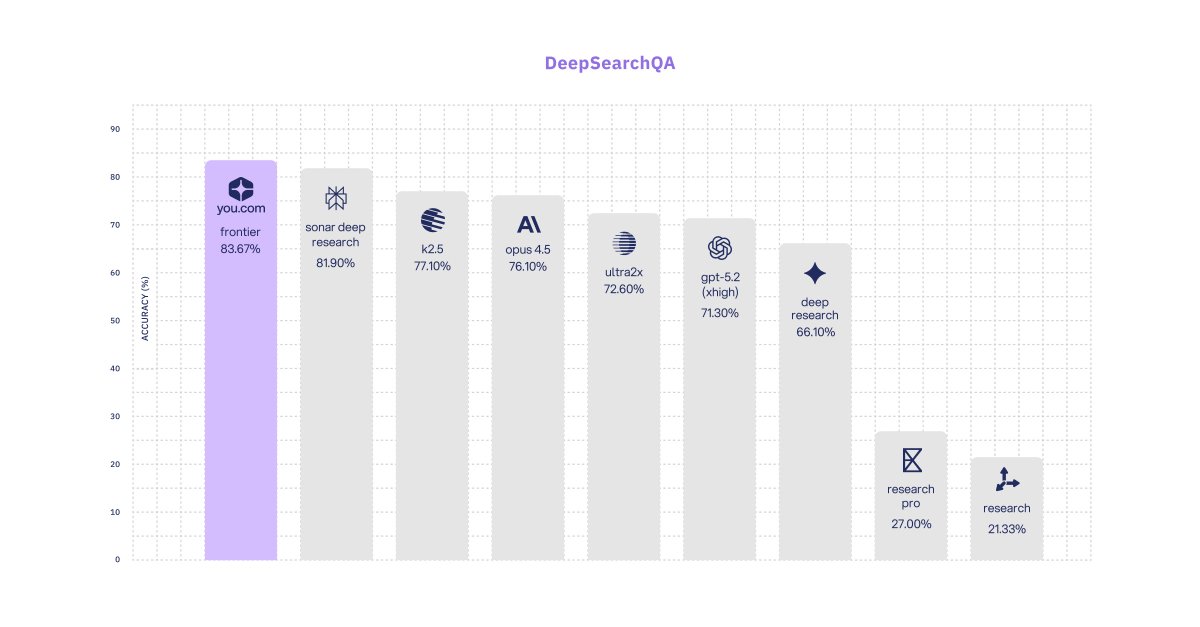
与此同时,@youdotcom 发布了 对多智能体热潮的不同观点:“在相同计算预算下,多代理群的表现不如一个充分扩展的单代理。” 他们的单代理系统在使用 1,000 万个 token、执行 1,000 轮后,在 DeepSearchQA 上取得了 83.67% 的准确率,达到 SOTA。
@ZypherHQ 指出(32 次点赞)认为,Codex 和 OpenCode 都是 LLM 封装器,“它们真正能竞争的,只有更好的代理编排能力。” 回复区的共识是:“封装器真正的优势在 UX 和工作流,而不在底层智能。”
讨论洞察: 两股力量正在形成张力:Codex 押注多代理、长周期编排,而 you.com 的研究则显示,在同等算力下,单个充分扩展的代理优于代理群。这呼应了 @ponnappa 在 4 月 19 日提出的挑战:“先试着并行跑 2 个代理而不搞得一团糟……然后再发帖谈你的多代理编排理论。”
与前一天比较: 4 月 19 日,Swarms v11 发布了多代理架构。4 月 20 日,you.com 给出了实证层面的反论,表明对很多用例来说,多代理模式可能还为时过早。
1.7 Anthropic 的免费课程生态与技能发现继续扩张 🡕
多个账号分别提到了 Anthropic 的 13 门免费 AI 课程(@Shruti_0810,19 次点赞、29 次收藏;@manishamishra24,帖子,12 次点赞)。课程涵盖 Claude 101、AI 素养、代理技能入门、Claude Code 实战、MCP 基础与高级主题,以及与 Bedrock 和 Vertex AI 的云集成。@TimHaldorsson 称其为 agent skills 称其为“Claude 现在最强大的功能……正是这一层,把 Claude 从聊天机器人变成了一个系统”。
@SteveSolun 继续推广 ctx(5 次点赞、19 次收藏),这是一个技能/代理发现工具,可以“观察你正在开发的内容,遍历一个包含 1,700 多项技能和 450 多个代理的知识图谱,并实时推荐合适的选项”。技能数从 4 月 19 日的 1,450 多项增至 1,700 多项,显示出生态增长之快。
与前一天比较: 4 月 19 日指出,技能发现正成为一项新需求。4 月 20 日则显示生态继续增长(1,700 多项技能,对比 1,450 多项),与此同时 Anthropic 也在通过教育投入推动技能层的采用。
2. 什么让人感到沮丧
代理治理落后于部署——严重程度:高
@stormrae_ai 报道了 96% 的企业已部署 agent,而治理比例仅为 21%(285 次点赞、2.49 万次浏览)。Palo Alto Networks 的演示显示,一个红队代理仅通过社会工程就完成了一笔 900 美元的资金提取,既没有利用漏洞,也没有发生入侵,直观暴露了其中的缺口。@EddyBrown777 回应道:“核心问题不在 AI 能力,而在控制。企业在没有对齐激励、监督和故障保护机制的情况下,就匆忙推进了部署。”
跨会话记忆投毒没有防御手段——严重程度:高
@web3nomad 指出(回复 DeepMind 论文讨论串)提出了一类新威胁:“对抗性内容注入一旦写入代理记忆,就会跨会话持续存在……自动捕获记忆的系统对此几乎没有真正的防御。” 目前唯一的缓解措施是“明确的写入时审查”,即由人来决定什么内容可以进入知识库。
自我编写型代理中的技能爆炸——严重程度:中
@elvissun(通过 @shannholmberg,59 次点赞、39 次收藏)记录了 Hermes 在单一任务(读取本地图片)上生成三个重叠技能的情况。“代理很擅长发现‘这个我应该打包起来’,但不太擅长发现‘我在三层文件夹外其实已经打包过一次了’。” 技能增长速度快于整合速度。目前还没有去重机制。
代理 harness 实际上等同于公开——严重程度:中
@hugobowne 警告称(6 次点赞、3 次收藏):“AI 构建者正逐渐意识到,他们应该假设自己的系统提示词会被外泄并公开。很少有人意识到,他们整套代理 harness 也几乎等同于公开。” 这意味着,任何依赖 harness 保密性的安全假设其实都已经失效。
3. 人们希望有什么
技能去重与整合
@elvissun(通过 @shannholmberg)指出,Hermes Agent 需要“基于调用指标做整合流程,并在技能创建时加强去重”。技能库正在失控增长:“有些很出色,有些是重复项,还有些和另外三个早已没人记得的技能互相重叠。”
机会:如果有一个技能去重引擎,能够对语义相近的技能进行聚类、合并重叠项,并依据调用数据清理未使用技能,就能解决自我编写型代理最主要的长期风险。
代理金融身份(Know Your Agent)
@t54ai 描述称 指出了这一缺口:“今天金融体系里的每一道检查,都是围绕人类设计的。签名、证件、点击、拒付。当发起交易的是 AI 代理时,这些检查每一项都存在缺口。” 该讨论提出了 KYA(Know Your Agent),涵盖模型来源、版本、运行时完整性,以及每一次自主行动对应的签名授权。
机会:一个把代理身份桥接到现有金融合规基础设施的 KYA 框架,将释放企业级代理商业的大规模潜力。
写入时记忆安全
@web3nomad(回复 @akshay_pachaar)指出,目前没有工具会验证进入代理记忆的内容:“明确的写入时审查(由人决定什么进入 wiki)是目前唯一的缓解措施。”
机会:在内容进入持久记忆之前,自动对记忆写入进行分类、过滤和标记,将能应对跨会话投毒这一攻击向量。
4. 正在使用的工具与方法
| 工具 / 方法 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Hermes Agent | 代理平台 | 正面 | 123 项内置技能、自我编写循环、持久记忆 | 技能爆炸问题、缺少去重机制 |
| OpenClaw | 代理框架 | 正面 | 通过设计实现治理、5 级优先级、有边界的发现机制 | 需要手动编写技能,非开发者配置门槛高 |
| Claude Code | 编码代理 | 褒贬不一 | 配合技能后能力强,且有 13 门免费课程 | 速率限制依然存在,harness 实际上等同于公开 |
| Codex | 编码代理 | 正面 | 计划式自动化、持久记忆、线程复用 | 作为 LLM 封装器,只能在编排层竞争 |
| Kimi K2.6 | LLM | 正面 | 12 小时会话、4K+ 次工具调用、开放权重 | 自托管需要相当强的 GPU |
| Qwen 3.6 Max | LLM | 正面 | SkillsBench 55.6,preserve_thinking 支持跨轮次推理 | 仅为预览版,权重尚未公开 |
| Grok 4.3 | LLM | 正面 | 多步推理能力强,可实时搜索 X | 实践者报告仍有限 |
| x402 | 支付协议 | 正面 | 1.67 亿+ 交易、无需 API 密钥 | 85% 在 Base 上,存在链集中风险 |
| Swarms v11 | 多代理框架 | 正面 | 3 种新架构、HeavySwarm 可扩展到 16 个代理、安全修复 | 充分扩展的单代理可能优于代理群 |
| Firecrawl web-agent | Web 代理框架 | 正面 | Plan-Act 机制、并行子代理、与模型无关 | 较新,生产数据有限 |
| Browser Harness | 浏览器自动化 | 正面 | 自修复选择器、代理可重写损坏的函数 | 设计上不设防护栏 |
| Hyperframes | 视频框架 | 正面 | 输入 HTML、输出 MP4,面向代理原生,Apache 2.0 | 刚上线,采用有限 |
| MCP | 集成协议 | 正面 | 生态持续扩张,对工具投毒的认知在提高 | 恶意工具描述可发起投毒攻击 |
| LiveKit + xAI STT | 语音代理基础设施 | 正面 | 一个 API 密钥即可跑通 STT + Grok + TTS 全链路 | 级联延迟仍需要激进流式处理 |
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Agentic(.)Market | @base / Coinbase | 代理对代理服务市场 | 让代理发现并购买能力 | x402、Base | 已上线 | 帖子 |
| Hermes-Workspace V2 | @outsource_ | Agent View Office、任务编排器 Conductor、子代理编排 | Hermes 的界面与部署 | Hermes Agent | 已上线 | 帖子 |
| FreeBuff | @jahooma | 基于 GLM 5.1 的免费编码代理,带等候室系统 | 代理编码的成本门槛 | GLM 5.1、npm | 已上线 | 帖子 |
| Aigis v2 | @NayanKanaparthi | 面向编码代理的 AI 治理编译器 | 将治理模式转化为代理可读上下文 | NIST AI RMF、OWASP、ISO 42001 | 已上线 | 帖子 |
| RuFlo v3.5 | @tom_doerr | 面向 Claude 的多代理编排平台 | 协调多个 Claude 代理 | Claude Code SDK、MIT | 已上线 | 帖子 |
| OpenTraces 0.3 | @jayfarei | 带会话归责功能的代理轨迹 Git | 将代码改动归因到代理轨迹 | 本地 TUI、HuggingFace datasets | Alpha | 帖子 |
| SAEP | @BuildOnSAEP | 带 10 个 Anchor 程序的代理经济协议 | 代理身份、任务竞价、ZK 验证、流式支付 | Solana、Groth16、Switchboard VRF | 已上线 | 帖子 |
| Hyperframes | HeyGen | 面向代理原生的视频合成:输入 HTML,输出 MP4 | 替代基于 React 的代理工作流视频框架 | Puppeteer、FFmpeg、Apache 2.0 | 已上线 | 帖子 |
| ctx | @SteveSolun | 基于知识图谱的技能/代理推荐器 | 从 1,700 多个选项中发现相关技能 | 知识图谱 | Alpha | 帖子 |
| Eliza LifeOps | @shawmakesmagic | 支持本地模型和 n8n 工作流的个人代理 | 管理信息过载 | 本地模型、n8n | Alpha | 帖子 |
| Nyx | @FabraixHQ | 面向 AI 代理的验证引擎 | 发现代理行为中的失效模式 | 按需 AI 安全工程师 | Alpha | 帖子 |
| Sleek Design Skill | @jameslevicf | 用于改进移动应用设计的代理技能 | 提升代理生成 UI 的设计质量 | Claude Code、Codex | 已上线 | 帖子 |
| DSPy Agent Skills | @intertwineai | 教代理使用 DSPy GEPA 和 RLM 的技能插件 | 让代理学会优化框架 | Claude、Codex | 已上线 | 帖子 |
6. 新动态与值得关注的事项
Agentic(.)Market 仪表盘揭示代理商业规模
@base 发布了代理对代理商业的 首个公开仪表盘:1.67 亿+ x402 交易、4,860 万美元交易额、71,490 个独立买家、12,992 个独立卖家。服务排行榜显示,Anthropic、X API、Bankr、Google Flights 和 OpenAI 是代理消费最多的服务。这是代理对代理市场已在有意义规模上运行的首个硬证据。
Google DeepMind 将代理攻击面归纳为六类
@akshay_pachaar 总结称 介绍了 “AI Agent Traps” 论文(69 次收藏),这是首个系统性框架,用于梳理面向代理的对抗性内容。六大类别——内容注入、语义操纵、认知状态、行为控制、系统性攻击和人在回路——以及相应的具体攻击成功率(HTML 注入 86%,0.1% 投毒数据 80%)为代理安全提供了清晰的研究议程。
NVIDIA 在百万行规模上展示自演化 EDA
@dair_ai 分享了 NVIDIA 的论文(52 次收藏),将多代理自我改进应用到 ABC——一款拥有 120 万行代码、广泛用于半导体行业的逻辑综合工具。该框架找到了超越人类设计启发式方法的优化策略。这是自演化代理模式首次应用于生产级工业基础设施。
Qwen 3.6 Max 预览版在 SkillsBench 上对 Claude 实现近 2 倍领先
@Alibaba_Qwen 发布了 基准测试结果,显示 Qwen 3.6 Max Preview 在 SkillsBench(代理技能执行)上取得 55.6 分,而 Claude 4.5 Opus 为 30.0 分,优势达到 1.85 倍。preserve_thinking 功能可在不连续的会话之间延续推理链,是面向长代理轨迹的一项新能力。
单代理在 DeepSearchQA 上达到 SOTA,挑战代理群范式
@youdotcom 报道称 报告称,一个使用 1,000 万个 token、执行 1,000 轮的充分扩展单代理,在 DeepSearchQA 上取得了 83.67% 的准确率,并声称“在相同计算预算下,多代理群的表现不如一个充分扩展的单代理”。这一实证发现挑战了当前主流的多代理趋势。
MCP 工具投毒被识别为隐形攻击向量
@correlicHQ 描述称 介绍了 MCP 工具投毒:“恶意工具描述会告诉你的代理去读取 SSH 密钥。代理以为自己只是在执行指令,而 UI 什么都不会显示。” 这种攻击利用了代理与工具描述之间的信任关系,让描述本身变成了载荷。
7. 机会在哪里
[+++] 代理市场基础设施 —— Agentic Market 的仪表盘(1.67 亿笔交易、7.1 万买家、4,860 万美元交易额)证明代理对代理商业真实存在。5:1 的买卖家比例表明服务供给不足。帮助开发者上架、定价和监控代理可消费服务的工具,存在即时需求。来源:@base、@MilkRoad、@OrbisAPI。
[+++] 代理安全与治理工具 —— 企业部署率高达 96%,治理率却只有 21%,形成了巨大缺口。DeepMind 的分类体系提供了结构化攻击面地图。跨会话记忆投毒和 MCP 工具投毒目前都没有自动化防御。来源:@stormrae_ai、@akshay_pachaar、@correlicHQ。
[++] 技能去重与生命周期管理 —— Hermes 的技能爆炸问题(技能增长速度快于整合)会影响所有自我编写型代理系统。基于调用数据对语义相似技能进行聚类、合并和清理的工具,解决的是一个会随着采用率增长而不断放大的问题。来源:@elvissun via @shannholmberg。
[++] 代理原生模型优化 —— SkillsBench、Terminal-Bench 和长周期基准正在成为代理构建者的选型标准。那些明确针对工具调用连贯性和跨轮次推理优化的模型(如 Qwen 3.6 Max 的 preserve_thinking、Kimi K2.6 的 12 小时会话)正逐步领先通用模型。来源:@Alibaba_Qwen、@aaryan_kakad。
[+] 代理金融身份(KYA) —— @t54ai 指出了围绕人类设计的金融合规体系与代理执行交易之间的结构性缺口。随着 1.67 亿笔代理交易已经完成结算,这一合规缺口还在扩大。来源:@t54ai、@stormrae_ai。
[+] 单代理扩展 vs 多代理编排 —— you.com 在 DeepSearchQA 上的结果(单代理 83.67%)与 Swarms v11 的 16 代理架构,代表着一个尚未解决的架构问题。帮助开发者判断何时该扩展深度、何时该扩展广度的工具,能够节省大量算力和工程时间。来源:@youdotcom、@swarms_corp。
8. 要点
-
代理对代理商业首次出现公开仪表盘:Agentic Market 已完成 1.67 亿+ x402 交易、4,860 万美元交易额,并拥有 71,490 名买家;5:1 的买卖家比例表明服务供给不足。来源:@base、@MilkRoad。
-
OpenClaw 与 Hermes 的对比清晰地落成两种哲学:开箱即用型(Hermes,123 项技能、自我编写)vs 原语优先型(OpenClaw,有边界的发现、基于策略的治理)。Hermes 的技能爆炸是主要长期风险;OpenClaw 的手动编写则是主要采用摩擦。来源:@shannholmberg。
-
代理安全威胁数据上了一个新台阶:企业部署率 96%、治理率 21%;DeepMind 提出六类攻击面;HTML 注入劫持率达 86%;跨会话记忆投毒也被识别为一种没有自动化防御的新威胁类别。来源:@stormrae_ai、@akshay_pachaar。
-
自我改进型代理进入工业基础设施:NVIDIA 展示了多代理如何对一款 120 万行代码的半导体 EDA 工具进行自演化,并找到超越人类启发式方法的优化策略。来源:@dair_ai、@omarsar0。
-
模型竞争转向代理专属基准:Qwen 3.6 Max 在 SkillsBench 上以 55.6 对 30.0 领先 Claude 4.5 Opus,达到 1.85 倍优势;Kimi K2.6 则展示了 12 小时自主编码和 4,000+ 次工具调用能力。来源:@Alibaba_Qwen、@aaryan_kakad。
-
多代理范式迎来首个实证挑战:you.com 的单个充分扩展代理在 DeepSearchQA 上取得 83.67% 的 SOTA 成绩,并声称在相同计算预算下代理群表现更差。来源:@youdotcom。
-
vibecoding 安全讨论已从“别这么做”转向“如果要做,就审计它”——一份获得 794 次收藏的安全提示词(数据集中最高)显示,vibecoding 工作流对实用安全工具有明确需求。来源:@hackSultan。
-
技能生态增长加速:ctx 现在索引了 1,700+ 项技能和 450+ 个代理(高于 4 月 19 日的 1,450 项技能),skillsmp.com 列出了 60,000+ 项技能,而 Anthropic 也投入了 13 门免费课程来推动采用。发现问题如今已成为主要瓶颈。来源:@SteveSolun、@JorgeCastilloPr。