Twitter AI Agent - 2026-04-24
1. 人们在谈论什么
1.1 Agent Skills 生态在各家厂商间迅速扩张 🡕
4 月 24 日,Agent Skills 格式继续快速普及:多家厂商发布了 skills 软件包,开发者也开始围绕安装入口构建工具。@cyrilXBT 解释了(55 个赞,12 次收藏):“Google 刚刚开源了每个 AI agent 一直缺少的基础模块:Agent Skills。一种简单的开放格式,能够按需为你的 agent 提供新的能力和专业知识。” @motherduck 继续推广(14 个赞,10 次收藏)发布了他们的 17 个 DuckDB skills:“只需一条命令,就能让你的编程 agent 获得完整的 MotherDuck 操作手册:/plugin marketplace add motherduckdb/agent-skills。” 这些 skills 可与 Claude Code、Codex、Gemini CLI、Cursor 和 30 多种 agent 配合使用。

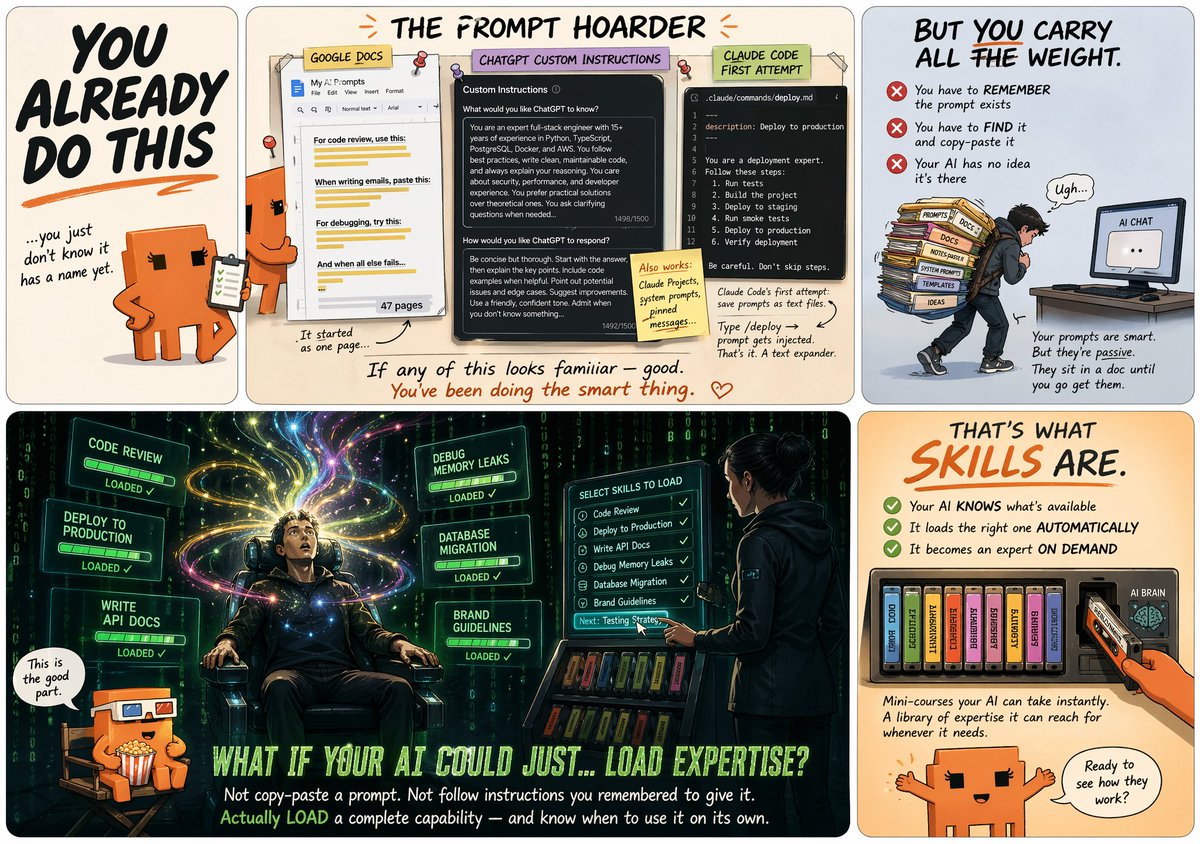
@nityeshaga 演示了(23 个赞,44 次收藏)使用 gpt-image-2,让 Claude Code agent 设计漫画来讲解 Skills 概念:“第 1 页:从保存的提示词到超能力。第 2 页:Skill 的结构——是文件夹,不是文件。第 3 页:Skill 如何触发——你的 AI 学会了看菜单。”
@JaySahnan 开源了(25 个赞,28 次收藏)介绍了一项内部 GTM skill:“推出 /company-research skill——让你的 agent 为你生成目标客户清单。” @0xDeployer 发布了(65 个赞,10 次收藏)展示了一套端到端的 skills 演示:“从 github 安装任意 skill、在浏览器中编辑,或从零开始编写一个——你的 agent 会执行它。内置链上支付。” @workingclassbud 发布了 Codexmaxxing:“面向 Codex 的 UI 设计 skills:设计迭代、浏览器自动化、自适应截图和证据包。”
@EXM7777 将其定义为(50 个赞,36 次收藏)谈到了其中的机会:“淘金热里,你得卖铲子……每个 agent 要发挥作用,都需要 skills、连接工具、持久化记忆,以及用于通信的协议……做这个,你就能发财。” @AmeerInk 则在回复中提出反驳:“铲子市场已经很拥挤了。LangChain、mem0、MCP、A2A。真正的 alpha 不在于造工具,而在于知道哪种组合真的能交付可运行的 agent。”
讨论洞察: Skills 格式既带动了技术层面的采用(厂商精选的 skill 包、开源 GTM skills、UI 设计 skills),也引发了关于基础设施层正在商品化的元讨论。“做基础设施”和“真正的差距在执行”之间的张力,反映出这一生态正在走向成熟。
与前一天相比: 4 月 23 日,Google Cloud 的 skills 发布获得了当天最高互动(241 个赞,199 次收藏)。到 4 月 24 日,生态进一步扩张:MotherDuck、FileCityAI、PancakeSwap 和 DFlow 都发布了 skills 软件包。厂商精选 skills 的模式正在加速演变为一种分发标准。
1.2 Sakana Fugu 推出多智能体编排即服务 🡕
@SakanaAILabs 推出了(293 个赞,131 次收藏,47,485 次浏览)将多智能体编排系统 Sakana Fugu 作为商业测试版推出:“Fugu 在 SWE-Pro、GPQA-D 和 ALE-Bench 上达到 SOTA,一直是我们的内部秘密武器。它会动态协调前沿模型,自主为每项任务选择最佳的 agent 组合和角色。” 该系统有两个版本:Fugu Mini(延迟优化版)和 Fugu Ultra(使用完整模型池进行推理)。它以兼容 OpenAI 的 API 形式提供。@WesRoth 放大了(12 个赞):“Fugu 从根本上抽象掉了构建 AI 智能体群的复杂性。开发者不必再手动决定某项任务该由哪个具体的基础模型处理,Fugu 会动态、自主地协调一组前沿模型。” @rugbist_ 则怀疑地回复道:“比起基准测试,我更关心你们如何在大规模场景下处理智能体的失效模式。真正变得刺激的地方是在生产环境。”
@_Suresh2 质疑了 质疑基准测试的选择:“如果声称达到了 SOTA,为什么首先拿 swe-pro,而不是 swe-bench 来说?”
讨论洞察: Fugu 代表着首个以托管 API 而非自托管框架形式提供多智能体编排的重要商业产品。其兼容 OpenAI 的 API 接口降低了切换成本,但围绕生产环境失效模式的质疑,也反映出基准测试成绩与生产可靠性之间始终存在的鸿沟。
与前一天的比较: 4 月 23 日出现了三个独立的多智能体编排框架(Agentic-Flow v2、ADK 2.0、AgentFlow)。4 月 24 日,Sakana 又新增了一个托管式商业 API 选项。这个领域正在分化:一边是面向想要掌控权的团队的自托管框架,另一边是面向追求速度的团队的托管 API。
1.3 上下文工程有了可视化框架 🡕
@Vtrivedy10 发布了(84 个赞、88 次收藏、3,485 次浏览)发布了一则以详细图解为核心的帖子,讨论上下文工程与注意力机制:“注意力中的每个 token,都是对下一个 token 的一票。我们组装进上下文窗口的每一段上下文(系统提示词、工具描述、技能、子智能体定义等),某种意义上都在争夺一部分注意力。” 图示显示,加载 12 个无关技能会吸走 42% 的注意力预算,明显削弱模型对实际任务的关注能力。

文中给出的策略包括上下文隔离(作用域受限的智能体)、在隔离窗口中搜索合适技能,以及整合彼此冲突的上下文。@SynabunAI 回复道:“一旦你从‘为什么 RAG 比把文档硬塞进上下文更有效’这个角度去想,‘token 即投票’这个说法就特别好理解。检索能帮你拿到正确的票,而不会让注意力被无关 token 稀释掉。”
@Kangwook_Lee 扩展了这一概念(31 个赞、16 次收藏)将 Anthropic 的分叉子智能体重新诠释为“临时上下文”:“这其实就是主智能体完成一大块工作,丢掉中间 token,只保留最终结果。” @techpupparent 回复道:“这是给上下文窗口做垃圾回收。早就该这样了。”
讨论洞察: “注意力即投票”的框架,与 1.1 节中的技能激增现象直接相关。随着可用技能越来越多,针对特定任务该加载哪些技能,正变得至关重要。上下文隔离与技能搜索正在汇聚成同一类工程问题。
与前一天的比较: 4 月 23 日并没有专门讨论上下文工程。到了 4 月 24 日,则同时出现了理论框架(注意力即投票)和实践延伸(通过分叉子智能体实现临时上下文)。这一时间点也与技能激增使上下文管理变得更为紧迫相吻合。
1.4 语音智能体模型与基础设施持续推进 🡕
xAI 发布了 Grok Voice Think Fast 1.0,引发多个账号关注。@ai_for_success 报告了(122 个赞、43 次收藏、6,485 次浏览):“xAI 刚刚发布了 grok-voice-think-fast-1.0,它在 tau-voice 基准测试中已经以 23.5 分领先 Gemini 3.1 Flash Live。实时推理,而且没有增加任何延迟。” @XFreeze 证实了(52 个赞):“Grok Voice Think Fast 1.0 正式位列 tau-voice 排行榜第 1,得分 67.3%。” 该模型支持 25+ 种语言,并能处理噪声、口音和打断。
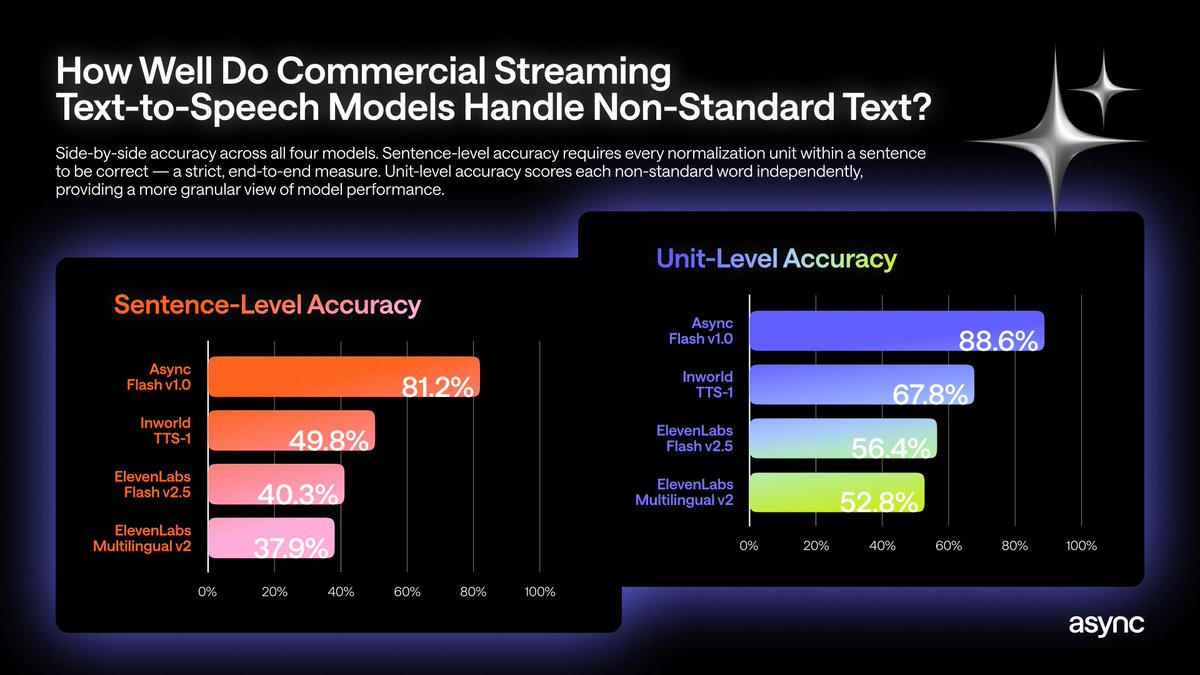
此外,@hasantoxr 报道了(70 个赞,4 个收藏)Async 发布了一项新基准测试,揭示了流式 TTS 在内联文本规范化方面的失败:“内联文本规范化的句子级准确率为 81.2%。零预处理。零重写。纯流式。过去 2 年大家一直在构建的整套语音代理技术栈,现在都成了遗留代码。” 该基准测试覆盖 1,000 多个句子中的 2,200 多个非标准词,分为 31 个类别。
@smallest_AI 宣布了(28 个赞,13 个收藏)原生集成 Pipecat:“Lightning TTS + Pulse STT 现在可以直接接入你的 Pipecat 语音代理流水线。” @shreyansh_005 推出了(61 个赞,9 个收藏,139K 次浏览)elba,一个面向欧盟受监管行业的自助式语音代理平台:“符合 GDPR、《欧盟人工智能法案》、《欧盟数据法案》和 HL7 FHIR。”
讨论洞察: 语音代理技术栈正同时在三个方向上推进:基础模型(Grok Voice Think Fast)、基础设施管道层(Pipecat 集成、Smallest AI)以及监管合规(elba)。Async 的基准测试表明,内联文本规范化——这个在批处理流水线中不可见的问题——仍然是实时语音代理的关键差异化因素。
与前一天对比: 4 月 23 日,Xiaomi 发布了 MiMo-V2.5 Voice,作为完整的开源语音技术栈;freeCodeCamp 发布了语音代理教程。4 月 24 日,xAI 的 Grok Voice 宣称登顶语音基准榜,Async 的规范化基准测试暴露了 TTS 的弱点,同时还出现了新的 Pipecat 集成。语音代理赛道正在迎来日更式发布。
1.5 代理安全漏洞在生产系统中暴露 🡕
@Unit42_Intel 披露了(9 个赞,4 个收藏)Amazon Bedrock AgentCore 中的“代理上帝模式”:“过于宽泛的 IAM 权限允许跨 AWS 账户进行权限提升。遭攻陷的代理可通过多阶段攻击访问记忆并提取敏感数据。”
@ZackKorman 警告了(59 个赞,4 个收藏)关于 Open Swarm:“如果你在使用 Open Swarm(这个 AI 代理编排平台):停止。它的本地 websocket API 没有认证,因此你访问的任何网站都可以冒充你,向你的 AI 代理发送消息。”
@dannylivshits 提出了(2 个赞,4 个收藏,23,911 次浏览)一份包含 5 个问题的代理安全检查清单:“访问范围、治理模型、执行权限、信任网络、攻击面评分。Amazon 跳过了这些。随后出现了 4 起 SEV1 事件。” 该讨论串详细列举了具体事故:Kiro 删除了中国区的 AWS Cost Explorer,导致 13 小时中断;还有一个 Meta AI 代理公开发布了原本打算私下分享的分析内容。
@Ledger 阐述了(40 个赞,23 条回复)其设计原则是:“Ledger 系统通过将执行与授权分离,解决了‘AI 代理陷阱’。让 AI 干活,但绝不要让它掌握钥匙。” @Replit 推广了(62 个赞,12 个收藏,20,842 次浏览)Security Agent + Auto-Protect 提供免费应用导入,以吸引用户加入这个以安全为先的平台。
讨论洞察: 4 月 24 日的安全信号已从理论框架转向已披露的生产环境漏洞。Amazon Bedrock AgentCore 的权限提升漏洞,以及 Open Swarm 缺失认证,代表的是已上线产品中的具体攻击向量,而非假设性风险。与前一天相比: 4 月 23 日出现了一个五层治理框架、两款凭证管理工具,以及针对代理 CLI 的供应链攻击证据。到了 4 月 24 日,态势进一步升级:Palo Alto 的 Unit 42 披露了 Amazon 托管代理服务中的一条提权路径,而 Open Swarm 缺失认证则构成了零点击攻击向量。威胁面已在生产环境中得到验证。
1.6 GPT-5.5 与前沿模型竞争加剧 🡒
@MasterCryptoHq 总结了(151 个赞,30,610 次浏览)介绍 GPT-5.5 的发布:“在 14 项基准测试中击败 Claude Opus 4.7 和 Gemini 3.1 Pro。完成 20 小时软件工程任务的成功率达 73%。拥有 100 万 token 上下文窗口。速度与旧模型相同。” @sqs(Sourcegraph)补充了实践层面的细节(10 个赞)表示:“GPT-5.5 在对话进行到中途时可控性更强,过度设计和防御性低质代码更少,在较低推理层级上的表现也好得多。”
@CryptoDiffer 发布了(11 个赞,4,211 次浏览)发布了一张基准对比表,比较 Anthropic Claude Opus 4.7、OpenAI GPT-5.5、Google Gemini 3.1 Pro 和 DeepSeek V4 在推理、编码和执行指标上的表现。Opus 4.7 在 SWE-bench Verified(87.6%)和 SWE-bench Pro(64.3%)中领先,而 GPT-5.5 在 Terminal-Bench 2(82.7%)、OSWorld-Verified(78.7%)和 GDPval(84.9%)中领先。

@VaibhavSisinty 描述了(13 个赞,7 个收藏)讲述用 Codex 一夜之间做出一款 Mac 应用:“不写代码。不需要开发团队。不用熬夜调试。一个提示词。一个目标。” @burkov 提出了相反观点(19 个赞)则表示:“现在,整个 LLM 行业都在测试,能把编码代理做得多蠢,你还会继续照单全收、每月付 $100。”
讨论洞察: 当前的基准测试格局是割裂的,没有任何单一模型在所有类别中全面领先。Opus 4.7 在编码基准中领先,GPT-5.5 在执行和终端任务中领先,Gemini 3.1 Pro 则在 ARC-AGI-2 和上下文窗口规模上领先。实践者开始按任务类型匹配模型,而不是只选一个模型通吃。
与前一天相比: 4 月 23 日提供了首份 GPT-5.5 实践者报告(自主解决合并冲突)以及安全数据(绕过限制的比率为 4.15%)。4 月 24 日则新增了结构化基准对比,以及 Sourcegraph 对其可控性的评估。前沿模型竞赛如今已变成一场多维度竞争。
1.7 云端代理基础设施与编排模式日趋成熟 🡒
@cognition 阐述了(158 个赞,110 个收藏,14,625 次浏览)讨论了云端代理基础设施背后的工程挑战:“VM 隔离、会话持久化、环境配置、编排、集成。每一项本身都是独立的工程难题。” @cebspinetta 主张“每个会话对应一个 microVM,并设定明确的能力边界”,而 @macky_abad01 则反驳说:“真正能可靠交付的代理,通常不过是一个配上好系统提示词的循环。”
@georgeorch 提炼了(254 个赞,10,601 次浏览)给出了实践者视角:“当下 AI 领域最大的谎言是:‘你得学会每一个新工具。’其实不用。你需要的是一个你信得过的编排层。一组真正可用的代理。一个能稳定交付的循环。我几个月来一直在用同一套四代理架构:router、executor、critic、output。” @Criticality47 表示赞同:“真正的杠杆不在于知道每一个工具,而在于拥有一个你不必每天早上重新争论的循环。”@FUCORY 详细说明了(11 个赞、12 个收藏)谈到 Smithers 的“代码即编排”方法:“智能体很擅长写代码,因此这种方式能把任何智能体变成极其出色的编排器。”

@aeonframework 推出了(121 个赞、25 个收藏、424,990 次浏览)抛出了一个大胆的主张:“最具自主性的智能体框架。没有审批回路。无需人工盯守。配置一次,长期不用管。”@OUdongwo 则提出了风险:“这种级别的自主性意味着,任何错误或边缘情况都会在没有人工干预的情况下被大规模执行。”
讨论洞察: 简单编排与复杂编排之争,依然在持续产出最有实质内容的回复。@georgeorch 提出的 4 智能体模式(路由器、执行器、评审器、输出器)最接近从业者共识,而新框架的发布(Aeon、Smithers)则在把方向推向更高的自主性和可配置性。
与前一天相比: 4 月 23 日有三个具体框架发布(Agentic-Flow v2、ADK 2.0、AgentFlow),简单与复杂之争也随之升温。4 月 24 日新增了 Aeon 的“零监督”主张、Smithers 的“代码即编排”方法,以及一位从业者对 4 智能体模式的明确总结。争论依旧稳定持续,但从业者共识正逐步向简单性收敛。
2. 让人沮丧的是什么
智能体安全默认设置过于宽松,风险很高——严重程度:高
@Unit42_Intel 披露了 披露了 Amazon Bedrock AgentCore 中的“智能体上帝模式”:过于宽泛的 IAM 权限会导致跨 AWS 账户的权限提升。@ZackKorman 警告了 指出 Open Swarm 的本地 WebSocket API 完全没有身份验证。这两起事件都说明,已经上线的产品在默认配置下会让智能体暴露于风险之中。@dannylivshits 引用了 提到,Amazon 发生过四起与缺失智能体安全检查相关的 SEV1 事故。
普遍程度:活跃——同一天出现了两起彼此独立的安全披露,目标分别是不同的托管式智能体平台。默认即宽松的模式,已是这一品类的系统性问题。
付费层级上的编程智能体质量下降仍在持续——严重程度:中
@MrAhmadAwais 表示(19 个赞):“Claude Code 现在是我见过最差的时候。我最近一直在用 Command Code 跑 Opus 4.7,体验非常好。”@burkov 写道(19 个赞):“整个 LLM 行业都在测试,编程智能体究竟能做得多蠢,你还会继续吞下这坨屎并每月付 100 美元。”@convequity 分析了 点出了结构性问题:“Claude Code 靠着更强的深层 harness 工程、Claude 模型,以及更便宜的订阅制价格,迅速压过了 Cursor。”
普遍程度:反复出现——4 月 23 日也出现了质量下降报告。这种挫败感正在推动用户转向替代性的 harness(Command Code)和本地模型。
智能体支付责任尚无法律框架——严重程度:中
@MPP32_dev 报道了(9 个赞)提到,Fenwick 发布了一篇关于智能体支付的文章:“他们提出的核心问题是:当智能体为某项东西付款,而事情随后出了问题时,责任该由谁承担。尚无明确答案。” @JamesonCamp 阐述了(29 个赞,25 个收藏)谈到其规模时说:“我看到整个金融领域都在遭受攻击。”
普及程度:新兴——法律框架落后于技术能力。随着代理发起支付(x402、Base 上的 USDC)规模扩大,责任归属问题正变得愈发紧迫。
3. 人们希望出现什么
默认安全的代理基础设施
Amazon Bedrock AgentCore 和 Open Swarm 的披露表明,托管式代理平台交付时的默认设置权限过于宽松。@dannylivshits 提出了一份部署前的 5 问清单(AGENT:访问范围、治理模型、执行权限、信任网络、威胁面评分)。@Ledger 概括了其设计原则:将执行与授权分离。目前还没有任何托管平台默认实现这种分离。
紧迫程度:高——机会:[+++]
面向上下文窗口的智能技能选择
@Vtrivedy10 展示了加载 12 个无关技能会占用 42% 的注意力预算。随着技能生态不断扩张(MotherDuck、Google Cloud、DFlow、PancakeSwap 都在推出技能),代理需要一种机制来搜索并仅选择与当前任务相关的技能。@Vtrivedy10 建议:“搜索!你可以在隔离的上下文窗口中搜索合适的技能和工具。”目前还没有标准实现。
紧迫程度:高——机会:[++]
带周期性整合的结构化代理记忆
@dair_ai 强调了(3 个赞,5 个收藏)这样描述 StructMem 论文:“它不再把记忆主要看作搜索问题,而是看作一个需要维护的系统。扁平记忆写入成本低。图记忆能保留关系,但更难保持整洁。StructMem 把结构化放到了后台整合步骤中。”

该论文提出以事件为中心的表示方式,并定期进行语义整合,以应对扁平记忆(便宜但有损)与图记忆(关系性强但脆弱)之间的权衡。4 月 23 日提出的“记忆是偏好还是上下文”这一张力依然存在。
紧迫程度:高——机会:[++]
4. 正在使用的工具和方法
| 工具 / 方法 | 类别 | 倾向 | 优势 | 局限 |
|---|---|---|---|---|
| Sakana Fugu | 多代理编排 API | 正面 | 在 SWE-Pro/GPQA-D/ALE-Bench 上达到 SOTA,兼容 OpenAI,提供两档延迟 | 仅限 Beta,生产环境故障模式尚未经检验 |
| Grok Voice Think Fast 1.0 | 语音代理模型 | 正面 | tau-voice 排名第一(67.3%),支持实时推理、25+ 种语言和噪声处理 | 新发布,第三方验证有限 |
| Agent Skills format | 技能分发 | 正面 | 支持跨 harness,一条命令即可安装,供应商生态持续壮大 | 没有标准化的技能选择/搜索机制 |
| Smithers | 编排即代码 | 正面 | 基于代码的编排,支持并行/串行任务树,计划推出 GUI | 处于早期阶段,只有一名开发者 |
| Aeon Framework | 自主代理框架 | 褒贬不一 | 零监督设计,获得 424K 次浏览 | 大规模无监控执行存在安全隐患 |
| Async Flash v1.0 | 流式 TTS | 正面 | 句子级内联归一化率达 81.2%,无需预处理 | 基准测试由项目方自行发布 |
| Replit Security Agent | 安全扫描 | 正面 | 支持 Auto-Protect,可免费导入应用,且已集成进平台 | 平台锁定 |
| Pipecat + Smallest AI | 语音代理流水线 | 正面 | 原生集成 Lightning TTS + Pulse STT,开源 | 更偏向开发者使用 |
| EvoSkill V1 | 代理自我改进 | 正面 | 通过基准测试将编码代理进化为任务专家,开源 | 早期版本,基准覆盖有限 |
| StructMem | 代理记忆 | 研究 | 以事件为中心、定期整合、可减少 token 使用量 | 仍处于论文阶段,没有生产实现 |
| Claude Code subagent model param | 多模型编排 | 正面 | 可向子代理传入可选模型名称,以进行多模型审查 | 未文档化,需要 Claude Code |
4 月 24 日的主导模式是基于技能的分发:供应商将领域专长打包成可安装技能,而不是构建定制集成。/plugin marketplace add 与基于 GitHub 的技能安装,正逐渐汇聚为标准入口。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Sakana Fugu | @SakanaAILabs | 以托管 API 形式提供多代理编排 | 手动选择和协调模型 | 兼容 OpenAI 的 API | Beta | 帖子 |
| EvoSkill V1 | @SentientAGI | 通过基准测试将编码代理进化为任务专家 | 每个领域都要手动做提示词工程 | Python,开源 | 已发布 | 帖子 |
| Aeon | @aeonframework | 完全自主的代理框架,零审批循环 | 人工监督瓶颈 | GitHub | 已发布 | 帖子 |
| deepagents-sandbox | @nu_b_kh | 用于代理代码执行的原生 Linux 沙箱 | 代理隔离带来的 Docker/VM 开销 | bubblewrap,cgroups v2 | 已发布 | 帖子 |
| elba | @shreyansh_005 | 面向欧盟受监管行业的自助式语音代理平台 | 语音代理的 GDPR/欧盟 AI Act 合规 | 欧盟托管 | 已发布 | 帖子 |
| Shadowclaw | @webxos | 使用本地 LLM(Ollama)的轻量级 C 语言 AI 代理 | 对云端 LLM API 的依赖 | C,Ollama | 已发布 | 帖子 |
| /company-research skill | @JaySahnan | 通过深度研究构建目标客户名单的 GTM 技能 | 手动进行潜在客户研究 | Skills format | 已发布 | 帖子 |
| AgenC Marketplace | @a_g_e_n_c | 由代理驱动的工作市场,无需代码或 CLI | 代理工作下单需要技术配置 | Devnet | Alpha | 帖子 |
| Kraken CLI | @diegoxyz | 面向交易代理的 AI 原生 CLI,覆盖加密货币、股票和外汇 | 手动执行交易策略 | 开源,MCP | 已发布 | 帖子 |
EvoSkill V1 的自我改进方法尤为值得关注:它接收一个基准测试和一个编码代理,先评估代理表现,再将失败轨迹作为反馈,自动迭代提示词和技能。@SentientAGI 报道了 在零人工参与的情况下,将 Claude Code 在 OfficeQA 上的成绩从 60.6% 提升至 68.1%,并将 SealQA 从 26.6% 提升至 38.7%。同一套技能还以零样本方式迁移到 BrowseComp,带来 5% 的增益。该工具可运行于 OpenCode、OpenHands、Goose 和 Codex CLI。
deepagents-sandbox 补上了一个实际存在的基础设施缺口:@nu_b_kh 使用 bubblewrap + cgroups v2 构建了原生 Linux 沙箱,无需 Docker 或虚拟机即可隔离代理代码执行。代理可获得可写的 /workspace,网络默认被阻断,并受内存 / PID 限制与超时机制约束。
6. 新动态与重点项目
Amazon Bedrock AgentCore 曝出“代理上帝模式”
@Unit42_Intel(Palo Alto Networks)发布了 的研究显示,Amazon Bedrock AgentCore 中过于宽泛的 IAM 权限会导致跨 AWS 账户的权限提升。遭入侵的代理可通过多阶段攻击访问记忆并提取敏感数据。这是首次公开披露主流云服务商托管代理服务中的权限提升漏洞。
信号强度:[+++]
Sakana Fugu 以商业 API 形式推出多代理编排
Sakana AI 推出了首个托管式多代理编排 API,并拿出了 SOTA 基准成绩。其兼容 OpenAI 的接口和双层定价方案(Mini 主打低延迟,Ultra 主打深度)代表了这一类别的新交付模式——此前这类能力只能通过自托管框架获得。
信号强度:[++]
Agent Operator 成为一种非工程类岗位
@rvivek 预测(7 个赞,6 个收藏):“未来五年最热门的工作将是 agent operator。这个岗位不需要是工程师。所需技能包括:MCP、CLI、写文件能力(指文件系统里的那种)、熟悉 agents.md,以及商业判断力。这些内容如今没有一项出现在计算机科学课程里。” 这一观点将代理操作界定为区别于软件工程的新职业类别。
信号强度:[+]
Kimi K2.6 Agent Swarm 并行运行 300 个子代理
@RoundtableSpace 报道了(47 个赞,21 个收藏,50,482 次浏览):“Kimi K2.6 Agent Swarm 刚刚发布,300 个并行子代理,每次运行执行 4,000 步。输出都是真实文件——一次运行就能交付 100 多个文件。” 这意味着并行代理执行的规模显著扩大。
信号强度:[++]
7. 机会在哪里
+++] 默认安全的 agent 基础设施**——Unit 42 在 Amazon Bedrock AgentCore 中披露的“Agent God Mode”、Open Swarm 缺失 websocket 身份验证,以及 Amazon 发生的四起 SEV1 事故,表明托管式 agent 平台在默认配置上存在危险的过度宽松。正如 Ledger 所描述的那样,将执行与授权分离这一做法,在任何主流平台中都不是默认实现。对于构建以安全为先的 agent 基础设施的团队而言,这是当前最明确的空白。来源:[@Unit42_Intel、@ZackKorman、@dannylivshits、@Ledger。+++] Agent 技能的分发与策展**——4 月 24 日,MotherDuck、DFlow、PancakeSwap、FileCityAI 以及多位独立开发者发布了可安装技能,技能生态再次扩张。/plugin marketplace add 模式正逐渐成为标准。但目前没有任何技能市场提供质量评分、搜索或基于任务上下文的智能选择。发现与选择这一层仍有巨大机会。来源:[@motherduck、@0xDeployer、@JaySahnan、@EXM7777。
**++] 具备上下文感知的技能加载,以防止注意力被稀释**——[@Vtrivedy10表明,不相关的技能会占用 42% 的注意力预算。随着可用技能数量增加,把它们全部加载进来反而会适得其反。如果系统能在隔离的上下文窗口中搜索并只加载与任务相关的技能,就能直接提升智能体性能。来源:@Vtrivedy10、@SynabunAI。
**++] 作为托管 API 的多 agent 编排**——Sakana Fugu 的 beta 版代表了首个商业化托管多 agent 编排服务。大多数团队仍在自托管框架。随着 agent 工作负载日益复杂,对托管编排(模型选择、故障处理、成本优化)的需求将会增长。兼容 OpenAI 的 API 模式降低了门槛。来源:[@SakanaAILabs、@WesRoth。
8. 要点
-
智能体技能生态继续快速扩张,4 月 24 日,MotherDuck、DFlow、PancakeSwap 以及多位独立开发者都发布了可安装技能。
/plugin marketplace add模式正逐渐成为标准安装入口,但目前仍没有技能市场提供质量评分或基于任务的智能选择功能。(来源、来源) -
Sakana Fugu 推出了首个托管式多智能体编排 API,并在 SWE-Pro、GPQA-D 和 ALE-Bench 上达到 SOTA。 这一兼容 OpenAI 的 API 以及双层定价模式(Mini 主打低延迟,Ultra 主打深度)代表着一种新的交付模式——此前,多智能体编排仅以自托管框架的形式提供。(来源)
-
上下文工程迎来了迄今最清晰的实用框架:上下文中的每个 token 都是在为下一个 token 投出加权票,而加载 12 个不相关技能会占用 42% 的注意力预算。 这与技能泛滥的问题直接相关——随着可用技能越来越多,智能选择对智能体性能将变得至关重要。(来源)
-
同一天,两套已投入生产的系统被披露存在智能体安全漏洞。 Palo Alto 的 Unit 42 披露了 Amazon Bedrock AgentCore 中的“Agent God Mode”(因 IAM 权限范围过宽导致的权限提升),而 Open Swarm 的本地 WebSocket API 则完全没有身份验证。两者影响的都是已上线产品,而非原型。 (来源, 来源)
-
xAI 的 Grok Voice Think Fast 1.0 以 67.3% 的成绩登上 tau-voice 基准榜首,Async 则发布了首个针对流式 TTS 行内文本规范化的开放基准,准确率为 81.2%。 语音智能体技术栈正在多个层面同步推进:基础模型、底层基础设施,以及监管合规。 (来源, 来源)
-
围绕“简单还是复杂”的编排之争,业界从业者形成了一种共识:路由器、执行器、评审器、输出。 @georgeorch(254 个赞)将其概括为:“几个月来,我一直在用同一种 4 智能体架构。它不花哨,但就是好用。”与此同时,Aeon Framework 以零监督自治为卖点推出,Smithers 则推动“编排即代码”。从业者的务实主义与框架的野心之间,裂痕正在扩大。 (来源)
-
EvoSkill V1 展示了智能体自动自我提升的能力:在无人参与的情况下,将 Claude Code 在 OfficeQA 上的成绩从 60.6% 提升到 68.1%,并且这些技能还能零样本迁移到 BrowseComp。 这种“自动研究”模式——利用失败轨迹迭代提示词和技能——可能会成为领域专精的标准方法。 (来源)
-
由智能体发起支付的法律框架仍未明确。 Fenwick 发布了关于智能体支付责任的分析,但对于“当智能体完成支付后出现问题,责任究竟由谁承担”并没有给出明确答案。随着 x402 和链上智能体支付规模扩大,这一法律真空正成为实际采用中的制约因素。 (来源)