Twitter AI Agent - 2026-04-29
1. 人们在讨论什么
1.1 Agentic Harness Engineering 论文将自我改进的 Harness 正式化 🡕
当天信号最强的内容是一篇新论文(arXiv:2604.25850v1),提出了 Agentic Harness Engineering(AHE)。该论文由 @omarsar0 在 详细拆解 中分享(500 个赞、1,013 个书签、34,840 次浏览)。这一框架通过三大支柱让 Harness 的演进变得可观测:组件可观测性(可回滚的文件级编辑)、经验可观测性(从数百万轨迹 token 中浓缩出的证据),以及决策可观测性(可根据任务结果检验的可证伪预测)。结果显示:经过十轮迭代,Terminal-Bench 2 的 pass@1 从 69.7% 提升至 77.0%,超过人工设计的 Codex-CLI(71.9%)以及自我演进基线 ACE 和 TF-GRPO。演进后的 Harness 还能跨模型家族迁移,带来 +5.1 到 +10.1 个百分点的提升,同时减少 12% 的 token 使用量。

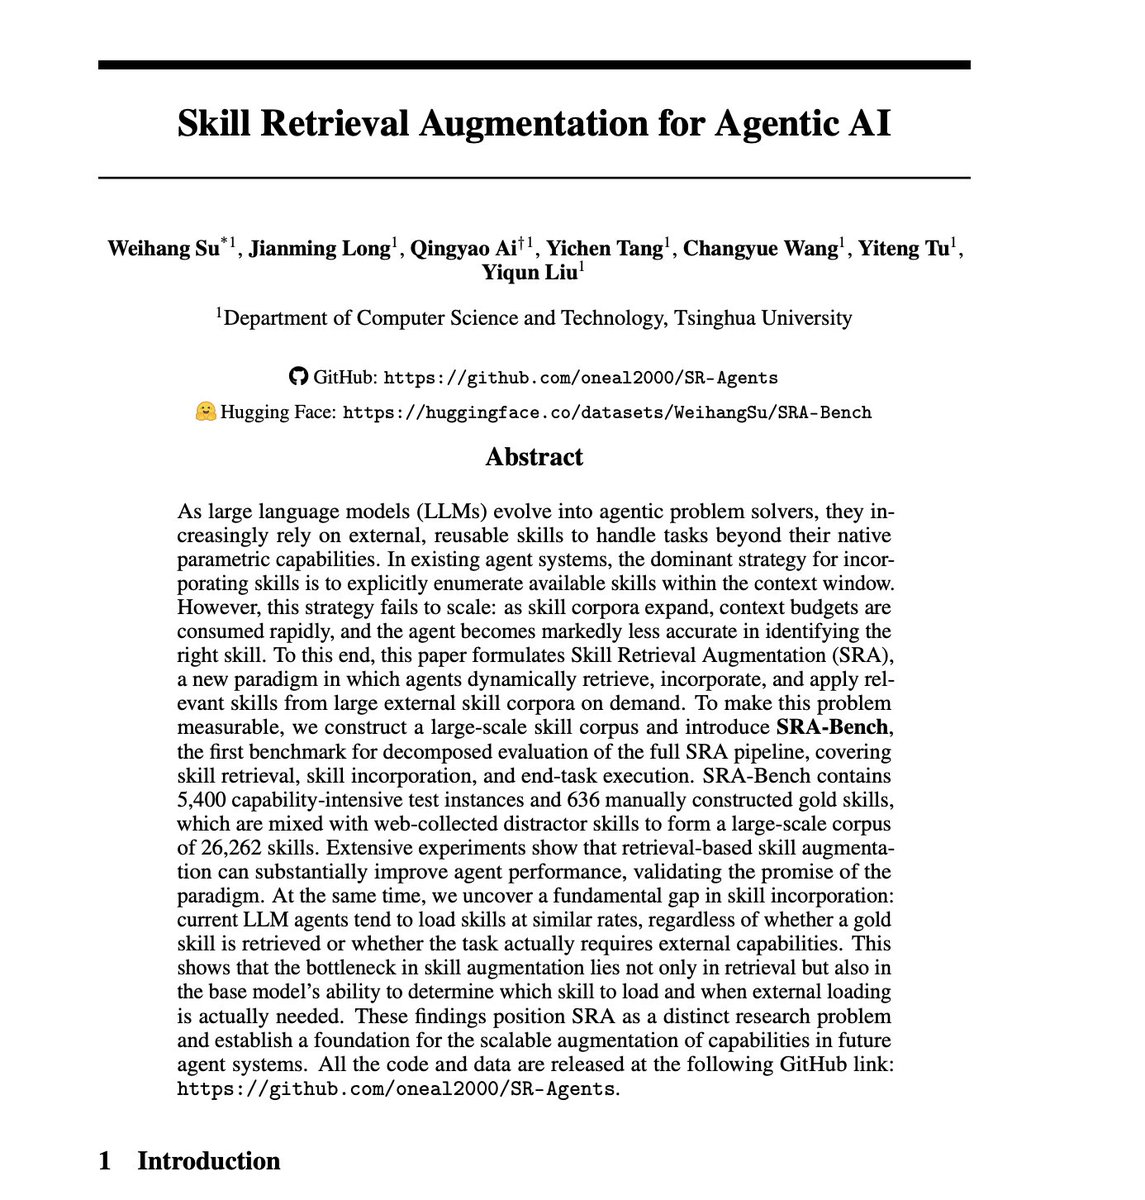
Martin Fowler 链接(139 个赞、170 个书签)在其 fragments 页面推荐了 Birgitta Böckeler 的 harness engineering 视频和 Chris Parsons 更新后的 AI 编程指南。后者指出:“现在比的已经不是‘我们能多快构建出来’,而是‘我们能多快判断它是否正确’。”@jobergum 发文(80 个赞、91 个书签)分享了清华大学的 Skill Retrieval Augmented Agents 论文。该论文提出从包含 26,262 项技能的语料库中动态检索技能。其 SRA-Bench 发现:无论任务是否真的需要外部能力,当前 agent 加载技能的频率都相近——瓶颈不在于知道检索什么,而在于知道何时加载。
讨论洞察: @RuijieRao 给出了最贴近实践的回应:“手动调优这件事确实存在。构建 agent 工作流时,我大部分时间并不是在写核心逻辑,而是在迭代 harness 配置……瓶颈在于,不运行完整任务,就无法评估 harness 的质量。”@ethankongee 则把这个框架扩展为:自我改进 + 自我修复 + 自我安全 + 自我维护 = 完整愿景。@DylSwanepoel 点出了核心价值:“让 agent 的改进变得可证伪,而不是凭感觉。”
与前一天对比: 4 月 28 日,harness engineering 通过 ODSC 演讲登上会议舞台;4 月 29 日则出现了首个用基准结果验证、可自动化 harness 演进的同行评审框架,推动范式从“教它”转向“让它自己改进”。
1.2 Agent Skills 生态在各平台爆发式增长 🡕
4 月 29 日,“skills” 这一基础原语在多个平台同步活跃,达到临界规模。@bigaiguy 报道称(12 个赞、11 个书签)称,Obsidian 创作者 Kepano 发布了 obsidian-skills,该项目已获得 27K stars,可让 Claude Code、Codex CLI 和 OpenCode 在 vault 中读写和推理。首发提供五项技能(obsidian-markdown、obsidian-bases、json-canvas、obsidian-cli、defuddle),可通过 npx skills add 安装。@WesRoth 指出(11 个赞)称 xAI 正在为 Grok 开发专门的“Skills”标签页,Grok 4.3 支持创建技能。@github_skydoves 发布(36 个赞、32 个书签)分享了面向 Jetpack Compose 的 Compose Performance Skills,内容基于一手资料。
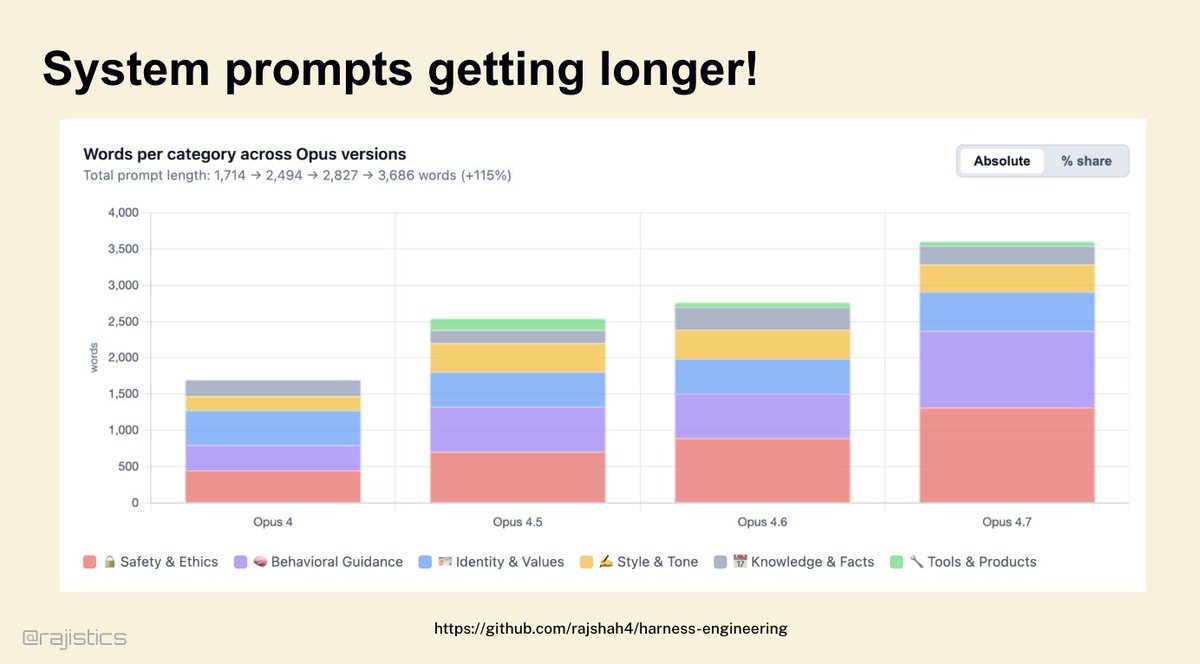
@code(VS Code)宣布(39 个赞、20 个书签)分享了 Agent Plugins,可用于安装技能、命令、MCP servers 和 hooks。@rajistics 分享了他在 ODSC 的 harness engineering 演讲幻灯片,其中显示 Opus 不同版本的系统提示词长度增长了 115%(从 1,714 词增至 3,686 词)。
讨论洞察: @_jphwang 承认 点出了实践者感受到的落差:“我其实并不知道(a)它们能把性能提升多少,以及(b)怎么写出好的技能。”这说明 skills 已被广泛采用,但人们对它的理解仍然不足。
与前一天对比: 4 月 28 日,Google 发布了官方 Agent Skills 仓库;4 月 29 日,这一模式开始扩散:Obsidian、xAI/Grok、VS Code,以及各类垂直领域仓库都在向 skills 作为标准扩展机制收敛。
1.3 Cursor SDK 和 /multitask 将 Agent 作为基础设施交付 🡕
Cursor 做出了两项重要动作。@cursor_ai 推出了 Cursor SDK 发布后,开发者可以使用驱动 Cursor 的同一套运行时、harness 和模型来构建 agent——可从 CI/CD 流水线、自动化流程中运行,也可嵌入产品。@alphabatcher 将其定义为(11 个赞)写道:“CI 失败 > agent 被唤醒 > 检查仓库 > 修补 bug > 发起 PR > 如果需要人类接手,它就会出现在 Cursor 里。到某个阶段,IDE 不再是 agent 栖身之处,而变成了你检查 agent 的地方。”
与此同时,@kevinkern 报道称(33 个赞、12 个书签)称 Cursor 已发布 /multitask:“不再由一个 agent 在一个超长上下文里包办所有事,主 agent 可以把工作拆分成更小的异步子 agent……你还可以在 Cursor 的 harness 里为不同任务使用不同模型。我一直让 Opus 4.7 充当主协调器,让 GPT-5.5 high 负责实现任务。”
讨论洞察: @infix_fun 指出了一项限制:“我只是希望它能稳定工作。它并没有像我想要的那样尽可能并行化。”这种跨模型编排模式——高端模型负责协调、低成本模型负责实现——正成为现实中的默认方案。
与前一天对比: 4 月 28 日,jcode 推出了处于灰色地带的并行 agent 会话;4 月 29 日,Cursor SDK 给出了正式版本:官方支持、可嵌入 CI/CD 的 agent 运行时,以及通过 /multitask 实现的 IDE 原生编排。
1.4 上下文工程与 Agent 编排正收敛到共享原语 🡒
@Av1dlive 强调(110 个赞、230 个书签)分享了一份关于“上下文工程、工具设计、协调器-子 agent、评估、harness 思维”的视频手册,并将其描述为成为 100 倍 agentic engineer 的路径。@yoheinakajima 认可(82 个赞、162 个书签)分享了一篇将 agent 编排简化到核心的文章,指出它“收敛到一种与 babyagi 2 十分相似的架构:把函数(agent 工具)及其输入/输出/依赖/keys 存进数据库”。
@akoratana 描述(90 个赞、135 个书签)分享了“context graph”——一种不是靠手工文档,而是从工作过程留下的痕迹中自然形成的公司世界模型。核心论点是:PlayerZero 仅凭六个月积累的上下文,就把模拟准确率从 54% 提升到了 95+%。@DeepLearningAI 报道(25 个赞、11 个书签)分享了一场关于记忆工程和上下文工程的工作坊,其中有一句话:“没有记忆的 AI Agent,不过是胸怀野心的自动补全。”
讨论洞察: @wanner_tyler 提出了一个综合设想:“想象一下,如果已经存在优雅、简单、健壮、可靠、可持久、确定性的工作流工具,具备简单的函数级工作流语义,而你只需给 agent 一些受治理的控制杠杆来运行这套系统。”收敛点在于:编排、上下文和记忆正在坍缩为同一门工程学科。
与前一天对比: 4 月 28 日聚焦于记忆架构的逆向工程(Hermes 五层系统);4 月 29 日则上升到更高抽象层次:把编排与上下文视为统一的工程学科。
1.5 Agent-to-Agent 商业交易首次获得真实资金证据 🡕
@omooretweets 分享(70 个赞、64 个书签、9,949 次浏览)分享了 Anthropic 内部的“Project Deal”实验:Claude 采访了 69 名员工,了解他们想买卖的物品,搭建了一个分类信息市场,并由 agents 自主协商交易。结果是达成 186 笔匹配,完成了超过 $4,000 的真实交易,交换的实物从滑雪板到乒乓球不等。参与者表示愿意为类似服务付费。

@ryanmcnutty33 指出了基础设施缺口:“我觉得要让这件事成立,我们需要一种供 agents 使用的无线电。我想的是某种新基础设施,像广播一样让其他 agents 看见彼此,而不只是依赖中心化查询。发现机制会是个大问题。”@pjmfinn 则将应用场景扩展到:“LinkedIn 也该往这个方向走。用一个 agent 中介来验证传入信息,并帮你处理传出信息。”
讨论洞察: 从“agent 协商理论交易”转向“agent 在真实员工之间用真实资金协商真实实物交易”,是一次显著的证据升级。被指出的瓶颈——agent 发现基础设施——从另一个角度映射了技能检索问题。
与前一天对比: 4 月 28 日通过 @DeFi_Pop 首次报道了这一实验;4 月 29 日则浮现出一手来源(Anthropic 博客)以及聚焦基础设施缺口的实践者反馈。
1.6 Pika Agents 延续“RIP Prompt Box”论点 🡒
Pika Agent 的发布持续引发讨论。@dr_cintas 演示了(38 个赞、39 个书签、5,063 次浏览)展示了如何向一个 agent 教会完整的创意广告技能,并让它一键执行。@svpino 分析了(13 个赞、16 个书签)总结了这种思路:“这里押注的是改善人与 agent 之间的接口。”多条帖子都在呼应 Pika 的框架:在创意工作流中,由个性驱动的对话将取代提示词工程。
@Th3RealSocrates 延续了 4 月 28 日的竞争分析:“这里真正的护城河是个性层。模型选择会在 6 个月内商品化,但‘我的 Pika agent’会让用户保持黏性。”
与前一天对比: 4 月 28 日介绍了 Pika Agent 的发布;4 月 29 日则增加了实践者演示和持续背书,但没有新的技术主张。
1.7 OneManCompany 组织型 MAS 框架获得关注 🡕
@TheTuringPost 发布(6 个赞、6 个书签)详细拆解了华为诺亚方舟实验室的 OneManCompany 框架。关键创新包括:Skills 变成 Talents(包含角色、工具、提示词、配置在内的完整 agent 包);Container = 运行时(Claude Code、LangGraph、脚本);用于动态招聘的 Talent Market;E2R(Explore-Execute-Review)树搜索;以及包含绩效评估、PIP、离职和替换在内的人力资源生命周期。结果是:在 PRDBench 上达到 84.67%,比基线高出 15 个百分点。
@Jiaru_Zou 推出(34 个赞、28 个书签、5,360 次浏览)分享了 RecursiveMAS,这是一种互补方案:通过潜在空间递归实现多 agent 协作,在 9 个基准测试中平均准确率提升 +8.3%,推理速度提升 1.2-2.4 倍,token 使用量减少 34.6-75.6%。
与前一天对比: 4 月 28 日,OMC 获得了 68 个书签;4 月 29 日则新增了详细的技术拆解和一种互补的递归方案,进一步坐实了组织隐喻作为主流多 agent 架构模式的地位。
2. 什么让人沮丧
编程 Agent 不会把反馈沉淀为可复用知识——严重程度:高
@RhysSullivan 阐明(34 个赞、1,787 次浏览)指出了这一缺口:“编程 agents 不会充分推动你去复用反馈。我刚刚告诉我的 agent,它做 optimistic updates 的方式不对,但并没有一个被鼓励的‘第二步’,去把这些知识编码下来供未来使用。”@skeptrune 证实了这个问题:“claude code 已经开始说‘我为此添加了一条 memory’,但我倾向于认为,这么做只会把你带向上下文腐化。”@_jack_hogan 补充道:“大量使用 memories 感觉不对(而且不可靠),我也不确定怎样做才是最优的。”唯一明确的变通办法来自 @NathanOyler:“我会把知识编码进 skills……也会用 cronjobs 去改进 skills。”
Harness 主权 vs 平台锁定——严重程度:中
@Vtrivedy10 认为(12 个赞)指出,harness “会深刻影响 agent 表现”,把它外包就意味着“祈祷实验室或封闭 harness 替你把这件事做好,并且他们的目标和你一致”。@jobergum 说得很直接:“不要把你的 agent harness 外包出去。”@itunpredictable 整理汇编(53 个赞、3,337 次浏览)列举了涌向实践者的相互冲突的话术:“我们在做一家 agent harness 公司。我们要转型做面向编程 agents 的开源 IDE。这是你内部大脑的上下文引擎。”信号很明确:开发者想掌握 harness 的所有权,但生态碎片化让选择代价很高。
Cursor /multitask 的并行化不稳定——严重程度:低
@infix_fun 报道称:“它并没有像我希望的那样尽可能并行化。事实上,我有一次会话里,它一直把任务派发给同一个 agent。”这属于早期编排 UX:能力已经有了,但可靠性仍不均衡。
3. 人们希望出现什么
默认将反馈转化为技能的 Agent 行为
@RhysSullivan 和多条回复都证实:当你纠正一个 agent 时,这个纠正应该自动变成可复用的技能或规则,而不是脆弱的 memory 条目。当前方案(会腐化的 memories、手动创建 skills)都需要额外的人力投入,抵消了效率提升的意义。需求是:一个框架级的“反馈捕获 > 技能合成 > 验证”流水线。
紧迫性:高 —— 机会:直接产品
面向商业交易的 Agent 发现基础设施
@ryanmcnutty33 在回应 Anthropic 的 marketplace 实验时指出:“需要某种新基础设施,像广播一样让其他 agents 看见彼此,而不只是依赖中心化查询。”随着 agents 开始进行交易,它们需要去中心化的发现机制——相当于 agent 服务世界里的 DNS。
紧迫性:中 —— 机会:基础设施
大规模技能质量验证
SR-Agents 论文显示,agents 不论是否需要技能,都会加载技能。随着技能语料库不断扩大(该基准中已达 26,262+ 项),缺失的一层是自动质量评分和相关性门控——不仅要知道哪些技能存在,还要知道加载它是否真的有助于当前任务。
紧迫性:中 —— 机会:研究转产品
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Claude Code | 编程 agent | 正面 | Fowler 推荐;ODSC 演讲提及;skills 生态在增长 | 多 agent 使用受订阅限制;反馈难以沉淀为可复用知识 |
| Cursor SDK | Agent 运行时 | 正面 | 与 IDE 共用同一运行时/harness;可嵌入 CI/CD;支持 /multitask 编排 | 并行化不稳定;刚刚发布 |
| Hermes Agent | Agent 框架 | 正面 | Swarm patches 持续交付;支持多用户 | 对初学者较复杂 |
| Obsidian Skills | Skills 包 | 正面 | 27K stars;首发 5 项技能;MIT;兼容 Claude Code/Codex/OpenCode | 面向特定 vault;生态尚新 |
| Agent Skills spec | 标准 | 正面 | 已被 Google、Obsidian、Sleek、HeyGen、VS Code、xAI 采用 | 缺少质量验证层 |
| Codex CLI | 编程 agent | 混合 | Fowler 推荐;AHE 论文将其作为基线(71.9%) | 被 AHE 演进后的 harness(77.0%)超越 |
| RecursiveMAS | 研究框架 | 正面 | +8.3% 准确率;2.4 倍提速;75.6% token 降幅 | 仍处研究阶段;没有生产级工具 |
| LiveKit | 语音 agent 基础设施 | 正面 | 结构化数据采集;Tasks/TaskGroups SDK;JSON 输出 | 仅适用于语音领域 |
| Gemini Agent Platform | 企业级 | 正面 | Agent Identity/Registry/Gateway;支持多 harness | 面向企业;入场较晚 |
主导趋势是 skills 正在收敛为扩展原语:Google、Anthropic 生态、xAI、VS Code、Cursor 等主要平台都在一周内发布或宣布支持 skills。
5. 人们在构建什么
| 项目 | 谁在做 | 做什么 | 解决什么问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Agentic Harness Engineering | Fudan/Peking Univ | 通过可观测性驱动演进实现自我改进的 harness | 手动调优 harness;改进不可验证 | Terminal-Bench 2, SWE-bench | 研究 | 帖子 |
| Cursor SDK | @cursor_ai | 可嵌入 CI/CD 和产品的 agent 运行时 | Agent 被锁在 IDE 里;缺少程序化访问 | Cursor runtime, multi-model | 已发布 | 帖子 |
| obsidian-skills | Kepano | 面向 Obsidian vault 的 Claude Code/Codex skills | Agent 无法在笔记系统内推理 | Agent Skills spec, npx | 已发布 | 帖子 |
| Lazar | @jasonkneen | 只有单一 execute 工具 + skills 的自我演进 agent | 工具膨胀;agent 能力漂移 | Go, recursive self-calls | Alpha | 帖子 |
| RecursiveMAS | @Jiaru_Zou | 潜在空间递归式 MAS 协作 | 多 agent 中的 token 浪费和推理缓慢 | Lightweight Connector, inner-outer loop | 研究 | 帖子 |
| Pentest Agent Suite | @VivekIntel | 自主漏洞赏金框架(48 个 agents) | 从侦察到报告全流程依赖人工 | Claude, Codex, FAISS, SQLite | 已发布 | 帖子 |
| Compose Performance Skills | @github_skydoves | 面向 Jetpack Compose 性能的 agent skills | 通用 agent 缺少领域专长 | Agent Skills spec | 已发布 | 帖子, 仓库 |
| VoiceBox(本地 TTS/听写) | @exploraX_ | 免费本地语音克隆和听写,附带 MCP server | ElevenLabs/WisprFlow 订阅成本高 | Chatterbox, MCP, 7 TTS engines | 已发布 | 帖子 |
| X Spaces Agent | @trythreews | Agent 加入实时 X Spaces,收听并以语音回应 | Agents 无法参与实时音频 | Puppeteer, Groq/Anthropic/OpenAI | Alpha | 帖子 |
| Harness Engineering exercises | @rajistics | 带已发布幻灯片和练习的 ODSC 演讲 | 缺少能量化 harness 增长的教学材料 | GitHub | 已发布 | 帖子, 仓库 |
@jasonkneen 的 Lazar 值得注意,因为它极端简约:一个工具(execute)、递归自调用,以及 skills 作为唯一扩展机制。它会自主创建、发现、演进 skills,因此成为检验“仅靠 skills 是否足以支撑通用 agent 行为”的纯粹实验。
6. 最新且值得关注
Agentic Harness Engineering 论文引入可观测的自我改进
AHE 论文(1,013 个书签)是首个展示自动化 harness 演进且具备可证伪预测的同行评审成果。Terminal-Bench 2 上 77.0% 的 pass@1 同时超过人工设计的 harness 和此前的自我演进方案,并且能跨模型家族迁移。代码:github.com/china-qijizhifeng/agentic-harness-engineering。
信号强度:[+++]
Cursor SDK 让 IDE 的 Agent 运行时可嵌入
Cursor SDK 让开发者可以在 CI/CD 流水线、自动化流程或产品中运行同一套 agent runtime。再结合 /multitask(跨模型编排),Cursor 从 IDE 转变为 agent 基础设施提供商。@alphabatcher 描述的“CI 失败 > agent 修补 > 发起 PR”工作流,如今已获得官方支持。
信号强度:[+++]
Martin Fowler 认可“验证优先”的 Harness Engineering
Fowler 的 fragments 页面(170 个书签)传递的核心论点是:“现在比的已经不是‘我们能多快构建出来’,而是‘我们能多快判断它是否正确’。”他对 Birgitta Böckeler 的 harness engineering 文章(以及一场新的视频讨论)的认可,表明这一概念已从实践者 Twitter 进入软件架构主流圈层。
信号强度:[++]
Anthropic 的 Project Deal:186 笔真实资金的 Agent-to-Agent 交易
Anthropic 的 内部市场实验(64 个书签)在 69 名员工之间促成了 186 笔交易,真实成交金额超过 $4,000,且交易的都是实体商品。这是迄今最有力的证据,证明 agent-to-agent commerce 在真实利益驱动下也能运作。参与者明确表示“愿意为类似服务付费”,显示出消费者需求。
信号强度:[++]
xAI 通过 Grok Skills 标签页加入 Skills 生态
@WesRoth 报道称,xAI 正在为 Grok 开发 Skills 标签页(目前隐藏),Grok 4.3 支持创建技能。这使 xAI 成为继 Google、Anthropic 生态、OpenAI 之后,第四个采用 skills 作为扩展原语的主要平台,正接近普遍收敛。
信号强度:[+]
7. 机会在哪里
**+++] 反馈到技能的流水线**——“我纠正了我的代理”和“代理永久学会了这件事”之间的差距,是多个独立实践者最一致提到的痛点。[@RhysSullivan、@skeptrune 和 @_jack_hogan 都证实,当前做法(memories、手动编写 skills)并不够好。机会在于构建自动化系统:捕获纠正内容,将其合成为经过验证的 skills,并清理陈旧技能。当前唯一被明确提到的有效模式,是 @NathanOyler 手动用“cronjobs 改进 skills”——这非常适合产品化。
**+++] 具备可观测演化的开放 harness**——AHE 论文证明,harness 可以实现可量化的自我改进。[@Vtrivedy10 和 @jobergum 都认为,开发者应掌握自己的 harness。机会在于打造一个开源 harness 底座,并内置 AHE 式可观测性:每次编辑都被跟踪、每个预测都可证伪、性能提升无需完整重跑任务也能衡量。第一个把这些能力做成产品特性的 harness,将吸引那些当前仍在手动调优的实践者。
[++] Agent discovery and commerce infrastructure -- Anthropic proved agents can transact. @ryanmcnutty33 指出了缺失的一层:广播/发现基础设施,让 agents 无需中心化查询就能彼此发现。随着 skills 市场持续扩张(Swarms、Cursor、Google),agent-to-agent 服务发现的互操作层将成为关键基础设施。
**++] 技能质量与相关性门控**——SR-Agents 论文([@jobergum 揭示了 agents 会不加区分地加载技能。随着技能语料规模达到并超过 26,262 项,机会在于构建一个在加载前就评估技能相关性的检索层——避免上下文浪费和错用技能。这就是 skills 生态里的“搜索质量”问题。
**+] 跨模型编排工具**——[@kevinkern 展示了 Opus 4.7 负责编排、GPT-5.5 负责实现的模式。Cursor 的 /multitask 支持这种模式,但并不稳定。机会在于构建可靠的跨模型编排:高端模型负责规划,低成本模型负责执行,并根据子任务复杂度自动选择模型。
8. 要点总结
-
Agentic Harness Engineering 论文(1,013 个书签)证明,harness 的自我改进既可衡量也可迁移:十轮迭代后,pass@1 从 69.7% 提升至 77.0%,超过人工设计和自我演进基线,同时减少 12% 的 token 使用量。 这让 harness engineering 从“教人如何调优”转向“让 harness 在可观测契约下自行调优”。(来源)
-
Agent skills 生态已完成收敛:Obsidian(27K stars)、xAI/Grok、VS Code Agent Plugins、Cursor SDK、Google,以及多个垂直领域仓库都在同一天发布或宣布支持 skills,使 Agent Skills spec 成为事实上的 agent 扩展标准。(来源、来源、来源)
-
Cursor SDK 正把 IDE 从工作空间转变为 agent 基础设施提供商:可嵌入 CI/CD 的运行时、通过 /multitask 实现的跨模型编排(Opus 4.7 规划、GPT-5.5 执行),以及明确的论点——“IDE 会变成你检查 agents 的地方”。(来源、来源)
-
Anthropic 的 Project Deal 提供了迄今最强的 agent-to-agent commerce 证据:186 笔真实交易、超过 $4,000 的成交额、实体商品交换,且参与者愿意为该服务付费——讨论焦点由“agents 能否交易?”转向“它们需要什么样的发现基础设施?”(来源)
-
“反馈到技能”的断层,成了当天最一致的实践者痛点:agents 会接受纠正,却不会把纠正沉淀为可复用技能,导致开发者在不同会话中反复纠正同样的错误。 现有变通方案(memories、手动 skills、cronjobs)都被一致认为不够理想。(来源)
-
Martin Fowler 对“验证优先”的 harness engineering 的认可——“现在比的不是‘我们能多快构建’,而是‘我们能多快判断它是否正确’”——标志着这一概念已获得软件架构主流认可,完成了从 Twitter 讨论到 Fowler 推荐的演进。(来源)