Twitter AI Agent - 2026-05-02
1. 大家在讨论什么
1.1 单人 AI 代理公司之梦:5 台 Mac Mini,月入 $34k 🡕
当天互动最高的话题(74,344 次浏览,569 次收藏)是 @regent0x_ 描述:一人运营的代理公司用 5 台 Mac Mini 充当专职 AI 代理——每台都有独立职责(architect、coder、reviewer、tester、ops),并通过各自专用的 CLAUDE.md 文件严格划分关注范围。他声称,4 个按月续约客户带来每月 $34k 收入,而总计算成本仅 $115/月(5 个 Claude 订阅 + 电费);上个月在 3 个客户项目中一共提交了 847 次 commit。
每台 Mini 的职责边界都很清晰:coder 看不到部署密钥,reviewer 不能推送代码,ops 从不接触业务逻辑。它们通过共享任务队列通信,而不是彼此直接交流。
讨论洞察: @FabioAlfDee 提出反驳:“这类帖子很适合爆红,但实际根本不是这么运作的。而且在我看来,大部分内容都是胡扯。来源:我每天都在 Mac 和 GPU 上使用本地 LLM。” @BenSammons 则指出,这个成本说法并没有按实际价格计入 Claude 订阅费用。
与前一天对比: 5 月 1 日的焦点是 Flue 框架和企业治理(Agent 365)。到了 5 月 2 日,话题转向对多代理系统实际形态的一种具体、直观展示——实体硬件、明确的职责隔离、以及宣称的营收数字。“单人代理公司”这一模式,在盈利导向的场景中验证了 harness engineering 的原则(隔离上下文、角色专门化)。
1.2 Harness Engineering 术语开始定型 🡒
多篇帖子都在整理 harness engineering 的术语和实践:
@mattpocockuk(TypeScript 教育者)定义(33 个赞,20 次收藏)给出了四个关键术语:Model(无状态参数)、Harness(模型周围的一切——工具、系统提示词、上下文窗口管理)、Environment(代理施加动作的世界)、Agent(model + harness + environment)。他还澄清说:“scaffolding 是 harness 的别名。或者说,是 harness 提供给模型的那部分东西。”
@avrldotdev 阐述(31 个赞)提出,取代 prompt engineering 的是三门学科:Memory Engineering(系统记住什么)、Context Engineering(LLM 当前看到什么)和 Harness Engineering(系统如何表现)。
@DamiDefi 发布(106 个赞,6,745 次浏览)发布了一份全面的实践者指南,宣称“你现在在学的所有 AI 框架,6 个月后都会过时”,并列出真正会持续复利的能力:context engineering、tool design、orchestrator-subagent patterns、evals,以及“the harness mindset”。
@drummatick 记录 反映了从业者的疲惫感:“AI engineering 已经卷到这种程度了,我读一篇两个月前关于 harness 的博客,都觉得它已经过时了。”
与前一天对比: 5 月 1 日,harness engineering 主要是在经验层面得到验证(AHE 论文、12% 的基准波动)。而到 5 月 2 日,重点从“证明概念成立”转向“统一语言”——多位教育者在同一天发布定义性内容,说明这个领域正在形成自己的术语体系。
1.3 Agent 记忆被视为基础设施,而非功能 🡕
三个彼此独立的信号汇聚到同一个结论:记忆是生产级代理的核心挑战:
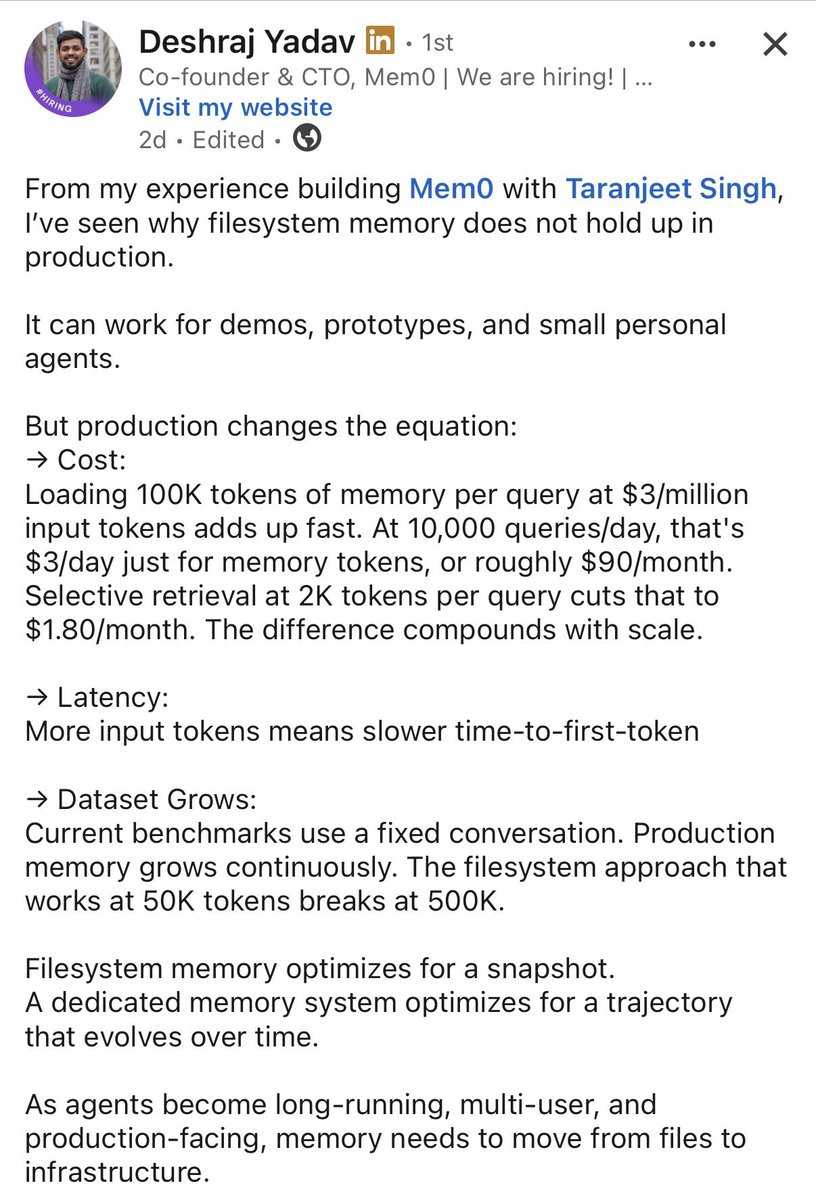
@DhravyaShah 介绍(28 个赞,26 次收藏,5,635 次浏览)介绍了 SMFS——一种可挂载的文件系统抽象,带有同步索引,旨在为代理优化 token 消耗和检索延迟。被引用的 Mem0 CTO 帖子解释了为何文件系统式记忆一旦规模化就会失效:如果每次查询都加载 100K tokens 的记忆,在每天 10K 次查询下每月要花 $90;而选择性检索可将成本降到 $1.80/月。
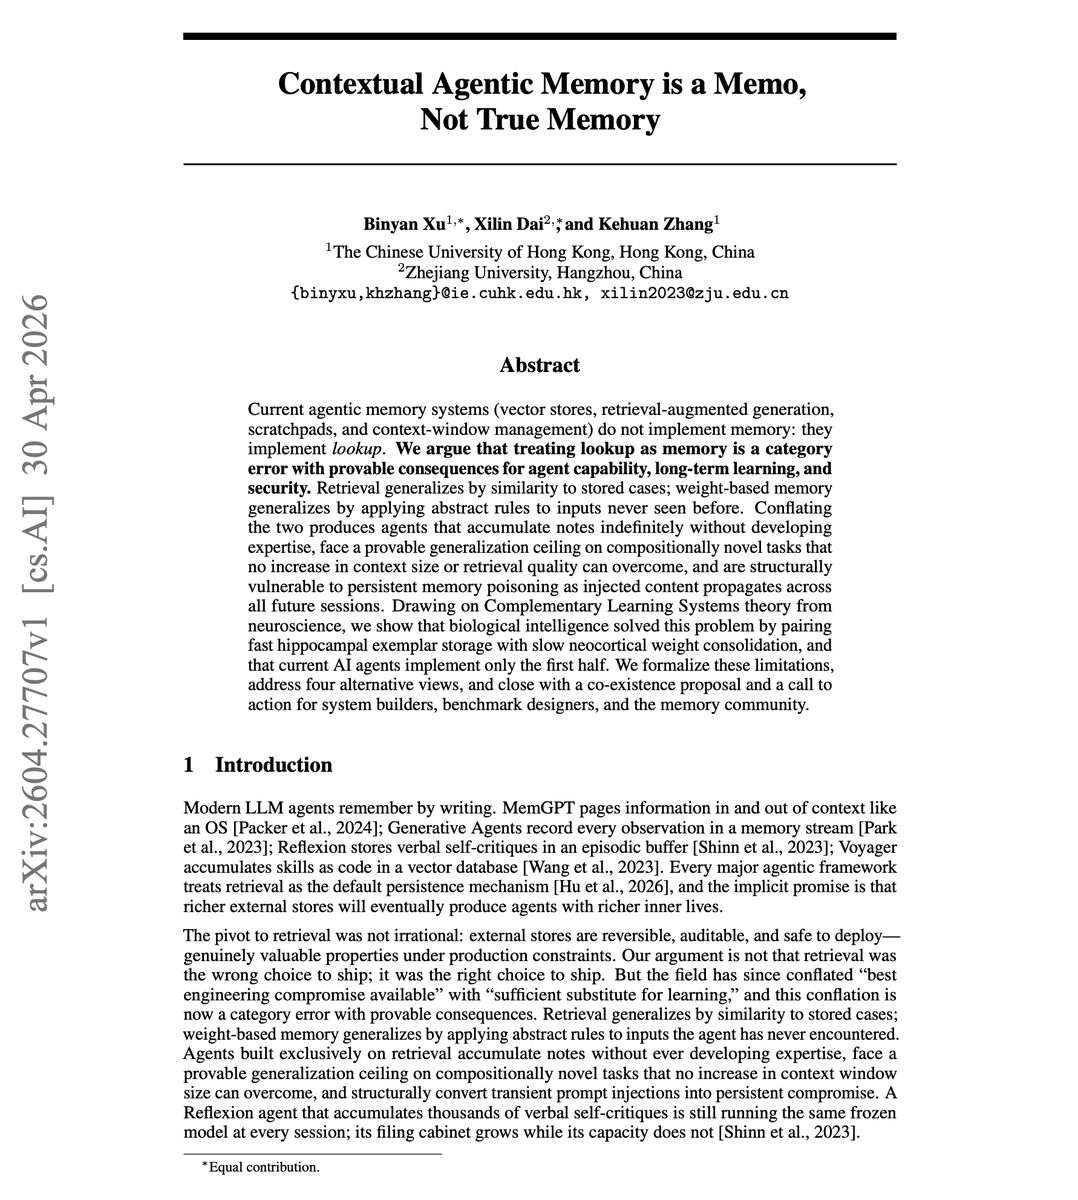
@dair_ai 分享(14 次收藏)介绍了一篇新论文《Contextual Agentic Memory is a Memo, Not True Memory》(arXiv:2604.27707,CUHK/Zhejiang),认为 vector stores、RAG buffers 和 scratchpads 实现的是查找,而不是真正的记忆。论文借鉴了神经科学中的 Complementary Learning Systems 理论,指出完全建立在检索之上的代理会遇到一个可证明的泛化上限。
@eng_khairallah1 发布(53 个赞,50 次收藏)围绕 Sam Altman 的一句话“Your whole life should fit in one context window”展开讨论,将记忆视为代理本身,而不是代理附带的一个功能。
讨论洞察: @lindavivah 采访 Richmond Alake(Oracle AI DevEx 总监)区分了三门学科:“Context vs Memory vs Harness engineering”——他认为,memory engineering 应把长期记忆视为一等基础设施,而不是事后补上的能力。
与前一天对比: 5 月 1 日对 memory 的讨论主要还是从 harness 原语切入(create_agent 的 memory 支持)。到了 5 月 2 日,memory 被提升为一个独立的基础设施问题,拥有自己的研究(Memo 论文)、成本经济学(Mem0)和专用工具(SMFS)。
1.4 编码代理基准进入新范式 🡕
@omarsar0 分享(30 个赞,30 次收藏)介绍了一篇新论文,提出用“从零实现著名机器学习突破”来评估 coding agents。第一个案例是:Claude Opus 4.7 在消费级硬件上用 3 小时搭建出一个 AlphaZero 风格的 Connect Four 自博弈流水线,并作为先手在 8 局中赢下 Pascal Pons solver 的 7 局。其他测试过的前沿代理没有一个超过 2/8。

讨论洞察: @MindTheGapMTG 区分了研究型基准与生产型基准:“从零做 AlphaZero 测的是研究自主性。生产需要的恰恰相反:受约束的执行、严格限定的范围。对 solver 打出 7/8 很惊艳;但真正能上线的是:在一个平淡无奇的任务上重复 10K 次,还能保持 7/8 的可靠性。”
与前一天对比: 5 月 1 日提到的标准评估面还是 Terminal Bench 和 SWE-bench。到了 5 月 2 日,出现了一种根本不同的评估范式——代理能否端到端重建一个非平凡的机器学习系统?——评估门槛也从补丁和单元测试,转向自主研究工程能力。
1.5 语音代理出现明确市场领先者 🡒
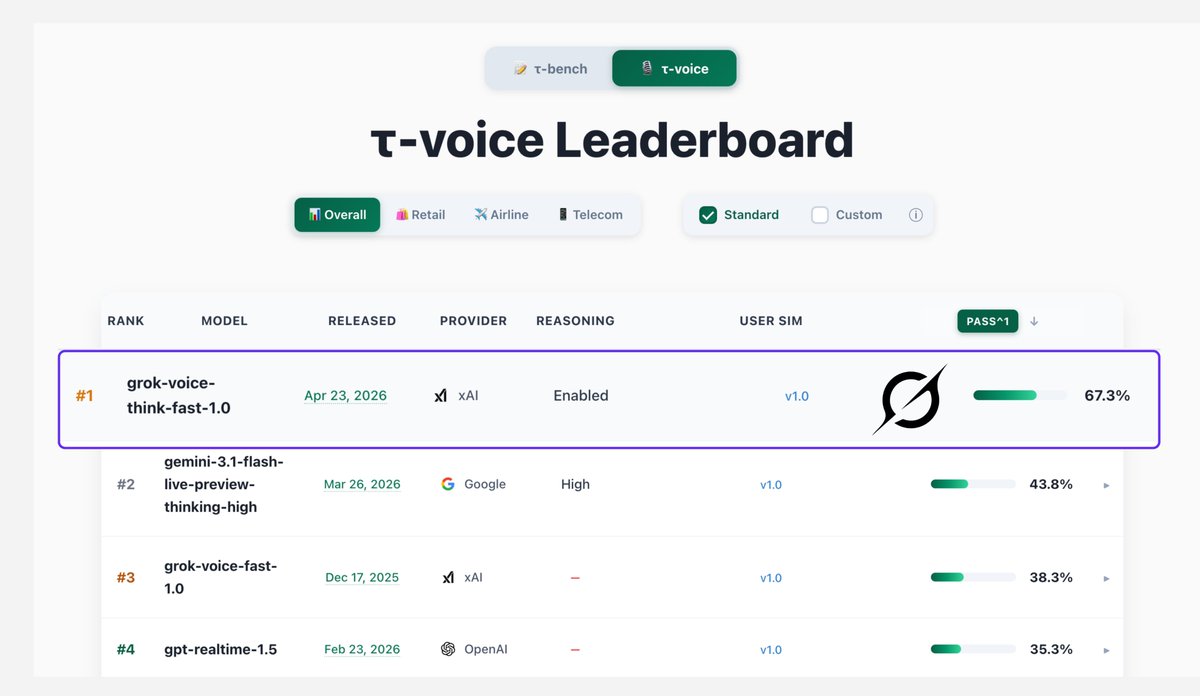
@XFreeze 报道(341 个赞,2.6M 次浏览)称,Grok Voice 在 tau-voice Bench 上得分 67.3%,而 Gemini 为 43.8%,GPT Realtime 为 35.3%。该基准对实时推理型语音代理进行排名。
@Saboo_Shubham_ 构建(27 个赞,34 次收藏)展示了一个面向保险理赔的开源语音 AI 代理,基于 Gemini 3.1 Flash Live + Google ADK,可实时填写受理表单、提取理赔信息,并将案件转交给理算员。
讨论洞察: @EloPhanto 点出了关键难点:“对理赔代理来说,难点不在演示里把表单填好——而在交接契约。什么样的置信度阈值才转给理算员、哪些字段缺失会阻止提交、以及代理如何解释自己的不确定性,这些都比语音层本身更重要。”
与前一天对比: 5 月 1 日的语音相关内容是 ElevenLabs voice skills。到了 5 月 2 日,我们既看到了基准格局(Grok 明显领先),也看到了实际部署场景(保险理赔),而讨论则表明:语音界面只是入场券,真正的难题在业务逻辑层。
1.6 多代理金融走向主流 🡕
@gusik4ever 发布(33 个赞,20 次收藏)列出了本周金融领域增长最快的 GitHub 仓库:
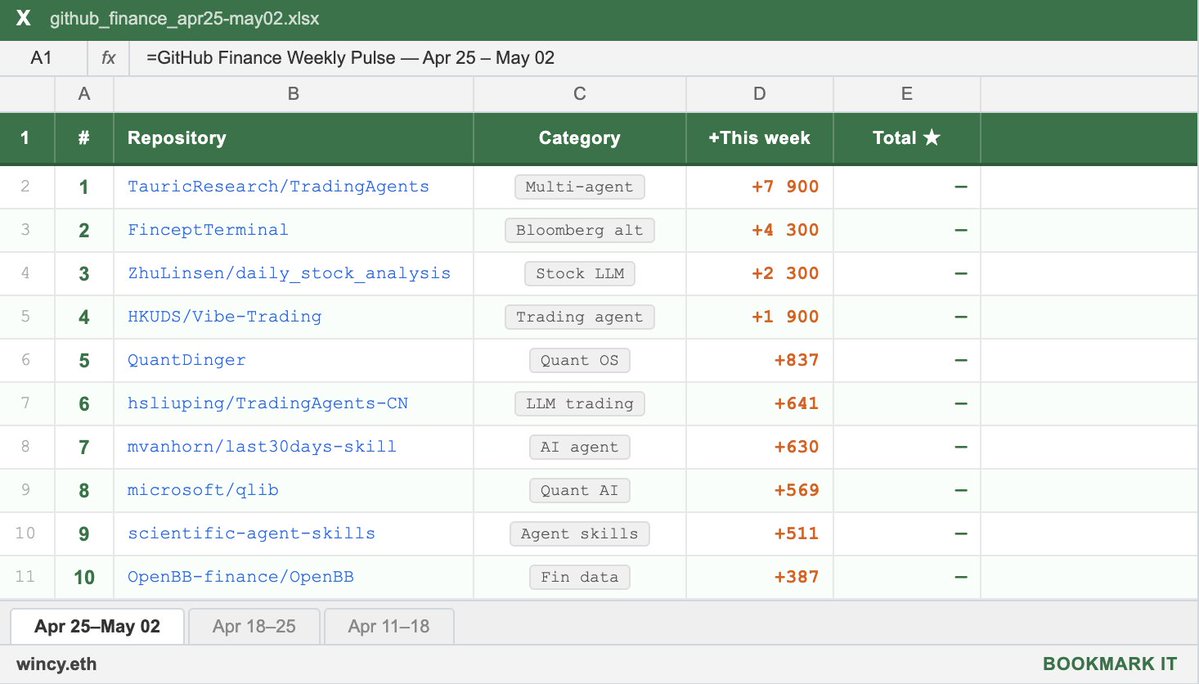
其中,TradingAgents(+7,900 stars)位居第一,这是一个来自 UCLA/MIT 的多代理 LLM 交易框架,包含 fundamental analyst、sentiment analyst、technicals 和 risk manager 等角色,并支持 DeepSeek V4 thinking-mode。FinceptTerminal(+4,300 stars)则提供了一个开源的 Bloomberg 替代方案,内含 37 个 AI 代理,采用 Buffett/Munger/Lynch/Graham 风格。
与前一天对比: 5 月 1 日时,TradingAgents 只有 +1.5K stars,同时也有批评者质疑“agent orchestration 是否真能带来优势”。到了 5 月 2 日,其 star 增长加速了 5 倍(+7.9K),说明怀疑声并未削弱市场兴趣。
2. 什么让大家感到挫败
Harness 知识衰减速度比学习速度还快 —— 严重程度:高
@drummatick 表达(19 个赞):“AI engineering 已经卷到这种程度了,我读一篇两个月前关于 harness 的博客,都觉得它已经过时了。” @DamiDefi 量化 进一步解释了这种衰减:“agent 领域每个季度都在变。你优化的 benchmark 已经被刷榜了。你刚掌握的 framework 已经成了 legacy。” harness 知识的生产速度与从业者的吸收速度之间,鸿沟正在拉大。多位教育者在同一天发布定义性内容,也说明这个领域的术语体系直到现在才开始稳定。
Agent trace 隐私会泄露一切 —— 严重程度:高
@MaziyarPanahi 记录(40 个赞,32 次收藏):“Agent traces 会泄露一切。邮件。API keys。patient IDs。support tickets。incident logs。” agent trace 正在成为可共享的工件(用于 evals、bug 报告、支持交接),但其中包含敏感数据。他的 openmed v1.3.0 会在分享前于本地对字段进行 mask/fake。@ewhauser 指出了缺口:这些模型需要获得“expert determination method”认证,医疗公司才会采用。
Orchestration 仍然得自己搭 —— 严重程度:中
@RhysSullivan 发布(67 个赞,92 次收藏)详细描述了一份“dream agent workflow”规范,涉及 Symphony、Diffity、Warden、Linear 和 Graphite——都是彼此独立、没有任何单一产品完成整合的工具。@ianlapham 推荐 的建议是:“直接为你的项目做一个专用 harness。” 前一天来自 @davidfowl 的挫败感(“Are we all doing this now?”)依然存在——Flue 虽然已经出现,但还很早期,从业者仍然默认选择自行拼装的方案。
3. 大家希望出现什么
真正会学习的 Agent Memory
《Contextual Agentic Memory》论文(来源)指出,当前的记忆系统(vector stores、RAG、scratchpads)实现的是查找,而不是真正的记忆。面对新任务时,它们存在“可证明的泛化上限”。从业者真正想要的是:能够把抽象规则泛化到从未见过的输入,而不只是检索相似案例的 memory。@DhravyaShah 的 SMFS 是一种尝试,瞄准的是成本/延迟问题;而 @Unibase_AI 的 Membase 则针对协作/共享状态问题。
紧迫性:高 —— 机会:基础设施
一体化的 Agent 开发工作流
@RhysSullivan(92 次收藏)详细描述了完整愿景:能把项目拆成 Linear tickets 的 skills、能显示运行中任务和 diffs 的 orchestrator、用于精修的本地 PR reviewer、anti-pattern enforcement、orchestrator/Linear/GitHub 之间的 backlinks,以及通过 Graphite 实现 stacked diffs。核心要求是:“你可以不用再 babysit agent runs。” 目前没有任何产品能端到端满足这一点。
紧迫性:高 —— 机会:产品
PII 安全的 Agent Trace 分享
@MaziyarPanahi(32 次收藏)已经为医疗场景发布了 openmed,但这类需求其实是通用的:agent traces 正在成为调试、评估和协作的主要工件,但它们同时包含凭证和 PII。@TommyFalkowski 提议:“做一个本地 key value store,这样回传时就能把伪造过的条目还原。” 完整方案需要支持导出时 mask/fake、重新导入时 unfake,并满足受监管行业的认证要求。
紧迫性:中 —— 机会:工具
4. 在用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Flue | Agent harness 框架 | (+) | 首个 harness 框架;运行时无关;虚拟与容器沙箱;TypeScript | 实验性;API 可能变动 |
| LangChain create_agent / Deep Agents | Agent 框架 | (+) | 可扩展原语;subagents、skills、memory、hooks;开源 | 生产使用仍需大量扩展 |
| AWS Strands Agent SDK v1.0 | Agent SDK | (+) | Zod schemas;streaming;MCP;内置 OpenTelemetry | 仅支持 TypeScript;新 |
| Google ADK + Gemini Enterprise | Agent 平台 | (+) | 长时间运行代理;Inbox command center;基于 LLM-as-a-judge 的异常检测 | GCP 专属 |
| GBrain | 个人代理大脑 | (+) | 自连接图谱;17K+ 页面;混合搜索;P@5 49%;34 个 skills;eval 系统 | 面向单用户设计;需要代理平台 |
| Hermes Agent v0.12 | 编码/通用代理 | (+) | Curator 每 7 天自动裁剪/评分 skills;通过 agent_control PR 支持多代理 | 社区驱动;Hermes 生态内使用 |
| OpenMed v1.3.0 | Agent trace 隐私 | (+) | 在分享 trace 前于本地 mask/fake PII;已确认用于医疗场景 | 企业采用需要认证 |
| AutoSkills | Skill 安装器 | (+) | 一条命令;检测技术栈;从 skills.sh 安装匹配 skills | 早期;依赖 skills.sh 目录 |
| SMFS | Agent memory | (+) | 可挂载抽象;同步索引;优化 token 与检索延迟 | 新;尚未证明可大规模使用 |
| Grok Voice | 语音代理 | (+) | tau-voice Bench 得分 67.3%;大幅领先竞品 | 仅限 xAI 平台 |
5. 大家在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| GBrain | @garrytan | 带自连接知识图谱和 34 个 skills 的个人 AI 大脑 | 个人代理缺乏结构化记忆 | OpenClaw/Hermes, PGLite, graph DB | 已发布(v0.25) | 帖子, GitHub |
| Voice Insurance Claims Agent | @Saboo_Shubham_ | 用于保险受理并转交理算员的语音 AI | 理赔处理依赖人工 | Gemini 3.1 Flash Live, Google ADK | 已发布(OSS) | 帖子 |
| Bug Hunter v3 | @VivekIntel | 采用 Hunter/Skeptic/Referee 流水线的对抗式代码审查 | AI 安全扫描误报 | Multi-agent, CVSS, CWE/STRIDE | 已发布 | 帖子 |
| Watchtower | @VivekIntel | 配有 Planner/Worker/Analyst 和 20+ 工具的 AI 渗透测试 | 手动渗透测试 | Multi-agent, SQLite, PDF reports | 已发布 | 帖子 |
| SMFS | @DhravyaShah | 用于 agent memory、带同步索引的可挂载文件系统抽象 | 文件系统记忆无法扩展到大规模 | Custom FS, indexer | Alpha | 帖子 |
| open-slide | @1weiho | 为代理打造的幻灯片框架——从 prompt 到精致 deck | 幻灯片制作依赖人工 | CLI, agent-native | 已发布 | 帖子 |
| Pi-Daytona Extension | @richardanaya | 用 Daytona sandbox 访问替换 Pi Coding Agent 的文件工具 | 代理中的不安全文件系统访问 | Pi agent, Daytona | 已发布 | 帖子 |
| Hermes agent_control | @DODOREACH | 基于 ACP 的多代理编排,面向持久化 Hermes profiles | 一次性 subagents 无法持久化 | Hermes Agent, ACP | PR open | 帖子 |
| Diff Viewer | @jeetnirnejak | 用于审查 coding agent 变更的组件,带动画效果 | 审查代理输出缺少打磨 | Figma, Motion | Demo | 帖子 |

6. 新动态与重点关注
GBrain:YC 总裁发布带基准图谱的个人代理大脑
@garrytan(YC President/CEO)开源(44 个赞,39 次收藏)发布了 GBrain——他的个人代理大脑,在一个自连接知识图谱中管理着 17,888 个页面、4,383 人、723 家公司。该系统在 12 天内构建完成,拥有 34 个 skills,可自主运行 21 个 cron jobs,摄取会议、邮件、tweets 和语音通话。基准结果为 P@5 49.1%、R@5 97.9%,比禁用图谱和 BM25+vector 基线高出 31+ 个点。这个代理甚至会在夜间自动维护并丰富知识图谱。
信号强度:[+++]
Coding Agent AlphaZero 基准确立新评估范式
一篇 新论文(arXiv:2604.25067,UChicago)论文提出,可通过要求 coding agents 自主重建著名机器学习突破来进行评估。Claude Opus 4.7 在消费级硬件上用 3 小时实现了 Connect Four 的 AlphaZero 自博弈系统,并在对阵 Pascal Pons solver 时赢下 7/8。其他前沿代理没有一个超过 2/8。它把评估重点从“能不能打补丁?”转向了“能不能端到端构建一个非平凡的机器学习系统?”
信号强度:[++]
“Memory is a Memo” 论文挑战 Agent Memory 的基础假设
一篇 来自 CUHK/Zhejiang 的论文(arXiv:2604.27707)论文指出,当前所有 agent memory systems(vector stores、RAG、scratchpads)实现的都是查找,而不是真正的记忆。借助 Complementary Learning Systems 理论,论文表明,仅基于检索的代理会遇到可证明的泛化上限,并且在结构上容易遭受持续性的 memory poisoning。论文呼吁将快速的 hippocampal storage 与缓慢的 neocortical weight consolidation 配对使用。
信号强度:[++]
AWS 发布完整 Agent Harness SDK v1.0
@awsdevelopers 发布(38 个赞,15 次收藏)发布了其 TypeScript agent SDK 1.0 版本,提供 Zod schemas、streaming、MCP 支持、多代理编排、会话持久化,以及内置 OpenTelemetry。提供方(Bedrock、OpenAI、Anthropic、Gemini)只需改一个配置即可切换。

信号强度:[+]
Google 推出 Agent 异常检测
@GoogleCloudTech 宣布(61 个赞,15 次收藏)在 Gemini Enterprise Agent Platform 中推出了 Agent Anomaly Detection,使用统计模型和 LLM-as-a-judge 框架实时标记异常推理。这代表着关注点从“model safety”转向“agent governance”——监控的是运行时行为,而不只是训练阶段的对齐。
信号强度:[+]
7. 机会在哪里
**+++] 个人智能体大脑基础设施** -- [@garrytan 已经证明了价值(17K 页面、21 个 cron jobs、可量化的检索质量),但这套方案需要相当高的技术能力。其模式——代理摄取所有个人数据、构建知识图谱、夜间自动维护、再用图谱增强检索来回答问题——是可复现的,但还没有产品化到非技术用户可直接使用的程度。前一天来自 @thegreatola 的“每月 $5-15 的个人 agent”模式是预算版;GBrain 则是高配版。两者之间的空白,就是产品机会所在。
**+++] 智能体轨迹隐私与 PII 管理** -- 智能体轨迹正成为主要的协作产物(评测、调试、交接),但也会泄露凭证和 PII。[@MaziyarPanahi 已为医疗场景发布 openmed;但通用方案(导出时 mask、重新导入时 unfake,并满足受监管行业认证)仍不存在。随着 traces 变得可共享,每个 agent 平台最终都需要这一能力。
**++] 一体化智能体开发工作流** -- [@RhysSullivan(92 次收藏)列出了完整愿望清单:ticket 拆解、orchestrator 可视化、本地审查、anti-pattern enforcement、stacked diffs。现在没有任何产品能端到端交付这一整套。Symphony、Diffity、Warden、Linear 和 Graphite 各自存在,但仍需手工胶合。第一个把它们整合成单一 agent 开发流程的产品,将抓住那些想“stop babysitting agent runs”的开发者。
[++] 超越检索的真正 agent memory —— “Memo, Not True Memory” 论文以及 SMFS/Membase 的发布都说明,当前基于检索的 memory 已触及天花板。机会在于构建能泛化(权重巩固、从经验中学习),而不只是回忆的 memory 基础设施。这个方向仍处研究阶段,但多个独立团队都释放出了明确的需求信号。
[+] Agent 安全工具(对抗式验证) —— Bug Hunter 的 Hunter/Skeptic/Referee 模式,以及 Watchtower 的 Planner/Worker/Analyst,都展示了多代理安全方案。共同洞察是:单一代理无法可靠地自我验证。对抗式多代理安全扫描正成为一个新兴类别,并且已有明确的从业者需求。
8. 要点总结
-
一人运营、用 5 台 Mac Mini 作为专职 AI 代理的公司声称,以每月 $115 的计算成本实现月入 $34k,拿下当天最高互动(74K 浏览,569 次收藏),展示了 harness engineering 的经济潜力。 该系统通过独立的 CLAUDE.md 文件实现严格的角色隔离——architect、coder、reviewer、tester、ops——并通过共享任务队列协作。(来源)
-
Harness engineering 的术语体系在一天之内迅速标准化:Matt Pocock 定义了 Model/Harness/Environment/Agent,多位教育者也同步发布定义性内容,说明这个领域已进入“给事物命名”的阶段。 这延续了 5 月 1 日的经验性验证,也意味着这门学科已准备好走向正式文档与课程体系。(来源)
-
一篇新论文指出,当前所有 agent memory(vector stores、RAG、scratchpads)实现的都是查找而非记忆,并存在可证明的泛化上限;与此同时,三个独立项目(SMFS、Membase、GBrain)正在推出彼此竞争的 memory 基础设施。 研究层面的批判与产品层面的发布正在汇合,这表明 memory engineering 正从一般性的 agent 工作中分离出来,成为一个独立的基础设施类别。(来源, 来源)
-
Claude Opus 4.7 在消费级硬件上用 3 小时从零构建出 AlphaZero 自博弈流水线,并以 7/8 击败 Pascal Pons solver,确立了一种新的 benchmark 范式:评估 coding agents 时,看的是其端到端实现机器学习系统的能力,而不是打补丁的能力。 其他前沿代理没有一个超过 2/8,说明在研究自主性层面存在显著能力差距。(来源)
-
Garry Tan(YC President)开源了 GBrain——他的个人代理大脑,内含 17,888 个页面和一个自连接知识图谱,P@5 达到 49.1%,比禁用图谱的基线高出 31+ 个点,表明个人代理基础设施在效果上已可量化地优于扁平检索。 共有 21 个 cron jobs 自主运行,用于摄取并维护图谱。(来源)
-
AWS 发布内置 OpenTelemetry 的 Strands Agent SDK v1.0,Grok Voice 以 67.3% 领先 tau-voice Bench(Gemini 为 43.8%),Google 也推出了 Agent Anomaly Detection,这些进展共同说明:agent 基础设施已经进入“无聊但关键的管道”阶段,此时 observability、governance 和 benchmarking 的重要性,已经超过单纯的 model 能力。(来源, 来源, 来源)