Twitter AI Agent - 2026-05-09
1. 人们在讨论什么
1.1 围绕智能体的控制平面正在成为产品本身 🡕
今天最强的主题是:AI 智能体的差异化,正在从底层模型的选择,转向包裹模型的那一层。大约十来篇高信号帖子都指出,真正的护城河在于控制框架、技能库、可观测性仪表盘、追踪格式和审查队列——这些组件让智能体更容易被引导、审计和复用。
@AMerchantmoh 认为 认为,开发者过度关注模型切换和多智能体编排,而真正需要的是“proper constraint topology”、上下文工程、提示词工程和验证。@asmah2107 制作了 也用更平和的语气表达了几乎相同的观点:一个配置了验证、记忆和严格工具访问控制的普通模型,会胜过一个没有护栏的更聪明模型。
@nikiforovall 展示了 展示了这种思路在产品中的样子:pi-kanban 是一个围绕 pi coding agent 的工作区,在同一个仪表盘中呈现会话、待办事项、子智能体和固定上下文。相关的 博文 说,这个工具会实时监视智能体会话文件;公开仓库则将其描述为一个面向会话、待办事项和可观测性的 Web 仪表盘,而不是另一个智能体运行时。
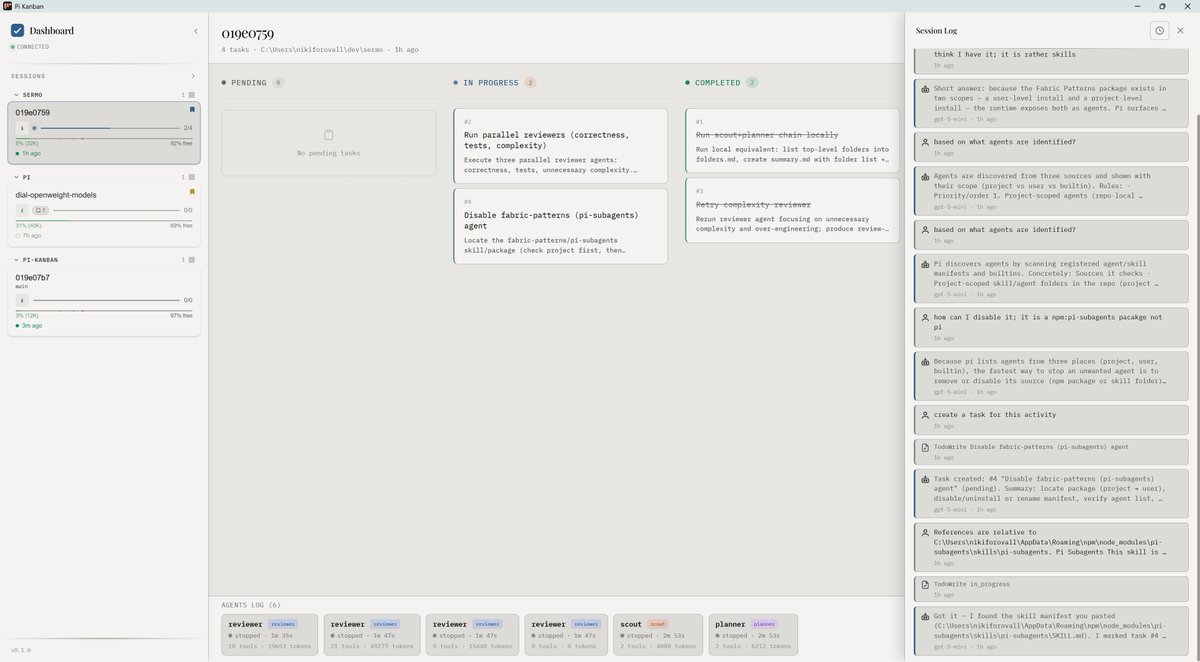
@MelkeyDev 介绍了 将 agent-tail.nvim 介绍为一个用于审查 Claude Code 修改的 Neovim 审查队列,公开的 仓库 则说,它无需 git、守护进程或 watcher,就能捕获逐事件的差异。@tom_doerr 指出 指向 awesome-claude-skills 仓库,而 @Voxyz_ai 分享了 则贴出一张 GitHub Trending 截图,其中 ruflo 位列榜首。这些都是对同一个问题的不同回答:团队需要的是围绕智能体的可复用技能、审查界面和编排层,而不只是更好的底层模型。
讨论洞察: @manthanguptaa 总结了 引用了 EntireHQ 的研究:近一半的智能体工具调用都与搜索相关,而更好的排序检索比单纯更快的 grep 更重要。实际讨论正从“选哪个模型?”转向“上下文是如何组装、排序、追踪和审查的?”
与前一天的对比: 5 月 8 日的观点是,用户依然想要一个简单的聊天界面,而真正的杠杆隐藏在上下文工程里。到 5 月 9 日,这个隐藏层已经以仪表盘、钩子、追踪规范和技能注册表的形式显现出来。
1.2 记忆与自我改进技能正在成为真正的差异化因素 🡕
第二个强势主题是:记忆不再是可有可无的加分项,而正在成为人们判断一个智能体在使用几天后是否依然好用的主要标准。
@hosseeb 表示 认为,Hermes Agent 跨会话的适应性明显强于 OpenClaw,后者“感觉像得了痴呆”。回复进一步点明了这为什么重要:一位用户说,跨会话连续性会让产品呈现出完全不同级别的体验;另一位则说,会话记忆决定了人们是否会在第三天之后继续使用某个智能体。
@banx0isme 提供了 提供了这批数据中最具体的自我改进案例。14 天内,一个基于 Hermes 的 Polymarket 智能体用自然语言重写了 8 个技能文件。作者称,这让每周提醒从大约 22 条降到 17 条,同时把“值得看”的提醒数量从大约 8 条提高到 13 条。关键不只是智能体变好了,更在于这种改进是沉淀在可编辑的技能文件里,而不是依赖重新部署流程。

@om_patel5 展示了 则从另一个角度展现了这种趋势带来的界面压力:Pokegents 是一个宝可梦风格的工作区,之所以被做出来,是因为在 tmux 窗格里管理大量 Claude 和 Codex 会话已经变得令人沮丧。帖子称,构建者加入了持久化智能体身份、会话克隆、MCP 消息传递和本地编排服务器。这与 pi-kanban 和 agent-tail 呈现的是同一种模式:构建者正在用连续性和监督界面把智能体包裹起来。
讨论洞察: 在与记忆相关的讨论中,反复出现的措辞并不是“更聪明”,而是“更少盯守”“更少误报”,以及智能体能保留有用状态,而不是逼着用户反复重新解释一切。
与前一天的对比: 5 月 8 日还只是把持久记忆视为本地智能体一个有吸引力的设计方向。到 5 月 9 日,它已经变成用户切换产品的直接理由、具体的质量指标,以及可量化的工作流收益来源。
1.3 语音正被视为下一层界面,而不是独立的智能体类别 🡕
语音是今天最明确的新界面主题。真正有意思的不是“AI 会说话”,而是构建者越来越把语音视为一个已经能在聊天里工作的智能体之外的一层薄封装。
@zarazhangrui 构建了 介绍了一个基于 OpenAI realtime 2 API 的 YouTube 实时副驾浏览器扩展。这个智能体会和用户一起观看视频,通过实时语音聊天回答刚刚讲过的内容;据帖子所述,它还能把 YouTube 音频流与用户自己的声音分离开来,避免把视频内容误当成命令来源。
@aiDotEngineer 将其定义为 直接点明了更大的趋势:2025 年是产品加入聊天智能体的一年,而语音显然是下一步,因为它更快、更易用,也能覆盖聊天触达不到的场景。配套幻灯片展示了一套 ElevenLabs 技术栈:轮次控制、语音转文本、文本转语音和打断处理,都是包在现有智能体及其集成之上的,而不是替换核心逻辑。

用户层面的产品诉求已经很明确。@VraserX 表示 说,他们最想要的升级是:带语音的 ChatGPT,再加上“真正的智能体模式”——能够浏览网页、控制电脑、管理文件,并真正把任务做完。
讨论洞察: 对这些实时与语音层帖子的回复,主要集中在延迟、自动暂停、打断质量和工具使用。需求并不是“让聊天机器人声音更好听”,而是给已经会行动的智能体配上一个口语界面。
与前一天的对比: 5 月 8 日几乎没有多少语音相关证据。到 5 月 9 日,语音已经成为现有智能体的一条清晰升级路径,而不是一个独立的新奇品类。
1.4 Web3 智能体构建者正在公开拼装身份、支付与执行基础设施 🡕
今天最嘈杂的一簇讨论围绕 Web3 和加密智能体展开。虽然其中很多内容带有宣传性质,但反复出现的组件非常一致:智能体身份、声誉、赞助、机器支付,以及受控执行。
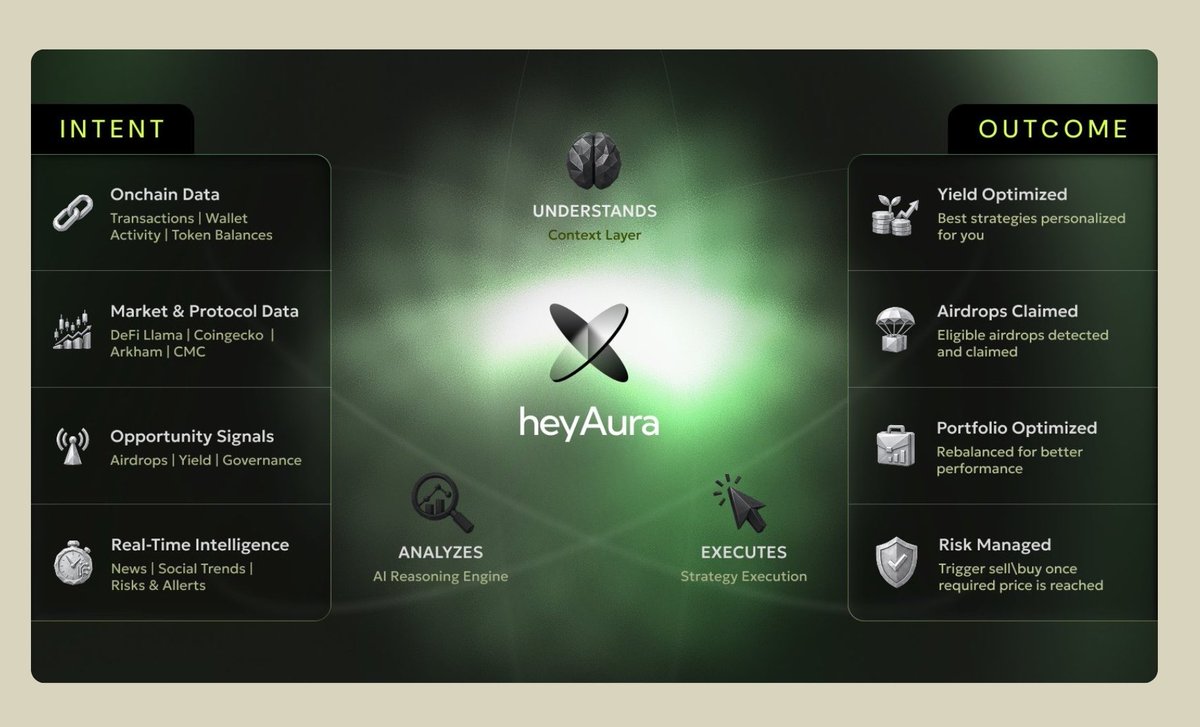
@ABWeb3_ 描述了 将 heyAura 描述为一个把手动 DeFi 研究转成自动执行的系统,并宣称拥有 17K+ 月活用户以及 $500M+ 的已分析钱包价值。附带的架构图显示,链上、市场、机会和实时情报输入共同流入上下文层与推理引擎,最后输出到收益、空投、投资组合操作和风险控制等执行环节。
@saidinfra 列出了 介绍了其所称已经在 SAID 上线的能力:3,000+ 个已验证智能体、质押加惩罚的经济安全机制、Merkle 锚定的行为证明、x402 支付,以及跨链 A2A 消息传递。@Crypto_Jayone 将其定义为 则把同一层概括为“Know Your Agent”,其 ERC-8004 技术栈由身份注册表、声誉注册表和赞助链接构成。@mpptestkit 补充说 聚焦支付侧,给出的路线图已经包括已发布的 TypeScript、Python 和 Go SDK,以及 AUTON beta。
讨论洞察: 与编码智能体工具相关讨论不同,这里的回复大多是在放大这些主张,而不是质疑它们。这本身就是一个信号:架构方向已经相当具体,但围绕真实部署质量的公开审视仍然偏少。
与前一天的对比: 5 月 8 日把市场和信任提升为正在形成的基础层。到 5 月 9 日,这个叙事已经被拆解为明确的基础设施:身份、赞助、机器支付、隔离执行和自主投资组合操作。
2. 什么让人沮丧
结构不好会导致工具层面来回折腾
最强烈的挫败感在于,人们总把模型切换、提示词反复重写和多智能体扩张,当成更好系统设计的替代品。@AMerchantmoh 说,真正的解决办法是约束拓扑、上下文工程和验证,而不是在不同 LLM 之间跳来跳去;@asmah2107 则说,控制框架是方向盘和刹车,不是可有可无的附加件。@manthanguptaa 进一步指出,在编码智能体里,真正的瓶颈是检索质量,而不只是搜索速度。严重程度:高。当前的应对方式是构建更强的控制框架和排序检索层;这看起来很值得直接做产品。
会话连续性依然太容易断掉
关于记忆的抱怨既直接又反复。@hosseeb 说 OpenClaw “感觉像得了痴呆”,回复则认为,跨会话连续性决定了一个智能体能否挺过新鲜感阶段。@banx0isme 展示了相反的案例:一个基于 Hermes 的工作流之所以变好,是因为智能体可以持续重写技能文件,而不是每次都把学习循环重置。严重程度:高。人们现在靠带持久记忆的智能体、技能文件和类似 pi-kanban 的仪表盘来缓解,但这个痛点依然活跃,也非常适合直接做产品来解决。
仍有太多高价值工作流起步于“标签页地狱”
一些最明确的痛点来自高度重复的操作循环。@mikefutia 把代理机构 SEO 描述为“打开 5 个 Ahrefs 标签页,导出 5 个 CSV,粘贴到 5 个 Google Docs”,随后构建了一个在 Claude Code 里跑这套循环的智能体;@ABWeb3_ 则用 DeFi 的话术表达了同样的不满:用户仍在手动追踪钱包、盯 CT 喊单,并自己跨链转移资金。严重程度:对于每周都在做这类工作的人来说非常高。当前的应对方式是把定制化的垂直智能体绑定到狭窄数据源上,这也使它成为另一个强烈的直接机会。
信任、授权和身份的默认机制依然薄弱
安全层面的抱怨正在变得更具体。@HGenng51023 说,大规模部署的阻碍是授权,而不是模型的原始能力;附带的 SUDP 基准测试还明确比较了 MCP Authorization 之类的密钥处理方案与更强的委托机制。与此同时,@saidinfra 和 @Crypto_Jayone 正在通过已验证智能体、证明、赞助链接和声誉层来补这些漏洞。严重程度:高。当前的应对策略是在事后加装证明、身份和额外验证层,因此这同样值得直接做。
3. 人们希望出现什么
自动生成技能与评估循环
最明确的“应该有人来做这个”的帖子来自 @ZypherHQ。它提出的问题是:是否应该有一个开源工具,能针对特定任务自动生成更强的提示词、技能和智能体文件。这个需求看起来很务实,而不是停留在愿景层面,因为 @banx0isme 已经展示了手动重写技能循环能创造多大价值——它可以减少误报、提升提醒质量。机会:直接。
用于同时监督多个智能体的共享工作区
pi-kanban、agent-tail.nvim 和 Pokegents 都指向同一个缺失层:一个可持久化的工作区,用来管理会话、差异、待办事项、子智能体和固定上下文。@bibryam 又把这个方向往前推进了一步,提出 Agent Trace——一个用于在版本控制代码库里记录 AI 贡献的开放规范。机会:直接。
真正能使用工具的语音优先智能体
这里的语音需求并不是“让聊天机器人会说话”。@VraserX 想要的是把语音、网页浏览、电脑控制和文件管理整合进一条工作流里;@aiDotEngineer 则认为,已经拥有可用聊天智能体的团队,其实离这个结果已经不远了。@zarazhangrui 则给出了最有说服力的概念验证:一个实时 YouTube 副驾。机会:直接。
身份、赞助和机器支付基础设施
Web3 智能体这一簇内容,本质上就是一份缺失基础设施清单。@saidinfra 在讨论已验证智能体、证明、x402 支付和跨链 A2A 消息;@Crypto_Jayone 把缺失部分概括为 KYA 身份;@mpptestkit 则直接在构建支付开发者层。这看起来更像竞争激烈的赛道,而不是完全空白的绿地,但需求本身很明确。机会:竞争型。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Hermes Agent | 开源智能体运行时 | (+) | 跨会话连续性强,支持自我改进技能,工具覆盖广 | 今天的公开证据仍主要是用户证言,而不是硬性的运营指标 |
| OpenClaw | 开源编码智能体 | (+/-) | 生态和集成较大 | 关于记忆连续性较弱、需要更多人工盯守的抱怨反复出现 |
| Claude Code | 编码智能体底层载体 | (+) | 强到足以支撑其上构建垂直智能体、技能包和审查工具 | 用户越来越需要第三方仪表盘、钩子和技能系统来管理复杂性 |
| pi-kanban | 可观测性工作区 | (+) | 在一个地方呈现会话、待办事项、子智能体和固定上下文 | 只读,且绑定于 pi coding agent 工作流 |
| agent-tail.nvim | 审查 / 审计插件 | (+) | 提供逐事件差异,不依赖 git,Neovim 工作流轻量 | 仍属实验性,仅支持 Claude,且作用范围限于单个会话 |
| awesome-claude-skills | 技能库 | (+) | 在调试、测试、架构、文档和安全等领域提供可复用、经过验证的技能 | 它是精选技能包,而不是自动技能生成或安全执行机制 |
| Agent Trace | 追踪 / 归因规范 | (+) | 让 AI 在存储、IDE、分析和日志系统中的贡献可被审计 | 仍停留在提案级规范,而不是已采用标准 |
| Voice Engine SDK / voice wrappers | 语音智能体层 | (+) | 无需重写智能体核心,就能加入语音、轮次控制和打断处理 | 延迟、自动暂停和工具使用体验仍未解决 |
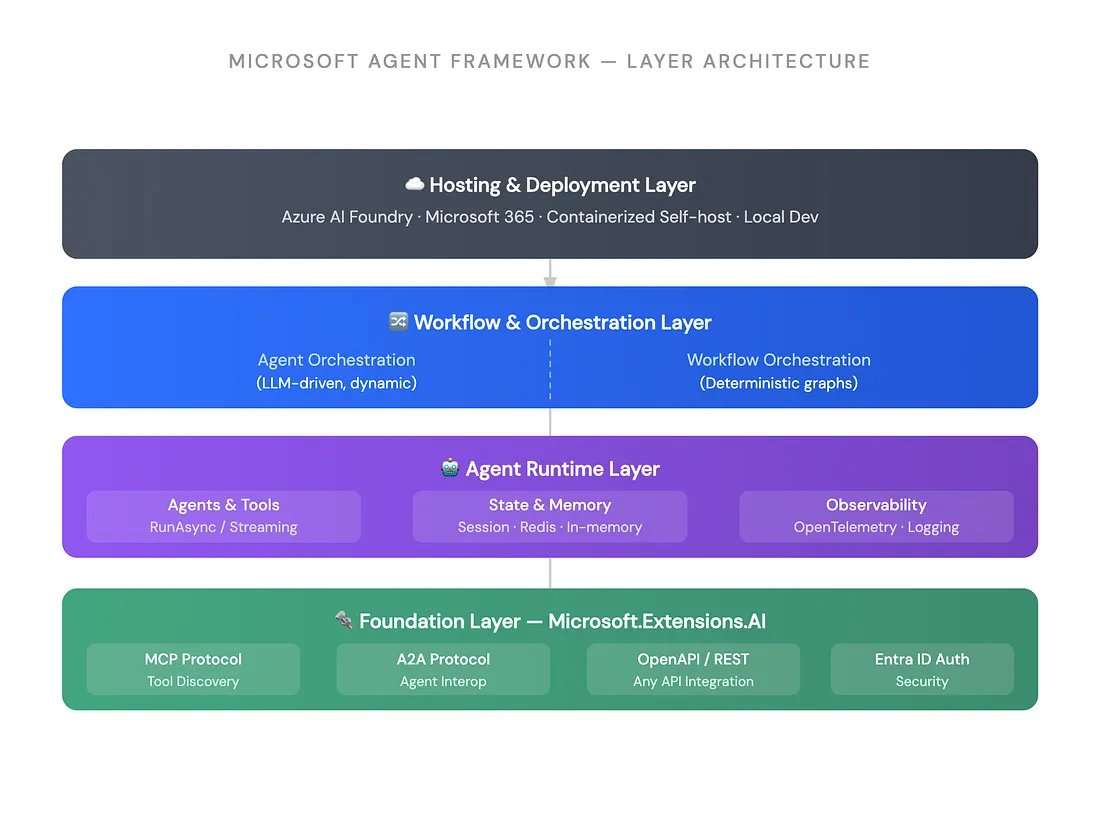
| Microsoft Agent Framework | 企业智能体框架 | (+) | 提供了涵盖编排、运行时、MCP、A2A 和遥测层的清晰参考架构 | 今天的证据更多停留在架构层面,而非大量部署案例 |
| OpenHarness | 开源控制框架 | (+) | 支持 MCP、多智能体协作、持久记忆和面向验证的设计 | 项目非常早期,目前几乎没有 traction 证据 |
| SAID / KYA identity rails | 身份 / 信任基础设施 | (+/-) | 提供已验证智能体、证明、赞助链接、声誉和支付钩子 | 仍然碎片化,且今天的证据带有较强宣传色彩 |
| MPP TestKit | 机器支付 | (+) | 已发布 SDK,并给出面向智能体集成的清晰路线图 | 仍属早期路线图,除构建者圈层外的真实采用情况不明 |
| heyAura | 自主 DeFi 智能体 | (+/-) | 通过多链上下文输入,把流程从建议推进到执行 | 公开证据偏产品导向,对对抗性审视着墨较少 |
总结: 当工具能减少监督负担时,满意度最高,这也是为什么今天 Hermes 式的连续性比模型原始能力获得了更多赞誉。最明显的迁移路径,是从裸智能体走向外围封装和交互界面:Claude Code 上面被叠加了技能库和审查工具,OpenClaw 用户被直接拿来与 Hermes 对比 和 聊天代理正在被套上一层语音 则是被包裹起来,而不是从头重建。竞争格局也在分化:编码智能体工具围绕技能、追踪、审查和可观测性聚集,而加密智能体工具则围绕身份、支付和受控执行聚集。
5. 人们在构建什么
| 项目 | 构建者 | 它做什么 | 解决什么问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| YouTube realtime copilot | @zarazhangrui | 与用户一起观看 YouTube 视频,并通过实时语音聊天回答问题 | 视频学习仍然高度依赖暂停、搜索和倒回 | 浏览器扩展、OpenAI Realtime 2 API | Alpha | 帖子 |
| Claude Code SEO agent | @mikefutia | 在 Claude Code 中执行关键词差距分析、竞品分析、内容起草和每周排名追踪 | 代理机构每周都在重复 Ahrefs、CSV 和文档工作流 | Claude Code、Google Search Console、Apify | Alpha | 帖子 |
| pi-kanban | @nikiforovall | 围绕 pi coding agent 提供一个展示会话、待办事项、子智能体和固定上下文的只读仪表盘 | 只靠终端开展的智能体工作难以监控、恢复和监督 | JavaScript、pi coding agent、基于文件监控的 Web 仪表盘 | Beta | 博客, 仓库, 帖子 |
| agent-tail.nvim | @MelkeyDev | 一个 Neovim 会话审查队列,展示 Claude Code 修改的逐事件差异 | 开发者需要一种低摩擦方式来审计智能体改动,而不增加额外仪式感 | Lua、Neovim、Claude Code 钩子集成 | Alpha | 仓库, 帖子 |
| OpenHarness | @abhishek__AI | 一个开源的 Claude Code 风格智能体框架,带有记忆和验证层 | 团队希望拥有自主智能体基础设施,而不依赖封闭产品 | Python、MCP、多智能体协作、持久记忆 | Alpha | 仓库, 帖子 |
| awesome-claude-skills | @tom_doerr / karanb192 | 一个公开的、覆盖调试、测试、文档和架构等场景的经过验证的 Claude 技能集合 | 用户总是在重复发明提示词和技能文件 | 面向 Claude Code、Claude.ai 和 API 用法的 Markdown 技能 | 已发布 | 仓库, 帖子 |
| MPP TestKit | @mpptestkit | 面向机器支付与智能体集成的 SDK 技术栈和协议路线图 | 智能体需要支付原语、生命周期回调和集成工具 | TypeScript、Python、Go SDK、AUTON beta | Beta | 帖子 |
| heyAura | @heyaura | 一个基于钱包、市场和机会上下文进行推理的自主 DeFi 执行智能体 | 手动 DeFi 研究和执行仍然依赖大量仪表盘,而且偏被动 | 多链数据摄取、上下文层、AI 推理、执行引擎 | 已发布 | 引用的帖子, 支持性帖子 |
今天构建者的大部分精力都落在两个桶里。一个桶是在编码智能体外面包上一层控制平面、审查界面、技能包和验证层:pi-kanban、agent-tail.nvim、OpenHarness 和 awesome-claude-skills 之所以存在,是因为底层智能体已经足够有用,以至于监督和复用正在变成独立的产品类别。
另一个桶是垂直执行。SEO 智能体和 heyAura 都从一个充满标签页、导出操作和人工决策的工作流出发,再把它压缩成一个更窄、带有真实运营数据的智能体循环。YouTube realtime copilot 介于这两个方向之间:它是一个具体构建,但也指向一个更广泛的界面转变——迈向口语化、具上下文感知能力的智能体。
6. 新动态与值得注意的内容
授权正被视为智能体系统的瓶颈
@HGenng51023 发布了 这是这批数据里最有实质内容、但讨论量不高的信号之一:一个围绕 SUDP 的四图帖子。SUDP 是一种面向智能体系统的密钥使用委托协议。配图包括论文截图、正式的 requester-authorizer-custodian 流程、安全模型对比,以及一张基准测试表,其中 SUDP Pro 得分为 8/8,而其他几种方案的结果明显弱得多。这很重要,因为它把扩展问题重新定义为授权与密钥处理问题,而不只是模型质量问题。

Microsoft 的四层智能体栈是一个很有用的公开参考模型
@adnan_hashmi 分享了 展示了一张 Microsoft Agent Framework 架构图,把托管与部署、编排、运行时和基础层放进同一张图里。这张图值得注意之处在于,它把 MCP、A2A、OpenAPI/REST、Entra ID、基于 Redis 的会话记忆和 OpenTelemetry 放进了同一套栈里,因此成为今天数据集中最清晰的企业级参考架构。
Agent Trace 暗示版本控制正在为 AI 来源追踪做准备
@bibryam 提出了 将 Agent Trace 描述为“an open specification for recording AI contributions alongside human authorship in version-controlled codebases.” 配图把智能体追踪路由到存储、IDE 或 CLI 视图、分析系统和审计日志中。值得注意的是,它把归因视为基础设施,而不是事后补丁。
7. 机会在哪里
[+++] 编码智能体的控制平面与审查界面 — pi-kanban、agent-tail.nvim、Pokegents、Agent Trace,以及更广泛的控制框架工程讨论,都指向同一个缺口:一旦智能体变得有用,团队就需要围绕它们建立监督、回放、可追踪性和可复用的工作区状态。这是最强的机会,因为痛点非常明确,而且多个构建者都在独立收敛到同一层。
[+++] 自主智能体的信任、授权与支付基础设施 — SUDP、SAID、KYA 和 MPP TestKit 分别切入同一个缺失栈的不同部分:密钥委托、已验证身份、赞助与声誉链接,以及机器支付。证据横跨研究、架构图和产品路线图,因此这已经不只是单线程叙事。
[++] 自动化技能生成与自我改进工具 — ZypherHQ 关于自动生成技能文件的请求、banx0isme 可量化的技能重写循环、OpenHarness 和 awesome-claude-skills,都在暗示市场需要一类能自动创建、测试、排序和维护技能的工具。需求很直接,但市场也可能很快拥挤起来。
[++] 面向已跑通聊天智能体的语音封装 — YouTube realtime copilot、ElevenLabs 的语音层表述,以及用户对“语音 + 真正的智能体模式”的直接需求,都说明很多团队不会从零重建智能体,而是会把语音作为界面层加上去。因此,相比从头做“语音智能体”,集成与延迟优化工具更有吸引力。
[+] 替代重复操作循环的垂直智能体 — SEO 智能体和 heyAura 展示了一种可复用模式:把一个有利可图但繁琐、充满标签页和决策的工作流,压缩成一个狭窄的智能体循环。上行空间很明确,但今天的证据仍主要由构建者主导,有时还带宣传色彩,因此这更像正在浮现的机会,而不是已经被充分验证的市场。
8. 要点
- 差异化正在从模型本身转向模型周围的控制层。 今天最强的一批帖子都在讨论约束拓扑、控制框架工程、仪表盘、审查队列和技能注册表;相比单纯比较模型,这已经是明显更偏运营层面的讨论。(约束拓扑, pi-kanban)
- 记忆连续性是当前用户最容易感知的智能体质量测试。 Hermes 与 OpenClaw 的讨论,核心在于系统能否跨会话适应;而 banx0isme 的帖子则表明,可编辑的技能记忆能够带来可量化的工作流收益。(Hermes 对比 OpenClaw, 自我重写技能)
- 语音正被视为对已能工作的智能体的界面升级,而不是一套独立栈。 实时 YouTube 副驾和 ElevenLabs 的语音层表述,都默认智能体逻辑已经存在,下一步只是用语音、轮次控制和实时上下文把它包起来。(实时 copilot, 语音层)
- 加密智能体栈正在围绕身份、支付和受控执行形成标准化,但大多数公开证据仍停留在架构层面。 SAID、KYA、MPP TestKit 和 SUDP 都描述了真实的栈组件,但当前讨论里依然是架构图和路线图多于长期运营证明。(SAID, KYA, MPP TestKit, SUDP)