Twitter AI 智能体 - 2026-05-10
1. 人们在讨论什么
1.1 Harness engineering 正在固化为智能体基础设施的总称 🡕
最明显的变化同时发生在语言和架构层面:人们谈论的重点越来越少是某个单一模型,越来越多是围绕模型构建的 harness。多篇高信号帖子都认为,决定智能体质量的真正来源是检索、记忆、编排、可观测性和执行管线,而不只是提示词措辞。
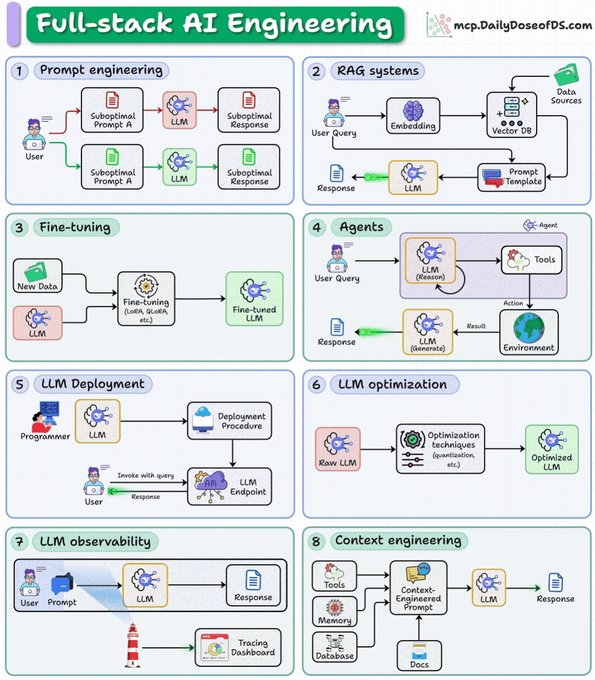
@morganlinton 力挺 发起了一条关于“harness engineering”的讨论串,@ghumare64 表示 则表示,Addy Osmani 的调研之所以重要,是因为领先的编程智能体正在收敛到同一种模式:真正的护城河是上下文、工具、记忆和编排。@_avichawla 分享了 分享了一份“全栈 AI 工程”路线图,明确将提示词工程、RAG、微调、智能体、部署、优化、可观测性和上下文工程放进同一栈中。@hasantoxr 补充了 还整理了一份“harness engineering”仓库清单,把 Harness、PostHog、GrowthBook、Chaos Mesh 和 Kubescape 归入同一运维层。
同样的主题也延伸到了工作流内部。@omarsar0 强调了 提到了 AAFLOW 论文;论文指出,agentic RAG 管线的时间通常不是耗在 LLM 调用本身,而是耗在序列化和协调上。相关的 论文 报告称,基于零拷贝 Arrow/Cylon 数据平面,管线整体最高可提速 4.64 倍,嵌入和 upsert 阶段可提升 2.8 倍。@aiDotEngineer 发布了 则从工具侧提出了同样的论点,把上下文工程概括为“80% 是 agentic search”,并引导读者关注一场研讨会,讨论 shell 工具、语义搜索和通用查询执行各自会在什么场景下失效。

讨论洞察: 回复和相邻帖子显示,人们仍在摸索这套词汇,但方向已经很明确。争论的重点不再是上下文是否重要,而是团队能否把检索、批处理和编排做得足够可复现,从而不再过度聚焦提示词微调。
与前一天对比: 5 月 9 日强调的是,智能体周围的控制平面才是真正的产品。到了 5 月 10 日,这一点被扩展成一门更完整的实践:有了命名清晰的技术栈、阅读清单、仓库组合,以及明确的数据平面性能主张。
1.2 由智能体编写的产品正推动开发者转向更轻的技术栈和更严格的约定 🡕
另一个强烈主题是,团队正在努力缩小智能体需要管理的表面积。相比赞美越来越庞大的应用框架,最务实的帖子更偏向简单的浏览器原语、更强的配方,以及能让 AI 输出更容易审查和约束的脚手架。
@ctatedev 表示 认为,对于完全由智能体编写的前端,开发者或许应该从 index.html、浏览器原语、Web Components 和严格约定入手,而不是一套重量级框架。回复也在推动同样的方向:有人说自己最近已经弃用了 NextJS 和 React,也有人认为,本地 markdown 文件加内联 CSS/JS 反而比更复杂的技术栈更容易让智能体掌控。@shadcn 表示 表示,他的路线图现在优先考虑更好的智能体集成,以及更适合智能体的 shadcn/skills;回复中则有人要求支持 Claude Design,也有人希望提供可复用的组件组合配方,避免浪费上下文。
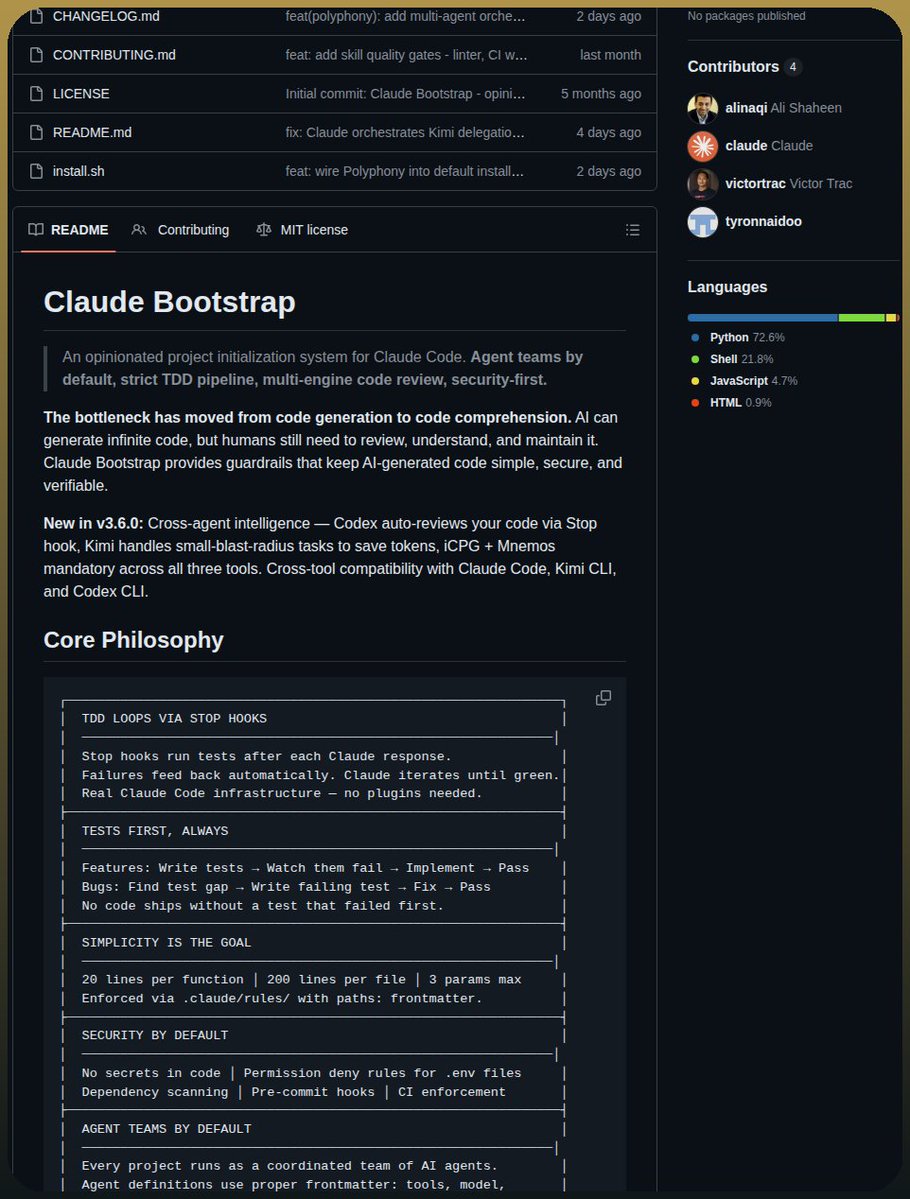
这种倾向同样出现在脚手架层面,而不只是 UI 层。@tom_doerr 分享了 展示了一套 Claude Code 配置,并指向 Claude Bootstrap;其 README 描述了 TDD stop hooks、默认安全规则,以及默认启用的智能体团队。该仓库后来演进为“Maggy”,但核心主张并没有变:让 AI 编码工作流更可预测、更易审查,也更容易跨工具迁移。@mikefutia 展示了 则展示了这类脚手架在垂直工作流中的价值:在 Claude Code 内为 DTC SEO 客户自动完成关键词缺口分析、竞品分析、内容起草和每周汇报。
讨论洞察: 这些回复的重要之处在于,它们不是只为演示效果叫好,而是反复回到可审查性、自定义模式,以及如何减少智能体一次要处理的上下文量。“对智能体友好”越来越意味着“足够轻,便于推理”。
与前一天对比: 5 月 9 日更关注编程智能体外围的仪表盘、审查队列和编排界面。到了 5 月 10 日,这些讨论进一步转化为直接的技术栈建议:更轻的前端、可复用的组件配方,以及更严格、面向 TDD 的脚手架。
1.3 记忆、技能与技能分发正在从提示词技巧变成可复用资产 🡕
第三个主题是,有用的智能体行为正在被外置到持久化文件、配置档案和目录层中。开发者越来越把工作产出理解为:不仅是智能体给出的答案,更包括它为下一次运行留下的技能、记忆或共享上下文。
@garrytan 介绍了 把这种模式称为“代码即记忆”:第一次运行负责调研并写出脚本,之后的运行只需要执行它。@kevincodex 表示 表示,一次通宵运行的 OpenClaude 会话生成了一个新的“智能体记忆文件系统”概念;他据此认为,这个时代需要的是新的原语,而不是更多提示词调优。@owenbjennings 预告了 将 Mongoose 描述为构建在 Goose OSS 之上的云端多智能体编排系统,可共享来自网页、日历、Slack、电子邮件和文档的上下文,从而让一个持久存在的“AI 员工团队”能持续跟踪不同界面上的动态。
围绕技能的分发层也在不断增厚。@exploraX_ 推广了 提到了一个拥有“70k+”智能体技能的开源市场,@kevinkern 表示 表示他做了一个工具,只提取你真正需要的那一小段技能,@RoundtableSpace 指出了 则指向 Awesome Opencode 仓库,把 Opencode 的插件、主题、智能体和资源集中整理在一起。即便是与 Hermes 相关的帖子,也符合这一模式:@IMJustinBrooke 表示 表示,Hermes 的不同 profile 都可以携带各自的规则、训练和技能;而 @Teknium 表示 提到,Hermes 早已把 Anthropic 的 banker skills 移植到了自己的可选 skillsets 中。
讨论洞察: 反复出现的价值主张并不是“我的智能体更聪明”,而是“我的智能体会记住、能复用既有流程,并且只加载恰到好处的能力,而不用把整个工作流重新搭一遍”。围绕 Mongoose 和 Opencode 目录的回复,都在强调上下文连续性和能力发现。
与前一天对比: 5 月 9 日已经把记忆视为差异化因素。到了 5 月 10 日,这一思路从单一产品功能扩展为一种生态模式,涵盖记忆文件、配置档案、市场、目录仓库和选择性技能检索。
1.4 治理与智能体安全正在成为明确的产品层 🡕
安全和治理正在更靠近讨论中心。最强的帖子不再只是笼统提醒风险,而是指向了可用于大规模部署智能体的具体界面、基准和预算控制机制。
@googlecloud 宣布了 将 Gemini Enterprise 中的 Agent Gateway 描述为一个集中管理点,用于处理网络策略、数据访问和提示词注入防护。相关的 Google Cloud 博文 表示,Gemini Enterprise 正在增加一个智能体平台,内置可复用技能、长时间运行的智能体、收件箱式管理、可观测性和治理功能。@Dinosn 链接到 Agent Security Bench,其仓库描述的是针对 LLM 智能体的攻击与防御基准,覆盖 10 种场景,包括直接提示词注入、观测提示词注入、plan-of-thought 后门,以及记忆投毒。@Crypto_Jayone 发布了 则从 Web3 角度讨论了同一类问题,提出面向自治机器的“Know Your Agent”身份基础设施。

成本控制也是同一主题的一部分。@MichaelThiessen 转发并评论了 转发了 @levie 的一篇长文,文中认为,随着智能体承担更长时长的工作、企业需要看清支出流向,token 预算会成为重要的组织级问题。这意味着,智能体治理不仅是安全策略,也包括预算、可审计性,以及对数字劳动力的集中控制。
讨论洞察: 共同主线是可追踪性。无论受众是企业 IT 还是加密智能体开发者,诉求都是一样的:身份、策略、可观测性和控制必须存在于平台层,而不是最后临时包一层。
与前一天对比: 5 月 9 日主要通过加密智能体相关帖子呈现信任与身份轨道。到了 5 月 10 日,这一主题被扩展为企业网关、正式攻击基准和 token 预算管理。
2. 什么让人沮丧
编排和数据管线仍然比模型调用本身更耗时间
最一致的技术性挫败感在于,智能体管线的瓶颈依然是 LLM 周围的一切。@omarsar0 直接指出,真正拖慢 agentic RAG 管线的是序列化开销、分布式服务协调,以及预处理与嵌入之间的交接;相关的 AAFLOW paper 也说明,其性能提升来自数据流优化,而不是模型加速。@DataScienceDojo 把“上下文管线”本身定义为关键架构,@aiDotEngineer 则把上下文工程界定为主要是搜索和工具选择。严重程度:高。目前的应对方式是投资于批处理、检索、审查闭环和运行时工程,而不是假设只靠模型升级就能挽救工作流。
智能体编写的应用仍在与厚重的前端栈和脆弱的 Web 界面较劲
@ctatedev 最直接地提出了这一抱怨:如果避免重量级框架、坚持浏览器原语和清晰约定,智能体编写前端的效果往往更好。回复也印证了这一点,不少人提到已经放弃 NextJS 和 React,转向更轻的方案。在数据采集侧,@aaliya_va 表示,大多数抓取器都会被反爬系统或简单的页面布局变化击穿,并推荐 Scrapling 作为避免反复重写选择器的一种方法。严重程度:高。人们目前的做法是简化应用架构、采用自适应抓取层,这也使其成为一个很明显的构建方向。
治理、攻击测试和支出可见性仍然落后于智能体能力
安全层面的挫败感已经不再抽象。@googlecloud 明确在推销 Agent Gateway 和 Model Armor,作为防范提示词注入和访问失控的手段;这本身就说明企业已经感觉自己暴露在风险之下。@Dinosn 之所以链接 ASB,正是因为人们需要更正式的智能体攻击覆盖,包括记忆投毒和观测层攻击。@MichaelThiessen 放大了 @levie 关于 token 预算的观点,因为长时间运行的智能体正在带来新的支出分配可见性问题。严重程度:高。当前的补救方式,是事后再给智能体加上网关、基准和预算控制;这看起来仍然不完整。
重复性的运营循环依然显而易见,却自动化不足
这种挫败既现实,也技术化。@mikefutia 描述了典型的 SEO 代理循环:5 个 Ahrefs 标签页、5 次 CSV 导出、5 份 Google Docs、作者 brief,然后下个月再来一遍;随后,他做了一个 Claude Code 智能体,把整套流程压缩进一个系统。这里的痛点并不是人们想不到怎么自动化,而是很多行业里仍有显而易见的高摩擦循环,等着有人把它们打包成工作流。严重程度:中高。这个方向看起来很值得直接去做。
3. 人们希望出现什么
轻量、智能体优先的应用约定
围绕 @ctatedev 的前端讨论、@shadcn 下对智能体集成的请求,以及 Claude Bootstrap 脚手架,都指向同一个缺失的标准:一套默认更轻、专为智能体编写和审查设计的应用栈。这不是推测性的需求,而是现实需求,因为人们已经在放弃更重的框架,或者发明自己的本地约定。机会:直接。
可复用的记忆与技能打包,以及精确检索
Mongoose、Hermes profiles、代码即记忆、70k 技能市场,以及 Kevin Kern 提取单一技能片段的工具,都在明确表达同一种需求。人们希望工作流能不断积累,而不是每次运行都重置;但他们也希望是选择性检索,而不是塞进巨大而混杂的提示词块。Awesome Opencode 和一些产品专有的技能系统提供了部分答案,但这一通用模式仍未定型。机会:直接。
面向智能体身份、策略和支出的托管治理
Agent Gateway、ASB、KYA 以及 token 预算讨论,从不同角度描绘的是同一个缺失层。团队希望智能体拥有清晰身份、权限边界、提示词注入防御、预算可见性和审计轨迹。这件事之所以紧迫,是因为长时间运行的智能体已经被定位为可持续数小时乃至数天的企业工作流。机会:直接。
更快、更可复现的智能体工作流数据平面
AAFLOW 之所以突出,在于它针对的是一个具体的系统问题,而不是又一层提示词抽象。帖子和论文都表明,开发者希望智能体运行时能以通信高效、可复现的方式处理检索/推理/记忆管线,而不必让每个团队都自己手搓编排层。这看起来比从零切入的空间更偏竞争性,但需求本身非常具体,也很技术化。机会:竞争型。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪倾向 | 优势 | 局限 |
|---|---|---|---|---|
| Harness engineering / context engineering | 方法 | (+) | 为检索、记忆、编排、可观测性和执行提供了一套共同词汇,避免把过多精力押在提示词上 | 概念仍然很宽,不同帖子、课程和仓库清单中的理解并不一致 |
| AAFLOW | 智能体运行时 / 数据平面 | (+) | 使用 Apache Arrow 和 Cylon 降低序列化开销;论文报告称管线整体最高提速 4.64 倍,嵌入和 upsert 阶段提升 2.8 倍 | 仍是研究阶段成果,数据集中关于实际部署的证据有限 |
| shadcn/skills + Claude Bootstrap | 智能体开发脚手架 | (+) | 推动可复用、对智能体友好的配方,包含 TDD stop hooks、安全默认项和协同多智能体工作流 | 仍绑定于特定工具生态,也受限于早期社区约定 |
| Hermes Agent | 智能体运行时 | (+/-) | 支持多 profile、可选 skillsets,且围绕可复用技能与记忆有明显势头 | 此处大多数证据来自社区证言和生态讨论,而非中立的生产指标 |
| Awesome Opencode / skill marketplaces | 技能目录 / 分发 | (+) | 加速发现插件、主题、智能体和可复用能力,减少从零重建 | 目录规模或 star 数并不保证质量、匹配度或长期维护 |
| Scrapling | Web 提取 / MCP 工具 | (+) | 自适应选择器、抗反爬姿态、并发抓取和 MCP 集成,有望在模型调用前先提供更干净的上下文 | 基准和抗反爬主张很吸引人,但今天证据中的大规模真实世界验证仍偏薄弱 |
| Gemini Enterprise 中的 Agent Gateway | 治理 / 安全 | (+) | 为企业智能体集中管理网络策略、数据访问、护栏和模型筛查 | 属于托管式 Google Cloud 产品,而不是可移植标准;最适合企业买家 |
| Agent Security Bench (ASB) | 安全基准 | (+) | 将 10 种智能体场景下的攻击和防御形式化,包括提示词注入和记忆投毒 | 适合做评估,但本身并不解决运行时安全或策略执行 |
| KYA identity rails | 智能体身份 / 信任基础设施 | (+/-) | 明确化自治智能体的机器身份、赞助方关联和声誉 | 当前公开证据更能说明其框架价值,而非广泛部署后的实际质量 |
总结: 最强的正向情绪集中在那些能让智能体更易于引导、观测和复用的方法与工具上。整体迁移方向,正在从以提示词为中心,转向以基础设施为中心:搜索、记忆、轻量 UI 层、技能加载、网关和基准。竞争格局也在分化成两条线:一条是面向智能体开发者的开源工具,一条是面向企业的托管治理层。
5. 人们正在构建什么
| 项目 | 构建者 | 它做什么 | 解决什么问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Claude Code SEO agent | @mikefutia | 为 DTC SEO 工作自动执行关键词缺口分析、竞品分析、品牌语气内容生成和每周排名循环 | 代理机构每周仍在执行重复、标签页密集的 SEO 操作 | Claude Code, Google Search Console, Apify | Alpha | 帖子 |
| Mongoose | @owenbjennings | 提供云端多智能体编排,共享来自网页、日历、Slack、电子邮件和文档的上下文 | 助手通常会丢失跨界面上下文,无法像持久化员工那样行动 | Goose OSS, 共享上下文编排, 记忆累积 | Alpha | 帖子 |
| Maggy / Claude Bootstrap | alinaqi | 将 Claude Code 配置转变为带有 stop hooks、智能体团队和跨工具同步的受控自主工程工作流 | AI 生成代码需要更强的审查、TDD 和安全默认项 | Python, shell, JavaScript, stop hooks, 智能体定义, 跨工具配置 | Beta | 仓库, 帖子 |
| Gemini Enterprise Agent Gateway | @googlecloud | 为企业智能体增加集中网关、Model Armor、技能、收件箱管理和可观测性 | 长时间运行的智能体需要托管式策略、可追踪性和安全的工具访问 | Gemini Enterprise Agent Platform, Agent Gateway, Model Armor | Beta | 博客, 帖子 |
| AAFLOW | Sarker et al. | 为检索、推理和记忆工作流提供带零拷贝数据平面的分布式运行时 | Agentic RAG 系统把时间耗在序列化和协调开销上 | Apache Arrow, Cylon, 异步批处理 | Alpha | 论文, 帖子 |
| Agent Security Bench | AGI Research | 对多种场景中的 LLM 智能体攻击与防御进行基准测试 | 开发者缺乏对提示词注入、记忆投毒及相关攻击的系统化评估 | 基于 AIOS 的攻击/评估框架 | Beta | 仓库, 帖子 |
今天这批构建者大致聚成三种模式。第一类是在为智能体开发本身构建控制平面和脚手架,比如 Claude Bootstrap、Mongoose,以及与 Awesome Opencode 相邻的目录。第二类是在做垂直领域操作员式产品,比如 Mike Futia 的 SEO 智能体,其优势在于把一个重复性的行业循环压缩掉。第三类则在搭治理与系统基础设施——网关、安全基准和分布式运行时——因为部署层面的痛点已经具体到无法忽视。
6. 新鲜且值得关注的内容
Harness engineering 正在成为共享框架,而不再只是小众说法
多篇彼此独立的帖子都把“harness engineering”或“context engineering”视为智能体质量的核心,而且支撑这一框架的不是某条孤立的热帖,而是仓库清单、路线图、研讨会和转推评论。这一点值得注意,因为它说明这个类别正在稳定为开发者之间的共同语言。(morganlinton, ghumare64, avichawla)
企业级智能体管理正在快速产品化
Google Cloud 的 Agent Gateway 公告之所以值得关注,是因为它把长时间运行的智能体、可复用技能、收件箱管理、治理和 Model Armor 打包成了一个统一的企业叙事。这比一次单独的模型发布更有信号意义,因为它把智能体视为一套运营系统,必须在业务工作流中被追踪、管理和保护。(博客, 帖子)
技能发现正在变成独立的工具层
技能市场帖子、Kevin Kern 的选择性技能工具,以及 Awesome Opencode 仓库,都指向同一个新类别:帮助智能体发现、加载和复用能力,而不是逼用户每次从头重建。“70k+”这个数字本身没那么重要,更重要的是:分发和策展已经成为可见的产品层。(市场帖文, 选择性工具, Awesome Opencode)
7. 机会在哪里
**[+++] 面向上下文、记忆与执行的智能体控制平面 ** — harness engineering 这一簇讨论、Mongoose、Claude Bootstrap 以及“代码即记忆”的话题,都指向同一个需求:更好的产品,用于组装上下文、协调智能体,并在多次运行之间保留可复用流程。
**[++] 面向智能体的应用与提取工具 ** — ctatedev 关于轻前端的论点、shadcn 的智能体集成路线图,以及 Scrapling 的自适应抓取主张,都表明今天的框架和 Web 界面仍在给智能体制造不必要的摩擦。
**[++] 面向自主工作的治理、安全与支出管理 ** — Agent Gateway、ASB、KYA 以及 Levie 对 token 预算的表述,都表明安全、策略和成本控制正在成为一等部署要求。
**[+] 技能发现与选择性能力加载 ** — 技能市场、目录和选择性技能工具说明,围绕可复用能力模块的打包与路由正在形成增长中的市场,同时避免用无关上下文淹没智能体。
8. 要点
- 重心已经从提示词转向基础设施。 5 月 10 日最重要的帖子讨论的是 harness engineering、上下文管线、agentic search 和数据平面瓶颈,而不是原始模型对比。(morganlinton, omarsar0, aiDotEngineer)
- 开发者正在简化技术栈,同时把可复用知识外置。 轻量前端约定、TDD 脚手架、代码即记忆、技能市场和基于 profile 的智能体,都指向同一种运行模式:先让环境更容易被智能体理解和操作,再把有效的部分持久化以供复用。(ctatedev, tom_doerr, garrytan, RoundtableSpace)
- 治理正在成为产品的一部分,而不是事后补充。 Google 的 Agent Gateway、ASB、KYA 和 token 预算讨论都表明,身份、策略、攻击测试和支出可见性已经成为评估智能体平台时的核心维度。(googlecloud, ASB, Crypto_Jayone, MichaelThiessen)