Twitter AI Agent - 2026-05-12
1. 人们在讨论什么
1.1 Harness engineering 正在沉淀为一门有名称、可教授的学科 🡕
当天最强的信号,是 “harness engineering” 持续从一句吸睛口号,逐步凝练为一套结构化知识体系,已经出现了文章、思维导图、课程大纲和从业者清单。这不是某一条爆款帖子带起来的,而是多个账号协同放大 @addyosmani 关于 harness engineering 的文章,并各自补上一层内容。
@akshay_pachaar 发布了当天互动最高的帖子(97,031 次浏览、2,664 次收藏),将提示缓存与语义缓存的权衡、大规模 KV 缓存管理、结构化输出回退链、评测、按功能归因成本、智能体护栏与循环预算、LLM 可观测性、模型路由,以及何时微调,列为必修内容(帖子链接)。@0xNeoArch 在回复中补充了提示注入防御、从大模型轨迹蒸馏模型,以及“知道什么时候不该用 LLM”,认为这些同样不可或缺。另一条回复则指出:“harness 占了系统的 95%;提示词反而是最容易的部分。”
@MindBranches 把 @addyosmani 的文章整理成了一份完整的 4K 明暗双版本思维导图,并引用了原帖(8,434 次浏览、110 次收藏)(帖子链接)。两张图都足够细致,本身就可以作为独立参考资料使用。

@dishantwt_ 还挖出一个结构化课程网站,标题为“学习 Harness Engineering”(7,842 次浏览、252 次收藏)。课程包含的讲题包括:为什么能力很强的智能体仍然会失败、Harness 到底是什么、为什么代码仓库必须成为事实记录系统、为什么一个巨型指令文件会失效、为什么长时运行任务会丢失连续性,以及为什么功能列表是 harness 的原语(帖子链接)。该课程将 OpenAI 的 Codex harness engineering 指南和 Anthropic 关于长时运行智能体有效 harness 的文档列为主要参考资料。
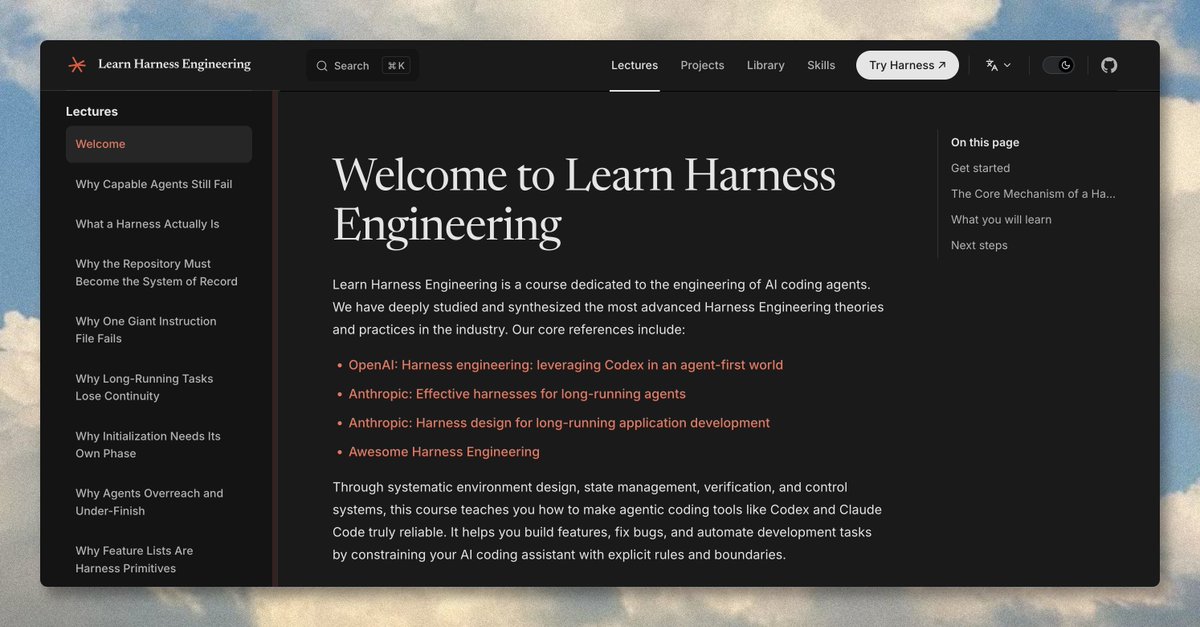
讨论洞察: 几乎没有人反对 harness 这一框架本身。若有质疑,主要也集中在要求给出具体实现案例,而不是停留在抽象分类上。这个领域对框架本身已基本达成共识,缺的是落地实现。
与前一天对比: 5 月 11 日,harness engineering 还只是一个社区标签;到 5 月 12 日,它已经进入结构化教育资源阶段,并出现了文章摘要的可视化版本。讨论焦点已经从“它是什么”转向“去哪里学”。
1.2 Context engineering 正在取代 prompt engineering,成为首要优化目标 🡒
另一组并行出现的帖子认为,普通 AI 用户与专家级用户之间的生产力差距,如今已不再是智力水平或提示词质量,而是他们维护了多少持久化上下文。相关常用词汇包括:AGENTS.md、CLAUDE.md、soul.md、品牌上下文文件、品味文件。
@NainsiDwiv50980 将这一转变概括为:“提示词工程已经成了新版‘学会更快打字’。”他对比了普通用户(使用泛化的角色提示词)与高阶用户:后者会把品牌语气存进 .md 文件,保存自己不喜欢的输出示例,并建立可复用的上下文文件夹(908 次浏览、34 次转发)(帖子链接)。@DamiDefi 也向 11,237 次浏览的受众表达了同样的观点:“在糟糕上下文里的完美提示词,产出的仍然是泛化结果;而在优质上下文里的简单提示词,几乎可以胜过一切。”(帖子链接)
@oliverwhudson 介绍了其团队如何不是靠改进提示词,而是靠建设上下文基础设施,每月产出 6,000 条广告——包括品牌上下文、领域上下文、Claude Skills 路由逻辑、参考文件系统、Notion MCP 集成和质量门禁。他们的报告技能每月可为每位创意策略师节省两天时间,而推理轨迹会记录每一次策略决策,使系统随时间持续积累能力(1,529 次浏览、34 次收藏)(帖子链接)。
@mark_k 则指出了更深层的问题:AI 仍然要求用户不断把自己的意图翻译成机器友好的指令,而真正的突破口,是一种界面——人们可以直接说、展示、指、打断、纠正,而不必为了机器重新组织自己的想法(4,554 次浏览、47 条回复)(帖子链接)。他还在回复中预测,未来会是由 AI 针对当前任务动态生成 UI。
讨论洞察: 最有实质内容的回复,把“上下文”这一主题进一步延伸到了工具层:Obsidian vault、N8N 工作流、CLAUDE.md 文件和多智能体记忆存储,都被视为实际实现方式。模式非常一致——持久化、机器可读的上下文文件会不断复利,而临时拼接的提示词最终会触顶。
与前一天对比: 5 月 11 日,上下文工程还只是 harness 清单中的一项;到 5 月 12 日,它已经成为最强的独立主题,从业者开始分享具体的文件化工作流和生产力数据。
1.3 Circle Agent Stack 为智能体推出可由机器支付的金融基础设施 🡕
Circle 发布了 Circle Agent Stack——面向智能体的金融基础设施,核心包括 Agent Wallets(可在多条区块链上持有并交易 USDC 和其他代币)、Agent Marketplace(可发现并按请求为 x402 服务付费,无需 API 密钥)以及 Circle CLI(面向智能体、具备确定性的编排工具,可与 Claude Code、Cursor、Codex 和 OpenClaw 集成)。仅公告帖本身就获得了 60,679 次浏览,并被 CoinMarketCap(16,217 次浏览)、Milk Road、作为发布合作伙伴的 QuickNode,以及多位 DeFi 评论者进一步放大。
@circle 宣布(332 次点赞、74 次转发、30 条回复、60,679 次浏览)称,Agent Wallets 可以持有和转移 USDC,Agent Marketplace 让智能体能够发现服务,而 Circle CLI 则能在既定权限范围内执行可重复的金融操作。Circle 的开发者文档确认,智能体无需订阅或 API 密钥,即可进行最低至 $0.000001 的免 gas USDC 纳支付;该 CLI 还可直接接入任何兼容 OpenAI 或 Claude Code 的工作流。
@CoinMarketCap 报道(175 次点赞、38 次转发、47 条回复、16,217 次浏览)也对这次发布进行了介绍。CoinMarketCap 受众的回复褒贬不一:@TravelerOfCode 认为智能体钱包是后续一切能力的使能层;而 @somi_ai 则提出了一个尖锐担忧——“如果智能体被越狱,向随机地址打款,链上支付是追不回来的。”@AgentPays_app 补充说,真正困难的不是区块链机制本身,而是如何让欺诈检测与支出控制系统把智能体识别为可信执行者,而不是威胁信号。
@MilkRoad 指出(10 次点赞、4 次转发、2,873 次浏览)指出,当前已有 $77B 的 USDC 在流通(同比增长 28%),CRCL 在公告当天收涨 16%,较前一个月上涨约 50%。Milk Road 引用了 @RaoulGMI 的话:“对智能体来说,只要更快、更高效、更便宜,它根本不在乎这是协议代币还是美元代币。”
讨论洞察: 围绕 Circle 的回复,持续聚焦在编排与策略层,而不是钱包本身。共识性的担忧是:如果要让智能体可信地执行自主金融交易,必须先有支出控制、速率限制和抗越狱能力。
与前一天对比: 5 月 11 日讨论的还是 Circle marketplace 视角下的智能体服务与定价;5 月 12 日则是正式发布日,开发者文档、演示以及媒体放大传播都已到位。
1.4 Hermes Agent 正在巩固其作为个人开发者首选 harness 的地位 🡒
多条独立帖子都在称赞 Hermes Agent 是适合个人和小团队的实用 harness,而且给出了真实部署细节,超出了前一天那种更抽象的背书。
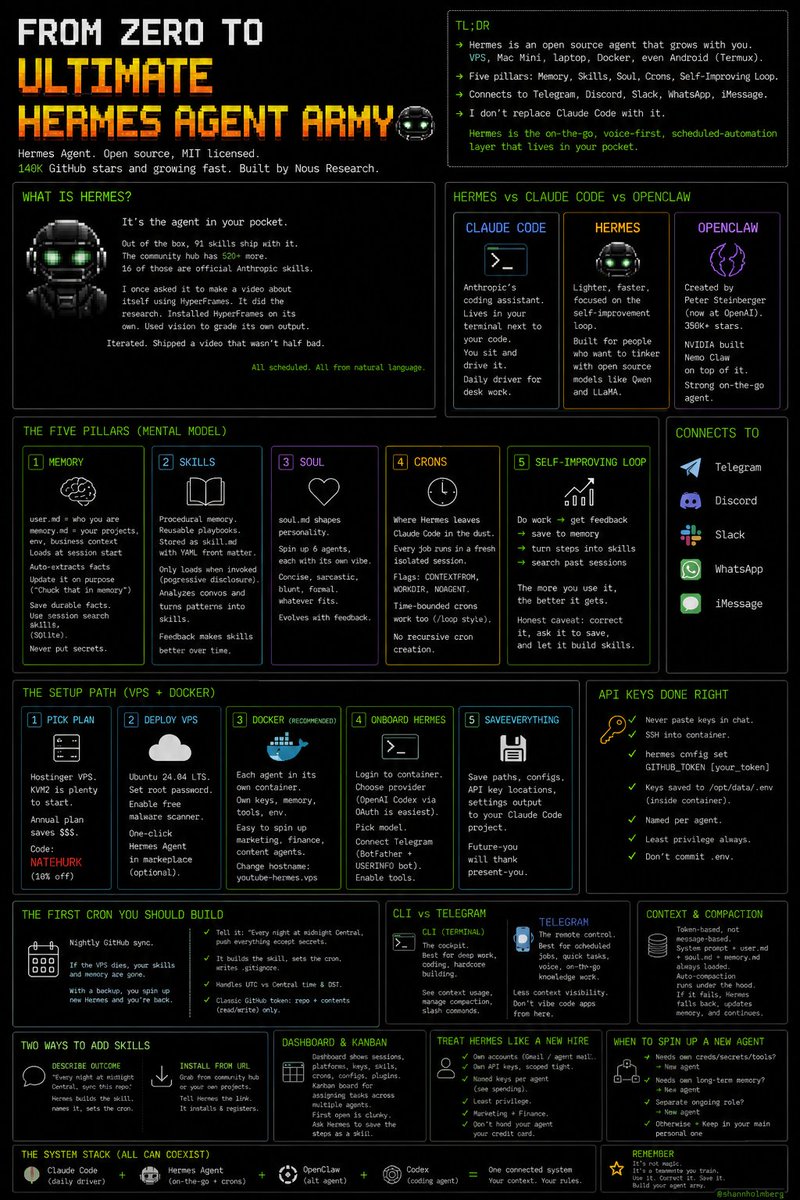
@shannholmberg 分享(78 次点赞、14 次转发、3,959 次浏览、51 次收藏)总结了 Hermes 为何是当前杠杆最高的智能体框架:能按复杂度与成本路由任务、能跨会话持久保留记忆而不需要用户反复重建,并且打通的是整条技术栈,而不是单一工具。附带的信息图——“从零到终极 Hermes Agent 军团”——是当天发布的 Hermes 生态最完整可视化总览。
@gregisenberg 分享了一门完整的 47 分钟课程(55 次点赞、7 次转发、2,404 次浏览、82 次收藏)介绍了如何单枪匹马搭建一家托管式 AI 智能体业务。技术栈包括:Hermes Agent 作为智能体 harness,Codex 或 Claude Code 用于构建与配置,Orgo 提供云 VM(每个智能体一个独立沙箱),Composio 提供数千款应用的一键认证,Agent Mail 提供每个智能体专属邮箱,Obsidian 则作为知识库。模型选择方面,主任务使用 GPT 5.5,低成本任务使用 ZAI 的 GLM 5.1。商业模式则是按 $5k/月提供托管式智能体服务,让客户完全不必考虑 token 或模型。@gao035 在回复中说:“智能体在演示里能跑。智能体在生产里能跑。两者的差别 = 错误处理基础设施。”
@hasantoxr 宣布(109 次点赞、11,891 次浏览)表示,SureThing 在 LongMemEval 上达到了 SOTA:总体准确率 88.0%、知识更新 91.0%、单会话偏好 76.7%——涵盖了每一个关键类别;他还说,自己以前给智能体构建的每一层记忆模块,都准备换成它。
讨论洞察: @shannholmberg 的信息图揭示了社区非正式形成的 Claude Code、Hermes 与 OpenClaw 定位:Claude Code 用于日常编码工作(Anthropic 的主力驾驶位),Hermes 用于移动场景、自我改进和语音优先层,OpenClaw(350K+ stars)则是基于 NVIDIA Nemo Claw 的替代型智能体。社区呈现出的不是竞争关系,而是互补关系。
与前一天对比: 5 月 11 日重点在于 Hermes 的实时执行轨迹与可观测性;到 5 月 12 日,讨论转向了采用模式、其上层构建的商业模式,以及底层技术的记忆基准。
1.5 Skills 获得厂商第一方支持,并出现市场化入口 🡕
Skills 这一层正从社区贡献清单,走向由厂商亲自编写、类似应用商店目录的形态:Obsidian CEO 亲自发布了五个官方智能体技能,另一个号称拥有超过一百万条目的技能市场也已上线。
@dr_cintas 报道(67 次点赞、15 次转发、3,258 次浏览、84 次收藏)表示,Obsidian CEO 亲自为自家应用编写了五个官方智能体技能:obsidian-markdown(wikilinks、callouts、embeds、frontmatter)、obsidian-bases(带筛选、公式、聚合的数据视图)、json-canvas(与笔记相连的可视化画布)、obsidian-cli(在终端中搜索、创建、管理任务),以及 defuddle(把任意网页清洗成干净的 Markdown)。这五个技能均采用 MIT 许可证,并可与 Claude Code、Codex CLI 和 OpenCode 配合使用。
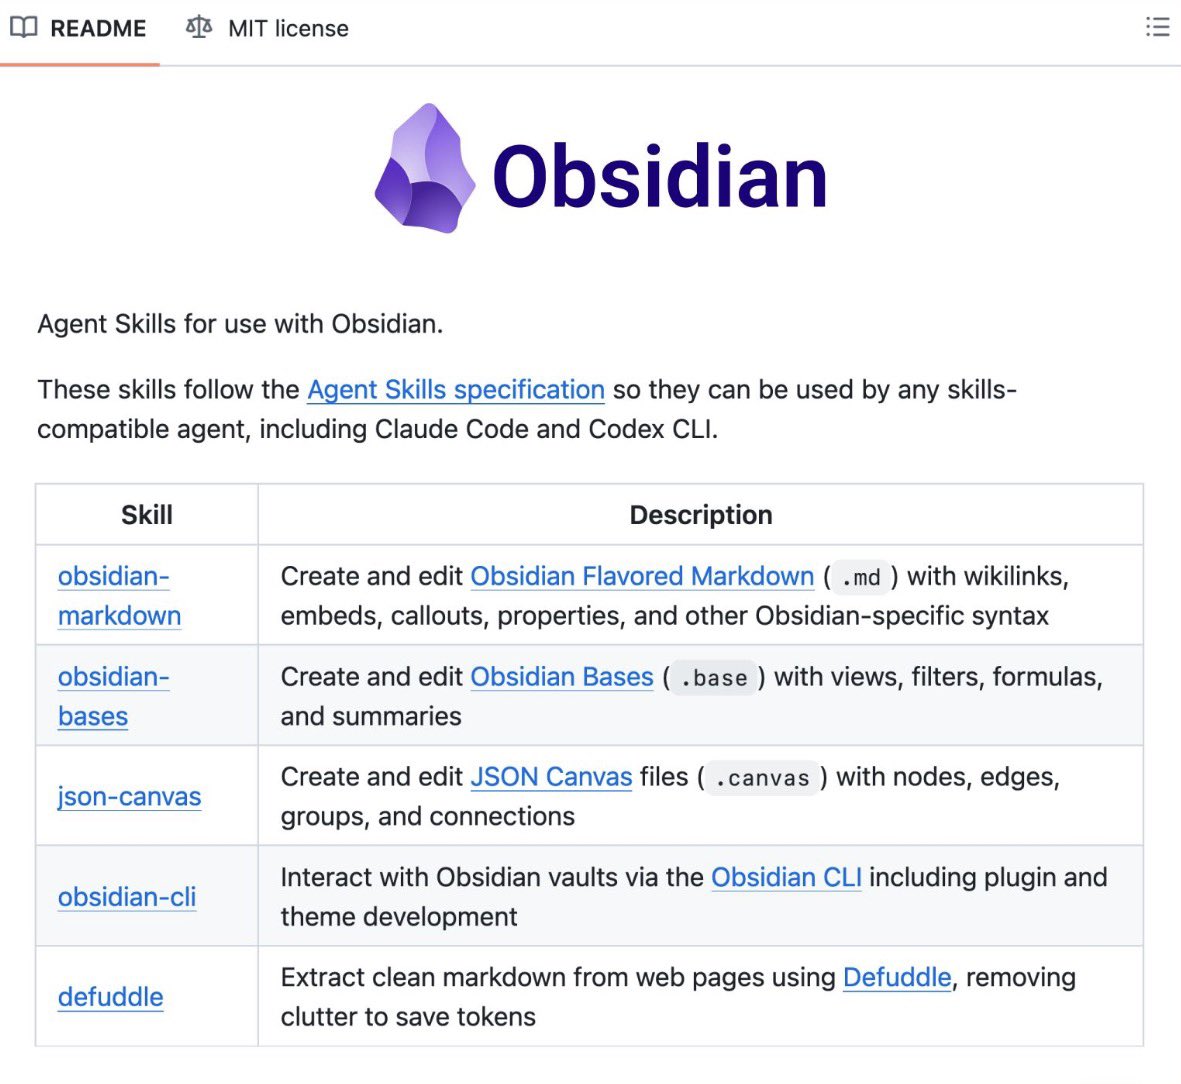
@StartupPrac_In 回复说:“能把任意网页清洗成 Markdown 的 defuddle,才是那个低调但特别有用的技能。智能体把网页内容拉进 Obsidian 时,格式噪声一直很乱。这个技能一下就去掉了一个每天都会碰到的摩擦点。”
@milesdeutscher 推广(57 次点赞、90 次收藏、4,167 次浏览)将 skillsmp.com 描述为拥有超过一百万个可直接使用的智能体技能和插件。回复里则有人提出质疑:@LordDr8ke 要求看到真正能跑的案例,而不是屏幕录制式演示。
@termix_ai 宣布(27 次点赞、5 次转发、5,171 次浏览)表示,TermiX Agent Skills 已在 OpenClaw ClawHub 上线,可用于自主智能体工作流中的技能发现与协同。
讨论洞察: 这一主题最明显的张力,在于承诺与现实之间的落差:一边是“上百万技能、可组合经济”的愿景,另一边是回复中对真实案例的强烈要求。相比之下,由 Obsidian CEO 编写的厂商官方技能,因为带有第一方背书,可信度更高。
与前一天对比: 5 月 11 日讨论的是用于从 Notion 同步技能的 notion-skills 工具,以及 AutoSkill 基于经验的技能提取;到 5 月 12 日,则新增了厂商官方技能和市场化入口——供给侧基础设施正从多个方向开始落地。
1.6 多智能体系统在量化结果上超过单模型基线 🡕
5 月 12 日分享了两项基准结果,为多智能体优势提供了硬数字:DeepMind 的 Co-Mathematician 登顶 FrontierMath 排行榜,Artificial Analysis 则发布了首个语音智能体 agentic 表现基准。
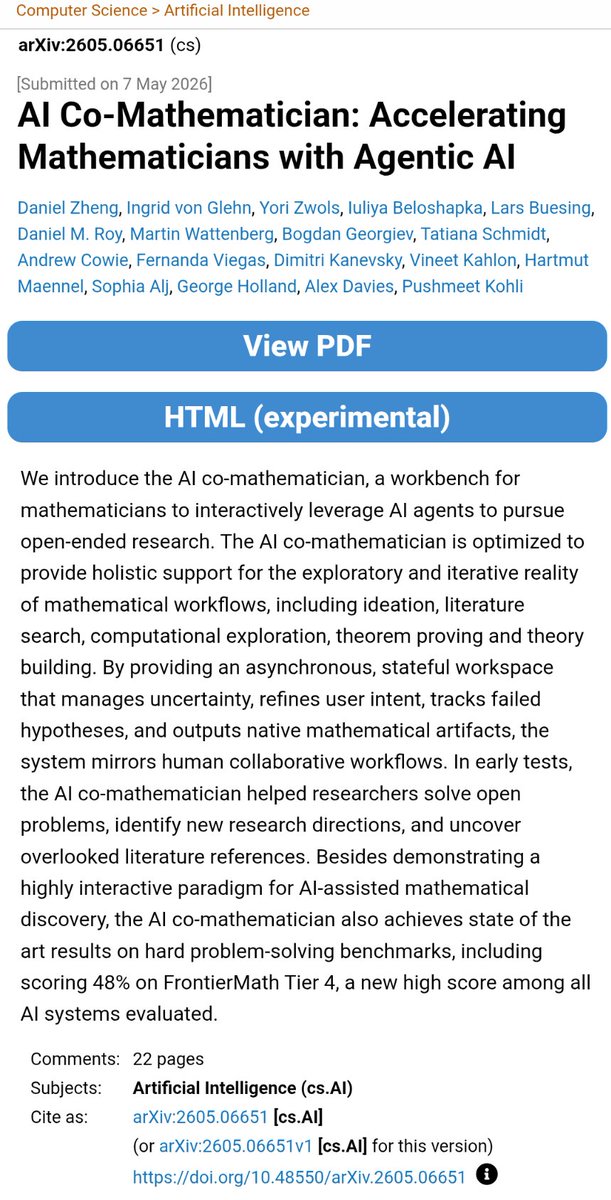
@hsu_steve 总结(38 次点赞、5 次转发、2,812 次浏览)介绍了 Google DeepMind 的 AI Co-Mathematician:Gemini 3.1 Pro 单独在 FrontierMath Tier 4 上得到 19%;多智能体框架(文献检索 + 代码执行 + 迭代验证循环)再增加 28.9 个百分点,达到 47.9%,超过 GPT-5.5 Pro(XHigh)的 39.6% 和 Claude 4.7 Opus 的 22.9%。该系统每题最多可获得 48 小时的异步计算,而 OpenAI 模型则是在标准 web harness 上接受测试。

@ArtificialAnlys 宣布(100 次点赞、7 次转发、5,221 次浏览、16 次收藏)介绍了一项基于 tau-Voice 的语音智能体 agentic 基准,用于在真实客服场景中测试语音到语音模型。关键结果是:即便最强的模型 Grok Voice Think Fast 1.0,端到端解决率也只有 52.1%,也就是只解决了大约一半场景。GPT-Realtime-2(High)得分 39.8%,Gemini 3.1 Flash Live Preview High 得分 37.7%,其余模型均低于 40%。该基准涵盖航空、零售和电信三大领域的 278 个场景,并纳入了多种口音、背景噪声,以及按照真实条件建模的丢包情况。
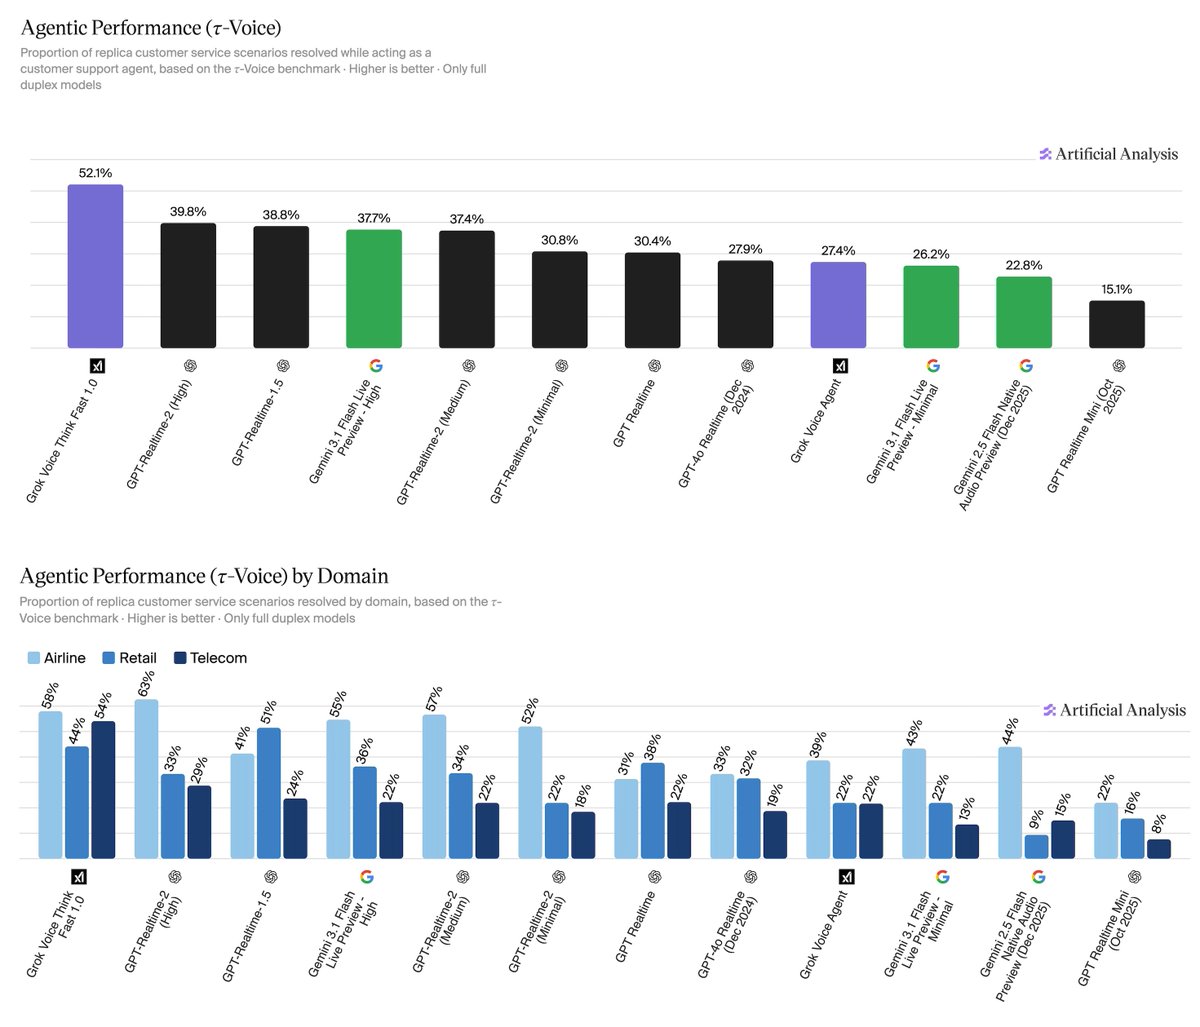
讨论洞察: Co-Mathematician 的结果在信息流中几乎没有引发实质性质疑——虽然有人提到其测试方法是“异步计算 vs 标准 harness”,但并未对这一方法提出反对。语音基准同样没有引发争议;它的价值在于给出了一个明确的能力上限。
与前一天对比: 5 月 11 日,TradingAgents(多智能体交易公司,73.7K GitHub stars)还只是一个构建者信号;到 5 月 12 日,则新增了两项同行评审基准结果,分别在研究场景和生产场景(语音)确认了多智能体优势。
2. 什么让人感到沮丧
Harness 的复杂性仍然是主要成本中心
最主要的挫败感——而且与前几天一致——是模型能力的提升,并没有降低 harness 的工程负担。@akshay_pachaar 点出了十项必备能力,并把每一项都视为独立学科;一条回复又补了三项。多种说法指向的实际结论是:如今用智能体做开发,已经需要与构建生产级 ML 系统一样的工程深度,包括缓存策略、可观测性、回退链和成本归因,而这些都不会因为模型更强就自动消失。严重程度:高。除了一项项把这些能力补齐之外,没有观察到其他解决办法。
从演示到生产的鸿沟,本质上是错误处理基础设施
@gao035(在回复 @gregisenberg 时,帖子链接)写道:“没人讨论的差距:智能体在演示里能工作 ✅。智能体在生产里不能工作 ❌。差别 = 错误处理基础设施。”这条回复虽短,却尖锐地概括了一个系统性抱怨。严重程度:高。@gregisenberg 提到的应对方式包括:监控网关崩溃的 watchdog、失败后的自动恢复,以及在 cron 作业出错时给你发邮件的智能体。
长会话场景下,上下文管理仍然会在规模扩大后失效
@aiDotEngineer 带出的层级记忆讨论提到,Arize AI 的 Sally-Ann Delucia 构建了一个智能体,它必须分析自己生成的轨迹数据;随着会话变长,朴素截断和显而易见的摘要策略都失效了。真正有效的是:保留头尾内容 + 可检索记忆存储 + 处理超大上下文的子智能体。严重程度:在长周期部署中为高。当前没有现成方案,从业者仍在自行构建定制策略。
对带钱包智能体的提示注入问题仍未解决
@somi_ai 融资 给出了这一风险最清楚的表述:“如果智能体被越狱,向随机地址打款,链上支付是追不回来的。”@AgentPays_app 也强调,欺诈检测需要把智能体理解为可信行为者,而不是威胁信号。这个风险是带自主支付能力智能体所特有的。严重程度:高。回复中没有提出缓解方案;Circle 虽然描述了护栏机制,但并未公开展示它在注入场景下的防护效果。
AI 界面仍然要求用户把意图翻译成机器指令
@mark_k(4,554 次浏览、47 条回复)说:“AI 现在仍然太像在和一个终端说话。”回复表明,这是一种广泛存在的挫败感。@Mikey100200 提到,编辑照片时,用户必须用精确文字描述改动,而不是直接圈出目标区域。严重程度:中等。已有一些部分缓解方案(Grok Imagine、HyperFrames Inspector、Google 的实验性鼠标指针演示),但都还没有成为主流。
3. 人们希望出现什么
不需要在会话之间反复重建的持久化上下文基础设施
@NainsiDwiv50980 和 @DamiDefi 都在隐含地呼唤一种工具:能够自动构建并维护上下文基础设施——把品牌语气、历史输出、风格违规记录和受众偏好保存在持久文件中,并在每次会话时自动载入。现在的替代方案仍是手工操作:.md 文件、Obsidian vault、N8N 管道和 AGENTS.md 配置。人们想要的是一个无需用户亲自管理、就能自行组装并更新这些上下文的系统。机会:直接——上下文基础设施工具市场活跃,但仍未被满足。
一个能让技能作者真正变现的智能体应用商店
@dotey(3,208 次浏览、4 次收藏)明确提出了这一点:MCP 负责连接,Skills 负责知识,但最后一公里——用户编辑与垂直工作流——仍未解决。其类比对象是 VSCode 扩展与 Chrome 插件:应该允许社区贡献高质量的垂直技能并对其收费,因为现有的技能模式没有变现通路。@dotey 提到,他的 baoyu-skills 仓库已接近 20,000 个 GitHub stars,但从中赚到的钱是 $0。Skills 透明、易复制;如果出现一个带支付与知识产权保护的插件市场,激励结构就会改变。机会:直接,但有争议——skillsmp.com、ClawHub 和 Codex 的早期 marketplace 都只是部分尝试。
真正能解决客户问题,而不只是接电话的语音智能体
@ArtificialAnlys 发布的 tau-Voice 基准表明,即使最好的语音智能体,也只能解决 52.1% 的客服场景。虽然回复里没有从业者直接抱怨,但数据缺口已经非常明显:行业需要的是能覆盖大量长尾边缘情况的语音智能体——包括口音、噪声、多轮策略合规——而不是在一半通话上仍需转人工。机会:竞争激烈——各大 AI 实验室都在积极冲击这一基准。
能赢得企业信任的智能体治理与信誉基础设施
@Conste11ation(45 次点赞、739 次浏览)表示:“多智能体系统无法靠尽力而为的编排赢得企业信任。它们需要确定性的底层基座,并且从设计上就能生成可审计记录。这个溯源层,正是当前智能体经济缺失的部分。”@Altcoinist 对 Virtuals.io 的分析则从加密侧指出了同样的缺口:为智能体建立不可篡改的链上履历,能够支撑大规模自主网络中的信任。机会:对于重视安全的企业买家而言是明确机会;对于链上信誉系统而言,则更偏理想化方向。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Hermes Agent | 智能体 harness | (+) | 持久记忆、自我改进循环、按任务复杂度进行模型路由、打通整条技术栈;140K GitHub stars | 直到近期桌面应用发布前都只有 CLI;不能替代 Claude Code;多智能体协同存在一定不稳定性 |
| Claude Code | 编码智能体 | (+) | 是桌面工作场景下的日常主力;借助 AGENTS.md 具备很强的上下文工程能力;Managed Agents 更新加入了 Dreaming/Outcomes/Webhooks | 权限边界可通过链式网页内容漏洞被绕过(@DarkNavyOrg 演示) |
| OpenClaw | 智能体 harness | (+/-) | 350K+ stars;由 NVIDIA Nemo Claw 支持;生态强 | 曾与原始创建者(Clawnch)发生高调决裂;信任分裂 |
| LangGraph | 智能体框架 | (+) | 有状态管道、循环、分支、生产级、控制力强 | 学习曲线更陡;抽象层较高 |
| CrewAI | 智能体框架 | (+) | 多智能体团队、角色化任务、代码可读性好、交付快 | 从业者认为其生产成熟度不如 LangGraph |
| PydanticAI | 智能体框架 | (+) | 结构化输出、类型安全、原生 Python 体验、验证优先 | 不太适合长周期任务 |
| Google ADK | 智能体框架 | (+) | 五种可组合智能体类型(LlmAgent、SequentialAgent、ParallelAgent、LoopAgent、CustomAgent) | 较新;公开场景中的实战验证较少 |
| MCP | 智能体协议 | (+) | 可跨框架把智能体接入现实世界工具;采用广泛 | 不能解决技能作者变现问题 |
| Circle CLI / Agent Stack | 金融基础设施 | (+) | 原生 USDC 支付、无需 API 密钥、最低至 $0.000001 的纳支付、可与 Claude Code/Cursor/Codex 配合使用 | 针对钱包的提示注入问题仍未解决;机构级韧性尚未得到验证 |
| Voiceflow + Twilio | 语音智能体构建器 | (+/-) | 无代码流程,从提示词到真实通话上线可在一小时内完成 | “无代码”仍需要 500 字结构化系统提示词;两次失败规则仍会让一半困难案例升级处理 |
| Obsidian + CLAUDE.md / AGENTS.md | 上下文基础设施 | (+) | 持久品牌语气、可复用上下文、多会话连续性;免费 | 维护仍需手动;无法根据会话结果自动更新上下文 |
| N8N | 工作流自动化 | (+) | 每日收件箱简报、由 cron 触发的智能体任务;可自托管 | 配置门槛较高;不是原生智能体工具 |
| Orgo | 面向智能体的云 VM | (+) | 每个智能体都在独立沙箱中运行;无需管理服务器 | 相比主流云服务商更不成熟 |
| Composio | 应用认证层 | (+) | 为智能体提供跨数千款应用的一键认证 | 存在依赖风险;未讨论定价 |
| SureThing | 记忆层 | (+) | LongMemEval SOTA:总体 88.0%,知识更新 91.0% | 较新;信息流中尚无独立复现 |
| Cisco DefenseClaw | 智能体安全治理 | (+) | 检查每一次提示、补全和工具调用;覆盖 9 个智能体;可按连接器执行阻止/批准/审计;Apache-2.0 | 覆盖仅限受支持连接器;未展示对提示注入利用链的防护能力 |
| Grok Voice Think Fast 1.0 | 语音到语音模型 | (+) | tau-Voice 上表现最佳,任务完成率 52.1% | 仍有 48% 的客服场景无法解决;平均通话时长第二长(5.6 分钟) |
总体情绪是谨慎乐观。最一致的迁移趋势,是从一次性提示词工作流,转向持久化上下文文件架构和对 harness 友好的工具。多位从业者都独立提到,自己正在从“每次会话开始时重建上下文”,转向使用预加载全部相关信息的文件。当前最主要的竞争叙事是 Hermes vs Claude Code,但社区共识认为两者是互补而非竞争:Claude Code 负责深度编码会话,Hermes 负责其他场景。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| TradingAgents | TauricResearch | 多智能体交易事务所,包含基本面分析师、情绪分析师、技术分析师、交易员和风控经理智能体,它们会围绕交易进行争论并投票 | 单智能体交易机器人缺乏角色分工与对抗性辩论 | Python、LLMs、Apache-2.0 | 已发布 | GitHub · arXiv |
| Purr-Fect Agent | Pieverse | 开源 TypeScript 智能体 harness;从 clone 到跑起来只需 60 秒,内置基于 TEE 的钱包、142 个链上技能和 5 个使用入口(REPL、ACP editor、HTTP gateway、API、cron) | 自带链上钱包与多链技能库的智能体 harness | TypeScript、OpenAI-compat、Anthropic、BNB Chain 生态 | 已发布 | 通过 @pieverse_io 宣布 |
| Circle Agent Stack | Circle | Agent Wallets + Agent Marketplace + Circle CLI + 纳支付($0.000001 USDC、免 gas) | 智能体与智能体之间的商业活动缺乏原生金融基础设施 | USDC、x402、Circle Gateway、Claude Code / Cursor / Codex 集成 | 已发布 | 文档 |
| Rail Protocol | RailProtocolOrg | 用 Rust 和 Anchor 编写的链上程序,提供钱包注册表、交易账本、策略执行和多智能体支付路由 | 多智能体系统缺少可审计的支付路由层 | Rust、Anchor、Solana | 已发布(已完成内部安全审计) | GitHub |
| Browser Harness (Browser Use) | Browser Use 团队 | 用直接 CDP 在 592 行代码内实现 Python 浏览器自动化;当缺少工具时,智能体会自己编写并持久保存工具(自愈);11.6K stars | 浏览器自动化框架会带来抽象上限;工具能力无法复利积累 | Python、Chrome CDP、MIT 许可证 | 已发布 | 通过 @thisdudelikesAI 被提及 |
| AI Co-Mathematician | DeepMind | 面向数学家的多智能体工作台:文献检索、计算探索、定理证明、迭代验证循环;FrontierMath Tier 4 得分 47.9% | 单模型在高难数学上出现平台期;人机协作需要结构化迭代 | Gemini 3.1 Pro + 多智能体框架 | 已发布(研究) | arXiv:2605.06651 |
| ClawdOS | Clawnch | 智能体操作系统:智能体以长期运行的守护进程(clawdaemons)形式运行,拥有独立窗口、沙箱文件系统、链上 Base 钱包,以及可选的 Farcaster 身份 | 当前智能体框架本质上是无状态聊天窗口;智能体需要像进程一样运行 | Python、PyPI(pip install clawdaemons)、Hermes Agent、Deer Flow、Base 钱包 | Alpha | GitHub |
| 托管式 AI 智能体业务 | Greg Isenberg / Nick Vasiles (Orgo) | 面向个人运营者的完整玩法:Hermes + Codex + Orgo VMs + Composio + Agent Mail + Obsidian,为 SMB 客户提供每客户 $5k/月的服务 | 现有智能体是为开发者打造的;企业主如果没有基础设施,无法自行搭建 | Hermes、Codex、Orgo、Composio、Agent Mail、GPT 5.5、GLM 5.1 | RFC / Playbook | 视频 |
TradingAgents 是当天被提及的开源项目中,结构上最有意思的一个:五个智能体分工、争论、辩论、投票,降低了单智能体系统的自评偏差。这个模式可以推广到任何“对抗性审查能提升决策质量”的领域。其 73.7K GitHub stars(已从仓库页面确认)说明,这种架构的吸引力早已超出金融场景本身。
ClawdOS 则采取了一个概念上截然不同的定位——把智能体当作操作系统进程,而不是聊天会话。它也是当天唯一一个明确正面处理当前所有智能体框架“单用户 / 单窗口”限制的项目。运行多个具名、拥有独立钱包和文件系统的智能体守护进程,更接近服务器进程模型,而不是聊天机器人模型。
6. 新动态与值得关注的内容
DeepMind Co-Mathematician 以 47.9% 登顶 FrontierMath Tier 4
Google DeepMind 发布了 arXiv:2605.06651《AI Co-Mathematician:用 Agentic AI 加速数学家工作》。该多智能体系统基于 Gemini 3.1 Pro,并加入文献检索与代码执行层,在 FrontierMath Tier 4 上取得 47.9%,显著超过 GPT-5.5 Pro 的 39.6% 和 Claude 4.7 Opus 的 22.9%。基础模型单独得分仅为 19%;多智能体框架贡献了完整的 28.9 个百分点提升。该系统每题可获得最多 48 小时的异步计算,而 OpenAI 模型则在标准 web harness 上接受测试,因此这组对比并非完全同类。但即便如此,这仍然是迄今最明确的公开证据,证明多智能体框架在高难推理任务上能带来显著能力增量,而这不是任何单一模型配置本身所能提供的。由 @hsu_steve 提及。
Google 正把鼠标指针变成智能体界面
@GoogleDeepMind 发布了实验性演示,重新想象这枚已有 50 年历史的鼠标指针,将其变成 AI 界面——用户只需指向屏幕元素,再说出自然简短的话(“修这个”“把那个移过去”),就能直接在屏幕上指挥 Gemini,而无需打开提示框。@minchoi 将其形容为“提示框正在死去”。这些演示仍处于实验阶段,似乎尚未进入任何已发布产品,但它们是目前最具体的公开信号之一,表明大型 AI 实验室正在积极解决 @mark_k 所指出的“意图翻译成本”问题。
Cisco DefenseClaw 扩展至支持 9 个编码智能体
@AISecHub 报道称,Cisco DefenseClaw(Apache-2.0,Cisco 官方项目)现已支持 9 个编码智能体:Claude Code、OpenAI Codex、Cursor、Windsurf、Gemini CLI、GitHub Copilot、Hermes、OpenClaw 和 Zeptoclaw。该产品会检查每个智能体发出的每一次提示、补全和工具调用,然后按连接器执行阻止、批准或审计。一次性覆盖 9 个智能体,表明 Cisco 将智能体安全治理视为横向基础设施层,而不是单个智能体的附属功能。巧的是,就在同一天,@DarkNavyOrg 展示了一条针对 Claude Code 的有效利用链:通过把网页内容探索与其他漏洞组合起来,绕过权限检查。
Anthropic Managed Agents 新增 Dreaming、多智能体编排、Outcomes 和 Webhooks
@Alina_with_Ai 和 @JulianGoldieSEO 都提到了 Claude Managed Agents 的一次升级,新增四项功能:多智能体编排,用于把任务委派给专门的子智能体;Outcomes,基于 rubric 的自我改进与评估循环;Dreaming,让智能体从历史会话中学习并更新记忆;以及 Webhooks,用于无需轮询地接收事件更新。据称,有客户借助 Dreaming 将完成率提升了 6 倍。@Vanarchain 在回复中补充了关键前提:“记忆 + 协同只有在始终扎根于可靠执行时才有意义,而不是仅仅让输出随着时间变得更好。”
7. 机会在哪里
[+++] 持久化上下文基础设施工具 —— 这是当天最一致、被重复最多的信号:普通 AI 用户与专家级用户之间的差距,不在模型质量,也不在提示词技巧,而在上下文基础设施。目前没有主流产品能自动构建并维护品牌语气文件、风格违规库、受众上下文和会话连续性。所有被提到的从业者,都是靠 .md 文件和 Obsidian vault 手工完成这件事。一个能够组装、更新并版本化用户持久智能体上下文的工具,将同时服务个人运营者和团队。证据见第 1.2、2.1、3.1 和 4 节。
[+++] 智能体安全治理层 —— 就在 Cisco DefenseClaw 扩展到支持 9 个智能体的同一天,针对 Claude Code 的有效利用也被公开演示。目前还没有任何产品,能以经过真实注入场景检验的方式,在多个智能体运行时上同时大规模地阻止、限速或审计智能体行为。问题扩张的速度快于解决方案。企业买家有明确需求——可审计记录、按连接器执行策略——但目前仍没有产品能完整满足。证据见第 1.6、2.4、3.4、5 和 6 节。
[++] 面向专业领域工作的多智能体编排 —— TradingAgents 的架构(角色分工 + 对抗性辩论 + 投票)可以自然推广到任何“对抗性审查能提升质量”的领域,例如法律文件审查、临床决策支持、代码安全审计和金融分析。TradingAgents 已获得 73.7K GitHub stars,并有 arXiv 论文;DeepMind 的 Co-Mathematician 则把同一模式扩展到了数学研究,仅多智能体层就带来了 28.9 个百分点的提升。框架是开源的,结果经过同行评审,但尚无主导产品把这套架构封装给非技术领域买家。证据见第 1.6、5 和 6 节。
[++] 让语音智能体可靠性突破 50% 门槛 —— tau-Voice 基准表明,当前没有任何语音智能体能端到端解决超过 52.1% 的客服场景。呼叫中心与预约服务已在部署语音智能体,但 50% 的上限意味着一半来电要么升级给人工,要么直接失败。最佳表现(52.1%)与“足够支持无人值守运行”(80%+)之间的差距,在抗噪性、多轮策略合规和优雅升级逻辑上,构成了明确的工程机会。证据见第 1.6、3.3 和 4 节。
**+] 面向技能作者的 Agent 变现原语** — [@dotey 点明了具体问题:skills 是透明的、便宜的、容易被复制的,而且无论质量或采用度如何,作者目前都赚不到钱。应用商店的类比(VSCode 扩展、Chrome 插件)已经很明确。缺的是一个内置支付、IP 保护和质量信号的可信 marketplace。Circle Agent Stack 的纳支付基础设施,从技术上已经能支持按次计费的技能收费;缺少的是其上的市场层。证据见第 1.5 和 3.2 节。
[+] 守护进程化的智能体运行时(智能体 OS 模型) —— ClawdOS 的定位——把智能体看作长期运行的 OS 进程,而不是无状态聊天会话——确实解决了一个真实问题:现有 harness 会重置状态、丢失连续性,也无法基于共享底座协调多个同时运行的智能体工作负载。如果智能体未来要持续执行后台任务(邮件分流、cron 作业、财务监控、代码审查),守护进程模型就是正确抽象。项目目前处于 Alpha,但定位足够差异化。证据见第 1.4 和 5 节。
8. 要点总结
-
Harness engineering 的课程体系,已经成为一套结构化、可教授的知识体。 addyosmani 的文章、“学习 Harness Engineering”课程,以及 @MindBranches 的思维导图,共同构成了这门学科第一套连贯的课程体系。社区已经越过“harness engineering 是什么”,进入“去哪里学”。(akshay_pachaar、dishantwt_)
-
面向智能体的机器支付金融基础设施已经上线。 Circle Agent Stack 在当天发布了 Agent Wallets、Agent Marketplace,以及免 gas 的 USDC 纳支付($0.000001)。而尚未解决的问题——提示注入导致未授权转账——在上线数小时内就被指出,且尚无公开缓解方案。(circle、somi_ai via CoinMarketCap)
-
在高难能力边界上,多智能体框架带来的增益超过模型升级。 DeepMind 的 Co-Mathematician 仅仅是在单一基础模型之上加了一层多智能体框架,就让 FrontierMath Tier 4 成绩提升了 28.9 个百分点。测试中最强的单模型配置 GPT-5.5 Pro,也没有超过 39.6%。(hsu_steve)
-
语音智能体正撞上约 50% 任务完成率的可靠性上限。 tau-Voice 是首个在真实条件下评估语音到语音模型 agentic 能力的公开基准。最佳模型端到端只能解决 52.1% 的客服场景,其余模型都低于 40%。这不是猜测性的市场空缺,而是一个已被量化的缺口。(ArtificialAnlys)
-
如今区分高绩效智能体操作者的,不再是提示词质量,而是持久化上下文基础设施。 多位已经跑出生产结果的从业者都表示,真正的核心杠杆不是反复打磨提示词,而是建设品牌语气文件、风格库和持久化上下文文件夹。这一模式同时出现在个人创作者(每月 6,000 条广告)、企业团队和开源构建者中。(NainsiDwiv50980、oliverwhudson)
-
智能体安全治理正在变成企业级基础设施。 Cisco DefenseClaw 扩展到 9 个智能体的同一天,针对 Claude Code 的有效利用链也被演示出来。攻防共同演化正在加速。任何使用浏览器工具或网页内容的智能体部署,都暴露在当前 harness 无法阻断的链式漏洞路径之下。(AISecHub、DarkNavyOrg)