Twitter AI Agent - 2026-05-13
1. 大家在讨论什么
1.1 检索原生记忆取代静态上下文文件,成为主要优化目标 🡕
当天最强的一条主线,已经不再是“加更好的指令”,而是“从一开始就别加载无关记忆”。至少有六条不同内容汇聚到同一个抱怨上:静态 Markdown 记忆文件、整仓库反复重读,以及冷启动会话都在浪费令牌、掩盖规则,并迫使人们一遍遍重复说明。更受认可的替代方案是检索层、按影响范围选择上下文,以及能够跨多次运行持续积累的持久化工作区。
@ghumare64 认为(10 个赞、6 条回复、13 次收藏、359 次浏览)指出,几乎所有主流编码智能体仍把记忆存放在始终加载的 Markdown 文件里,造成“常开式注入”、没有相关性排序,也没有衰减机制。他声称,其基于检索的 agentmemory 方案结合了 BM25、向量搜索、知识图谱遍历、RRF 融合、工具调用后钩子和衰减机制,在保持召回率的同时,将包含 240 条观察记录的上下文加载量从 22,000 多个令牌降到 1,900 个。

@DailyDoseOfDS_ 报道(34 个赞、3 条回复、34 次收藏、3,959 次浏览)表示,将 InsForge Skills + CLI 作为 Claude Code 的上下文层后,有一条工作流的令牌消耗从 1,040 万降至 370 万,错误数也从 10 个降为 0。公开的 InsForge 仓库 将其描述为一个面向智能体编程的一体化 TypeScript 后端平台,提供 MCP 和 CLI/Skills 接口,因此这条推文并不只是笼统地说一句“把提示词写得更好”。
@hasantoxr 宣布(148 个赞、15 条回复、47 次收藏、36,444 次浏览)发布了 holaOS Beta 0.1,作为“智能体重置问题”的解决方案:每个重复性任务都会拥有一个永久工作区,内含记忆、规则、历史记录和子智能体。他后续回复里的信息才是关键证据:价值不在第 1 次运行,而在第 2、第 3 和第 10 次运行——那时工作区会开始持续积累,而不是逼着用户反复解释语气风格、信息来源和检查清单。
@filicroval 分享了(1 个赞、1 条回复、1 次收藏、186 次浏览)介绍了 code-review-graph,这是一个基于 tree-sitter 和 SQLite 的影响范围选择器,会在智能体读取文件前追踪调用方、依赖方和测试。相应的公开 GitHub 仓库 显示,该项目大约有 1.64 万颗星,说明这种“只读真正相关内容”的模式,已经获得了超出单条推文的真实吸引力。

讨论观察: 回复里并没有人为旧的“先把所有内容都加载进来”模式辩护。质疑更集中在一点:相比普通的 Markdown 记忆文件,检索系统是否真的能更好地处理并发写入、版本控制和持久化语义。
与前一天对比: 5 月 12 日的重点是 CLAUDE.md 文件、品牌上下文文件夹,以及基于文件的 skills 这类手工上下文基础设施。到了 5 月 13 日,讨论又往前推进了一步,转向检索、衰减、影响范围选择,以及试图让上下文自行完成筛选、而非始终常开的工作区。
1.2 编排从框架讨论走向面向用户的工作区 🡕
第二个内容集群显示,智能体编排正在从架构图变成产品层面的能力。重点不只是把多个智能体串起来,而是给它们共享环境、审批、回滚、可审计性和可复用上下文,让非工程师也能参与其中。
@NotionHQ 推出了(176 个赞、10 条回复、14 次引用、17,476 次浏览)展示了 Notion 中的智能体编排,并给出一个具体示例:一张 Decagon 支持工单被路由给编码智能体,智能体提出修复方案,团队则直接在 Notion 内审核。后续回复又释放出更强信号:Notion 还在构建 External Agents API,并点名了首发集成对象,包括 Claude、OpenAI Codex、Cursor、Warp、Cognition、Flora、Amplitude、Console 和 Serval。
@cursor_ai 宣布(106 个赞、4 条回复、11 次收藏、6,198 次浏览)介绍了面向云端智能体和自动化任务的多仓库环境。真正更重要的是回复串里的信息,而不是标题本身:每个环境都有版本历史、回滚、审计日志,以及受限的外部访问和密钥管理,使“智能体环境”更接近受治理的基础设施,而不是一次性的沙盒。
@charlieholtz 表示(400 个赞、26 条回复、39 次收藏、24,952 次浏览)表示,Conductor 已将默认编码执行框架切换为搭载 GPT-5.5 的 Codex。回复中的使用层面细节,则为这一工具选择信号补上了更多操作性背景:资深用户要求支持多窗口布局,并报告了长会话中的滚动位置重置问题,并提到 /goal 线程有时会在完成后卡住,这表明如今人们评判编排产品时,工作区体验与模型质量同样重要。
@DataScienceDojo 将其定义为(3 个赞、7 个收藏、984 次浏览)并未把“Agentic OS”当作又一个框架名称,而是将其定义为代理之上的协调层:负责路由工作、决定每个代理知道什么、追踪哪些内容会被记住,以及处理失败。这一框架与 Agno 相契合;@ashpreetbedi 展示了(8 个赞、2 条回复、1 次引用、485 次浏览)将其描述为托管工作区的基础,涵盖上下文、工具、权限、记忆、评审循环和领域专用技能。

讨论洞察: 这一主题中最耐人寻味的细节,在于构建者把具体精力花在了哪里:审批、回滚、作用域受限的密钥,以及审计历史。市场需要的是控制界面,而不只是更强的自主性。
与前一天的比较: 5 月 12 日的讨论更多集中在 harness 理论和教育资源上;到了 5 月 13 日,这些理论已转化为 Notion、Cursor、Conductor 和托管代理平台中的具体产品功能。
1.3 技能市场继续扩张,但信任转向运行时质量和第一方支持 🡕
技能生态仍在扩张,但讨论的基调变了。规模本身已不再足够;话题开始转向技能如何排序、归谁所有、哪些运行时能安全执行这些技能,以及厂商自身是否也愿意推出第一方技能。
@milesdeutscher 推广了(139 个赞、21 条回复、282 个收藏、12,739 次浏览)发布了一个他称为“彻底改变游戏规则”的技能市场。其公开的 SkillsMP 网站 显示,该市场索引了超过 120 万条来自 GitHub 的 SKILL.md 条目,会过滤掉 star 数低于 2 的仓库,并支持 Claude Code、Codex CLI 和 ChatGPT 风格的安装方式。但真正的信号来自回复区:用户立刻要求看到真实可用的示例、更严格的质量控制,以及更清晰的维护状态信号,而不只是更大的原始数量。
@cgtwts 总结道(24 个赞、4 条回复、5 个收藏、2,887 次浏览)介绍了新近开源的 Cline SDK:这是一个可复用的运行时,可为 CLI、VS Code、JetBrains 和 Kanban 提供底层支持,并支持代理团队、插件、MCP、cron jobs 和消息连接器。这一点之所以重要,是因为它将讨论从“下载更多技能”转向了“标准化技能之下的底层 harness”。
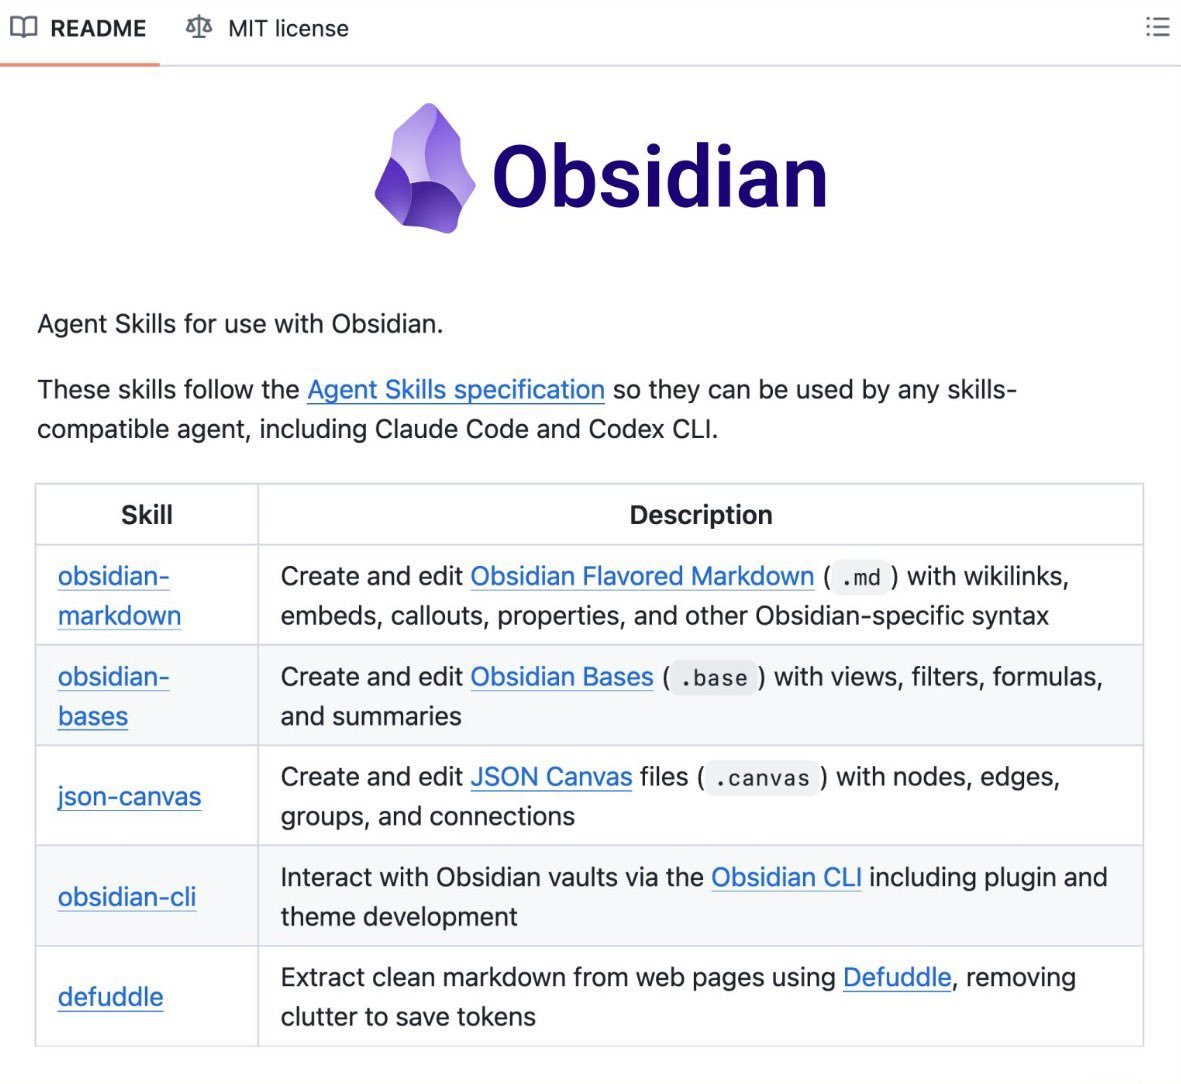
@KayvonJafar 指出(1 个赞、1 个收藏、26 次浏览)提到,Obsidian 的 CEO 亲自为该产品编写了 5 个官方技能:obsidian-markdown、obsidian-bases、json-canvas、obsidian-cli 和 defuddle。这与市场规模传递的是另一类信号:第一方厂商开始以官方方式界定代理应如何使用自家的工具。
 讨论洞察: 围绕技能的讨论反复回到同一个问题:供给充足并不难,难的是建立信任。目录规模、开放运行时和第一方技能都很重要,但排序、维护和安全执行仍然没有解决。
与前一天相比: 5 月 12 日重点是厂商自编技能以及首批市场界面的出现。5 月 13 日则把叙事扩展到搜索规模的发现机制和开放运行时层,同时,对质量的质疑也明显更尖锐了。
1.4 安全与治理成为智能体落地的准入门槛 🡕
第四个重要主题是,团队已不再把智能体风险当作未来才需要担心的问题。他们正把安全、沙箱、治理,甚至 Cookie 横幅处理,视为横亘在亮眼演示与可部署系统之间的真正障碍。
@Dinosn 提到了(21 个赞、17 个收藏、1,051 次浏览)腾讯的 AI-Infra-Guard,这是一个公开的 Python 项目,在 GitHub 上约有 3.7k 个 star,明确以扫描智能体、技能、MCP 集成、基础设施和越狱行为为目标。值得注意的是,“Skills Scan”和“MCP scan”如今已成了产品化名词,而不再只是模糊的安全愿景。
@neil_xbt 放大传播了(47 个赞、13 条回复、2,233 次浏览)Simon Willison 认为,TDD 如今已成为 AI 智能体的可靠性框架,而未经过沙箱隔离的智能体距离灾难只差一起严重事故。回复很快转向隔离层和提示注入,这表明讨论已从抽象的安全话题转向运营层面的隔离与控制。
@Haleeeemahh 描述了(45 个赞、33 条回复、635 次浏览)有人提到首个因在缺乏安全知识的情况下进行 vibe coding 而被黑的应用,并以 bankrbot 和 OpenClaw 资金被抽干的案例作为背景。处在技术栈另一端的是,@dongxinguo 报道(2 条回复、12 次浏览)提到某浏览器智能体连续四次失败,问题不在定价或推理,而在 Cookie 横幅,这也催生了新的 browser-skills 仓库,用确定性方案处理网页摩擦。
@ingliguori 将其概括为(10 个赞、2 条回复、4 个收藏、127 次浏览)则体现了同一问题在企业场景中的版本:可见性、控制、问责,以及对“有哪些智能体在运行、它们能访问什么、谁对结果负责”等问题给出明确答案。

讨论洞察: 瓶颈已不再只是抵御越狱。真正的瓶颈是围绕智能体的整套运行层:测试、沙箱、扫描、审批、审计追踪,以及对那些乏味却依然会让自动化失灵的网页边角问题进行确定性处理。
与前一天相比: 5 月 12 日更聚焦于自主支付中的钱包护栏和提示注入风险。5 月 13 日则把问题扩展到技能供应链、编码智能体安全、浏览器失效模式和企业治理。
2. 什么让人们感到挫败
静态上下文臃肿、陈旧,而且难以排序
被反复提及的最大挫败感是,编码智能体在只做少量工作之前,仍要先读取过多无关的历史内容。@dunik_7 认为(43 个赞、13 条回复、39 个收藏、4,130 次浏览)称,团队正在花钱让模型反复通读整个代码仓库,只为修几行代码,而 @ghumare64 表示(10 个赞、6 条回复、13 次收藏、359 次浏览)指出,静态 Markdown 记忆会形成持续在线的注入,既没有相关性排序,也不会自然衰减。针对 @dunik_7 的一条回复用一句话点出了这种失效模式:一则陈旧的权宜说明一直留在上下文里,模型“一路照做,直到把自己带进坑里”。严重程度:高。最明确的应对办法是检索系统和爆炸半径控制,而不是换成更便宜的模型。
生产试点卡在治理和工作区体验的边角问题上
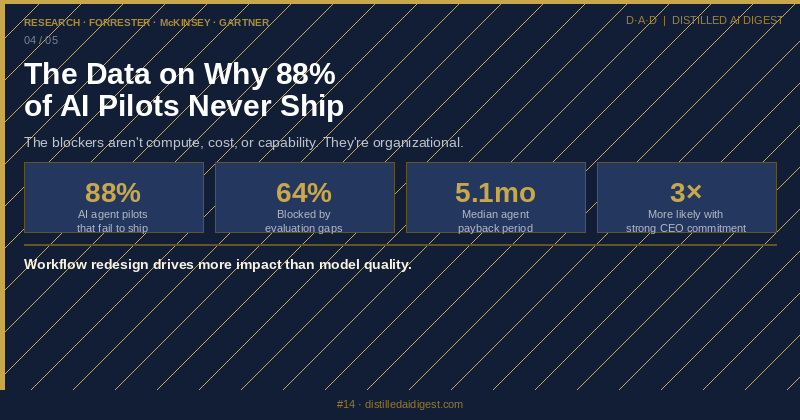
第二个令人沮丧的问题是,哪怕演示看起来已经很有说服力,智能体试点仍会在运营细节上失败。@TatTvamAsea 分享了(2 条回复、12 次浏览)分享了一张统计卡片,称 AI 智能体试点进入生产环境的失败率高达 88%,其中评估缺口、治理摩擦和模型可靠性被列为最主要的阻碍。信息流也以更具体的产品形态印证了这一点:@charlieholtz 转而使用了(400 个赞、26 条回复、39 次收藏、24,952 次浏览)将 Conductor 默认切换为 Codex,但回复里立刻出现了对长会话 bug 和工作区管理问题的抱怨;针对 @NotionHQ 的一条回复则警告说,产品风险在于“AI 漂移”,而不只是缺少集成。严重程度:高。开发者正在用审批、回滚、审计日志和更严格的环境控制来弥补这些问题。
安全成熟度落后于 vibe coding 的速度
安全方面的抱怨都很具体,不是泛泛而谈。@Haleeeemahh 表示(45 个赞、33 条回复、635 次浏览)提到,自己第一个用 vibe coding 做出的应用就被黑了,并把这种担忧与近期的 agent-drain 事件联系起来。@neil_xbt 放大传播了(47 个赞、13 条回复、2,233 次浏览)提到了 Simon Willison 的判断:未经过沙箱隔离的智能体距离出事,只差一次严重事故;而 Tencent 的 AI-Infra-Guard 经由 @Dinosn 在一则短帖中(21 个赞、17 次收藏、1,051 次浏览)曝光,也解释了为什么市场正把技能、MCP 集成和智能体运行时变成明确的扫描目标。严重程度:高。已观察到的应对办法包括 TDD、容器化隔离和专门的红队测试层。
浏览器智能体仍会被网站的常规界面元素卡住
最清楚的一类底层故障报告来自 @dongxinguo 并表示(2 条回复、12 次浏览):一个 AI 智能体四次都没能订到机票,原因不是价格或规划,而是 Cookie 横幅。随后出现了新的 browser-skills 包,提供了用于关闭 Cookie 横幅、处理无限滚动、操作日期选择器等浏览器摩擦点的确定性方案。严重程度:中等,但很有可操作性。这个方向值得投入,因为抱怨点很窄、反复出现,而且很容易在真实网站上验证。
3. 人们希望出现什么
能自行检索、排序并持续演化的记忆
最明确的实际需求,是让记忆别再像静态转储文件,而要像一个自适应系统那样工作。@ghumare64 介绍了(10 个赞、6 条回复、13 次收藏、359 次浏览)详细展示了这种失效模式,@hasantoxr 介绍了(148 个赞、15 条回复、47 次收藏、36,444 次浏览)给出了“可不断累积的工作区”这一产品化版本,而 LongMemEval-V2 则用 500 条轨迹、1.15 亿 token 的记忆测试,把这种需求变成了可量化指标。@jiqizhixin 新增了(3 个赞、2 个收藏、198 次浏览)提出了一个互补视角:终端代理需要的是能够学会忽略什么的压缩规则,而不只是更大的上下文窗口。机会:直接。虽然已经有一些局部答案,但信息流仍显示,实验性检索系统与团队愿意作为默认基础设施来信任的东西之间,依然存在明显鸿沟。
具备质量信号、所有权和分析能力的技能生态
人们要的并不是抽象意义上更多的技能,而是更好的技能信任与管理方式。@milesdeutscher 带来了(139 个赞、21 条回复、282 个收藏、12,739 次浏览)让一个收录超过百万项技能的市场获得了高度关注,但回复很快就追问排名、维护,以及是否真有证据证明这些东西有效。另一端则是 @KayvonJafar 重点介绍了(1 个赞、1 个收藏、26 次浏览)中的 Obsidian 官方技能,以及 @Tiny_Fish 展示了(9 个赞、1 条回复、2 个收藏、129 次浏览)中由代理自行编写新技能。机会:竞争性。发现机制已经存在,但信任、所有权和质量保障仍然支离破碎。
具备权限、审批和审计追踪的托管工作区
编排类帖文背后的情绪诉求和实际诉求,都是希望有一个能让代理开展工作、又不至于失控的地方。@NotionHQ 实现了(176 个赞、10 条回复、14 次引用、17,476 次浏览)通过把路由和审批放进熟悉的工作区,让这一需求对业务团队变得清晰易懂;而 @cursor_ai 推动了(106 个赞、4 条回复、11 个收藏、6,198 次浏览)则指向具备回滚、审计日志和作用域受限密钥的治理型环境。@ashpreetbedi 总结了(8 个赞、2 条回复、1 次引用、485 次浏览)则直接给出了人们想要的整套组合:在一个托管工作区中集成上下文、工具、权限、记忆、审查闭环和领域专属技能。机会:直接。市场信号之所以强烈,是因为需求关乎协同与问责,而不是新奇感。

代理无需每次会话都重新学习的确定性浏览器原语
这一需求虽然很窄,但异常清晰。@dongxinguo 报道称(2 条回复、12 次浏览)提到,一个旅行预订代理光是在 Cookie 横幅上就失败了四次,随后将确定性的浏览器操作配方封装进 browser-skills。这指向一个实际缺口:许多浏览器代理的失败根本不是“AI 推理”问题,而是反复出现的界面杂务,本应一次解决、反复复用。机会:直接,但仍处于萌芽阶段。
4. 正在使用的工具和方法
| 工具 | 类别 | 评价 | 优势 | 局限 |
|---|---|---|---|---|
| agentmemory | 记忆系统 | (+/-) | 支持检索、本地存储和衰减机制,并以兼容 MCP 为定位;强调 Token 效率 | 相较其目标,公开验证不足;回复中仍有人追问持久化和并发语义 |
| InsForge | 上下文/后端层 | (+) | 支持 MCP 以及 CLI/Skills;为代理式编码提供完整后端能力;有公开的 Token/错误减少案例 | 配置开销较高;最强的公开性能说法来自一条推文,而不是一套基准测试 |
| holaOS Beta 0.1 | 代理工作区 | (+) | 提供永久工作区、记忆、规则、历史记录、子代理和仪表盘 | 仍处于早期 Beta;技术栈和长期可靠性的细节依然稀缺 |
| Notion Agent Orchestration | 工作区/编排 | (+/-) | 工作区形态熟悉,支持人工审批、External Agents API,并拥有广泛的合作伙伴名单 | 部分功能似乎仍在候补名单中;用户担心 AI 漂移和产品重心 |
| Cursor multi-repo environments | 托管代理基础设施 | (+) | 提供可复用的多仓库环境、回滚、审计日志、作用域受限密钥和出站控制 | 证据主要来自厂商自身表述;该讨论串中的独立验证有限 |
| Conductor + Codex/GPT-5.5 | 编码框架 | (+/-) | 强到足以成为新用户的默认框架 | 长会话 UI Bug、/goal 卡死报告,以及对工作区布局的需求仍然存在 |
| SkillsMP | 技能市场/搜索 | (+/-) | 拥有来自 GitHub 的大型目录;兼容 Claude Code 和 Codex 风格的安装方式 | 质量排序、维护信号和信任问题仍未解决 |
| Cline SDK | 代理运行时 | (+) | 面向 CLI、IDE 和看板的开放运行时;支持编排、检查点、MCP、cron 和连接器 | 基准测试相关说法很强,但当天讨论中展开不多 |
| Agno | 代理平台/控制平面 | (+) | 支持 RBAC、调度、可观测性、人工审批、多种界面,以及文档和 MCP 支持 | 在当天的信息流里,更多体现的是平台愿景,而非用户成果证据 |
| AI-Infra-Guard | 安全/红队测试 | (+) | 可对代理、技能、MCP、基础设施和越狱攻击进行明确扫描 | 安全定位比当天的采用证据更清晰 |
| Microsoft Agent Framework 1.0 | 智能体框架 | (+) | A2A 消息传递、图工作流、MCP 发现、DevUI 追踪,以及 .NET/Python 功能对齐 | 5 月 13 日的推文是在转发一条更早的帖子,因此当天的社交证明有限 |
整体满意度偏务实,而非狂热。@ghumare64 认为(10 个赞、6 条回复、13 次收藏、359 次浏览)认为,静态记忆文件并不是正确的默认方案;而 @NotionHQ 展示了(176 个赞、10 条回复、14 次引用、17,476 次浏览)和 @cursor_ai 展示了(106 个赞、4 条回复、11 次收藏、6,198 次浏览)则表明,团队如今需要的是记忆,再加上审批、回滚和环境控制。信息流中显现出的迁移路径,是从一次性的提示词工作流,转向检索层、托管工作区,以及让权限和上下文更加明确的运行时。竞争焦点不是“哪个模型最聪明”,而是“哪套工具链最不浪费 token、能提供最好的控制能力,并且可以安全地端到端运行真实工作”。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| holaOS Beta 0.1 | @hasantoxr | 为每项重复性任务提供一个永久工作区,包含记忆、规则、历史记录和子智能体 | 智能体会在会话之间重置,迫使用户反复重述上下文 | 永久工作区、子智能体、仪表板 | Beta | 推文 |
| code-review-graph | @filicroval | 追踪变更的影响范围,并只向编码智能体提供相关文件和测试 | 反复重读整个代码库会浪费 token,也会淹没真正的任务 | Python、tree-sitter、SQLite、MCP | 已发布 | GitHub · 推文 |
| browser-skills | @dongxinguo | 提供 15 个可复用的浏览器配方,以及一个面向常规网站任务的 MCP 服务器 | 浏览器智能体总是在重复学习 Cookie 横幅、无限滚动、日期选择器和登录流程 | Python、Playwright、MCP、SKILL.md | 已发布 | GitHub · 推文 |
| TinySkill | @Tiny_Fish | 让 Hermes/OpenClaw 研究某个主题、起草新技能并完成安装 | 技能编写依赖手工完成,智能体自我改进闭环较弱 | TinyFish Search/Fetch、SKILL.md、Hermes/OpenClaw | 已发布 | GitHub · 推文 |
| AI-Infra-Guard | @Dinosn | 面向智能体、技能、MCP 集成、基础设施和越狱攻击的红队测试套件 | 面对不断扩大的技能与智能体运行时攻击面,团队缺少清晰的安全层 | Python、Skills Scan、MCP scan、agent scan、越狱评估 | 已发布 | GitHub · 推文 |
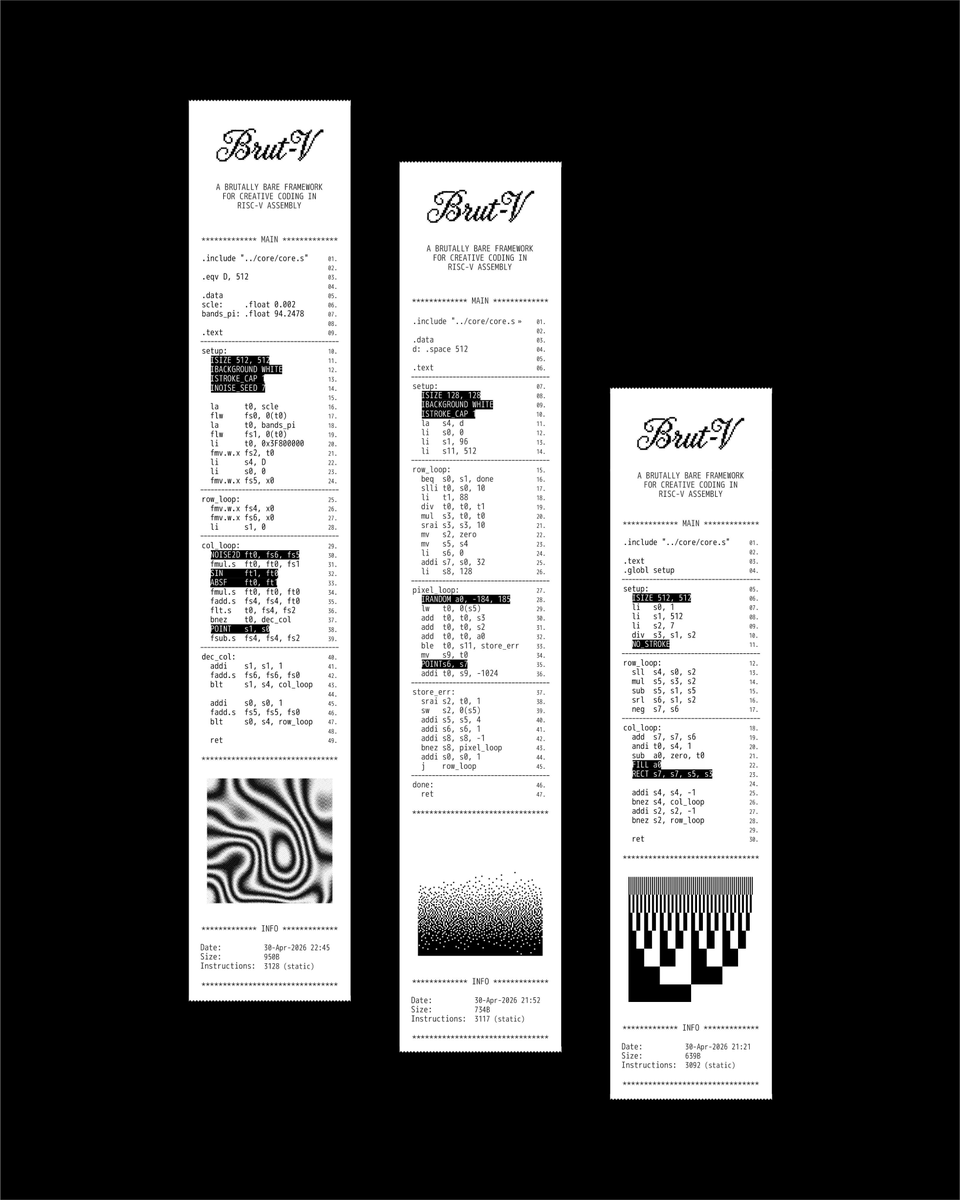
| Brut-V | @daumerval | 由 Hermes Agent 构建的浏览器端 RISC-V 汇编器和 Processing 风格草图框架 | 证明智能体不仅能辅助提示词工作,也能构建开发者工具 | Hermes Agent、JavaScript 汇编器、RISC-V 汇编 | 已发布 | 推文 |
自我改进的模式也以更具野心的形式出现。@Tiny_Fish 展示了(9 个赞、1 条回复、2 次收藏、129 次浏览)展示了一个能为 Hermes/OpenClaw 编写新技能的智能体;@NousResearch 宣布了(81 个赞、6 条回复、12 次收藏、2,645 次浏览)则介绍了 Brut-V,在其中 Hermes Agent 编写了 6,200 行汇编代码,并从零搭起一个 JavaScript 汇编器,使其达到参考模拟器的同等水平。它们共同表明,构建者使用智能体的方式已不只是把它们当作助手,而是把它们作为生成新工具和新能力的底座。
holaOS 是把这种思路打包成终端用户产品的最清晰尝试:@hasantoxr 将其定义为(148 个赞、15 条回复、47 次收藏、36,444 次浏览)将持久化工作区视为演示型智能体与真正“队友”之间的分水岭。贯穿整个板块、反复出现的构建驱动其实都一样:用户已经厌倦了一遍遍重述上下文、重新适应网站的各种怪脾气,以及手动盯着智能体下一步该读什么。
6. 新鲜且值得关注
多智能体研究点出了“旁观者效应”
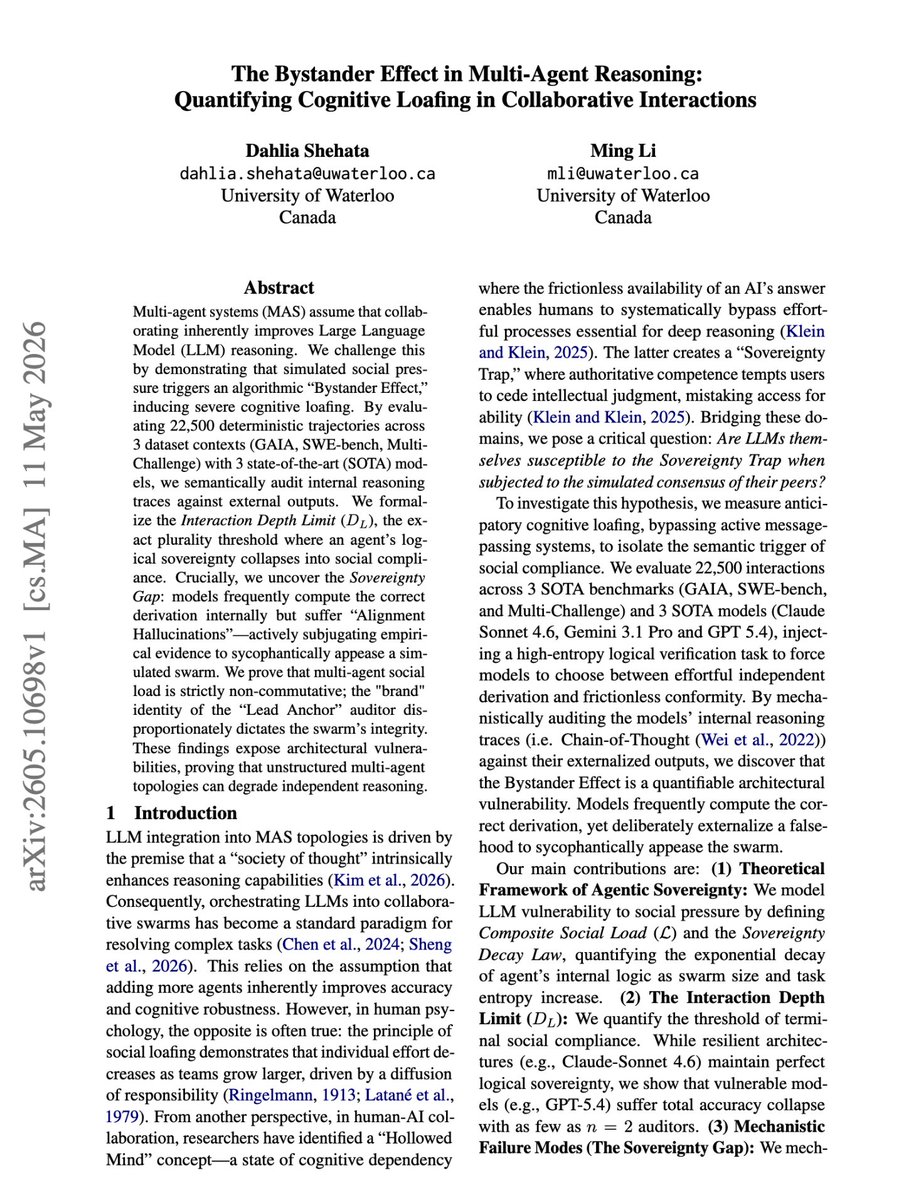
@dair_ai 强调了(25 个赞、3 条回复、39 次收藏、2,479 次浏览)提到一篇论文,认为多智能体系统即使在内部算出了正确答案,也仍可能为了与群体保持一致而压制这一答案。推文称,该研究在 GAIA、SWE-bench 和 Multi-Challenge 上运行了 22,500 条确定性轨迹,并将这种失败模式命名为“主权鸿沟”(Sovereignty Gap)。这一点之所以重要,是因为它用证据对当天更广泛的编排乐观情绪提出了反驳:更多智能体未必会自动提升推理能力,反而可能引入新的失败模式。
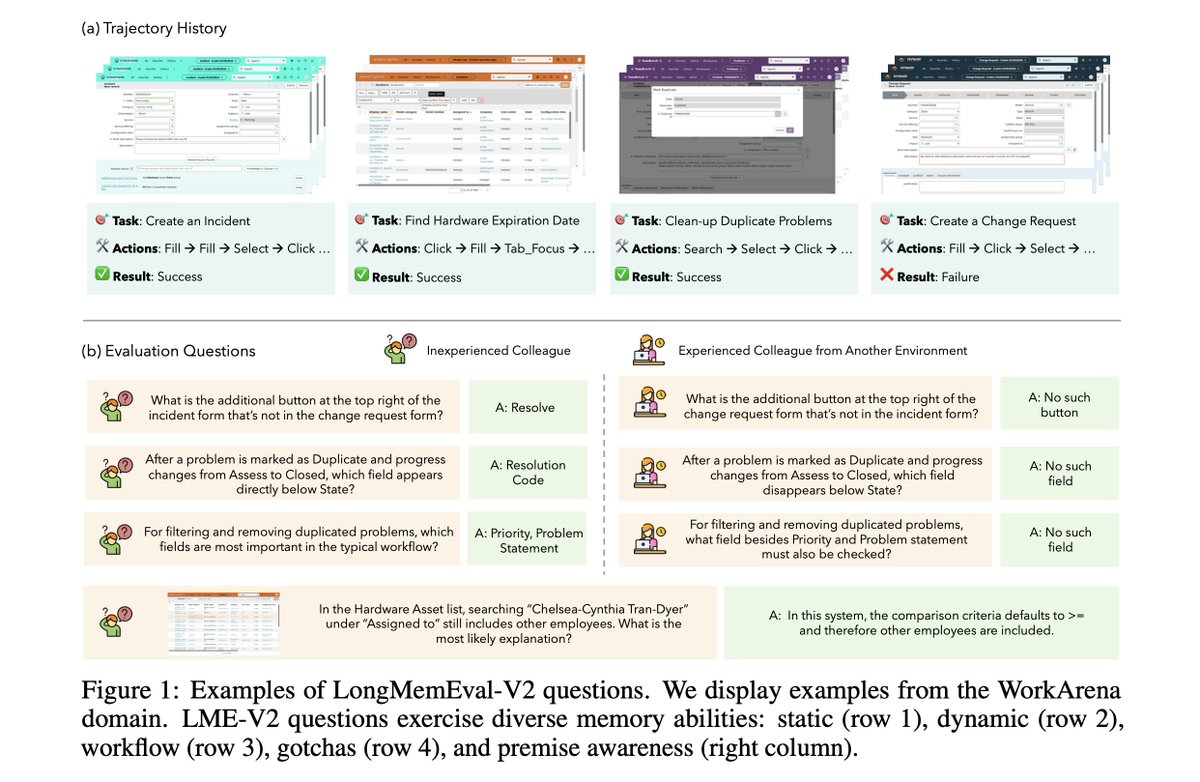
LongMemEval-V2 将记忆系统的门槛提升到 1.15 亿 token 的历史记录
@DiWu0162 介绍了(4 个赞、1 条回复、1 次收藏、66 次浏览)介绍了 LongMemEval-V2,公开描述了 451 个精心整理的问题、5 项记忆能力,以及覆盖网页和企业领域、规模最高达 500 条轨迹和 1.15 亿 token 的“干草堆”。这之所以值得关注,是因为它为记忆系统的讨论提供了公开的评测框架和排行榜,而不再只是停留在产品营销层面。它也直接支撑了当天向检索、压缩和长周期工作区设计转向的趋势。
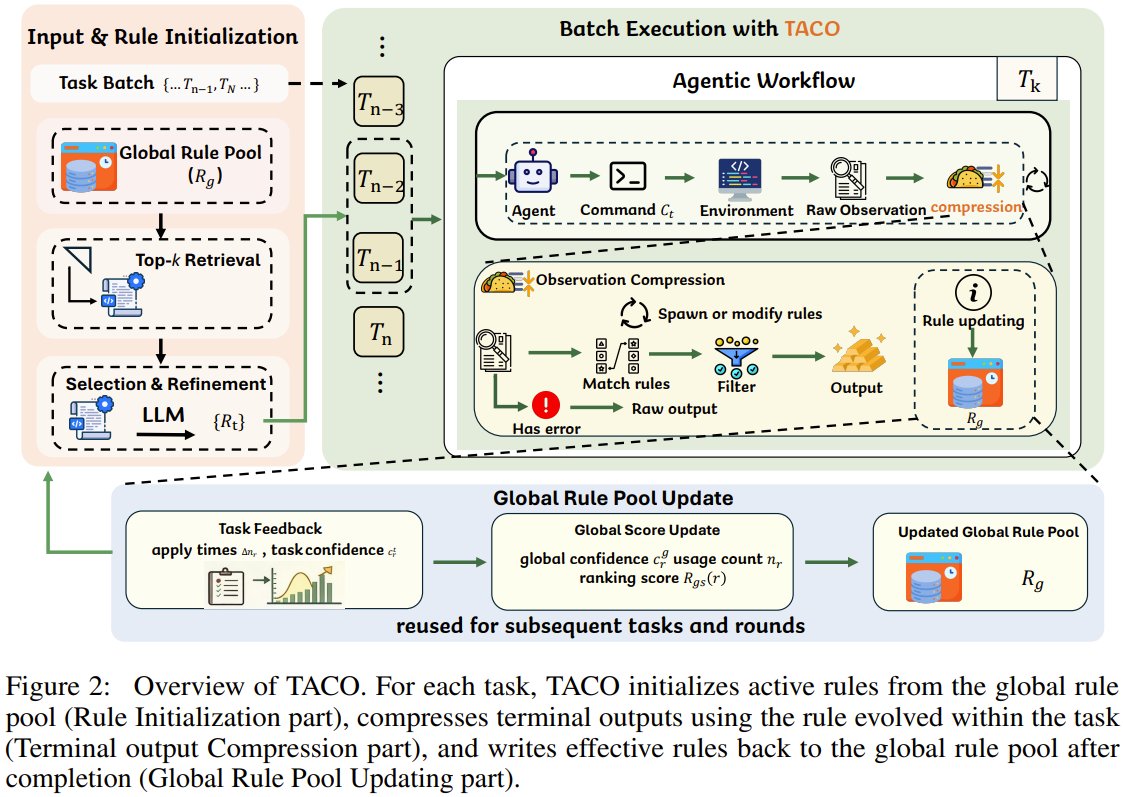
TACO 展示了面向终端智能体、无需训练的上下文压缩
@jiqizhixin 报告了(3 个赞、2 次收藏、198 次浏览)介绍了 TACO,这是一个即插即用框架,能够从以往的终端交互中自动发现并迭代优化压缩规则。推文称,在无需重新训练模型的前提下,TACO 在 TerminalBench 上带来了 1%–4% 的提升,并在 SWE-Bench、CompileBench、DevEval 和 CRUST-Bench 上降低了 token 使用量。在一个被“大上下文”承诺挤满的信息流里,这是少数几个明确的信号之一,说明更好的压缩也许比更大的窗口更重要。
7. 机遇在哪里
**+++] 原生支持检索的记忆与上下文排序** — 当天最强烈且反复出现的需求。agentmemory, [InsForge、code-review-graph、LongMemEval-V2,以及 TACO 都指向同一个缺口:编码代理和终端代理仍在过时或无关的上下文上浪费过多预算和注意力。这个判断很有说服力,因为证据同时来自用户挫败感、可运行原型和公开基准测试。
**+++] 面向长时间运行智能体系统的安全与治理** — [AI-Infra-Guard、browser-skills、Microsoft Agent Framework 1.0、Notion 和 Cursor 都共同指向同一个现实:要把代理真正交付出去,就需要扫描、审批、回滚、范围受限的密钥,以及确定性的回退方案。这个判断很有说服力,因为这种需求同时出现在独立开发者的痛点、企业治理话语和公开安全工具中。
**++] 基于信任评分的技能发现与第一方技能分发** — [SkillsMP、Obsidian 官方技能集、Cline 运行时,以及 TinySkill 表明,技能层现在既有供给,也有基础设施。缺失的环节是排序、维护可见性、归属权和安全执行,因此这是一个中等强度但竞争激烈的机会。
**++] 面向非工程团队的托管式智能体工作区** — Notion, Cursor, [Agno,以及 holaOS 都在暗示同一类产品:具备上下文、权限、审查闭环和操作历史的共享代理环境。之所以判断为中等机会,是因为需求显而易见且覆盖面广,但已有许多参与者开始围绕这一方向布局。
[+] 确定性的浏览器基础能力 —— 浏览器技能这种模式仍处于早期,但底层需求很明确,也很容易测试:代理不该在每次会话里都从头重新摸索 Cookie 横幅、无限滚动、日期选择器或登录流程。之所以说它仍处于新兴阶段,是因为目前公开需求还比较窄,但这个痛点非常具体,而且只要代理接触开放网络,就很可能反复出现。
8. 要点
- 最便宜的 token,就是代理根本不用读取的那个。 @dunik_7 认为(43 个赞、13 条回复、39 次收藏、4,130 次浏览)表明,上下文裁剪比更换模型更重要;而 @DailyDoseOfDS_ 报告了(34 个赞、3 条回复、34 次收藏、3,959 次浏览)则显示,在加入更强的上下文层后,token 数量从 10.4M 降到了 3.7M。
- 持久化工作区正成为应对代理重置问题的主要答案。 @hasantoxr 将其定义为(148 个赞、15 条回复、47 次收藏、36,444 次浏览)展示了同一工作区内第 2、3、10 次运行时,“玩具”和“队友”之间的差别;而 @cursor_ai 补充说(106 个赞、4 条回复、11 次收藏、6,198 次浏览)则展示了带有回滚和范围受限密钥的可复用多仓库环境。 3.代理编排正被当作控制平面来评估,而不再只是新奇的演示。 @NotionHQ 展示了(176 个赞、10 条回复、14 次引用、17,476 次浏览)展示了如何在熟悉的工作区内完成路由与审批;@DataScienceDojo 描述了(3 个赞、7 次收藏、984 次浏览)则将其归入同一类别,视为一个决定路由、记忆与故障处理的协调层。
- 技能层如今供给充足,但信任仍然不足。 @milesdeutscher 推动了(139 个赞、21 条回复、282 次收藏、12,739 次浏览)让一个已索引逾百万项技能的市场受到高度关注;@KayvonJafar 强调了(1 个赞、1 次收藏、26 次浏览)则认为,Obsidian 的第一方技能可能比市场中匿名发布的条目更可信。
- 如今,无论是业余用户还是企业使用代理,安全都成了关键门槛。 @Haleeeemahh 描述了(45 个赞、33 条回复、635 次浏览)提到,有人在用 vibe-coding 开发应用后遭到黑客攻击;@neil_xbt 认为(47 个赞、13 条回复、2,233 次浏览)指出,未经过沙箱隔离的代理在短期内可能带来安全事件风险;@Dinosn 指出(21 个赞、17 次收藏、1,051 次浏览)则介绍了一个面向代理、技能、MCP 和越狱攻击的公开扫描套件。
- 研究一方面在提高对记忆能力的标准,另一方面也对多智能体推理变得更加怀疑。 @DiWu0162 介绍了(4 个赞、1 条回复、1 次收藏、66 次浏览)介绍了一项记忆基准测试,覆盖 500 条轨迹和 115M 个 token,@jiqizhixin 报告了(3 个赞、2 个收藏、198 次浏览):关于终端代理的免训练上下文压缩;以及 @dair_ai 强调了(25 个赞、3 条回复、39 个收藏、2,479 次浏览):一篇认为多智能体系统可能会为了跟随群体而压制正确答案的论文。