Twitter AI Agent - 2026-05-19
1. 大家在讨论什么
1.1 托管运行时与 harness 控制已从理念走向正式产品能力 🡕
5 月 19 日最强的一组讨论,已经不再只是“为什么 agent 需要 harness”,而是厂商开始把 harness 作为产品能力直接交付。最有价值的帖子提到托管 Linux 环境、自托管沙箱、MCP 隧道、浏览器原生 QA,以及可安装的指导包。相比 5 月 18 日围绕指南、上线分工和信任护栏展开的讨论,5 月 19 日明显更进一步,转向第一方执行界面与验证工具。
@_vmlops 发帖称(367 次点赞,15,588 次浏览,348 次收藏)发布了一张《Claude Code 的 Harness 工程:设计指南》的封面。图片本身比配文更重要:它把可靠的 agent 系统拆解为控制平面、循环、恢复、权限、中断和验证,并用一句话概括核心论点:先系统,后模型。

@GoogleAIStudio 介绍了(704 次点赞,26 条回复,29,816 次浏览,285 次收藏)介绍了 Gemini API 上的 Managed Agents。产品主张非常具体:一次 API 调用,就能获得由 Google 托管、可扩展的远程 Linux 环境,并可用 Markdown 定义自定义指令、技能和工具。回复很快分成两派:一派看重更低的 agent 运维开销,另一派则担心定价和培训资料,这说明需求是真实存在的,即便这种运营模式仍然较新。
@ClaudeDevs 宣布(207 次点赞,15 条回复,8,456 次浏览,75 次收藏)讨论了用于 Claude Managed Agents 的自托管沙箱与 MCP 隧道。Anthropic 的 发布文章 和 文档 表示,工具执行既可以保留在客户可控的基础设施中,也可以放在 Cloudflare、Daytona、Modal 或 Vercel 等托管提供商上;同时,私有 MCP 服务器无需开放入站防火墙规则也能被访问。随后一条 回复(19 次点赞,3,851 次浏览)补充说,实时会话无需重启即可切换工具、MCP 服务器或 vault ID,还能把超大的 MCP 输出转存到沙箱文件中。

@Google 已推出(36 次点赞,4 条回复,10,950 次浏览,14 次收藏)将 Chrome DevTools for agents 视为浏览器原生验证层。Chrome 文档 和 GitHub 仓库 表示,它以 MCP 服务器、CLI 和技能包的形式发布,使 agent 能在上线前检查实时页面、模拟用户、运行 Lighthouse 审计并分析性能;第一条回复还提出了 WebMCP(26 次点赞,2 条回复,6,670 次浏览,16 次收藏),作为网站与编码 agent 之间的一座拟议桥梁。
@ChromiumDev 介绍了(20 次点赞,2 条回复,3,078 次浏览,10 次收藏)提到 Modern Web Guidance,这是一个面向 Antigravity CLI、Claude Code 和 Copilot 的可安装技能包。文档 表示,该包会持续更新,并经过专家审核,还提供 Baseline 回退方案,避免编码 agent 默认使用过时的 Web 模式。
讨论洞察: 这一整组主题背后的安全动机说得异常明确。@nazirtech01 表示(22 次点赞,1 条回复,1,657 次浏览,18 次收藏)表示,他们已经把所有 AI 编码 agent 项目切换到 npm ci --ignore-scripts,并加上 7 天的 Renovate 冷却期,因为 Claude 和 Codex 会毫不犹豫地安装幻觉出来的包。因此,沙箱、隧道和指导包的兴起,看起来更像是在回应已观察到的风险,而不只是厂商对产品做精细打磨。
与前一天相比: 5 月 18 日把 harness engineering 视为课程、发布纪律和信任基础设施;而 5 月 19 日则把这些理念做成了可执行的产品:托管运行时、具备边界感知的沙箱、浏览器 QA,以及可安装的指导包。
1.2 Agent-first 产品与编排器继续取代单 agent 聊天 🡕
第二组讨论聚焦于 agent 应该如何被呈现与协调。共同趋势是:不再把 agent 当作又一个侧边栏,而是把它视为具有委派、交接和明确隔离的长时运行工作者。相比 5 月 18 日更关注市场、商业化通道,5 月 19 日谈得更多的是执行界面、编排命令,以及工作究竟应该在哪里运行。
@antigravity 介绍了(793 次点赞,132 条回复,33 条引用,33,684 次浏览,285 次收藏)介绍了 Antigravity 2.0:一款独立桌面应用,围绕多 agent 团队、定时任务、原生语音,以及与其他 Google 产品的一键集成进行重构。这次发布将其定位为为 agent 优化的桌面环境,而不只是更好的 IDE 扩展。
@Google 强调了(246 次点赞,23 条回复,21,089 次浏览,23 次收藏)进一步明确了这一定位,直接把该应用称为“agent-first”,以 agent 对话、agent 生成的产物和多 agent 编排为核心。回复不断回到同一个区分点:大多数软件仍然是以文件或应用为中心,而这次发布则把 agent 作为主要界面。
@lobehub 发布了(383 次点赞,62 条回复,67 条引用,580,400 次浏览,133 次收藏)介绍了一个 Chief Agent Operator:它可从拥有 27.3 万项技能的市场中“雇佣” agent,在云端 24/7 运行,并通过 IM 应用汇报。一条来自 @CatCatBros 表示(5 次点赞,2 条回复,590 次浏览)的回复称,Discord 连接“极其简单”,这让通过 IM 路由汇报的说法,更像是一个易用性故事,而不只是对市场规模的炫耀。
@warpdotdev 宣布(110 次点赞,11 条回复,5 条引用,5,738 次浏览,27 次收藏)讨论了 Oz 中面向 Claude Code、Codex 和 Warp Agent 的多 agent 编排。原始推文只是发布预告;真正有分量的是后续回复:本地 subagent 拥有各自的工作树,云端 subagent 拥有隔离的 Docker 容器,本地会话还能在夜间交接给云端继续执行。
@Saboo_Shubham_ 展示了(57 次点赞,13 条回复,2,552 次浏览,65 次收藏)展示了一个 Hermes 工作流:由看板拆解任务,SmallCode 加 Ollama 处理范围窄的编码任务,Claude 或 Codex 则负责高难度规划与模糊工作。图片之所以重要,是因为它把路由策略具体展示出来,而不是仅仅把“多 agent”停留在模糊承诺上。
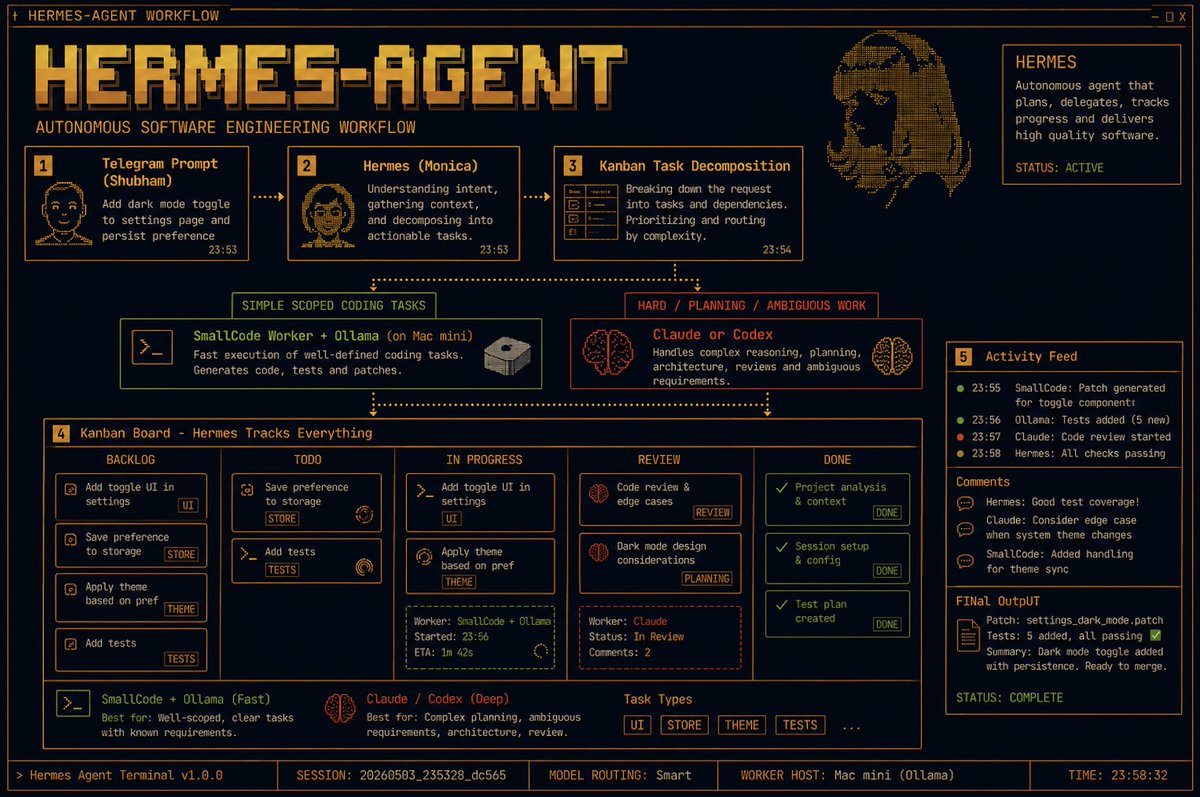
讨论洞察: 最有力的纠偏来自 @pvncher:他先在 认为(78 次点赞,10 条回复,12,674 次浏览,67 次收藏)中主张用 manager 主导的编排取代 swarm,然后又在 回复(2 次点赞,2 条回复,145 次浏览)中指出,任意 agent 间消息传递会引入无关细节;并行最适合只读工作,而写路径则需要加锁和验证。这与当天的产品发布形成呼应:胜出的模式不是让 agent 之间说更多话,而是给它们建立更清晰的边界。
与前一天相比: 5 月 18 日的 operator 层更偏向市场、结算和云 operator;而 5 月 19 日延续了 operator 叙事,但把重点落在隔离工作树、隔离容器和 agent-first 界面上。
1.3 记忆、上下文与技能开始成为真正的控制界面 🡕
当天最有实质内容、且非发布类的讨论,是关于 agent 在多次运行之间携带什么:受限上下文、结构化记忆、自我纠错存储,以及会随时间演化的技能。当天几条最强势的帖子明确表示,agent 策略本质上就是数据策略,或者说 Markdown 技能文件正在成为一种新的软件单元。相比 5 月 18 日强调可移植性,5 月 19 日进一步深入到归属、失效和检索设计。
@Aurimas_Gr 梳理了(141 次点赞,7 条回复,6,206 次浏览,147 次收藏)把 agent 记忆拆分为情节记忆、语义记忆、程序性记忆和短期工作记忆。图片把这一结构具体化:私有知识库和 embeddings 构成语义记忆,提示词与工具注册表构成程序性记忆,而 orchestrator 在运行时组装短期工作记忆。

@levie 认为(116 次点赞,22 条回复,18,427 次浏览,123 次收藏)指出,企业 agent 策略中最大的挑战,是为 agent 提供恰当且受约束的上下文,因为冲突信息过多或上下文过少,都会破坏结果。回复进一步点明痛点:@tokenomicz 表示(16 次浏览)表示,当文档、聊天记录和表格相互矛盾时,上下文的归属比上下文规模更重要;而 @jatingargiitk 表示(31 次浏览)则表示,难点在于持续维护,因为数据在清理后的第二天就开始腐坏。
@garrytan 表示(141 次点赞,24 条回复,16,488 次浏览,125 次收藏)表示,动态技能之所以强大,是因为 Markdown 就是代码,agent 可以在出现新场景时修改它。该推文引用的例子把这一方向推得更远:技能包应自带测试,agent 应被允许在运行过程中更新工具,而不是停留在静态库上。
@tom_doerr 分享了(30 次点赞,2 条回复,1,719 次浏览,32 次收藏)提到 Pro Workflow,其 GitHub 仓库 描述了一个统一的 SQLite 存储,用于自我纠错记忆、FTS5 索引 wiki 和自动研究循环。这一承诺立刻招来了恰当的质疑:@Timur_Yessenov 回复(16 次浏览)指出,自我纠错记忆同样需要一条坏记忆路径,让已失效的假设能够被撤销,而不只是被记住。
@Ghast_AI 开源了(15 次点赞,2 条引用,767 次浏览)提到 Anamnesis,其 仓库 描述它是一个 local-first 的记忆桥,可在 Claude Code、Codex、Hermes、OpenClaw、mem0、Letta 和通用 MCP 来源之间导入并提供已有记忆。这个信号不如其他帖子大,但它契合了同样的需求:记忆应归用户所有,而不应属于某一个 agent 运行时。
讨论洞察: 最具体的实现警告来自 @0xMevu,他在 回复(41 次浏览)中表示,在一个编码 agent 里,向量记忆因过时的工具输出而污染了约 3,000 条记录的召回,直到他改用 append-only 事件日志和回放才解决。当天对记忆的态度很积极,但对检索与遗忘的问题并不天真。
与前一天相比: 5 月 18 日强调的是技能、线程以及跨 agent 的可移植性;而 5 月 19 日花了更多篇幅讨论谁拥有上下文、记忆如何组织,以及当记忆出错时会发生什么。
1.4 语音 agent 看起来更可部署,也更不像演示了 🡕
语音依然是最清晰的应用型 agent 集群之一,但证据重心已转向交付机制:基于 IDE 的构建流程、面向呼叫中心的专门设计、自动生成的集成,以及教育等垂直场景。相比 5 月 18 日,更多讨论开始把语音 agent 当作普通的软件交付目标,而不是独立的“惊艳演示”。
@tec_aryan 表示(67 次点赞,24 条回复,15,860 次浏览,8 次收藏)表示 PolyAI 已向所有人开放其语音 agent 平台。最有力的证据来自后续回复:@tec_aryan 表示(16 次点赞,709 次浏览)表示,开发者无需专业服务或六位数合同,就能在 10 分钟内部署一个可用于生产环境的语音 agent;另一条 回复(13 次点赞,478 次浏览)则称,该平台已为 FedEx、Marriott、Caesars 和 Gordon Ramsay restaurants 的客户对话提供支持。
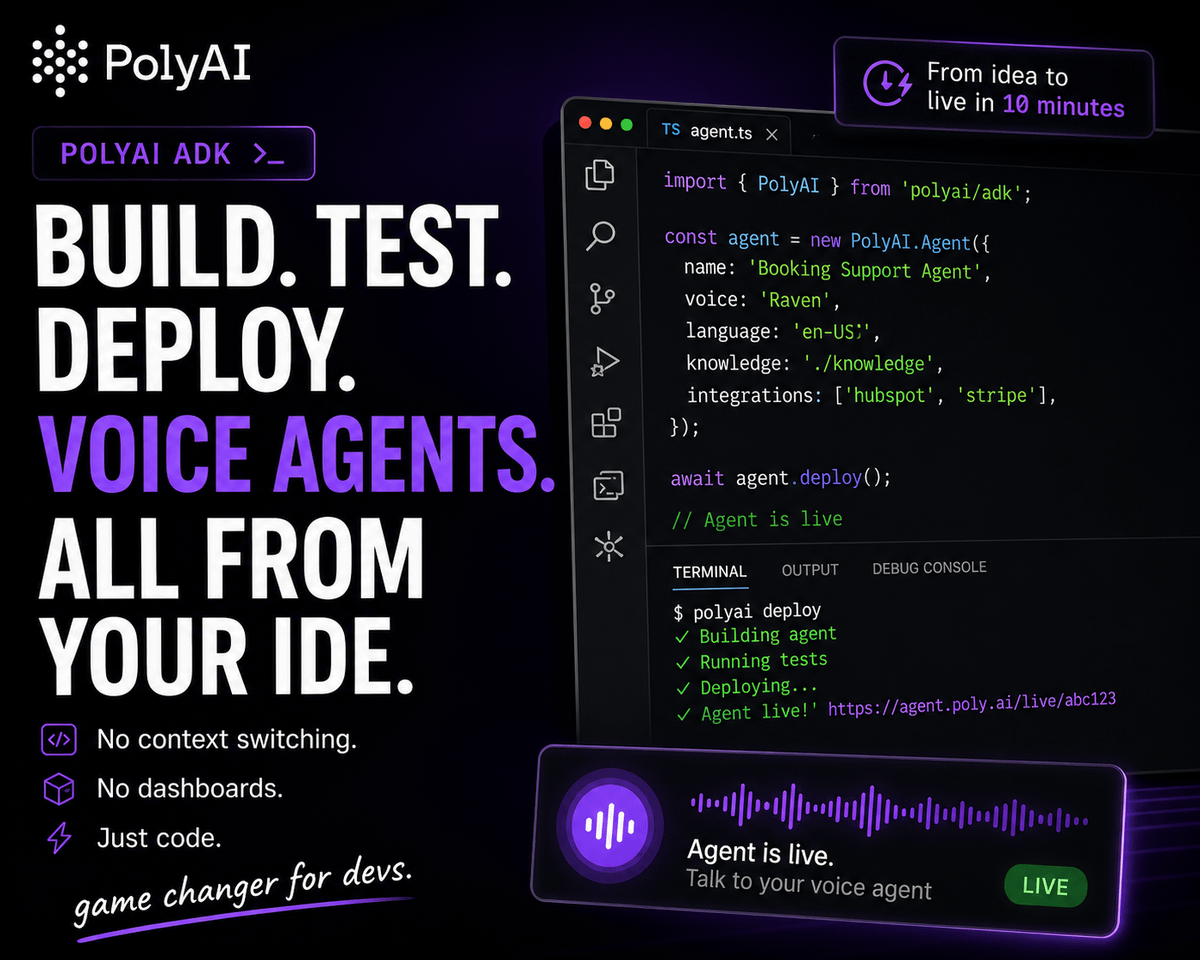
@TheAIColony 声称(110 次点赞,12 条回复,7,601 次浏览,84 次收藏)表示,Claude 加 PolyAI 可以在 10 分钟内构建一个能接听电话、筛选销售线索并服务客户的语音 agent。单看这一条,它更像是一个搭建演示;但结合前面更长的 PolyAI 讨论串,它读起来更像是一个逐渐成形的开发者工作流。
@ElevenLabs 发布了(197 次点赞,19 条回复,13,803 次浏览,47 次收藏)提到一个 Einstein agent,可将档案材料转化为面向教育的交互式语音体验。回复很有用,因为并非一边倒地正面:一条来自该公司的回复强调多语种教育价值,另一条则称其是“一个带口音、非常昂贵的搜索引擎”,从而把真实效用与新奇感区分开来。
@Google 介绍了(47 次点赞,6 条回复,3,666 次浏览,5 次收藏)提到 Gemini Spark:一个与 Gmail 和 Docs 绑定的后台个人 agent,即使笔记本电脑合上后也会继续工作。它并不严格属于语音 agent 帖子,但它强化了同样的转变:agent 正在处理长时间运行的现实任务,而不是等待下一次 prompt。
讨论洞察: 最清晰的差异点来自 @tec_aryan 称(14 次点赞,1 条回复,882 次浏览),其观点是大多数 AI 语音工具原本是聊天机器人系统,后来才被改造,因此至今仍难以处理打断、口音、背景噪音和正常的人类对话。这使得面向电话系统的专用设计,成为真正的产品楔子,而不只是品牌说法。
与前一天相比: 5 月 18 日语音 agent 已经很活跃,但 5 月 19 日进一步提供了证据,表明它们可以通过常规开发者工作流构建、测试和部署,而不必依赖定制化企业项目。
2. 什么让人沮丧
上下文质量失效的速度,快于上下文窗口扩张的速度
严重程度:高。@levie 认为(116 次点赞,22 条回复,18,427 次浏览,123 次收藏)指出,大多数企业 agent 失败,本质上都是数据策略失败:冲突信息过多,或可用上下文过少,都会破坏结果。回复把这种失效模式说得更尖锐:@tokenomicz 表示(16 次浏览)表示,当文档、聊天和表格彼此矛盾时,上下文归属至关重要;@jatingargiitk 表示(31 次浏览)则说,真正困难的是持续维护,因为清洗过的数据会立刻开始腐坏。@DailyDoseOfDS_ 分享了(11 次点赞,1 条回复,2,505 次浏览,17 次收藏)还引用了一项说法:通过 InsForge 打包后端上下文后,Claude Code 的使用量从 10.4M tokens 和 10 个错误,降到了 3.7M tokens 和 0 个错误。这是该数据集中最具体的证据,证明上下文打包会改变成本和故障率。应对模式已经很明显:缩小任务范围、建立单一事实来源,以及预先组装的上下文层,而不是反复发现。值得投入建设,因为人们已经在消耗 token 和工程时间来给这个问题打补丁。
安全边界依然依赖硬隔离与更严格的包管理卫生
严重程度:高。@ClaudeDevs 宣布(207 次点赞,15 条回复,8,456 次浏览,75 次收藏)提到自托管沙箱和 MCP 隧道,使托管 agent 能在客户基础设施内执行,并在不公开暴露私有服务的情况下访问它们。@nazirtech01 表示(22 次点赞,1 条回复,1,657 次浏览,18 次收藏)表示,他们现在强制使用 npm ci --ignore-scripts 并设置 7 天的 Renovate 冷却期,因为 Claude 和 Codex 会安装幻觉出来的包。@DarkWebInformer 分享了(18 次点赞,2 条回复,2,848 次浏览,22 次收藏)提到 Pentest Agent Suite,但即便这种安全响应也隐含着同样的结论:如果执行、依赖和工具访问没有被严密控制,agent 的自主性就会扩大攻击面。目前的应对办法是分层隔离、保守的包策略,以及更明确的权限边界。值得投入建设,因为人们已经在手动修改安装和运行时策略。
同时有太多 agent 写入时,多 agent 协作会退化
严重程度:中。@pvncher 认为(78 次点赞,10 条回复,12,674 次浏览,67 次收藏)指出,manager 主导的编排优于 swarm,随后 回复(2 次点赞,2 条回复,145 次浏览)进一步表示,任意 agent 间消息传递会引入无关细节,而写路径需要加锁和验证。@warpdotdev 回答了(110 次点赞,11 条回复,5,738 次浏览,27 次收藏)提到本地使用隔离工作树、云端使用隔离 Docker 容器;@Saboo_Shubham_ 展示了(57 次点赞,13 条回复,2,552 次浏览,65 次收藏)则展示了一个 Hermes 看板,把范围窄的任务路由给一类 worker,把模糊工作交给另一类。解决办法是串行拆解加上强隔离,而不是让更多 agent 彼此交谈。值得投入建设,因为社区现在已对什么会出问题、以及怎样做隔离形成了清晰判断。
记忆系统仍然需要“遗忘”,而不只是“检索”
严重程度:中。@Aurimas_Gr 介绍了(141 次点赞,7 条回复,6,206 次浏览,147 次收藏)提出了一个分层记忆模型,但更有启发性的证据来自回复:@0xMevu 表示(41 次浏览)表示,过时的工具输出污染了召回,直到改用 append-only 事件日志和回放才解决;@Timur_Yessenov 回复(16 次浏览)则指出,自我纠错记忆需要一条明确的坏记忆路径。当天充满了记忆产品和框架,但最清晰的痛点是失效处理:如何撤销或隔离那些曾经有用、如今却已错误的记忆。值得投入建设,因为当前系统更容易记住,而不擅长遗忘。
3. 大家希望出现什么
能跨工具、且始终归用户所有的可移植记忆
人们显然在要求一种能在 harness 切换后依然保留、且不会把他们锁定在某个运行时中的记忆。@tom_doerr 分享了(30 次点赞,2 条回复,1,719 次浏览,32 次收藏)提到 Pro Workflow 基于 SQLite 的记忆和 wiki 存储;@Ghast_AI 开源了(15 次点赞,2 条引用,767 次浏览)提到 Anamnesis 作为跨 Claude Code、Codex、Hermes 等工具的桥梁;@warpdotdev 搭配了 则提到 Oz 的跨 harness Agent Memory 候补名单。这里的紧迫性是现实性的,而非愿景性的:人们已经有上下文被困在多个系统里,不想每次切换工具都从零开始。机会:直接。
可测试、可打包、且允许演进的技能系统
现在的诉求已不再只是“更多技能”。@garrytan 表示(141 次点赞,24 条回复,16,488 次浏览,125 次收藏)表示,agent 应该能在运行中更新 Markdown 技能;@kotlin 发布了(62 次点赞,1 条回复,1,938 次浏览,29 次收藏)提到一个官方 GitHub 仓库,提供可安装的 Kotlin agent 技能;@DanKornas 展示了(10 次点赞,2 条回复,509 次浏览,15 次收藏)则提到 Skill Conductor,它把技能编写视作 create、eval、edit、review 和 package,而不是“写一个 SKILL.md 然后听天由命”。尚未满足的需求,是为技能建立真正的软件生命周期:架构选择、测试、打包、分发和安全修订。机会:直接且竞争激烈。
默认具备私有执行与私有工具访问能力
最大的基础设施诉求,是让 agent 在不离开组织边界的情况下依然有用。@ClaudeDevs 已发布 提到自托管沙箱加 MCP 隧道,而 @GoogleAIStudio 介绍了 则提到 Gemini API 上的托管 Linux 环境。两条讨论串呈现出同样的模式:团队想要托管编排,但不想为此放弃网络策略、私有服务或文件系统控制。机会:直接且竞争激烈。
像正常生产软件一样工作的语音 agent 构建器
语音类帖子并不是在要求更好的演示,而是在要求可部署的系统。@tec_aryan 表示(67 次点赞,24 条回复,15,860 次浏览,8 次收藏)表示,PolyAI 现在允许任何人从 IDE 快速构建并部署可用于生产的语音 agent,而后续讨论串强调,真正的差异点在于中断处理、口音适配和通话流程可靠性。@ElevenLabs 展示了 提到一个面向教育的语音 agent,@Google 介绍了 则提到 Gemini Spark 作为一个在笔记本合上后依然继续工作的后台个人 agent。缺少的并不是兴趣,而是长时运行的语音与任务 agent 的可靠、生产级交付路径。机会:直接且竞争激烈。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Gemini API Managed Agents | Agent 运行时 | (+/-) | 一次 API 调用即可提供远程 Linux 环境,并用 Markdown 定义指令、技能和工具 | 回复立刻提出定价和上手问题;公开的运行细节仍然较少 |
| Claude Managed Agents | 托管 agent 运行时 | (+) | 自托管沙箱、MCP 隧道、实时切换工具与 MCP、大输出可转存到沙箱文件 | 自托管沙箱目前尚不支持记忆;MCP 隧道仍处于研究预览阶段 |
| Chrome DevTools for agents | 调试 / MCP | (+) | 实时浏览器检查、Lighthouse 审计、模拟、截图、性能分析,以及 CLI 与技能 | 仅限浏览器场景,且会有意向 MCP 客户端暴露浏览器状态 |
| Modern Web Guidance | 技能包 | (+) | 持续更新、经专家审核的 Web 技能,并提供 Baseline 回退;可安装到主流编码 agent 中 | 聚焦范围较窄,仅限 Web 开发 |
| Warp Oz | 编排平台 | (+/-) | 跨 Claude Code、Codex 和 Warp Agent 的多 harness 编排,支持隔离工作树与云容器 | 仍处于 beta;Agent Memory 仅在研究预览阶段 |
| Hermes Agent | 编排器 / 运行时 | (+/-) | 明确的看板式任务拆解、适用于简单任务的本地 scoped worker,以及更强模型负责规划和评审 | 需要严格的范围控制和路由;类似 swarm 的写路径仍被视为高风险 |
| Pro Workflow | 记忆 / 上下文层 | (+) | 基于 SQLite 的自我纠错记忆、FTS5 wiki、自动研究循环、跨会话召回 | 即便支持者也希望增加坏记忆路径和明确的失效机制 |
| PolyAI ADK | 语音 agent 平台 | (+) | 可从 IDE 构建、测试和部署语音 agent,具备面向电话系统的流程和自动生成的集成 | 公开证据目前仍主要来自发布讨论串细节和企业客户案例,而非广泛用户评价 |
| InsForge | 后端上下文层 | (+) | 通过 MCP 和 CLI 在一个地方暴露后端拓扑,据称可将 token 用量从 10.4M 降至 3.7M | 最适合愿意将 InsForge 作为后端控制界面的团队 |
| Pentest Agent Suite | 安全框架 | (+/-) | 大型跨工具套件,包含 50 个 agents、26 个命令、19 个 CLI 工具、11 个技能和 2 个 MCP 服务器 | 安全探测仍需更多证据与验证,避免幻觉式发现 |
| Kotlin agent skills | 语言技能包 | (+) | 可复用的迁移与工具类技能,采用标准 SKILL.md 文件夹打包 | 仅适用于 Kotlin,目录也更像 incubator 风格 |
| Skill Conductor | 技能生命周期方法 | (+) | 先架构后编写的 create、eval、edit、review、package 流程,在写 SKILL.md 前就要求明确模式选择 | 相比快速的 prompt-to-skill 工作流,流程更重 |
当工具能把边界讲清楚时,整体满意度更偏正面:自托管沙箱、工作树、容器、浏览器 QA 和官方技能包都获得了较好的关注。情绪变得复杂的地方,往往是工具又引入了一层仍需治理的新抽象,比如多 harness 编排、跨会话记忆,或缺少强证据支撑的安全自动化。
迁移路径也越来越容易描述。团队正在从 prompt-first 配置转向 architecture-first 技能,从反复发现转向预打包的上下文层,从单 agent 聊天转向本地与云 worker 的编排协作,以及从记忆孤岛转向可移植或自托管的记忆存储。竞争压力也越来越清晰:Google 和 Anthropic 正在交付运行时,Chrome 和 Chromium 正在交付验证与指导,而社区则在围绕这些运行时争夺记忆、技能和 orchestration 层。
5. 大家在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Antigravity 2.0 | @antigravity | 独立的 agent-first 桌面应用,具备多 agent 团队、定时任务、原生语音和 Google 集成 | 聊天窗口式工作流不适合长时间运行的自主任务 | 桌面应用、多 agent 编排、原生语音、Google 产品集成 | 已发布 | 推文, 博客 |
| Managed Agents on Gemini API | @GoogleAIStudio | 托管式远程 Linux 环境,一次 API 调用即可启动带有自定义指令、技能和工具的 agent | 团队希望托管执行,但不想手工搭建运行时管线 | Gemini API、远程 Linux 环境、Markdown 技能和工具 | Beta | 推文 |
| Claude Managed Agents | @ClaudeDevs | 带有自托管沙箱和私有 MCP 隧道的托管 agent | 企业需要在自身安全边界内执行 agent 并访问工具 | Anthropic agent loop、自托管沙箱、MCP 隧道、Cloudflare/Daytona/Modal/Vercel | Beta | 推文, 博客, 文档 |
| LobeHub Chief Agent Operator | @lobehub | 从大型技能市场中挑选 agent,持续运行,并通过 IM 应用汇报 | 手工选择和监控 agent 过于繁琐 | 云端 agent 市场、IM 集成、技能目录 | 已发布 | 推文 |
| Oz + Agent Memory | @warpdotdev | 跨本地和云运行编排 Claude Code、Codex 与 Warp Agent;Agent Memory 旨在让学习成果跨 harness 持续存在 | 团队需要协调的多 agent 协作,但又不想被锁定在单一 harness 上 | 工作树、隔离 Docker 容器、多 harness 编排、可移植记忆 | Beta | 推文, 记忆 |
| Pro Workflow | @tom_doerr shared | 为 Claude Code 和其他 agent 增加自我纠错记忆、FTS5 wiki 和自动研究循环 | 重复的修正与研究会在会话间消失 | SQLite、FTS5、hooks、技能、agents | 已发布 | 推文, GitHub |
| PolyAI ADK / Agent Studio | @tec_aryan | 从 IDE 构建、测试和部署电话语音 agent,具备自动生成的知识与集成 | 大多数语音工具由聊天产品改造而来,难以应对真实通话流程 | TypeScript ADK、电话语音栈、HubSpot/Stripe 集成、Studio | 已发布 | 推文, Studio |
| Autogenesis | @AI4S_Catalyst | 自演化 agent 协议与运行时,可对 prompts、tools、memory、environments 和 agents 做版本管理与回滚 | 自我改进型 agent 需要明确的生命周期、版本管理与治理 | RSPL/SEPL 协议、tracing、versioning、tool-calling runtime | Alpha | 推文, 论文, GitHub |
| Pentest Agent Suite | @DarkWebInformer shared | 面向 Claude Code 和其他六种编码工具的自主化漏洞赏金框架 | 安全探测需要可重复、可跨工具迁移的 agent 工作流 | Python、50 个 agents、26 个命令、19 个 CLI 工具、11 个技能、2 个 MCP 服务器 | Alpha | 推文, GitHub |
| Kotlin agent skills | @kotlin | 面向迁移和工具任务的开源 Kotlin 专用技能仓库 | 团队希望获得可复用的语言专用技能,而不是每次迁移都重新写 prompt | SKILL.md 技能文件夹、plugin 和 npx 安装流程 | 已发布 | 推文, GitHub |
Google 和 Anthropic 当天都在从不同角度把同一个核心理念产品化:让编排继续托管,但让执行与控制界面更像真正的基础设施。Antigravity、Managed Agents on Gemini API、Claude Managed Agents 和 Oz 都在假设,下一个瓶颈不只是模型质量,而是 agent 如何被部署、隔离、恢复与观测。
第二种重复出现的构建模式,是把记忆和技能打包成耐久产物。Pro Workflow、Autogenesis 和 Kotlin agent skills 都把 prompts、规则、上下文或任务流程视为可存储、可版本化、可检索、可分发的软件,而不是一次性聊天上下文。即便它们解决的问题不同,也共享同一个前提:只有当 agent 能力能跨越单次会话存续,它才会产生复利。
最强的垂直构建方向是语音和安全。PolyAI 正在把语音 agent 变成开发者可从 IDE 构建和部署的东西,而 Pentest Agent Suite 则把漏洞挖掘工作流打包成一套可在编码工具间跟随用户迁移的 bundle。LobeHub 则位于两者之间,自己构建协调层:它不是再做一个 agent,而是试图同时掌控多个 agent 的选择、执行与汇报。
6. 新发布与值得关注的内容
Chrome DevTools for agents 达到稳定版 1.0
@Google 已推出(36 次点赞,4 条回复,10,950 次浏览,14 次收藏)发布了 Chrome DevTools for agents,@ChromiumDev 表示(17 次点赞,2 条回复,825 次浏览,9 次收藏)表示,它现在通过 MCP 服务器、CLI 和专用技能,把浏览器调试、模拟和 Lighthouse 审计提供给编码 agent。GitHub 项目 则明确指出更大的趋势:浏览器验证正被打包成可复用的 agent 基础设施,而不再是临时的手工步骤。
Gemini Spark 让后台个人 agent 更具体了
@Google 介绍了(47 次点赞,6 条回复,3,666 次浏览,5 次收藏)提到 Gemini Spark:一个与 Gmail 和 Docs 集成的个人 agent,即使笔记本电脑合上后也会继续运行。示例任务刻意选得很日常——协调街区派对的后勤事务——这让这次发布更值得注意,因为它讲的是后台任务完成,而不是聪明的聊天能力。
技能编写变得更正式了
@DanKornas 展示了(10 次点赞,2 条回复,509 次浏览,15 次收藏)提到 Skill Conductor,这是一种 architecture-first 的技能生命周期方法:在写下任何 SKILL.md 之前,先强制在若干模式中做出选择,然后进入 create、eval、edit、review 和 package 阶段。这之所以值得关注,是因为它不再把技能视为 prompt 片段,而更像是带有测试和发布纪律的软件组件。

Anamnesis 把记忆可移植性做成了一座 MCP 桥
@Ghast_AI 开源了(15 次点赞,2 条引用,767 次浏览)提到 Anamnesis,仓库 表示,它可以在 Claude Code、Codex、Hermes、OpenClaw、mem0、Letta 和通用 MCP 来源之间导入、标准化、索引并提供已有记忆。相比大规模发布,这只是一个较小信号,但它是最清晰地直接解决跨工具记忆碎片化问题的案例之一。
7. 机会在哪里
**+++] 私有执行加私有工具访问** —— Google Managed Agents 和 Claude Managed Agents 都指向同一项需求:团队希望使用托管式编排,但又希望执行环境、文件系统和内部服务仍由自己掌控。来自 [@nazirtech01 的软件包卫生警告 让这一点更加明显,因为它说明了企业为何首先会要求沙箱和更严格的策略边界。
[+++] 具备归属与失效能力的可移植记忆 — Pro Workflow、Anamnesis、Warp Agent Memory,以及记忆讨论串中的回复,都指向同一个缺口:人们想要能跨工具迁移、可自托管,并在必要时遗忘错误假设的记忆。这是一个强机会,因为这一需求同时出现在产品发布和实践者对过时召回的抱怨中。
[++] Architecture-first 的技能生命周期与精选技能包 — Garry Tan 关于动态技能的帖子、Kotlin 官方技能仓库、Skill Conductor 和 Modern Web Guidance,都把技能当作需要测试、打包和分发的软件产物。这里的机会属于中等而非完全空白,因为多个厂商和社区已经在快速推进。
[++] 具备隔离写路径的多 harness 编排 — Oz、Hermes 和 pvncher 的回复都在主张同一种运行模式:受限范围的 subagent、隔离,以及对写入任务采用串行拆解。这是一个有意义的机会,因为团队显然需要编排,但当前共识是:没有控制的 swarm 依然脆弱。
[++] 电话级语音 agent 构建器 — PolyAI、ElevenLabs 和 Gemini Spark 显示出明确需求:agent 要能处理电话、教育或长时运行的个人任务。最强的切入点不是“语音”本身,而是在打断、口音、背景噪音和长时间工作流下的可靠性。
[+] 高 token 效率的后端上下文层 — InsForge 引用的 10.4M 到 3.7M token 降幅,以及 Levie 关于上下文归属的讨论,都表明一个正在形成的细分方向:在 agent 开始编码前,预先组装好后端和组织上下文的系统。这仍处于早期,但在成本和错误率上的故事已经很有说服力。
8. 要点总结
- 托管执行成为当天最明确的产品信号。 Google 和 Anthropic 都推出了更强的运行时界面,这意味着 agent 可靠性正越来越多地被当作基础设施来销售,而不只是 prompt 技巧。(来源)
- 社区正在收敛到“有边界的编排”,而不是“无规则的 swarm”。 最有力的回复倾向于受限范围的 subagent、隔离的工作树或容器,以及对写入任务进行串行拆解。(来源)
- 企业 agent 质量问题,归根结底仍是上下文归属问题。 最有说服力的沮丧类帖子指出,相互冲突的数据源和不断衰败的知识库,会比更大的上下文窗口更快地拖垮 agent。(来源)
- 记忆现在既要可移植,也要可撤销。 记忆相关帖子的关键细节,不是 agent 应该记住更多,而是它们需要能在工具之间迁移记忆,并使过时召回失效。(来源)
- 语音 agent 开始越来越像正常的生产软件。 PolyAI 的讨论串是最清晰的信号,因为它描述了基于 IDE 的构建、测试和部署流程,以及真实客户通话场景中的落地。(来源)
- 技能正被越来越多地当作软件包,而不是 prompt 片段。 官方技能仓库、指导包和 architecture-first 的创建流程,都在指向带有测试、打包和发布纪律的技能。(来源)