Twitter AI Agent - 2026-05-20
1. 大家在讨论什么
1.1 语音代理的讨论重心变成了延迟预算,而不只是产品演示 🡕
5 月 20 日最明显的变化是,关于语音代理的讨论不再主要停留在垂直场景演示上,而是转向:要让语音真正可用,底层到底需要哪些分层架构和延迟预算。证据来自四条分量十足的内容:一边是新的语音技术栈,另一边是围绕首个 token 时间、工具调用和企业分发的基准测试讨论。相比 5 月 19 日侧重可部署的语音工作流和垂直演示,5 月 20 日花了更多篇幅讨论决定这些工作流是否自然流畅的基础设施。
@ElevenLabs 介绍了(171 个赞,10 条回复,15,281 次浏览,105 次收藏)将 Speech Engine 描述为一种只需一个提示词,就能把现有聊天代理变成语音代理的方法。文档 表示,该 SDK 让构建者继续掌控 LLM 和对话逻辑,而 ElevenLabs 负责语音转文本、文本转语音、轮次控制和打断检测;后续的 回复(11 个赞,1 条回复,1,034 次浏览)还补充说,底层文本代理本身无需改动。
@kwindla 发布了(77 个赞,11 条回复,7,820 次浏览,37 次收藏)公布了基准测试结果,显示 Gemini 3.5 Flash 在他的任务代理基准中成为新的综合第一,但对语音代理来说仍然太慢,因为首个 token 时间大约是一秒,而“我们确实需要把 TTFT 压到 700ms 以下”。附带表格之所以重要,是因为它显示 Gemini 3.5 Flash 虽然拿到了顶级通过率,却仍未达到他想要的延迟目标;而他在正文中也明确表示,Claude Haiku 4.5 仍然是在 TTFT 低于 700ms 条件下表现最好的模型。他还补充了一个价格层面的情况:在他的基准中,Gemini 3.5 Flash 比 GPT-5.4 和 Claude Sonnet 4.6 更贵。

@bridgebench 表示(62 个赞,18 条回复,4,641 次浏览)称 Gemini 3.5 Flash 以每秒 581.1 个 token 创下新的速度纪录,并认为这类速度才让实时语音编程和代理即时响应成为可能。但最有价值的修正来自回复区:在一位用户贴出竞争对手图表后,账号 回答了(1 个赞,141 次浏览)回了一句“只有速度,没有脑子”,这也精准概括了当天讨论中的紧张关系:一边是吞吐量的炫耀,另一边是真正的代理质量。
@Databricks 宣布了(74 个赞,3 条回复,3,884 次浏览,11 次收藏)称 Gemini 3.5 Flash 已经在 Databricks 上可用,并将其定位为适用于公司数据、具备治理和运维工具的企业级 Agentic AI 方案。这条信息的重要性不在于又一次模型发布,而在于它提供了分发层面的证据:围绕语音和代理基准的讨论,几乎立刻就被包进了生产级基础设施中。
讨论洞察: 分歧不在于语音代理是否重要,而在于现阶段最关键的瓶颈到底是什么。ElevenLabs 强调语音编排和打断处理,而基准测试讨论则不断把话题拉回 TTFT、工具调用和成本;结果是,这一天关于语音的讨论比前一天明显更偏向运营和工程落地。
与前一天对比: 5 月 19 日还在讨论语音代理终于可以通过常规开发者工作流来构建和部署。到了 5 月 20 日,讨论又下沉了一层,开始争论语音引擎、延迟预算,以及底层模型到底够不够快。
1.2 代理能力越来越多以捆绑包、目录和安装命令的形式交付 🡕
第二个讨论集群围绕“打包”展开。人们不再抽象地讨论技能和浏览器使用,而是开始分享可强制加载的技能包、代理可浏览的站点专属目录,以及能把最新专家知识拉入代理上下文的可安装指导包。这个主题有四条具体内容支撑,而不只是零散技巧。相比 5 月 19 日把技能当作一种控制界面和记忆产物来讨论,5 月 20 日在分发方式上更加具体。
@Teknium 表示(232 个赞,19 条回复,25,270 次浏览,82 次收藏)称 Hermes Agent 现已支持 Skill Bundles,允许用户预先定义一组技能,并通过一条斜杠命令强制加载。发布措辞本身很直接,但回复区里的细节更有意思:当有人问这是否意味着不再需要在工作流中创建技能时,Teknium 回答了(1 个赞,67 次浏览)回答:“No”,这让这个 bundle 功能看起来更像是打包和分发能力,而不是某种自动化魔法。
@NousResearch 宣布了(105 个赞,20 条回复,4,697 次浏览,66 次收藏)称 Hermes Agent 可通过 Browserbase 新推出的 browse.sh hub 使用数百种浏览器技能。该网站将其描述为一个浏览器 CLI 加一个开放式 Web 目录,涵盖技能、浏览器原语、调试和云会话,并表示其中推荐的 DOM 选择器和 XHR 请求可将 token 成本降低 50 倍。这使得这次发布不只是一个内容目录;它实际上是在宣称,浏览器自动化可以被压缩为可复用、站点专属的检索与操作原语。
@firt 分享了(3 个赞,346 次浏览,5 次收藏)Google I/O 发布的《现代 Web 指南》,而附带的幻灯片则把安装入口明确展示了出来:npx modern-web-guidance install。Chrome 文档 和 GitHub 仓库 表示,这是一个可长期适用、经过专家审校的技能包,旨在引导编码代理采用现代、可访问、高性能且安全的 Web API,而不是沿用过时模式。

@aiedge_ 分享了(26 个赞,4 条回复,1,322 次浏览,25 次收藏)提到了 Claude Code 的 Academic Research Skills 仓库,其 README 将其描述为一整套从研究到发布的技能套件。回复也立刻暴露出下一个问题:一位读者 询问了(14 次浏览)质疑它引用的是否是真实来源,还是编造了虚假的 DOI。由此可见,专业技能包如今被评判的已不只是便利性,还包括来源与验证是否可靠。
讨论洞见: 这一主题下最常见的修正意见是,打包降低了配置门槛,但并没有消除内容筛选与信任建立的工作。技能捆绑包仍然需要过硬的技能本身,浏览器目录仍然需要足够的网站覆盖,而垂直领域的技能包也仍然必须证明自己在引用和执行上都足够可靠。
与前一天的对比: 5 月 19 日将技能描述为一种新的软件单元,并强调了官方 Web 指南。到了 5 月 20 日,这一想法已经转化为具体的落地形态:强制加载的捆绑包、浏览器技能市场,以及一键安装。
1.3 比起更大的上下文窗口,上下文工程与评测获得了更多关注 🡕
5 月 20 日最强的一条研究主线,不是如何使用更大的上下文,而是为什么更大的上下文仍会失效,以及团队应该转而采取什么做法。证据来自四项内容,它们都强调了架构选择、诊断工作流,以及当前位置编码的局限。相比 5 月 19 日聚焦于记忆归属和陈旧召回,这一次的讨论更尖锐地指向了窗口内部究竟会在哪里出问题。
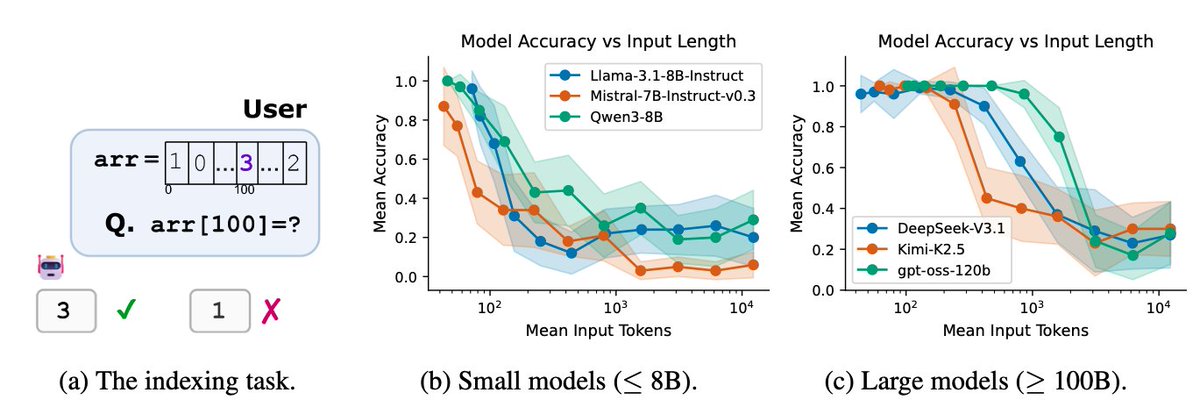
@haopeng_uiuc 分享了(165 个赞,5 条回复,13,084 次浏览,103 次收藏)提到一篇新论文,认为基于 RoPE 的长上下文模型在长度较大时,可能无法同时区分位置和 token。论文 表示,对于若干关键属性,其失败概率会逼近随机猜测;附图则显示,随着输入长度增加,会出现位置倒置、token 混淆,以及准确率崩塌。在回复中,作者 补充说(188 次浏览)表示,调整 RoPE 的 base 只是在不同失败之间做权衡,并不能解决任何一种;另一条回复则称,100 万上下文的营销说法“基本上是虚构的”。
@HSirui 介绍了(2 个赞,1 条回复,34 次浏览,1 次收藏)提到了用于 GUI 代理测试的 DiagEval,出发点是一个很直接的抱怨:当代理说“测试失败”时,你仍然不知道到底是产品坏了,还是评测器出了问题。论文 表示,其基于轨迹条件的探针可找回 45.6%-62.1% 的假阴性,并将 WebDevJudge-Unit 上的评测准确率从 69.9% 提升到 78.3%,将 RealDevBench 上的准确率从 65.0% 提升到 81.6%。虽然这条内容的互动量不高,但证据异常具体。
@himanshustwts 写道 表示,当下最受需求推动的技能包括构建代理、上下文工程、评测与 harness、分布式系统、推理工程和安全。这与其余数据的表现一致:相比只关注模型提示词,人们把更多时间花在代理看到了什么、如何评估它,以及如何选择它的架构上。
@dair_ai 认为(26 个赞,10 条回复,3,013 次浏览,26 次收藏)表示,生产级代理的构建者太常让框架默认设置替自己做出架构决策。回复从两个方向进一步点明了这一点:一位持怀疑态度的人说,这篇论文只是把每个 Claude/Codex 用户都得靠吃亏才学会的经验正式化了;另一位则表示,对检索层的调优往往忽略了一个事实:真正的瓶颈其实是 harness 的默认设置。讨论洞察: 这里的反驳是建设性的,而非一味否定。人们并没有否定上下文工程;他们的观点是,它必须带来更好的架构选择、更短且筛选更精细的上下文,以及比单纯反复重试智能体更强的诊断能力。
与前一日对比: 5 月 19 日将记忆与上下文框定为所有权和失效问题。5 月 20 日则更聚焦于长上下文的理论极限、架构分类,以及智能体运行失败时的评估协议。
1.4 安全智能体和治理层被视为运行时系统,而非核对清单 🡕
关于安全的讨论也变得更具操作性。帖子不再只是给出泛泛的警告,而是开始描述位于工具执行前的策略引擎、用于注册和管控智能体的平台层,以及能够修补或发现真实漏洞的安全智能体。共有四条独立内容支撑了这一主题。相比 5 月 19 日对自托管沙箱和私有 MCP 隧道的强调,5 月 20 日更多讨论了显式运行时控制,以及面向安全的智能体任务。
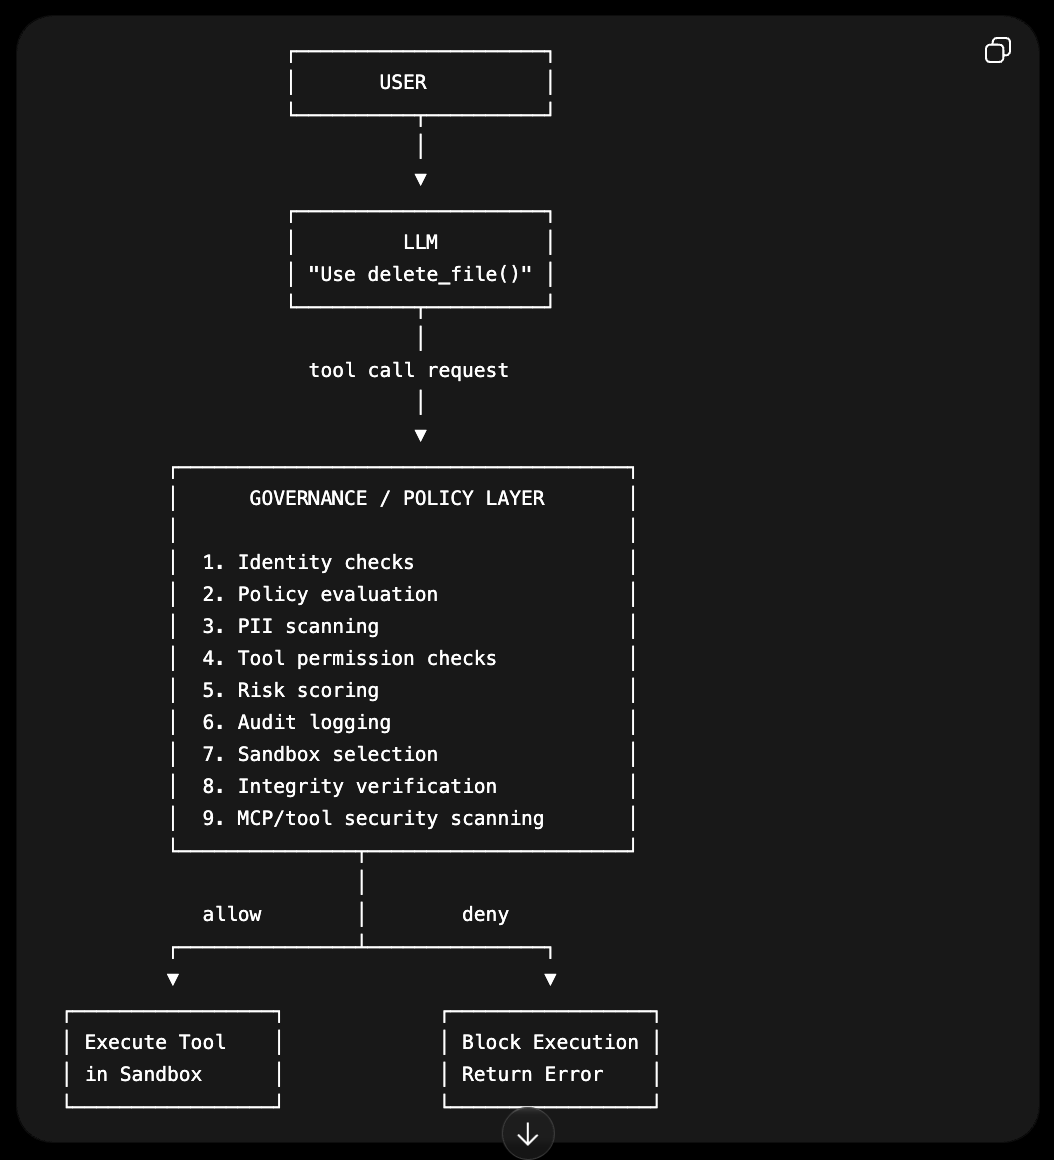
@bibryam 分享了(33 个赞,2 条回复,1,247 次浏览,31 次收藏)Microsoft 的 AI Agent Governance Toolkit,描述了确定性策略执行、零信任身份、执行沙箱化,以及面向自主智能体的 SRE。该仓库的 README 明确说明了其模型:每一次工具调用、资源访问和智能体间消息,都会在执行前接受策略评估;其示意图显示,诸如 delete_file() 这样的高风险调用,会先经过身份检查、策略评估、风险评分、审计日志记录和沙箱选择,然后才会被放行或拦截。
@GoogleCloud_ME 提到(12 个赞,95 次浏览,10 次收藏)指向 Gemini Enterprise Agent Platform 的集成治理能力。链接中的 Google Cloud 文章 表示,该平台以 Agent Identity、Agent Registry、Agent Gateway、Agent Runtime 和 Memory Bank 为核心,将信任与治理视为平台的核心能力,而不是附加功能。
@ralucaadapopa 表示(17 个赞,4 条回复,3,808 次浏览,11 次收藏)Google DeepMind 的 CodeMender 不只是发现漏洞,还会修补漏洞;其论点是,开发者已经被海量报告淹没,他们需要能够以智能体化的速度修复软件的智能体。这与 5 月 19 日“沙箱/控制”的安全智能体叙事不同:智能体现在成了修复闭环的一部分。
@nebusecurity 声称(306 个赞,7 条回复,42,538 次浏览,166 次收藏)其 Vega 安全智能体在此前一个问题已被修补后,又发现了一个新的 nginx 1.31.0 RCE。Nebula 的 网站 将 Vega 描述为该公司的漏洞发现系统,因此这是这组数据中最清晰的案例之一:安全智能体被与一项真实漏洞声明联系起来,而不只是基准测试或玩具演示。
讨论洞察: 最简洁的纠偏来自 @1clawAI 认为(5 个赞,2 条回复,71 次浏览):调用 API 的智能体与执行代码的智能体有着截然不同的攻击面;一旦智能体能够运行 Python、shell 命令或工作流,凭证和执行环境就需要更严格的隔离。这条内容热度不高,但与当天更大范围内转向策略层和沙箱的趋势一致。
与前一日对比: 5 月 19 日聚焦于具备边界感知能力的沙箱和浏览器验证。5 月 20 日则新增了显式策略引擎、平台治理对象、修补型智能体,以及公开的漏洞发现声明。
2. 什么让人感到沮丧
语音智能体仍然达不到自然交互所需的延迟预算
严重性:高。@kwindla 表示(77 次点赞,11 条回复,7,820 次浏览,37 次收藏)表示,当前的 Gemini 3 模型依然太慢,难以很好地用于语音代理,因为首 token 时间约为 1 秒,而“我们确实需要把 TTFT 降到 700ms 以下”;尽管如此,Gemini 3.5 Flash 已经成为他在 task-agent 基准上的新最高分。@bridgebench 展示了(62 次点赞,18 条回复,4,641 次浏览)创下了 581.1 tokens-per-second 的速度纪录,但随后一条 回复(1 次点赞,141 次浏览)又把这股庆祝气氛拉回到“只有速度,没有脑子”。当前的应对模式是分层:让 Speech Engine 这类系统处理轮次切换和打断,同时团队仍在积极寻找更低延迟的模型。这值得投入,因为需求强劲,而剩余障碍是具体且可度量的。
一旦代理能执行代码,仅靠提示词安全就不够了
严重性:高。@bibryam 分享(33 次点赞,2 条回复,1,247 次浏览,31 次收藏)展示了一套围绕确定性策略执行、零信任身份和执行沙箱构建的治理工具包,而 @GoogleCloud_ME 指出(12 次点赞,95 次浏览,10 次收藏)则指向一个围绕代理身份、注册表、网关和运行时控制构建的平台。最直白的一句来自 @1clawAI 表示(5 次点赞,2 条回复,71 次浏览):一旦代理能够运行任意 Python 或 shell 命令,攻击面就会彻底改变。应对办法是在执行前进行分层约束,而不是在提示词里写得更客气。这值得投入,因为即便是在互动不多的从业者讨论串里,风险边界如今也已得到广泛认知。
长上下文能力的宣传,在代理工作负载下仍会失灵
严重性:高。@haopeng_uiuc 认为(165 次点赞,5 条回复,13,084 次浏览,103 次收藏)指出,长上下文 LLM 的失败是 RoPE 的内在问题,而不只是实现缺陷,并明确表示,对外宣称的上下文长度应谨慎看待。在回复中,他 表示(188 次浏览)表示,调整 RoPE base 只是用一种失败换另一种失败;另一条回复则称 1M 上下文的营销“基本上就是虚构”。同一条推文里也能看到应对模式:把工作拆分为更短的上下文,并依靠 agentic framework 来组织状态,而不是相信一个巨大的窗口。这值得投入,因为代理工作负载恰恰就是那类多轮、会调用工具、长时程的任务,最容易触发这些限制。
GUI 代理上线失败后,团队仍不知道到底哪里出了问题
严重性:中。@HSirui 发布(2 次点赞,1 条回复,34 次浏览,1 次收藏)在指出“测试失败”并不能告诉你究竟是应用坏了,还是评估器失效之后,提出了 DiagEval。论文 表示,有针对性的诊断探针可以挽回 45.6-62.1% 的假阴性,并显著提升 WebDevJudge-Unit 和 RealDevBench 两项基准的准确率。当前的应对方式是在失败后加入定向诊断,而不是盲目重试。这值得投入,因为团队已经在用 GUI 代理测试 vibe-coded 应用,但通过/失败信号仍然过于模糊,难以信任。
3. 人们希望出现什么
可直接接入、且保留现有聊天逻辑的语音层
开发者想要的不是另一个完全托管的演示,而是一层可以接到他们现有系统上的语音层。@ElevenLabs 推出(171 次点赞,10 条回复,15,281 次浏览,105 次收藏)将 Speech Engine 准确描述为这种产品,而 文档 则表示,它把 LLM 选择、路由、上下文管理和工具调用都留在开发者自己的服务器上。其紧迫性来自现实:下一个障碍是延迟,而不是兴趣。机会:直接,且竞争激烈。
在工具调用落地前执行策略约束的执行平面
基础设施层面的诉求是:只有在身份、权限、风险和沙箱检查全部完成后,代理才能执行代码。@bibryam 分享(33 次点赞,2 条回复,1,247 次浏览,31 次收藏)展示了一套围绕这一模型构建的工具包,而 Gemini Enterprise Agent Platform 这条帖子则用平台术语描述了同样的需求:Agent Identity、Registry 和 Gateway。@1clawAI 表示(5 个赞,2 条回复,71 次浏览)最直接地点出了这一点:可执行代码的智能体改变了攻击面。机会:直接。
带溯源信息的精选技能包与浏览器目录
人们显然想要可复用的智能体能力,但也希望它们是打包好的、可安装的、可信的。@Teknium 发布(232 个赞,19 条回复,25,270 次浏览,82 次收藏)为 Hermes 推出了 Skill Bundles,@NousResearch 接入 将 Hermes 接入 browse.sh 的浏览器技能目录,而 Google 展示了 Modern Web Guidance,将其作为可安装的专长包。围绕学术技能的回复表明,缺失的一环在于:用户还希望有证据证明,一个技能包确实引用了真实来源,并且行为可靠。机会:直接且竞争激烈。
让智能体在运行后更好地演化上下文并诊断失败的方法
这里的需求有两个方面。@haopeng_uiuc 认为(165 个赞,5 条回复,13,084 次浏览,103 次收藏)认为超大上下文本质上并不可靠,而 @HSirui 展示(2 个赞,1 条回复,34 次浏览,1 次收藏)则认为,智能体上线失败后需要的是诊断,而不只是重试。另一个较弱但起支持作用的信号来自 @oliviscusAI 总结(11 个赞,3 条回复,426 次浏览,8 次收藏):它把 ACE 定义为一个“生成器—反思器—策展器”循环,能够根据执行反馈更新操作手册;与此同时,ACE AppWorld repo 展示了离线和在线两种适配工作流。目前缺少的是一个被广泛采用的层,能够在不进行昂贵微调的情况下,让上下文保持紧凑、最新且具备自我纠错能力。机会:直接。
4. 在用的工具与方法
| 工具 | 类别 | 情绪倾向 | 优势 | 局限 |
|---|---|---|---|---|
| ElevenLabs Speech Engine | 语音栈 | (+) | 为任何现有聊天智能体加入 STT/TTS、轮次控制、流式处理和打断处理,同时让 LLM 逻辑保留在构建者自己的服务器上 | 仍然依赖底层模型的延迟和工具调用质量 |
| Gemini 3.5 Flash | LLM | (+/-) | 在 BridgeBench 上创下 581.1 tok/s 的速度纪录,并在一个高要求的任务型智能体基准中位列第一,工具调用能力也强于更早的 Gemini Flash 变体 | 约 1s 的 TTFT 仍未达到语音智能体的目标;基准作者称其成本可能高于 GPT-5.4 和 Claude Sonnet 4.6 |
| Claude Haiku 4.5 | LLM | (+) | 在 kwindla 的测试中,它在 TTFT 低于 700ms 的选项里仍是表现最好的,而这正是语音构建者想要的阈值 | 属于较早一代模型;并未被描述为任务型智能体的总体最佳得分者 |
| Hermes Agent | 智能体运行时 | (+/-) | Skill Bundles 让团队可以强制加载可复用的能力包;更广泛的生态还加入了浏览器技能,以及创作者共享的记忆/看板更新 | 就连其自身的回复也承认,打包并不能消除技能创建工作 |
| browse.sh | 浏览器自动化目录 | (+) | 提供开放的 Web 目录、浏览器原语、调试能力,以及推荐的选择器/XHR 请求,旨在让网页任务更可靠、更省 token | 需要针对具体网站做覆盖,而且仍然建立在浏览器自动化本身的复杂性之上 |
| Modern Web Guidance | 技能包 | (+) | 常新、经专家审核的 Web 指南,支持一条命令安装,并采用现代 API 模式 | 聚焦范围较窄,仅限 Web 开发 |
| AI Agent Governance Toolkit | 治理/安全 | (+) | 提供执行前的确定性策略检查、零信任身份、沙箱、审计日志,以及对广泛框架的支持 | 仍处于公开预览阶段,因此团队应预期 GA 前会有变动 |
| Gemini Enterprise Agent Platform | 智能体平台 | (+/-) | 将智能体运行时、记忆、身份、注册表、网关、评估和可观测性整合到一个企业平台中 | 在这组数据里,公开的实际上手证据仍然不多,而且平台复杂度较高 |
| 面向智能体的 Chrome DevTools | 验证 / MCP | (+) | 为智能体提供实时浏览器检查、响应式测试、限速,以及调试/优化工作流 | 仅限浏览器范围,而且只有当智能体已经接入浏览器循环时才有用 |
| 学术研究技能 | 领域技能包 | (+/-) | 在一个可安装的 Claude Code 包中涵盖研究规划、写作、审阅和修订 | 回复随即提出了溯源方面的担忧,即输出是否忠实引用了真实来源 |
当工具充当模型外围的脚手架时,整体满意度更偏正面:语音编排、浏览器技能目录、现代 Web 指南和治理层都获得了不错的反响,因为它们减少了运营工作。而当原始模型的速度、成本或可信度问题仍未解决时,情绪就转为复杂,尤其是在语音工作负载和专用技能包上。
常见的变通方案也很明确。构建者会通过专门的语音层来承接语音能力,在更新模型赢得更广泛基准时仍选择延迟更低的模型,安装精选技能而不是从零开始写提示,并在工具执行前插入策略检查。迁移趋势也很清晰:正在从单纯的提示工程转向上下文工程、包式技能、浏览器专用目录和运行时治理。竞争压力同样十分明显:Google 正在主打模型速度和平台治理,ElevenLabs 正在争夺语音层,Microsoft 正在主打策略执行,而 Hermes、Browserbase 和 Chrome 则在竞争谁能掌控围绕智能体的可复用能力层。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Speech Engine | @ElevenLabs | 为现有聊天智能体加入实时语音输入/输出、轮次控制和打断处理 | 构建者想要语音能力,但不想重写现有聊天智能体逻辑 | ElevenLabs STT/TTS、WebSocket 会话、任意 LLM、浏览器流式处理 | 已发布 | 推文, 文档 |
| AI Agent Governance Toolkit | @bibryam 分享 | 在执行前根据策略评估工具调用、资源访问和消息 | 仅靠提示层面的安全措施,不足以充分保护可执行代码的智能体 | Python、TypeScript、.NET、Rust、Go、策略评估器、沙箱 | Beta | 推文, GitHub |
| Open Agent Bazaar | @swarms_corp | Agent Bazaar 经济对齐模拟器的开源实现,用于多智能体市场 | 研究人员需要一种可运行的方式,用来测试智能体市场中的崩盘动态、Sybil 卖家和对齐策略 | Swarms、LiteLLM、Claude/Gemini/GPT 模型后端、EAS 指标 | Alpha | 推文, GitHub |
| roach-pi | @tom_doerr 分享 | 将 pi 编码智能体变成一个有纪律的循环,具备编排、审查、记忆、LSP 和快速搜索能力 | 构建者希望多智能体编码流程可检查、可验证,而不是临时拼凑 | TypeScript、pi、子智能体、审查流水线、工作区记忆、LSP | 已发布 | 推文, GitHub |
| Upstash Box 对 OpenClaw 和 Hermes 的支持 | @enesakar | 在持久化云盒中运行 AI 网关和智能体框架,并提供 SSH、日志和快照 | 团队希望拥有隔离、常开的智能体环境,而不是把笔记本电脑当作运行时 | Upstash Box、OpenClaw、Hermes、持久化云盒、SSH、快照 | 已发布 | 推文 |
| 面向智能体的 Chrome DevTools | @ChromiumDev | 让编码智能体能够检查并控制真实运行的浏览器,用于测试和调试 | 智能体需要针对实际渲染出的应用建立验证闭环,而不只是依赖对代码的猜测 | chrome-devtools-mcp、浏览器仿真、性能/调试工具 | 已发布 | 推文, 文档 |
@ElevenLabs 推出(171 个赞,10 条回复,15,281 次浏览,105 次收藏)Speech Engine 被定位为叠加在现有聊天智能体之上的一层,而不是它的替代品。文档 表示,构建者仍可将模型选择、路由、上下文管理和工具调用保留在自己的服务器上,而 ElevenLabs 负责语音会话本身。这一点很特别,因为它把语音视为一种可附加的运行时能力,而不是独立的智能体平台。
@bibryam 分享(33 个赞,2 条回复,1,247 次浏览,31 次收藏)AGT 被定义为位于执行之前的一层策略层。代码库 称,它会在工具调用、资源访问和智能体间消息真正执行前进行评估,因此这个项目的亮点与其说在于模型新颖性,不如说在于它如何明确地把治理做成软件。
@swarms_corp 推出(65 个赞,13 条回复,2,860 次浏览,9 次收藏)Open Agent Bazaar 是近期一篇经济对齐论文的开源实现。代码库 复现了 crash 和 lemon-market 场景,并提供 StabilizingFirm 和 SkepticalGuardian harness,让构建者能以一种具体方式测试:能力更强的模型是否真的在经济层面更加对齐。
反复出现的构建模式,是给智能体再包上一层运作结构。browse.sh 用可复用的站点目录封装浏览器工作,roach-pi 用编排和审查纪律封装编码智能体,Upstash Box 用隔离且常开的运行时封装本地框架,而 Chrome DevTools 则用真实浏览器验证封装代码生成。在整个数据集中,触发这些构建的痛点高度一致:语音延迟、执行不安全、评估不可靠,以及协调开销。
6. 新作与值得关注的项目
DiagEval 让失败的 GUI 智能体运行具备诊断价值
@HSirui 推出(2 个赞,1 条回复,34 次浏览,1 次收藏)DiagEval 被定位为面向 GUI 智能体失败后分析的诊断框架,论文 表示,其定向探针可找回 45.6–62.1% 的假阴性,并提升 WebDevJudge-Unit 和 RealDevBench 上的准确率。这一点很重要,因为它把失败的 rollout 重新定义为可用于诊断的证据,而不只是需要重跑的错误。

Code as Agent Harness 为社区提供了一张共享的智能体基础设施地图@HuggingPapers 被披露(15 个赞,2 条回复,834 次浏览,8 次收藏)发布了 Code as Agent Harness 调查;与此同时,@krystal_ning 分享(42 个赞,1 条回复,13,036 次浏览,29 次收藏)发布了配套的 Awesome Code as Agent Harness Papers 仓库。这份调查从 harness 接口、harness 机制以及 harness 的扩展三个方面梳理了这一领域,之所以值得注意,是因为 harness engineering 如今正被系统化整理成文献地图和持续更新的论文索引,而不再只是一些零散经验的集合。
低置信度提示:ACE 将上下文框定为一套持续演进的操作手册
@oliviscusAI 总结(11 个赞,3 条回复,426 次浏览,8 次收藏)将 Agentic Context Engineering 描述为一个 generator-reflector-curator 循环:它会根据执行反馈更新操作手册,并声称将适应延迟降低了约 87%。ACE AppWorld 仓库 是一项研究预览,包含离线和在线适应实验。这个信号不如 RoPE 和 DiagEval 两条讨论线那么强,但它契合了当天更广泛的趋势:将上下文视为 agent 会随着时间持续维护和修订的对象。
Vega 围绕一个仍在影响中的 nginx 漏洞提出了安全 agent 主张
@nebusecurity 声称(306 个赞,7 条回复,42,538 次浏览,166 次收藏)表示,其 Vega agent 在同一领域的另一个问题已经修复之后,又发现了一个新的 nginx 1.31.0 RCE。Nebula Security 网站 将 Vega 定位为该实验室的漏洞发现系统,这使这条帖子格外值得关注,因为在这批数据中,它是最明确的公开尝试之一:不是把 agent 绑定到基准测试结果上,而是直接关联到一项真实漏洞主张。
7. 机会在哪里
[+++] 面向可执行代码 agent 的运行时治理与隔离 —— 今天最强的安全证据表明,真正的边界不在于 AI 的一般能力,而在于 agent 是否能够执行代码。AGT、Gemini Enterprise Agent Platform、CodeMender 和 1Claw 的警告都指向同一种需求:执行前策略检查、身份管理、沙箱选择和可审计性。
[+++] 围绕延迟预算构建的语音 agent 基础设施 —— Speech Engine、kwindla 的 TTFT 阈值、BridgeBench 的速度竞赛以及 Databricks 的分发都在说明,市场现在就需要语音 agent;但最终胜出的产品,将是那些能够协调语音、打断处理、工具调用以及 700ms 以下交互预算的产品。
[++] 技能封装、来源追踪与浏览器任务目录 —— Hermes Skill Bundles、browse.sh、Modern Web Guidance 和 Academic Research Skills 都表明,能力正在被封装,而不是靠反复重写 prompt 来获取。当前的缺口在于可靠的来源追踪、策展能力,以及对站点/域名的覆盖。
[++] 失败后诊断与上下文工程层 —— 对 RoPE 的质疑、DiagEval、架构模式论文和 ACE 都指向同一种需求:更小、更审慎的上下文,以及在运行出错时更好的观测与诊断手段。这里存在工具空间:既能保持上下文紧凑、让架构更明确,又能将失败分析自动化。
[+] 面向 agent 市场的经济对齐测试平台 —— Open Agent Bazaar 仍处于研究阶段,但它指向一种日益增长的需求:在 agent 市场进一步扩张之前,先衡量价格崩塌、Sybil 行为以及护栏的有效性。
8. 要点
- 语音 agent 的讨论已经从演示导向转向系统导向。 最有价值的帖子关注的是语音层、打断处理、TTFT 阈值以及模型速度权衡,而不再只是“看看我的 agent 能做什么”式的演示。(来源)
- 能力封装正成为围绕智能体的一层重要产品层。 技能包、浏览器目录和可安装的指导包表明,相比一次性的提示词,可复用的脚手架正越来越占上风。 (来源)
- 社区正在反驳对超大上下文的乐观预期。 RoPE 论文及其相关讨论认为,长上下文失效在结构层面的问题已相当明显,因此构建者应围绕更短、筛选更精细的上下文来设计。 (来源)
- 安全讨论正转向运行时强制约束。 当前最强烈的信号集中在策略检查、可信执行、治理对象、为智能体打补丁,以及实时发现漏洞的相关主张。 (来源)
- 智能体评估正变得更具诊断性。 DiagEval 及相关架构讨论都指向这样一个未来:评判智能体时,人们不再主要依据一次失败的运行尝试,而会更多关注能从失败轨迹中学到什么。 (来源)