Twitter AI Agent - 2026-05-22
1. 人们在讨论什么
1.1 Harness 工程与上下文预算成了主要瓶颈 🡕
5 月 22 日最强的一组讨论认为,智能体可靠性的核心瓶颈是 harness 和上下文,而不只是模型本身。共有五条高信号内容支撑这一判断:一条明确给出成本与运行时长差异的 harness 工程帖子;一条将“好的上下文”拆解为可导航、快速、最新且可累积等特性的上下文工程帖子;一项覆盖 432,000 次请求的 token 研究;一份点明主流编码智能体共享 harness 层的调查;以及另一条讨论成本的帖子,认为更多 token 往往反而与更差结果相关。
@_vmlops 认为(295 个赞、2 条回复、18,280 次浏览、444 次收藏)表示,让一次智能体运行从不可用变得可用,差别不在模型,而在模型外层的 harness。他给出的受控示例称:没有 harness 时,Opus 4.5 花了 $9 和 20 分钟,只得到不可用输出;而完整 harness 则花了 $200 和 6 小时,产出了一个可玩的游戏。这条帖子还少见地具体说明了 harness 包括什么:工具调用前的指令、持久状态、验证门、范围受限的任务,以及清晰的会话生命周期。
@svpino 写道(73 个赞、12 条回复、13,538 次浏览、157 次收藏)表示,如今智能体失败,原因与其说是模型太弱,不如说是上下文给错了。在回复串中,他把这个判断进一步具体化,将目标上下文定义为可导航、快速、最新且可累积;而 @Rigario 的一条回复则指出,许多记忆系统仍然更擅长保留“回忆”,却不擅长保留决策、失败路径、验收标准或证明材料。
@SemiAnalysis_ 报道称(95 个赞、9 条回复、10,558 次浏览、57 次收藏)称,在一组包含 432,000 个真实编码智能体请求的样本中,中位数请求已经携带 96k 个输入 token,约一半请求超过 128k。后续回复称,这种增长主要来自系统提示词、工具定义、技能、MCP schema、前序轮次上下文和文件内容,而不只是用户提示词本身。

@AlphaSignalAI 表示(27 个赞、3 条回复、3,095 次浏览、32 次收藏)称,来自 UIUC、Meta 和 Stanford 的一项新调查显示,Claude Code、Codex 和 SWE-agent 共享同一种三层 harness 架构:接口层、机制层和扩展层。这一点之所以重要,是因为当天的讨论并不只是泛泛地说“加更多上下文”,而是在明确可复用的系统层。

@IntuitMachine 声称(9 个赞、624 次浏览、9 次收藏)称,16,000 次生产环境运行显示,agentic coding 消耗的 token 是普通聊天式使用的 3,500 倍,其中 95% 的成本集中在输入 token 上;而当一次运行拉长到约 300k token 以上时,成功率会开始下降。尽管互动量较低,它仍强化了与 SemiAnalysis 帖子相同的观点:token 增长如今已是一个运营约束。
讨论洞察: 最有价值的修正来自回复,而不是主帖标题。@Rigario 区分了回答上下文与工作流状态;而对 SemiAnalysis 的一条回复则要求提供逐轮 diff,精确显示每一轮重新读取了哪些文件、规则和工具输出。
与前一天相比: 5 月 21 日已经把 harness 工程和记忆诊断推到台前,但 5 月 22 日又把讨论进一步推进到了运营经济学层面。新的帖子为同一个可靠性问题附上了明确的 token 数量、成本区间和架构分类。
1.2 共享记忆层与可安装技能包成了真正的基础设施 🡕
第二个主要讨论集群聚焦于:智能体需要的是持久化记忆底座和可安装知识包,而不只是更长的提示词。共有四条重要内容支撑这一主题:一位构建者为 Hermes 团队绘制了一层共享记忆;另一位将记忆归纳为“记住、引用、遗忘”三项检查;一篇高互动量解读认为 Google 正在为产品知识发布打包技能;而 Waza 的仓库描述则显示,技能工具正从评测扩展为运营基础设施。
@shannholmberg 分享了(9 个赞、2 条回复、315 次浏览、9 次收藏)介绍了一种“gBrain + Hermes Agent”架构:每个专职智能体在开始工作前都会读取一层类型化的共享记忆,并通过主编排器把持久化决策写回去。这条帖子具体说明了文件夹与流程:人物、公司、概念、想法、媒体、newsletter、项目和运营都位于同一记忆层之下。

@Voxyz_ai 写道(36 个赞、4 条回复、8,114 次浏览、76 次收藏)表示,给 Hermes 或 OpenClaw“增加更多记忆”只会造出一个杂物抽屉,除非把记忆拆分为三项工作:记住、引用、遗忘。@abdiisan 的一条回复也从实践角度支持了这一抱怨,称在用混合向量加文本插件替代默认记忆路径之前,长时间的 Hermes 会话一直都时灵时不灵。
@KanikaBK 认为(15 个赞、8 条回复、503 次浏览、3 次收藏)称,Google 已经把产品知识做成了可安装技能,可跨 Claude Code、Cursor、Codex 和 Gemini CLI 使用,原因正是通用编码智能体在被问到 Google 产品时,仍会猜测或使用已弃用的方法。与此同时,Modern Web Guidance 仓库 将自己描述为一种智能体技能:通过可安装、节省 token 的指导,直接向编码智能体注入现代 Web 平台专业知识,而不是只给提示词建议。
@spboyer 表示(11 个赞、515 次浏览、9 次收藏)表示,Waza 最初是一个评测框架,后来之所以扩展成 CLI 和智能体支持界面,是因为实践者不断把它往这个方向拉。公开的 microsoft/waza 仓库 将其描述为一个面向智能体技能的 CLI 和框架,帮助团队创建、测试、衡量并改进技能的质量与效果。
讨论洞察: 有用的细微差别在于,“记忆”和“技能”都在被拆分成更狭义的角色。上下文讨论中的回复区分了工作流状态与回答上下文;而记忆相关帖子也同样推动讨论从原始堆积转向类型化文件夹、来源信息和过期机制。
与前一天相比: 5 月 21 日关注的是各种能力包能否顺畅组合;而 5 月 22 日延续了这种打包主题,但进一步深入到共享记忆架构,以及可直接安装进智能体的官方厂商知识包。
1.3 智能体支付与工作型市场更接近日常运营 🡕
第三个大主题是,智能体商业正在被当作运营管道来讨论,而不再只是未来主义口号。共有四条内容支撑这一点:一个带钱包的智能体自行购买了电话服务;xPay 推出了带护栏的商业通道;x402 和 pay.sh 描述了基于 HTTP 的机器可支付 API;Dispatch 则展示了当智能体干活时,带资金支持的审核流程会是什么样。
@bleso_a 展示了(88 个赞、16 条回复、6,394 次浏览、20 次收藏)介绍了一个智能体:它花 5 USDC 买了一个电话号码,打电话给他做市场分析,并以 0.133 USDC 结算了这通电话。在后续回复中,他公开了提示词:使用 Circle Agent Wallet 用 USDC 为自己注资,找到获取电话号码和发起语音通话所需的付费服务,为其付款,并返回电话号码、通话 ID、文字记录和录音 URL。
@xona_agent 介绍了(37 个赞、10 条回复、835 次浏览)介绍了 xPay:这是一个面向 agentic commerce 的 SDK 层,提供多链钱包、跨 Solana 和 Base 的服务发现、x402 支付以及支出护栏。信息量最大的一条回复明确了这个闭环:发现服务、执行护栏、用 USDC 付款、返回结果,并明确声称,即便智能体产生幻觉,也无法超出自己的支出上限。
x402 文档 将该协议描述为一种围绕 HTTP 402 Payment Required 响应码构建的开放支付标准,目的是让服务在无需账户、会话或凭证管理的情况下,就能对 API 访问收费。pay.sh 网站 则把同一模式面向消费者表达为:“无需账户、无需密钥、无需订阅”,智能体只为实际使用的调用付费。
@wyckoffweb 写道(59 个赞、16 条回复、2,919 次浏览、6 次收藏)称,Dispatch 现在更强调清晰的任务流、任务状态、USDC 支付可见性、模板、更强的智能体档案,以及资金释放前的“审核加修订”步骤。这条推文对产品的定位不是“雇一个 AI 智能体”,而是一个工作层:智能体接收有资金支持的任务、提交工作、接受审核,并随着时间推移建立声誉。

讨论洞察: 回复里并没有争论机器支付是否可行,而是立刻转向服务发现、合规、支出上限和付款条件。这与单纯为演示感到兴奋相比,是完全不同的成熟度。
与前一天相比: 5 月 21 日在 Circle 技术栈中已经出现了电话号码和 USDC 通道;而 5 月 22 日又补上了支出上限、按调用付费的 API 网关,以及更明确的市场审核与结算界面。
1.4 托管运行时与远程智能体工作循环变得更明确 🡕
第四个主题是,关注点正从本地实验转向那些能持续运行、断线后继续工作并暴露工作状态的智能体。共有三条内容推动了这一主题:一位日常使用智能体的用户表示,DIY 托管和安全才是真正的阻碍;Qoder CLI 把远程执行做成了主打特性;而 Waza 在实践者推动下的范围扩张,也进一步说明团队希望围绕技能和智能体获得运营层能力。
@PossibltyResult 写道(17 个赞、6 条回复、3,518 次浏览、5 次收藏)表示,日常使用智能体后,他确信瓶颈不在模型,而在于如何托管并保护一个始终在线、可扩展的智能体。这条推文最后直接变成了产品求助:最好的托管智能体服务有哪些?
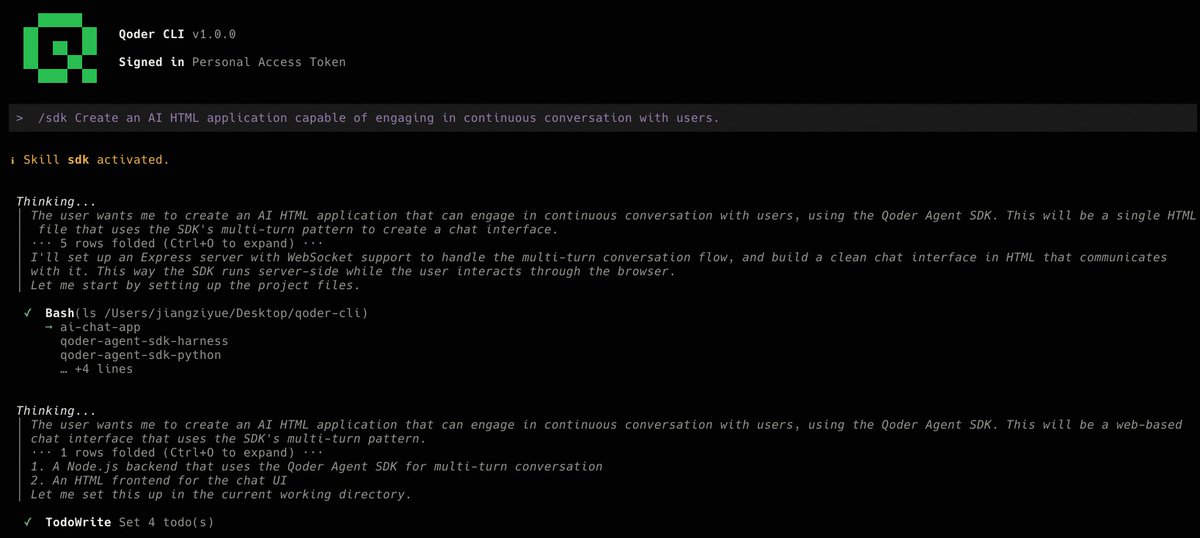
@qoder_ai_ide 宣布(19 个赞、4 条回复、635 次浏览、5 次收藏)介绍了 Qoder CLI 1.0,包含 Agent SDK 和 Cloud Agents 托管运行时。回复补充了实际卖点:qodercli --remote 能让长工作流在笔记本电脑合上后继续运行,/goal 可以在无需逐步提示的情况下定义完成状态,产品还声称支持最高 1M token 的上下文窗口。
@spboyer 表示(11 个赞、515 次浏览、9 次收藏)称,Waza 的路线图并没有预见它会从评测框架走到 CLI,再走到智能体支持;是实践者把它拖到了这里。公开仓库描述也与这一叙事一致,其重点放在技能创建、测试、衡量和改进上,而不只是提示词。
讨论洞察: 贯穿始终的一条主线是,用户越来越希望智能体像远程员工一样工作:拥有持久状态和明确的完成标准,而不是绑定在某台打开着的笔记本电脑上的一个会话。
与前一天相比: 5 月 21 日强调的是确定性工作流和编排作为产品能力;而 5 月 22 日则把云端持久化、远程执行和托管服务需求说得更明白了。
2. 什么让人沮丧
非结构化记忆一旦放大规模,就会变成杂物抽屉
严重程度:高。@Voxyz_ai 写道(36 个赞、4 条回复、8,114 次浏览、76 次收藏)表示,给 Hermes 或 OpenClaw“更多记忆”只会造出一个杂物抽屉,直到把记忆的三项工作——记住、引用、遗忘——拆开,并分别按层级、来源和过期时间做审计。@abdiisan 还补充说,长时间 Hermes 会话之所以变得不可靠,直到后来用混合向量加文本插件替代了默认记忆路径才改善。当前的应对方式是在内置记忆外层加上明确的插件或审计结构。之所以值得构建,是因为这种失败模式出现在多个智能体和多个用户身上,而不只是某个边缘配置。
上下文膨胀会推高成本,而且难以预测或阻止
严重程度:高。@SemiAnalysis_ 报道称(95 个赞、9 条回复、10,558 次浏览、57 次收藏)称,在 432,000 个样本中,编码智能体请求的中位输入已达 96k token,约一半超过 128k;增长来源不是用户提示词变长,而是系统提示词、工具定义、技能、MCP schema、前序轮次上下文以及每轮都会被重新读取的文件内容。@IntuitMachine 声称(9 个赞、624 次浏览、9 次收藏)则称,16,000 次生产环境运行显示,智能体消耗的 token 是聊天式使用的 3,500 倍,且成功率会在约 300k token 之后下滑。@runbounds 的一条回复把诊断说得很直白:逐轮 diff 能精确显示每一轮重新读取了哪些文件、规则和工具输出。现在的权宜之计是缓存和严格的上下文管理,但根本原因——反复重读同一批文件——在主流智能体运行时里仍基本没有得到解决。之所以值得构建,是因为成本是真实的,而没有埋点时,这种泄漏又是静默发生的。
智能体因缺乏最新知识而使用已弃用的厂商 API 方法
严重程度:中。@KanikaBK 认为(15 个赞、8 条回复、503 次浏览、3 次收藏)表示,通用编码智能体在被要求部署到 Google Cloud Run 或配置 Firebase 身份验证时,经常会猜测或使用已弃用的方法;唯一的解决办法是提供带有最新产品知识的官方可安装技能包。@TanmaySaboo 的一条回复也印证了这一判断:“问题从来不是模型不会写代码,而是它们往往使用的是过时或不完整的产品知识。”现在的应对方式是安装官方技能包,但今天这类技能包只覆盖很少一部分厂商。凡是文档更新快于模型训练周期的领域,都值得围绕这一问题构建产品。
运行一个始终在线、可扩展的智能体,需要多数构建者难以承担的托管与安全工作
严重程度:中。@PossibltyResult 写道(17 个赞、6 条回复、3,518 次浏览、5 次收藏)表示,连续数周的日常使用已经让他确信,瓶颈不在模型,而在于托管和保护一个始终在线、可扩展的智能体所需的成本与复杂度。这条帖子最后直接变成了一条产品需求。现有应对方式是只在本地运行智能体、限制其能力范围,或用临时方案绕过托管问题,但这会牺牲可靠性和在线时长。之所以值得构建,是因为这个需求表达得既明确又具体。
企业级智能体集群缺乏对单个智能体行为与成本的可见性
严重程度:中。@Johnsjawn 转推并评论(44 个赞、3 条回复、10,624 次浏览、33 次收藏)借 Notion 推出 Custom Agent Insights 一事指出,一旦企业意识到智能体是真的要进入业务流程,治理就会成为每一场严肃企业讨论中的头号功能诉求:谁构建了什么、它在做什么、花了多少钱、效果如何,以及应该从哪里优化。当前应对方式是自己搭仪表板,或依赖服务商层面的使用视图。之所以值得构建,是因为这个需求并不只是开发者的抱怨,也已经从企业销售视角得到了验证。
3. 人们希望出现什么
内置安全、持久化和可扩展性的托管智能体服务
@PossibltyResult 提问(17 个赞、6 条回复、3,518 次浏览、5 次收藏)直接发问:“最好的托管智能体服务有哪些?”此前他已经得出结论:把始终在线、可扩展智能体的托管和安全维护,当作一项副业来做并不可持续。这是一个现实而紧迫的需求。@qoder_ai_ide 宣布(19 个赞、4 条回复、635 次浏览、5 次收藏)把 Qoder Cloud Agents 视作一种答案,而 --remote 这个标志则对应那项具体能力:笔记本电脑合上后,长工作流仍能继续运行。但这个领域目前还没有明显的既有主导者。机会:直接。
具有明确“记住、引用、遗忘”职责的结构化记忆底座
@Voxyz_ai 写道(36 个赞、4 条回复、8,114 次浏览、76 次收藏)表示,人们真正需要的,是把记忆拆成三项工作——记住、引用、遗忘——并按层级、来源和过期时间审计,而不是堆进一个没有区分的统一存储。@shannholmberg 描述了(9 个赞、2 条回复、315 次浏览、9 次收藏)则在架构层面表达了同样的需求:在编排器之下有一层类型化共享记忆,使专职智能体在被唤醒时就带着完整上下文,而不是每次都从零开始。@svpino 还从检索角度补充说,上下文必须可导航、快速、最新且可累积;而他在帖子回复中通过 @Rigario 区分了回答上下文与工作流状态,并指出大多数记忆方案虽能改善回忆,却仍保不住决策、失败路径、验收标准或证明材料。机会:直接且竞争激烈,Redis Iris 与 Mnemosyne 等插件已经在部分覆盖这一问题。
能显示每一轮上下文浪费位置的 token 可观测性
@runbounds 对 SemiAnalysis 帖子的回复把需求说得很准确:“逐轮 diff 可以显示哪些文件被重读、哪些规则被加载、哪些工具输出被保留,以及具体改变了什么。”@IntuitMachine 表示(9 个赞、624 次浏览、9 次收藏)称,GPT-5 对自身 token 使用量的估算相关性只有约 r=0.39,这意味着智能体在开始执行前,无法可靠地自行报告预算。人们想要的是一种轻量级的逐轮拆分——不是完整 trace——能在成本飙升前标出重复文件读取和输入 token 的累积。机会:直接;目前还看不到明显的市场主导者,能在智能体运行时而不是事后计费仪表板中提供这种能力。
面向所有主要厂商和平台的官方、最新、可安装产品知识
@KanikaBK 记录了(15 个赞、8 条回复、503 次浏览、3 次收藏)表示,Google 的官方智能体技能库终于让编码智能体获得了准确、最新的 Google Cloud、Firebase、BigQuery 及相关产品指导。这也框定了更广泛的未满足需求:实践者希望每个厂商都发布同类可安装、最新、经专家验证的知识包,而不是让智能体根据可能早于最近一轮弃用周期的训练数据自行猜测。机会:竞争性机会——Google 先走了一步,格式也是开放的,但绝大多数厂商 API 和服务都还没有对应方案。
将工作交付、审核、支付和声誉整合在同一层的智能体市场基础能力
@wyckoffweb 描述了(59 个赞、16 条回复、2,919 次浏览、6 次收藏)把 Dispatch 描述为一个“真正的工作层”,而不是一个目录,并明确指出当前智能体产品的缺口在于:缺少有资金支持的任务、审核、结算和声誉追踪。引用的那条更早推文描述了完整闭环:发布、注资、分配、审核、批准、支付并更新声誉。如今大多数智能体产品在“提交输出”这一步就结束了。机会:偏愿景型——构建所需的工具已经逐渐到位,但市场机制本身仍在拼装中。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Claude Code | 编码智能体 | (+) | 如 harness 工程帖子所述,具备具体的 harness 原语、验证门和会话生命周期管理 | 根据 $200/6 小时的例子,如果没有合适的 harness,运行成本会很高 |
| Hermes Agent | 智能体运行时 | (+/-) | 灵活的多专职智能体编排;支持共享记忆层和技能包 | 若没有外部插件,内置记忆在长会话中会变得不可靠 |
| Redis Iris(Context Retriever + Agent Memory) | 记忆 / 检索 | (+) | 语义图遍历、托管式短期与长期记忆,以及来自 Postgres/MySQL/数仓的持续数据同步 | 需要一定集成工作;且是在赞助帖语境下被提及 |
| Mnemosyne plugin | 记忆插件 | (+) | 混合向量加文本搜索、跨会话实体记忆、5 分钟完成设置 | 生态较为特定(偏 Hermes);公开证据有限 |
| x402 protocol | 支付 | (+) | 开放的 HTTP 标准,可在无需账户、会话或凭证管理的前提下按 API 调用收费 | 仍处于早期采用阶段;依赖服务提供方实现该标准 |
| xPay SDK | 支付 | (+) | 多链钱包、发现 21k+ 服务,以及签名前执行的支出护栏 | v0.1.0;虚拟卡和跨链桥接尚未发布 |
| Circle Agent Wallet | 支付 / 电话服务 | (+) | 智能体可用 USDC 为自己注资、购买电话号码、拨打电话并按通话结算 | 合规问题以及一次性验证码等边缘场景仍需人工处理 |
| Agora Skills | 语音技能包 | (+) | 一条命令即可安装支持打断、多轮对话的语音演示;支持 Deepgram、GPT-4o-mini、MiniMax 和自定义 LLM | 每个 App ID 默认仅支持 20 个并发会话;尚无大规模生产就绪证据 |
| Qoder CLI | 编码智能体 / 托管运行时 | (+/-) | 通过 --remote 进行远程卸载,借助 /goal 定义完成状态,最高支持 1M-token 上下文 |
仍然较早期;缺乏第三方生产使用证据 |
| Microsoft Waza | 智能体技能框架 | (+) | 用于创建、测试、衡量和改进技能质量的 CLI;在实践者拉动下扩展出了智能体支持 | 范围由实践者需求而非固定路线图塑造,长期 API 稳定性存在不确定性 |
| Dispatch | 智能体市场 | Beta | 用 USDC 为任务注资、付款前审核、智能体档案与声誉追踪 | 目前运行在 Arc 测试网;尚未说明生产级结算与争议处理 |
| Google Modern Web Guidance skills | 技能包 | (+) | 13 个可安装技能,覆盖 Cloud、Firebase、BigQuery、GKE;可跨 Claude Code、Cursor、Codex、Gemini CLI 使用 | 范围仅限 Google 产品;其他厂商仍无同类方案 |
| pgvector + semantic retrieval | 检索方法 | (+) | 据实践者报告,可将上下文负载降低约 5 倍;减少特定领域检索中的幻觉 | 需要严格的索引与分阶段评测,才能定位检索失败原因 |
5 月 22 日的满意度分布,关注点集中在模型外围的那一层,而不是模型本身。那些增加了明确结构的工具——类型化记忆、支出护栏、技能包、远程持久化——获得了正面反馈,因为它们降低了运营层面的不确定性。对于 Hermes 这类智能体运行时,情绪则更复杂:内置默认配置可能会在规模扩大后静默退化,而支出护栏或记忆插件又往往需要另行获取。最主要的迁移趋势,是从原始 prompting 转向结构化 harness 层、可安装知识包,以及无需手动管理凭证的支付通道。竞争张力最明显地出现在技能包分发上:Google 使用 Anthropic 的开放格式发布官方技能,表明大型厂商现在已把可安装知识视为值得投入的一等分发层,而不再只是社区绕行方案。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| xPay | @xona_agent | 面向 agentic commerce 的支付 SDK,具备多链钱包、服务发现、x402 支付和支出护栏 | 智能体需要在不手动配置凭证、且不会无限制支出的前提下,发现服务、为服务付费并完成调用 | Solana、Base、x402、USDC、PayAI Network discovery、SDK | Alpha(v0.1.0) | 推文 |
| Dispatch | @wyckoffweb | 智能体工作型市场,支持有资金支持的任务、USDC 支付可见性、付款前审核、智能体档案和声誉追踪 | 智能体需要一个真正的工作层,来处理任务分配、提交、审核、结算和声誉,而不只是聊天输出 | Arc testnet、USDC、已部署的任务合约、在线前后端 | Beta(测试网) | 推文、网站 |
| gBrain + Hermes multi-agent company | @shannholmberg | 在 Hermes 编排器与专职智能体之下提供类型化共享记忆层;所有专职智能体都会在执行任务前读取 gBrain,并将持久决策写回 | 多智能体团队缺乏共享上下文底座,每次运行都要从零开始 | Hermes Agent、类型化文件夹(人物/公司/概念/想法/媒体/项目/运营)、编排器读写模式 | Alpha | 推文 |
| 通过 Agora skill 构建的语音 AI 智能体 | @exploraX_ | 通过在 Claude Code 中安装一个技能,即可构建具备会话记忆、支持实时打断的语音智能体 | 构建者希望无需手动配置控制台或准备多个 API 密钥,就能得到一个可工作的语音演示 | Agora skill(npx skills add)、Deepgram STT、GPT-4o-mini、MiniMax TTS |
已发布 | 推文 |
| Qoder CLI 1.0 | @qoder_ai_ide | 托管式云端编码智能体运行时,具备 Agent SDK、远程卸载、/goal 完成状态定义,以及最高 1M-token 上下文 |
本地编码智能体会在笔记本电脑合上后停止,还需要一步一步提示,缺乏持久状态 | Qoder Agent SDK、Cloud Agents runtime、--remote flag |
已发布 | 推文 |
| Google official agent skills library | Google / @KanikaBK 将其带入讨论 | 13 个可安装技能包,覆盖 Cloud、Firebase、BigQuery、GKE、身份验证和 Well-Architected Framework | 如果没有最新产品知识,编码智能体就会为 Google 产品生成已弃用或错误的方法 | Anthropic skills format、npx skills add google/skills、Apache 2.0 |
已发布 | 推文、仓库 |
| Wallet-funded voice-calling agent | @bleso_a | 智能体用 USDC 为自己注资,购买电话号码,给真人打去带市场分析的电话,并返回通话文字记录和录音 URL | 证明智能体可以自主采购并支付真实服务,而不只是浏览网页或生成文本 | Circle Agent Wallet、USDC、BlandAI(电话服务)、语音合成 | 已发布(演示) | 推文 |
@wyckoffweb 详细说明了(59 个赞、16 条回复、2,919 次浏览、6 次收藏)展示了 Dispatch 作为一种不断演进的尝试,正在补齐智能体周边缺失的工作原语:任务注资、状态清晰度、审核步骤,以及跨任务累积的声誉。引用的早前推文点出了它与简单目录的差别:智能体必须能够接收一项有资金支持的任务、提交工作、接受审核、只有在通过审批后才能收款,并随着时间推移建立可验证的声誉。这是数据集中第一个具备在线测试网前端的链上智能体声誉与结算闭环。
@bleso_a 发布了(88 个赞、16 条回复、6,394 次浏览、20 次收藏)公开了他用来让 Circle Agent Wallet 自主采购电话与语音服务的完整提示词——“Use Circle Agent Wallet to call MY_PHONE_NUMBER... find the paid services required to get a phone number and make the voice call, pay for them with USDC, and return the phone number, call ID, transcript, and recording URL.” 这让整个工作流具备了可复现性,而不只是一个演示性主张。
5 月 22 日这些项目反复呈现出的构建模式,是让智能体获得运营基础设施——钱包、市场席位、持久记忆、托管运行时、可安装知识——而不只是塞给它更长的系统提示词。数据集中的每个重要构建,都新增了一层能够在断线后继续存在、执行支出限制,或把类型化上下文存下来供下一次运行直接读取的能力,而不是每次重新推导。
6. 新近且值得关注的内容
x402 和 pay.sh 把机器可支付 API 描述为一种开放标准
x402 文档 将其描述为一种围绕 HTTP 402 Payment Required 响应码构建的开放支付标准,目的是让服务在无需账户、会话或凭证管理的情况下,对 API 访问收费。pay.sh 网站 则将同一模式面向消费者表达出来,并明确声称:“无需账户、无需密钥、无需订阅”,智能体只为实际使用的调用付费。@xona_agent 介绍了(37 个赞、10 条回复、835 次浏览)介绍了 xPay,称其是第一个明显将 x402 与多链钱包和服务发现层结合起来的 SDK。开放标准(x402)、面向消费者的产品(pay.sh)和 SDK(xPay)在同一天的数据中同时出现,说明这更像是一轮协同基础设施发布,而不是彼此独立的实验。
Google 用 Anthropic 的开放格式,为编码智能体发布了官方技能库
@KanikaBK 指出(15 个赞、8 条回复、503 次浏览、3 次收藏)称,Google 选择用 Anthropic 开源的技能格式交付其官方产品知识——13 个技能覆盖 Cloud、Firebase、BigQuery、GKE 和 Well-Architected Framework,因此能够同时兼容 Claude Code、Cursor、Codex 和 Gemini CLI。这个决定之所以重要,是因为它表明,一家主要模型厂商正在把竞争对手的分发格式作为务实默认选项采用,这意味着胜出的可能是格式本身,而不是控制底层模型的一方。
SemiAnalysis 发布了 432,000 次真实编码智能体请求的上下文长度数据
@SemiAnalysis_ 报道称(95 个赞、9 条回复、10,558 次浏览、57 次收藏)称,真实编码智能体请求的中位输入已经达到 96k token,约一半超过 128k。后续帖子表示,驱动因素并不是用户提示词更长,而是用户输入之前 harness 已经加载进来的所有东西:系统提示词、工具定义、技能、MCP schema、前序轮次上下文以及文件内容。这是首次以大样本实证方式为上下文规模估算提供支撑;此前相关判断更多停留在理论层面,或局限于个别厂商的数据。
Redis 发布了 Iris:面向智能体的专用上下文与记忆平台
在 @svpino 的上下文工程讨论串中,一条回复 描述了(73 个赞、12 条回复、13,538 次浏览、157 次收藏)介绍了 Redis Iris:这是一个新平台,结合了 Context Retriever(在实时数据上做语义图遍历,而不是只取 top-k 向量块)、Agent Memory(带嵌入、检索和摘要能力的托管式短期与长期记忆)以及 Redis Data Integration(将关系数据库中的数据持续同步到 Redis)。这一发布之所以值得关注,是因为它重新定义了 Redis——不再只是缓存,而是智能体原生的记忆底座,直接与团队从零搭建的自定义记忆方案竞争。
7. 机会在哪里
[+++] 面向智能体运行时的 token 可观测性与成本控制工具 —— SemiAnalysis 记录了 432,000 次真实请求中 96k 的输入 token 中位数;IntuitMachine 显示 token 消耗是聊天式使用的 3,500 倍,且超过 300k token 后成功率开始下降;还有回复明确要求提供逐轮 diff,以显示哪些文件在被反复重读。当前运行时能暴露的内容(计费总额)与实践者真正需要的内容(逐轮、逐文件、带冗余检测的拆解)之间,仍存在巨大且未被填补的缺口。证据同时来自实证数据、实践者抱怨,以及一群已经遭遇成本意外的明确用户。
[+++] 具备安全性、持久化和可扩展性的托管智能体基础设施 —— @PossibltyResult 基于日常使用提出了明确的产品需求;Qoder Cloud Agents 和 xPay 的路线图(仪表板加虚拟卡)只是部分答案。这个需求来自亲自尝试 DIY 托管并得出“不可持续”结论的实践者,而不是空泛猜测。在大型云服务商之外,这一领域还没有明显的始终在线智能体基础设施主导者;而大型云提供的是通用算力服务,并非专为智能体生命周期管理而设计。
[++] 具有类型化角色与过期机制的结构化记忆底座 —— @Voxyz_ai 的“记住/引用/遗忘”框架、@shannholmberg 的共享 gBrain 架构、@svpino 的“可导航/快速/最新/可累积”框架,以及 @Rigario 对工作流状态与回答上下文的区分,都指向同一个缺口:市场上还没有现成记忆层,能在多智能体团队里同时强制执行来源追踪、过期机制与类型安全分类。Redis Iris 和 Mnemosyne 是部分答案,但同一天内来自不同构建者的重复模式已经足以说明,这是一种持续性需求。
[++] 带支出护栏和按调用结算能力的智能体支付通道 —— x402、xPay、Circle Agent Wallet 和 pay.sh 同日出现,说明机器可支付 API 似乎正在经历一次协同推进。xPay 的护栏主张——“即使智能体产生幻觉,也无法超出其上限”——是关键差异点:提供的不只是支付,而是执行前就受限的有界支付。机会真实存在,但这个领域进展很快,也已经有多个团队在做。
[++] Google 之外可安装、最新且经厂商验证的知识包 —— Google 的官方技能库证明,产品专属知识可以用开放格式,作为可安装、兼容智能体的知识包来分发。绝大多数 API、平台和云服务仍然没有对应方案。@KanikaBK 的帖子给出了明确需求信号:编码智能体反复产出已弃用的方法,而“一键安装”如今已经成了可行修复路径。格式是开放的,任何厂商都能采用。
[+] 具备链上声誉与支付逻辑的智能体市场基础能力 —— Dispatch 是数据集中最清晰的例子,但它目前仍在测试网。引用的推文把缺失的那一层描述为任务、支付、审核、结算、声誉和工作历史,并将其视为把 bot 变成 worker 的关键。机会真实存在,但还很早期;缺的不是技术想象力,而是生产级结算、争议解决与可信声誉聚合。
8. 要点
- Harness 工程如今已被明确命名、形式化,并有实证数据支撑。 受控成本实验(没有 harness 花 $9,而为取得可比输出、使用 harness 则花 $200)、432,000 次请求的 token 研究,以及一份关于共享 harness 架构的 100 页学术调查,共同把 harness 工程从一种实践者经验,推进成一门被承认的学科。(来源)
- 上下文膨胀如今是运营成本问题,而不只是模型能力限制。 SemiAnalysis 的数据显示,中位输入 token 已达 96k,且一半超过 128k;IntuitMachine 则发现成功率会在 300k token 之后下降。两者共同把上下文管理框定为一个经济性与可靠性问题,而不只是能力问题。(来源)
- 智能体记忆需要明确分工,而不只是更大容量。 “记住/引用/遗忘”框架、类型化共享 gBrain 层,以及工作流状态与回答上下文的区分,都在同一天独立出现,说明实践者普遍都在对无差别的记忆堆积感到不满。(来源)
- 智能体支付已从演示性质的好奇心,转向协同推进的基础设施建设。 x402、xPay、Circle Agent Wallet 和 pay.sh 在同一天同时出现,再加上一个由钱包注资的电话呼叫演示,说明智能体支付层正在被认真搭建,而不再是各自为战的探索。(来源)
- 官方厂商技能包正成为交付最新产品知识的新分发层。 Google 使用 Anthropic 的开放格式发布了 13 个技能,并同时兼容所有主要编码智能体,这是当天最重要的分发信号——因为它意味着,要让编码智能体准确理解某个厂商自家平台,已经出现了一种第一方、可安装的答案。(来源)