Twitter AI Agent - 2026-05-23
1. 人们在讨论什么
1.1 Harness 工程从“成本抱怨”走向可落地的代码仓库基础设施 🡕
5 月 23 日最强的一组讨论延续了 5 月 22 日关于 harness/context 的话题,但焦点已经从“上下文很贵”转向人们可以安装、基准测试和拿来教学的具体产物。共有七项留存内容支撑了这一趋势:一个高互动的 harness 实验、一张区分 prompt/context/harness 角色的示意图、一款代码图产品、一项 AGENTS.md 研究、一项代码仓库级代码图基准、一段浏览器 harness 演示,以及一篇自演化 harness 论文。
@_vmlops 认为(397 个赞、5 条回复、24,034 次浏览、597 次收藏)指出,Anthropic 保持模型和 prompt 不变,只改变模型所处的环境:没有 harness 时,成本是 $9、耗时 20 分钟,产出不可用;完整 harness 则意味着 $200、6 小时,以及一个可玩的结果。真正特别的不是价格,而是那份清单:工具调用前的指令、持久化状态、验证关卡、范围受控的工作,以及清晰的会话生命周期。
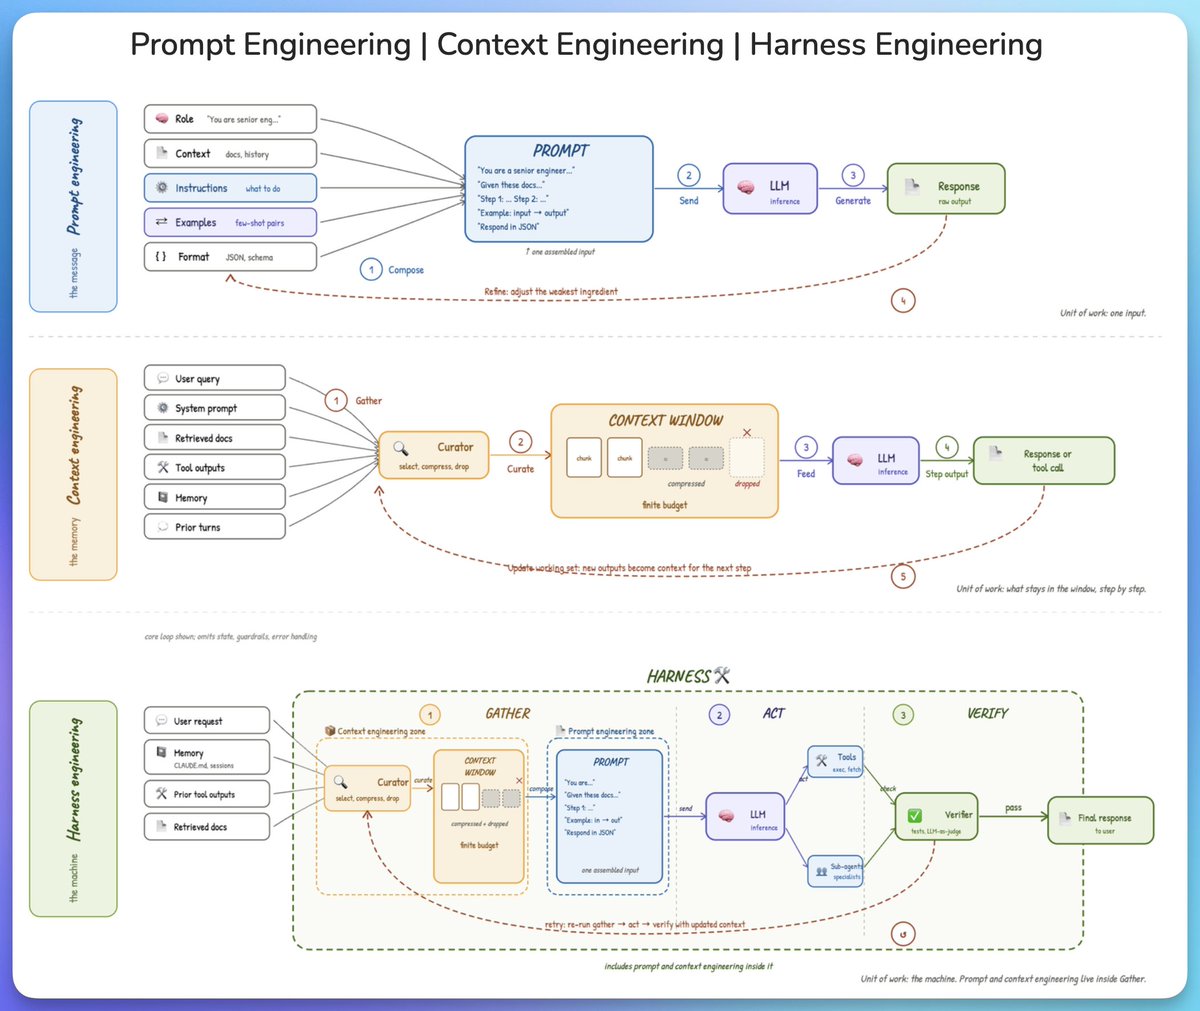
@akshay_pachaar 写道(367 个赞、22 条回复、34,564 次浏览、564 次收藏)提出:prompt engineering 负责消息,context engineering 负责记忆,而 harness engineering 则是包裹“收集/行动/验证”循环的那台机器。配图把这种区分呈现得足够直观,以至于回复区直接把它当成共享词汇,而不是又一句口号。
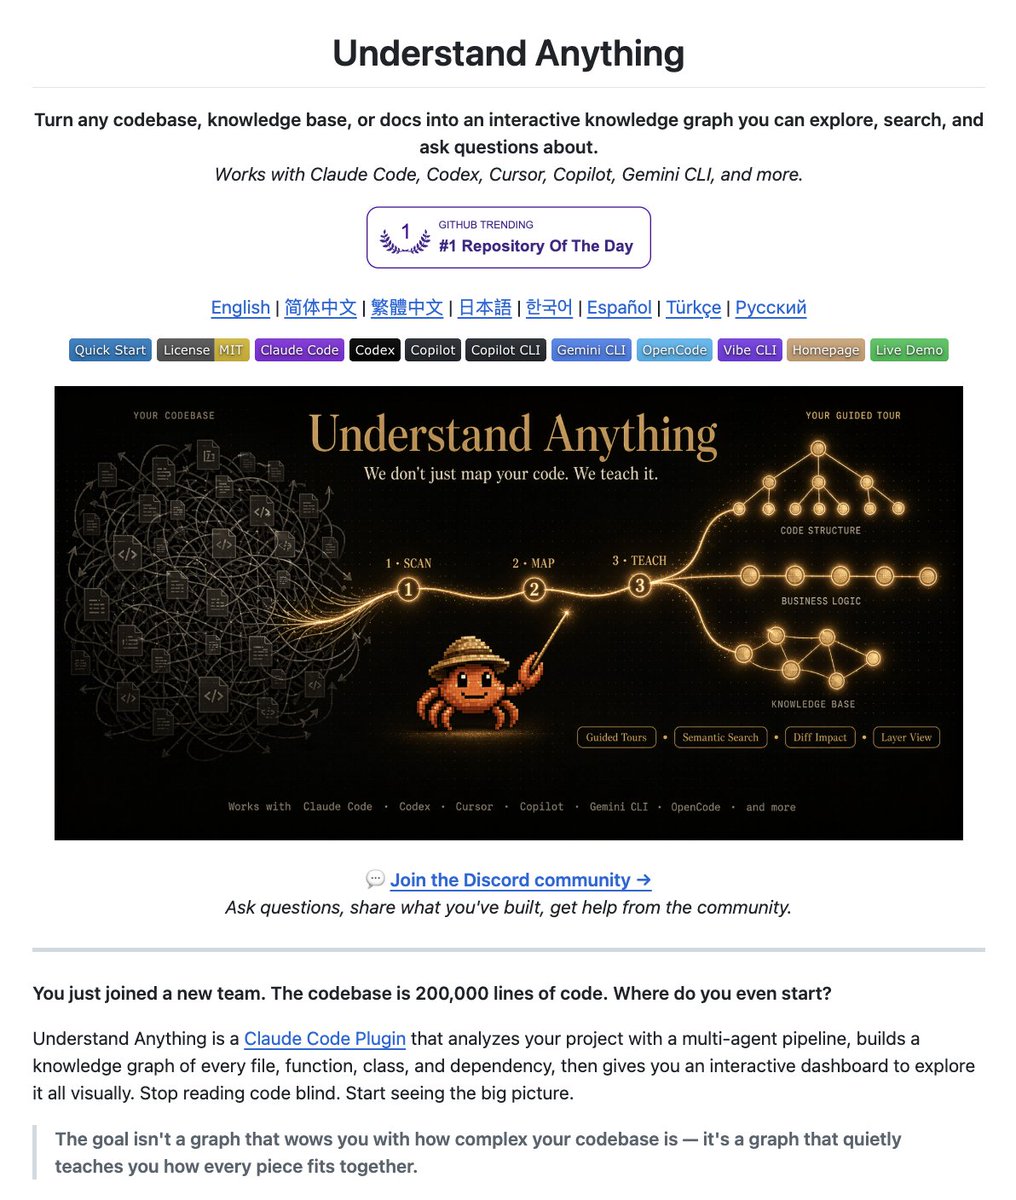
@Saboo_Shubham_ 发帖称(63 个赞、13 条回复、4,975 次浏览、135 次收藏)指出,Understand Anything 可以把代码库变成交互式图谱,让 agent 直接查询,而不必反复重读文件。Understand Anything 网站 称,它提供业务域视图、引导式导览、模糊搜索和语义搜索,并可快速安装到 Claude Code、Codex、OpenCode、Gemini CLI 等工具中;@SynabunAI 警告称 的一条回复则提醒,图谱的新鲜度只取决于最近一次索引,过时的边可能让 agent 对已删除的代码做出看似自信的推理。
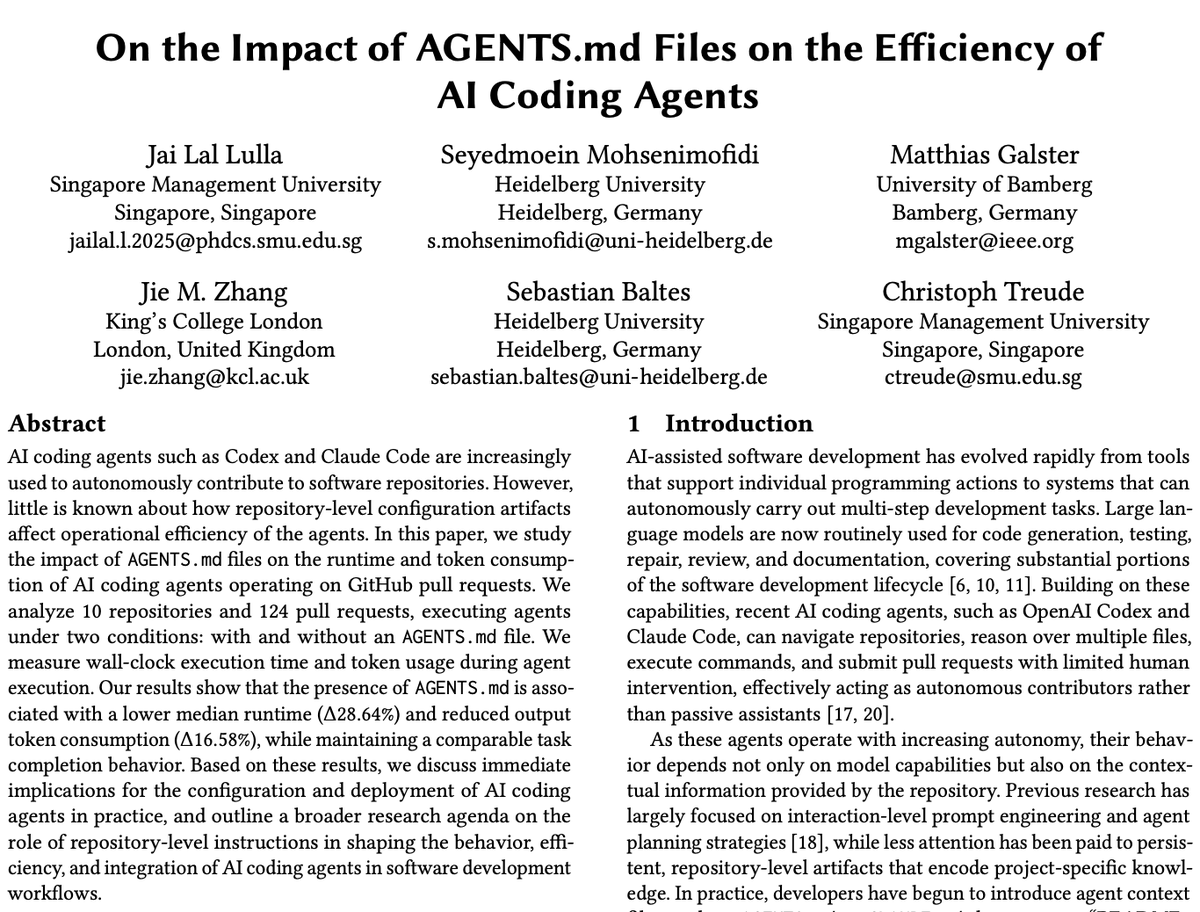
@IntuitMachine 声称(5 个赞、2 条回复、266 次浏览、11 次收藏)称,一个根目录级 AGENTS.md 让 124 个拉取请求的中位运行时间下降了 28.64%,输出 token 数下降了 16.58%;arXiv 摘要 则在 10 个代码仓库上确认了这些变化。与此同时,@BeauJohnson89 强调了(106 次浏览)CodeGraph,其 README 称,预先建立索引的本地图谱在 7 个代码库上把成本降低了 35%、token 降低了 59%、耗时缩短了 49%、工具调用减少了 70%;另有 @TheDawningRoad 分享了(6 个赞、6 次转发、37 次浏览)介绍了 AHE 论文,它把 harness 改进定义为围绕组件、经验和决策展开的可观测循环。
讨论洞察: 最有价值的反驳不是“少用上下文”,而是“让上下文更新鲜、出处更清楚”。代码图帖子下的回复要求有持久化的任务状态,并警告说,过期索引有时比完全没有索引更糟。
与前一天对比: 5 月 22 日聚焦 token 预算、长上下文的经济性和 harness 分类。到了 5 月 23 日,这一框架还在,但重点已明显转向代码仓库级修复方案,比如代码图、AGENTS.md 和自演化 harness。
1.2 技能文件开始变成软件层和安全边界 🡕
第二组讨论把 SKILL.md、AGENTS.md 及相邻的指令文件,当成真正的软件制品,而不再只是隐藏的 prompt 片段。共有五项内容支撑这一趋势:一条被广泛转发的警告,提醒不要从互联网下载技能;一项 AGENTS.md 效率研究;一个能从专家语料生成 agent 指令文件的工具;一套新的 agent-skills 课程;以及一股持续推动这些文件显式化、版本化,而不是隐式存在的趋势。
@AlexFinn 警告称(289 个赞、46 条回复、9,768 次浏览、150 次收藏)提醒不要从互联网下载 agent skills,因为公开的 skill 目录正在成为提示注入的攻击面。真正有价值的信息出现在回复里:@Trish_DIntel 回复称 指出,哪怕只是让 agent 检查一个恶意 skill,也可能不安全,因为载荷已经进入上下文窗口;@TulioSousapro 认为 则表示,更安全的做法是由人手动检查,然后再向模型单独描述其内容。
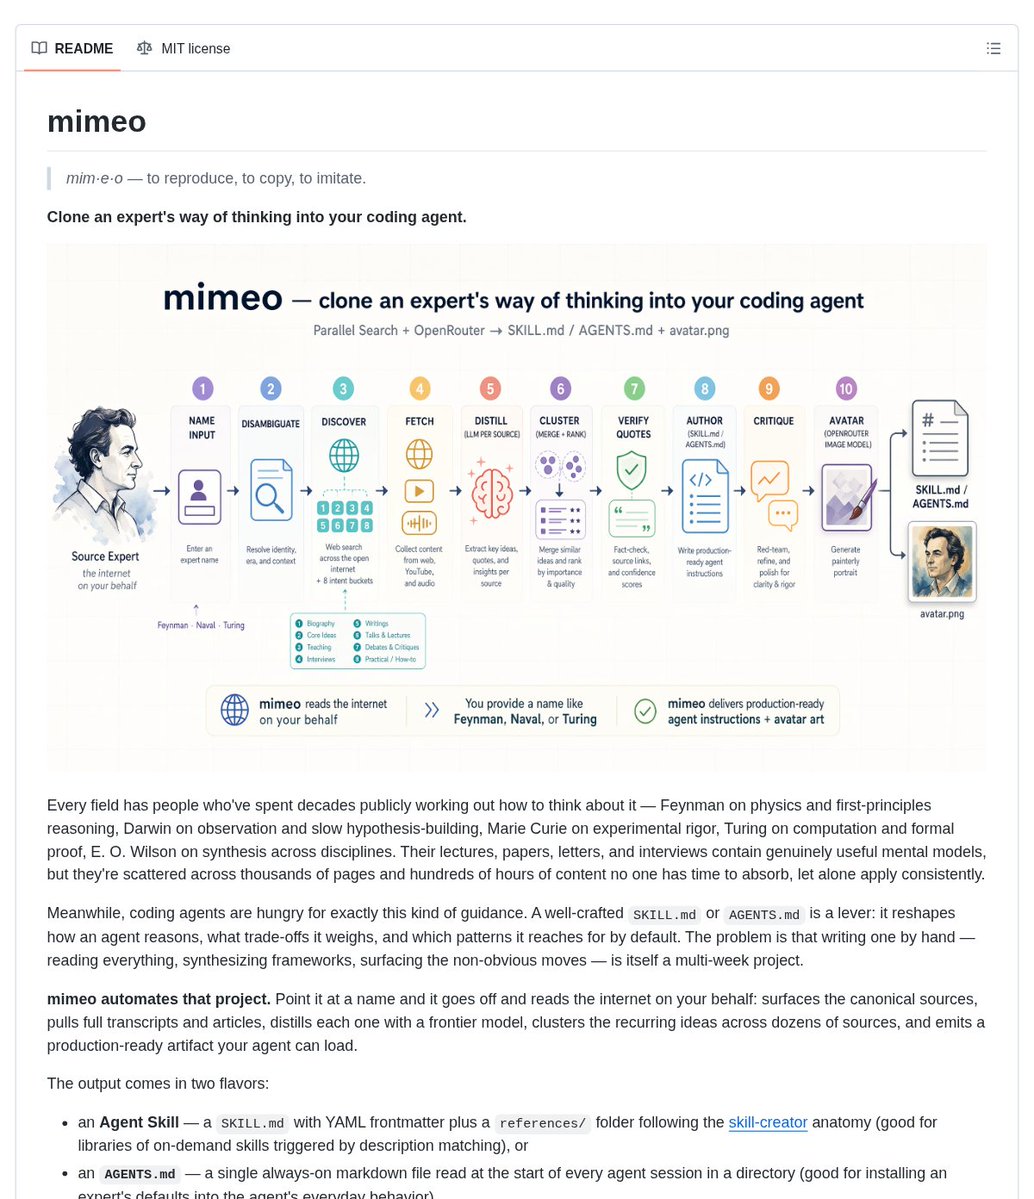
@DanKornas 介绍了(7 个赞、252 次浏览、12 次收藏)介绍了 mimeo:一个 Python 工具,可把某位专家公开发表的作品转化为可直接使用的 SKILL.md 或 AGENTS.md。仓库 称,它会发现来源、抓取文字记录和文章、聚类反复出现的观点、依据原文核验引语,并在输出制品前运行一轮批判性审查。
@IntuitMachine 使用了(5 个赞、2 条回复、266 次浏览、11 次收藏)借助新的 AGENTS.md 论文论证:更好的代码仓库指令,比继续折腾 prompt 更有效;与此同时,@omarsar0 推出了(97 个赞、6 条回复、8,484 次浏览、123 次收藏)介绍了一套新的 DAIR Agentic Engineering lab,其第一个公开模块就是“构建你的第一个 Agent Skill”。这一组合之所以重要,在于人们不只是发布技能文件,也在教授它们、衡量它们。
讨论洞察: 争论的重点不是指令文件是否重要,而是它们的导入路径是否安全。当天最强的一批回复都默认这些制品会长期存在,真正讨论的是如何在不把恶意指令交给 agent 的前提下,对它们进行编写、审核和版本管理。
与前一天对比: 5 月 22 日强调的是厂商官方 skill 包和可安装的知识包。5 月 23 日则把范围扩大到安全导入、自动化编写,以及可衡量的代码仓库级指令文件。
1.3 持久记忆和多 agent 控制室变得更加可见 🡕
第三个强势话题不是单纯给 agent 更多记忆,而是让长期运行的 agent 系统变得可见、可操作。共有五项内容支撑了这一趋势:支持语音的 GBrain 发布、类型化记忆架构解读、remember/cite/forget 框架、基于浏览器的 Hermes war room,以及一个围绕 agent 通知构建的终端。
@garrytan 发布了(327 个赞、38 条回复、16,428 次浏览、260 次收藏)介绍了 GBrain v0.40.0:一个基于 Gemini Live、面向 OpenClaw 和 Hermes 的语音 agent。GBrain README 将其描述为一个持久化大脑,能够摄取会议、邮件、推文和语音通话;@neosphere_inc 回复称 则指出,语音加工具调用的瓶颈,与其说在上下文长度,不如说在每次工具调用的往返延迟。
@shannholmberg 解释道(19 个赞、8 条回复、605 次浏览)介绍了她如何把 GBrain 用作一个 Hermes company 的底层记忆层:输入是 Markdown,输出是图谱;底层由 Markdown、Postgres 和 pgvector 组成;检索结合关键词、向量和图谱;夜间还会跑一轮去重,修复链接并更新整理后的事实。@untold_bits 的一条回复补充了关键提醒:自动摄取仍必须经过人工判断把关,否则系统最终会变成“一个随着时间推移不断膨胀的巨大垃圾团”。
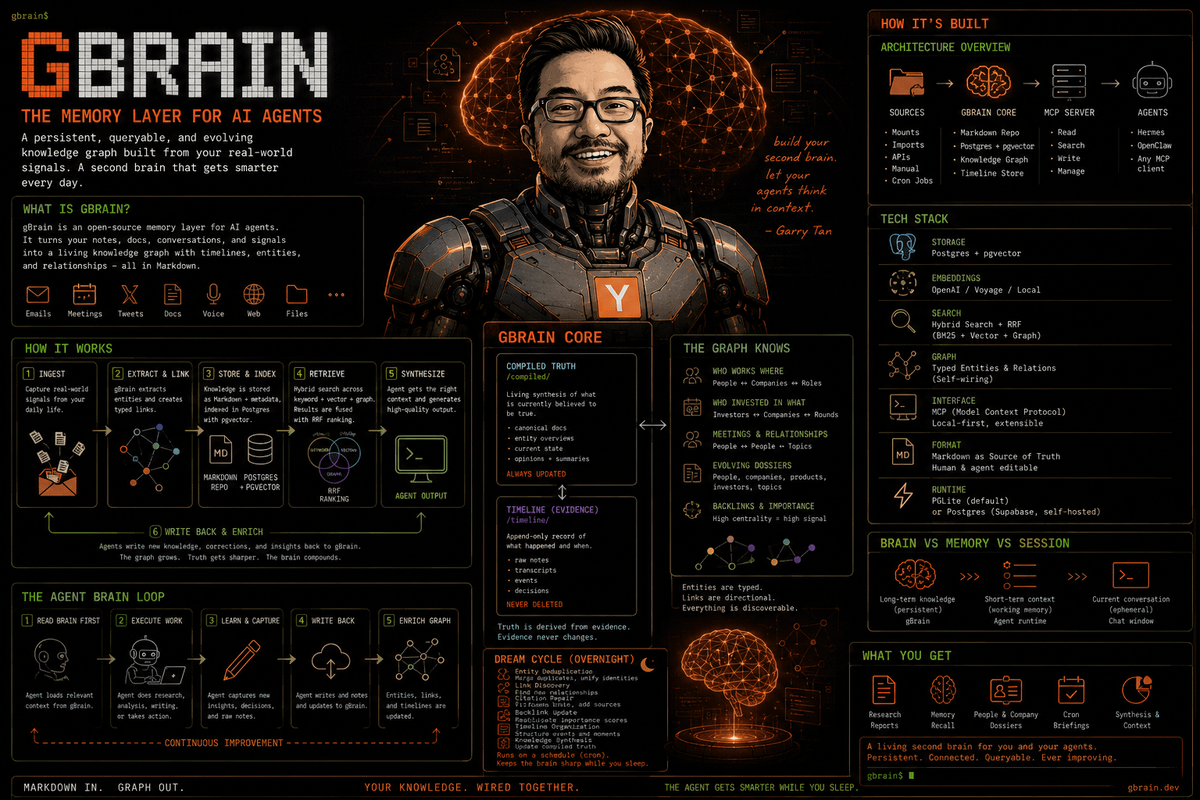
@Voxyz_ai 写道(71 个赞、6 条回复、15,911 次浏览、155 次收藏)指出,agent memory 需要承担三个彼此不同的职责——remember、cite 和 forget——因此应当有层级、来源和过期检查,而不是塞进一个不加区分的存储里。至于可见性方面,@tom_doerr 分享了(13 个赞、1 条回复、1,947 次浏览、31 次收藏)Hermes War Room,其 README 描述的是一个覆盖 Hermes 委派和看板系统的浏览器仪表板;同时,@lawrencecchen 构建了(21 个赞、899 次浏览、9 次收藏)cmux,这是一款带分栏级通知的终端,因为“你必须知道 agent 何时、又是在什么地方想和你说话”。
讨论洞察: 共同的修正意见是,仅靠更好的记忆还不够。构建者持续加入来源、过期、通知和审阅界面,让人类能看到 agent 记住了什么、正在做什么,以及什么时候需要介入。
与前一天对比: 5 月 22 日还在用较抽象的方式谈共享记忆层和托管运行时;到了 5 月 23 日,它们已经变成了面向用户的产品:语音前端、类型化记忆架构海报、战情室和通知分栏。
2. 什么让人沮丧
公开技能的导入在推理前仍然不安全
严重程度:高。@AlexFinn 警告称(289 个赞、46 条回复、9,768 次浏览、150 次收藏)指出,公开 skill 网站正在成为提示注入的攻击面。回复进一步把失效模式说得更清楚:@Trish_DIntel 回复称 表示,即便只是让 agent 检查一个恶意 skill 也不安全,因为载荷已经进入上下文窗口;@TulioSousapro 认为 则指出,唯一安全的变体是人工审查后,再向模型单独描述内容。@elsontec 询问 则呼吁采用一套完全更安全的工作流。今天的应对方式仍是“把 skills 当成不可信输入,并从头重建”,但数据集中并没有强有力的证据表明,已经存在一个可信的审核层或沙箱,能把这个问题干净利落地解决掉。值得投入,因为需求非常明确,而且故障发生在模型开始做有用工作之前。
代码仓库上下文仍然会过时,或需要高成本反复重读
严重程度:高。@Saboo_Shubham_ 发帖称(63 个赞、13 条回复、4,975 次浏览、135 次收藏)推出了一款基于图谱的上下文工具,正是因为 agent 仍在反复重读代码库,而不是把结构延续下来;@SynabunAI 回复称 则提醒,过时的边可能让 agent 自信地推理三次 PR 之前就已经删除的代码。@Bushmaster18523 补充道 指出,人们在压缩和交接中真正丢失的,其实是持久化的任务状态:决策、检查点、死胡同和证据。量化层面,@IntuitMachine 引用了 介绍了 AGENTS.md 论文,该研究发现,在 124 个拉取请求上,中位运行时间下降了 28.64%,输出 token 使用量下降了 16.58%;与此同时,CodeGraph README 宣称,预索引能带来更低成本、更少 token、更短时间和更少工具调用。当前的变通方法是添加代码仓库指令、让索引持续保温,或在事后蒸馏执行轨迹,但每一种修补都会额外增加一层需要保持最新的东西。值得投入,因为同一天里多个彼此独立的制品,都在试图修复同一种无声的浪费。
没有来源和过期机制的记忆层,会变成杂物抽屉
严重程度:高。@Voxyz_ai 写道(71 个赞、6 条回复、15,911 次浏览、155 次收藏)指出,给 Hermes 或 OpenClaw 一味增加记忆,只会堆出一个杂物抽屉;只有把记忆拆成 remember、cite 和 forget,并加入层级、来源和过期检查,情况才会改善。@abdiisan 回复称 表示,Hermes 的内置记忆在长会话中时灵时不灵,直到 Mnemosyne 用混合向量加文本搜索取而代之;@shannholmberg 展示了 则提出了一个更结构化的替代方案,包含类型化链接、混合检索和夜间去重。@untold_bits 的一条回复概括了剩余问题:自动摄取很快,但如果没有人工质量闸门,它最终可能“随着时间推移变成一个巨大的垃圾团”。值得投入,因为构建者仍在用自定义插件、schema 包和清理任务来解决这个问题,而不是依赖一个稳定的默认方案。
编排开销仍让相当一部分开发者望而却步
严重程度:中。@ThePrimeagen 发帖称(963 个赞、68 条回复、32,835 次浏览)表示,“沉浸式深度思考,比某种疯狂而躁动的 agent 编排 fever dream 要平和得多”,而回复区里有很多人都在说,比起重 agent 的工作流,他们仍更享受缓慢、手动地构建。这种挫败感并不只来自怀疑者:@simonlast 建议(304 个赞、14 条回复、28,727 次浏览、171 次收藏)在改进测试 harness 的同时,明确警告“通常还是越简单越好”;@_avichawla 写道(51 个赞、9 条回复、5,980 次浏览、79 次收藏)则指出,一个工具到位的单 agent,通常胜过一整套多 agent 架构。当前的应对模式,是把确定性的控制逻辑下沉到运行时代码,把 human-in-the-loop 作为一种设计模式,并避免在一条更便宜的规则就能解决问题时继续往系统里塞 agent。值得作为设计约束认真对待:如果产品只增加编排开销,却没有增加可理解性,用户最终还是会回到更简单的循环。
3. 人们希望存在什么
在 agent 看到文件之前完成安全的技能审核
这不是模糊的愿望,而是一项紧迫且实际的需求。@elsontec 询问 询问,如何在防住提示注入的同时遵循流行的“先分析、后重建”建议;@JoeJ45665 询问 则追问,是否存在任何经过审核的 marketplace。@Trish_DIntel 和 @TulioSousapro 的回复把缺口说得很明白:问题必须在推理前解决,因为模型一旦读入恶意指令,损害可能就已经发生。今天,数据集中唯一算得上部分答案的,仍是人工审查加从头重建,但这显然无法扩展。机会:直接。
更快、可审计地编写 AGENTS.md 和 SKILL.md
人们不只是使用指令文件,也在要求更好的创建方式。@DanKornas 表示 表示,写一个高质量的 AGENTS.md,不该花上几周去翻资料;mimeo 的存在,正是为了发现来源、提炼内容、核验引语并生成最终制品。@omarsar0 发起了 推出了一套新课程,而 agent skills 就是第一课;AGENTS.md 论文 则暗示,这些文件一旦存在,回报就是可测量的。因此,这既是一个实际需求,也是一个竞争性需求:人们想要可审计的默认方案,但眼下的编写过程看起来仍主要依赖人工或模型。机会:直接且竞争激烈。
保持新鲜的代码仓库地图,以及持久化的任务状态
需求并不只是“更好的检索”。@Saboo_Shubham_ 展示了 给出的一个答案是代码图谱;但 @SynabunAI 警告称 提醒,过时的边会污染结果;@Bushmaster18523 询问 则呼吁拥有能跨越压缩、工具切换和交接而持续存在的持久化任务状态。CodeGraph README 和 AGENTS.md 论文 都指向了部分答案,但两者本身都无法独自解决“新鲜度”问题。这是一项投资回报清晰、且市场已开始成形的现实需求。机会:直接且竞争激烈。
面向 agent 集群的人类控制室
当天的构建者反复要求的是可见性,而不是更多自主性。@lawrencecchen 构建了 推出 cmux,是因为人类需要知道 agent 想在何时、何地沟通;@tom_doerr 分享了 推出 Hermes War Room,是为了在浏览器里看见委派和看板状态;@wyckoffweb 写道 则表示,用户应当始终知道某项任务是已获资助、已分配、已提交、已锁定,还是已准备好审查。现有产品通过仪表板和通知部分满足了这一需求,但底层需求更广:一个能让单个操作员看懂多 agent 状态的清晰工作界面。机会:直接。
以人工审批为前提的本地语言语音 agent
@dadbodshuffl 构建了(56 个赞、6 条回复、4,743 次浏览、37 次收藏)展示了一个支持 Gujarati、Hindi 和 English 的语音购物 agent。它用确定性的运行时步骤执行浏览器操作,且只有在获得明确批准后才会更新 Blinkit 购物车。回复很快就从“酷炫演示”转向具体用例:@buildwithsid 想要 想给自己的母亲做一个类似的东西;@ankit_auth 表示 则表示,他也能想象把同样的模式用在乡村制造业企业里。语音技术栈和浏览器工具已经提供了部分答案,但“本地语言 + 运行时确定性 + 明确审批”这一组合仍然罕见。机会:正在显现。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Harness engineering | 方法 | (+) | 通过指令、持久化状态、验证关卡和会话生命周期,让 agent 行为变得明确 | 如果团队把循环设计得过于复杂,可能演变成额外的编排负担 |
AGENTS.md |
代码仓库指令文件 | (+) | 仓库特定的架构、命令和约定可以减少探索性绕路;该 arXiv 研究报告称,中位运行时间下降了 28.64%,输出 token 减少了 16.58% | 只有在保持更新时才有效;编写和维护本身也会变成一项工作 |
| Understand Anything | 代码图 / 上手引导 | (+/-) | 交互式图谱、业务域视图、引导式导览,以及面向主流 agent 的快速安装 | 回复提醒,过时索引可能误导 agent;大型图谱仍需要严格维护新鲜度 |
| CodeGraph | 代码图 / 索引 | (+) | 预索引的本地图谱;README 宣称在 7 个代码库上降低了成本、token、耗时和工具调用 | 需要预先建立索引,而且基准测试结论来自项目方自身 |
| GBrain | 记忆层 | (+/-) | 类型化知识图谱、混合检索、夜间去重,以及面向语音的个人 agent 界面 | 自动摄取仍需人工质量把关,基础设施要求也高于纯 prompt 方案 |
| Mnemosyne | 记忆插件 | (+) | 为 Hermes 会话提供混合向量加文本搜索和实体召回 | 生态适配面较窄,除回复线程外公开证据有限 |
| Hermes Agent | Agent 运行时 | (+/-) | 多 profile 委派、SOUL.md 和 skills、看板,以及活跃的附加生态 | 内置记忆在长会话中时灵时不灵;可见性往往依赖附加组件 |
| cmux | 终端 UI / 通知 | (+) | 分栏通知、侧边栏元数据、应用内浏览器,以及对多并发 agent 的会话恢复 | 仅支持 macOS,而且只有在团队已同时管理大量会话时才最有价值 |
| Browser Harness | 浏览器自动化 | (+) | 自愈式 harness 能选择比字面 UI 流程更优的路径 | 公开证据仍以演示为主,行为也可能显得不够透明 |
| 本地开放栈(Qwen 3、Ollama、CrewAI、Cline、Browser Use、ChromaDB、Whisper、HF Spaces、OpenRouter、MCP) | 本地/开放栈 | (+/-) | 订阅成本低,覆盖面广,从模型到浏览器再到语音都有 | 隐性成本包括接线时间、笔记本性能上限、路由选择和模型质量参差不齐 |
| mimeo | 技能编写 | (+) | 自动完成来源发现、核验、批判性审查,以及 SKILL.md 或 AGENTS.md 输出 |
仍是早期项目;产物质量依然取决于来源选择和模型行为 |
| Dispatch | Agent marketplace | (+/-) | 任务有资金支持、状态清晰、付款前审查,并可积累声誉 | 仍处早期且基于测试网;信任与争议处理尚未被验证 |
最受欢迎的工具,都是那些把状态外显出来的工具:代码仓库指令、预索引图谱、类型化记忆层,以及通知界面。只要“新鲜度”或运营开销一进场,情绪就会转为复杂:图谱会过时,记忆层会吞进垃圾,本地栈会把笔记本拖垮,而编排界面如果不能减少工作,反而会增加工作。整体迁移方向很清楚:从原始 prompt 微调和不可见的后台 agent,转向代码仓库级指令文件、图谱与索引层,以及面向人的控制室。在代码仓库理解这一赛道,竞争张力最明显:Understand Anything 强调业务逻辑和引导式导览,而 CodeGraph 强调预索引本地图谱带来的更低 token 消耗和更少工具调用。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| GBrain v0.40.0 | @garrytan | 为持久化的 OpenClaw/Hermes 大脑加入 Gemini Live 语音 | 个人 agent 会忘记跨会话上下文,也缺少自然的交互界面 | GBrain、Gemini Live、OpenClaw/Hermes、类型化知识图谱、混合检索 | Alpha | 推文, 仓库 |
| Understand Anything | Lum1104 | 把代码库变成交互式图谱,并提供业务域视图与引导式导览 | agents 会反复重读仓库,缺乏结构或业务上下文 | TypeScript、多 agent 分析流水线、交互式仪表板、插件安装 | 已发布 | 推文, 网站, 仓库 |
| Orchestration War Room | Naroh091 | 覆盖 Hermes 委派和看板的浏览器仪表板 | 多 agent 集群很难通过原始终端会话来观察 | Vue、Node、Hermes CLI、浏览器仪表板 | Beta | 推文, 仓库 |
| cmux | @lawrencecchen | 基于 Ghostty 的终端,为编码 agents 提供通知、浏览器分栏和会话恢复 | 操作员需要知道哪个并行 agent 需要关注,并让长期会话保持可管理 | Swift、AppKit、libghostty、应用内浏览器、会话恢复 | 已发布 | 推文, 仓库 |
| mimeo | @DanKornas | 从专家公开语料生成 SKILL.md 或 AGENTS.md,并附带核验与批判性审查 |
手工编写高质量 agent 默认配置耗时过长 | Python、Parallel Search API、OpenRouter、可选 Whisper | Alpha | 推文, 仓库 |
| Dispatch | @wyckoffweb | 一个带有任务资助、审查、付款和声誉机制的 agent marketplace | agents 需要真实的工作层,而不只是一个聊天框 | Arc testnet、USDC、实时前后端、任务合约 | Beta | 推文, 网站 |
| Blinkit 本地语言语音购物 agent | @dadbodshuffl | 接收 Gujarati、Hindi 或 English 语音请求,在浏览器中操作 Blinkit,并在购物车变更前等待批准 | 非英语用户需要免提式商业交互,同时又不放弃控制权 | Sarvam Saarika、Saaras、Sarvam Translate、本地运行时、Playwright、Blinkit | Alpha | 推文 |
@Saboo_Shubham_ 挖掘出了(63 个赞、13 条回复、4,975 次浏览、135 次收藏)体现了当天最具代表性的构建模式:把原本隐藏的上下文外显成操作员可检查的对象。Understand Anything 通过图谱加业务域视图做到这一点;GBrain 通过类型化记忆层实现;mimeo 则通过明确的 SKILL.md 或 AGENTS.md 制品来实现。它们是不同的产品,但都在把 agent 状态从冗长 prompt 中移出来,放进能够被回看、版本化或审计的结构里。
@wyckoffweb 描述了(62 个赞、16 条回复、3,085 次浏览、8 次收藏)把 Dispatch 描述为一个真实的工作层:任务先获得资助、再被分配、接受审查,最后才付款。前文引用的那条讨论把差别说得很直白:重点不在于列出 agents,而在于给它们配上任务历史、付款逻辑,以及会随着已完成工作不断累积的声誉。

Hermes War Room 和 cmux 从两个相反方向解决同一个瓶颈:前者提供一个覆盖委派和看板的浏览器控制室,后者则在多个 agent 并行运行时提供原生终端通知层。@dadbodshuffl 补充道(56 个赞、6 条回复、4,743 次浏览、37 次收藏)则展示了数据集中最清晰的审批模式:让运行时代码处理浏览器动作,只有在获得明确批准后才真正提交购物车更新。5 月 23 日这些构建中反复出现的模式,并不是“不惜一切代价追求更多自主性”,而是更明确的状态、更清晰的交接,以及围绕真实动作收紧的审批边界。
6. 新鲜且值得注意的内容
AGENTS.md 研究为代码仓库指令文件给出了硬数据
@IntuitMachine 提到了(5 个赞、2 条回复、266 次浏览、11 次收藏)指向新的 arXiv 论文,这是一项关于编码 agents 的代码仓库级指令文件研究。其摘要之所以重要,在于它把一种民间最佳实践变成了可量化证据:在 10 个代码仓库和 124 个拉取请求上,AGENTS.md 条件带来了 28.64% 更低的中位运行时间和 16.58% 更低的输出 token 使用量,同时保持了可比的任务完成表现。这是本数据集中最明确的定量支持,表明仓库特定的 agent 指令是一种效率原语,而不只是文档卫生。
Agentic Harness Engineering 把 harness 调优变成了可观测的闭环
@TheDawningRoad 分享了(6 个赞、6 次转发、37 次浏览)介绍了 AHE 论文 及其用于自演化编码 agent harness 的代码仓库。论文最有辨识度的主张是结构性的,而不是修辞性的:它把 harness 改进拆成组件可观测性、经验可观测性和决策可观测性三个部分,并报告称,在 10 次迭代中,GPT-5.4 Terminal-Bench 2 的 pass@1 从 69.7% 提升到了 77.0%;repo README 还进一步表示,该系统后来凭借 GPT-5.5 在 Terminal-Bench 2.0 上排名第三。这让 AHE 成为当天最有分量、但互动不高的制品。
DAIR 把 agent skills 设为新 agentic-engineering 课程的第一课
@omarsar0 推出了(97 个赞、6 条回复、8,484 次浏览、123 次收藏)推出了一个新的 Agentic Engineering 系列,并明确从 Agent Skills 讲起。公开的 labs 页面 目前主打“构建你的第一个 Agent Skill”,并把 context engineering、多 agent 系统和长期运行 agents 作为后续模块。这一点值得注意,因为它说明 skills 和 harness 相关工作正在沉淀为课程体系,而不再只是零散的构建者讨论串。
7. 机会在哪里
[+++] 技能导入安全与推理前沙箱 —— 第 1、2、3 节的证据都指向同一个结论:技能文件正变得举足轻重,但 AlexFinn 的帖子及其回复表明,当前“先分析、后重建”的工作流在导入阶段仍可能被攻破。需求明确、痛点即时,而数据集中没有出现可信的默认解决方案。
[+++] 新鲜的代码仓库上下文与持久化任务状态基础设施 —— Understand Anything、CodeGraph、AGENTS.md 论文和 AHE 从不同角度攻击的是同一个问题:agents 重读太多、遗忘太多,或者基于过时结构运作。@Bushmaster18523 的回复又把需求从检索扩展到跨交接保留决策与证据。痛点、ROI 和反复出现的构建投入叠加在一起,使其成为全文最强的机会点。
[++] 面向 SKILL.md 和 AGENTS.md 的可审计编写与生命周期管理 —— Dan Kornas 的 mimeo 项目、DAIR 的新 labs,以及 AGENTS.md 效率论文,都表明指令文件正在成为一个真正的软件层,且回报可衡量。缺失的并不只是生成,还包括这些文件随时间推移的审查、diff、来源追踪和安全发布。
[++] 面向多 agent 工作的人类控制室 —— Hermes War Room、cmux 和 Dispatch 的存在,都是因为人们想知道哪个 agent 正在工作、被阻塞、在等待,或已准备好审查,而不是靠手动解析日志来猜。已有多个团队在这里布局,所以这不像技能安全那样还是一片空白,但需求信号非常明确。
[+] 采用审批优先运行时设计的本地语言语音 agent —— dadbodshuffl 的构建及其回复展示了一个实际而被低服务的市场角落:本地语言语音界面、对高风险部分采用确定性的运行时步骤,以及在状态变更前先获得明确批准。证据仍在形成,但下游用户请求已经来得既快又具体。
8. 要点总结
- Harness 工程正在被当作代码仓库基础设施,而不再是模型圈的经验之谈。 当天最强的证据来自明确的脚手架制品——
_vmlops对 harness 组件与成本的说明、Akshay 对 prompt/context/harness 的分类,以及AGENTS.md关于运行时间和 token 节省的论文——而不是单纯依赖更大的上下文窗口。(来源) - 指令文件如今既是性能杠杆,也是攻击面。
SKILL.md和AGENTS.md已经标准化到可以被基准测试、教学和自动生成,但 AlexFinn 的帖子说明,导入路径仍是一个危险且远未解决的问题。(来源) - 下一阶段的记忆增益来自来源、过期和可见性,而不只是更多存储。 remember/cite/forget 框架、类型化 gBrain 架构,以及 Mnemosyne 这一变通方案,都指向同一个教训:未经区分的记忆累积速度,往往快于它带来清晰度的速度。(来源)
- 构建者正在先用面向人的状态界面包裹 agents,再把真实工作交给它们。 Dispatch 的“审查后付款”流程、Hermes War Room 的浏览器仪表板、cmux 的通知提示,以及 dadbodshuffl 在更新购物车前要求明确批准,都押注于同一个设计判断:可见性优先于自主性。(来源)
- 编排复杂度本身已成为一种产品风险。 即使这一天充满了控制室和 harness 工具,互动量最高的推文之一仍来自 ThePrimeagen:手动深度思考比“躁动不安的 agent 编排”更让人安心;而 simonlast 也独立提醒,通常还是越简单越好。(来源)