Twitter AI Agent - 2026-05-26
1. 人们在讨论什么
1.1 技能正成为可训练的产品与可复用的工程资产 🡕
5 月 26 日最明显的变化是,“技能”不再像私藏的提示词包袱,而开始呈现为可迁移资产。在高信号内容中,它们同时以三种形式出现:可销售的市场产品、可供智能体训练的外部状态,以及可跨运行时安装的可复用工程习惯。相比 5 月 25 日对记忆层和 harness 术语表的强调,5 月 26 日则把同一理念进一步推进到了变现、优化和分发层面。
@Capafyai 发布了(373 个赞、227 条回复、254 条引用、119,630 次浏览)将 Capafy 描述为一个市场:在 Claude Code、Codex 或 OpenClaw 中构建的技能,可以在线运行,同时保持闭源。实时 Capafy 网站 已经列出了电商广告、简历筛选、社交媒体文案、PDF 生成和数据分析等领域的专家智能体,而 Capafy-skills 仓库 则解释了两种客户端流程——Capafy-Publisher 和 Capafy-User——以及闭源 Run Online 模式与普通 Download 模式之间的关键商业差异。
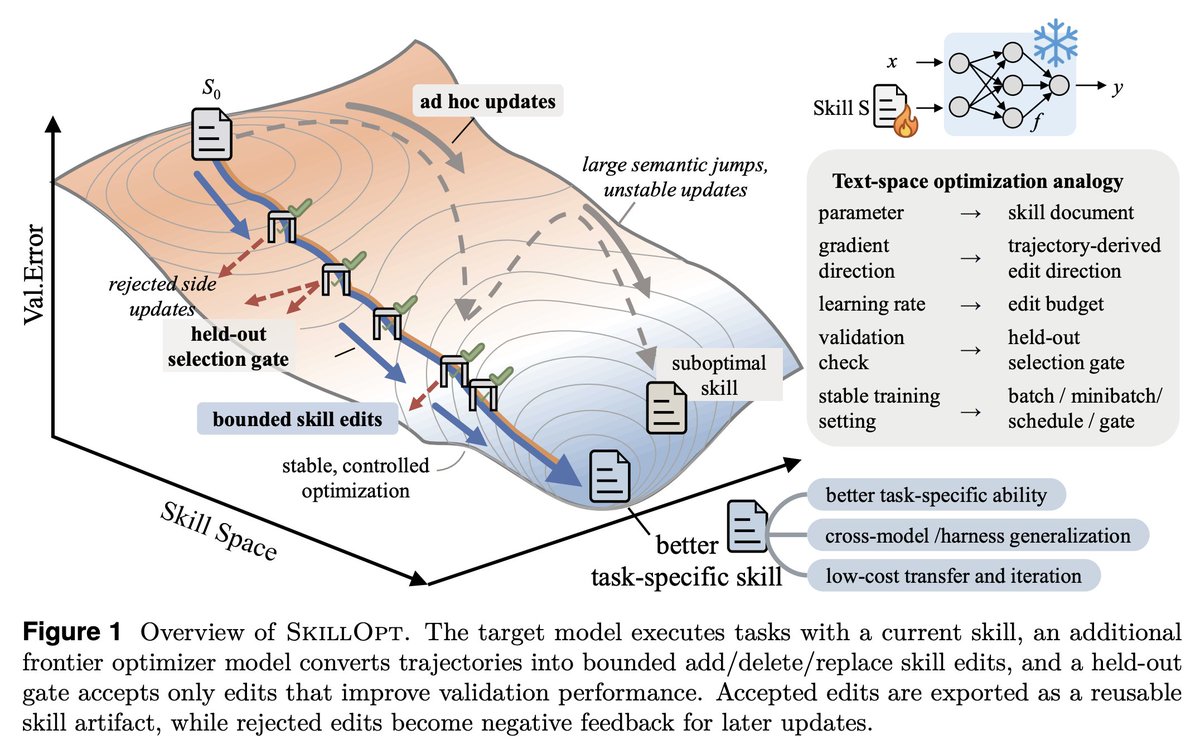
@koylanai 认为(231 个赞、502 次收藏、55,849 次浏览)介绍了 SkillOpt 如何将 SKILL.md 文件转化为可训练参数,并配套留出验证闸门、有界编辑预算和跨 harness 可移植性。配图让这一主张变得格外具体:被接受的修改幅度很小、经过验证且可复用,而不是大范围重写。SkillOpt 仓库 和 论文 进一步用六项任务上的基准覆盖与已报告的提升幅度支撑这一点,其中包括 GPT-5.5 在 Codex 风格 harness 中提升 +24.8 分。
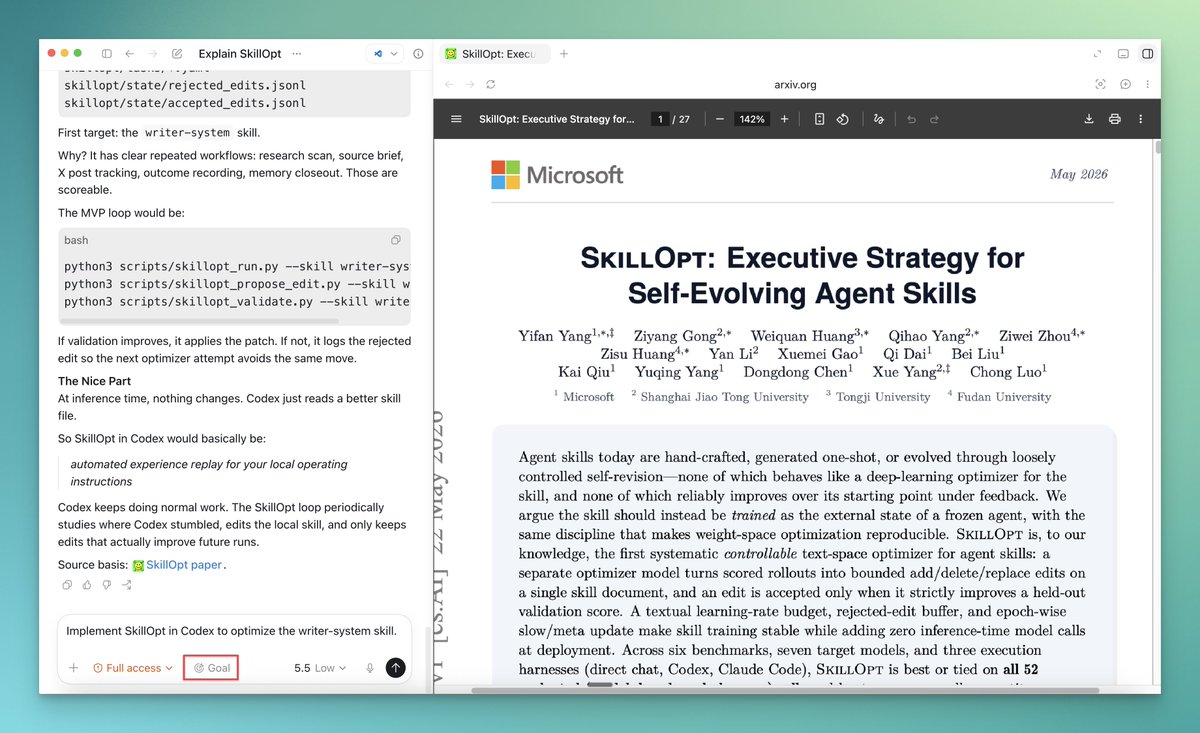
@daniel_mac8 翻译了(281 个赞、10 条回复、18,606 次浏览、343 次收藏)把这一研究思路变成了一套可运行的 Codex 习惯:先读论文,进入 /goal 模式,再在本地配置中实现这一循环。这张截图之所以重要,是因为它一边展示论文,另一边展示具体的脚本与目标工作流,把“可训练技能”变成了编码智能体可以立刻采用的实践模式,而不只是又一个收藏链接。
@HiTw93 打包了(47 个赞、9 条回复、10,160 次浏览)介绍了 Waza 的八项工程技能,涵盖规划、设计、调试、评审、阅读、写作、研究和健康检查。Waza 仓库 展示了 Claude Code 和 Codex 的安装流程,以及手动串联技能的方法,因此这篇帖子不只是关于习惯的口号,而是一套关于可复用工程行为如何跨智能体分发的具体方案。

讨论洞察: 回复并不买账那种模糊的“自我改进智能体”说法。大家反复回到几个问题:能否按单项技能进行度量、差异范围是否受限、安装入口在哪里,以及技能能否在不泄露底层诀窍的前提下被验证或出售。
与前一天对比: 5 月 25 日,技能主要被讨论为记忆层和可复用知识文件。到了 5 月 26 日,同一底层载体则更明确地被当作可以训练、安装和变现的对象。
1.2 Harness 设计从概念走向治理与可运维性 🡕
第二个主要主题是,harness 工程不再只是画架构图,而开始聚焦控制点:策略在哪里执行、状态存放在哪里,以及当智能体拥有真实权限或要服务多个用户时,会在哪些地方出问题。最有代表性的帖子把研究语言与具体实现接口结合起来,例如 YAML 策略内核、基于 Postgres 的状态,以及可组合的记忆层。
@_vmlops 强调了(215 个赞、8 条回复、15,069 次浏览、364 次收藏)将 Microsoft Agent Governance Toolkit 描述为一个确定性层:在工具调用真正发出前进行拦截,并提供 YAML 策略、身份机制、沙箱和防篡改日志。AGT 仓库 README 明确将提示词层安全界定为非控制面;但最有实质内容的一条回复补充了一个重要限制:工具调用层面的强制执行看不到提示词中的恶意指令,也看不到输出里的敏感内容,因此团队仍需要独立的输入与输出防护。
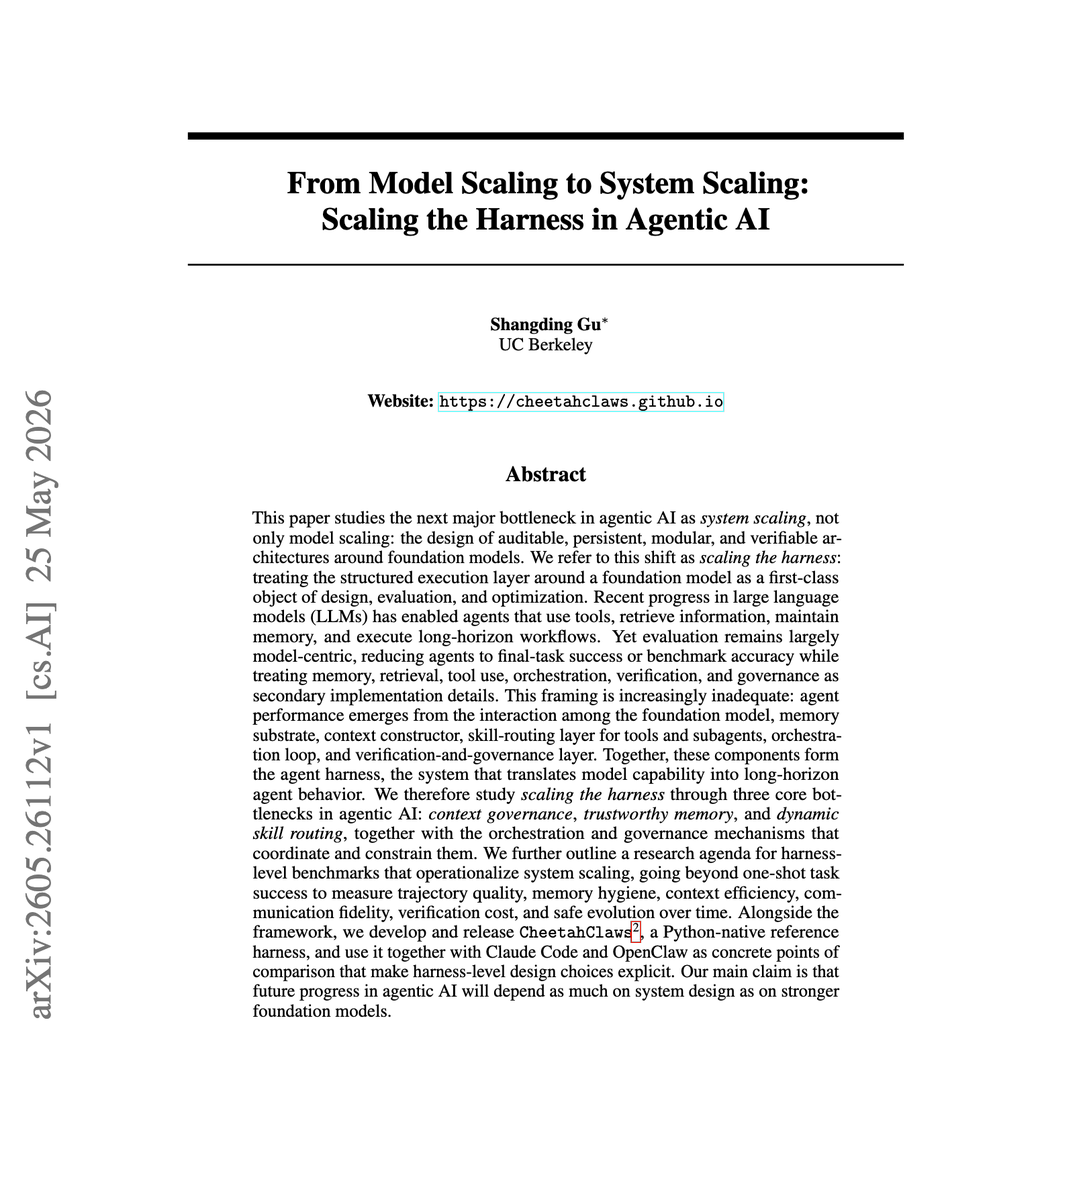
@dair_ai 重新定义为(59 个赞、10 条回复、3,530 次浏览、54 次收藏)把整个问题概括为“系统扩展”,认为如今智能体质量来自记忆、上下文构建、技能路由、编排、验证与治理,而不只是模型规模。论文配图之所以重要,是因为它直接点出了三个 harness 瓶颈——上下文治理、可信记忆和动态技能路由——并将它们与参考 harness CheetahClaws 联系起来;项目页面则将其描述为原生支持 Python 且与模型无关。
@Hey_Amiko 表示(9 个赞、190 次浏览)指出,OpenHermit 之所以存在,是因为一旦智能体系统超出单用户场景,本地文件、密钥和会话状态就会失控。OpenHermit 网站 和 仓库 明确划出了边界:内部状态放在 PostgreSQL 中,外部状态放在每个智能体各自的沙箱中,同时还提供面向整个集群的技能与 MCP 服务器 rollout 命令。@mattapperson 发布了(94 个赞、7 条回复、11,134 次浏览、120 次收藏)则以相似思路介绍了 Noetic,带有 七个可组合原语 和一种多层记忆模型,试图让上下文边界变得可读,而非神神秘秘。
讨论洞察: 回复最终收敛到同一个边界条件:光靠提示词不够。即便是偏乐观的帖子,也会被追问是否具备版本化策略、明确回滚、集中式状态,以及模型之外的确定性强制执行。
与前一天对比: 5 月 25 日的 harness 讨论仍以解读文章、架构图和资源地图为主。到了 5 月 26 日,讨论进一步下沉到运行时策略、集群运维,以及那些必须直接工程化解决的 harness 层瓶颈。
1.3 实时智能体开始拥有更快的语音回路和可视化前端 🡕
还有一个规模较小但很清晰的讨论簇,聚焦于后端回路足够快之后,智能体会“看起来、听起来”像什么。共同点并不是某个新模型本身,而是围绕既有智能体加上的封装层:更低延迟的对话推理、替代固定聊天面板的动态画布,以及无需替换整套栈就能增加视觉存在感的头像层。
@kwindla 报道称(88 个赞、4 条回复、7,712 次浏览、56 次收藏)称,由 Cerebras 提供服务的 Kimi K2.6 可以在 500 毫秒内完成启用推理的语音智能体单轮交互。这一点很关键,因为推理延迟通常会让对话式智能体变得难以使用。相关的 Cerebras 博客 声称其输出速度达到每秒 981 个 token,最终答案生成时间比官方 Kimi 端点快 29 倍;Kwindla 的回复则交代了实际技术栈:Pipecat Smart Turn、Nemotron 流式 ASR、Cerebras Kimi K2.6 和 Kyutai Pocket TTS。
@pika_labs 分享了(128 个赞、18 条回复、6,985 次浏览)介绍了“生成式 UI”:一种由语音控制的界面,智能体每一轮都会生成新的 HTML 布局,而不是往固定外壳里填内容。相关的 generative-ui README 说明,这是一个仅限本地运行的原型,基于 OpenAI Realtime、Pika MCP 和可选的 Google Workspace 工具;回复则强调,它是有意保持粗糙的实验品,并非面向生产环境。
@AiwithYasir 放大了(59 个赞、11,420 次浏览)介绍了 LiveAvatar 面向 LiveKit、Pipecat、Agora 和 VisionAgent 的插件接入路径。LiveKit LiveAvatar 文档 将其描述为叠加在现有语音应用之上的 Python 头像会话,这也强化了当天更大的趋势:多模态存在感正作为当前智能体栈之外的一层封装被加上去,而不是被视作一套独立技术栈。
讨论洞察: 这些帖子默认核心智能体已经存在。如今的工作重点正转向延迟、视觉编排和存在感层,让同一个底层智能体更像在对话,而不再只是困在终端里。
与前一天对比: 5 月 26 日的语音与 UI 信号比 5 月 25 日更明显。讨论从泛泛的“语音智能体”热情,转向了关于低于 500 毫秒回路、动态画布和头像插件的具体主张。
2. 什么让人沮丧
仅靠提示词的安全方案,总会在最需要信任的时刻失灵
严重程度:高。@RoundtableSpace 推荐了(50 个赞、14 条回复、37,788 次浏览)分享了一个用于安全审查的 Claude 单提示词方案,但回复几乎都指向同一个结论:@Trish_DIntel 说模型无法可靠识别自己会中哪些招,@OraclesTech 认为容易受提示词注入攻击的同一个模型,不可能靠自己保护自己,@0xDawny 则呼吁做代码审计,而不是修补提示词。AGT 线程则从反方向强化了同样的挫败感:@_vmlops 提到了(215 个赞、8 条回复、15,069 次浏览、364 次收藏)提出了确定性的工具调用治理,但一条详细回复仍指出,团队需要独立的提示词与输出防护。@tom_doerr 分享了(17 个赞、8 条回复、1,242 次浏览、22 次收藏)将 Cisco Skill Scanner 视作一种尽力而为的回应,而那个线程里也立刻有人追问:它能否捕捉多步骤数据外泄。人们目前的应对方式,是在模型之外叠加扫描器、策略内核和人工审查。值得投入建设:是。
单用户文件布局撑不过生产环境
严重程度:高。@Hey_Amiko 写道(9 个赞、190 次浏览)指出,一旦智能体框架超出单用户场景,本地文件会四散、密钥会泄露,扩展最终变成“SSH 加祈祷”。@dair_ai 认为(59 个赞、10 条回复、3,530 次浏览、54 次收藏)认为,真正的系统扩展瓶颈是上下文治理、可信记忆和动态技能路由;@mattapperson 发布了(94 个赞、7 条回复、11,134 次浏览、120 次收藏)则将 Noetic 描述为带有显式记忆与控制流原语的方案,而不是依赖框架的隐藏行为。当前可见的权宜之计,是集中内部状态、隔离工作区,并为技能、密钥和 MCP 服务器增加 rollout 入口。值得投入建设:是。
推理仍让语音智能体显得迟缓
严重程度:中。@kwindla 报道称(88 个赞、4 条回复、7,712 次浏览、56 次收藏)指出,推理模式带来的延迟是语音智能体的真实痛点,并把 Kimi K2.6 的速度视为其变得可用的原因。回复里的实际解决方式是栈级方案,而非单一模型方案:把 Pipecat Smart Turn、流式 ASR、快速推理和 TTS 一起调优,让用户不用干等模型“思考”。值得投入建设:是——这个痛点具体、可量化,而且直接关系到用户体验。
构建者正被术语泛滥拖慢进度
严重程度:中。@adithya_s_k 抱怨道(55 个赞、5 条回复、2,855 次浏览、28 次收藏)指出,harness、scaffold、上下文工程和 agentic workflows 这些术语常被当作共识来使用,尽管它们在实践中往往指的不是同一件事。回复大多是在感谢那篇术语表帖子建立了基础标准,而不是反驳这一抱怨。虽然这不如安全和扩展问题尖锐,但它依然在消耗工具评估、上手培训和框架比较的时间。值得投入建设:也许。
3. 人们希望出现什么
面向开放式智能体工作的验证器
数据里最明确的需求,是一种能像基准测试评判代码那样,严格评判写作、设计、策略与安全行为的闸门。@koylanai 写道(231 个赞、502 次收藏、55,849 次浏览)指出,验证是瓶颈,因为基准测试的自动评分器无法迁移到开放式工作;AGT 与 Roundtable 线程在安全层面也暴露出同样的缺口:团队可以拦截工具调用,但仍缺乏可靠的提示词、输入和输出评估器。@tom_doerr 分享了(17 个赞、8 条回复、1,242 次浏览、22 次收藏)把 Skill Scanner 当作一个部分答案,但它自己的 README 也把它定义为尽力而为,而回复立刻追问多步骤数据外泄。机会:直接。
面向智能体集群的生产控制平面,而不只是单兵智能体
人们想要的是:一旦牵涉团队或客户,智能体依然能把状态、密钥、日程和技能管理得可操作、可运维。@Hey_Amiko 描述了(9 个赞、190 次浏览)将 OpenHermit 视为单用户文件散落问题的解法,@mattapperson 将其定位为(94 个赞、7 条回复、11,134 次浏览、120 次收藏)将 Noetic 视为一个带有显式原语和记忆层的可定制 harness,而 @dair_ai 认为(59 个赞、10 条回复、3,530 次浏览、54 次收藏)则指出,如今真正的瓶颈已经是系统扩展。这是一个很务实的需求,而且市场上已经有可用的部分答案,因此机会确实存在,但竞争大概率会很激烈。机会:直接且竞争激烈。
面向专家技能的闭源分发与支付能力
Capafy 的发布主张之所以成立,只是因为底层需求本来就存在:人们已经在 Claude Code、Codex 和 OpenClaw 中做出了有价值的技能,但并不想把这些文件免费公开。@Capafyai 将其概括为(373 个赞、227 条回复、254 条引用、119,630 次浏览)给出的答案是闭源 Run Online 技能,用户可以直接调用,也可以通过另一个智能体接入使用。这个需求非常务实,也直接与钱有关,而非停留在愿景层面:保护诀窍、开放结果,并让别人为访问权限付费。机会:直接且竞争激烈。
可插入现有语音栈的视觉存在感
这些多模态帖子指向了一个具体的产品愿望:加上一张脸或一块画布,而不用从头重建智能体。@AiwithYasir 放大了(59 个赞、11,420 次浏览)将 LiveAvatar 定位为叠加在 LiveKit、Pipecat、Agora 和 VisionAgent 之上的一层,@pika_labs 展示了(128 个赞、18 条回复、6,985 次浏览)则展示了由同一对话回路驱动的动态 HTML 界面。这个需求仍在成形,但已经具体到构建者开始打包插件和实验,而不只是空谈多模态智能体。机会:竞争性机会。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| SkillOpt | 技能优化 | (+) | 有界编辑、留出验证、跨 harness 迁移、部署时零推理成本 | 需要可自动评分的任务;开放式验证仍然薄弱 |
| Capafy | 技能市场 | (+/-) | 闭源在线运行技能、浏览器访问、智能体到智能体使用,支持 Claude Code/Codex/OpenClaw | 上线初期的信任与市场质量仍未被验证 |
| Agent Governance Toolkit | 治理 / 安全 | (+/-) | 确定性的工具调用强制执行、YAML 策略引擎、身份机制、沙箱、审计日志 | Public Preview;自身不会检查提示词/输入/输出内容 |
| Noetic | Harness 框架 | (+/-) | 七个可组合原语、可读控制流、可插拔记忆、评估支持 | 早期 alpha、公开影响力较小、文档仍较粗糙 |
| Waza | 技能包 | (+) | 八项聚焦的工程习惯、跨智能体安装、无遥测、明确的评审/调试回路 | 仍然依赖手动串联和用户自律 |
| OpenHermit | 智能体基础设施 | (+) | 基于 Postgres 的状态、每个智能体独立的沙箱、频道、日程、全集群 rollout 控制 | 需要数据库与沙箱运维,而单智能体工具往往回避这些复杂度 |
| Pipecat + Cerebras Kimi K2.6 | 语音智能体栈 | (+) | 低于 500 毫秒的单轮交互、推理在语音场景中仍可用、从 ASR 到 TTS 的栈组合清晰 | 性能主张绑定于调优过的基准栈,而非默认配置 |
| LiveAvatar | 头像插件 | (+/-) | 无需替换整套栈,就能给现有语音应用加上实时头像会话 | 多了一层插件/API key 复杂度,线程里几乎没有运营者反馈 |
| Pika Generative UI | 实验性界面 | (+/-) | 动态 HTML 布局、实时画布、覆盖面广的 MCP 创意工具界面 | 仍是粗糙实验、仅限本地原型,并依赖 Pika MCP 和 Realtime API |
| Skill Scanner | 安全扫描器 | (+/-) | 静态、YARA、LLM 与行为分析,并支持 CI/CD 和 pre-commit | 仅属尽力而为;回复质疑其对多步骤数据外泄的覆盖能力 |
总体满意度更偏向那些把结构显式化、而不是藏起来的工具。@koylanai 描述了(231 个赞、502 次收藏、55,849 次浏览)将 SkillOpt 视为有纪律的技能训练,@HiTw93 打包了(47 个赞、9 条回复、10,160 次浏览)将 Waza 视为显式的工程习惯,而 @Hey_Amiko 拆分为(9 个赞、190 次浏览)则强调 OpenHermit 把状态从工作区中分离出来。情绪分化主要集中在安全与体验仍不完整的地方:@_vmlops 推广了(215 个赞、8 条回复、15,069 次浏览、364 次收藏)认可确定性治理,但回复立刻追问提示词/输出层面的覆盖;@pika_labs 称之为(128 个赞、18 条回复、6,985 次浏览)把 Generative UI 视为实验;@kwindla 打造了(88 个赞、4 条回复、7,712 次浏览、56 次收藏)则明确指出,语音可用性仍取决于端到端延迟是否足够紧。当天的迁移轨迹十分一致:从只靠提示词的行为,转向可安装的技能与评估回路;从本地文件,转向集中式状态加沙箱;从纯文本智能体,转向语音与视觉封装层。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Capafy | @Capafyai | 一个市场:专家技能可以作为闭源智能体在线运行,也可以作为下载内容出售 | 在不立即泄露逻辑的前提下,让专有智能体技能实现变现与分发 | Python、Web 市场、Claude Code/Codex/OpenClaw 客户端 | Beta | 网站, 仓库, 帖子 |
| Noetic | @mattapperson | 由七个可组合原语和可插拔记忆构成的 TypeScript harness | 让开发者无需忍受黑盒框架行为,也能构建自定义 harness | TypeScript、Bun、步骤原语、记忆层、评估工具 | Alpha | 网站, 仓库, 帖子 |
| OpenHermit | @Hey_Amiko | 用于部署智能体集群的平台,提供集中式状态和每个智能体独立的沙箱 | 解决多用户扩展、密钥散落和全集群技能 rollout | TypeScript、Hono、PostgreSQL、Docker/E2B/Daytona | Beta | 网站, 仓库, 帖子 |
| Waza | @HiTw93 | 面向规划、调试、设计、评审、研究和健康检查的跨智能体技能包 | 将隐性的工程习惯转化为可复用的智能体命令 | Markdown 技能、辅助脚本、npx skills、Claude Code/Codex/Cursor/Pi |
Shipped | 仓库, 帖子 |
| Agent Governance Toolkit | @_vmlops | 在工具调用执行前强制实施规则的策略层 | 阻止不安全操作、增加溯源信息,并插入人工审批闸门 | Python 包、YAML 策略引擎、TS/.NET/Rust/Go SDKs | Beta | 仓库, 帖子 |
| Pika Generative UI | @pika_labs | 由语音控制、每轮生成新 HTML 布局的界面 | 用与上下文相匹配的视觉编排,取代僵硬的聊天面板 | JavaScript、OpenAI Realtime、Pika MCP、可选 Google Workspace | Alpha | 仓库, 帖子 |
| Skill Scanner | @tom_doerr | 扫描智能体技能中的提示词注入、数据外泄和恶意代码模式 | 为技能包和智能体指令增加部署前安全审查 | Python、YAML/YARA、LLM 分析、行为数据流、SARIF | Beta | 仓库, 帖子 |
Capafy、Waza 和 SkillOpt 从三个不同角度展示了同一种反复出现的构建模式:卖技能、装技能,或训技能。@Capafyai 推出了(373 个赞、227 条回复、254 条引用、119,630 次浏览)代表市场化形态,@HiTw93 打包了(47 个赞、9 条回复、10,160 次浏览)代表可复用工程习惯形态,@koylanai 描述了(231 个赞、502 次收藏、55,849 次浏览)代表可训练优化形态。三者共同的触发因素,是人们对通用智能体输出不满,并希望得到持久、可检查的行为。
OpenHermit、Noetic 和 AGT 则覆盖了同一趋势的运维侧。它们都默认智能体回路已经存在;现在最难的是,当系统离开单用户笔记本之后,如何处理状态、权限、rollout 和恢复。Pika Generative UI 则通过把布局视为另一种智能体输出界面,为这一模式补上了前端分支;Skill Scanner 也表明,技能安全已经开始成为一个独立构建类别,而不再只是事后补丁。
6. 新鲜且值得关注的内容
技能文件拥有了真正的训练回路
@koylanai 认为(231 个赞、502 次收藏、55,849 次浏览)指出,SkillOpt 将 SKILL.md 视为带有有界编辑和留出验证的可训练外部状态;@daniel_mac8 展示了(281 个赞、10 条回复、18,606 次浏览、343 次收藏)则展示了如何通过 /goal 模式,直接把这一回路拉进 Codex。这一组合之所以重要,是因为它在同一天就把研究结果转化成了实际工作流。
提示词自审迅速失去公信力
最尖锐的讨论模式不是一次发布,而是一场反驳。@RoundtableSpace 提出了(50 个赞、14 条回复、37,788 次浏览)展示了一个面向 Claude 智能体的单提示词安全审查方案,而回复立即指出,模型无法可靠检测那些它自己本来也会漏掉的提示词注入路径。这使得 @_vmlops 分享(215 个赞、8 条回复、15,069 次浏览、364 次收藏)提出的确定性治理内核,比孤立来看更值得关注。
智能体界面开始逃离聊天框
@pika_labs 介绍了(128 个赞、18 条回复、6,985 次浏览)展示了一块每轮都改变布局的生成式 HTML 画布;@AiwithYasir 放大了(59 个赞、11,420 次浏览)则把 LiveAvatar 呈现为现有语音栈上的几行代码扩展。再加上 @kwindla 展示(88 个赞、4 条回复、7,712 次浏览、56 次收藏)所展示的低于 500 毫秒的语音智能体单轮交互,信号已经很明确:前端实验终于开始追上模型速度。
7. 机会在哪里
[+++] Open-ended verifier layers for agents and skills — @koylanai 点名指出(231 个赞、502 次收藏、55,849 次浏览)指出验证是瓶颈,@RoundtableSpace 引发了(50 个赞、14 条回复、37,788 次浏览)展示了为什么自审提示词无法赢得信任,而 @tom_doerr 分享了(17 个赞、8 条回复、1,242 次浏览、22 次收藏)则是一个尽力而为的扫描器,其回复立刻追问更深层覆盖能力。这个机会很强,因为它同时出现在安全、技能优化和评估工具三个方向。
[+++] Operable multi-user agent infrastructure — @Hey_Amiko 描述了(9 个赞、190 次浏览)直接点出单用户文件问题,@dair_ai 命名为(59 个赞、10 条回复、3,530 次浏览、54 次收藏)把上下文治理、可信记忆和动态技能路由列为瓶颈,而 @mattapperson 发布了(94 个赞、7 条回复、11,134 次浏览、120 次收藏)则围绕显式原语和记忆边界介绍了 Noetic。这个信号很强,因为痛点发生在运维层,而不是停留在愿景层。
[++] Closed-source skill distribution and monetization — @Capafyai 推出了(373 个赞、227 条回复、254 条引用、119,630 次浏览)介绍了一个围绕闭源 Run Online 技能搭建的市场,而 Waza 和 SkillOpt 则显示出对可安装、可训练技能工件的相邻需求。这个机会属中等强度,因为需求显而易见,但市场信任、质量控制和定价能力仍未定型。
[+] Voice-agent presence layers — @kwindla 展示了(88 个赞、4 条回复、7,712 次浏览、56 次收藏)指出更快的推理会改变语音可用性,@pika_labs 尝试了(128 个赞、18 条回复、6,985 次浏览)展示了动态画布,而 @AiwithYasir 指向了(59 个赞、11,420 次浏览)则展示了面向现有技术栈的头像插件支持。这个信号仍处于形成期,尚未成为主流,但用户体验层显然已经打开。
8. 要点总结
- 技能正在成为一等产品界面。 Capafy 的市场发布和 Waza 可安装的工程习惯,都把技能视为持久资产,而不是个人提示词文件。(Capafy, Waza)
- 技能优化正从直觉走向纪律化训练。 SkillOpt 的有界编辑和留出闸门,再加上 Codex 的
/goal实现模式,表明智能体行为开始像可复用工件一样被改进,而不是临时反复改提示词。(SkillOpt 讨论, Codex 工作流) - 如今,harness 才是质量与信任的决胜处。 CheetahClaws 论文明确把上下文治理、可信记忆和动态技能路由列为瓶颈,而 AGT 则把策略强制执行下沉到提示词层之下。(系统扩展, AGT)
- 仅靠提示词的安全建议正在失去公信力。 安全相关线程里最强烈的反应不是兴奋,而是反驳:模型无法可靠审计自身的提示词注入弱点,这也让扫描器、策略内核和其他外部控制的需求持续高企。(安全提示词讨论串, Skill Scanner)
- 随着延迟下降,智能体构建者正把更多时间花在存在感与界面上。 低于 500 毫秒的语音单轮交互、动态 HTML 布局和头像插件,都指向同一个下一步:让同一个智能体显得更快、更可视,也更面向人类用户。(Kimi 语音栈, Pika Generative UI, LiveAvatar)