Twitter AI Agent - 2026-06-26
1. 人们在讨论什么
1.1 “循环工程”被正式命名并公开为一门实践学科(🡕)
当天最核心的叙事,是“循环工程”(loop engineering)凝结为一种有明确名称、有文档沉淀、带有专属代码仓库、操作手册与术语体系的实践方法。同一天,一个循环工程 GitHub 仓库被广泛传播;与此同时,一份据称出自 Anthropic 一位资深工程师的 11 页操作手册也在流传。Boris Cherny 的一句话成为这场转变最具代表性的总结:“我已经不再直接给 Claude 写提示词了。我有一些循环,会替我给 Claude 写提示词。”至少有 6 条高信号内容支撑了这一主题。
@hasantoxr 提出 (34 个赞、6 条回复、5,699 次浏览、52 次收藏) 将 Loop Engineering 仓库称为“提示工程之后的下一步”。该仓库包含一系列具体模式——每日分诊循环、PR 看护循环、CI 清扫循环、依赖清扫循环、变更日志起草循环——以及用于搭建循环、估算 token 成本、审计仓库就绪度、添加记忆与状态、加入人工交接、设置验证关卡的 CLI 工具。

@cyrilXBT 放大阐述 (79 个赞、17 条回复、6,033 次浏览、33 次收藏) 介绍了该仓库的发布,并配上了 Boris Cherny 的那句名言。@DataChaz 总结 (34 个赞、4 条回复、3,822 次浏览、33 次收藏) 则介绍了配套的 11 页 Anthropic 操作手册,其中以清晰的五步拆解了循环的结构:发现(代理从失败的 CI 和未关闭 issue 中自行寻找工作)、隔离(使用独立的 git worktree,避免并行代理相互覆盖)、验证(让第二个代理在“假定代码有问题”的前提下审查第一个代理的结果——“绝不能让代理给自己打分”)、持久化(将结果写入磁盘,而不是困在上下文窗口中)、调度(由计时器自动再次触发)。
@rileywestreel 分享 (10 个赞、8 条回复、440 次浏览、10 次收藏) 分享了该操作手册首页的截图,确认手册将这一术语分别归于 Peter Steinberger、Boris Cherny 和 Addy Osmani,三人都在 2026 年 6 月的同一周内独立收敛到相同的想法。
@4rblaber 发布 (12 个赞、9 条回复、186 次浏览、9 次收藏) 用两页图示正式拆解了闭环的五个构件:(1) 触发器与 worktree——隔离执行环境;(2) 代理运行框架(技能)——以系统提示词形式注入操作规范;(3) MCP 连接器——连接 Sentry、Jira 和 CLI 工具;(4) 持久化状态——通过 GitHub Issue 评论记录尝试与错误;(5) 并行子代理——将生成与评估分离。第二张图中的最小可行循环(MVL)框架,则给出了五步认知周期:设定目标、注入上下文、执行与评估、自我反思(回灌原始 stderr,而不是依赖推测性的 AI 批评)、迭代或终止。

@_avichawla 补充 (14 个赞、1 条回复、1,348 次浏览、15 次收藏) 最清楚地解释了循环工程真正自动化的是什么:如今被移除的是外循环——也就是人类阅读代理输出、撰写下一条提示词并捕捉失败的那一层。它的权衡也说得很明白:把自己移出循环,意味着即便仍保有所有权,也会失去对过程的理解;同时还会新增对停止条件、上下文裁剪和独立验证的要求。
讨论洞察: 最有价值的回复戳破了炒作。@bojan_ai 回复 cyrilXBT:“‘内置验证’这一部分才是全部关键。没有验证器的代理循环,只会按计划不断累积自己的错误。”@ffflukeee 补充道:“这个仓库给你的是解剖结构,不是判断力。每个人都能搭出循环,几乎没人能告诉它什么时候该停。”
与前一天相比: 6 月 25 日,循环架构开始进入讨论,成为一种设计方法;6 月 26 日,它则通过一个正式命名的术语、一个上线首日超过 800 star 的仓库、一份归因于 Anthropic 的操作手册,以及一套清晰的权衡词汇,被系统化了。
1.2 护城河在运行框架:结构化上下文胜过模型选择(🡕)
另一条并行主线认为,真正的竞争面是运行框架,而不是模型本身。多条高互动帖子收敛到同一个判断:模型选择只决定结果的一小部分,围绕模型构建的指令、上下文、工具、可观测性和验证机制,才决定了大多数结果。至少有 4 条高信号内容支撑这一点。
@businessbarista 分享 (140 个赞、14 条回复、24,643 次浏览、205 次收藏) 分享了 Tenex Labs 一位工程负责人对整体工作模式倒转的描述:“现在我们把 95% 的时间和精力花在规划上,5% 花在执行上。”Tenex 构建了可自我改进的结构化工程上下文工具,让代理能即时获取产品意图、架构、约定、交付流程和计划,因此“系统几乎可以自行组装”。@dipankarsarkar 的热门回复则精准点出了机制:“护城河变了。不是代理本身,而是你喂给它的结构化上下文:意图、约定、计划。一旦这层底座开始自我改进,代码就只是构建产物。”
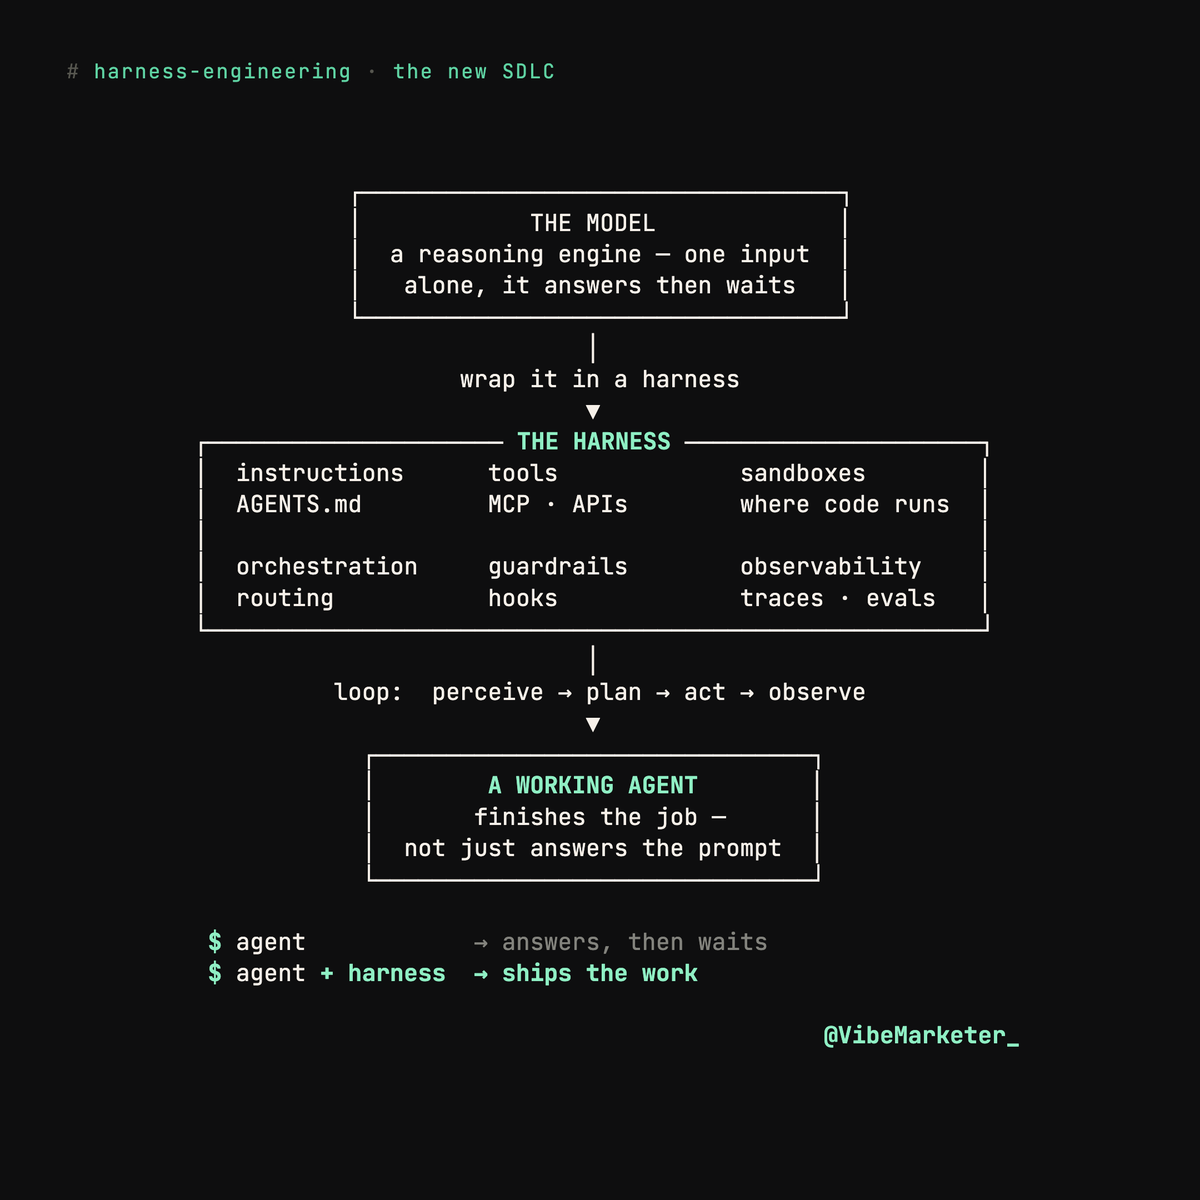
@VibeMarketer_ 综合提炼 (39 个赞、11 条回复、2,702 次浏览、62 次收藏) 将 Google 的 50 页代理式工程操作手册概括为:“模型可能只占结果的 10%,另外 90% 来自运行框架。”配图把这个论点可视化了——单独的模型回答完就停;被运行框架包裹的模型则会把工作真正交付出去。这里的运行框架包括指令、工具、沙箱、编排、护栏、可观测性、路由、hooks 和追踪。
@omarsar0 澄清 (105 个赞、18 次转发、16 条回复、9,274 次浏览、148 次收藏) 指出,动态工作流——运行框架组合的前沿形态——只适用于“极少数用例”,应被视为测试时算力,并且必须把验证器作为一等组件;在这个领域,“前沿模型并不具备在运行时动态生成最优运行框架的能力”。配图展示了根据 Anthropic 动态工作流指南复现的 6 种 Claude 运行框架模式:分类并执行、扇出并综合、对抗式验证、生成并筛选、锦标赛,以及循环直到完成。

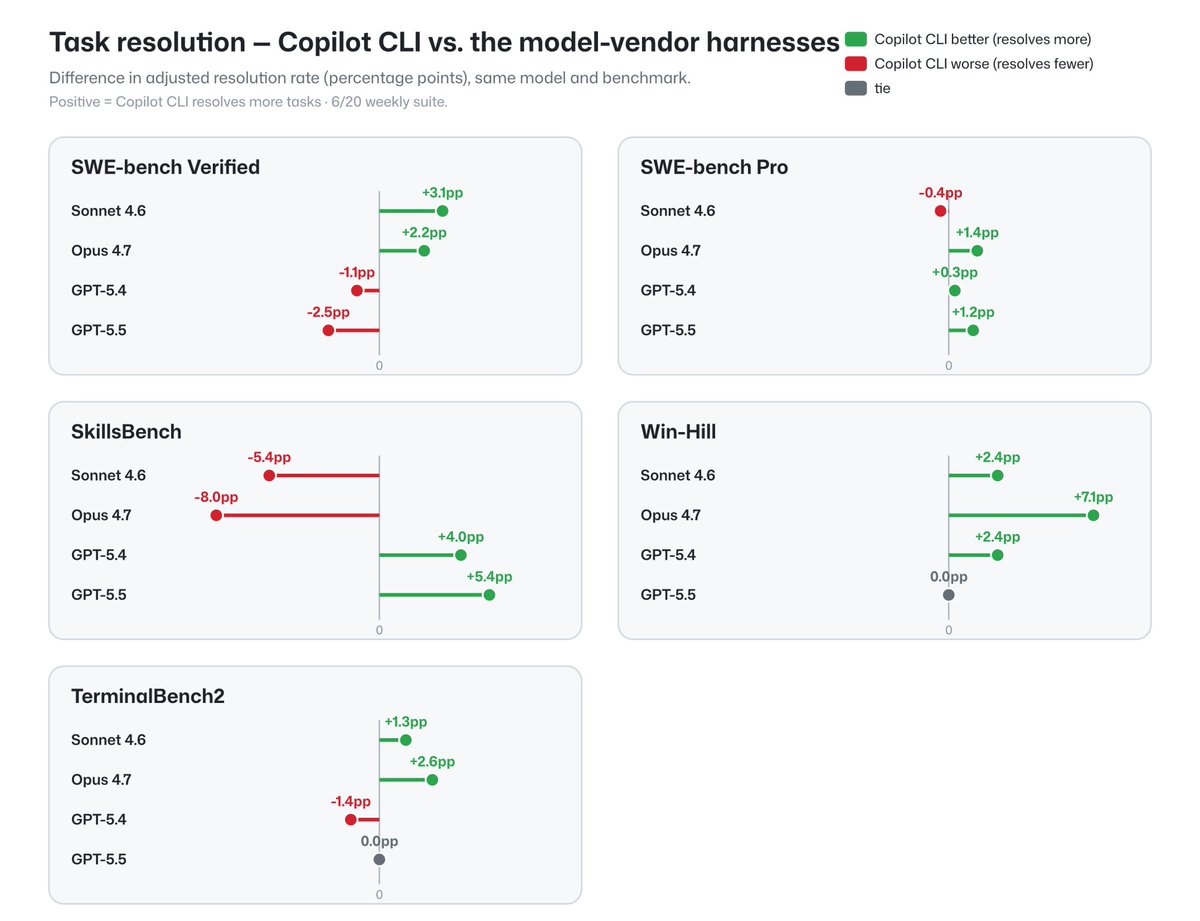
@pierceboggan 发布 (56 个赞、5 条回复、3 次引用、2,420 次浏览、16 次收藏) 发布了首个公开基准,对比 GitHub Copilot 的代理式运行框架与模型厂商自带的运行框架。图表显示,运行框架优势取决于具体模型:在使用 Claude 模型的 SWE-bench Verified 上,Copilot CLI 胜过模型厂商的运行框架(Sonnet 4.6 高 3.1 个百分点,Opus 4.7 高 2.2 个百分点);但在 SkillsBench 上表现更差(分别低 5.4 和 8.0 个百分点)。而在 GPT 支持的实验中,结果则呈现相反模式。数据强化了一个结论:运行框架与模型是相互作用的关系,而不是简单线性叠加。
讨论洞察: omarsar0 的讨论串里出现了一段很有价值的交流:有人追问验证器应该是提示词中的一部分,还是独立文件,说明团队已经开始把验证当作一个明确的架构层来设计。还有人指出,像 Mythos 这样的新模型,未来可能会比通用前沿模型更适合做编排型运行框架。
与前一天相比: 6 月 25 日,运行框架这一术语主要是通过架构指南进入讨论;6 月 26 日则新增了量化基准证据(Copilot 数据)、Google 操作手册的提炼,以及一线从业者关于规划/执行比变成 95/5 的实时经验。
1.3 记忆操作系统:EverOS 凭借鲜明的本地优先设计冲到 8.7k star(🡕)
记忆基础设施是当天第三大主题,核心由两条分别介绍 EverOS 的帖子带动——它既是一个 Python 库,也是一个本地优先的记忆运行时。两条帖子都传播甚广,足以使 EverOS 成为当天围绕记忆展开的头号讨论对象。
@kate_osita_ 描述 (125 个赞、51 次转发、28 条回复、8,648 次浏览、73 次收藏) 将 EverOS 介绍为一个开源“记忆操作系统”,旨在帮助代理随着时间推移进行记忆、反思与演化,并提供一个能跨不同代理工作流使用的便携式记忆层。她重点强调的功能——Knowledge Wiki、把反思视作做梦、便携式代理记忆、自我进化技能——也正是该仓库 README 用来区别传统记忆库的特征。
@KylieHopkinsX 提供 (117 个赞、52 次转发、28 条回复、10,983 次浏览、71 次收藏) 介绍了其技术细节:以 Markdown 作为权威事实源,使用本地 SQLite + LanceDB 做检索,分离用户记忆与代理记忆轨道,支持多模态摄取,并具备自我进化技能。她的帖子链接到 GitHub 仓库 github.com/EverMind-AI/EverOS;截图显示,该仓库当时已有 8.7k star 和 776 fork。仓库描述为:“跨代理与平台的自我进化记忆。为用户使用的每一个代理——Claude Code、Codex、OpenClaw、Hermes 等——提供唯一的便携式记忆层。”


讨论洞察: 最有价值的回复来自 @Timur_Yessenov:“当代理只能检索出一团 blob,而人类却无法检查或修复它时,记忆系统就失效了。相比多模态摄取,我会先测试过期偏好的清理。”这种权衡——人类可检查性 versus 功能丰富度——比发布帖本身更尖锐地呈现了从业者的顾虑。
与前一天相比: 6 月 25 日介绍的是 memlawb 这一零知识记忆层;6 月 26 日出现的 EverOS 则采用了覆盖更完整工作流的本地优先设计——不只是加密,而是涵盖存储、检索与自我改进的完整闭环——且 star 数高出约 10 倍。
1.4 Razorpay 的 Slash:上线一个月后日处理 5,000 个任务,并计划做模型路由(🡕)
@shashank_kr 发布 (106 个赞、11 次转发、12 条回复、17,732 次浏览、80 次收藏) 发布了 Razorpay 内部代理 Slash 的一个月更新。截至最新统计,Slash 每天处理超过 5,000 个任务,且还在快速增长。它会生成代码、审查每一个 PR、编写测试用例、监控生产环境、支持事故复盘,并为新进 bug 做分诊。销售、市场和支持团队也在使用它。团队路线图包括接入 WhatsApp 和电子邮件渠道(而不只是 Slack)、根据任务复杂度自动选择合适运行框架和模型的模型路由,以及让 Slash 随每次交互持续更新组织知识库。
更新中引用的 Slash 最初的发布帖 给出了详细指标:一周内处理 14,854 个任务,提出 2,150 个 PR,其中 1,152 个已合并;45% 的成果在零人工返工的情况下直接交付;一次自动扩缩容运行节省了每月 560 美元的 K8s 成本;一名非开发者通过 Slash 修复了营销横幅,全程无需前端工程师参与。提交过 11 个及以上 Slash PR 的工程师,平均无返工合并率为 63%,而首次使用者只有 37%。
讨论洞察: @killix 提出了最有实质性的治理问题:“5,000 个任务/天已经是生产流量,不是实验了。我会关注的不是代码生成质量,而是哪些写入、部署、退款或面向客户的操作,可以在没有第二个参与者处于环内的情况下发生。”
与前一天相比: 6 月 25 日展示的是带有早期 beta 指标的垂直领域代理;6 月 26 日则出现了目前最具体的规模化案例之一:跨职能的自然采用、真实的成本节省,以及已经把路由、渠道和记忆纳入规划。
1.5 不透明的多模型编排在毫无可见性的情况下烧掉配额(🡕)
@SaharaAI 分析 (33 个赞、7 次转发、17 条回复、6,687 次浏览) 以 Sakana 的 Fugu 模型为案例,讨论了编排层的不透明性。Fugu 是一个协调器(约 7B 参数),经过训练后会拆解任务并将其路由到一组更大的第三方模型,再递归调用自身。其公布的基准成绩——SWE-Pro 54.2、GPQA-D 95.1、LiveCodeBench v6 93.2,且三项都高于 Opus、Gemini 3.1 和 GPT 5.4——都属于前沿级表现。以这种体量的协调器取得这样的成绩,强烈暗示真正完成大部分工作的其实是底层模型。两名用户都意外触达使用上限:@LLMJunky 称一条提示词就耗尽了其五小时配额的 100%;@cortesi 则付费购买了 200 美元档位,发现 API 很慢,而且不到一小时就打满额度。帖子还指出,Anthropic 短暂开放 Fable 访问时,用户也报告了类似的配额燃烧现象。
@demian_ai 映射 (74 个赞、8 次转发、8 条回复、8,201 次浏览、49 次收藏) 解释了每一个代理步骤最终如何落到硬件层:CPU 负责编排,DRAM 承载上下文与状态,SSD 存储日志与追踪,网络支撑分布式任务,沙箱负责工具使用,可观测性系统负责遥测;并据此指出,代理式工作负载让“无聊”的基础设施变得至关重要,而这一点常被以 GPU 为中心的叙事忽略。

讨论洞察: @sooyoon_eth 将这种信任风险命名为“环境式权限”(ambient authority):“真正的复杂性和风险在编排层与工具沙箱里。”@demian_ai 回应道:“ambient authority 这个命名很漂亮。”这个术语精准抓住了风险所在——当代理能跨系统调用工具时,它会逐步累积起任何单次调用都未明确请求的权限。
与前一天相比: 6 月 25 日讨论的是支付层和数据访问层作为基础设施;6 月 26 日则明确点出了多模型系统中的可见性与信任缺口,是下一个尚未解决的问题。
2. 什么让人沮丧
代理无法给自己的工作打分,而大多数循环都没有独立验证器
严重程度:高。围绕循环工程的讨论暴露出一个反复出现的痛点:自我评分的代理会系统性地产生过度自信的结果。@DataChaz 描述 (34 个赞、3,822 次浏览、33 次收藏) 转述了 Anthropic 操作手册中的明确规则:“绝不能让代理给自己打分。”@rileywestreel 总结 则点出了问题的关键:“代理给自己的工作打分时,总会判自己通过。现在稀缺的不是生成能力,而是判断力。”@4rblaber 形式化定义 将其概括为“生成器—批评者验证模式”:一个 Builder Agent 提出解决方案,另一个独立 QA Agent 则在并行循环中、以“假定代码有问题”为前提尝试找出漏洞。两个代理会相互对话、批评并协同重构。现实里,人们实际交付的大多数循环实现都缺少这一约束。常见补救办法始终是增加第二个模型,或用二元/确定性测试充当外部验证器,但工程成本确实不低。
上下文膨胀会拖垮长时运行循环,而业界没有标准补救方案
严重程度:高。@_avichawla 识别出 (14 个赞、1,348 次浏览、15 次收藏) 总结了外循环自动化中的四个叠加问题:上下文每轮都在增长(模型会随着上下文填满而变差)、没有标准的裁剪方法、把大输出移到文件并把子任务拆成独立运行会增加系统复杂度、而且每一轮都要重发完整上下文,使长循环变得昂贵。标准应对方式仍然是手动做上下文管理——裁剪、摘要、路由——但尚不存在自动化的通行标准。
多模型编排会在用户毫无解释能力的情况下烧尽配额
严重程度:高。@SaharaAI 记录 提到了 Sakana Fugu 发布后的两个具体配额耗尽案例:一条提示词打满五小时配额的 100%,以及一名 200 美元档位用户在不到一小时内就触顶。两位用户都无法解释到底跑了哪些模型、递归调用了多少次,或为什么单条提示词会花掉这么多。Anthropic 开放 Fable 访问时也出现了同样的模式。“你无法给不可预测的东西定价,也无法调试不可追踪的东西。”这个问题值得投入建设,因为它影响的是生产预算规划,而不只是爱好者使用体验。
大多数公司仍卡在第 1 层(任务自动化),无法推进到工作流重构
严重程度:中。@mardehaym 量化采用差距 (18 个赞、15 次转发、543 次浏览、8 次收藏) 指出:88% 的公司停留在第 1 层(任务自动化,节省 20%–30% 时间,但没有结构性变化),从未进入第 2 层(工作流重构,此处 ROI 才开始复利)或第 3 层(代理团队:2–5 名人类监督 50–100 个代理,目前只有 6% 的公司处在这一层)。

3. 人们希望出现什么
一套能自动处理发现、验证、持久化与调度的标准外循环
围绕循环工程的讨论指出了一个非常具体的空白:内循环(模型 + 工具)一直都是自动的,但外循环——发现待办工作、把任务隔离到 worktree、由独立代理验证输出、把状态持久化到磁盘、以及按计划再次触发——仍然需要人们一个模式一个模式地手工拼装。@hasantoxr 发布 提供了一个带起步模式的仓库,但多条回复都明确表示,“这个仓库给你的是解剖结构,不是判断力。”人们想要的是一套可用于生产的循环运行框架,把停止条件、上下文管理、验证关卡和调度打包在一起,并且能在 CI 中稳定运行。机会:直接。
能跨会话持久化、可在本地检查、还能从经验中演化的记忆
@kate_osita_ 总结 表达了这种判断:“下一代 AI 产品的定义因素不会是模型规模,而会是记忆。”EverOS 的 8.7k star 以及围绕它的回复讨论表明,人们对这样一种记忆有强烈需求:本地存储、以 Markdown 形式可读可改、分离用户与代理记忆轨道,并且能从经验中演化出技能,而不是只存原始历史。@Timur_Yessenov 明确提出的关键需求是可检查性:“当代理只能检索出一团 blob,而人类却无法检查或修复它时,记忆系统就失效了。”机会:直接。
面向多模型与编排式代理运行的执行可见性
@SaharaAI 表示 直白地说明了需求:“执行可见性正在成为核心基础设施。”当一次 API 调用扇出成一群子调用、而每个子调用又可能继续产生更多调用时,用户就失去了预测成本、归因性能和审计实际运行内容的能力。一个能够追踪到底跑了哪些模型、调用了多少次、每次调用花了多少钱、原始提示词触发了什么的工具,会直接解决 Fugu 和 Fable 暴露出的配额耗尽与调试难题。@demian_ai 指出 也从基础设施角度指向同一需求:每个代理步骤最终都会落到硬件,而那些能把这些运行变得足够可理解、足够值得信任的团队,将拿下下一层基础设施。机会:直接。
能自我改进的结构化工程上下文工具
@businessbarista 报告 提到,Tenex Labs 构建了自定义的结构化工程上下文工具,为代理即时提供产品意图、架构、约定、交付流程和计划,而且这套系统会随时间自我改进。热门回复提出了一个尖锐问题:“你们现在是否已经像给代码做版本管理一样,给上下文做版本管理了?”讨论串里没人给出清晰答案。从业者希望有现成方案,能像管理源代码那样维护、版本化并呈现结构化工程上下文。机会:直接。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Loop Engineering repo | 代理式循环框架 | (+) | 为每日分诊、CI 清扫、PR 看护提供具体模式;配有用于脚手架生成与成本估算的 CLI 工具 | 提供的是结构,不是判断;停止条件和验证仍需手工补上 |
| EverOS | 代理记忆 / 记忆操作系统 | (+) | 8.7k star,本地优先(Markdown + SQLite + LanceDB),自我进化技能,人类可检查,Apache-2.0 | 需要自行托管;过期偏好清理与多模态摄取被认为仍需验证 |
| Claude Code + dynamic workflows | 代理式编码运行框架 | (+/-) | 6 种可组合的运行框架模式;配合 Sonnet/Opus 在 SWE-bench 上表现强劲 | 动态工作流只适用于少数用例;前沿模型尚未针对运行框架生成做最优训练 |
| GitHub Copilot agentic harness | 编码代理运行框架 | (+/-) | 在 Claude 模型的 SWE-bench Verified 上优于模型厂商运行框架(Sonnet +3.1pp);在 Win-Hill 上表现强 | 在 Claude 模型的 SkillsBench 上落后(Sonnet -5.4pp);性能强烈依赖模型与基准 |
| Hermes Atlas | 资源中心 / 代理生态 | (+) | 提供免费指南库、技能、记忆工具、插件和扩展;收藏率高(67/4,977 次浏览) | 社区整理;看不出官方维护信号 |
| Sakana Fugu | 多模型编排器 | (+/-) | 约 7B 协调器却拿到前沿级基准成绩(SWE-Pro 54.2、GPQA-D 95.1);单一 API | 执行过程不透明;用户在不到一小时内烧掉 200 美元以上配额,却看不到子调用细节 |
| Ampersend Marketplace | 代理式商业 / API 支付 | (+) | 按次付费的在线服务市场,无订阅、也无需按供应商分别结算;已列出 Exa、Laso Finance、BlockRun.AI | 市场仍早期;服务目录深度取决于供应商参与度 |
| n8n + Claude + MCP | 个人自动化技术栈 | (+) | 通过单一通道连接 GTM 技术栈与自动化;MCP 集成带来原生工具访问 | 需要良好的配置纪律;从业者仍强调不会轻易把一切都自动化 |
6 月 26 日的整体趋势,是从评估“该选哪个模型”,转向评估“该构建在哪种循环架构和记忆栈之上”。工具讨论集中在系统层面的问题:如何把验证编进循环、如何让记忆对人类可检查、以及如何让多模型运行可追踪。具体工具提及中,Claude 系列模型占据主导;Codex、Cursor 和 Grok 则作为循环工程语境下的替代选项出现。
一个迁移模式尤为清晰:过去把 AI 编码理解为“提示、等待、复制、修复、重复”的开发者,正在转向设计成闭环系统——他们不再待在循环内部操作,而是站到循环之外。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Loop Engineering repo | Addy Osmani 等 | 一套用于设计“自动向代理发出提示”的系统模式与 CLI 框架 | 把人类从代理式编码工作的内部反馈循环中移除 | Node.js/npm,兼容 Claude Code/Codex/Cursor/Grok,GitHub Actions | 已发布 | 推文, GitHub |
| EverOS | EverMind-AI | 面向代理的本地优先记忆操作系统,支持自我进化技能 | 代理跨会话遗忘上下文,缺少便携且可检查的记忆层 | Python 3.12+、Markdown、SQLite、LanceDB、Apache-2.0 | 已发布 | 推文, GitHub |
| Slash (Razorpay) | @shashank_kr + Razorpay engineering | 内部代理,可生成代码、审查 PR、分诊 bug,并在工程和业务团队中每天处理 5,000 个任务 | 人工工程协调、跨团队知识瓶颈 | Claude、Slack、GitHub、Linear、K8s;正扩展到 WhatsApp/电子邮件 | 已发布 | 推文 |
| Cohere vLLM-skills | Cohere AI | 用于维护长期 vLLM fork 的开源代理技能 | 通过自动化 rebase/测试/修复控制循环,把原本需数周的 fork 同步工作压缩到数天 | vLLM、Cohere 模型、开源技能库 | 已发布 | 推文, GitHub |
| Guardian CLI | @VivekIntel | AI 驱动的渗透测试框架,包含 50+ 安全工具、多代理工作流和 RAG 驱动分析 | 面向侦察、漏洞评估、证据收集与报告生成的自主安全审计 | Python 3.11+、OpenAI/Claude/Gemini/OpenRouter/Ollama、Nmap、Nuclei、SQLMap、Semgrep、BloodHound、MIT | 已发布 | 推文, [推文中的 GitHub 链接] |
| Ampersend Marketplace | @ampersend_ai | 面向代理的按次付费 API 市场——无订阅,也不按供应商分别计费 | 代理需要浏览并支付外部 API 服务,同时不想手动管理凭证 | AgentCore Payments、x402、代理原生钱包,已有 9+ 服务类别上线 | 已发布 | 推文 |
| Cantina Apex | @chrispyprojects | 面向 Web3 安全审计的自主 AI 漏洞猎手 | 传统审计耗时数月、费用超 50 万美元;AI 可在几天内以数千美元完成相当结果 | 多供应商 LLM、代理式循环、由运行框架扩展的算力 | 已发布 | 推文 |
Loop Engineering 和 EverOS 是当天信号最强的两个开源发布。Loop Engineering 提供了社区此前一直零散拼装的外循环自动化框架;EverOS 则提供了使循环在多次运行之间保持状态的记忆底座。
Cohere 发布的 vLLM-skills 值得注意的原因不同:它证明了,将循环工程应用到 DevOps 维护——尤其是 fork 同步——能够显著压缩时间(从数周缩短到数天),并产出可回流上游、成为共享基础设施的工件,也就是这些技能本身。
Cantina Apex 的安全审计数据,是这组数据中最强的已发布 ROI 论据:有效 bug 数量与算力呈对数线性增长,能够检测饱和点,在大规模运行时消除不确定性,并以专家主导审计 1/100 到 1/1000 的成本,在基准测试中取得相当甚至更好的表现。
Slash、vLLM-skills 和 Loop Engineering 共同反复呈现出一个模式:最有说服力的 builder 案例并不是产品发布本身,而是把控制循环应用到边界明确、结果可衡量的具体运营问题上——例如 PR 审查、fork 维护、CI 清扫——并且循环会在真实条件满足时终止。
6. 新消息与值得关注的内容
Anthropic、Google Chrome 与开源社区围绕“循环工程”形成术语收敛
根据该操作手册自己的摘要,三位彼此独立的从业者——Peter Steinberger、Boris Cherny(Anthropic 的 Claude Code 负责人)和 Addy Osmani(Google Chrome)——都在 2026 年 6 月的一周内独立收敛到“循环工程”这一术语。这种收敛并不常见:不同公司的从业者在没有协调的情况下,为同一变化起出同样的名字,通常意味着底层实践已经被足够广泛地采用,到了肉眼可辨的程度。Loop Engineering 仓库在上线当天就拿到了 800+ star,而这份归因于 Anthropic 的操作手册至少出现在 6 个讨论串中,并吸引了 LangChain、Razorpay 以及独立构建者参与。@rileywestreel 提到 (10 个赞、440 次浏览、10 次收藏) 指出:“现在稀缺的不是生成能力,而是判断力。”
AI Engineer World Fair 在 LangChain 设置了专门的“运行框架工程”会场
@Vtrivedy10 宣布 (47 个赞、6 条回复、5,120 次浏览、16 次收藏) 介绍了 AI Engineer World Fair(2026 年 7 月 1 日)的一场议程,题为“改进代理是一个数据挖掘问题”,将循环工程之后的下一前沿定义为追踪挖掘与持续学习。议程卡确认,“运行框架工程”已成为正式会议分会场,并把追踪数据定位为代理改进的生命线:“每一个持续学习平台,最终看起来都会像一个可观测性平台。”

Razorpay 的 95/5 规划/执行比例走红,成为企业校准信号
@businessbarista 分享 (140 个赞、24,643 次浏览、205 次收藏) 传播了一个甚至在工程圈外也引起共鸣的具体运营指标:95% 的时间用于规划,5% 用于执行。这个比例与传统代理式叙事里的“只要告诉代理做什么就行”形成鲜明对照,也意味着关键的工程投入,不在模型,也不只在循环本身,而在为两者供给输入的结构化上下文系统。
7. 机会在哪里
[+++] 内置验证与调度的生产级外循环工具 —— 来自第 1、2、3 和 5 节的证据表明:Loop Engineering 仓库提供了模式,但几乎每个从业者讨论串都指出了同样的缺失——可靠的停止条件、外部验证关卡、上下文裁剪,以及能在生产 CI 中稳定运行的调度机制。Anthropic、Google 和一位独立社区构建者在同一周内收敛到同一个术语,也进一步说明需求真实存在,而采用仍处于早期。机会在于把这套结构打包为可部署的运行框架,处理 _avichawla 所列举的那些权衡。
[+++] 本地优先、可检查、且能自我进化的代理记忆基础设施 —— 来自第 1、3 和 5 节的证据表明:EverOS 通过让记忆对人类可读(Markdown)、可在本地运行(无需托管服务),并为代理行为随时间演化提供结构,拿到了 8.7k star。Timur_Yessenov 指出的缺口——先保证可检查性,再谈功能丰富度——仍是一个尚未解决的设计约束。能够覆盖完整生命周期(存储、检索、过期、更新、以技能形式呈现),并能在 Claude Code、Hermes、Codex 和 OpenClaw 之间便携工作的记忆基础设施,拥有很大的可服务空间。
[++] 多模型编排的执行可见性与追踪 —— 来自第 1、2 和 3 节的证据表明:Fugu 的配额耗尽案例,是系统性问题的早期信号。当一次 API 调用扇出为递归 swarm 时,用户无法做预算、无法调试,也无法证明实际运行了什么。下一轮基础设施竞争,将属于那些能让复杂代理运行变得可理解的团队。现有可观测性工具并不是为递归式多模型扇出而设计的,而 LangChain 关于追踪挖掘的提法(第 6 节)也从代理改进的角度指向了同一空白。
[++] 帮助卡在第 1 层的企业完成代理式工作流重构 —— 来自第 1 和第 2 节的证据表明:mardehaym 的四层模型及其明确统计数据(88% 在第 1 层、6% 在第 3 层、不到 1% 在第 4 层)既描述了当前企业采用的分布,也揭示了第 2 层(工作流重构)的价值缺口。Razorpay Slash 的案例则展示了第 3 层在生产规模下的样貌。无论是咨询服务、工具,还是运行框架产品,只要能帮助公司从第 1 层走向第 2 层,面对的都是一个巨大且当前供给不足的转型市场。
[+] 低于 1 万美元成本的自主安全审计 —— 来自第 5 节的证据表明:Cantina Apex 已公布的数据——以 1/100 到 1/1000 的成本替代 50 万美元以上的审计、漏洞发现数量与算力呈对数线性增长、并在规模化时消除不确定性——是当天所有领域中最清晰的代理自动化 ROI 证据。一个正在浮现的担忧是:“雇一名研究员,可能也意味着雇用他自建的运行框架。”这意味着市场最终会围绕运行框架质量,而非研究员人数,发生收敛。
8. 要点总结
-
循环工程在一周内凝结为一个正式命名的实践,并迅速形成社区级通用词汇。 Anthropic、Google 与开源社区的 3 位独立从业者几乎同步收敛到这一术语,而相关仓库在上线首日就突破 800 star。它描述的转变——从“向代理发提示词”转向“设计会向代理发提示词的系统”——也正是 businessbarista、VibeMarketer_ 与 mardehaym 在同一天各自独立描述的变化。(来源)
-
运行框架如今已是竞争面,而不再只是配置细节。 Tenex Labs 的 95/5 规划/执行比例、Google 操作手册中“模型只占 10%”的表述,以及 GitHub Copilot 的基准数据,都指向同一个结论:在生产级代理系统里,运行框架工程决定了绝大多数结果差异;包含结构化上下文、独立验证与可观测性的运行框架,会优于缺少这些能力的方案。(来源)
-
EverOS 的 8.7k star 证明,本地优先、对人类可检查的记忆已成为一个独立且有价值的产品类别。 它的架构细节——以 Markdown 作为权威事实源、本地 SQLite + LanceDB、分离用户与代理轨道,以及自我进化技能——正好对应了厂商托管方案尚未解决的记忆权衡;而 star 数也说明,这种需求绝非纸上谈兵。(来源)
-
Sakana Fugu 的配额耗尽案例,把“环境式权限”明确为多模型编排中的信任问题。 当协调器以递归方式将任务路由到多个模型时,用户会失去预测成本、证明实际运行内容的能力。生产团队在把真实工作流交给编排式代理之前,首先需要执行可见性。(来源)
-
Razorpay 的 Slash 在上线一个月后达到日处理 5,000 个任务,是目前最清晰的公开证据,说明代理式第 3 层采用在现实中是什么样。 资深 Slash 用户 63% 对比新手 37% 的无返工合并率、45% 的零返工 PR,以及已规划的模型路由路线图,都说明这是一个会随着使用而持续复利、而非很快见顶的系统。(来源)