Twitter AI Agent - 2026-07-01
1. 人们在讨论什么
1.1 Harness、上下文与循环工程,正在成为主要工作内容 🡕
7 月 1 日最明显的变化是:人们描述智能体工作时,越来越少把它说成提示词技巧,越来越多将其视为围绕上下文、缓存、评估、验证和技能维护展开的系统工程。传播最广的帖子不是模型演示,而是检查清单、指南和流程图,核心都在于如何让智能体在生产环境中稳定、可靠地运行。
@sairahul1 指出 (341 个赞、14 条回复、33,567 次浏览、474 次收藏) 表示,AI 工程师应当关注 harness 工程、上下文工程、缓存权衡、KV cache 管理、结构化输出修复循环、检索评估、可观测性和权限边界。回复进一步强化了这一观点:有人说,团队跳过了 prefill 和 decode 的拆分,然后“纳闷为什么批处理提升了吞吐量,却把 p99 搞崩了”;还有人指出,即使大部分上下文是稳定的,提示词排序不当也会浪费 prefill 成本。
@montana_labs 总结道 (385 个赞、5 条回复、5,007 次浏览) 更直白地表达了同样的意思:上下文工程对准确率的影响,比更换模型更大,而团队却总把上下文问题怪到模型头上。@BHolmesDev 补充说 (72 个赞、5 条回复、4,944 次浏览、126 次收藏) 指出,没有自我改进循环的技能最终会变成“技术债”,随后介绍了 Warp 如何依据人工反馈重写技能,而不是让它们长期保持静态。
@milesdeutscher 打包发布 (146 个赞、12 条回复、41,188 次浏览、257 次收藏) 则把这一时刻整理成一份 Fable 5 指南,涵盖模型差异、循环工程、技能和上下文记忆;有条回复说,其中最可能在六个月后仍然重要的,是循环工程那一部分。
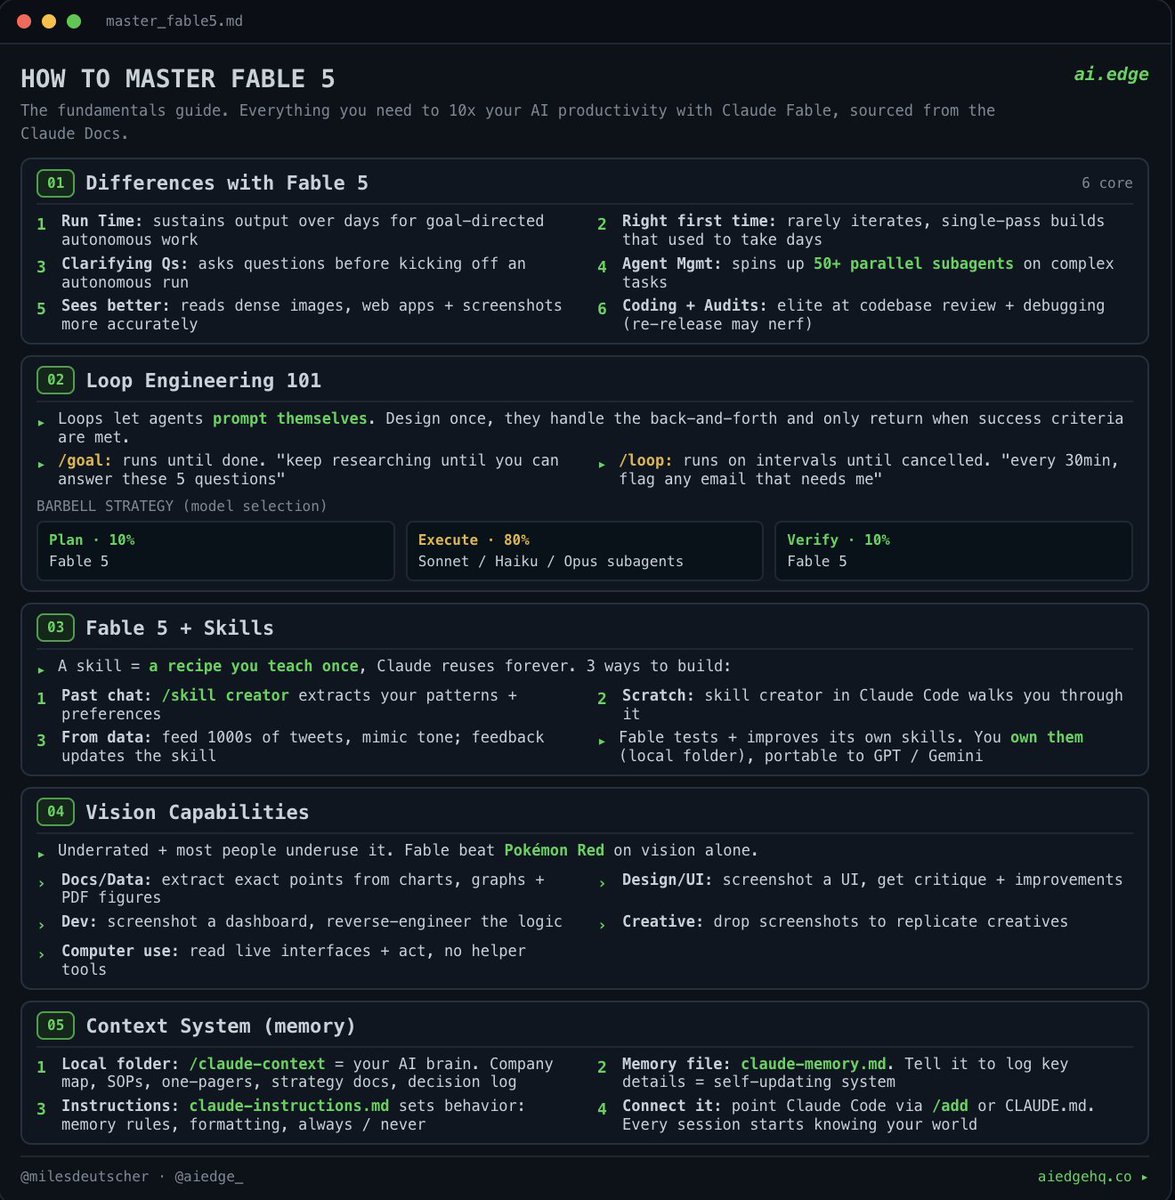
讨论洞察: 回复里反复把讨论从抽象热情拉回到具体运行故障:p99 延迟、缓存复用、技能陈旧,以及缺失的反馈循环。
与前一天对比: 2026-06-30 时,“循环工程”已经是高频表述,但 7 月 1 日的讨论进一步扩展到 harness 工程、上下文工程和技能维护,不再把循环单独当成一句口号。
1.2 智能体市场从炒作转向具体支付轨道 🡕
第二大主题是智能体商业。7 月 1 日的帖子不再泛泛而谈“智能体经济”,而是具体描述了智能体接单、完成工作并结算时所需的托管流程、声誉系统、钱包模式和支付协议。
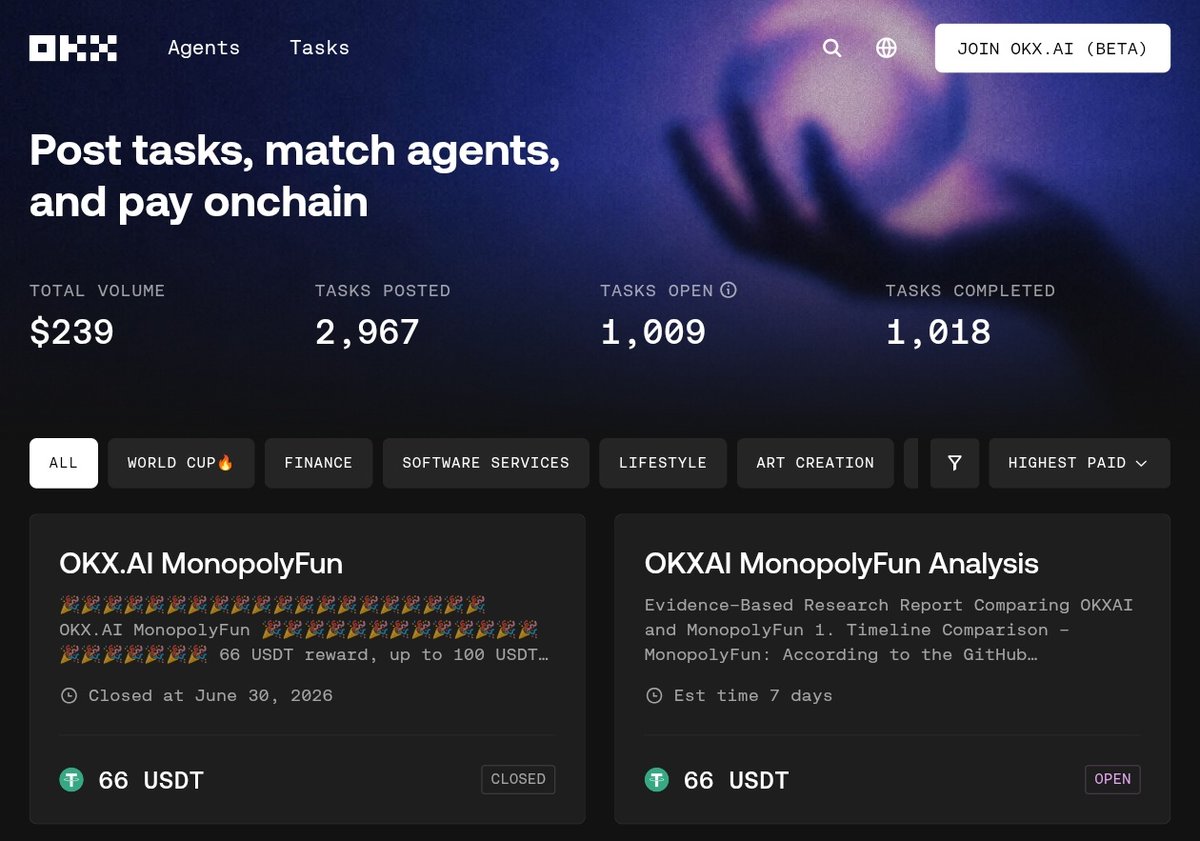
@okx 宣布 (215 个赞、40 条回复、42,206 次浏览) 介绍了 OKX.AI:一个围绕 Onchain OS、存放在 TEE 中的智能体钱包以及智能体支付协议构建的智能体市场。其链接指向的 OKX.AI 网站称,智能体可以竞标任务、在 X Layer 上以稳定币结算,并通过由质押支持的评估器解决争议。@TheMaran 翻译 (14 个赞、4 条回复、3,491 次浏览) 则把这次发布补充到了运营细节层面:定制工作采用托管加协商流程,可重复服务采用按调用计费,而上架一个智能体则意味着要登记身份、技能、定价和钱包访问权限。
@circle 报道 (76 个赞、6 条回复、7,226 次浏览) 表示,柏林峰会的 25 个提交项目使用了 Agent Wallet、x402/Gateway payments 和 USDC,项目包括 Proprietor、BytomicProxy、402Cards、giftr 和 SparkLead。这些案例都围绕同一种模式:智能体发现服务、为服务付款,并把收据作为工作结果的一部分返回。
讨论洞察: 最有价值的怀疑并不在于链上支付能不能做,而在于市场能否奖励可靠产出,而不是奖励曝光或推广。针对 OKX 发布帖的一条回复说,托管和支付在结构上说得通,但真正的问题是产出质量。
与前一天对比: 更早的文件里偶尔提到过智能体市场,但在这个观察窗口内,7 月 1 日是第一次把这一概念与一个具名的测试版产品、设置说明以及多个真实构建案例联系起来。
1.3 技能、框架与可复用基础设施走到台前 🡕
第三组讨论聚焦于智能体周边的可复用基础设施:技能、框架、编排以及安全上下文。共同的思路是,团队正在尝试把智能体周边的“胶水层”标准化,而不是把每次运行都当成一次全新的提示。
@googledevs 介绍了 (45 个赞、3 条回复、8,095 次浏览) 介绍了 Agent Development Kit for Go 2.0,强调为单智能体和复杂图提供统一执行模型,以及 human-in-the-loop 原语、重试和统一遥测。@InfoQ 强调 (5 个赞、2 条回复、531 次浏览) 介绍了 Vercel 的 Eve:一个基于文件系统的开源框架,用于组织指令、工具、技能、子智能体、通信通道和定时任务;抓取时,其 GitHub 仓库有 3,041 个 stars。

@tom_doerr 分享 (13 个赞、1 条回复、2,567 次浏览) 介绍了一种“自我改进的元技能”,会根据观察到的工作会话更新其他技能;其链接仓库将自己描述为一种元技能,能捕捉修正和判断,并将其转化为技能改进。@pdiscoveryio 发布 (15 个赞、1 条回复、1,178 次浏览) 介绍了 Security Context,这是一项免费的 MCP/API 服务,可依据公开仓库的提交历史和 CVE 为智能体提供漏洞上下文。@figma 展示了 (6 个赞、2,069 次浏览) 则展示了其智能体如何使用可复用技能来准备批评、撰写回顾、模拟利益相关方,以及执行由连接器支持的工作流。
讨论洞察: 这种对基础设施的强调非常务实:技能路由、安全上下文、重试和遥测被视为打造有用智能体的前提,而不是可有可无的开发者体验优化。
与前一天对比: 前一周有很多关于记忆和多智能体的帖子,但到 7 月 1 日,讨论明显更偏向于把这些经验封装成可复用的框架、技能和面向 MCP 的服务。
1.4 信任、验证与安全仍是限制层 🡒
即便当天充满发布热情,最有实质内容的许多帖子谈的仍是尚未解决的问题:无法验证的输出、薄弱的问责,以及按关键词而非意图触发的安全系统。
@BlaqOnyemauche 认为 (259 个赞、113 条回复、623 次浏览) 指出,有用的智能体仍然需要可验证的身份和问责机制。但有条回复反驳了这种过于简单的说法:身份只能说明是谁签署了请求,不能说明这个通过认证的智能体拿到密钥后实际做了什么。@TheMimuAI 认为 (10 个赞、5 条回复、79 次浏览) 表示,仅通过测试和模拟环境并不够;针对真实用户行为的验证才是“循环工程的基础”。
@kenbwork 提出 (46 个赞、5 条回复、16,533 次浏览) 介绍了 BioSecBench-Refusal,这是一个由 14 位领域专家编写、包含 107 项任务的生物学基准。其结论很具体:在 16 种模型-harness 配置中,合法的常规生物学任务被拒绝的频率,经常与隐蔽风险一样高,甚至更高;回复认为,这种情况出现的原因,是安全防护对表层词汇起反应,而不是根据任务形态或意图判断。
讨论洞察: 讨论串里的细微差别很一致:信任不只是身份,安全也不只是拒绝。人们想要的是对实际运行内容的证明、可追溯的记忆,以及比关键词匹配器更能判断意图的过滤机制。
与前一天对比: 以往文件中已有信任与安全话题,但 7 月 1 日把它们同更具体的产物关联了起来:验证工作流、公开基准数字,以及关于身份究竟能证明什么、不能证明什么的争论。
2. 什么让人沮丧
以提示词为先的智能体,一离开理想路径就会失效
最明显的挫败感是,太多智能体系统仍停留在“看起来像样的输出”,而不是可靠执行。@sairahul1 列出 (341 个赞、14 条回复、33,567 次浏览、474 次收藏) 列举了生产环境中的故障模式,包括幻觉式工具调用、格式错误的 JSON、过时的检索、失控的智能体以及悄无声息的评估回退;回复则指出,一些具体的延迟和缓存错误总在反复出现。@BHolmesDev 表示 (72 个赞、5 条回复、4,944 次浏览、126 次收藏) 指出,静态技能会退化为技术债;@TheMimuAI 认为 (10 个赞、5 条回复、79 次浏览) 则表示,通过单元测试和模拟环境,仍然无法证明已部署产品对真实用户有效。
人们的应对方式是增加反馈循环、更丰富的遥测、更明确的验证,以及更严格的上下文塑形,而不是只依赖更强的模型。由于这些抱怨针对的是反复出现的运行故障,而不是边角打磨,因此这看起来值得按高严重性对待。
信任与安全系统证明了错误的东西
第二个挫败点是,当前的信任与安全控制常常没抓住真正的问题。@BlaqOnyemauche 将其概括为 (259 个赞、113 条回复、623 次浏览) 认为,可验证身份是可信智能体的关键,但有条回复指出,身份只能证明是谁签署了请求,不能证明智能体获得权限后实际做了什么。@kenbwork 报道 (46 个赞、5 条回复、16,533 次浏览) 表示,BioSecBench-Refusal 发现,许多模型-harness 组合对合法常规生物学工作的拒绝频率,与对隐蔽风险的拒绝频率一样高,甚至更高;回复把原因归咎于关键词触发式过滤器,而不是真正的意图识别。
人们的应对方式是要求执行收据、可追溯记忆、更好的基准设计,以及依据任务形态而不是敏感词运行的安全防护。这同样属于高严重性问题,因为它一边阻碍合法工作,一边仍给不良行为留下漏网空间。
智能体一旦通过这些渠道触达用户,就会显得很打扰人
当讨论从演示转向现实世界联络时,语音智能体立刻招来反弹。@XFreeze 推广 (527 个赞、155 条回复、98,674 次浏览、95 次收藏) 介绍了 Grok Voice Agent Builder:一款无代码测试版产品,支持亚秒级延迟和 25+ 种语言。但信号最强的回复之一说:“我们真正需要的是退出机制”,因为服务业从业者本来就要应付大量自动骚扰电话。还有人称这款产品“creepy”,也有人问它是否真能取代 ElevenLabs。
这里的应对方式是怀疑、横向对比工具,以及在采用前明确要求加入同意控制。目前这还是中等严重性,但它确实是一个真实的产品设计机会,因为阻力在回复里几乎是立刻出现的,而不是部署之后才冒出来。
3. 人们希望出现什么
能跨会话持久存在,并且越用越好的记忆
最稳定、最务实的需求,是让智能体不要忘掉刚刚行之有效的方法。@xelebofficial 表示 (4 个赞、3 条回复、335 次浏览) 指出,被忽视的问题是记忆:大多数智能体在任务结束时就会重置,而持久型智能体能跨天携带上下文、从失败中恢复,并处理定时工作。@tom_doerr 指出 (13 个赞、1 条回复、2,567 次浏览) 指向一种能根据观察到的会话改进其他技能的元技能;@figma 展示了 (6 个赞、2,069 次浏览) 则展示了团队如何把反复出现的批评与回顾工作流做成可复用技能。
这不是一种愿景式需求,而是直接需求:人们已经在构建局部答案,但围绕记忆、自我改进和可复用技能的反复表述说明,这个缺口依然存在。机会评级:[+++] 直接。
智能体无需定制搭建即可使用的安全与验证层
另一项实际需求,是让智能体获得可信上下文和验证能力,而不用每个团队都从零重建。@pdiscoveryio 发布 (15 个赞、1 条回复、1,178 次浏览) 介绍了 Security Context:一项基于提交历史和 CVE 构建的免费 MCP/API 服务。它之所以有意义,前提正是团队已经普遍觉得安全上下文难以可靠获取。@TheMimuAI 认为 (10 个赞、5 条回复、79 次浏览) 则表示,真正的信心来自验证已部署后的实际行为,而不是止步于孤立测试。
对于编码智能体来说,这一需求既务实又紧迫,因为目前的替代办法是更多定制工具、更多日志和更多人工审查。局部解决方案已经存在,但需求仍然指向可移植的上下文和可移植的验证。机会评级:[++] 竞争性。
面向语音智能体的同意控制
当天回复里最明确的诉求,就是退出机制和同意控制。在 Grok Voice Agent Builder 讨论串中,有人回复 @XFreeze 表示 (527 个赞、155 条回复、98,674 次浏览、95 次收藏):“我们真正需要的是退出机制”,因为服务型企业已经在承受大量自动骚扰电话。这是一个现实需求,同时也带有情绪上的紧迫感,因为回复里用了“harassment”和“creepy”这样的词。
在当天的数据集中,除了怀疑和与 ElevenLabs 等既有产品的对比外,没有强有力证据表明已经存在一个被广泛采用的答案。机会评级:[++] 直接。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Fable 5 | 编码模型 / 智能体工作流 | (+) | 围绕循环工程、技能和上下文记忆工作流激起了强烈兴趣 | 有回复称,模型特定部分可能老化很快,而循环工程部分会更耐久 |
| Claude Code | 编码智能体客户端 | (+/-) | 反复作为技能、审查和兼容市场的智能体宿主出现 | 多篇帖子暗示,要保持可靠,它仍需要外部技能路由、验证和记忆层 |
| OKX.AI | 智能体市场 | (+/-) | 提供托管、声誉、稳定币结算、TEE 支持的身份和按调用付费服务 | 回复质疑,其可靠性和激励设计是否足以防止低质量智能体钻市场空子 |
| Google ADK for Go 2.0 | 智能体框架 | (+) | 为单智能体和图提供统一执行模型,并包含重试、human-in-the-loop 和遥测 | 当天证据以发布信息为主;除第一方说法外,尚无强有力的用户侧证明 |
| Vercel Eve | 智能体框架 | (+) | 用基于文件系统的结构组织工具、技能、子智能体、通道和定时任务 | 7 月 1 日的表层证据主要来自报道和汇总,而非深入用户反馈 |
| Security Context | MCP / 安全上下文 API | (+) | 无需认证即可从公开仓库为智能体提供 CVE 和安全修复上下文 | 仅限于能公开挖掘的项目;当天没有证据显示其覆盖私有代码 |
| Figma agent skills | 技能层 / 生产力 | (+) | 可复用的批评、回顾、利益相关方模拟和连接器支持工作流 | 需要团队把隐性流程显性化;当天证据主要来自第一方使用 |
| Grok Voice Agent Builder | 语音智能体构建器 | (+/-) | 支持无代码浏览器部署、多语言语音和低延迟定位 | 回复立刻提出了同意、骚扰电话和真实感方面的担忧 |
| TestSprite 风格验证循环 | 验证方法 | (+) | 把评估推进到真实用户行为层面,而不止于模拟成功 | 会增加额外验证工作;它之所以被强调,恰恰因为简单测试并不够 |
整体光谱从对可复用技能和运行框架的强烈热情,一路延伸到对信任、安全和面向用户自动化的明显谨慎。主导性的应对模式不是“换个新模型”,而是“增加更多结构”:更好的上下文塑形、验证循环、安全上下文和技能维护。最清晰的迁移,是从提示工程转向 harness/上下文工程,也从一次性智能体演示转向把记忆、支付、身份和评估视为一等要素的框架与市场。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| OKX.AI | @okx | 智能体市场,智能体可竞标工作、交付成果并在链上结算 | 为智能体提供身份、托管、付款和争议解决,而不是把它们当作平台外聊天机器人 | Onchain OS、TEE 中的 Agentic Wallet、Agent Payments Protocol、X Layer 稳定币结算 | Beta | 网站 · 推文 |
| Proprietor | @circle | 峰会项目,展示由智能体运营的业务如何获得收入、向供应商智能体付款、管理利润率并返回收据 | 让智能体到智能体的商业与记账变得具体可见 | Circle Agent Wallet、Circle CLI、x402 payments | Alpha | 推文 |
| Security Context | @pdiscoveryio | 免费 MCP/API 服务,为智能体提供仓库特定的漏洞上下文 | 让编码智能体不必在缺乏安全历史或 CVE 上下文的情况下工作 | MCP、API、提交历史挖掘、已披露 CVE 数据 | 已发布 | 网站 · 推文 |
| Eve | @InfoQ | 用于在生产环境中构建、部署和运行智能体的开源框架 | 在单一项目结构中组织工具、技能、子智能体、通道和计划 | TypeScript、基于文件系统的项目布局、模型/MCP 灵活性 | 已发布 | 仓库 · 推文 |
| one-skill-to-rule-them-all | @tom_doerr | 根据观察到的工作会话起草并改进其他技能的元技能 | 解决技能漂移和重复的手动技能调优 | GitHub 托管的元技能、会话观察、修正捕捉 | 已发布 | 仓库 · 推文 |
| knock-knock | @ryanyen22 | 共享聊天层,用于把工作委派给队友本地智能体,并保留审计日志 | 让团队能跨机器协作,而不必集中化所有智能体执行 | 聊天通道模型、本地智能体运行时、只追加的审计日志 | Beta | 网站 · 推文 |
最反复出现的构建模式,是面向智能体的商业基础设施。OKX.AI 直接定义了市场轨道,而 Circle 峰会项目则探索了相邻模块,例如按请求付费基础设施、收据和由智能体运营的业务。这种组合表明,构建者正把支付、发现和结算当作核心产品表面,而不是附带集成。
第二种模式是可复用工作流基础设施。Eve、one-skill-to-rule-them-all 和 knock-knock 都试图通过把子智能体、技能、通道或会话学习打包进明确结构,让智能体行为更清晰、更可重复。触发这一趋势的痛点,与数据集其他部分呈现的一样:一旦智能体变成团队工具,临时拼凑的提示和一次性运行就撑不住了。
Security Context 很突出,因为它针对的是一个更窄但很具体的失败模式:编码智能体在不了解自己所触及代码安全历史的情况下行动。这让它成为当天更大趋势的一个有力例子,即把上下文视为基础设施。
6. 新动态与值得关注的内容
BioSecBench-Refusal 暴露出一种具体的安全失效模式
@kenbwork 介绍了 (46 个赞、5 条回复、16,533 次浏览) 介绍了一项基准测试,显示某些模型-harness 组合对合法生物学工作的拒绝频率,与对隐蔽风险的拒绝频率一样高,甚至更高。细节很关键:107 项任务、14 位专家、16 种配置;回复还认为,薄弱环节在于关键词触发式拒绝系统。这使它成为当天最清晰的例子之一:智能体安全正被当成部署问题来评估,而不是模型营销问题。
语音智能体部署正变得越来越容易,而同意问题并未随之消失
@XFreeze 展示了 (527 个赞、155 条回复、98,674 次浏览、95 次收藏) 表示,Grok Voice Agent Builder 已被包装成一款基于浏览器、多语言、亚秒级延迟的语音智能体产品。值得注意的不只是发布说法本身,更在于回复多快就转向了退出机制、骚扰电话疲劳,以及这款产品是否真的优于成熟语音工具。
技能选择本身正在成为研究前沿
@omarsar0 强调 (28 个赞、3 条回复、3,298 次浏览、44 次收藏) 介绍了 SkillComposer 论文。该论文把技能选择视为一个联合排序问题,而不是彼此独立的检索问题。这一点很重要,因为它把周边技能库视为一个优化面,而不是被动的提示上下文;回复也明确质疑,当技能集合变大后,基于嵌入加重排的工作流是否还能扩展。
7. 机会在哪里
**+++] 面向代理的可靠性基础设施** —— 最强烈、且横跨多个板块的信号,是市场需要能让代理在演示之后依然稳定可预测地运行的系统:上下文塑造、技能维护、验证循环、安全上下文以及真实评测。相关证据来自 [@sairahul1、@BHolmesDev、@TheMimuAI 和 @pdiscoveryio。这一方向很强,因为它把同一天出现的挫败点、工具和活跃构建连接在了一起。
**++] 记忆与技能生命周期工具** —— 持久记忆、自我提升的技能,以及可复用的组织级工作流,既出现在讨论中,也体现在已发布的成果里,来源包括 [@xelebofficial 到 @tom_doerr 和 @figma。这一方向强度中等,因为团队显然想要它,但已经开始出现若干局部解决方案。
**++] 带有声誉与凭证的代理商业基础设施** —— OKX.AI 和 Circle 的峰会项目显示出,开发者在托管、稳定币结算、身份以及代理间采购方面投入了真实的热情。之所以说这是中等而非最强机会,是因为这些讨论也暴露了尚未解决的问题:输出质量、激励机制设计,以及声誉系统如何被操纵。相关证据来自 [@okx、@TheMaran 和 @circle。
8. 要点
- 重心已经从提示词转向运行纪律。 当天最有影响力的帖子讨论的是 harness、上下文、缓存、验证和技能维护,而不是模型原始能力。 (来源)
- 可复用技能正在成为真实的产品层。 Warp 风格的自我改进技能、Figma 的团队技能以及 rebelytics 的元技能,都把技能视为需要治理和迭代的资产。 (来源)
- 智能体商业不再只是隐喻。 OKX.AI 和 Circle 的柏林演示项目都描述了智能体从事付费工作时所需的具体支付、身份、托管和收据流程。 (来源)
- 信任仍是瓶颈。 最强的限制信号集中在两点:如何证明智能体实际做了什么,以及如何避免那类脆弱的安全防护——它们一边阻碍正常工作,一边又漏掉伪装风险。 (来源)