Twitter AI Agent - 2026-07-07
1. 人们在讨论什么
1.1 Harness 成为主要优化对象 🡕
当天最大的主题已不再是提示词措辞,而是模型外围的运行时系统:工作流形态、可持久化产物、评估器、停止条件,甚至是能改进未来 harness 的 harness。相比前一周仍以 loop engineering 讲解为主,7 月 7 日的讨论更多聚焦于智能体该记住什么、该如何验证,以及控制逻辑应放在哪里。
@lilianweng 认为(2,689 个赞、54 条回复、181,202 次浏览、3,145 次收藏)表示,harness engineering 是智能体近期实现自我改进的路径,并借所链接文章将 harness 定义为围绕基础模型处理规划、工具调用、上下文、文件存储与评估的系统。文中的具体模式比口号更重要:工作流自动化、把文件系统当作持久记忆,以及子智能体配合后端任务,都体现为可复用的设计原语。回复很快转向失败模式:一位读者提醒,循环效果取决于它所优化的评估;另一位则追问,自动研究循环如何避免不断放大自身错误。
@gregisenberg 将其定义为(350 个赞、47 条回复、16,118 次浏览、204 次收藏)也体现了产品语言上的同一转向:harness 是新的操作系统,幻觉是新的 bug,权限是新的防火墙,而信任是新的瓶颈。这条帖子的意义在于,回复并非只是叫好,而是进一步强化了它的运维解读:一条回复称上下文溢出是新的“静默崩溃”,另一条则说,持久记忆才是真正的持久化层。结果是,讨论少了“智能体无所不能”的炒作,多了对防止智能体无声失效的软件层关注。
@VaibhavSisinty 总结道(10 个赞、2,584 次浏览、16 次收藏)则用更直白的话点出了实践层面:写代码的智能体不应同时负责评判结果;而没有机器可验证“完成”标准的循环,本质上只是一次计费事件。这条讨论补上了许多概览文章缺失的两条约束:无人值守循环需要硬性的支出上限,而人类无法迅速理解的高速输出,很快就会变成理解债务。
讨论洞察: 主要分歧已不再是循环是否有效,而是验证器、停止条件和记忆层是否足够强,能否防止循环自己给自己判卷。
与前一天对比: 在 2026-07-06,loop engineering 仍主要以工作坊、速查表和阅读清单的形式传播。到 7 月 7 日,重心则上移到能够检查、约束并改进模型外围工作流本身的 harness。
1.2 语音智能体工具转向产品化基础设施 🡕
语音智能体的讨论也更具体了。最有分量的帖子不再把语音当作新奇界面,而是聚焦可部署层面:多语言语音目录、无代码构建器、免费电话号码、编码工具内的语音转文本,以及在慢速工具仍在运行时维持通话不中断的运行时模式。
@XFreeze 报道(870 个赞、128 条回复、207,056 次浏览)称,Grok Voice 新增了 21 个旗舰级多语言音色,并已通过 Realtime Voice Agent API、Text-to-Speech API 以及新的 Voice Agent Builder 提供。这条帖子的价值,不只是一次普通发布说明,更在于配图:它展示了 xAI 自家的发布页面如何把这些音色与 API 访问及 builder 界面绑定,而不只是面向消费者的演示。

来自 @teslayoda 展示了(12 个赞、1,350 次浏览)的一张规模更小但信息更具体的图片,则直接展示了 Voice Agent Builder 的 beta 通知:无代码构建器、每个账户一个免费电话号码,以及“不到两分钟即可创建生产级语音智能体”的承诺。这个细节之所以重要,是因为它暴露了上手与分发路径,而这些通常只是高互动量总结帖一笔带过的内容。

@livekit 推出了(11 个赞、4 条回复、597 次浏览、8 次收藏)讨论了语音智能体的异步工具;所链接的 公开指南 则明确写出其要解决的运维问题:长时间工具调用期间的冷场。该指南记录了进度更新、填充语音、取消操作和重复调用处理,因此成为当天最清晰的案例之一,显示语音工作正从“它会不会说话”转向“它能不能像可用的通话流程那样运作”。@AuraVision_Co 描述了(27 个赞、8 条回复、319 次浏览)则介绍了 TONI,把它定位为一个带有诊所自定义护理路径和接诊仪表盘的患者导航语音智能体,使这一主题落在真实垂直场景流程上,而不只是工具发布。
讨论洞察: 最能说明问题的回复,关注的不是模型质量,而是运维缺口。人们要求全双工能力、长任务期间可见的进度,以及真实通话开始后系统仍能遵守诊所或企业护栏的可信度。
与前一天对比: 7 月 6 日已经有面向语音的产品案例,但 7 月 7 日给出的证据更偏基础设施。讨论开始转向 builder、runtime,以及那些让语音智能体看起来还未达到生产可用状态的具体 UX 失败点。
1.3 记忆与规格正围绕可审计性和可移植性重构 🡕
第三个主题是,“记忆”越来越指向可检查的状态,而不是更大的向量库。最有分量的帖子强调的是可重放的检索、分层记忆、可读的知识存储,以及能够在人与智能体之间交接时保留下来的上游产物。
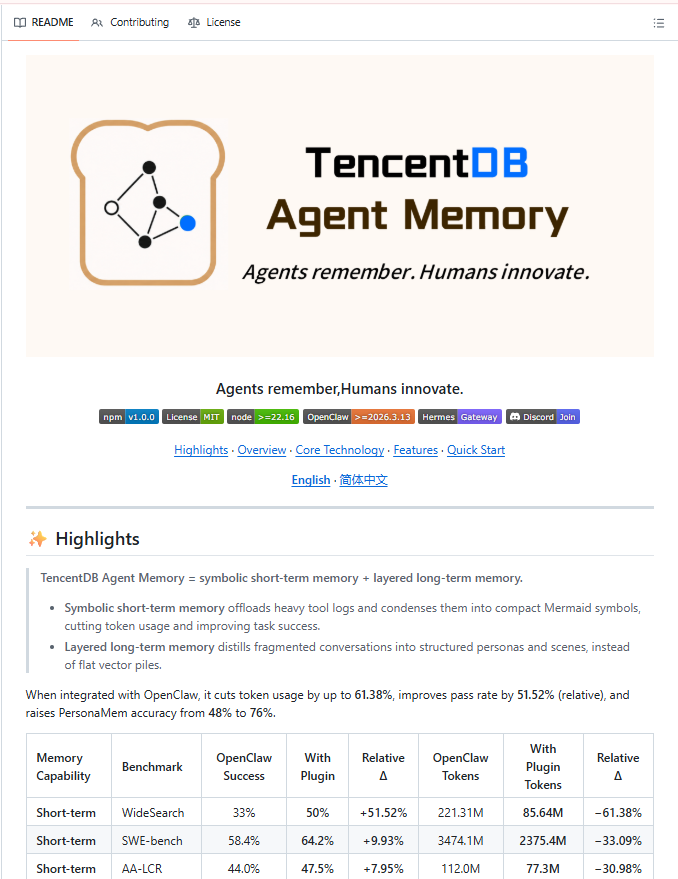
@Shruti_0810 强调了(5 个赞、875 次浏览)介绍了 TencentDB Agent Memory:一个围绕符号化短期记忆与分层长期记忆构建的本地记忆系统。真正让它值得关注的是所链接仓库及附带的 README 图片:其声称提供零外部 API 依赖的本地 TypeScript 实现,最多可降低 61.38% 的 token 使用量,并把 PersonaMem 准确率从 48% 提升到 76%。
@guifav 认为(1 个赞、30 次浏览)提出,长期智能体记忆应从设计上就具备可审计性,并附上一张 MOSS 图示,明确展示其机制:智能体分析意图,由 QueryProfiler 将该意图编译为 SQL,检索核心在中间不经过 LLM,相同查询应返回相同行。图片还补充了大多数“更好记忆”讨论里看不到的生产背景:约 1 年生产运行,覆盖 44M tokens、110,183 个片段、163,494 份文档、569 个概念和 322,662 条标注。

@hwchase17 表示(29 个赞、7 条回复、5,464 次浏览、46 次收藏)称,LLM wiki 是智能体记忆未来的一瞥;回复则进一步说清了其吸引力:人们想要的是能读、能改的记忆,而不只是隐藏的召回层。同样的可移植性逻辑也出现在更上游:@gokulr 提出了(36 个赞、7 条回复、6,088 次浏览、64 次收藏)提出 ProductSpec,作为实现前表达软件意图的开放 Markdown 格式;所链接的 仓库 则把它落实为 parser/CLI、问题/假设/范围/验收标准/成功指标等必填章节,以及用于持续演进规格的 spec_revision handles。
讨论洞察: 当人们说“记忆”时,他们反复要求的是可解释性、修订句柄和可重放的证据,而不是仅仅把更多 token 塞进上下文。
与前一天对比: 在 2026-07-06,本地记忆和技能库已开始受到关注。到 7 月 7 日,更有力的证据进一步走向可审计的 SQL 检索、基准表,以及能在人工与智能体交接中顺畅流转的正式产物。
1.4 编排与智能体市场开始围绕智能体本身增长 🡕
最后一个主要主题,是单个智能体之上的基础设施:监督者—工作者控制平面、托管 MCP 加技能包,以及带有托管、声誉和争议处理机制的市场。共同模式是,构建者投入在协调、签名边界和市场规则上的精力,正在多于只盯着基础模型本身。
@DanKornas 指出(14 个赞、3 条回复、1,715 次浏览、13 次收藏)提到了 CLI Agent Orchestrator(CAO);无论是推文配图还是公开 README,都在强调同一点:这是一个 808 stars 的 Python 项目,能在隔离的 tmux 会话中运行真实编码 CLI,并通过 MCP 的 handoff、assign 和 send-message 原语进行协调。其意义在于:它保留了供应商原生行为,同时仍给监督者提供了清晰的工作者模型。

@hedera 发布了(161 个赞、6 条回复、13,514 次浏览)介绍了一个托管 MCP 服务器和开源技能市场;所链接的 发布文章 对信任边界的说明异常明确:托管服务器可以构建交易,但签名与提交仍保留在用户侧,通过返回字节而非托管私钥来完成。在市场一侧,@vanvster 描述了(18 个赞、10 条回复、554 次浏览、9 次收藏)把 OKX AI 描述为一套劳动力栈,包含任务发现、托管、链上声誉以及基于评估器的争议解决;而 @0X_CUPZ 使用了(20 个赞、18 条回复、184 次浏览)则借一则钱包故障轶事指出,智能体经济需要裁决层,而不只是确定性合约。
讨论洞察: 即便是支持性的回复,也主要围绕失败处理。人们想知道:如果工作者在交接中途失败怎么办;如果市场在其所在地区不可用怎么办;如果智能体交付错误结果却仍声称完成合约怎么办。
与前一天对比: 在 2026-07-06,智能体初创公司仍主要被视为一个开放机会类别。到了 7 月 7 日,更多帖子开始展示这些产品实际围绕的控制平面、签名边界、评估器角色和市场机制。
2. 什么让人沮丧
自我评分的循环与薄弱的停止条件
高严重性。@lilianweng 认为(2,689 个赞、54 条回复、181,202 次浏览、3,145 次收藏)称,自我改进会发生在 harness 上;但这条帖子下最有价值的回复指出,循环效果取决于它所优化的评估,并追问无人值守研究循环如何避免不断累积自身错误。@VaibhavSisinty 重申(10 个赞、2,584 次浏览、16 次收藏)则用更直白的话指出同一痛点:如果写代码的智能体也负责裁判结果,或者“完成”无法被机器验证,那么循环悄悄交付的就是自信,而非正确性。
人们正通过构建者—检查者分离、硬性预算上限和人工审核关卡来应对。这是一个很强的构建信号,因为这种失败模式很常见、代价高,而且即便在信号最强的“loop engineering”讨论里仍不断出现。
记忆依然过于不透明,或过于易失
高严重性。@guifav 抱怨(1 个赞、30 次浏览)指出,基于嵌入相似度的长期智能体记忆,无法很好回答“为什么检索到这个”;并附上一张围绕显式 SQL 和日志化检索构建的 MOSS 图示。@cyrusnewday 提供了(19 个赞、3 条回复、1,118 次浏览、17 次收藏)则给出了编码智能体的另一种应对方式:cap'n hook 会把聚焦后的代码库发现保存到本地,并在底层文件变化时删除这些发现;其仓库声称,在重复提问时可减少 77% 的 token。
同样的挫败感也出现在更轻量的记忆讨论中。@hwchase17 表示(29 个赞、7 条回复、5,464 次浏览、46 次收藏)称,LLM wiki 是未来;其中最尖锐的一条回复说,人类可读、可改的记忆,胜过只会不断累积的记忆。团队目前正靠本地文件、wiki、分层记忆和“先问再取”的召回工具来应对,因此这仍是一个值得按高严重性投入构建的问题。
语音智能体仍会在冷场与轮次衔接上失灵
中等严重性。@livekit 将其定义为(11 个赞、4 条回复、597 次浏览、8 次收藏)围绕一个具体失败点讨论了异步工具:普通工具调用会阻塞对话,而沉默会让来电者以为通话已断。所链接的 指南 将进度更新、填充语音、取消操作和重复调用控制视为核心运行时功能,而非表面打磨。在更大的 Grok 语音讨论串下,用户侧的同样挫败感也很明显;其中一条对 @XFreeze 询问(870 个赞、128 条回复、207,056 次浏览)的回复,就明确要求全双工行为。
构建者目前通过增加播报、取消钩子和更窄的护栏来应对,但这些基础问题仍不断被点名,说明运维层面的问题尚未解决。
公开行动的智能体仍缺乏身份、追索与区域可用性保障
高严重性。@AiswaryaVenkit1 表示(36 个赞、9 条回复、416 次浏览)提到 Microsoft Entra Agent ID 为 AI 智能体带来身份、治理和可见性控制;这一点之所以重要,是因为官方 Microsoft 概览 把智能体身份视为真正的访问治理问题,而不是简单的命名问题。在市场中,@vanvster 描述了(18 个赞、10 条回复、554 次浏览、9 次收藏)介绍了 OKX AI 基于评估器的争议模型,但回复马上追问:现实中争议到底会是什么样。@0X_CUPZ 推动了(20 个赞、18 条回复、184 次浏览)则借 Lobstar Wilde 的钱包故障故事,把这一点进一步推进:仅靠确定性合约,并不足以裁决智能体犯下的错误。
即便是对产品市场的热情,也伴随着摩擦。在对 @defidarling 分享(112 个赞、37 条回复、3,819 次浏览)关于 OKX AI 上架流程的回复中,一位用户表示该产品在其所在地区无法使用。治理需求与可用性摩擦并存,使其成为任何构建会花钱、打电话、交易或公开发布内容的智能体时的高严重性痛点。
3. 人们希望存在什么
可审计、可重放、可编辑、可移植的记忆
这是数据集中最明确的直接需求。@guifav 想要(1 个赞、30 次浏览)希望召回能够重新执行并解释原因;@Shruti_0810 强调了(5 个赞、875 次浏览)展示了具有可量化 token 节省效果的本地分层记忆;@hwchase17 提及了(29 个赞、7 条回复、5,464 次浏览、46 次收藏)把记忆视为可编辑 wiki;@cyrusnewday 展示了(19 个赞、3 条回复、1,118 次浏览、17 次收藏)则展示了会在文件变化时自动失效的代码库专属记忆图。
人们真正想要的似乎不是“更多记忆”,而是无需信任黑盒、可以检查、裁剪、引用,并能跨会话或跨工具携带的记忆。机会评级:[+++] 直接。
像真实通话运营一样工作的语音智能体运行时层
语音相关帖子展示了很多能力,但其下隐藏的需求其实是运维层面的:即时确认、避免冷场、处理中断,以及快速部署到真实电话入口。@teslayoda 展示了(12 个赞、1,350 次浏览)展示了一个带免费电话号码、两分钟内可完成设置的 builder;@XFreeze 描述了(870 个赞、128 条回复、207,056 次浏览)展示了规模更大的多语言语音目录;@livekit 记录了(11 个赞、4 条回复、597 次浏览、8 次收藏)则展示了防止来电者挂机所需的底层机制。
这一需求显得紧迫,因为当前的补救方式仍是定制运行时胶水代码、更窄的护栏,以及针对静默或取消的产品级修补。机会评级:[+++] 直接。
面向智能体行动的身份、托管与争议系统
市场与治理相关帖子都在围绕同一个愿望打转:如果智能体要像劳动者一样行动,它们就需要类似身份、政策、托管与法院的体系。@AiswaryaVenkit1 关联了(36 个赞、9 条回复、416 次浏览)把智能体身份连接到企业控制;@vanvster 详细说明了(18 个赞、10 条回复、554 次浏览、9 次收藏)给出了一套从任务发现到争议解决的完整栈;@0X_CUPZ 认为(20 个赞、18 条回复、184 次浏览)则认为,在智能体运行真实经济体之前,它们先需要一套司法系统。
这不是推测性的需求,而是直接需求,因为产品已经上线,用户也已经开始追问出错时到底怎么办。机会评级:[+++] 直接。
能在多智能体交接中存续的意图产物
另一个明显需求,是在模糊 PRD 与实际运行的智能体循环之间,存在一种中间产物。@gokulr 称其为(36 个赞、7 条回复、6,088 次浏览、64 次收藏)将 ProductSpec 称为“实现前的软件意图开放标准”;而 @DanKornas 指出(14 个赞、3 条回复、1,715 次浏览、13 次收藏)则把 CAO 放在该工作进入多个真实智能体后的编排层。共同需求是:上下文在交接中能够持久保留,而不是每到一个阶段就从头重新解释。
这一方向既现实又具有竞争性:问题显而易见,但围绕它已经开始形成多个标准与控制平面。机会评级:[++] 直接。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Harness engineering / meta-harness | 方法 | (+/-) | 把质量工作转移到工作流设计、文件、评估器、重试和子智能体上 | 仍依赖明确检查、停止条件,以及防止静默失效的保护机制 |
| Grok Voice + Voice Agent Builder | 语音平台 | (+) | 21 种多语言音色、实时 API、无代码 builder、免费电话号码 | 用户仍在要求全双工行为和更多生产级证明 |
| LiveKit async tools | 语音运行时 | (+) | 为慢工具提供进度更新、填充语音、取消操作和重复调用控制 | 开发者仍需自行设计安全的长时任务与中断边界 |
| TencentDB Agent Memory | 记忆层 | (+/-) | 本地符号化短期记忆、分层长期记忆,以及具体 token 与准确率指标 | 证据仍偏早期,且与特定 OpenClaw/Hermes 风格工作流绑定较深 |
| MOSS | 检索型记忆架构 | (+) | 确定性 SQL 召回、显式日志、可重放检索链 | 研究属性较强,采用度远低于主流 RAG 栈 |
| cap'n hook | 编码智能体记忆 | (+) | 声称在重复代码库问题上可减少 77% 的 token,并会自动使过时答案失效 | 主要聚焦代码库召回,社区采用仍处早期 |
| CLI Agent Orchestrator (CAO) | 编排框架 | (+) | 真实 CLI 智能体、tmux 隔离、MCP 协调、跨供应商工作流 | 交接失败与上下文串味问题仍未解决 |
| ProductSpec | 规格 / 意图标准 | (+) | 可移植 Markdown 规格、修订句柄、结构化评估与指标区块 | 仍属早期标准;代码/规格漂移与采用情况仍待解决 |
| Microsoft Entra Agent ID | 身份 / 治理 | (+) | 智能体身份、生命周期、审计、Conditional Access、影子 AI 发现 | 新且偏 Microsoft 生态,真实运行模式仍在形成中 |
| OKX AI | 智能体市场 | (+/-) | 托管、竞价、声誉和评估器支持的争议处理 | beta 可用性与地区限制仍在用户回复中反复出现 |
总体来看,满意度区间介于“这终于有结构了”和“这还需要拿出凭证”之间。人们喜欢本地记忆、带修订能力的规格,以及能保留真实 CLI 行为的编排层,但他们并不信任自我验证循环、静默的语音运行时,或隐藏式记忆层。大家的常见应对方式也很一致:让人类或明确的检查器处于主生成器之外;优先选择本地或可读产物,而不是不透明召回;并让状态与权限可检查。
迁移趋势也很清楚。讨论持续从扁平向量召回转向分层或类 SQL 记忆;从单智能体聊天转向监督者—工作者编排;从泛泛的聊天机器人语音演示转向电话号码加运行时控制;从负担过重的 PRD 转向正式意图章节与修订句柄。竞争压力也在上移:基础模型仍重要,但在这组数据里,差异化更多来自模型周边的编排、记忆、治理与支付轨道,而不是模型本身。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Voice Agent Builder | xAI | 面向可电话访问、使用多语言 Grok 音色的语音智能体的无代码构建器 | 无需定制电话系统即可快速部署生产风格的语音智能体 | Grok Realtime Voice Agent API、Text-to-Speech API、Voice Agent Builder | Beta | 发布推文, Builder 图片推文 |
| TONI | @AuraVision_Co | 带有诊所自定义护理路径和接诊仪表盘的患者导航语音与聊天智能体 | 全科诊所前台与分诊过载 | 语音智能体、网页聊天机器人、管理仪表盘 | Beta | 推文, 网站 |
| CLI Agent Orchestrator (CAO) | @DanKornas / awslabs | 在隔离 tmux 会话中协调真实编码 CLI,并通过 MCP 进行监督者—工作者委派 | 在不放弃供应商原生 CLI 行为的前提下实现多智能体编码编排 | Python、tmux、MCP、Web UI、flows | Beta | 推文, GitHub |
| TencentDB Agent Memory | TencentDB | 具备符号化短期记忆和分层长期记忆的本地长期记忆系统 | 不透明、昂贵且受供应商锁定的智能体记忆 | TypeScript、SQLite、本地记忆层 | Alpha | 推文, GitHub |
| cap'n hook | @cyrusnewday | “先问再取”的代码库记忆图,文件变化时会使过时发现失效 | 编码智能体反复重新发现代码库信息并浪费 token | TypeScript、基于本地文件的记忆 | Alpha | 推文, GitHub |
| ProductSpec | @gokulr | 用于实现前软件意图的开放 Markdown 标准及 parser/CLI | 在人与智能体交接中失效的 PRD 和规格 | TypeScript、Markdown、parser/CLI | Alpha | 推文, GitHub |
| Hosted MCP Server + Hedera Skills | @hedera | 托管 MCP 服务器,配套 Hedera 交易与工作流的开源技能市场 | 为具备区块链能力的智能体提供工具访问与可复用操作手册 | 托管 MCP 服务器、RETURN_BYTES 签名流程、TypeScript skills | Shipped | 推文, 发布文章, GitHub |
| OKX AI | @defidarling / OKX AI | 智能体可竞标任务、在托管下工作、积累声誉,并接受评估器主导的争议处理的市场 | 面向智能体劳动力的发现、支付、信任与追索 | Web marketplace、托管、链上声誉、评估器质押 | Beta | 清单推文, labor-stack 推文, 网站 |
CAO 和 ProductSpec 是同一种构建模式的两面。@gokulr 定义了(36 个赞、7 条回复、6,088 次浏览、64 次收藏)指向实现上游的持久意图产物;@DanKornas 展示了(14 个赞、3 条回复、1,715 次浏览、13 次收藏)则指向其下游的监督者—工作者执行层。两者共同说明,构建者越来越多的精力正转向交接与控制界面,而非仅仅停留在代码生成上。
记忆方向的构建者也在趋同。TencentDB Agent Memory 与 cap'n hook 都默认“让模型自己记住”太贵或太不透明,但它们解决的是不同层级的问题:前者是通用本地记忆系统,后者是代码库专用发现图。讨论中反复出现的构建触发点很明显:人们不想继续为重新发现同样的事实买单。
语音项目则分为横向基础设施与垂直工作流。xAI 的 builder 压缩了部署与分发,而 TONI 则把问题收窄到患者导航,配以受护栏约束的诊所流程和仪表盘接诊。合起来看,这两条帖子把通用 builder 界面与医疗垂直工作流清楚地区分开来。
Hedera 与 OKX AI 则把同样的逻辑延伸到公开行动与支付。Hedera 聚焦签名边界与可复用 skills;OKX AI 聚焦市场、托管、声誉与评估器支持的争议处理。多个构建者都在独立开发智能体外围的层,而不只是智能体本身。
6. 新的、值得关注的动向
托管 MCP 加 skills 以套件形式落地
@hedera 发布了(161 个赞、6 条回复、13,514 次浏览)同时推出了托管 MCP 服务器和开源 skills 市场;所链接的 发布文章 之所以值得关注,是因为它把交易构建与交易签名分离开来。信号在于这种打包方式:不是只给工具,而是工具加可复用操作手册一起给出。
智能体身份成为明确的企业控制平面
@AiswaryaVenkit1 提及了(36 个赞、9 条回复、416 次浏览)介绍了 Microsoft Entra Agent ID;官方 概览 则描述了面向非人类智能体的身份、生命周期管理、Conditional Access、Identity Protection 和可审计性。其值得关注之处在于,它把“智能体治理”从模糊担忧变成了有文档、有产品界面的明确控制层。
记忆类帖子开始拿出具体凭证,而非抽象宣称
@Shruti_0810 分享了(5 个赞、875 次浏览)给出了 TencentDB Agent Memory 的 token 和准确率变化;@guifav 分享了(1 个赞、30 次浏览)则给出了带生产规模日志与确定性检索设计的 MOSS 图示。尽管两者的互动量差异悬殊,但都因提供了可检查的机制与数字,而不是泛泛宣称“记忆更好”,所以格外突出。
“实现前的软件意图”成为一个被命名的产物
@gokulr 提出了(36 个赞、7 条回复、6,088 次浏览、64 次收藏)把 ProductSpec 定义为一种开放的意图标准,位于工程规格、任务、代码与评估之前。其值得关注之处在于,这条讨论把许多智能体构建者数周来一直在暗示、却未正式命名的缺口说清楚了:一种既能被人类读懂、也能被编码智能体读懂,同时又不会把 PRD 压得过重的产物。
7. 机会在哪里
[+++] 可审计的记忆基础设施 — 证据来自对不透明检索的挫败、MOSS 可重放的 SQL 式召回、TencentDB Agent Memory 的本地分层设计,以及 cap'n hook 的变更感知型代码库记忆。最强机会是构建一层可供人类检查、裁剪、重放并跨工具迁移的记忆层。
[+++] 验证优先的智能体运行时 — Lilian Weng 的 harness 文章、Vaibhav Sisinty 的构建者—检查者框架,以及 Greg Isenberg 关于“信任是新的瓶颈”的讨论,都指向同一个缺口:团队需要的是面向检查、凭证、支出上限和机器可验证完成条件的运行时基础设施,而不只是更快的生成。
[+++] 生产级语音智能体运维 — xAI 的语音发布、LiveKit 的 async-tool runtime,以及 TONI 的垂直部署,都表明市场需要能快速确认、处理长任务、遵守护栏并落到真实电话入口的语音智能体。缺失的层是运维可靠性,而不是原始语音合成本身。
[++] 智能体身份、托管与争议处理中间件 — Entra Agent ID、Hedera 的签名边界、OKX AI 的托管与评估器模型,以及 Lobstar Wilde 的争议故事,都表明智能体一旦公开行动,就需要政策与追索机制。这已经是活跃的产品层,但实现仍按生态与场景彼此割裂。
[+] 面向人机交接的可移植意图产物 — ProductSpec 和 CAO 展示了一条从意图到执行的初步路径,但相关讨论也暴露出漂移与重新同步仍是开放问题。这里仍有空间构建工具,让规格、任务、代码与评估随着工作演进保持对齐。
8. 要点总结
- 讨论已从提示词转向模型外围的 harness。 当天最有力的 loop engineering 证据,集中在评估器、记忆、工作流自动化和子智能体,而不只是提示词措辞。(Lilian Weng)
- 语音智能体的进展,正按运行时行为而不只是语音质量来评判。 最具体的语音帖子聚焦于 builder、电话部署、进度更新,以及长时间工具调用中的取消操作。(xAI 语音发布, LiveKit 异步工具)
- 可读、可重放的记忆,正在相对于不透明召回获得更多认可。 TencentDB Agent Memory、MOSS、LLM wiki 和 cap'n hook 都汇聚到同一偏好:记忆应可检查、可修订,而不是藏在向量库里。(TencentDB Agent Memory, MOSS, LLM wiki)
- 构建者正在同时把意图与编排正式化。 ProductSpec 处理的是实现前的产物,CAO 处理的是多个真实智能体参与后的控制平面。(ProductSpec, CAO)
- 治理与追索已不再是边缘议题。 Entra Agent ID、Hedera 的托管 MCP 流程、OKX AI 的托管与评估器模型,以及围绕智能体经济争议的讨论,都把信任边界视为核心基础设施。(Entra Agent ID, Hedera, OKX AI)