Twitter AI Agent - 2026-07-12
1. 大家在讨论什么
1.1 Harness 卫生取代了模糊的提示词建议 🡕
7 月 12 日最密集的一组讨论,把 agent 质量视为一种运行纪律:定义循环、精简技能列表、按通道路由模型,并在生成代码前强制先做规划。共有 8 条高信号内容支撑了这一趋势,其中几条还指出,真正的瓶颈不是生成更多 token,而是决定该加载什么、何时算完成,以及哪些内容需要审查。
@MengTo 表示(122 次点赞、13 条回复、14,807 次浏览、137 次收藏)表示,他现在会给 agent 开放式目标,让 GPT-5.6 Sol 将其拆解为 20 多个具体步骤,然后让每个步骤都在独立线程中运行,这样每项变更都可以单独提交、审查或回滚。这里的独特之处并不是抽象意义上的自主性,而是把隔离当作一种控制机制:用一组专注的“工人”替代一个巨大的上下文窗口。回复中也补充提醒,跨步骤耦合仍然必须被明确监控。
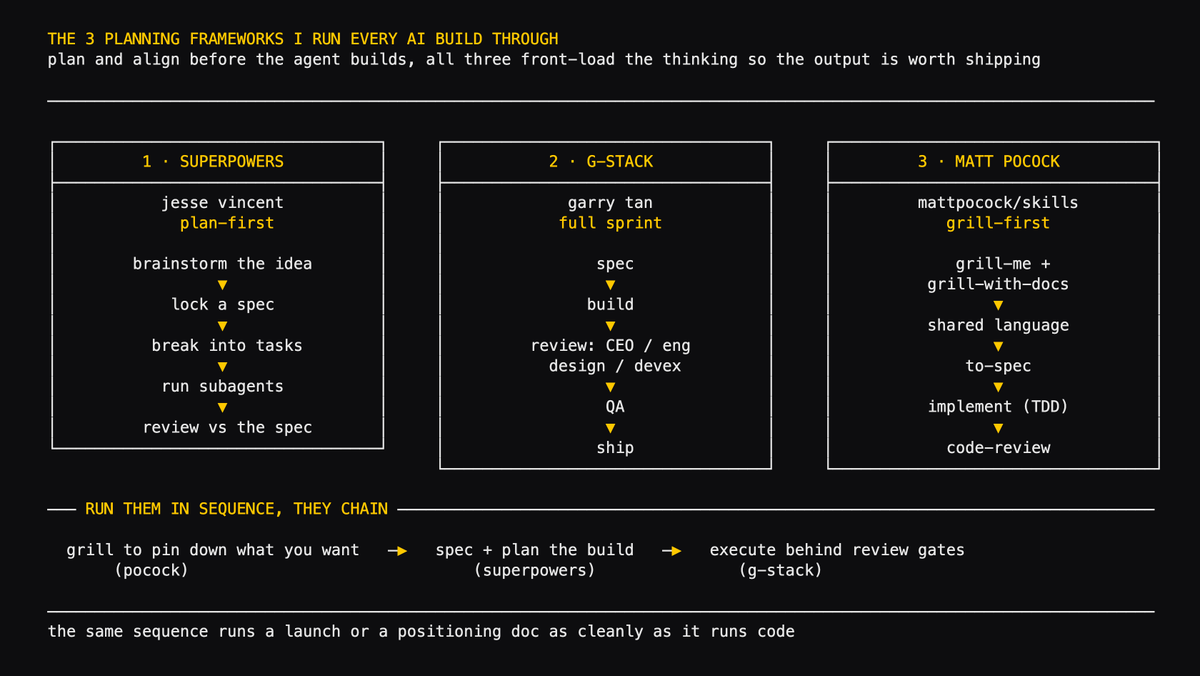
@shannholmberg 展示了(61 次点赞、13 条回复、2,570 次浏览、65 次收藏)总结了三套规划系统——Superpowers、G-Stack,以及 Matt Pocock 的先 grill 再上技能的方法——它们都强制工作流前半段遵循同样的过程:澄清、写规格、拆解、审查,然后交付。这张图之所以重要,是因为它把模糊的“先规划”规范变成了有名称的阶段和审查关卡,可复用于代码与非代码工作。
@kunchenguid 梳理了(67 次点赞、18 条回复、3,409 次浏览、57 次收藏)展示了一张 firstmate 模型组织结构图:由 GPT-5.6 Sol 或 Grok 4.5 运行快速编排循环,Claude Fable 5 负责更深入的产品和技术设计,最后再由更便宜的 GPT-5.6 Sol 审查通道兜底查错。附图之所以有信息量,是因为它把模型选择变成了可操作的流程:Grok 负责实时 X/新闻工作,Codex 或 Sol 负责功能实现,而审查则成了专门通道,而非事后补救。

@Voxyz_ai 认为(35 次点赞、6 条回复、3,305 次浏览、42 次收藏)表示,大型全局技能包如今已成负担,因为冗余技能会迫使 agent 处理相互冲突的指令,并付出额外的上下文成本。他提到了 autoskills,其 README 写明,它会扫描项目文件,只从经过审计的注册表中选择匹配技能,用 SHA-256 哈希校验,并支持在向本地写入任何内容前先 dry run。
@pvncher 警告(61 次点赞、9 条回复、9,698 次浏览、72 次收藏)表示,这种纪律甚至延伸到了技能描述层:如果某项技能对使用 sub-agent 的描述过于宽泛,GPT-5.6 Sol 可能会比预期更频繁地激活它,从而消耗更多用量。回复则从另一个角度强化了同样的结论:较低的推理等级、更少的已加载技能,以及更短的描述,可能与模型选择本身一样重要。
@RoundtableSpace 分享了(89 次点赞、10 条回复、49,996 次浏览、43 次收藏)推广了免费的 学习 Harness Engineering 课程,截图显示其内容围绕 AGENTS.md、初始化、可观测性和交接,包含讲座、项目和资源库。这很重要,因为关于 harness 的讨论已不再只是非正式建议,它正在变成公开课程体系。
讨论洞察: 常见的回复模式,是把策略从记忆中移出,放进可复用工件里。操作者希望模型通道、技能过滤器、审查关卡和规格步骤成为系统行为,而不是每次都得记得手动输入的一句话。
与前一日对比: 7 月 11 日的重点是面向整个 repo 的 agent 操作系统。到了 7 月 12 日,方向未变,但下沉到了运行卫生这一层:技能裁剪、模型通道,以及可复用的规划流程。
1.2 多 agent 工作变得更有边界,也更关注上下文 🡕
大家对多 agent 的热情并未消退,但高信号帖子对“并行在何时有用、哪些部分必须受限”讲得具体得多。构建者反复回到同样的约束:只拆分彼此独立的工作、让每个上下文保持小而清晰,并用关卡或停止条件控制开销和漂移。共有 6 条内容提供了具体证据。
@shivam74689 构建了(40 次点赞、2 条回复、1,284 次浏览、32 次收藏)展示了一个用 LangGraph 构建的并行多 Agent 股票研究系统,包含独立的财务、新闻、社交情绪和 SEC 文件分支。他的论点很明确:当每个分支都彼此独立且总是需要运行时,扇出加扇入模式比把一切都交给 supervisor 更简单也更快。截图之所以重要,是因为它同时展示了编排图和最终合并报告界面。

@petergyang 总结了(35 次点赞、6 条回复、9,015 次浏览、27 次收藏)转述了 Cognition 的 Jared 的观点:强大的 agent 需要发挥空间,但只能在狭窄上下文内。最具体的主张是,正确的拆分方式应按经济性来定:目标是最大化回报,而不是原始 token 消耗,因此每个 sub-agent 都应分配一个有边界的任务和一个小型上下文窗口。
@pvncher 提问(56 次点赞、11 条回复、4,479 次浏览、18 次收藏)征集 GPT-5.6 中使用 sub-agent 的创新方式,而最有价值的回复描述了带有目标锁、验收标准、心跳,以及审查或发布关卡的持久 worker 线程。另一条回复称,搭配 Fable 的 Claude Code 已经会自动拉起 agent 团队,而 Codex 仍需通过刻意设计提示词才能做到。
@nyk_builderz 认为(9 次点赞、1 条回复、706 次浏览、11 次收藏)表示,orchestrator 应当有意保持廉价且“笨”,只有在某个关卡要求升级时才调用昂贵的 sub-agent。这样一来,多 agent 就从展示型功能变成了可计量的系统。
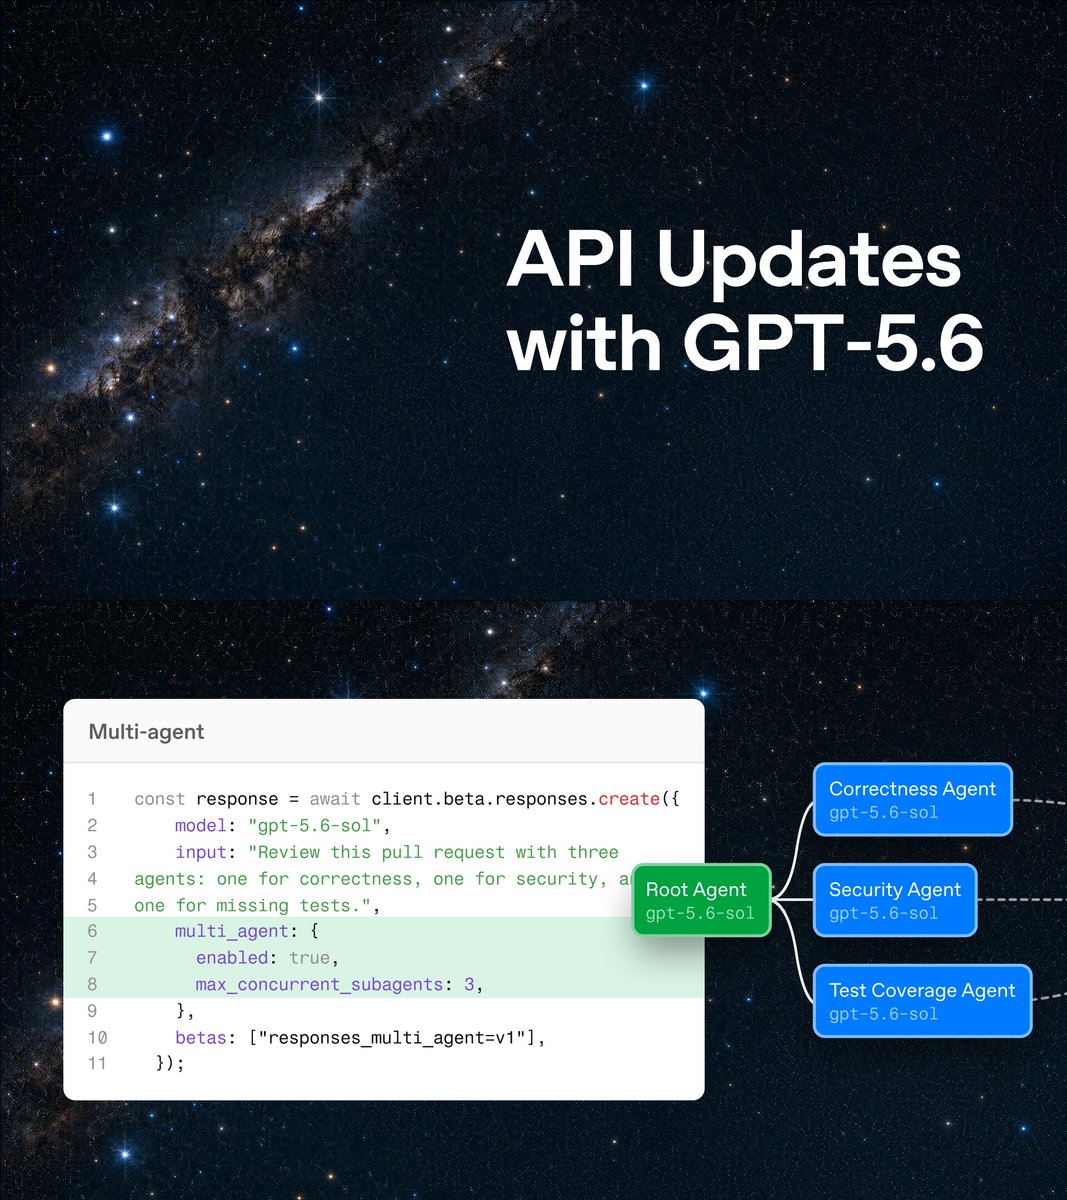
@gabrielchua 提到了(6 次点赞、2 条回复、312 次浏览)提到 OpenAI 新推出的 Responses API 多 Agent 指南,其中写明根 agent 可以并行生成并协调 sub-agent,但建议工作流保持有边界且彼此独立,并将保守的 max_concurrent_subagents 默认值设为 3。图片之所以有信息量,是因为它把“根 agent + sub-agent”的模式展示成了官方产品界面,而不只是社区 hack。
讨论洞察: 最强烈的细微倾向是反极大化。人们想要的多 agent 配置,是知道何时不该分支、何时该停止,以及如何让每个分支都足够便宜,从而能反复运行。
与前一日对比: 7 月 11 日强调图式规划和托管 sub-agent 是一种方向。7 月 12 日则把它落实成了运行指南:扇出与扇入、狭窄上下文,以及明确的并发上限。
1.3 控制层、规格与付费 agent 背板变得更具体 🡕
7 月 12 日最产品化的表现,并不是一个新的通用 agent,而是一组围绕 agent 的控制层:产品意图文件、基于 eval 的完成校验、供应链来源证明,以及付费服务市场。共有 7 条内容支撑这一主题。
@gokulr 宣布(20 次点赞、8 条回复、2,717 次浏览、21 次收藏)介绍了 ProductSpec MCP server。新工具允许 coding agent 读取范围、验收标准、AI eval、成功指标及相关工件,然后在宣称完成之前调用 check_completion_claim。公开的 ProductSpec 仓库 显示,这一标准还附带 validator、GitHub Action、agent skills 和 Decision Trace 支持,从而把产品意图变成了一个可查询的控制文件,而不是人类看过就忘了再打开的文档。
@Saanjana_Nikita 认为(55 次点赞、43 条回复、1,181 次浏览)表示,生产故障通常都很“无聊”:假完成、无限循环、工具重试失效,或上下文过载。附图之所以有信息量,是因为它直接点出了这些故障模式,并把修复手段与 eval 而非 demo 绑定起来。

@Azurite_ai 警告(57 次点赞、48 条回复、396 次浏览)讨论了 HalluSquatting:模型幻觉出一个包名或 repo 名,攻击者先把这个名字抢注下来,agent 就会安装错误的内容。截图之所以有信息量,是因为它展示了确切的危险模式——一个刚创建的仓库在安装时被标记为可疑。

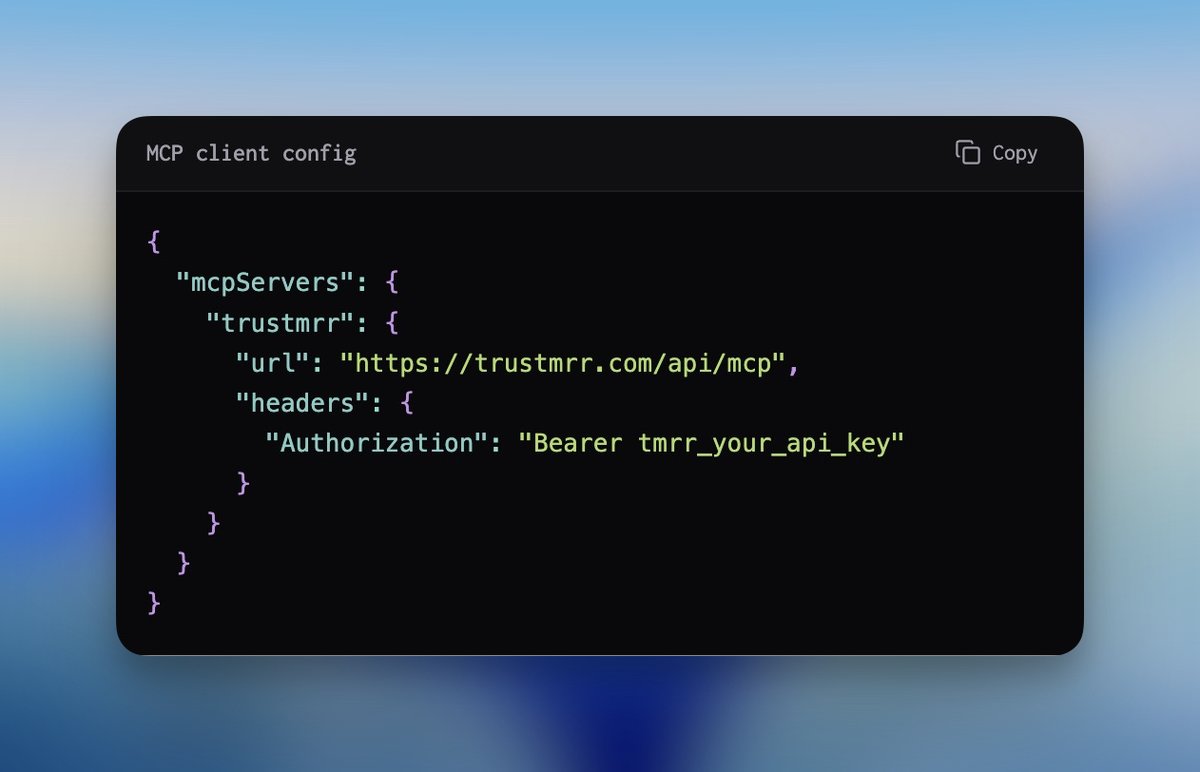
@marclou 补充说(205 次点赞、48 条回复、42,886 次浏览、90 次收藏)介绍了一个用于 TrustMRR 公共 API 的 MCP 包装器,使 agent 能按营收、MRR 和营销渠道查询 startup。TrustMRR API 文档 证实其中包含经过验证的 startup 营收数据,以及按营收、MRR、要价和增长进行筛选的功能,这使其成为结构化商业数据接口,而不是抓取捷径。
@NavenNetwork 介绍了(63 次点赞、14 条回复、3,469 次浏览)介绍了 Naven Marketplace,在这里 agent 可以从 CoinGecko、CoinMarketCap 和 Nansen 等提供方购买付费、可验证的服务。截图之所以重要,是因为它直接展示了按调用计费的列表模式,而 x402 概览 则解释了底层支付层:基于 HTTP 402 的、面向 AI agent 的编程化稳定币支付,无需账户或会话。

讨论洞察: 规格、安全和服务发现都被当作同一种问题来处理:先给 agent 一个更窄、更可信的接触面,再让每一个外部动作都更容易审查。
与前一日对比: 7 月 11 日已经出现了契约和 MCP 轨道。到了 7 月 12 日,它们变得更具体:由规格支撑的完成校验、包来源告警、已验证的营收 API,以及按调用付费的服务市场。
2. 什么让人沮丧
上下文膨胀与失控的用量
严重程度高。@pvncher 警告(61 次点赞、9 条回复、9,698 次浏览、72 次收藏)表示,冗长的技能描述和宽泛的 sub-agent 表述会在 GPT-5.6 Sol 上触发额外用量;而 @Voxyz_ai 描述了(35 次点赞、6 条回复、3,305 次浏览、42 次收藏)则把全局 Codex 和 Claude Code 技能堆视为彼此冲突的规则堆,模型现在不得不从中协调。@RoundtableSpace 展示了(53 次点赞、15 条回复、43,315 次浏览)之所以加入预算护栏工作流,正是因为一个不受约束的 agent 可能在任何人察觉之前就烧掉大量昂贵的视频生成额度。人们当前的应对方式包括:加载更少技能、降低推理等级、在安装前先 dry run,并在高成本操作前强制人工检查点。这值得投入去构建,因为当前的解决方案仍是手工式裁剪,而不是一类一等工具。
Agent 仍然不知道自己何时算完成
严重程度高。@Saanjana_Nikita 认为(55 次点赞、43 条回复、1,181 次浏览)表示,真正的生产故障是:假完成、无限循环、工具重试失效和上下文过载。@gokulr 构建了(20 次点赞、8 条回复、2,717 次浏览、21 次收藏)提到 ProductSpec 的 check_completion_claim 工具,因为 agent 往往看不到原始范围或验收标准;而 @nyk_builderz 表示(9 次点赞、1 条回复、706 次浏览)则指出,反复提示“停下来提问”本质上是一条治理规则,应该被放进关卡里。人们目前通过审查关卡、验收标准和 eval 来应对。这值得投入去构建,因为多条彼此独立的帖子都汇聚到同一个缺失原语:可复用的 verifier。
模型路由仍然依赖手工,且脆弱
严重程度中高。@kunchenguid 发布了(67 次点赞、18 条回复、3,409 次浏览、57 次收藏)画出了一整张组织结构图,只为解释 Fable、GPT-5.6 Sol、Grok 4.5、Codex 和 Opus 4.8 各自该在何时接手工作。@bindureddy 推广了(139 次点赞、14 条回复、350,566 次浏览)讨论了自定义 coding-agent 组合,但最有用的回复指出,真正困难的部分是判断哪些代码足够新颖,值得交给昂贵模型,哪些只是模板化内容,适合便宜模型。@uday_devops 将其定义为(25 次点赞、20 条回复、791 次浏览)则把 Claude Code 和 Cursor 视作完全不同的产品层——一个是系统构建器,一个是 coding assistant——而非可直接替换的产品。人们当前的应对方式是手工制作通道、fallback 规则和工具特定工作流。这值得投入去构建,因为路由逻辑目前大多仍属于部落知识。
包与 repo 的来源证明,成了 agent 特有的安全缺口
严重程度中等。@Azurite_ai 描述了(57 次点赞、48 条回复、396 次浏览)讨论了 HalluSquatting:攻击者先抢注 agent 幻觉出来的包名或 repo 名,然后等待其安装。@pengsonal 补充说(16 次点赞、11 条回复、191 次浏览)则从框架侧给出了同一信任问题的第二个版本:请使用官方 FoundationAgents/OpenManus repo,因为假 repo 和诈骗 token 共用同一个名字。人们当前通过优先使用已审计注册表、固定 manifest 和官方来源来应对。这值得投入去构建,因为 agent 化安装会放大原本可能被人类识别出来的错误。
3. 大家希望存在什么
按项目范围加载技能,而不是全局技能垃圾场
需求说得很明确:只保留那些能提供模型无法自行推断的项目知识,或者团队原本容易忘记的真实命令与检查项。@Voxyz_ai 表示,全局技能堆已经变成上下文成本,而 autoskills 则提供了一个部分答案:技术栈扫描、已审计 bundle、哈希校验,以及 dry-run 安装。这是实际需求,不是情绪化诉求。人们想要更少的指令杂讯和更少的误激活。机会评级:[+++] 直接。
agent 能在编码前查询的产品意图控制文件
@gokulr 直接描述了缺失的文件:要解决什么问题、哪些在范围内、哪些不在范围内、哪些验收标准必须通过、该跑哪些 AI eval,以及上线后什么才算成功。ProductSpec MCP 是一个具体实现,但需求并不局限于单个项目。agent 需要一个持久的控制文件,能够跨越 repo、issue、prompt 和 review 边界存续。这很紧迫,因为它正位于反复出现的“假完成”抱怨之下。机会评级:[+++] 直接。
可复用的停止条件、预算上限与人工检查点
人们一再要求的是更安全的长时间运行,而不是为了自主性本身追求更多自主。@RoundtableSpace 在昂贵的视频生成前插入了人工检查点,@Saanjana_Nikita 表示可靠团队信任 eval 而非 demo,而 @nyk_builderz 则希望关卡只编码一次,而不是每天重打。实际需求是一个可复用的 verifier 层,能够停止长时间运行、计量预算,并在正确时机升级处理。现有工具覆盖了其中一些片段,但整个工作流看起来仍然很手工。机会评级:[++] 直接。
面向 agent 的付费、可验证服务市场
@NavenNetwork 希望 agent 能按调用发现并支付专业服务,而 @marclou 则希望有 MCP 包装的商业数据 API,能直接回答收购类问题。需求很实际:agent 需要可信的外部能力,而且它们应当比逐个账户集成的定制方案更容易购买和审查。机会评级:[++] 直接。
超越提示词技巧的公开 harness 与 loop 课程体系
@RoundtableSpace 和 @RohOnChain 都在放大免费的 harness 与 loop 资源,因为许多构建者仍缺乏关于 loop、verifier 和 review gate 的共享词汇。这一需求一部分是教育性的,一部分是运营性的:团队要的是今天下午就能拿来用的可迁移模式,而不是另一门泛泛而谈的 AI 课程。机会评级:[+] 竞争性。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Claude Code | Coding harness | (+) | 高自主多文件工作、系统指令、长上下文推理 | IDE 原生感较弱;需要前期结构设计和关卡 |
| Cursor | IDE 编码工具 | (+/-) | 快速内联编辑、紧密反馈循环、适合上下文切换的侧边对话 | 更偏响应式而非主动式;不太适合长时间编排 |
| GPT-5.6 Sol | LLM | (+) | 强规划拆解能力、适合后端和审查通道、小线程工作 | 技能或推理档位配置不当时,用量可能激增 |
| Claude Fable 5 | LLM | (+) | 深度产品与技术设计、编排、对抗式审查 | 大批量实现时更慢或更贵;需要预算护栏 |
| Grok 4.5 | LLM | (+/-) | 快速实现通道、实时 X 和新闻访问 | 在混合栈中,限制和架构分歧会成为问题 |
| LangGraph | 编排框架 | (+) | 清晰的扇出与扇入模式,支持共享状态同步 | 需要有意识地在 supervisor 与并行模式间做选择 |
| autoskills | 技能安装器与注册表 | (+) | 技术栈检测、已审计注册表、dry run、哈希校验 | 只有当技能确实携带项目知识或校验价值时才值得 |
| ProductSpec MCP | 规格与控制层 | (+) | 将范围、验收标准、AI eval 和完成检查工具化 | 需要有纪律地维护 Product Spec |
| OpenAI Responses Multi-agent | API 运行时 | (+) | 托管式 sub-agent 生成、共享工具、有边界的并发 | Beta;额外 token 成本;不适合共享可变状态 |
| TrustMRR API plus MCP | 数据背板 | (+) | 已验证的 startup 营收数据和可供 agent 查询的筛选器 | API key 和速率限制;商业数据领域较窄 |
| Naven Marketplace plus x402 | agent 商务层 | (+) | 按调用计价、可验证服务、机器支付 | 生态尚早;信任和验证仍需额外工作 |
| OpenManus | 开源 agent 框架 | (+/-) | BYO-LLM 通用 agent 基座、CLI 与 MCP 模式、强社区信号 | 用户仍需自行承担模型成本,多 agent 流程被标为不稳定 |
总体满意度最高的情况,是工具消除了某种具体成本,而不是承诺泛化自主性。@kunchenguid 和 @bindureddy 都把规划者、执行者和审查者拆分到不同模型上;@pvncher 和 @Voxyz_ai 持续尝试缩小技能接触面;@gokulr 把范围和验收标准移入控制文件;而 @marclou 与 @NavenNetwork 则把外部数据和服务封装成 agent 友好的 API。
因此,迁移压力看起来不再像“选出唯一最好的模型”,而更像“给每条通道一个更窄的任务、更小的上下文,以及更明确的完成证明”。竞争动态也不只存在于模型厂商之间,而是在于哪些脚手架能够路由工作、验证结果并控制成本。
5. 大家在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| ProductSpec MCP server | @gokulr | 通过 MCP 工具让 coding agent 可查询产品意图 | 防止实现偏离和薄弱的完成声明 | Markdown Product Specs、parser and validator、MCP、GitHub Action | Beta | 推文、仓库、编辑器 |
| TrustMRR MCP | @marclou | 为 agent 包装一个经过验证的 startup 数据 API | 让 agent 按营收、MRR 和渠道搜索收购标的,而不是去抓取网页 | Public API、MCP、计划中的 ChatGPT app | Beta | 推文、文档 |
| Naven Marketplace | @NavenNetwork | 面向自主 agent 的付费、可验证服务市场 | 为 agent 提供可按调用结算的按需数据与情报端点 | x402、稳定币支付、服务端点 | Beta | 推文、x402 文档 |
| autoskills | midudev via @Voxyz_ai | 检测项目技术栈并安装经过审计的匹配技能 | 减少全局技能蔓延和随机第三方技能安装 | Node.js CLI、已审计注册表、SHA-256 manifest、skills-lock.json | Shipped | 推文、仓库 |
| OpenManus | FoundationAgents via @pengsonal | 开源通用 agent 框架,支持 BYO 模型后端、CLI 和 MCP 模式 | 为构建者提供一个无需等候名单的通用 agent 基座 | Python、CLI、MCP、可选多 agent 流程 | Beta | 推文、仓库 |
| Parallel Stock Research Agent | @shivam74689 | 扇出与扇入的股票研究工作流,合并财务、新闻、社交和 SEC agent | 展示并行专家何时优于 supervisor | LangGraph、Python、共享状态、Streamlit UI | Alpha | 推文 |
| firstmate agent distro | @kunchenguid | 由 prompt、skills 和 scripts 组成的可复用行为层,可跨多个 harness 使用 | 为团队提供一套可迁移的模型路由与审查配置,而不是在每个工具中重建 | System prompt、内置 skills、bash scripts、多模型通道 | Alpha | 路由图、agent 分发讨论串 |
ProductSpec MCP 与 autoskills 都是在工作流更早阶段引入控制。ProductSpec 在 agent 写代码之前,就把范围、验收标准和 AI eval 放到它面前;而 autoskills 则在运行开始前,就决定哪些技能包被允许加载。
TrustMRR MCP 和 Naven Marketplace 更像背板,而不是面向终端用户的聊天体验。两者反复触发的原因其实相同:agent 需要结构化的外部能力,而且这些能力应比临时浏览器操作或一次性集成更容易查询、定价和建立信任。
OpenManus 和 firstmate 表明,开源势能仍然分散在“完整框架”和“叠加于现有 harness 之上的轻行为层”之间。shivam74689 的股票研究原型则再次强化了当天最大的编排教训:当每个子任务都拥有自己的状态,且合并点明确时,并行分支才真正有帮助。
6. 新内容与值得关注的事
Loop engineering 变成了一个明确的 verifier-first 框架
@RohOnChain 提到了 推出了一门免费的 Loop Engineering 指南,并提出了一个明确主张:如今的瓶颈是 verifier,而不是 generator。这一点值得关注,因为它把零散的社交媒体 meme 变成了一个可审视的框架,涵盖开放与封闭 loop、明确的停止条件,以及 Andrew Ng 的三层 loop 模型。

ProductSpec MCP 把产品意图变成了工具界面
@gokulr 发布了 推出了 ProductSpec MCP,而公开的 仓库 显示,它不只是一个格式公告。它附带 validator、GitHub Action、agent skills、Decision Trace 支持,以及 MCP 工具,让 agent 能直接查询范围、验收标准、AI eval 和完成状态。
HalluSquatting 为“包幻觉”问题提供了清晰的攻击模型
@Azurite_ai 将其命名为 将 HalluSquatting 定义为这样一种利用方式:攻击者先抢占 AI agent 幻觉出的包名或仓库名。这一点值得关注,因为它把模糊的“错误安装”故事重构为一种可重复的供应链模式,安全工具终于可以有针对性地处理。
OpenAI 的 Responses API 让托管式多 agent 在 beta 阶段正式化
@gabrielchua 重点提到 提到了 OpenAI 的 多 Agent Responses API 指南,其中记录了 root-agent 生成、sub-agent 消息传递、等待和并发上限。这很重要,因为产品界面如今已经与许多操作者此前仍靠线程和技能手工搭建的工作流对齐。
7. 机会在哪里
**+++] 产品意图与完成门控层** — [@gokulr、@Saanjana_Nikita、@nyk_builderz,以及 Loop Engineering 指南 都指向同一个缺失层:agent 在宣称完成之前,需要范围、验收标准和 claim-check。这个机会很强,因为同一天里,这一信号同时以“痛点”和“在建项目”的形式出现。
**+++] 上下文预算与技能治理工具** — [@pvncher、@Voxyz_ai 和 @RoundtableSpace 描述的都是同一种成本:无关指令过多,而成本控制不足。这个机会很强,因为节省是立竿见影的,而绕过方法仍然全靠手工。
**++] 混合模型团队的路由与评估器层** — [@kunchenguid、@bindureddy、@petergyang,以及 OpenAI 的 多 Agent 文档 都展示了人工划分的规划者、执行者和审查者通道。这个机会中等,因为需求很明确,但正确的分类逻辑仍然取决于具体工作负载。
**++] Agent 原生付费服务底座** — [@marclou 和 @NavenNetwork 显示出对机器对机器商务和结构化外部数据的需求。这个机会中等,因为信任、定价和采用必须协同发展。
**+] 依赖来源追溯与幻觉安装防御** — [@Azurite_ai 和 @pengsonal 暴露出一个狭窄但真实的安全缺口:agent 化安装器比谨慎的人类更容易被欺骗。这一机会仍在萌芽期,因为利用模式已经很明显,但自动化防御市场还很早期。
8. 要点
- 可靠的 agent 工作持续向栈底下沉。 最强的讨论不再只是关于巧妙提示词,而是规划框架、技能裁剪和模型通道。(来源,来源)
- verifier 成了反复出现的控制界面。 ProductSpec 的
check_completion_claim、loop engineering 指南,以及生产故障讨论串都汇聚到同一点:稀缺能力在于判断什么才算完成。(来源,来源) - 多 agent 配置的使用变得更有选择性,而不是更盲目。 构建者更偏好把扇出与扇入用于独立任务、让廉价 orchestrator 负责关卡控制,并为每个 sub-agent 保持小上下文,而不是无限制分支。(来源,来源)
- 最具体的商业化动能出现在 agent 背板,而不是 agent 人设上。 TrustMRR 和 Naven 都把外部能力封装成结构化、可付费的界面,供 agent 直接调用。(来源,来源)
- agent 侧的供应链信任正在成为一个真实的安全类别。 HalluSquatting 和 OpenManus 的来源告警都表明,agent 化安装器为将恶意依赖混入原本正常的工作流创造了新路径。(来源,来源)