Twitter AI 智能体 - 2026-07-18
1. 人们在讨论什么
1.1 harness 工程成了解释智能体成败的默认答案(🡕)
至少有六条入选内容认为,模型质量已经不再是主要变量。当天最强势的帖子认为,真正拉开差距的,如今在 harness、验证、记忆和控制层。相比 7 月 16 日“同一个模型,不同的系统”的提法,7 月 18 日进一步把 harness 工程推到核心位置,并把它与具体的检查清单、角色边界和运行数据绑定起来。
@0xCodez 表示(141 个赞、16 条回复、15,712 次浏览、215 个书签)称,Anthropic 的内部栈由模型、harness、智能体和上下文构成,还特意强调“RAG 是一种反模式。用 grep”,把注意力从模型升级转向基于文件的记忆和面向任务的 harness。@sairahul1 认为(134 个赞、18 条回复、15,887 次浏览、184 个书签)称,循环工程真正关心的是触发器、独立检查器、持久记忆和可观测性,而不只是更好的提示词。@neil_xbt 写道(82 个赞、31 条回复、4,327 次浏览)称,“智能体并不难,难的是 harness”,随后把 harness 拆成工具、记忆/状态、约束、验证和编排。

@ParamSiddh 列出(71 个赞、5 条回复、2,977 次浏览、89 个书签)列出了 AI 工程师现在需要掌握的具体能力:工具契约、降级模式 UX、检索评估、可观测性、安全工程、多租户隔离和循环预算。@cyrilXBT 补充说(110 个赞、31 条回复、11,874 次浏览、62 个书签)提出了一个由模型、harness、工具和环境组成的四层生产级智能体模型,并附上了少见的具体数字:93% 的权限提示会在未阅读的情况下被批准,复杂任务中只有 16.4% 会触发澄清;Anthropic 团队还用 16 个协同智能体构建了一个可编译 Linux 6.9 的 C 编译器,API 成本约为 $20,000。
讨论洞察: 回复里并没有人要求更花哨的提示词。大家要的是固定的审查智能体、成本更低的否决循环、硬停止条件、幂等操作、降级模式,以及始终明确保留的人类判断。即便是那条一度试探“删掉引导”的讨论,也有人直接回应:一旦没有引导,可靠性就会下降。
与前一天对比: 7 月 16 日把“同一个模型,不同的系统”与资源配置摩擦并列为主要主题。到了 7 月 18 日,这一框架被推到正中央,并被明确的角色、检查清单和生产指标进一步具象化。
1.2 图、记忆和评估从配角变成下一条升级路径(🡕)
至少有七条入选内容把智能体质量视为状态管理和度量问题。这一天的讨论已经不再停留在“用循环”,而是转向明确的图式路由、记忆整理和上下文质量评分。
@sairahul1 认为(26 个赞、6 条回复、5,990 次浏览、42 个书签)在引用 OpenClaw 创始人 Peter Steinberger 后表示,循环正让位于图工程:专业化智能体、分支、记忆、并行工作、条件路由和长时运行状态。@N01ennn 报道(45 个赞、11 条回复、1,201 次浏览、31 个书签)表示,Anthropic 关于记忆系统的演讲重点讨论了 CLAUDE.md、技能、版本控制、哈希、权限、带内记忆上限,以及让智能体在休眠时整理记忆的“做梦”机制。@coreyhainesco 构建了(55 个赞、7 条回复、4,558 次浏览、79 个书签)介绍了一项第二大脑技能:把采集内容编译成相互链接的 wiki,并且只基于此前收集的来源来回答问题。

@omarsar0 强调了(35 个赞、16 条回复、3,406 次浏览、41 个书签)介绍了 ProofAgent Harness 及其背后的论文;该论文从角色清晰度、防护栏覆盖度、指令一致性、工具 schema 质量、依据充分性、注入防护强化和 token 效率等维度评估上下文质量。@nykdotdev 认为(11 个赞、4 条回复、636 次浏览、9 个书签)指出,仅靠日志还不够;要安全运行多个智能体运行时,Mission Control 还需要任务分配、执行、审查、批准、完成回执和验证证据。


讨论洞察: 最有力的回复持续强调,记忆必须可检查,上下文边界必须可审计。一位回复者希望记忆能由用户直接编辑;另一位表示,当前缺失的评估目标,是做出决策那一刻实际可见的文件、工具结果和指令窗口;还有人指出,引用验证应按来源谱系去重,而不是把重复 URL 当作彼此独立的证据。
与前一天对比: 7 月 16 日已经提到 shell 状态漂移和工作记忆冲突。到 7 月 18 日,这进一步升级为图工程、“做梦”式记忆整理、上下文评分量表,以及位于智能体运行时之上的明确控制平面。
1.3 构建者开始围绕模型封装编排、研究和运行时控制(🡕)
最强的一批构建活动并没有宣称模型更聪明,而是把规划角色、引用验证、共享沙箱和运行时控制封装起来,让智能体减少手动复制上下文的需要。至少有八条入选内容支持这一模式。
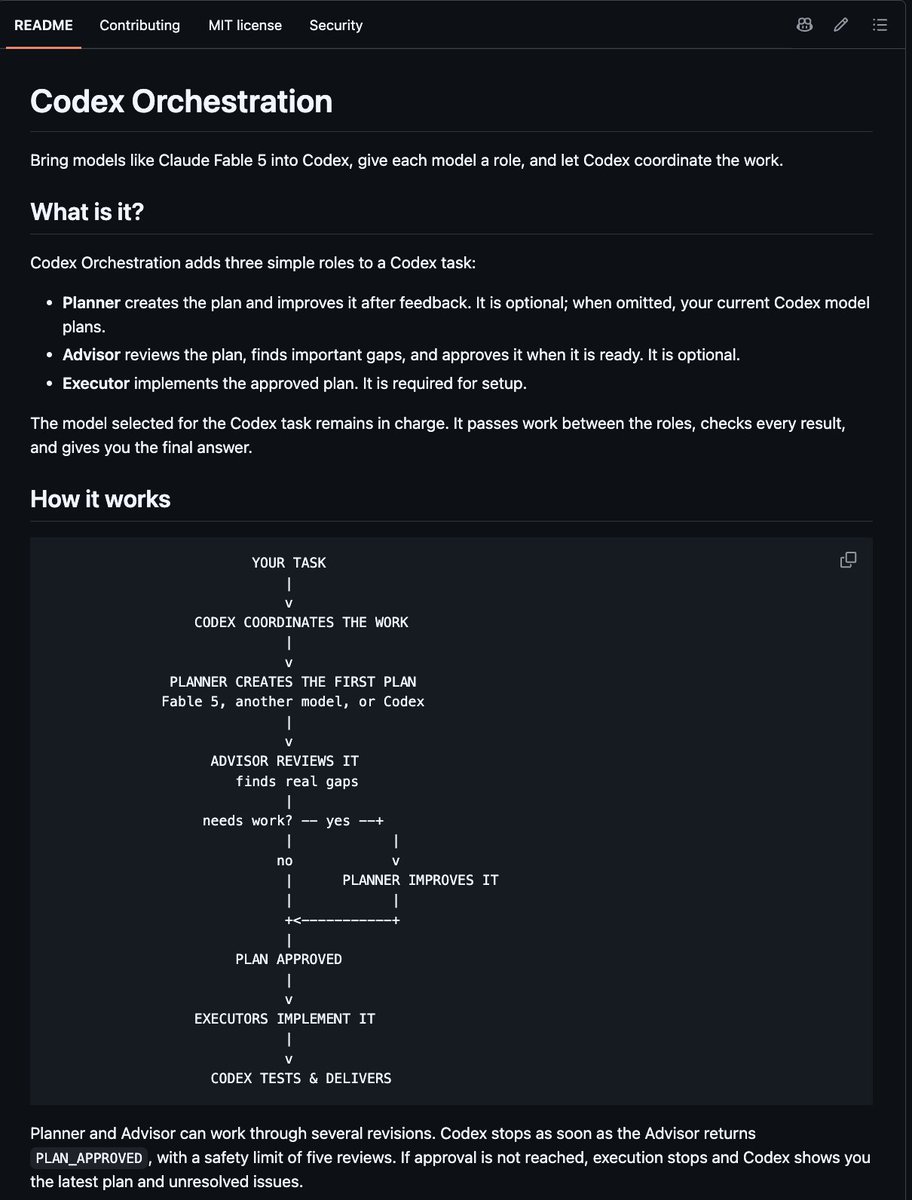
@akshay_pachaar 构建了(62 个赞、18 条回复、7,298 次浏览、83 个书签)介绍了一个开源的 CrewAI 编码 harness:以文件工具充当记忆,配有子智能体、一次性 VM 沙箱、人工审批和检查点。@socialwithaayan 展示了(29 个赞、16 条回复、13,855 次浏览)介绍了 Codex Orchestration:Codex 继续担任根编排器,但把规划、建议和执行交给专门角色,而不是在一个循环里包办所有事情。
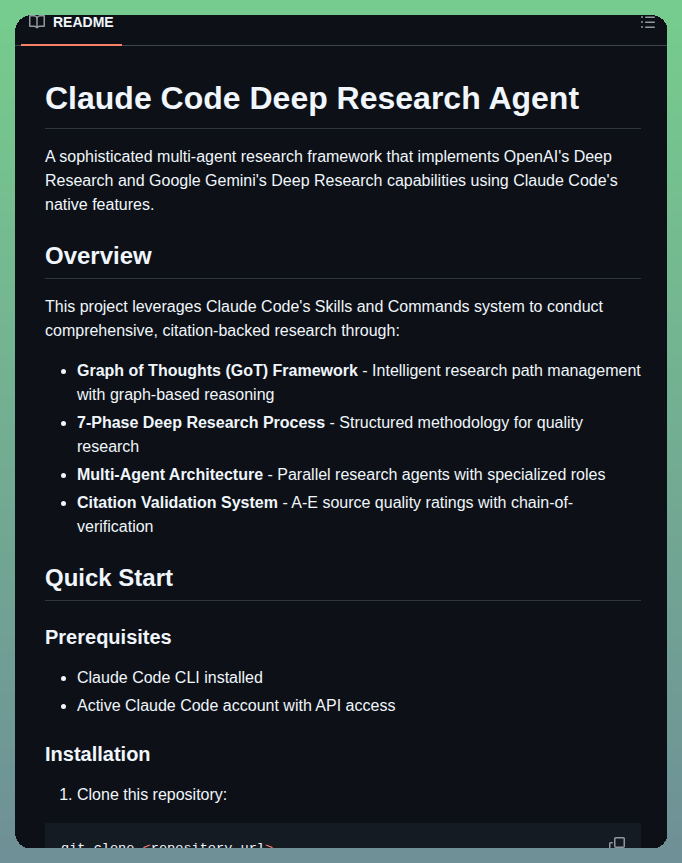
@tom_doerr 指出了(17 个赞、4 条回复、2,926 次浏览、18 个书签)介绍了 Claude Code Deep Research Agent,其 README 特别提到 Graph of Thoughts、七阶段流程、并行研究角色和引用验证。@DanKornas 介绍了(6 个赞、1 条回复、1,061 次浏览、8 个书签)介绍了 Open Deep Research;LangChain 自己的文章称,它把工作拆成 Scope、Research 和 Write 三个阶段,并且只在可并行的研究部分使用多智能体。

@ClaudeDevs 描述了(61 个赞、7 条回复、22,909 次浏览、20 个书签)介绍了 Managed Agents:可在不同模型和提示词之间共享沙箱或金库凭证;与此同时,@GrokInsider 报道(55 个赞、3 条回复、7,100 次浏览)介绍了运行时级控制,例如 require_sha、可配置的 env/cwd 继承、MCP 设置选项,以及 Grok Build CLI v0.2.103 中更安全的本地 Bash 行为。
讨论洞察: 回复更偏好有边界的编排,而不是松散的智能体蜂群。Codex Orchestration 的支持者强调,根编排器必须始终掌控全局;一条关于 Claude Managed Agents 的回复称,真正的价值在于交接前先把人类想法清理干净;还有一条深度研究相关回复认为,来源谱系去重比原始引用数量更重要。
与前一天对比: 7 月 16 日的构建者主要围绕浏览器工作区、部署入口和供给工具展开。到了 7 月 18 日,封装层进一步上移,转向编排插件、深度研究智能体和运行时控制平面。
2. 什么让人感到沮丧
记忆依然失灵,因为智能体记住了太多垃圾,却没有足够结构
人们烦恼的并不是“我们需要更多 token”,而是智能体忘掉了该记住的东西,却保留了不该保留的内容。针对 @sairahul1 的一条回复明确要求,记忆应当能被人检查、更新、删除和补充。@N01ennn 报道(45 个赞、11 条回复、1,201 次浏览、31 个书签)指出,Anthropic 的记忆演讲已经提醒过:带内记忆会碰到天花板,需要版本控制、权限和“做梦”式整理。@coreyhainesco 构建了(55 个赞、7 条回复、4,558 次浏览、79 个书签)之所以提出第二大脑技能,正是因为一堆扁平、可搜索的材料还不够;@chenzeling4 提到了(1 个赞、42 次浏览)介绍了 Context Mode,其仓库主张把工具输出减少 98%,并保留跨运行的会话记忆。


严重程度:高。当前可见的应对方式包括外部记忆层、wiki 式链接、上下文压缩和显式状态同步,而不是指望更大的上下文窗口自然表现得像持久记忆。这一方向值得直接投入,因为相关痛点同时出现在高互动量讨论和互动量较低、但实现细节很具体的帖子里。
仅靠日志,仍不足以证明任务完成、经过审查或结果正确
@nykdotdev 认为(11 个赞、4 条回复、636 次浏览、9 个书签)指出,难点已经不再是让智能体动起来,而是弄清究竟发生了什么:谁负责这项任务、实际执行了什么、哪些内容经过审查、什么环节悄悄失败了,以及声称的输出是否得到验证。@omarsar0 强调了(35 个赞、16 条回复、3,406 次浏览、41 个书签)介绍了上下文评分方法,因为薄弱的上下文之后会表现为幻觉、工具误用或暴露于提示注入;其中一条回复进一步点明,真正的失败往往“在前两步就已经开始了”,因为当时可见的是错误的上下文窗口。即便是基准测试表现亮眼的帖子,也招致了同样的质疑:一条针对 @XFreeze 的回复称,私有基准里 70 项做成 69 项,如果任务列表、污染检查和审计轨迹不公开,仍然只是营销。
严重程度:高。人们正通过增加审查关卡、上下文评分、来源谱系检查和完成回执来应对,但这批内容仍显示,在“智能体运行过”和“结果值得信任”之间,缺了一层关键能力。这一方向值得直接投入,因为它横跨编码、研究和多智能体运营。
安全和执行边界依然很容易出错
@ParamSiddh 列出(71 个赞、5 条回复、2,977 次浏览、89 个书签)把提示注入防御、数据泄露防护、权限边界、工具预算和终止条件列为标准工程问题,而非边缘案例。@AiCamila_ 发布了(2 个赞、46 次浏览)介绍了一套安全蓝图,覆盖输入防护栏、工具与操作安全、行为控制、输出控制,以及监控或审计。@GrokInsider 报道(55 个赞、3 条回复、7,100 次浏览)指出,Grok Build CLI 加入了 require_sha,以阻止远程插件跟随可变分支或标签;在目录删除失败后,它还移除了持久化本地 shell。公开的 Hugging Face 2026 年 7 月事件披露 则把风险具体化了:一个自治智能体系统利用数据集处理的执行路径,借助窃取的凭据实现权限升级;由于安全防护栏阻止对真实攻击产物做取证分析,防御方被迫放弃托管的前沿模型。

严重程度:高。当前可见的应对方式包括插件钉住版本、默认故障关闭、审计日志,以及为事件响应保留开源权重或自托管备用方案。这一方向值得直接投入,因为相关痛点已不再是假设;无论是推文还是外部事件报告,都描述了具体的失效面。
3. 人们希望出现什么
可检查、可裁剪、可同步,并能跨会话存续的记忆
这里的需求既实际又紧迫:人们想要的不只是更大的上下文窗口,而是可检查、可整理、可信赖的记忆。@sairahul1 下的回复明确要求,用户应能更新或删除记忆;@coreyhainesco 展示了(55 个赞、7 条回复、4,558 次浏览、79 个书签)希望得到一个相互链接的第二大脑,而不是一堆扁平笔记;@chenzeling4 提到了(1 个赞、42 次浏览)介绍了 Context Mode,可在保留会话记忆的同时压缩嘈杂的工具输出。@AiCamila_ 将其定义为(9 个赞、135 次浏览)把缺失的实现层归纳为短期记忆、长期记忆、持久状态、记忆管理和同步。今天已经有一些不完整的答案,但信息流仍表明,“有上下文”和“能正确记住”之间依然存在缺口。机会:直接投入。
能把运行变成回执的控制平面
人们要的是运行结束后的证据,而不只是转录记录。@nykdotdev 认为(11 个赞、4 条回复、636 次浏览、9 个书签)指出,智能体运营需要任务分配、执行、审查、批准、完成回执和验证证据;@omarsar0 指出了(35 个赞、16 条回复、3,406 次浏览、41 个书签)则把上下文评分视为判断一次智能体运行能否保持可靠的先行指标。围绕 @XFreeze 的基准讨论,最终也变成了对可审计任务列表、污染检查和单位成功成本的期待,而不是只看排行榜上的单一数字。Mission Control 和 ProofAgent Harness 目前只能部分满足这一需求,但紧迫性依然很高,因为这一痛点横跨编码智能体、研究智能体和多智能体团队。机会:直接投入。
具备清晰角色边界和来源谱系感知研究能力的图式编排
最强烈的编排诉求并不是“更多智能体”,而是更好的智能体拆分。@sairahul1 表示(26 个赞、6 条回复、5,990 次浏览、42 个书签)指出,图正在取代循环,因为真正的系统需要分支、记忆、条件路由和并行工作。@socialwithaayan 展示了(29 个赞、16 条回复、13,855 次浏览)介绍了 Codex Orchestration:根编排器继续掌控全局,同时由不同角色分别负责规划、审查和执行。@tom_doerr 指出了(17 个赞、4 条回复、2,926 次浏览、18 个书签)认为,引用验证是深度研究克隆系统缺失的关键层;@DanKornas 介绍了(6 个赞、1 条回复、1,061 次浏览、8 个书签)介绍了 Open Deep Research,其官方博客提醒不要把写作步骤并行化。这是一个现实需求,而且已经出现直接竞争。机会:直接投入。
面向插件、工具和自治运行时的默认安全执行层
这里的诉求,是让默认设置就把危险路径变得更难走,而不是再多一份安全备忘录。@AiCamila_(2 个赞、46 次浏览)希望每个生产系统都从分层防护栏起步;@GrokInsider 报道(55 个赞、3 条回复、7,100 次浏览)则要求在 require_sha 中加入真正的 CLI 加固步骤;Hugging Face 2026 年 7 月事件披露 表明,当托管安全系统阻止取证分析时,防御方还需要自托管模型选项。这里的需求是实际的,而非情绪性的:更安全的插件解析、更清晰的权限边界、可逆操作,以及面向事件响应的备用方案。机会:直接投入。