Twitter AI 智能体 - 2026-07-27
1. 人们在讨论什么
1.1 上下文工程正在演变为运行时架构(🡕)
当天最反复出现的观点是:如今智能体的质量,取决于上下文如何随时间被组装、裁剪和路由,而不是提示词写得越来越长。至少六条高信号帖子都汇聚到同一转变上:删掉臃肿提示词,只在需要时加载参考资料,把持久行为放进技能和记忆里,并将生成与评估分离。
@harleyfoote_ 指出 (137 个赞,7 条回复,231,629 次浏览)称,据报道,Anthropic 工程师在 Opus 5 / Fable 5 中移除了 Claude Code 超过 80% 的系统提示词,却没有带来可测量的代码评测损失;随后又在回复中进一步解释:提示词只是更大环境中的一部分,这个环境还由 Skills、CLAUDE.md、记忆及其他运行时状态共同构成。@aiedge_ 阐述了 (7 个赞,3 条回复,2,212 次浏览,24 次收藏)则分享了类似的 Claude 5 检查清单:用判断替代僵化规则,设计更干净的工具接口,而不是不断往里塞示例;采用渐进式上下文加载,而不是维护一个臃肿的项目文件。
@alex_verem 写道 (19 个赞,6 条回复,3,515 次浏览,28 次收藏)指出,提示词、上下文、执行框架和循环会分别在不同层级失效;真正的危险在于,循环状态如果持续足够久,就会变成“承重”状态,因此独立的怀疑型评估器比更聪明的生成器更重要。@0xRafy 将其定义为 (22 个赞,9 条回复,2,218 次浏览,26 次收藏)则把图工程视为继提示词、上下文、执行框架和循环之后缺失的第五层,认为图解决的是跨智能体状态与来源追踪问题,而不只是检索。

@AiandTechHub 提到 (46 个赞,11 条回复,615 次浏览)把 IBM 的结构化知识图谱课程视为一个信号:这件事正变得可以系统教授,而不再只是网络热梗。@kv1nsiii 警告 (24 个赞,9 条回复,1,287 次浏览,22 次收藏)指出,周边技能生态仍然相当混乱:6 个传播广泛的“42 Claude skills”链接指向了错误仓库,另外 4 个只把人带到根目录;而被引用的 ToxicSkills 研究,则把讨论从“安装更多技能”推进到“先读 SKILL.md”。
讨论洞察: 回复区对“下一层”叫什么并不太感兴趣,更在意的是怎么把它做轻。删减、延迟加载和独立评估器不断被视为成熟信号,而不安全或低质量的技能包则被当作围绕模型形成的真实供应链问题。
与前一天的比较: 7 月 21 日的重点,是通过导师卡、课程和论文来解释图工程。到了 7 月 27 日,这个概念更接近实际操作:删掉提示词冗余,把行为拆分到工具和技能中,并把图和评估器视为生产级控制面。
1.2 基准测试变得更垂直,也更关注长周期任务(🡕)
第二个讨论簇围绕测量展开。人们分享的不再只是通用排行榜,而是专门考验代码库维护、漏洞复现、罕见病诊断和智能体强化学习基础设施的基准测试,使评估讨论越来越聚焦端到端系统,而不是底层模型本身。
@dexhorthy 分享了 (226 个赞,16 条回复,41,709 次浏览,437 次收藏)分享了第三篇针对 Opus 5 的 SlopCodeBench 文章;最尖锐的回复来自 @rohangupta_,他表示自己的团队已经把“对抗式背压框架”用在同一基准上。这说明,长周期编码评测已经开始改变框架设计,而不只是给模型排个名。@testingcatalog 指出 (47 个赞,2 条回复,5,461 次浏览)分享了 Microsoft 在 CyberGym 上取得的 96% 结果;而 @rohanpaul_ai 深入解析了 (12 个赞,2 条回复,2,604 次浏览)则指出,MDASH 的优势来自围绕 MAI-Cyber-1-Flash 搭建的一层 100+ 智能体编排,包括专门角色、工具、提示词和停止规则。

@danielmckinn0n 介绍了 (3 个赞,1 条回复,630 次浏览)介绍了 RareBench 0.1——一个包含 122 个案例的罕见病基准,用来支撑 Gamow 的“George”诊断智能体。比起帖子里的措辞,附带图表本身更重要:Opus 5 在诊断率上领先,Kimi K3 以明显更低的预估成本取得了出人意料地接近的表现,而错误矩阵则暗示,集成方案可能优于任何单一模型。@xdotli 指出 (15 个赞,1 条回复,1,139 次浏览,7 次收藏)介绍了 Kimi 发布的 AgentENV;AgentENV 项目 和其 发布文章 将其描述为一个基于 Firecracker 的大规模智能体强化学习运行时,支持快照/分叉工作流,并可显著降低环境成本。
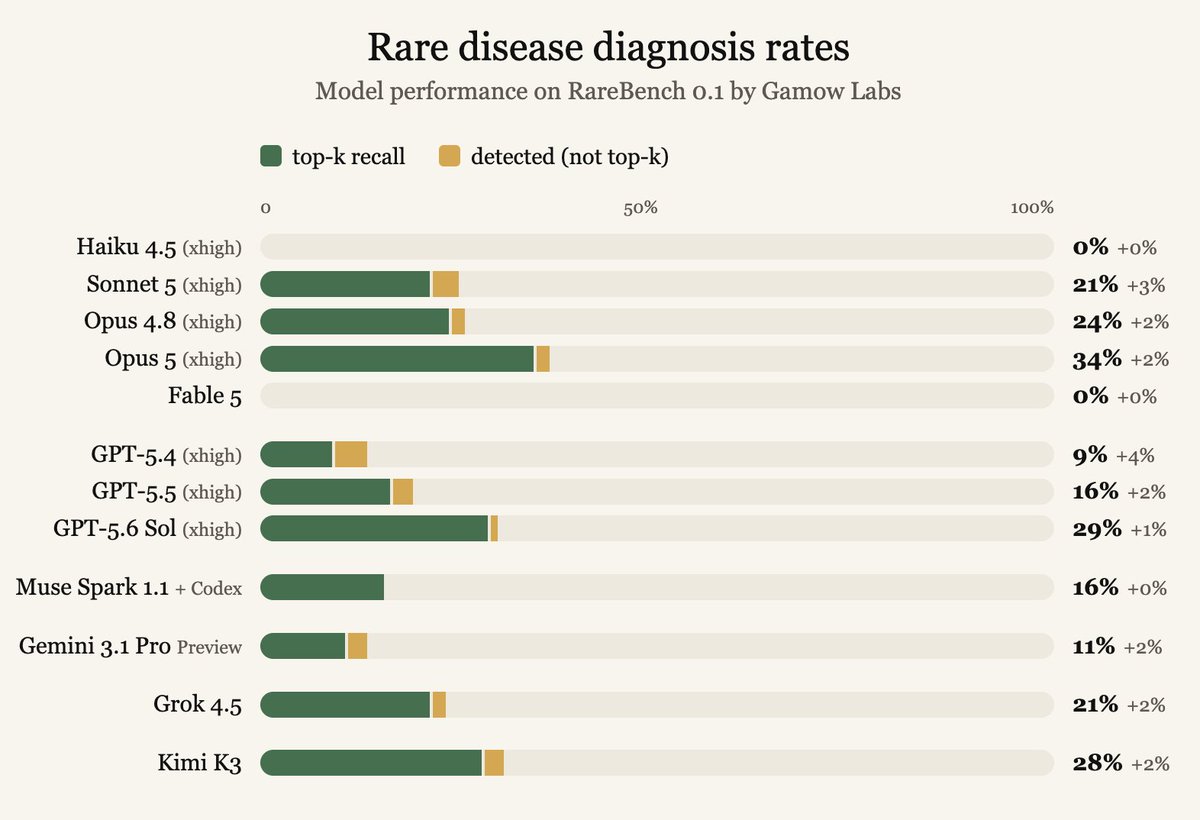
讨论洞察: 有两层细节反复出现。第一,基准胜利被归因于框架设计、专门路由和环境控制的程度,至少不亚于基础模型质量。第二,Kimi/Gamow 相关帖子让信息流开始关注单位结果成本和错误多样性,而不只是表面准确率。
与前一天的比较: 7 月更早些时候的讨论,仍 heavily 偏向围绕循环和图的教学。到了 7 月 27 日,讨论明显更偏实证:同一天内,基准产物横跨编码、网络安全、医疗和强化学习基础设施。
1.3 安全讨论从“要小心”转向授权、证明与联盟(🡕)
当天最强的信任主题是:智能体安全正在围绕权限边界和公开证据被重新定义,而不再停留于泛泛的红队口号。至少五项较有分量的内容都指向同一种设计直觉:是谁提出请求、允许执行什么任务、什么行动具有正当性,以及系统最终能返回什么证明。
@NVIDIAAI 宣布 (752 个赞,52 条回复,35,377 次浏览)介绍了其对 Open Secure AI Alliance 的贡献,核心是把 NOOA 作为开放智能体执行框架研究项目推出,并把智能体安全从单一厂商定位,转成一个拥有 37 个成员的联盟叙事。@fly51fly 链接到 (2 个赞,101 次浏览)介绍了论文《智能体安全需要通过整体框架重新定义》;其附图显示,同样的动作文本,可能是安全的,也可能是恶意的,区别取决于来源授权、任务一致性、行动一致性和数据隔离。@posthog 认为 (24 个赞,2,677 次浏览,31 次收藏)指出,在没有额外控制的情况下信任更聪明的智能体,就像因为车变好了就不系安全带,这与当天更正式的研究语言形成了很好的呼应。

@Acurast 演示了 (60 个赞,29 条回复,10,641 次浏览)介绍了 OKX AI Marketplace 上的机密 TEE 智能体:它能在去中心化智能手机网络的可信执行环境中运行 Shell 或 Python;回复中则强调了签名执行证明和 x402 支付。@yashaswini_s_s 分享了 (9 个赞,3 条回复,407 次浏览)分享了一个为她祖母在 WhatsApp 上订购杂货的智能体;最犀利的回复立刻补上了缺失的控制模型:预先批准的购物篮和硬性价格上限,这样即便语音被克隆或失真,也无法凭空制造新的可支付意图。
讨论洞察: 最实用的安全建议并不是“禁止自主性”,而是收紧权限、证明执行过程,并把“被允许的意图”与“只是看起来合理的文本”区分开来。这既符合论文中的框架,也符合更产品化的 TEE/支付案例。
与前一天的比较: 7 月 21 日聚焦于钱包和软件包安全中的受限自主性。到了 7 月 27 日,话题扩展成联盟发布、明确的情境化安全框架,以及一个让授权问题一眼可见的消费支付案例。
1.4 智能体工作空间开始像完整的操作环境(🡕)
第四个主题是,“使用智能体”越来越意味着围绕它搭建持久化界面:云沙箱、浏览器工作区、终端、语音层、记忆后端和审查循环。最强的帖子,与其说在讨论该选哪个模型,不如说在讨论智能体到底住在哪里、周围配了什么。
@vinvan 写道 (65 个赞,10 条回复,16,880 次浏览,132 次收藏)指出,很多公司还没准备好迎接云智能体,随后又在回复中列出了运维栈:Open-Inspect/Devin/Cursor 负责工作层,Infisical 负责密钥,AgentMail 负责邮箱,Limrun 负责 iOS 模拟。@chakhan22 记录了 (1 个赞,2 条回复,133 次浏览)分享了一套真实的每周配置,由 Claude Code、Codex、Hermes Agent、WezTerm、Herdr 和一个运行后 “No Mistakes” 审查流水线组成;同时也提到,把 GPT-5.6 与 Claude Code 作为框架配对使用时,反复遇到上下文限制问题。@pavlenex 展示了 (228 个赞,9 条回复,9,530 次浏览,372 次收藏)介绍了 Buzz——一个用于视频采集、报告、缺陷分诊和定时工作流的协作编排界面,但回复很快就开始抱怨耗电、token 统计和会话上限。
@witcheer 解释了 (34 个赞,6 条回复,865 次浏览,16 次收藏)介绍了 Hermes Agent 在记忆和技能上的具体控制:定时提醒、回复后复审、可选写入审批、详细通知,以及过期技能整理器。@mhdfaran 强调了 (17 个赞,9 条回复,4,164 次浏览)介绍了 Voicebox,称其是面向兼容 MCP 智能体的本地优先语音层,支持语音克隆、听写和端侧处理;与此同时,@Daniel_Farinax 介绍了 (30 个赞,6 条回复,3,127 次浏览,12 次收藏)介绍了 GrokTerm,将其描述为具备语音和共享控制面的多标签 PTY 主机。@ag2oss 发布了 (9 个赞,2 条回复,364 次浏览,5 次收藏)则介绍了 AG2 v1.0.0,将其定位为面向长时运行、多智能体工作的协议驱动型 AgentOS。

讨论洞察: 共同模式并不是“一个超级智能体”,而是分层界面:一个工具管密钥,另一个管浏览器状态,另一个管语音,另一个管运行后审查,还有一个管记忆和技能。即便最乐观的操作者帖子,也充满了关于上限、成本、审批和状态管理的保留意见。
与前一天的比较: 7 月 21 日是把智能体推进到文档、演示文稿和收件箱等办公载体中。到了 7 月 27 日,覆盖面继续扩大,但重点转向智能体本身周围的控制面:云端准备度、终端宿主、语音 I/O、长生命周期记忆循环,以及明确的审查界面。
2. 人们在为什么事感到沮丧
技能泛滥,却没有来源可追
想把技能真正用起来的人,仍在被失灵的发现机制和脆弱的信任边界绊倒。@kv1nsiii 警告 (24 个赞,9 条回复,1,287 次浏览,22 次收藏)指出,6 个传播很广的“42 Claude skills”链接指向了错误仓库,另外 4 个只落到根目录;被引用的 ToxicSkills 研究还发现,受测技能中相当一部分存在严重缺陷。问题不只是链接失效,而是安装一个技能,往往就意味着让陌生人的代码以智能体权限运行。@vinvan 写道 (65 个赞,10 条回复,16,880 次浏览,132 次收藏)指出,云智能体栈现在需要明确的密钥和沙箱工具;而 Open-Inspect README 则说明,其共享 GitHub App 设计只有在单租户部署里才安全。严重程度:高。人们的应对方式,是先看 SKILL.md 文件、少装一些 bundle,并尽量缩小仓库或密钥的权限范围。之所以值得投入,是因为无论初次使用技能的人,还是高级云智能体操作者,都还在手动做同样的信任决策。
会自我打分的循环,会把坏状态藏起来
可靠性上的核心挫败,仍然是不可见的漂移。@alex_verem 写道 (19 个赞,6 条回复,3,515 次浏览,28 次收藏)指出,糟糕的循环会在多轮交互中把一个错误假设变成“承重”状态,这也是为什么独立怀疑者比更精致的生成器更重要。@fly51fly 链接到 (2 个赞,101 次浏览)介绍了一篇论文,认为同一表面动作可能是无害的,也可能是恶意的,区别取决于来源授权、任务一致性、行动一致性和数据隔离;这意味着只做内容检查,会错过真正的违规。@witcheer 解释了 (34 个赞,6 条回复,865 次浏览,16 次收藏)指出,Hermes 现在需要明确的记忆和技能审批开关,再加上一套整理流程,才能让自我改进保持可理解。严重程度:高。构建者正在用外部评估器、审批关卡和更显性的记忆写入来应对。之所以值得投入,是因为这种故障隐蔽、代价高,而且在编码、安全和记忆系统里反复被重新发现。
云智能体把密钥和执行状态变成了运维问题
转向后台和云端智能体,正在暴露一类新的运维痛点。@vinvan 认为 (65 个赞,10 条回复,16,880 次浏览,132 次收藏)指出,许多公司还没为云智能体做好准备;一条回复提到,智能体永远不会直接拿到 AWS 访问权限,因为密钥放在 moto 后面,数据库状态则通过快照恢复。面向 Cursor 云代理的 Infisical 指南 也明确表达了同样的不满:静态密钥界面解决不了轮换、审计轨迹和快照泄漏问题,所以密钥应该在运行时拉取,而不是预先写死在环境里。严重程度:高。人们的应对方式包括机器身份、运行时密钥注入、受限仓库权限和隔离沙箱。之所以值得投入,是因为痛点恰好出现在采用下一阶段要去的地方:拥有真实基础设施访问权限的长时运行智能体。
真实操作者栈仍然昂贵、耗电,而且受上下文窗口限制
即便最热情的工作流帖子,也都伴随着日常摩擦。在回复 @pavlenex 的 Buzz 演练指南 (228 个赞,9 条回复,9,530 次浏览,372 次收藏)时,就有用户抱怨该应用耗电、隐藏 token 用量,而且很快触及会话上限。@chakhan22 记录了 (1 个赞,2 条回复,133 次浏览)则再次提到,把 GPT-5.6 放在 Claude Code 后面测试时,反复遇到上下文限制问题,即使这套工作流已经精心搭配了 Hermes、WezTerm 和运行后复审。严重程度:中。人们在用类似 Voicebox 这样的本地优先层、类似 GrokTerm 这样的标签式宿主,以及运行后审查循环来缓解,但底层问题并未解决。之所以值得投入,是因为操作者疲劳恰恰出现在那些原本最看好智能体采用的讨论串里。
3. 人们希望出现什么
具备授权感知的控制面
最明确的实际诉求不是“让智能体更聪明”,而是“让它们知道谁有权要求什么”。@fly51fly 链接到 (2 个赞,101 次浏览)介绍了一个框架,认为同样的动作文本可能安全,也可能恶意,区别取决于来源授权、任务一致性、行动一致性和数据隔离。@posthog 认为 (24 个赞,2,677 次浏览,31 次收藏)指出,更聪明的模型并不会消除外部约束的必要性;而在 @yashaswini_s_s 的 WhatsApp 杂货购物代理 (9 个赞,3 条回复,407 次浏览)下,最高赞回复立刻就要求加入预先批准的购物篮和硬性价格上限。@Acurast 展示 (60 个赞,29 条回复,10,641 次浏览)则在执行侧给出了一部分答案:TEE 支撑的证明,但它还没有覆盖完整的用户意图层。这是一个紧迫的现实需求,而现阶段只有局部答案。机会:直接。
面向普通团队的云智能体就绪套件
人们想要的是一套可部署配方,让长时运行的云智能体在密钥、快照、仓库访问和沙箱选择上都有现成方案,而不是逼着每个团队从零发明整套栈。@vinvan 写道 (65 个赞,10 条回复,16,880 次浏览,132 次收藏)指出,许多公司尚未为云智能体做好准备,并在回复中列出所需栈组件:Open-Inspect、密钥工具、邮箱界面和模拟器支持。面向 Cursor 云代理的 Infisical 指南 涵盖了运行时密钥注入,Open-Inspect README 则记录了一种强大但明确只适用于单租户的设计,这意味着需求虽被部分满足,但运维负担依旧很重。这是一个会直接影响预算和安全的现实需求。机会:直接。
能跨会话延续、并改变下一次决策的记忆
信息流一再把记忆描述为让智能体变得有用的关键,但更尖锐的诉求关注的是行动,而不是回忆。@Mnilax 认为 (12 个赞,3 条回复,182 次浏览,12 次收藏)指出,当前记忆基准测试问的是智能体能否回忆自己见过什么,而不是记忆在经历行动和反馈之后,是否会改变下一次决策。@witcheer 展示了 (34 个赞,6 条回复,865 次浏览,16 次收藏)讨论了 Hermes 如今如何围绕记忆写入增加明确审批、通知和整理;而 @chakhan22 使用 (1 个赞,2 条回复,133 次浏览)则把 Hermes 放在更大工作流栈中,作为实用的“第二大脑”。@0xRafy 将其定位为 (22 个赞,9 条回复,2,218 次浏览,26 次收藏)把图工程视为一种答案,但整体需求仍未真正闭合。这是一个已有多个局部竞争者的现实需求。机会:竞争性。
经过整理、可审计的技能路径,而不是病毒式技能堆
人们想要的是更小、更好、更安全的技能包和学习路径。@kv1nsiii 展示了 (24 个赞,9 条回复,1,287 次浏览,22 次收藏)说明了原因:失效仓库、重复列表和未经审查的陌生人代码,会构成极差的上手体验。与此同时,@AiandTechHub 提到 (46 个赞,11 条回复,615 次浏览)把 IBM 的结构化知识图谱专项课程视为人们真正愿意信任的那类课程;@rlaope 封装了 (18 个赞,1 条回复,1,676 次浏览,26 次收藏)则把 Oh My Hermes 定位为一个经过整理的运行层,而不是另一份零散清单。这是一个已有早期产品化答案的现实需求,但还没有明确默认方案。机会:竞争性。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Claude Code + Codex | 编码智能体组合 | (+/-) | 真实操作者工作流中的日常主力组合;围绕技能、记忆和审查循环形成了较强生态 | 上下文限制、成本/配额问题仍在,也仍需要外部验证 |
| Kimi K3 | 开放权重模型 | (+/-) | 强调编码/智能体,在基准图表里展现出有竞争力的单位结果成本 | 基础设施占用重;收益取决于外围运行时和框架是否足够强 |
| MDASH + MAI-Cyber-1-Flash | 网络安全执行框架 | (+) | 在 CyberGym 上拿到 96% 成绩,具备专门路由,成本低于 Microsoft 之前的技术栈 | 领域特化、偏预览式系统,依赖大规模遥测与编排层 |
| Hermes Agent | 智能体 Shell / 记忆层 | (+/-) | “第二大脑”工作流、自动记忆、技能创建和明确审批控制 | 需要整理、审批调优和持续清理,才能保持可理解 |
| Buzz | 协作 / 编排 | (+/-) | 面向报告、缺陷分诊、排期和智能体协作的共享工作区 | 耗电、token 统计薄弱,以及会话上限相关抱怨 |
| Open-Inspect | 后台编码智能体 | (+/-) | 支持 Slack/GitHub/Linear/webhook 触发、定时运行、浏览器自动化和并行沙箱 | 单租户安全模型,以及对共享 GitHub App 的依赖假设 |
| Infisical | 密钥管理 | (+) | 运行时密钥注入、轮换、审计轨迹,并为云智能体缩小爆炸半径 | 增加身份/引导配置开销,也增加一个运维界面 |
| Voicebox | 语音 I/O / MCP 层 | (+) | 本地优先的语音克隆、听写、隐私保护,以及面向 MCP 感知型智能体的一次调用语音能力 | 本地部署和硬件/运行时开销仍由用户承担 |
| AG2 v1.0 | 智能体框架 / AgentOS | (+) | 协议驱动的多智能体网络、事件流、MCP/A2A 和评估钩子 | 并不是经典 AutoGen 式流程的即插即用升级 |
| AgentENV | 沙箱运行时 / 智能体强化学习基础设施 | (+) | Firecracker 隔离、快速快照/分叉,以及大规模智能体执行的经济性 | 基础设施负担重,以 Linux/KVM 为主;缺少额外授权控制时不宜直接暴露 |
| GrokTerm | 终端宿主 | (+) | 多标签 PTY、共享控制面,以及真实 Shell 会话上的双向语音 | 仍属 WIP,以 macOS 为主;Linux 构建据称尚未完全测试 |
表格之外,整体满意度大致落在“很有前景,但需要脚手架”到“只有把缺失的控制层再补上才真正有用”之间。@chakhan22 使用 (1 个赞,2 条回复,133 次浏览)把 Claude Code、Codex、Hermes Agent 和运行后审查流水线组合在一起,因为没有任何单一界面能独自覆盖记忆、执行和验证。@pavlenex 展示了 (228 个赞,9 条回复,9,530 次浏览,372 次收藏)展示了协作编排的上行空间,但回复里依然有人抱怨耗电、会话上限和 token 用量不透明。
最常见的变通办法,几乎全是“划边界”:运行时拉取密钥,而不是存储密钥;采用单租户部署,而不是共享信任;明确审批记忆写入,而不是静默写入;使用独立审查循环,而不是自我打分。@vinvan 将其视为 (65 个赞,10 条回复,16,880 次浏览,132 次收藏)把云智能体就绪度描述为一个横跨沙箱、密钥、邮箱和设备模拟器的栈问题;而 @witcheer 将其转化为 (34 个赞,6 条回复,865 次浏览,16 次收藏)则把 Hermes 的记忆变成一个明确受治理的子系统。
迁移模式正在从单体式提示词转向分层专精。模型选择依然重要,但当天最强的信号表明,持久优势在于上下文组装、路由、可观测性、记忆和证明。因此,竞争格局越来越不像“一个智能体通吃”,而更像栈的分层拆分:Kimi K3 这类前沿模型拼的是成本/性能,MDASH 这类系统拼的是领域框架质量,Hermes 这类 Shell 和 GrokTerm 这类终端宿主拼的是操作者体验,而 AG2 这类框架或 AgentENV 这类运行时,则竞争模型外围的基础设施层。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Buzz | @pavlenex | 用于报告、缺陷分诊、视频采集、触发器和排期的协作式智能体工作区 | 把孤立的一人智能体会话变成共享团队工作流 | 共享频道、触发器、排期、智能体动作;更深层技术栈未公开披露 | Beta | 文章 |
| Acurast Confidential TEE agent | @Acurast | 在去中心化智能手机网络的可信执行环境中执行 Shell 或 Python | 为智能体提供具备签名证明和支付通道的机密计算 | TEE 支撑的智能手机、Shell/Python、x402 payments、IPFS、OKX AI Marketplace | Beta | 文章 |
| Oh My Hermes | @rlaope | 打包记忆、编码编排、wiki 构建和领域化 Hermes 工作流 | 用经过整理的 Hermes 运行层替代插件泛滥 | Hermes Agent、36 个技能、7 个角色智能体、Kanban、交付证据工作流 | Beta | 文章 |
| GrokTerm | @Daniel_Farinax | 在真实多标签终端内运行语音驱动的智能体会话 | 为智能体提供原生 PTY 宿主,而不是伪浏览器终端 | Rust、PTY 宿主、Grok Voice、多标签会话、macOS 应用/CLI | Alpha | 文章, 网站 |
| Voicebox | jamiepine | 本地优先语音工作室,让兼容 MCP 的智能体能说能听 | 在不依赖云端语音栈的情况下加入隐私友好的语音克隆、听写和语音输出 | MCP server、本地/离线处理、7 个 TTS 引擎、23 种语言 | Beta | 代码库 |
| AgentENV | kvcache-ai | 面向大规模智能体强化学习和沙箱执行的 Firecracker 运行时 | 降低大规模训练和评估智能体的环境成本 | Firecracker microVMs、snapshot/fork、快速恢复、Linux/KVM | 已发布 | 代码库, 文章 |
| AG2 v1.0 | ag2ai | 面向长时运行多智能体系统的协议驱动型 AgentOS | 为构建者提供面向生产的框架,具备事件流和评估钩子 | Python package、事件流、多智能体 Network、MCP/A2A、AG-UI、evals | 已发布 | 代码库, 文章 |
| Reelful | @katedeyneka | 移动优先的智能体视频编辑器,可从提示出发完成规划、编辑、验证和渲染 | 把智能体复杂性隐藏在手机原生编辑流程之后 | 移动应用、媒体分析、隔离 VM、自研编辑技能、Remotion、验证器 | 已发布 | 文章 |
| Nextbrowser | @nextbrowser_oss | 托管式浏览器会话,让智能体可复用配置文件、脚本和技能 | 为智能体提供一个持久化的 Web 工作场所 | 托管浏览器配置文件、实时串流、自定义脚本、可复用技能、桌面应用 | Beta | 网站, 文章 |
| George / RareBench | @danielmckinn0n | 对罕见病诊断工作流做基准测试并构建智能体方案 | 试图通过基准驱动的智能体设计改善新生儿低诊断率问题 | RareBench 评估、表型+基因组输入、模型框架、集成/错误分析 | Alpha | 文章 |
最有辨识度的消费者向项目是 Reelful。@katedeyneka 展示了 (12 个赞,1 条回复,251 次浏览)介绍了一条流程:从用户媒体和提示开始,先请求对计划的明确批准,再把工作交给一个沙箱化智能体,由其编写 Remotion composition,并在渲染前通过验证层。Buzz 和 Voicebox 也呈现出同样的模式:把复杂性藏起来,把护栏留下来——产品界面保持简单,而编排或语音基础设施沉到下层。
反复出现最多的构建模式,是“给智能体一个真实的工作场所”。GrokTerm 把终端变成带语音委派的多会话智能体宿主;Nextbrowser 对浏览器配置文件和脚本做了同样的事;Oh My Hermes 则把这一思路用在记忆、技能和操作流程上。这些是彼此独立的项目,但解决的是同一个问题:聊天界面太薄,所以构建者开始围绕模型加上持久化工作空间。
基础设施密集型项目也在向明确边界收敛。AgentENV 优化的是运行时底座,AG2 提供的是长时运行系统的协议与评估层,Acurast 增加的是机密执行加证明,而 George/RareBench 则把基准设计视为通往医疗智能体的路径,而不是附带产物。四者共同之处在于:严肃的构建者在承诺更多自主性之前,先投资于沙箱、评估、证明和可复用控制面。
6. 新动态与值得关注的项目
Open Secure AI Alliance 把智能体安全带入联盟模式
@NVIDIAAI 宣布 (752 个赞,52 条回复,35,377 次浏览)称,其正在向 Open Secure AI Alliance 贡献 NOOA 和其他开放资产。这之所以重要,是因为公开叙事已经从“一家公司的安全姿态”转向“共同的开放防御行动”,并且附带了具体的执行框架研究和共享工具。
AgentENV 让智能体运行时层成为一个产品类别
@xdotli 指出 (15 个赞,1 条回复,1,139 次浏览,7 次收藏)把 AgentENV 作为一个新近发布的独立框架推出,而不是隐藏在内部的组件。配套公开文档描述了 Firecracker 快照、可分叉环境,以及大幅降低的额外开销,这让“运行时经济性”本身成为当天新闻的一部分,而不再只是模型性能的附属话题。
AG2 v1.0 推动开源框架走向 AgentOS 设计
@ag2oss 发布了 (9 个赞,2 条回复,364 次浏览,5 次收藏)介绍了一次从头重写的 AG2,加入了事件流、多智能体联网、MCP/A2A 支持、评估钩子,以及构建其上的权限优先助手。关键不只是版本号升级,而是框架作者如今开始把长时运行编排、可观测性和协议支持打包成一等默认能力。
RareBench 0.1 让医疗智能体评估变得具体
@danielmckinn0n 预览了 (3 个赞,1 条回复,630 次浏览)把 RareBench 0.1 作为一个包含 122 个案例的罕见遗传病诊断基准推出,并直接与 Gamow 未来的“George”智能体绑定。附带图表的信息量异常高:它们比较了诊断率、成本和错误多样性,而该领域的基线问题本身依旧十分严峻。
Acurast 展示了付费智能体的公开执行证明路径
@Acurast 演示了 (60 个赞,29 条回复,10,641 次浏览)介绍了一个 OKX marketplace 智能体:它接收 Shell 或 Python 任务,在 TEE 支撑的智能手机网络中运行,并在 x402 支付后返回签名证明。它之所以突出,是因为执行、支付和证明闭环都在同一个公开产物中被完整描述。
7. 机会在哪里
[+++] Cloud-agent runtime governance — The strongest direct opportunity is the layer that sits between a long-running agent and real infrastructure. @vinvan 描述了 把云智能体就绪度描述为一个横跨工作者基础设施、密钥、邮箱和模拟器的技术栈问题;与此同时,Infisical 云代理指南、Open-Inspect README,以及 @Acurast 的 TEE 演示 都指向同一个缺失的组合包:受限凭证、沙箱策略、执行证明,以及可审查状态。
[+++] 持久化智能体工作空间 —— 多个独立构建者都在尝试给智能体一个耐久的工作场所,而不是再加一个漂浮聊天窗口。GrokTerm、Nextbrowser、Voicebox、Hermes Agent 和 Buzz 分别从终端、浏览器、语音、记忆和团队协作切入,这更像强烈的收敛信号,而不是某种偶发的产品偏好。
[++] Trustworthy skill and memory supply chains — @kv1nsiii 展示了 指出,技能发现已经变成信任和安装质量问题;而 Hermes 与 Oh My Hermes 展示了一种应对方式:审批、整理、角色打包和生命周期管理。这个机会很实在,但也会很卷,因为很多团队都能做出某种“整理过的技能 + 审查”版本。
[++] 领域框架与基准产品 —— SlopCodeBench、MDASH、RareBench 和 George 都在说明,价值正在转向针对单一任务调优的基准与编排,而不是通用模型接入。这在安全和医疗领域尤其强,因为买方有理由为围绕更窄工作流提供的评估、路由、停止规则和审计轨迹付费。
[+] Consumer-safe action agents — @yashaswini_s_s 展示了 展示了一个可信的日常用例:语音订购杂货;Reelful 也为移动视频编辑展示了类似路径。这个信号仍在形成之中,因为产品需求很直观,但控制层——支付上限、审批计划、验证和语音安全——还没有形成标准。
8. 要点
- 智能体质量越来越被理解为运行时架构,而不是提示词技巧。 Harley Foote 对 Claude Code 的总结、Alex Verem 对提示词/上下文/执行框架/循环的拆分,以及 0xRafy 的图工程层,都把持久优势描述为上下文组装、评估和状态管理,而不是更长的提示词。(来源)
- 基准测试正在迅速变得面向领域、面向工作流。 同一天里,既有 SlopCodeBench 讨论,也有 Microsoft 的 95.95% CyberGym MDASH 成绩,以及用于罕见病诊断的 RareBench 0.1;这异常有力地说明,智能体构建者如今优化的是具名工作负载,而不是通用排行榜。(来源)
- 安全讨论已经从模糊的谨慎,转向权限、证明和范围。 情境化安全框架、PostHog 的“安全带”比喻、Acurast 基于证明的 TEE 执行,以及那条关于批准购物篮的杂货智能体回复,都在追问:谁能授权某个行动,系统又如何证明发生了什么。(来源)
- 最活跃的构建者,正在围绕智能体打造工作空间,而不只是打造智能体本身。 GrokTerm、Nextbrowser、Voicebox、Hermes 和 Buzz 分别给模型提供了更持久的环境——终端标签、浏览器配置文件、语音 I/O、托管记忆或团队协作——这说明接口层已经成为主要产品战场。(来源)
- 云智能体的采用,首先会被运维成熟度卡住,而不是被原始模型能力卡住。 当天最强的操作者线程之一,是 Vin Van 的云智能体技术栈清单;它也与 Infisical 和 Open-Inspect 关于密钥、快照和租户隔离的外部指导形成呼应。(来源)