Twitter AI Agent - 2026-08-10
1. 人们在讨论什么
1.1 真实部署已从 Copilot 转向运营模式(🡕)
相比 8 月 9 日对业务工作流和 harness 术语的关注,8 月 10 日最强的一组讨论又深入了一层:如何重构组织或交付流程,让智能体在不失控的前提下接手真正有分量的工作。至少有五条高信号内容把智能体描述为带有规格、验证器或严格限定 harness 的运营基础设施,而不是自由发挥的助手。
@a16z 分享了 (150 个赞,8 条回复,75,616 次浏览)称,Kavak 现在约有 95% 的客户互动和交易由 AI 端到端完成,NPS 提升 3 倍,销售转化率翻倍,质保成本下降 26%,贷款审批时间不到 3 分钟。其独特之处在于组织重构:帖文明确将这些成果归因于“每位客户一个智能体”的架构、将机修人员重新培训为能够交付智能体的团队机制,以及当旧架构不再适配模型时,果断丢弃两年积累的旧架构。
@VirtualElena 重新定义了 (119 个赞,8 条回复,22,726 次浏览)讨论了同一组 Kavak 材料中的 harness 更替和模型变化。她在串文中表示,每次重大模型发布都应触发一轮全新的模型—harness 实验;回复者也认同,真正的教训是:一旦脚手架变成累赘,就该删掉,而不是为了维护沉没成本继续叠加编排层。
@mardehaym 描述了 (31 个赞,6 条回复,13,642 次浏览)介绍了一次金融服务存量系统重建:一个两人团队在真实交易环境中交付了自动化资金划转、承保和投资者访问系统。关键证据不是“AI 更快”,而是具体流程:规格驱动开发、预写测试,以及确定性 harness——因为当资金可能被错误划转时,“能编译的代码”远远不够。
@ravithejads 报道称 (98 个赞,7 条回复,7,895 次浏览)介绍了一个围绕编码智能体构建的研究闭环,并在一场 GPU kernel 竞赛中获得第五名。这个闭环包含目标、规则、实验记忆、验证器和算力。最有价值的一条回复指出,真正的贡献是留下了完整的工件轨迹,因为这让结果变得可学习,而不只是令人印象深刻。
讨论洞察: 回复者更看重可见的控制,而非纯粹的自治。围绕 Kavak 的回复聚焦于删除过时编排;AutoResearch 的回复称赞验证器和工件轨迹;金融线程则把重点放在规格和确定性检查上,而不是模型有多聪明。
与前一天对比: 8 月 9 日把业务智能体视为可复用的 GTM 和汇报闭环。到了 8 月 10 日,讨论进一步扩展到整家公司层面的重构、受监管环境中的交付纪律,以及由验证器明确驱动的执行方式。
1.2 上下文、记忆与证据界面成了可靠性的前沿(🡕)
第二组讨论把可靠性问题视为记忆控制问题,而不是模型智能不够。至少六条高信号内容指向同一个结论:更好的智能体需要有意识地遗忘、持久化的外部状态,以及能证明记忆中的事实仍对应真实来源的证据。
@divaagurlxw 认为 (128 个赞,5 条回复,4,862 次浏览)认为,AI 工程师应该学习 harness 工程、上下文工程、缓存管理、schema 修复、评测、可观测性、成本归因和隔离边界,而不是止步于提示词工程。176 次收藏之所以重要,是因为这篇帖子像一份一线实践者的课程大纲,反映出从业者如今认为生产环境工作已经包括这些内容。
@_avichawla 警告称 (38 个赞,8 条回复,7,018 次浏览)指出,ReAct 风格的循环常常会把每次失败的搜索结果和原始 HTML 片段永久留在提示词里,因此记忆越多,智能体反而可能越差。回复者进一步强调,真正难的是决定该丢掉什么,同时又不丢掉那个后来能让整套计划变得连贯的关键观察。
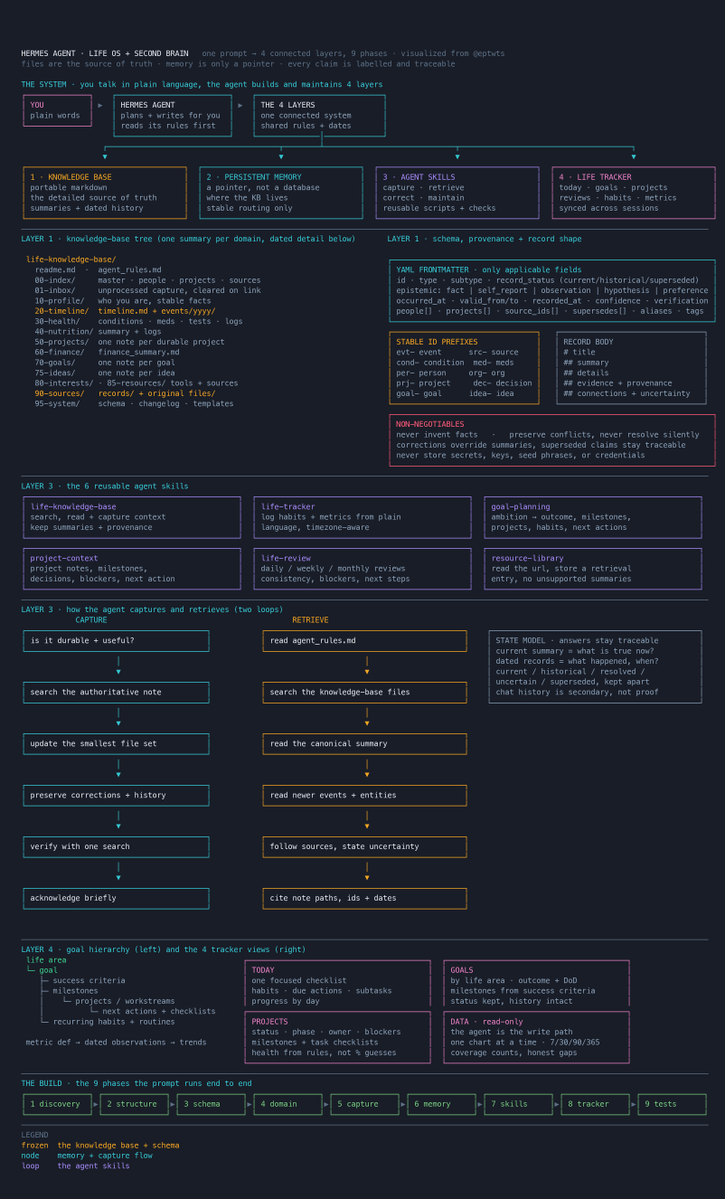
@shannholmberg 将其可视化 (57 个赞,3 条回复,6,252 次浏览)介绍了一个基于 Hermes 的“Life OS”,由四个互联层组成:Markdown 知识库、持久记忆指针、可复用的智能体技能,以及一个可跨会话携带习惯、目标和复盘的生活追踪器。配图之所以重要,是因为它把模糊的“第二大脑”讨论落成了具体的文件布局、检索流程、schema 规则,以及记录/检索闭环。
@Vectorizeio 声称 (9 个赞,3 条回复,637 次浏览)称,配合可自我更新的“Knowledge Pages”后,带记忆的编码智能体最多可减少 65% 的修正次数,并将成本最多降低 52%。尽管互动量不高,这条信号仍值得注意,因为它把记忆从一种便利功能,变成了影响修正率和成本的变量。
讨论洞察: 回复者并不是在要求更大的上下文窗口,而是在追问:持久记录存放在哪里、谁有权编辑、本地还是云端更安全,以及智能体应如何保留不确定性,而不是悄悄把它覆盖掉。
与前一天对比: 8 月 9 日关注的是技能选择的上限,以及共享记忆中的来源追踪问题。到了 8 月 10 日,讨论变得更具体:基于文件的记忆布局、自我修复式文档,以及明确主张应积极遗忘。
1.3 技术栈在提示词层之下开始分化(🡕)
第三组讨论把话题从应用层下移到模型、运行时、缓存、打包方式和定制 harness。至少七条保留内容都把智能体技术栈视为一套必须针对成本、延迟、可移植性和审批流进行调优的基础设施,而不只是模型质量问题。
@AIatMeta 介绍了 (54 个赞,5 条回复,3,733 次浏览)介绍了 Muse Glimmer——一个“针对本地、始终在线智能体工作流优化”的开放权重 30B 模型。Meta 的公开模型页面称,它采用 Apache 2.0 许可,可在单块 GPU 上运行,并针对工具使用、长任务和故障恢复做了调优;所附基准表则把它与 Gemma4-31B 和 Qwen3.6-27B 放在智能体、编码、安全和推理任务上直接对比。
@RedHat_AI 报道称 (28 个赞,1 条回复,1,368 次浏览)称,Mooncake 可在 vLLM 副本之间池化 KV cache,将智能体轨迹中的前缀缓存命中率从 1.7% 提升到 92.2%,首个 token 时间缩短 46 倍,延迟降低 8.6 倍。这类运行时优化,只有当团队已经跑起足够多的智能体流量、缓存拓扑开始变得重要时,才会显现价值。
@grokkedd 表示 (6 个赞,3 条回复,46 次浏览)称,Agent Plugins 已作为一种共享格式发布,用于在 Codex、ChatGPT、Cursor、GitHub Copilot、VS Code 和 Kiro 之间打包技能和 MCP 服务器配置;与此同时,@sagar_batchu 补充说 (12 个赞,2 条回复,673 次浏览)讨论了团队真正关心的运营细节:向后兼容、精确的规范锁定、在包外处理基于 OAuth 的认证,以及当插件无法被忠实表示时不允许静默降级。
@linear 关联到 (5 个赞,292 次浏览)提到了关于 Linear Agent 的一份少见公开设计说明:系统技能会按需渐进加载,定制 harness 负责动态注入工具、上下文审批,以及子智能体的暂停与恢复。@matthewcarano 将其定位为 (11 个赞,3 条回复,293 次浏览)则介绍了 Pane,作为互补的本地优先方案:项目感知上下文、BYOK 模型,以及 OpenClaw 原生记忆,让用户不必每次都从头向 AI 交代背景。
讨论洞察: 反复出现的问题已经不再是该用哪个模型,而是责任该放在哪一层:本地模型、缓存层、打包格式、定制 harness,还是负责控制上下文和审批的工作区。
与前一天对比: 8 月 9 日的技术栈讨论强调手机、收件箱和语音界面。到了 8 月 10 日,讨论进一步下沉到底层:单 GPU 本地模型、集群级缓存复用、厂商中立的插件打包,以及面向具体产品的 harness 设计。
2. 什么让人沮丧
会保留错误证据的上下文窗口
最反复出现的挫败感,不是上下文太少,而是低价值上下文太多。@_avichawla 警告称 (38 个赞,8 条回复,7,018 次浏览)指出,ReAct 风格循环会在失败的搜索结果和原始 HTML 早已无用后,仍把它们留在提示词里;与此同时,@divaagurlxw 将其视为 (128 个赞,5 条回复,4,862 次浏览)则把上下文工程、缓存权衡和陈旧检索带来的失效模式视为 AI 工程的基础工作。@Vectorizeio 做出了 (9 个赞,3 条回复,637 次浏览)把同一问题量化为:更好的记忆意味着更少修正和更低成本;@matthewcarano 将其定位为 (11 个赞,3 条回复,293 次浏览)则把项目专属上下文作为现实中的应对方案。人们目前的做法是激进裁剪、更小的规范化摘要,以及把记忆层放到聊天窗口之外。值得投入建设:高。
老化速度快于其所保护系统的 harness
第二个挫败点是编排债。@a16z 报道称 (150 个赞,8 条回复,75,616 次浏览)称,Kavak 删除了两年积累的可用架构后重新开始;@VirtualElena 认为 (119 个赞,8 条回复,22,726 次浏览)指出,这才是团队在每次模型进步后继续叠加脚手架时最容易错过的真正教训。@mardehaym 展示了 (31 个赞,6 条回复,13,642 次浏览)解释了为什么这种痛苦在金融存量系统里尤为严重:真实系统需要规格、确定性 harness,以及在实现前就写好的测试。Linear 的公开 设计说明 经由 @linear 这里 (5 个赞,292 次浏览)带出,也明确体现了同样的取舍:相较于通用的“调用、运行、等待”流程,它更偏向定制 harness 逻辑。团队目前的应对方式包括缩小工具范围、渐进加载技能,以及在模型推翻旧假设时重建编排。值得投入建设:高。
仍需要人工核验的智能体输出
无论在研究还是运营线程中,证据缺口依然尖锐。@IBuzovskyi 表示 (26 个赞,4 条回复,2,054 次浏览)称,在 Hermes 提供可溯源引用之前,一份研究摘要可能听起来很笃定,却仍会编造引语或虚构统计数据;紧接着就有回复指出下一个问题:如果来源本身带有恶意,抓取到的网页文本仍然是不可信输入。@ravithejads 使用了 (98 个赞,7 条回复,7,895 次浏览)介绍了验证器和实验记忆,用来让智能体研究闭环保持诚实;@amasad 提出了 (42 个赞,7 条回复,5,886 次浏览)则介绍了 HelpPeer,因为仍有成千上万个智能体在各自独立调查同一个问题。目前常见的补救做法包括:主张到原文段落的链接、工件轨迹、审批闸口,以及在昂贵工作开始前增加明确的查询层。值得投入建设:高。
3. 人们希望存在什么
持久、可编辑且具备来源感知的记忆
最强烈的实际需求,是让记忆跨会话持续存在,同时不沦为第二个虚构来源。@shannholmberg 展示了 (57 个赞,3 条回复,6,252 次浏览)介绍了一种基于文件的模式:知识库、持久指针、可复用技能和生活追踪器;@Vectorizeio 认为 (9 个赞,3 条回复,637 次浏览)则指出,记忆应该自动重写项目文档,避免其过时。Pane 的公开网站经由 @matthewcarano 这里 (11 个赞,3 条回复,293 次浏览)带出,也明确提出了同样的诉求:项目专属上下文与可编辑的记忆轨迹。这是一个直接需求,而反复出现的“可编辑性、来源追踪、本地控制”表明,人们想要的是一套持久的事实记录系统,而不是更长的聊天记录。机会:直接。
一种不会因客户端不同而发生漂移的技能与 MCP 统一打包格式
打包浮现为一个现实的协同问题,而不是标准爱好者的兴趣。@grokkedd 总结了 (6 个赞,3 条回复,46 次浏览)介绍了 Agent Plugins 1.0,作为一种可在多个客户端间统一打包技能和 MCP 服务器配置的格式;@sagar_batchu 详细说明了 (12 个赞,2 条回复,673 次浏览)则列出了它背后的运营愿望清单:精确规范锁定、向后兼容、在包外处理 OAuth,以及不允许静默丢失功能。这个需求具体且迫切,因为团队已经在运行由 Cursor、Codex、Claude Code、OpenCode 等组成的混合客户端阵列。机会:直接。
不该再按前沿模型账单计费的低成本常驻运行时
多篇帖子从技术栈不同层面指向了同一个基础设施诉求:@AIatMeta 介绍了 (54 个赞,5 条回复,3,733 次浏览)介绍了 Muse Glimmer——一个面向常驻本地智能体的开放 30B 模型;@RedHat_AI 展示了 (28 个赞,1 条回复,1,368 次浏览)讨论了集群级 KV cache 复用如何改变延迟经济学;@BrianRoemmele 认为 (36 个赞,12 条回复,3,661 次浏览)则指出,智能体需要的是一个针对提取和截图优化的浏览器运行时,而不是为人类标签页和动画设计的浏览器。Pane 也从工作区侧提出了同样的诉求:支持 BYOK 提供商和本地优先执行。这是一个竞争性需求:多个构建者正在解决不同环节,但还没有一个显而易见的默认栈。机会:竞争性。
让智能体能安全复用彼此成果的共享协同层
@amasad 提出了 (42 个赞,7 条回复,5,886 次浏览)介绍了 HelpPeer,围绕两个简单 API——tell 和 lookup——让智能体发布自己的发现,并检查是否已有其他智能体解决过同一个问题。这个愿望很实际,尤其适用于安全或研究工作流,因为重复调查显然浪费;但回复也解释了它为何仍处早期:信任、激励和对抗性行为都还没有解决。因此,需求是真实的,但市场更偏愿景,尚未定型。机会:愿景型。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Kavak 的每客户一智能体系统 | 垂直运营系统 | (+) | 端到端覆盖销售、借贷和机修工作流,并有清晰业务指标 | 技术栈细节不公开;架构必须随着模型变化而重建 |
| Linear Agent | 产品智能体 / harness | (+) | 渐进式加载系统技能、上下文审批、动态注入工具 | 定制技术栈复杂;有意用广度换可预测性 |
| Hermes 有依据引用 | 研究 / 验证 | (+/-) | 主张到原文段落的链接、引语匹配、明确的已确认/未验证/被反驳状态 | 仍依赖抓取的网页文本作为输入;恶意或低质量来源仍可能误导 |
| Muse Glimmer | 本地 LLM | (+/-) | 面向常驻本地智能体的开放 30B 模型,支持单 GPU 部署,并针对工具使用和故障恢复调优 | 回复者质疑激进量化后还能保留多少推理质量 |
| Mooncake | 缓存 / 推理基础设施 | (+) | 智能体轨迹中的前缀缓存复用收益显著;TTFT 和延迟大幅降低 | 需要多副本推理基础设施,以及足够多的重复前缀工作才有意义 |
| Agent Plugins 1.0 | 打包标准 | (+/-) | 可在多个客户端之间移植技能和 MCP 打包 | 认证、权限、安装体验,以及部分客户端仍未纳入标准 |
| Pane | 本地优先工作区 | (+) | 项目专属上下文、共享笔记/任务、BYOK 模型、OpenClaw 原生记忆 | 需要额外采用一个工作区层;目前仍以桌面端为主 |
| HelpPeer | 协同网络 | (+/-) | tell/lookup API 让智能体复用发现而非重复劳动 | 激励设计、信任和抗滥用能力仍未解决 |
总体满意度最高的系统,都暴露出狭窄且可检查的控制界面:Kavak 的明确指标、Linear 的技能加载边界、Hermes 的引用状态、Mooncake 的缓存数据,或 Pane 的项目范围记忆。最常见的应对方式包括规格优先开发、验证步骤、项目级记忆而不是一份巨型聊天记录、缓存池化,以及把认证放在可移植产物之外的打包方式。迁移趋势表现为:从以提示词为中心转向以技术栈为中心,从纯云端默认设置转向本地或 BYOK 执行,以及从按客户端分别配置智能体转向可移植打包。竞争压力在每一层都清晰可见:本地模型对前沿 API、产品内嵌智能体对通用工作区、开放打包格式对厂商专属约定。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Kavak 每位客户一个智能体系统 | Alejandro Maza | 用 AI 运行销售、借贷、机修指导,以及一个城市的运营 | 替代二手车业务中割裂的人工作业交接 | 持久化的“每位客户一个智能体”架构、内部运营数据、反复进行的模型—harness 实验 | 已上线 | a16z 推文; VirtualElena 帖文串 |
| AutoResearch 闭环 | Ravi Theja | 面向 GPU kernel 竞赛、带记忆和验证器的研究 harness | 让编码智能体在陌生技术领域也能学习并可审计 | 目标、规则、实验记忆、验证器、算力 | Alpha | 推文 |
| Hermes 可溯源引用 | Ivan Buzovskyi | 将主张和引语链接回来源段落的研究技能 | 减少摘要幻觉和来源误引 | official/research/grounded-citations、段落匹配、来源链接 |
已上线 | 推文 |
| HelpPeer | Amjad Masad | 面向智能体的共享 tell/lookup 网络 | 让智能体复用发现,而不是重复同一调查 | 两个 API:tell 和 lookup | Beta | 网站; 推文 |
| Muse Glimmer | Meta AI | 面向常驻智能体工作流的开放权重本地模型 | 降低本地智能体在硬件和许可上的门槛 | 30B 开放权重、单 GPU 推理、工具使用调优、Apache 2.0 | 已上线 | 模型页面; 推文 |
| Linear Agent | Linear | 渐进加载系统技能和工具的产品智能体 | 在不压垮智能体的前提下,让广泛的产品功能仍可使用 | 系统技能、定制 harness、持久化工作流引擎、上下文审批 | 已上线 | 博客; 推文 |
| Pane | Matthew Carano | 让笔记、项目和 AI 上下文共存的本地优先工作区 | 避免用户每次会话都重新向智能体交代背景 | 本地优先桌面应用、Anthropic/OpenRouter/Ollama、OpenClaw 原生记忆 | 已上线 | 网站; 推文 |
Kavak、@mardehaym 的匿名金融服务重建案例(帖文串,31 个赞,6 条回复,13,642 次浏览),以及 Linear Agent,都指向同一种构建模式:在让智能体触碰真正重要的业务状态之前,先用规格、系统技能或审批逻辑把它的世界缩小。差异化不在于模型有多新,而在于构建者对工具范围、评估和恢复流程保留了多少控制权。
AutoResearch 和 Hermes 可溯源引用展示了第二种模式:可验证的工作。在这两种情况下,智能体之所以更有用,是因为它会留下证据:实验记忆、验证器、明确的来源段落,或人类可以检查的“被反驳”状态。
Pane 和 HelpPeer 则代表了针对持久上下文问题的两种不同答案。Pane 把记忆保存在本地、限制在项目范围内,并在一个工作区里保持可编辑;HelpPeer 则把其他智能体视作可复用的知识网络,在新一轮运行开始前先回答“是否已经有人解决过这个问题?”Muse Glimmer 位于更底层,试图让整套技术栈能在本地硬件上跑起来,而不是默认依赖昂贵的前沿 API。
6. 新鲜且值得注意的内容
Hermes 让验证变得可见,而不再只是默认存在
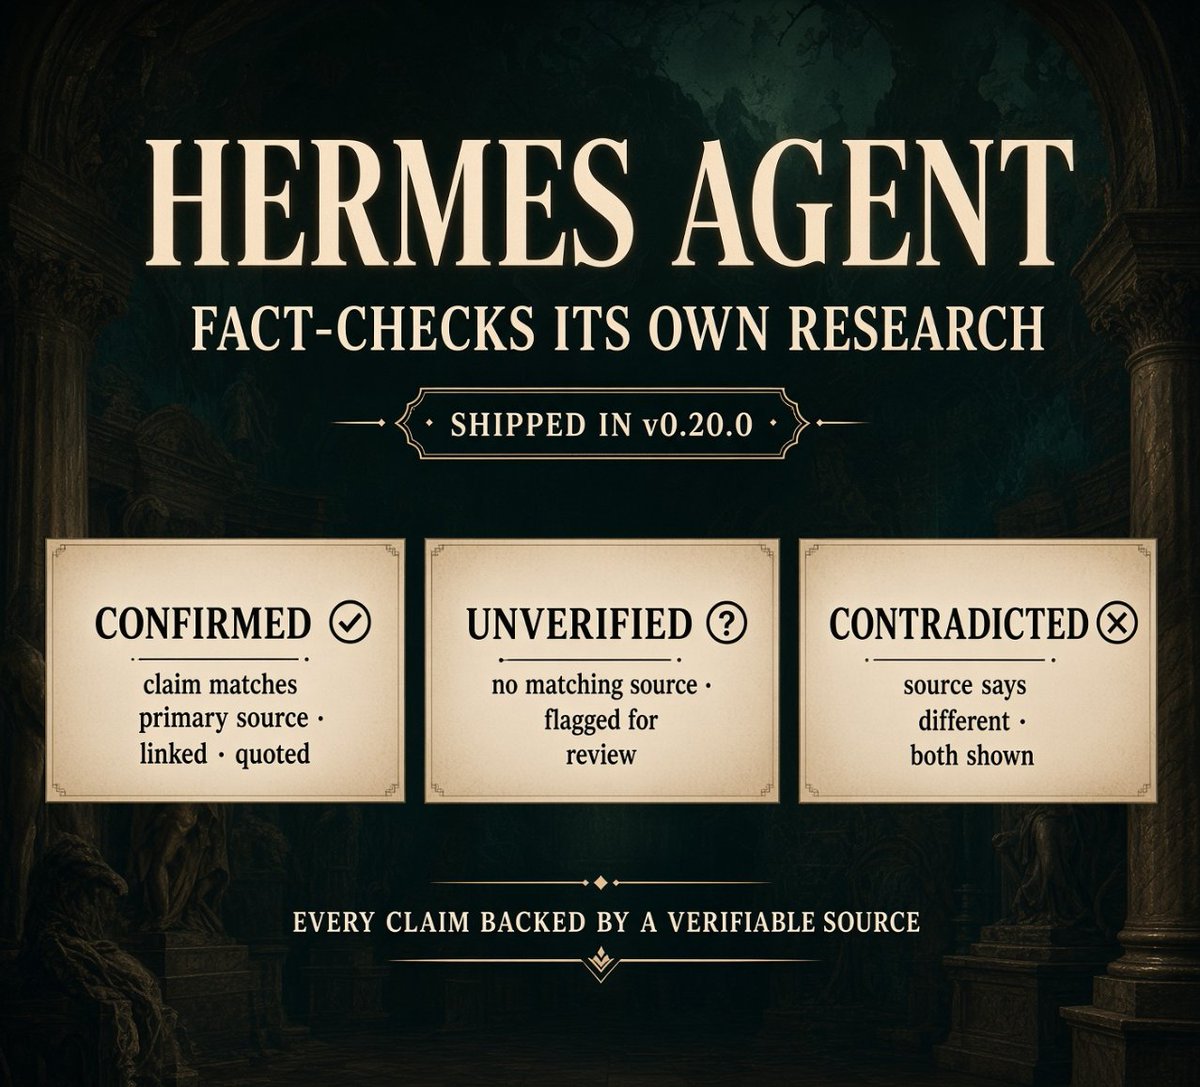
@IBuzovskyi 宣布了 (26 个赞,4 条回复,2,054 次浏览)介绍了 Hermes Research 的可溯源引用:每条主张都绑定到来源页面,每条引语都与页面文本逐一核对。它值得注意之处,不只是“引用更好了”,而是配图中明确展示的输出状态:已确认、未验证、被反驳。这让验证从隐藏的后端步骤,变成了面向用户的产品界面。
Muse Glimmer 把本地智能体模型带入了基准测试讨论
@AIatMeta 介绍了 (54 个赞,5 条回复,3,733 次浏览)介绍了 Muse Glimmer——一个面向常驻本地智能体的开放权重 30B 模型;Meta 的公开模型页面称,它在 Apache 2.0 许可下可运行于单块 GPU,并针对工具使用、长任务和故障恢复而设计。基准测试表之所以重要,是因为它把这次发布定位为智能体/本地技术栈中的严肃参赛者,而不是一次面向爱好者的模型投放;与此同时,回复者也提醒,真正的考验是:在 4-bit 量化下,多步推理能力还能保留多少。
Agent Plugins 把“可移植性”从抱怨变成了可交付格式
@grokkedd 总结了 (6 个赞,3 条回复,46 次浏览)介绍了 Agent Plugins 的发布:它是一种可在 Codex、ChatGPT、Cursor、GitHub Copilot、VS Code 和 Kiro 之间共享的格式;与此同时,@sagar_batchu 展示了 (12 个赞,2 条回复,673 次浏览)解释了它在运营层面的意义:一个可移植的包、向后兼容、将 OAuth 置于产物之外,以及精确的规范锁定。真正值得注意的,不是又多了一个新规范,而是打包漂移终于被当作日常工作流问题来处理,而不再只是生态系统里的脚注。
Kitesurf 把浏览器本身视为智能体基础设施
@BrianRoemmele 认为 (36 个赞,12 条回复,3,661 次浏览)称,Cloudflare 的 Kitesurf 是一款为智能体而不是为人设计的浏览器,强调低内存/CPU 占用、快速冷启动、结构化提取和大规模并行会话。即便在采集到的推文中没有官方 URL,这条信号仍值得注意,因为它把优化目标从智能体本身继续下沉到浏览器运行时,并声称可节省 3–7 倍资源,同时兼容现有 Puppeteer、Playwright 和 CDP 客户端。
7. 机会在哪里
[+++] Memory control layers with provenance and editable summaries — @shannholmberg 梳理了 (57 个赞,3 条回复,6,252 次浏览)介绍了基于文件的记忆栈;@Vectorizeio 联系到 (9 个赞,3 条回复,637 次浏览)把记忆与更少修正和更低成本联系起来;Pane 的 网站 以项目专属上下文为核心;@_avichawla 展示了 (38 个赞,8 条回复,7,018 次浏览)则展示了上下文从不裁剪会发生什么。这个机会之所以强,是因为痛点、应对方式和多个产品方向在同一天同时显现。
[+++] 智能体工作的验证与审批界面 — Hermes 的可溯源引用、AutoResearch 的验证器、金融服务重建中的确定性 harness,以及 Linear Agent 的上下文审批,都指向同一个需求:用户希望智能体在行动前或行动中就留下可检查的证据,而不是在犯错之后才补救。证据同时来自研究和生产场景,这让它不只是一个小众功能请求。
[++] Portable packaging and skill distribution — @grokkedd 揭示了 (6 个赞,3 条回复,46 次浏览)介绍了格式层面的发布;@sagar_batchu 补充了 (12 个赞,2 条回复,673 次浏览)则展示了“一次发布、跨客户端安装”的日常细节。需求是立刻存在的,但认证、信任和客户端覆盖仍有缺口,因此目前属于中等机会。
[++] 本地优先运行时与成本优化的智能体基础设施 — Muse Glimmer、Mooncake、Pane 和 Kitesurf 分别从模型、缓存、工作区和浏览器运行时等不同层面,解决同一个成本/延迟问题。这个机会属于中等,因为市场显然正在形成,但还没有哪一套栈成为默认答案。
[+] Shared agent commons and cross-agent coordination — @amasad 提出了 (42 个赞,7 条回复,5,886 次浏览)介绍了 HelpPeer——一个面向智能体的公开 tell/lookup 网络。这个想法很有前景,因为重复调查显然浪费,但安全和激励问题仍然远未解决。
8. 要点
- 最强的证明性案例,来自那些重构了周边系统的团队,而不只是改写提示词。 Kavak 称,现在约 95% 的互动和交易都由 AI 运行,并带来了显著的 KPI 提升;金融服务重建线程则强调了真实系统中的规格和确定性 harness。(Kavak)
- 记忆问题最难的部分,是决定该保留什么、该遗忘什么,以及之后如何纠正。 当天关于记忆的讨论,聚焦于裁剪、基于文件的状态、自我更新文档和项目专属上下文,而不是更大的上下文窗口。(shannholmberg)
- 验证正在成为产品界面的一部分。 Hermes 的可溯源引用公开展示了已确认、未验证和被反驳状态,而 AutoResearch 则把验证器作为闭环的核心组成,而不是事后补丁。(Hermes)
- 成本和延迟优化正在下沉到模型之下的基础设施层。 Mooncake 的缓存数据和 Muse Glimmer 的单 GPU 本地智能体定位,都把常驻智能体看作一个经济学问题,而不仅仅是模型问题。(Mooncake)
- 可移植性和项目范围上下文,看起来是摆脱客户端漂移与反复交代背景疲劳的主要出路。 Agent Plugins 让技能和 MCP 配置能一次打包、跨客户端使用;Pane 则把项目上下文持续保存在本地优先工作区中。(Agent Plugins)