Twitter AI Agent - 2026-08-12
1. 人们在讨论什么
1.1 Harness engineering 成为解释智能体质量的默认层(🡕)
至少有九条入选内容把智能体质量视为一个围绕循环、闸门、状态和证据的系统问题,而不是提示词编写问题。最有说服力的帖子都明确指出了生产环境中的失效方式:智能体过早宣布完成、不必要的子智能体堆栈、上下文无声衰减,以及并行汇合抹掉扇出带来的大部分收益。
@unclebobmartin 认为(1,081 个赞、65 条回复、30,640 次浏览、212 次收藏)认为,把“危险地反复无常”的智能体驯化进一个高效的 harness,是这个十年里软件工程的挑战。回复则把这一判断说得更具体:一位开发者表示,真正的痛点始于代码进入生产环境并变得复杂之后;另一位则把关键设计问题归结为,哪些部分必须始终留在智能体控制范围之外。
@khushiirl 向人们推荐了(94 个赞、11 条回复、2,036 次浏览、73 次收藏)介绍了 Learn Harness Engineering。其官网将其描述为一门面向 Codex 和 Claude Code 的项目制课程,涵盖环境、状态、验证和控制系统。推文本身信息不多,但课程链接和截图解释了它为何传播开来:harness engineering 现在正被当作一门可重复传授的工程学科,而不再只是零散经验。

@femke_plantinga 梳理了(60 个赞、5 条回复、1,733 次浏览、40 次收藏)讨论了从 prompt engineering 到 context engineering,再到 harness engineering 的演进,并把 harness 定义为借助记忆、工具和护栏串联数百轮交互的那一层。最有价值的回复来自 @eriks_b:真正的“完成了吗?”检查,必须指向一个之前是红的、现在变绿的测试;模型自己说“是”,不算数。
@gippp69 警告(32 个赞、11 条回复、885 次浏览、23 次收藏)指出,从一个简单请求直接跳到“编排器 + 子智能体”堆栈,可能会为本来一次调用就能完成的工作烧掉 10 倍 token,却得不到任何收益,反而放大失效面。@monokern 补充说(18 个赞、8 条回复、362 次浏览、16 次收藏)则从研究角度提出了同样的论点,展示了 Stanford Systems Intelligence Lab 对 router、planner-worker、supervisor 和 hierarchical 设计的综述,并明确警告上下文衰减、token 膨胀和共享状态工程问题。

讨论洞察: 大家真正争论的并不是模型质量,而是在争论持久的控制面应该放在哪里:外部状态、证据闸门、schema 修复、具备 AST 感知能力的工具,以及只有在任务确实逼迫时才扩张的小型架构。
与前一天对比: 8 月 11 日已经把讨论从提示词下探到上下文、harness 和治理。8 月 12 日则通过课程、图示、反模式警告和循环设计检查清单,把这套语言讲得更明确,也更容易传授。
1.2 Skills 和插件成为智能体能力的封装层(🡕)
第二个讨论簇把 skills、插件和打包好的工作流视为智能体能力在工具与团队之间流动的主要方式。讨论焦点不再只是如何在单一客户端里写出更好的提示词,而是如何封装记忆、MCP 服务器、领域逻辑和内部工作流,使其可以被安装、治理和复用。
@garrytan 宣布(109 个赞、24 条回复、10,926 次浏览、71 次收藏)介绍了 GBrain v0.45.6.0,新增 17 个 “brain skills”,并称现已支持 Codex 和 Claude Code。截图之所以重要,是因为它展示了实际新增的原语——correction-pipeline、fact-check、data-loss-gate、conversation-archive、citation-graph-ingest 和 skill-autobench。公开的 代码库 将 GBrain 描述为一个拥有 28,312 个 star 的持久化“大脑”,具备综合、图遍历和缺口分析能力,而不是普通的检索工具。

@code 宣布(76 个赞、2 条回复、7,762 次浏览、24 次收藏)介绍了 Agent Plugins 1.0 支持。GitHub 公开的 更新日志 表示,该规范会把 skills 和 MCP 服务器打包成一个可安装插件,可跨 VS Code、Copilot CLI、Copilot app 和 SDK 客户端运行。该帖还把治理纳入叙事:插件可通过 marketplace 分发,并可借助现有企业设置和 MCP allowlist 进行管理。
@I_AM_AYASHA 传播了(36 个赞、4 条回复、1,051 次浏览、33 次收藏)列出了 13 门免费的 Anthropic 课程,其中现在明确包括 Introduction to Agent Skills、Claude Code in Action,以及两门 MCP 课程。@ShrivuShankar 补充说(5 个赞、440 次浏览、4 次收藏)则给出了 Abnormal 内部 harness 的一个生产细节:他们把每个智能体的 skill-definition 文件视为工作流原语,让集成可以直接对接沙箱文件系统,并为智能体提供三个 VM 层级,以保留计算资源选择空间。
讨论洞察: 市场两端开始出现一种共享抽象。公开厂商正在标准化 skills 和 MCP 服务器如何在不同客户端之间交付,内部团队则把 skill 定义变成自家 harness 内工作流组合的基本单元。
与前一天对比: 8 月 11 日展示了可安装的上下文包和插件式封装这一新兴模式。8 月 12 日则把它扩展成正式插件标准、系统化课程目录,以及公开发布的 “brain skills”,使能力封装成为一等产品层。
1.3 编码智能体看起来越来越像长期运行的操作员,而不是副驾驶(🡕)
第三个讨论簇关注的是作为持久工作者的智能体:它们有 issue 看板、桌面环境、可路由任务以及明确的审查边界。至少有七条入选内容描述了依托沙箱、worktree 或专用计算机长期运转的智能体,而不是只回答一次提示后就结束的智能体。
@harjotsgill 宣布(133 个赞、50 条回复、10,456 次浏览、40 次收藏)提到 Abnormal 完成 1.43 亿美元 C 轮融资,并表示市场已经从“AI 代码需要单独的 reviewer”转向“把工作直接移进变更本身”。链接中的 Nora 文章 让这一说法更具体:Nora 每天提交 200+ 个 pull request,处理约 1,000 条 Slack 请求,并通过 skills 和 personas 来运行工作流,而不是依赖彼此隔离的机器人提示词。
@reach_vb 发布了(123 个赞、13 条回复、5,415 次浏览、16 次收藏)介绍了 Codex for Linux,具备并行智能体、worktree、diff、skills、automation 和浏览器工作流。回复补充了真实的操作细节,而不只是发布宣传:使用消耗会因模型和自动审查设置而有很大差异;还有一条回复指出,当两个智能体分别在彼此冲突的修改上都“成功”时,基于 worktree 的并行模式仍有尚未解决的合并协调问题。
@mardehaym 展示了(26 个赞、9 条回复、4,350 次浏览、16 次收藏)介绍了 Velocity Core:一个自主任务执行器,当看板状态变化时,会触发沙箱、修复循环、CI 通过和经审查的 pull request。该幻灯片对其运行形态描述得异常具体:触发、沙箱、循环、闸门和路由执行;人类被放在工单接入和审查环节,而不夹在运行过程当中。

@testingcatalog 展示了(80 个赞、8 条回复、6,320 次浏览)展示了语音智能体中的同类转变:通话结束后触发短信、邮件和 API 操作,并与来电号码等系统变量绑定。@Voxyz_ai 描述了(24 个赞、5 条回复、2,887 次浏览、7 次收藏)则介绍了 Grok Bot 作为一个具名角色,拥有自己始终在线的 Linux 电脑、文件、例程和记忆,同时也指出了反向压力:既然 Codex 和 Claude Code 已经存在,就很难证明再买一个 200 美元席位是合理的;回复还质疑每个 bot 的机器究竟隔离到什么程度。
讨论洞察: 人类的角色在不断上移。现在,操作员负责写工单、批准 PR、设定预算,或在认证和支付环节接管;而智能体则越来越被期待在这些节点之间持续持有工作状态。
与前一天对比: 8 月 11 日的重点是仪表盘、云端操作手册和操作员控制台。8 月 12 日仍然偏运营,但更靠近执行层:Linux 原生工作空间、从看板到 PR 的循环、生命周期评估框架,以及按角色托管的计算机。
2. 什么让人沮丧
系统仍会在工作真正完成之前宣布成功
最尖锐的挫败感并不是“模型很蠢”,而是智能体系统仍然太容易给自己打高分。@unclebobmartin 将其定义为(1,081 个赞、65 条回复、30,640 次浏览、212 次收藏)把整个问题概括为如何把反复无常的智能体变成一个高效 harness;回复则立刻把讨论推进到控制边界和受监管行业的定制化。@femke_plantinga 明确说明了(60 个赞、5 条回复、1,733 次浏览、40 次收藏)讨论了从提示词工作转向 harness 工作;其中一条回复认为,只有存在外部证据——例如之前失败、现在通过的测试——“完成”才算数。@mardehaym 坚持(26 个赞、9 条回复、4,350 次浏览、16 次收藏)提到 Velocity Core 即便其余环节都已自主运行,仍保留人工审查闸门;@OracleDevs 认为(11 个赞、527 次浏览、6 次收藏)则指出,评估必须覆盖 onboard、develop、release、assure 和 recover。当前的应对策略是:把判断放进明确的闸门、证据文件或审查检查点,而不是相信模型自己对成功的叙述。值得投入建设:高。
并行和编排花在等待上的时间比真正工作还多
第二个挫败点是,“多智能体”这个词背后仍藏着大量浪费。@gippp69 警告(32 个赞、11 条回复、885 次浏览、23 次收藏)指出,四层堆栈可能会为本来一次调用就能完成的工作烧掉 10 倍 token;回复把教训概括成一句话:“先从笨办法开始,非必要不加复杂度。”@hanakoxbt 描述了(18 个赞、15 次收藏、835 次浏览)揭示了同一问题更微妙的一面:barrier join 可能让 20 个智能体的扇出任务以最慢分支的速度结束,而追踪看起来却很“干净”,因为空等并不会被记录成事件。@monokern 补充说(18 个赞、8 条回复、362 次浏览、16 次收藏)转述了研究界的警告:标准交接会在每个节点消耗上下文;@vincentzed_cuda 给出了量化数据(9 个赞、364 次浏览)则从基础设施角度提出,CPU 沙箱可能有超过 75% 的时间处于闲置状态,而供应商计费掩盖了 20 倍的成本差距。人们的应对方式包括:保持架构更小、尽可能让工作跨过汇合点持续流动,以及把运行时迁移到闲置的内部算力上。值得投入建设:高。
记忆层和结构层仍然需要信任、修复与衡量
第三个挫败点是,当记忆或工具接口过于松散时,智能体的可靠性仍会下降。@garrytan 发布了(109 个赞、24 条回复、10,926 次浏览、71 次收藏)介绍了 GBrain 的 correction-pipeline 和 fact-check 等功能,原因恰恰在于:无法自我修复的持久记忆会在长周期中不断累积错误。@MrAhmadAwais 认为(63 个赞、7 条回复、2,060 次浏览、6 次收藏)指出,许多开源模型的失败其实来自一小组 schema bug,应该用 30–100 行代码做确定性修补,而不是为更多模型调用继续付费;@devagrawal09 表示(15 个赞、1 条引用、417 次浏览、11 次收藏)则指出,编码智能体需要 AST 层,因为只靠文本匹配无法保证绑定、导入和精确位置。官方的 @AgentMemoryL 发布(1 条回复、1 条引用、4 次浏览)之所以重要,也是出于同样的原因:这个领域现在需要公开排名,而不是关于“记忆更好”的含混说法。当前的变通方案包括自我修复记忆、位于模型下层的结构化工具,以及让不同说法能够相互比较的基准框架。值得投入建设:高。
3. 人们希望出现什么
可移植的 skill 包和可管理的市场
最明确的实际需求,是让智能体能力只需交付一次,就能在多个客户端和内部 harness 间运行。@code 宣布(76 个赞、2 条回复、7,762 次浏览、24 次收藏)介绍 Agent Plugins 1.0,正是因为团队不想为每个客户端分别维护 manifest 和打包规则;@garrytan 将其视为(109 个赞、24 条回复、10,926 次浏览、71 次收藏)则把 “brain skills” 定位为 Codex 和 Claude Code 之上的可复用层。@I_AM_AYASHA 展示了(36 个赞、4 条回复、1,051 次浏览、33 次收藏)表明,正式培训也已经沿用同样的抽象,包括 agent skills 和 MCP 课程。这是一个直接需求:人们想要的是可安装的能力包加治理机制,而不是一次性的提示词迷信。机会:直接。
支撑多日智能体工作的持久控制面
第二个需求是一个能跨会话、交接和现实时间持续存在的状态层。@mardehaym 介绍了(26 个赞、9 条回复、4,350 次浏览、16 次收藏)介绍了 Velocity Core,它通过路由元数据和人工审查闸门实现从看板到 PR 的循环;@Chinazhidx 披露了(9 个赞、3 条回复、334 次浏览、6 次收藏)介绍了 LoopX,它把目标、闸门、待办、证据、配额和交接放在模型上下文之外。@reach_vb 补充说(123 个赞、13 条回复、5,415 次浏览、16 次收藏)展示了桌面侧的一面:Codex for Linux 把 worktree、浏览器工作流和 automation 放在开发者原本就使用的同一环境里。这个需求之所以紧迫,是因为一旦状态只存在于聊天记录中,长时间运行的工作立刻就会崩掉。机会:直接。
既能自我修复、又能公开衡量的记忆
人们还想要一种既不只是回忆能力、也不只是营销话术的记忆。@garrytan 展示了(109 个赞、24 条回复、10,926 次浏览、71 次收藏)介绍了 correction-pipeline 和 fact-check 这样的自我修复记忆原语;官方的 @AgentMemoryL 发布(1 条回复、1 条引用、4 次浏览)则发布了并排排名,而不是再次声称某个框架“记得更好”。@OracleDevs 认为(11 个赞、527 次浏览、6 次收藏)指出,随着自主程度和生产风险上升,证据深度也应同步提升,这从另一个角度表达了同样的需求。这一方向既实际,也越来越有竞争性:很多人都想要,但几种可信路径已经开始形成。机会:竞争性。
无需 DIY 运维或订阅膨胀的托管智能体工作站
另一个更偏情绪、但同样现实的需求,是提供像队友一样持续在线的智能体计算机,同时又不让每个用户都变成自己的基础设施团队。@Voxyz_ai 描述了(24 个赞、5 条回复、2,887 次浏览、7 次收藏)体现了 Grok Bot 的吸引力:它作为一个具名角色,拥有自己始终在线的 Linux 计算机、文件、记忆和例程;被引用的发布帖还声称每个 bot 都会得到一台独立托管机器。但同一帖子也捕捉到了尚未满足的那一面:产品仍然需要证明额外 200 美元席位的合理性,而回复则提出了 bots 之间是否真正隔离的问题。这是一个竞争性需求:用户想要托管持久化的便利,也想要清晰的边界、定价和信任。机会:竞争性。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Learn Harness Engineering | 课程 / harness 方法 | (+) | 直接聚焦 Codex 和 Claude Code 的环境、状态、验证与控制系统 | 教育资源,不是开箱即用的 harness |
| GBrain | 记忆 / 知识层 | (+/-) | 综合、图遍历、缺口分析、correction pipeline,以及 Codex/Claude Code 支持 | 更适合作为独立记忆智能体使用;信任仍取决于验证和维护 |
| Agent Plugins 1.0 | 插件封装 | (+) | 一次打包 skills 和 MCP 服务器,供多个客户端使用;内置 marketplace 和企业设置 | 仍需编写 manifest,并处理客户端特有的能力边界 |
| Codex for Linux | 智能体桌面 / IDE | (+/-) | 在 Linux 上提供并行智能体、worktree、diff、skills、automation 和浏览器工作流 | 使用消耗因模型和自动审查设置而异;worktree 协调问题仍未解决 |
| Velocity Core | 智能体 CI harness | (+) | 看板到 PR 的循环、一次性沙箱、路由元数据、明确的人工审查闸门 | 企业集成负担较高;自主性止于审查 |
| LoopX | 控制面 | (+) | 将目标、闸门、待办、证据、配额和交接放在模型上下文之外;支持多日循环 | 增加了一层需要运维的状态层,并且有意把最终判断留给人类 |
| OCI Agent Evaluation Framework | 评估 / 治理 | (+) | 生命周期模型把证据深度与自主程度、数据敏感性和生产暴露面关联起来 | 属于框架层面的指导,而不是现成产品 |
| SpaceXAI Voice Agent Builder | 语音智能体平台 | (+/-) | 支持通话后短信/邮件/API 操作和来电变量,为对话后的行动层提供更强能力 | 通话结束检测与动作触发时机仍是棘手的产品边界 |
| Agent Memory Leaderboard | 基准测试 | (+) | 让记忆系统超越泛泛的检索宣称,具备可比性 | 仍处早期,目前只覆盖文本记忆赛道 |
| Agentic Data Scientist | 领域框架 | (+) | 规划/审查智能体、持续验证、MCP 集成和科学技能支持 | 相比简单分析脚本,需要更多组件、模型协调和操作员配置 |
总体满意度最高的,都是那些暴露出明确状态面和审查面的工具:GBrain 的 correction pipeline、Agent Plugins 的封装规则、Velocity Core 的闸门、LoopX 的控制状态、Oracle 的生命周期模型,以及语音构建器的动作钩子。常见的变通做法,是把脆弱逻辑从单轮聊天中移出去,放到可检查的结构里:测试、worktree、配额、生命周期阶段、插件 manifest、图记忆或外部控制状态。迁移压力正从提示词调优转向 harness 设计,从临时本地 skills 转向标准化插件封装,并从无状态助手转向能够跨会话或多次运行保留持久上下文的智能体。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Nora | Abnormal AI | 面向 PR、Slack 工作流、研究和会议准备的公司级智能体 harness | 把团队从彼此孤立的审查机器人,转向嵌入公司日常运营的 skills/personas | Slack、GitHub、Jira、Confluence、personas/skills、Python SDK、Airflow 风格后台任务 | 已发布 | 文章;推文 |
| GBrain | Garry Tan | 持久化的“brain”层,用于综合答案、维护图谱并存储长期智能体记忆 | 防止编码智能体和个人智能体在会话之间及长周期中遗忘上下文 | Markdown memory、综合层、知识图谱、本地优先数据库、Codex/Claude Code 集成 | 已发布 | 代码库;推文 |
| Velocity Core | @mardehaym | 将看板工单转化为经审查 pull request 的自主任务执行器 | 减少工单接入、编码、测试、CI 和 PR 创建之间的人工交接 | Jira/ClickUp 触发器、一次性沙箱、GitHub、CI、路由式 LLM 网关 | 已发布 | 推文 |
| Agent Plugins 1.0 | @code | 面向兼容智能体客户端的 skills 和 MCP 服务器开放封装标准 | 消除 IDE 与智能体工具之间重复的封装工作 | plugin.json、skills/、mcp.json、marketplace、企业托管设置 |
已发布 | 博客;推文 |
| Codex for Linux | @reach_vb | 具备 worktree、diff、skills、automation 和浏览器工作流的 Linux 桌面智能体环境 | 把完整的编码智能体桌面工作流带到 Linux 原生开发环境 | 桌面应用、并行智能体、git worktree、浏览器自动化、diff/review 界面 | 已发布 | 推文 |
| LoopX | huangruiteng | 本地优先控制面,把目标、闸门、待办、证据、配额和交接保存在模型上下文之外 | 让长期运行的智能体工作在跨会话、跨智能体时仍可重启、审查和治理 | Python 状态内核、CLI 控制面、Codex/Claude Code/Cursor 集成、本地持久状态 | 已发布 | 代码库;推文 |
| Agentic Data Scientist | K-Dense AI | 用于规划、执行和验证数据科学任务的自适应多智能体工作流 | 把多智能体模式封装进一个特定垂直场景,而不是停留在通用编码演示层面 | Python、Google ADK、Claude Agent SDK、OpenRouter、MCP、scientific skills | Beta | 代码库;推文 |
最强的构建模式是“把状态外置,再给运行设边界”。Nora、Velocity Core、Codex for Linux 和 LoopX 都在模型周围增加了持久化表面——工单状态、worktree、审查闸门、配额或交接——而不是假设聊天记录本身就足够。
GBrain 的特别之处在于,它外置的是另一层:不是工作流状态,而是记忆状态。它的公开定位是,编码智能体或个人智能体需要一个能够综合、验证,并告诉你自己还不知道什么的“大脑”;而 LoopX 则把同样的外置思路应用到目标和证据上,而不是知识检索。
Agent Plugins 1.0 和 Agentic Data Scientist 则指向第二种模式:能力封装与垂直化。前者标准化了 skills 和 MCP 服务器如何跨客户端交付,后者则展示了多智能体模板正以多快的速度被重新包装,用于数据科学等垂直工作,而不再只是泛泛的“AI 智能体”演示。
6. 新鲜且值得关注的内容
Agent Plugins 1.0 把 skills 和 MCP 变成可移植、可治理的封装
@code 宣布(76 个赞、2 条回复、7,762 次浏览、24 次收藏)介绍了 Agent Plugins 1.0 支持。GitHub 公开的 更新日志 表示,该规范现在把智能体 skills 和 MCP 服务器打包成一个可安装插件,可跨多个兼容客户端运行。它值得关注的地方不只是可移植性;同一帖子还把插件与 marketplace、企业托管设置和 MCP allowlist 关联起来,把“skills”从松散的社区惯例,变成企业真正可以分发和治理的对象。
LoopX 用公开的长时运行示例,把控制面这个概念讲具体了
@Chinazhidx 披露了(9 个赞、3 条回复、334 次浏览、6 次收藏)介绍了 LoopX:一个循环工程框架,把目标、闸门、待办、证据和配额持久化在模型上下文之外,以支持 200+ 小时的智能体运行。公开的 代码库 将其定位为一个拥有 4,432 个 star、与供应商无关的状态内核和本地优先控制面,并记录了 200+ 小时的贡献与实验轨迹。这之所以重要,是因为它为当天最反复出现的建议——持久状态、边界清晰的切片、交接和人工判断——提供了一个具体的公开实现。

智能体记忆第一次有了公开排行榜,而不是又一个营销说法
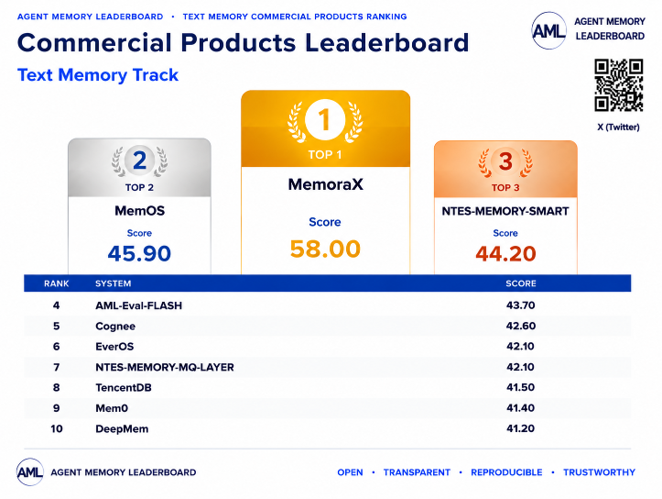
官方的 @AgentMemoryL 发布(1 条回复、1 条引用、4 次浏览)之所以值得注意,是因为它公布了商业和开源文本记忆系统的公开排名。商业榜单图片显示,MemoraX 以 58.00 分位列第一,高于 MemOS 的 45.90 分和 NTES-MEMORY-SMART 的 44.20 分;开源榜单图片则显示 InvMem 以 45.06 分位列第一,高于 ReFind 的 44.97 分和 ActiveMemoryIndex 的 44.84 分。经历了数周的记忆讨论后,这是数据集中少数真正尝试让这一类别具备可比性的内容,而不只是继续打口水仗。
一项覆盖 1.8 亿个仓库的普查显示,编码智能体已在生态系统规模上变得可见
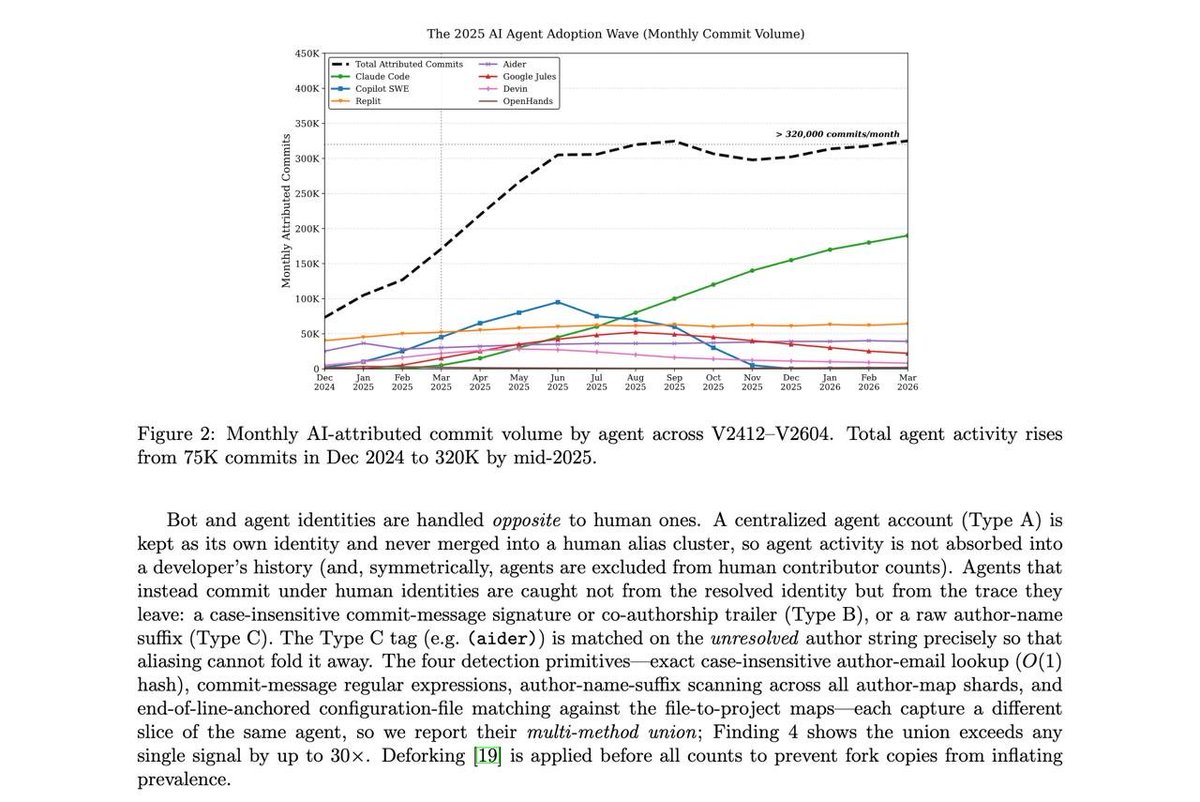
@ikyinusa 分享了(3 个赞、3 条回复、16 次浏览)介绍了一篇论文,声称可以在超过 1.8 亿个代码仓库中检测到 AI 编码智能体。帖子中的图片显示,AI 归因的月度提交量从 2024 年 12 月的大约 75,000 次,上升到 2025 年年中约 320,000 次。尽管互动量很低,但这是当天材料里最清晰的“走出演示阶段”采用信号之一,因为它指向的是可观察的仓库活动,而不是厂商自报的使用数据。
7. 机会在哪里
[+++] Evidence-backed harnesses for long-running coding agents — @unclebobmartin 将其定义为(1,081 个赞、65 条回复、30,640 次浏览)把 harness 视为这个十年的挑战,@mardehaym 展示了(26 个赞、9 条回复、4,350 次浏览、16 次收藏)展示了带硬性审查闸门的看板到 PR 循环,@OracleDevs 提供了(11 个赞、527 次浏览、6 次收藏)给出了生命周期评估模型,@devagrawal09 表示(15 个赞、1 条引用、417 次浏览、11 次收藏)指出智能体需要 AST 层,而 @MrAhmadAwais 认为(63 个赞、7 条回复、2,060 次浏览)则主张在模型之下做结构化 schema 修复。这个方向很强,因为痛点、期望中的护栏以及多种实现路径都在同一天出现了。
[+++] Cross-client skill and plugin distribution — @code 做出(76 个赞、2 条回复、7,762 次浏览、24 次收藏)通过 Agent Plugins 1.0 让封装与治理正式化,@garrytan 将其视为(109 个赞、24 条回复、10,926 次浏览、71 次收藏)把 “brain skills” 作为可复用产品层推出,@ShrivuShankar 展示了(5 个赞、440 次浏览、4 次收藏)则在生产 harness 里呈现了同样的抽象。这个方向很强,因为用户现在希望 skills 像可安装软件一样工作,而不是像可复制的提示词片段。
[++] Durable control planes and hosted workstations for persistent agents — @Chinazhidx 指出(9 个赞、3 条回复、334 次浏览、6 次收藏)指向 LoopX,@reach_vb 发布了(123 个赞、13 条回复、5,415 次浏览、16 次收藏)指向 Codex for Linux,@Voxyz_ai 描述了(24 个赞、5 条回复、2,887 次浏览、7 次收藏)则体现了按角色托管 bot 电脑的吸引力。这个机会属于中等强度,因为需求很明显,但若干强势产品形态已经开始出现。
[++] Memory systems that can self-correct and also prove they work — @garrytan 补充说(109 个赞、24 条回复、10,926 次浏览、71 次收藏)把 correction-pipeline 和 fact-checking 功能带进 GBrain,而公开的 @AgentMemoryL 排行榜(1 条回复、1 条引用、4 次浏览)则指向一个用户既想要持久性、又想要证据的类别。这个机会属于中等强度,因为需求真实且反复出现,但这个领域已经分化成多个彼此竞争的框架和基准。
[+] Tooling that reduces hidden orchestration waste — @hanakoxbt 开放了(18 个赞、15 次收藏、835 次浏览)讨论了 join barrier,@vincentzed_cuda 开放了(9 个赞、364 次浏览)讨论了供应商计费下的闲置浪费,@gippp69 开放了(32 个赞、11 条回复、885 次浏览、23 次收藏)则讨论了架构过度设计。这个方向还处于萌芽阶段,但这些抱怨已经具体到足以支撑调度器、性能分析器和“最小可行循环”诊断工具。
8. 要点
- Harness engineering 现在关注的是证据,而不是提示词抛光。 @unclebobmartin 将其定义为(1,081 个赞、65 条回复、30,640 次浏览)把这一类别定义为 harness 问题,而当天其余讨论则不断把成功条件从模型内部移到测试、闸门、证据和有边界的循环上。
- Skills 正在成为智能体能力真正的分发单元。 @code 宣布(76 个赞、2 条回复、7,762 次浏览、24 次收藏)介绍了 Agent Plugins 1.0,而 @garrytan 发布了(109 个赞、24 条回复、10,926 次浏览、71 次收藏)则介绍了构建在 GBrain 之上的 brain skills。
- 市场正从“AI reviewer”走向“AI 变更执行器”。 @harjotsgill 宣布(133 个赞、50 条回复、10,456 次浏览、40 次收藏)描述了向 Agentic Change Management 的转变,@mardehaym 展示了(26 个赞、9 条回复、4,350 次浏览、16 次收藏)则给出了这一循环的看板到 PR 版本。
- 关于记忆的讨论正在变得更严肃,因为其中已经包含修复和排名。 @garrytan 强调(109 个赞、24 条回复、10,926 次浏览、71 次收藏)介绍了修复与事实核查,而官方的 @AgentMemoryL 发布(1 条回复、1 条引用、4 次浏览)则发布了公开排行榜,而不是继续停留在含混的记忆能力宣称上。
- 长期运行的智能体正在摆脱聊天记录,变成持久化工作环境。 @Chinazhidx 指出(9 个赞、3 条回复、334 次浏览、6 次收藏)指向 LoopX,@reach_vb 发布了(123 个赞、13 条回复、5,415 次浏览、16 次收藏)则把 Codex for Linux 呈现为同一持久化转变在桌面端的体现。