Twitter AI 智能体 - 2026-08-14
1. 人们在讨论什么
1.1 智能体工程正在被整理成可教授的技术栈和课程(🡕)
至少有三条高信号内容,把智能体工作当作一门有明确名称、技能栈相对稳定的学科,而不再只是零散的提示词技巧。最有代表性的帖子几乎都收敛到了同一组要素:记忆、上下文工程、工具、触发器、权限、评估,以及仓库级控制。今天的变化不只是热情升温,更在于这些内容开始被系统化打包:技能地图、实践配方和完整课程,让智能体工程看起来像是一种团队可以系统训练的能力。
@AndrewYNg 分享(2,308 个赞、75 条回复、143,316 次浏览、3,934 次收藏)介绍了“一张 AI 工程中最重要技能的地图”;Andrew Ng 在回复中表示,这项工作将“远不止一门课程”,将其定位为 DeepLearningAI 围绕可就业的 AI 工程技能展开的更大推动,而不是一次性的单节课程。
@nicbstme 概述(304 个赞、9 条回复、35,821 次浏览、551 次收藏)给出了一套完整的智能体产品配方:记忆、上下文工程、技能、工具/MCP、运行时循环、事件触发器、信任/权限以及评估。下方的引用推文把这个观点又往前推了一步,认为前沿方向是能够在事件发生时被唤醒的主动式后台智能体,而真正的竞争在于:能否以可行的单用户成本,获得高质量上下文并执行有用操作。
@beamnxw 推荐(44 个赞、16 条回复、1,296 次浏览)介绍了面向 Codex、Claude Code 和智能体团队的免费课程 Learn Harness Engineering。截图也解释了它为何引发共鸣:课程讨论了为什么能力很强的智能体仍会失败、为什么仓库必须成为事实来源、为什么长时间运行的任务会失去连续性,以及为什么智能体会越权或半途而废。

讨论洞察: 这一组内容中最有价值的回复来自 @mrlaraibkhan,他对 Nicolas Bustamante 说:“大家都在做收集,却跳过了遗忘。”这让“记忆”从存储问题变成了保留策略问题。
与前一天比较: 8 月 13 日已经把 harness 和技能视为封装层;8 月 14 日则更进一步,明确提出了技能地图、课程体系和技术栈配方。
1.2 DeepSeek Harness 让行业继续聚焦插件化运行时、日志和安全自修改(🡒)
DeepSeek Harness 仍是当天的参照点,但讨论已经从发布热潮转向实现层面的问题:到底什么算上下文、模型可见状态如何记录、插件化是否保留提示词缓存,以及 harness 在不打破安全保障的前提下,究竟能在多大程度上重配自身。最有分量的帖子并没有争论模型“智商”,而是在争论运行时应该长什么样。
@akshay_pachaar 解释(390 个赞、18 条回复、40,107 次浏览、458 次收藏)把 DeepSeek Harness 描述为一个“万物皆插件”的系统:模型适配器、工具注册表、会话日志,甚至智能体循环都可以替换。公开的 代码仓库 目前显示该项目拥有 98,337 个 GitHub stars,并称其为开发者预览版;模型、工具、技能、会话、沙箱、循环、编排和 UI 全部都是由 Cordis 驱动的插件。

@code_hiyouga 提出观点(143 个赞、7 条回复、9,829 次浏览、119 次收藏)认为,当训练和 RL 框架膨胀得过于庞大时,插件化是顺理成章的答案;随后又将其与 PenguinHarness 对比:在那里,智能体、上下文和长期记忆都是智能体可以在有限边界内修改的文件。第一张图展示了 LlamaFactory 从单体式 v0 转向插件化 v1 的变化,第二张图则将 Claude Code 的紧密循环,与 PenguinHarness 更广的记忆、技能和轨迹表面区分开来。
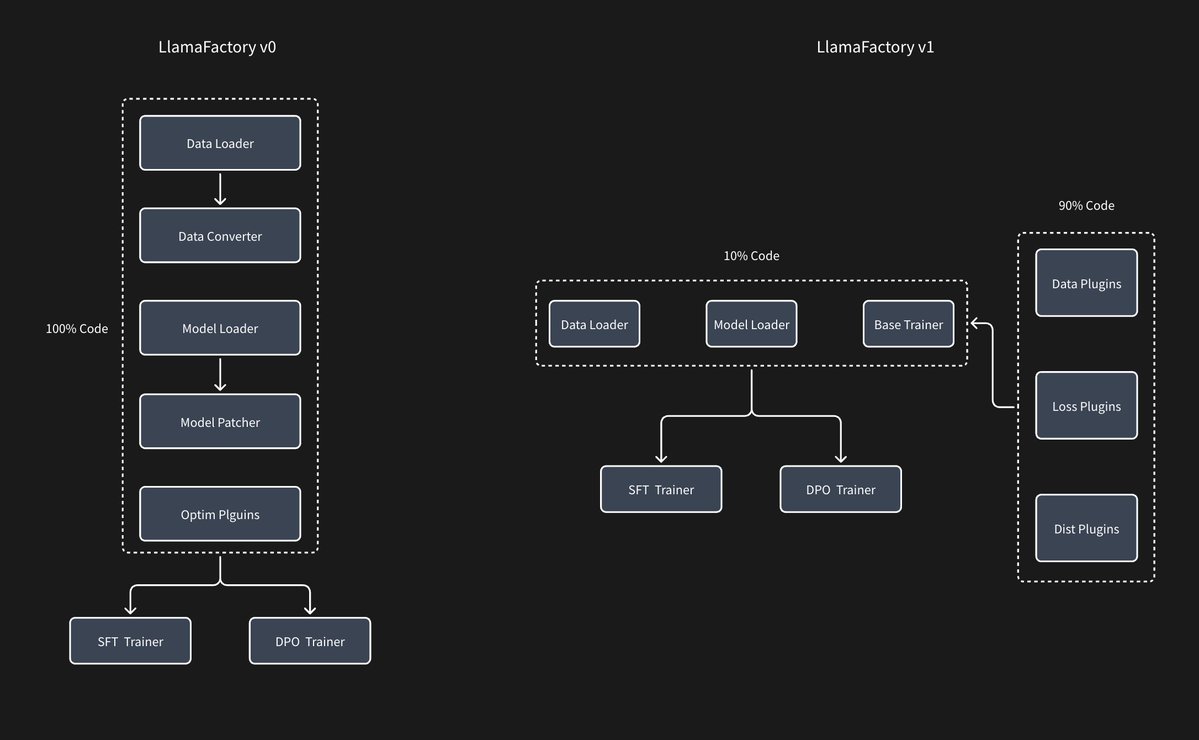

@hsu_steve 将其定义为(189 个赞、6 条回复、27,580 次浏览、115 次收藏)认为,同一套 Cordis 底层也可能成为递归式自我改进的路径:可逆副作用和具备依赖感知的重计算,能让智能体重写 harness 的部分内容,同时避免永久性状态损坏或整套系统重启。与此同时,@RoundtableSpace 提升了(35 个赞、7 条回复、50,021 次浏览)介绍了 Arcee 的 nac;其 README 描述了一种适用于长期任务的 thread-and-episode 架构:中央编排器负责规划,但不执行命令。
讨论洞察: 最尖锐的回复关注的是可观测性,而不是可扩展性。一条回复警告说,插件顺序可能在悄无声息中破坏提示词缓存;另一条则指出,fork 会出现在 diff 里,而插件注册只有在运行时才看得见。
与前一天比较: 8 月 13 日让 DeepSeek Harness 成为头条;8 月 14 日仍以同一个仓库为中心,但讨论已经转向日志、可逆性、提示词缓存契约,以及替代性的 harness 设计。
1.3 多智能体系统变得更聚焦、更便宜,也更强调角色分工(🡕)
最实用的多智能体帖子,已经不再单纯庆祝智能体数量本身。它们会明确说明规划器位于哪里、昂贵模型看到内容前先压缩什么、哪些角色可以并行运行,以及何时必须由验证器或人工介入。重点已从 swarm 的规模转向上下文约束。
@gippp69 总结(23 个赞、9 条回复、231 次浏览)介绍了 Anthropic 关于高效智能体的说明,其流程是:规划器 -> 专家 -> 归约器 -> 验证器。40 个 Haiku worker 生成了 41,200 个 token,经确定性归约后,在 Sonnet 读取前被压缩到 5,300 个 token,并声称成本从 $1.38 降至 $0.19,延迟则从 51 秒降至 11 秒。
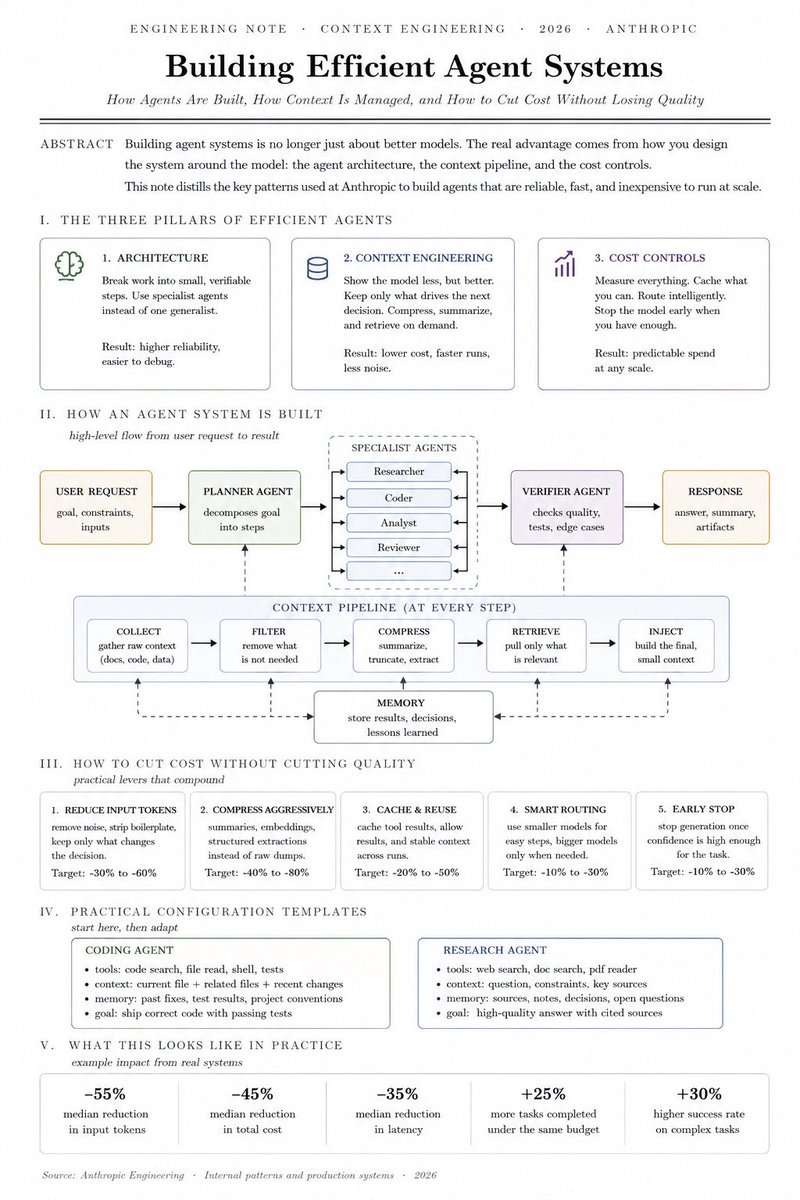
@hanakoxbt 描述(59 个赞、3 条回复、4,381 次浏览)介绍了一条由六个智能体组成的 PR 流程:规划器只制定一次计划,三个构建者并行工作,评审器依据计划而不是代码本身做否决,记录员根据轨迹撰写 PR,失败再回流到下一版规范中。这条讨论里最重要的不是“六个智能体”,而是这条回流到未来约束的反向边。
@gippp69 传播(93 个赞、33 条回复、3,348 次浏览)介绍了 awesome-claude-code-subagents 仓库。网页和仓库信息显示,该项目拥有 24,314 个 stars,收录了 10 个类别下 100+ 个专用 Claude Code subagent。传播最广的主张很直接:让主会话充当协调器,把后端、安全、数据、测试或基础设施工作推到隔离的专家上下文里。
@DanKornas 表示(7 个赞、2 条回复、1,222 次浏览)指出,真正困难的不是找到某一项技能,而是把许多技能变成一条真正可运行的流水线;随后提到 AgentSkillOS,其公开 README 描述了跨 200,000+ 技能的能力树检索和 DAG 编排。
讨论洞察: 共同的设计规律是:昂贵的推理应该看到更少,而不是更多。增加 worker 很便宜;真正的工程层在于更好的归约、路由和验证。
与前一天比较: 8 月 13 日仍把多智能体描绘成带有记忆和审批机制的队友;8 月 14 日则更具体地落到了归约器、验证器、DAG 和专家角色边界上。
2. 人们感到挫败的地方
记忆系统什么都收集,却仍然做不好选择和遗忘
反复出现的设计挫败并不是“我们需要更多记忆”,而是“我们需要更好的记忆卫生”。@nicbstme 概述(304 个赞、9 条回复、35,821 次浏览、551 次收藏)把这项技术栈要求讲得很清楚——先学会所有有用信息,再判断究竟哪一小部分真的该进入上下文窗口;紧接着就有一条回复指出,真正困难的是决定哪些内容在六个月后本来就该过期。@gippp69 补充(23 个赞、9 条回复、231 次浏览)则指出了成本后果:让每个 worker 都把原始输出往上游倾倒,正是 swarm 变得嘈杂、缓慢又昂贵的原因。当前的应对方式是压缩、确定性归约,以及更小、更按角色划分的上下文。值得投入建设:高。
“已验证”的智能体输出,仍然缺乏独立证据
第二个挫败,来自那些尚未真正证明工作的智能体,却给出了过度自信的状态表述。@itamar_mar 警告(2 个赞、250 次浏览)指出,夜间运行的编码智能体可以添加依赖、修改基础设施并跨越仓库边界,却让审查者无法判断到底测试了什么、影响范围有多大;随后还展示了一张截图,其中“端到端已验证……没有 mock”这句话在受到质疑后不得不撤回。@hanakoxbt 提出(59 个赞、3 条回复、4,381 次浏览)从结构上表达了同一点:测试回答的是“它能运行吗”,而评审器必须回答“它该不该存在”。@marfinxx 扩展(27 个赞、8 条回复、1,400 次浏览)则把这一担忧延伸到网络安全,主张加入治理审计智能体和不可篡改的决策轨迹。
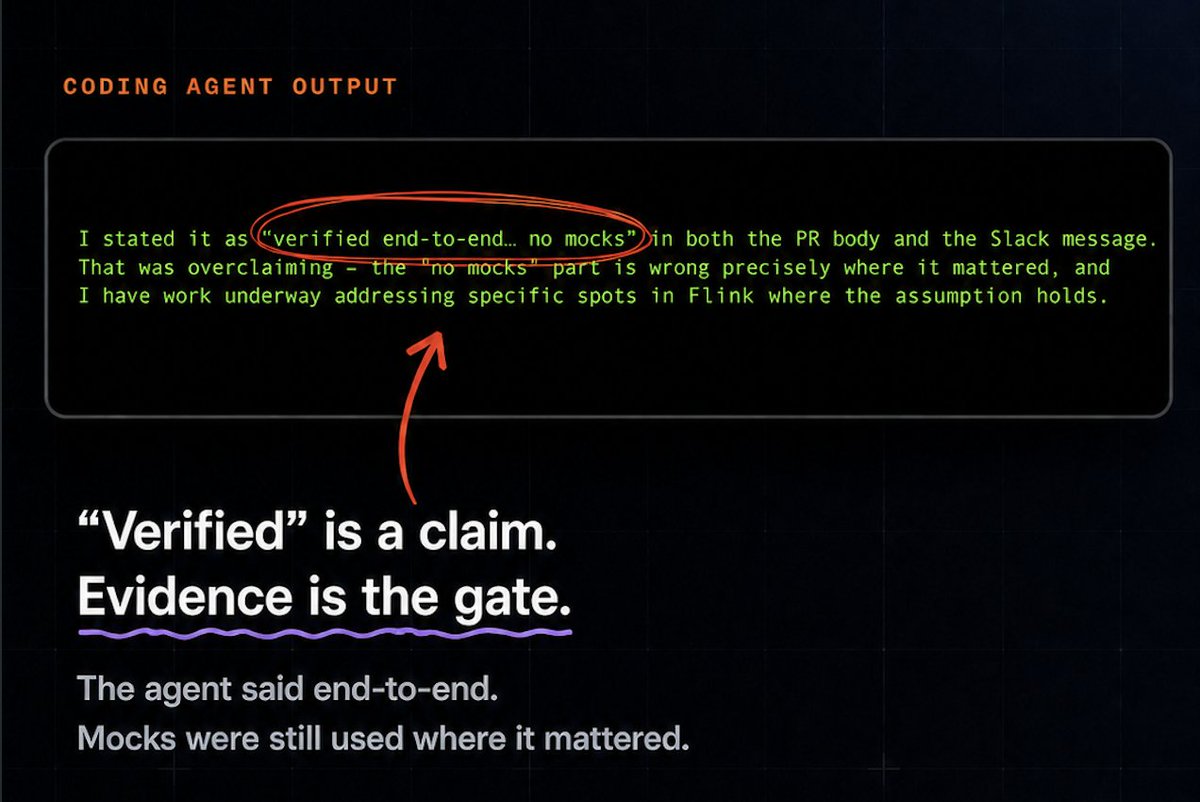
人们目前的应对方式,是加入评审器、审批步骤、溯源检查和独立审查智能体。值得投入建设:高。
长时间运行的任务仍然需要更清晰的日志、更强的可恢复性和运行时边界
第三个挫败是,一旦工作跨越几十次工具调用,harness 本身就成了故障面。@akshay_pachaar 提出观点(390 个赞、18 条回复、40,107 次浏览、458 次收藏)指出,DeepSeek Harness 里他“真正会去用”的部分,是仅追加的会话日志,因为仅靠工具调用日志并不能告诉你模型到底看到了什么。@RoundtableSpace 强调(35 个赞、7 条回复、50,021 次浏览)介绍了 nac,这是一个面向长期工程任务的 harness;有条回复把基准问题归结为一句很简单的话:它能否在 50 次工具调用、局部失败和不断变化的仓库状态下存活下来,并保持可恢复?当前的应对方式,是把 thread、episode、trace 和状态转换外置,而不是信任单一的一份转录。值得投入建设:高。
3. 人们希望存在什么
更便宜的主动式智能体,以及更好的记忆衰减和上下文选择
最明确的实际需求,是那种能在事件发生时被唤醒的后台智能体,同时不会永远拖着全部历史前行。@nicbstme 表示(304 个赞、9 条回复、35,821 次浏览、551 次收藏)认为前沿方向是主动式后台智能体,但也表示真正的竞争在于:一边尽量提升上下文质量和有用操作,一边尽量压低 token 成本。同一讨论里最有价值的回复指出,描述“收集用户记忆”很容易,而决定哪些内容该过期,才是真正的产品问题。这是一项直接需求:人们想要主动式智能体,但前提是记忆必须便宜、可选择且可信。机会:直接。
能把庞大技能库变成一条可运行流水线的技能检索与编排
人们还希望有一层系统,能够发现、路由并组合大量技能,同时不让协调器淹没在无关输出中。@DanKornas 表示(7 个赞、2 条回复、1,222 次浏览)指出,“找到合适的智能体技能,只完成了一半工作”,并将 AgentSkillOS 定位为一个支持能力树发现、任务感知检索和跨 200,000+ 技能 DAG 执行的系统。@gippp69 补充(93 个赞、33 条回复、3,348 次浏览)则通过一个面向 Claude Code 的 100+ 专家 subagent 目录,展示了同一需求的人工作策展版本。这是一项实际且竞争日益激烈的需求:市场已经有技能库了,但仍缺乏一种默认方式,能干净利落地选择并组合这些技能。机会:竞争性。
面向软件工程之外领域专家、以协作为先的工具
最强烈的愿景型需求,来自那些不希望专业工作被压扁成一次性“提示词到产物”体验的人。@voooooogel 提出观点(174 个赞、23 条回复、7,369 次浏览、71 次收藏)指出,数学领域不应重走艺术工具的路径:为低专业门槛编辑而优化的模型,挤掉了与专家协作的空间;该帖子明确希望出现的是,能帮助数学家和其他专业人士主导工作流程的系统,而不是把他们排除在外。@TONGYI_SpeechAI 展示(50 个赞、2 条回复、1,728 次浏览)则给出了这种协作模式在语音领域的一个具体版本:一个 ASR 智能体能够接受“不是 Megan,是 Megan,M-e-g-a-n”这样的纠正,并把任务拉回正轨,而不是悄无声息地失败。


这既带有愿景色彩,也有现实意义。人们要的是一种工具:让专家的主导始终留在闭环里,而不是只为通用输出做优化。机会:愿景型。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| DeepSeek Harness | 智能体 harness / 运行时 | (+/-) | 万物皆插件的架构;仅追加的会话日志;生态关注度高 | 开发者预览版;预计会有破坏性变更;插件顺序和仅在运行时显现的行为会带来调试和缓存方面的担忧 |
| Learn Harness Engineering | 课程 / 方法 | (+) | 将状态、验证、连续性和仓库控制转化为可教授的课程体系 | 仅是教育资源;团队仍需自行实现 harness |
| AgentSkillOS | 技能检索与编排 | (+) | 跨 200,000+ 技能的能力树发现;DAG 编排;GUI 和批处理 CLI | 需要编排策略和技能池策展;相较于更高声量的智能体仓库,仍属小众 |
| awesome-claude-code-subagents | Subagent 套件 | (+/-) | 100+ 个专用角色;让协调器会话保持聚焦;易于按插件方式复用 | 如果不做过滤、归约和验证,更多智能体仍可能制造噪声 |
| nac | 长任务 harness | (+) | thread-and-episode 架构;中央编排器;仪表板;入门技能 | 项目很新,采用证据有限;还增加了 provider 登录和配置成本 |
| uAgents | 智能体框架 | (+) | 支持定时运行和事件驱动的智能体;结构化消息;身份和安全钱包 | 对 Fetch-network 的假设限制了默认使用场景;高层编排指导较少 |
| Harvey custom GLM-5.2 review-table model | 领域模型 / harness | (+) | 以更低成本获得更高的答案和引文质量;agentic search 降低了 token 负载 | 专用于法律审查工作流;需要定制训练数据和人工审查 |
| Agentic ASR + S²ER | 语音智能体方法 | (+) | 交互式纠正闭环;衡量的是意图和实体是否保留下来,而不仅是原始转录准确率 | 仍处于早期阶段;推文集合并未展示广泛的生产级可靠性 |
| three.ws | 3D 智能体平台 | (+/-) | 结合 avatar、语音、支付、MCP/A2A、身份和 WebXR 部署 | 覆盖面非常广;相较于产品野心,公开仓库的 traction 仍然有限 |
总体来看,满意度集中在那些能够收窄上下文、暴露状态并把验证明确化的系统上。最受认可的帖子称赞了插件边界、DAG 路由、领域调优的 harness,以及能够感知纠正的交互。抱怨也高度一致:记忆系统仍然收集过多,多智能体技术栈仍然产出过多,而“已验证”往往仍只是“智能体自己这么说”。迁移压力同时体现在三个方向:从提示词转向 harness 工程,从通用会话转向专家流水线,以及从一次性输出转向能感知纠正和证据的工作流。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| DeepSeek Harness | DeepSeek AI | 开源智能体 harness,模型、工具、技能、会话、循环和 UI 都是插件 | 团队希望拥有一套第一方运行时,能替换和扩展,而不必 fork 整个框架 | TypeScript、Cordis、插件架构、web UI | Beta | 代码仓库, 网站 |
| awesome-claude-code-subagents | VoltAgent | 收录 10 个类别下 100+ 个专用 Claude Code subagent 的精选套件 | 当一个通用智能体承担所有角色时,主会话上下文会被稀释 | Claude 插件分发、提示词/配置包、安装脚本 | Beta | 代码仓库 |
| AgentSkillOS | ynulihao | 在 200,000+ 个技能中检索、组合并运行工作流 | 庞大的技能生态难以搜索,更难端到端编排 | Python、能力树、DAG 编排、web UI、批处理 CLI | Beta | 代码仓库, 项目页面 |
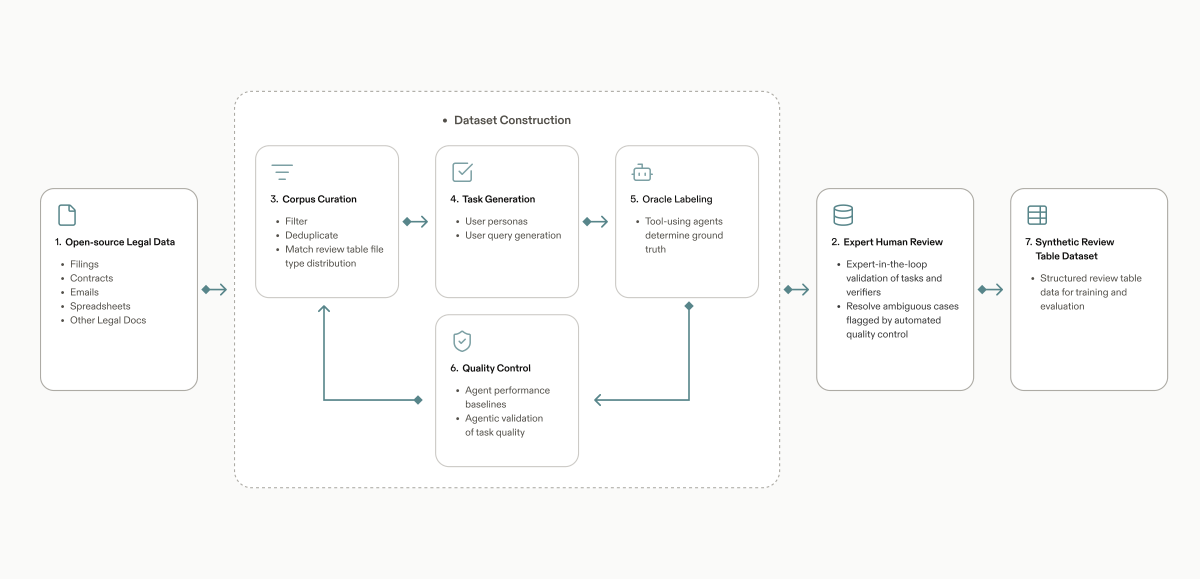
| Harvey review-table custom model | @harvey | 面向大型法律审查表的后训练模型和 agentic-search harness | 审查表工作负载可能达到数百万次查询,在通用前沿模型上成本过高 | GLM-5.2、Applied Compute AC2、合成法律数据、agentic search、人工法律审查 | Shipped | 公司 |
| uAgents | @Fetch_ai | 面向自治智能体的 Python 框架,可按计划运行、响应事件并交换结构化消息 | 构建者希望获得内置身份和消息能力的轻量智能体原语 | Python、Almanac smart contract、安全钱包/消息 | Shipped | 代码仓库, 文档 |
| nac | Arcee | 使用中央编排器加 thread-and-episode 执行机制的长任务 harness | 有野心的工程工作在长时间跨度下会逐渐偏离最初意图 | Rust、thread-and-episode 架构、仪表板、入门技能 | Beta | 代码仓库, 博客 |
| three.ws | nirholas | 开源 3D AI 智能体框架,支持 avatar、支付、身份和工具连接 | 非编码智能体需要具身化、变现能力以及跨智能体可发现性 | JavaScript、Three.js、MCP、A2A、x402、Solana/EVM、LiveKit、ElevenLabs、WebXR | Beta | 网站, 代码仓库 |
当天最重要的构建讨论中,@akshay_pachaar 将其定义为(390 个赞、18 条回复、40,107 次浏览、458 次收藏)介绍了 DeepSeek Harness:这是一个运行时,其中上下文组装、工具访问和会话日志都可以替换。这个项目之所以重要,不只是因为仓库热度,还因为它提出了一个更明确的主张:模型可见状态应当被记录、可重放且可替换。
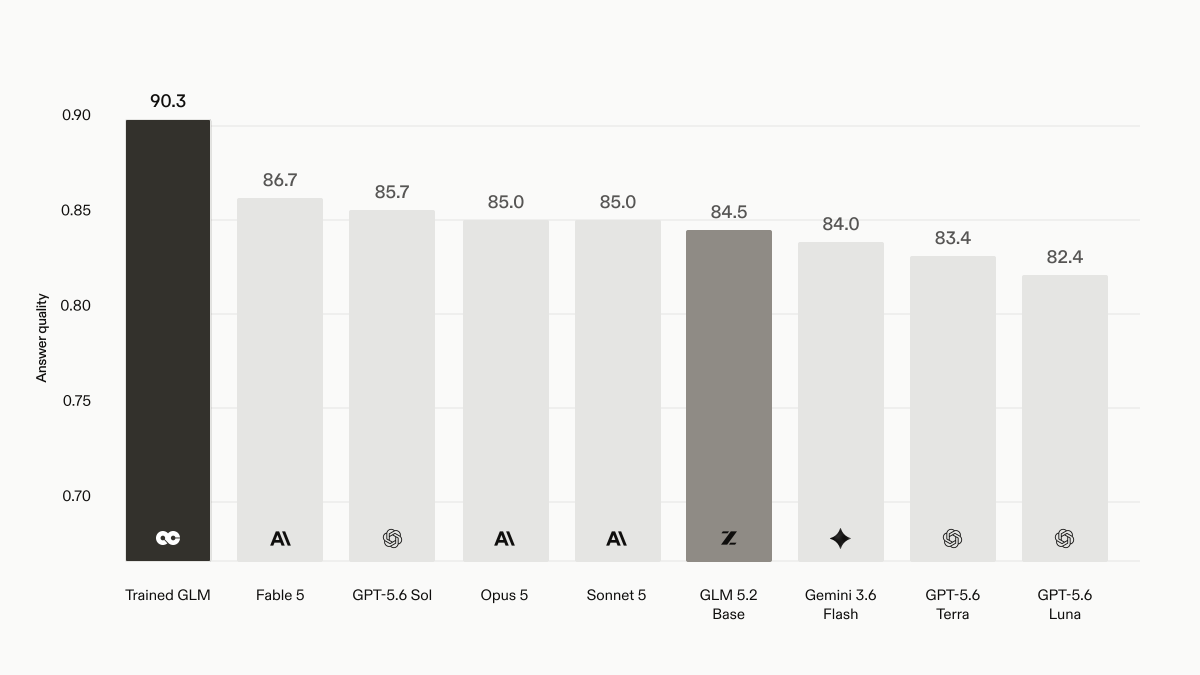
@harvey 展示(43 个赞、1 条回复、11,562 次浏览)展示了另一种构建模式:与其购买更多通用模型容量,不如围绕最昂贵的内部工作流,对模型和 harness 进行调优。截图把这件事讲得很具体:从覆盖多份合同的审查表 UI,到数据集构建流水线,再到基准测试;Harvey 训练的 GLM-5.2 变体在成本/质量曲线上处于更便宜的位置,同时分数高于多个前沿基线。


第二种反复出现的构建模式,是技能表面爆炸之后再做编排清理。@DanKornas 描述(7 个赞、2 条回复、1,222 次浏览)把 AgentSkillOS 描述为一个能够在庞大技能池中进行检索和 DAG 协调的系统;而 @gippp69 售卖(93 个赞、33 条回复、3,348 次浏览)则介绍了一个为 Claude Code 人工策展的专家 subagent 套件。两者的构建目标其实相同:别让协调器淹没在一张扁平的能力清单里。
最后,@fourjjjjt 回顾总结(24 个赞、5 条回复、282 次浏览)介绍了 three.ws,这是一个开源 3D 智能体技术栈,支持 avatar、记忆、自主支付和链上身份;其公开网站还补充了 WebXR 放置、MCP 工具接线、A2A 发现,以及按聊天计费的 USDC 收费。它与 uAgents 一起,标记出了一支正在远离纯代码 copilot、转向网络、身份和终端用户智能体界面的构建力量。
6. 新动向与值得关注的内容
能感知纠正的语音智能体
@TONGYI_SpeechAI 展示(50 个赞、2 条回复、1,728 次浏览)提出了“agentic ASR”的框架:语音识别不再是一次性扔出一份转录,而是一个交互式纠正闭环。关键回复还补充了 S²ER——一项检查核心意图和实体是否保留下来的指标,这标志着一个值得注意的变化:不再把词错误率当成唯一目标。
领域后训练在经济性上优于通用前沿方案
@harvey 报道(43 个赞、1 条回复、11,562 次浏览)表示,一个面向 Review Tables 做过后训练的 GLM-5.2 变体提升了答案和引文质量,同时相较 Sonnet 5 将成本降低了一半以上,相较领先的前沿模型则降至约十分之一。这一点之所以值得关注,是因为它把 harness 和任务分布视为可训练的资产,而不仅仅是模型选型问题。
面向科学智能体的委派感知训练
@ShashwatGoel7 强调(1 个赞、32 次浏览)介绍了 Faraday 如何为一个 27B AI scientist 使用自动评审器和 turn-level credit assignment;附图显示,“delegate to coder”获得了最高的平均每 token credit weight。即便互动量不高,这仍是少数明确展示如何把智能体训练成显式重视委派决策的内容之一。
7. 机会在哪里
[+++] Verification and evidence gates for autonomous coding work — @itamar_mar 展示(2 个赞、250 次浏览)展示了智能体是多么容易夸口“端到端已验证”;@hanakoxbt 拆分(59 个赞、3 条回复、4,381 次浏览)则强调应将测试与评审分开;@marfinxx 补充(27 个赞、8 条回复、1,400 次浏览)提出了不可篡改的治理轨迹。共同需求是:在合并或部署之前,加入能够质疑智能体声明的独立审查层。
[++] Skill retrieval, reduction, and orchestration layers — @DanKornas 描述(7 个赞、2 条回复、1,222 次浏览)讨论了如何把众多技能变成一条流水线;@gippp69 展示(23 个赞、9 条回复、231 次浏览)说明了为什么在强模型读取任何内容之前,归约器都很重要;而 awesome-claude-code-subagents 仓库则展示了专家目录扩张的速度。机会不在于再做一个技能库,而在于做那一层:负责选择、压缩、路由并验证这些技能。
[+] Collaborator-first domain agents — @voooooogel 提出观点(174 个赞、23 条回复、7,369 次浏览、71 次收藏)呼吁的是面向数学等领域专家、而非取代专家的工具体验;@TONGYI_SpeechAI 演示(50 个赞、2 条回复、1,728 次浏览)展示了能感知纠正的语音智能体;@harvey 证明(43 个赞、1 条回复、11,562 次浏览)则说明,领域调优可以重塑专用工作流的经济性。机会在于构建那些能让专家按照自己的原生流程去引导、纠正并信任工作成果的系统。
8. 要点总结
- 智能体讨论如今主要围绕系统设计,而不是提示词小技巧。 Andrew Ng 的技能地图、Nicolas Bustamante 的技术栈配方和 Learn Harness Engineering,都把重点放在记忆、上下文、权限、评估和仓库控制上,而不是单纯讨论提示词措辞。(来源)
- DeepSeek Harness 让插件化运行时继续处于市场中心,但真正的争论在于可观测性。 Akshay Pachaar 强调了仅追加、模型可见的日志,而回复很快把讨论推进到了提示词缓存和仅在运行时显现的行为上。(来源)
- 多智能体系统正在被归约器、验证器和角色边界重新约束。 今天最有力的案例使用了规划器、专家 worker、评审器、DAG 和上下文压缩,而不是简单增加智能体数量。(来源)
- 最清晰的价值,正在领域专用 harness 中显现。 TONGYI 的可纠正 ASR 和 Harvey 的审查表模型都说明了同一点:一旦工作流足够具体,智能体设计和调优就能同时改善质量与经济性。(来源)