Twitter AI Agent - 2026-08-15
1. 人们在讨论什么
1.1 Harness 与图工程取代了模型选型(🡕)
至少有八条入选内容认为,如今代理的质量更多取决于运行时设计,而不是挑选某个前沿模型。大家的共同词汇也不再只是“把提示词写得更好”,而是插件契约、爆炸半径、保留推理、上下文压缩、图结构、故障恢复,以及验证器该放在哪里。相比 8 月 14 日的地图和课程,8 月 15 日又往下深入了一层,开始讨论 harness 到底可以触碰什么,以及它出错时该如何恢复等机制问题。
@zhengyaojiang 认为(164 个赞、8 条回复、12,932 次浏览、91 个书签)认为,Cordis 为 DeepSeek Harness 提供了一种在理论上更干净的组件增删方式,但也提醒说,LLM 的上下文窗口会制造隐性依赖,使这些契约在实践中更难满足。引用的 DeepSeek Harness 发布 和公开的 代码仓库 也从构建者角度强化了同一点:模型、工具、技能、会话、循环、编排和 UI 都应是可替换的插件,而不是固定写死的内部部件。
@starmexxx 认为(47 个赞、13 条回复、8,221 次浏览、87 个书签)认为,每月收费 200 美元的编码代理之间,真正的差异化因素不是模型 IQ,而是决定代理能接触什么的 harness 层。这个论点异常具体:按爆炸半径给工具评分,把不可逆操作放在审批之后,为写操作提供沙箱,限制 token 消耗和实际运行时长,并将工具调用日志放在对话记录之外,因为“代理声称自己做了什么”和它实际做了什么并不是一回事。
@daniel_mac8 表示 指出(20 个赞、5 条回复、3,234 次浏览、14 个书签),同一个模型在配上更好的 harness 后,完全可能变成一个显著更强的代理,并援引 OpenAI 的说法称,保留推理加上压缩机制,使 GPT-5.6 Sol 在 ARC-AGI-3 上的成绩从 13.3% 提升到 38.3%。这是这组内容里最清晰的实证证据,表明模型能力与代理能力如今已被视为两个不同的优化目标。
@gippp69 流传 分享了一份“构建可靠代理系统”检查清单(15 个赞、3 条回复、110 次浏览、11 个书签),把新的控制平面明确列了出来:循环停止条件、工具与上下文、记忆与恢复、状态与权限,以及验证。

讨论洞察: 最好的回复并不是在要求一个更聪明的模型,而是在追问如何让日志与叙述分离、如何在不把代理彻底锁死的前提下限制权限,以及这整个方向是否更像操作系统研究,而不是提示词技巧。
与前一天相比: 8 月 14 日让 harness 工程变得可教;8 月 15 日则通过聚焦契约、爆炸半径、压缩和图结构,让它开始走向可操作。
1.2 对于复杂代理工作,仓库和文件成了首选记忆载体(🡕)
第二组讨论把“权威记录”进一步下沉到 Git 仓库、Markdown 文件和明确版本化的技能中。最有力的例子并不来自纯软件团队,而是来自一些操盘者:他们把品牌语气、客户背景、SOP 和绩效历史都当作文件,让代理按需加载、更新和共享,而不是在每次聊天里反复重讲同一套上下文。
@fivosaresti 展示了(15 个赞、485 次浏览、16 个书签)展示了一套分层的“LinkedIn 内容工程”栈:模板和品牌指南存放在 Notion 与 GitHub 中,Exa 和 Pinecone 负责研究层,五个代理角色覆盖从策略制定到打分的流程,人类则保留最终发布审批权。这张图的重要性在于,它展示的是从研究输入到内容日历、QA 和互动数据回收的完整闭环,而不是一个单代理演示。

@fivosaresti 介绍了(20 个赞、2 条回复、530 次浏览、18 个书签)展示了更激进的版本:一个 Company OS 仓库,里面有公司数据、客户背景、原始研究、插件、26 个代理、23 个命令和 79 个 Claude 技能;同时还有通过 MCP 和 CLI 连到 GitHub、Google Workspace、Airtable、Slack、InstantlyAI 等系统的客户专属仓库。值得注意的说法是,基于 PR 的治理机制和安全钩子如今会拦住 94+ 个高风险操作,因此这个仓库不只是存储层,更是协调界面。
@jordan_ross_8F 认为(13 个赞、957 次浏览、28 个书签)表示,“所有营销运营都会走向文件”,随后解释了为什么终端比聊天附件更适合长时运行的工作:终端可以只加载任务需要的两个文件,而聊天 UI 会在后台反复重读上下文,并随着对话拉长悄悄丢失早先的信息。附带的仓库截图把这个观点具体化了:一套新闻简报工作流就住在一个普通的 GitHub 目录树里。
@theparuchh 建议(17 个赞、4 条回复、97 次浏览、13 个书签)介绍了三项可安装的 Claude Code 技能,但最突出的是 claude-mem:一个项目记忆层,可避免用户每次会话都重新解释自己的技术栈。类似的诉求也出现在其他 repo-native 讨论里:一旦流程变成文件,真正持久的资产就是工作流,而不是聊天记录。
讨论洞察: 这组讨论里最有用的一条回复说,把语气指南和设计系统存进仓库,就能让它们变得可检查。更深一层的模式是:人们正在要求代理围绕那些可以 diff、可以审阅、也可以共享的工件来工作。
与前一天相比: 8 月 13 日和 14 日把技能当作可复用的封装;而 8 月 15 日展示的是,团队正把整个运营模型推入仓库、文件夹和版本化技能界面。
1.3 多代理系统变得更有边界、与模型解耦,也更贴近具体领域(🡕)
多代理讨论里最大的变化是克制。构建者更明确地讨论何时才该增加代理、每个代理应该接收哪些信息,以及哪些领域值得采用专门管线。最有力的帖子并不是为了 swarm 而 swarm,而是更关注 supervisor 模式、结构化摘要、跨模型委派和故障归因。
@reach_vb 宣布(117 个赞、11 条回复、5,089 次浏览、24 个书签)指出,multi-agents v2 现在可以把任务委派给任何受支持模型作为子代理;引用的发布帖称,这套机制已经可靠到可以与 Luna 一起运行,也能与更强的默认模型配合。随后的回复立刻开始索要工作流文档和 BYOK 指南,这是个很好的信号,说明用户如今期待委派层能与模型解耦,而不是锁死在某一家供应商上。
@monokern 认为(2 个赞、1 条回复、33 次浏览、1 个书签)认为,团队应从一个代理开始,只有在出现少数几个明确信号时才加第二个,比如注意力被摊薄、需要领域专精、存在天然并行性,或者错误成本很高。附带的论文页给出了这一组讨论中最重要的实现规则:代理接收的应该是结构化摘要和数据切片,而不是完整对话历史。

@biogerontology 分享了(11 个赞、716 次浏览、6 个书签)介绍了 MARC v1:一个开源的临床框架,用确定性的多代理编排、分离的角色、明确的上下文传递和分阶段故障归因,取代单体式提示。公开的 论文 和 代码仓库 进一步印证了更广泛的一点:受监管领域的构建者想要的是 YAML 定义的代理、可配置的管线,以及可解释的中间输出。
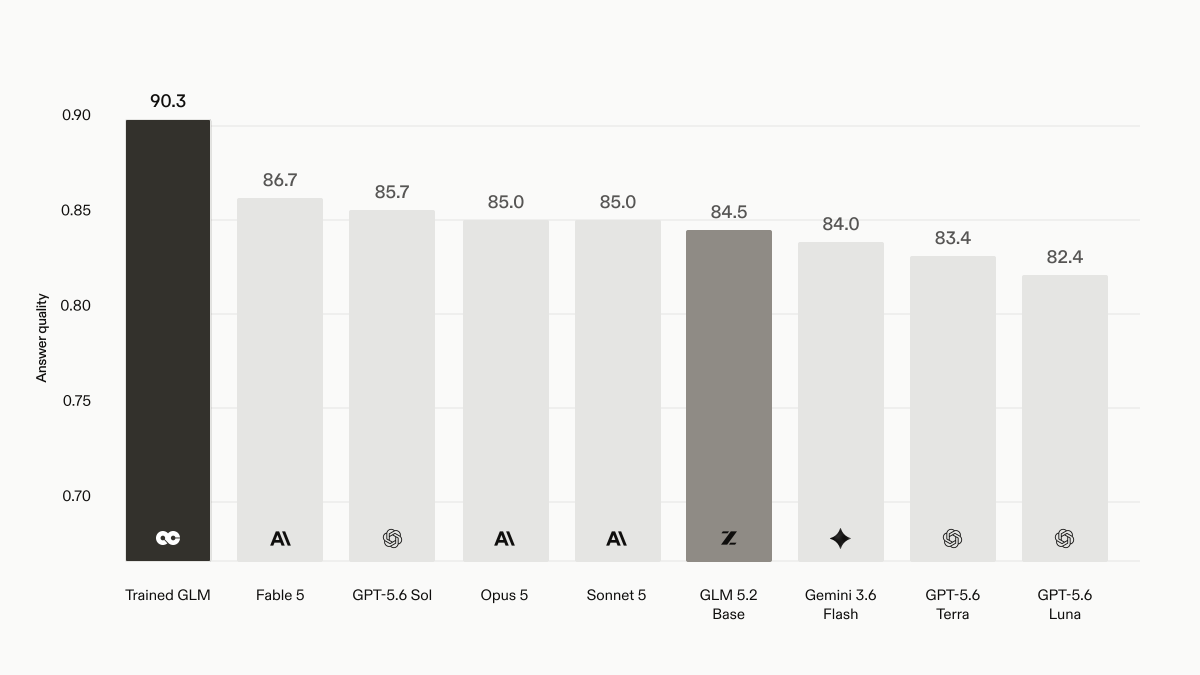
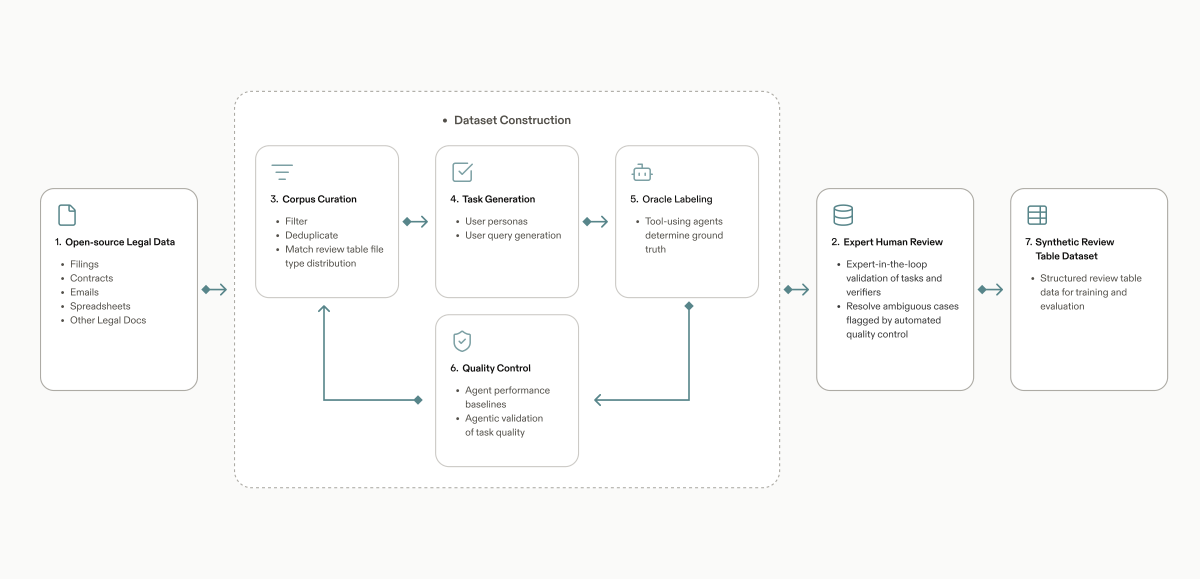
@harvey 报道(73 个赞、2 条回复、2 条引用、28,500 次浏览、60 个书签)展示了同样纪律在法律审查表格中的领域化版本。Harvey 表示,它先针对一个明确定义的工作负载对 GLM-5.2 做了后训练,再单独调优 harness,使 agentic-search 方案在答案质量上与单轮 RAG 持平,同时把输入 token 降低 50%,输出 token 降低 29%。
讨论洞察: 一条贯穿始终的主线是,多代理系统现在需要明确规则来规定谁在何时能看到什么、何时专门化值得付出额外开销,以及 supervisor 应如何验证结果,而不是相信一份对话记录就够了。
与前一天相比: 8 月 14 日已经把重点放在规划器、归约器和验证器上;8 月 15 日则更具体地说明了何时该加代理、如何在它们之间传递上下文,以及领域专用管线在什么地方优于通用栈。
2. 人们感到沮丧的地方
一旦代理能够写入、部署或通过 SSH 操作,权限面仍然过宽
最尖锐的不满并不是文本输出差,而是代理一旦接入真实工具,错误就会变成运维事故。@starmexxx 认为(47 个赞、13 条回复、8,221 次浏览、87 个书签)提到,一次使用 41 个 MCP 工具、且没有沙箱的仓库清理,最终扩大成涉及 423 个包的爆炸半径;随后它给出了人们真正想要的应对模式:不可逆操作先审批,写操作走临时目录,限制 token 和墙钟时间消耗,并保留模型无法改写的日志。@prathamgrv 总结道(118 个赞、5 条回复、2,494 次浏览、20 个书签)则把这归结为同一个设计问题:模型能看到哪些上下文、失败如何反馈、以及它能在不损害用户体验的情况下自主做到什么;@makatack_ 的一条回复把这种权衡说得很直白:对 harness 约束过严,它就会卡住;约束不足,它就会清空你的 DB。@DanKornas 分享了(2 个赞、3 条回复、384 次浏览)之所以做 MCP SSH Manager,正是因为远程服务器操作现在需要只读模式、受限模式和审计日志。严重程度:高。值得构建:高。
当太多内容都塞进聊天历史时,上下文和记忆仍会悄悄衰减
第二类不满是静默退化,而不是显性失败。@jordan_ross_8F 认为(13 个赞、957 次浏览、28 个书签)指出,把六个文件挂到聊天里,意味着模型每一条消息都要重读这六个文件,直到上下文窗口悄悄丢掉更早的信息;而重检索型系统即便底层文件没变,也可能出现“周二还很好用,周四就没用了”的体验。@theparuchh 建议(17 个赞、4 条回复、97 次浏览、13 个书签)把 claude-mem 视为缓解这种痛点的最快办法;@BimbaCrypto 的一条回复则说,真正的收益在于 这样到第四次会话时,就不用再一轮轮重新解释你自己的技术栈了。同样的问题也出现在一个讨论量不大但很有价值的 Picobot 线程中:@tom_doerr 分享了(7 个赞、2 条回复、1,972 次浏览)介绍了一个单二进制、自托管代理,而一条回复提醒说,一旦持久记忆和工具调用都放进同一个进程里,过时的记忆会让错误的工具看起来像是正确的。严重程度:高。值得构建:高。
如果摘要、supervisor 和指标不够明确,多代理系统仍会失控蔓延
第三类不满是不必要的编排开销。@monokern 认为(2 个赞、1 条回复、33 次浏览、1 个书签)认为,大多数团队都应从一个代理起步,只有当任务结构明确要求拆分时才增加代理,因为如果每个 worker 都拿到完整历史而不是结构化摘要和数据切片,上下文保护就会失效。@reach_vb 宣布(117 个赞、11 条回复、5,089 次浏览、24 个书签)介绍了 multi-agents v2 中与模型无关的子代理,但最初几条回复已经在索要工作流指引和 BYOK 规则,这表明真正的瓶颈是编排纪律,而不是模型可用性。在受监管领域,应对方式更严格:@biogerontology 分享了(11 个赞、716 次浏览、6 个书签)之所以做 MARC v1,正是因为它提供了分离的角色、明确的上下文传递和分阶段故障归因,而不是一次不透明的长链运行。人们目前的应对方式包括增加 supervisor 模式、机械式验证、回滚循环,以及更小、更贴合任务的代理图。严重程度:中高。值得构建:高。
3. 人们希望出现什么
能跨会话保存、又保持可检查的上下文选择型记忆
最明确、最直接的需求,是一种既能让工作持续存在,又不迫使模型在每一轮都拖着完整对话记录前进的记忆层。@jordan_ross_8F 认为(13 个赞、957 次浏览、28 个书签)认为,终端之所以占优,是因为它可以只加载任务真正需要的两个文件,其他内容仍留在磁盘上;他还明确把文件夹视为一种临时过渡,直到产品在上下文管理上做得好得多。@theparuchh 建议(17 个赞、4 条回复、97 次浏览、13 个书签)出于同样原因推荐 claude-mem:它能避免用户在每次会话中反复解释架构、偏好和决策。@fivosaresti 展示了(20 个赞、2 条回复、530 次浏览、18 个书签)则展示了这种做法在实践中的完整版:公司和客户上下文住在仓库里,而不是聊天里。这是一个直接需求,因为大家已经有了各种权宜之计;他们真正想要的,只是让记忆层把这些权宜之计变得不再必要。机会:直接。
不把工作流锁死在单一栈上的可移植技能和跨模型子代理
人们还想要能跨工具、跨模型迁移的技能与委派层。@reach_vb 宣布(117 个赞、11 条回复、5,089 次浏览、24 个书签)介绍了 multi-agents v2 中与模型无关的子代理,立刻引发了对文档和 BYOK 支持的请求。@myfear 报道(9 个赞、779 次浏览、8 个书签)表示,在翻看了 技能 上的 1,800 条条目后,热门列表里大多并不是编码技能,而是办公自动化、内容、营销以及围绕个人偏好塑形的工作流;这强烈说明,内部市场需要支持多种类型的可复用行为。@DanKornas 分享了(6 个赞、2 条回复、732 次浏览)介绍了 Autoresearch,这是一项可安装到 Claude Code、OpenCode 和 Codex 上的技能,把同样的可移植性理念从任务执行扩展到了改进循环。这条赛道很实用,但也已经开始拥挤:市场上已有跨模型委派、可安装技能和跨 CLI 的循环包,但还没有一种默认方式,能让它们既由本地持有,又保持一致。机会:竞争型。
能调用真实工具、又持续赢得信任的持久化操作界面
第三个需求,是那种既能登录、执行操作、并在用户离开后继续运行,又不会变成不透明风险面的代理产品。@aakashgupta 认为(2 个赞、2 条回复、1,415 次浏览、2 个书签)认为,Grok Bot 的真正优势不在产品质量,而在于它进入了 Cursor Ultra 那批已经付费、也已经愿意信任这类产品的用户群,因为这些用户已经跨过了允许代理接触自己工具的冷启动门槛。@DanKornas 分享了(2 个赞、3 条回复、384 次浏览)则把 MCP SSH Manager 视为服务器运维版的同一梦想,只不过加上了命名主机、受限模式和审计日志等护栏。@starmexxx 认为(47 个赞、13 条回复、8,221 次浏览、87 个书签)呼吁提供待审批门和写入沙箱,因为在现实里,信任仍然要靠一道一道权限边界慢慢赢得。这是个紧迫的产品需求,但围绕持久性、信任和工具覆盖范围,已经有多种路径在竞争。机会:竞争型。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| DeepSeek Harness | 代理 harness / 运行时 | (+/-) | 万物皆插件的设计;模型、工具、会话、循环和 UI 都可替换;围绕 Cordis 契约已有较强的公开关注 | 仍处于开发者预览阶段;一旦 LLM 上下文制造出隐性依赖,原本干净的模块化契约就会变得复杂 |
| n8n | 工作流自动化 / 代理构建器 | (+/-) | 可视化多步骤代理构建器;1,500+ 集成;人工审批与可观测性适合真实工作流自动化 | 连接器覆盖面越广,爆炸半径越大;故障处理仍需有意识地配置 |
| Practical Loop Engineering | 方法 / 运行时分类法 | (+) | 清晰区分基于轮次、基于目标、基于时间和主动触发的循环;让人的判断保持明确 | 它只是一个框架工具,本身并不提供记忆、权限或验证层 |
| claude-mem + skills ecosystem | 记忆技能 / 技能市场 | (+/-) | 减少反复解释项目;支持快速发现技能和进行预发布安全检查 | 本地指令的归属、时效性和质量控制仍然需要人工处理 |
| MARC v1 | 多代理框架 | (+) | 确定性阶段、明确的上下文传递、YAML 定义的代理、本地或 API 后端,以及分阶段故障归因 | 项目仍很早期;面向临床塑形的工作流和配置开销限制了短期的通用适用性 |
| Picobot | 自托管代理运行时 | (+) | 单个约 9MB 的二进制文件;低 RAM 占用;持久记忆;工具调用;Telegram/Discord 集成 | 把记忆和工具调用放进同一进程,可能让陈旧上下文导致的失败更难察觉 |
| MCP SSH Manager | 远程运维 / MCP 服务器 | (+/-) | 37 个基于 SSH 的工具;只读与受限模式;命名服务器管理;可选审计日志 | 仍然暴露高风险的远程操作;安全性取决于主机与作用范围配置是否足够谨慎 |
| Autoresearch Anywhere | 改进循环 / 技能 | (+) | 有边界、由指标驱动的迭代;出现回归可回滚;可用于 Claude Code、OpenCode 和 Codex | 只有在团队已经具备可衡量的验证步骤和清晰的 git 工作流时才真正划算 |
| Harvey custom GLM-5.2 + agentic search | 领域模型 / 法律 harness | (+) | 在明确定义的法律工作负载上,以更低成本提升答案与引文质量;harness 调优也显著降低了 token 使用量 | 高度专门化;要复现效果,离不开领域数据、后训练和人工法律审查 |
总体来看,满意度主要集中在那些能缩小作用范围、把状态保存在聊天记录之外,并把验证机制显式化的系统上。正面案例要么让控制平面变得可见(DeepSeek Harness、MARC、MCP SSH Manager、Autoresearch),要么通过文件、技能和外部记忆让工作流具备持久性(claude-mem、Company OS、repo-native 代理机构方案)。迁移压力同时朝三个方向显现:从只做提示词转向 harness 工程,从扁平聊天上下文转向仓库与文件支撑的记忆,以及从单一供应商的代理栈转向可移植技能加与模型解耦的委派。主要抱怨也高度一致:静默式上下文衰减太多、权限面太宽,以及太多“多代理”系统仍缺乏明确的摘要、回滚或 supervisor 逻辑。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| DeepSeek Harness | DeepSeek AI | 插件化代理 harness,模型、工具、会话、循环、沙箱和 UI 均可替换 | 团队希望在不 fork 整个运行时的前提下调整控制平面 | TypeScript、Cordis、插件架构、Web UI | Beta | 代码仓库, 网站 |
| Harvey Review Tables custom model | @harvey | 后训练的法律审查表格模型,加上一套 agentic-search harness | 审查表格工作负载可能产生数百万次模型调用,用通用前沿模型成本过高 | GLM-5.2、Applied Compute AC2、合成法律数据、agentic search、人工法律审查 | Shipped | 帖子, 公司 |
| MARC v1 | Penn-RAIL | 具有明确上下文传递和可追踪阶段的确定性临床多代理管线 | 单体式临床提示会掩盖提取、推理或答案生成到底在哪一步失败 | Python、YAML、Gemini/Ollama、Chroma、提示模板、decomposer | Alpha | 代码仓库, 论文 |
| Picobot | louisho5 | 可由单个二进制文件运行的轻量自托管代理 | 典型代理栈对廉价 VPS、小型服务器或个人常驻部署来说过于笨重 | Go、OpenAI 兼容 API、Docker、Telegram/Discord、持久记忆 | Beta | 代码仓库 |
| MCP SSH Manager | bvisible | 用于操作多个 SSH 主机、带命名工具和护栏的 MCP 服务器 | 团队希望实现远程自动化,但不想让代理拥有不受限制的 shell 权限 | JavaScript、MCP、SSH、TOML/.env 配置、审计日志 | Shipped | 代码仓库, npm |
| Autoresearch Anywhere | rahulthakore16 | 跨 CLI 的技能,用于有边界、由指标驱动的改进循环 | 构建者需要一种可重复的方法,让代理改进代码,而不是陷入含糊的“再试一次”循环 | Shell、安装脚本、技能文件、git、测试/基准 | Beta | 代码仓库 |
| Company OS / AI-Native Services stack | @fivosaresti | 面向代理机构、以仓库为原生载体的操作系统,包含客户仓库、技能、MCP 和人工发布审批 | 纯提示词工作流既留不住品牌和流程上下文,也难以在多个客户或团队成员之间扩展 | GitHub、Notion、Exa、Pinecone、Claude、MCP/CLI、Airtable、Slack、InstantlyAI | Shipped | 帖子, 帖子 |
当天最具体的公开构建案例来自 @harvey 报道(73 个赞、2 条回复、2 条引用、28,500 次浏览、60 个书签):一个经过领域调优的法律审查表格系统,其中 7 月单笔最大查询成本达到 26,000 美元,而完整工作负载最高可达 500 万次模型查询。Harvey 表示,相比前沿基线,定制版 GLM-5.2 将答案质量提升了 4%-17%,引文质量提升了 11%-19%;与此同时,配套的 agentic-search harness 在答案质量上与单轮 RAG 持平,并将输入 token 降低 50%、输出 token 降低 29%。这很值得注意,因为它优化的目标并不是“通用 AI 代理性能”,而是某个昂贵、重复发生的专业工作流。


第二种反复出现的构建模式,是 repo-native 操作系统。@fivosaresti 介绍了(20 个赞、2 条回复、530 次浏览、18 个书签)把 Company OS 和客户仓库作为代理机构的共享记忆层;@jordan_ross_8F 认为(13 个赞、957 次浏览、28 个书签)则表示,品牌语气是一份 Markdown 文件,客户是一个文件夹,而技能是一套机器可以执行的 SOP。共同触发因素也很一致:聊天原生上下文太容易丢失,所以构建者正把流程迁移到文件中,以便按需加载、通过 PR 更新,并在不同的人和自动化流程之间复用。
第三种构建模式,是围绕现有终端和服务器做更小、更有边界的扩展,而不是一体化“超级代理”。@tom_doerr 分享了(7 个赞、2 条回复、1,972 次浏览)介绍了 Picobot,这是一款面向廉价基础设施和渠道集成的单二进制代理;@DanKornas 分享了(2 个赞、3 条回复、384 次浏览)介绍了用于受控远程操作的 MCP SSH Manager;分享了(6 个赞、2 条回复、732 次浏览)介绍了以回滚优先为核心的 Autoresearch 改进循环。这些项目都比 DeepSeek Harness 更窄,但这种取舍是有意的:更小的表面更容易获得信任、更容易衡量,也更容易纳入明确策略之下。


整个部分中反复出现的构建触发因素非常清晰:高吞吐专业工作流里的成本失控、聊天记录无法保存持久流程,以及工具表面在缺乏显式权限控制时风险过高。人们并没有都在做同一种东西,但他们正收敛到相同的架构动作上:把状态外置、限制行动表面,并一次只为一个工作流优化 harness。
6. 新消息与值得关注的内容
代理分发正在成为产品护城河
@aakashgupta 认为(2 个赞、2 条回复、1,415 次浏览、2 个书签)指出,Grok Bot 真正的发布优势,不是它在产品质量上击败了所有对手,而是它直接进入了 Cursor Ultra 那批已经付费、也已经愿意信任它的用户群。这一点很重要,因为它重新定义了持久化代理的采用难题:让用户愿意把工具和工作流交给 bot,可能比把 bot 本身做出来还难。
受监管领域中的确定性多代理设计
@biogerontology 分享了(11 个赞、716 次浏览、6 个书签)介绍了 MARC v1,这是一个开源临床框架,具备明确的上下文传递和分阶段故障归因;公开的 论文 加上 代码仓库 进一步确认了 YAML 定义的代理、Gemini/Ollama 后端,以及一个能够根据自然语言任务描述生成管线的 decomposer。即使互动量不高,它仍是最清晰的信号之一,说明领域专家如今想要的是可解释的多代理系统,而不是黑箱式提示。
机械化自我改进被做成了可安装技能
@DanKornas 分享了(6 个赞、2 条回复、732 次浏览)介绍了 Autoresearch,这是一项可复用于 Claude Code、OpenCode 和 Codex 的技能。公开的 代码仓库 之所以重要,是因为它把一种具体的代理纪律打包成了一个可安装循环:建立基线、只做一次改动、验证、保留或回滚,然后在边界内重复。
7. 机会在哪里
[+++] Repo-native memory and workflow operating systems for non-engineering teams — @fivosaresti 展示了(20 个赞、2 条回复、530 次浏览、18 个书签)介绍了把 Company OS 和客户仓库作为代理机构持久上下文层的做法;@jordan_ross_8F 认为(13 个赞、957 次浏览、28 个书签)指出,品牌语气、客户和技能都应该是文件;@theparuchh 建议(17 个赞、4 条回复、97 次浏览、13 个书签)则强调需要记忆层和技能层,因为聊天原生上下文一直在衰减。这一机会很强,因为替代方案已经很清楚,痛点不断重复出现,而且这种模式已经从软件团队扩展到了营销和服务业。
[++] Permission, audit, and recovery layers for agents with real-world reach — @starmexxx 认为(47 个赞、13 条回复、8,221 次浏览、87 个书签)呼吁提供爆炸半径评分、审批门和写入沙箱;@DanKornas 分享了(2 个赞、3 条回复、384 次浏览)介绍了一个带护栏的 MCP SSH 层;@aakashgupta 认为(2 个赞、2 条回复、1,415 次浏览、2 个书签)则指出,只有当用户已经愿意信任持久化 bot 去接触工具时,这类产品才真正成立。这个机会属中等,因为很多构建者现在已经理解了问题,但现有护栏层仍按工具类型和工作流零散分布。
[+] Model-agnostic delegation and bounded improvement primitives — @reach_vb 宣布(117 个赞、11 条回复、5,089 次浏览、24 个书签)介绍了跨模型子代理;@monokern 认为(2 个赞、1 条回复、33 次浏览、1 个书签)主张只有在六种明确信号下才增加代理;@DanKornas 分享了(6 个赞、2 条回复、732 次浏览)介绍了以回滚为先的 autoresearch 循环。这还处于兴起期,而不是成熟期:需求已可见,但用户仍在索要工作流、文档和默认的 supervisor 模式。
8. 要点
- 今天,绝大多数变化都发生在模型外围的运行时。 无论是 Cordis/DeepSeek 讨论、爆炸半径线程,还是 OpenAI 关于保留推理的案例,都把 harness 设计当作一等优化面,而不是模型外围的附属物。(来源)
- 在传统软件团队之外,文件和仓库正成为代理工作的持久记忆层。 Fivos Aresti 的 Company OS 和 Jordan Ross 的 repo-native 代理机构工作流,都利用 Git 支撑的工件,让品牌、流程和客户上下文保持可检查、可复用。(来源)
- 多代理系统正在被收紧边界,而不只是继续扩张。 今天最有用的建议是:只有在明确条件下才增加代理,传递摘要而非完整历史,并保留分阶段故障归因。(来源)
- 最清晰的经济收益,来自按领域塑形的 harness 和工作负载。 Harvey 的审查表格系统最有说服力,因为它把定制模型训练和 harness 调整,直接与某个明确法律工作流中的答案质量、引文质量和成本改善挂上了钩。(来源)
- 持久化代理如今面临的,不只是能力测试,也是信任与分发测试。 无论是 Grok Bot 关于装机用户基础的论点,还是 MCP SSH Manager 的受控远程运维界面,都指向同一个市场现实:只有当引导流程和控制边界本身已经讲得通,用户才会交出真实的工具访问权限。(来源)