Twitter AI Agent - 2026-08-21
1. 大家在讨论什么
1.1 Agent 工程被视为一种操作规范,而非提示词技巧(🡕)
最集中的一组讨论把 Agent 工作视为系统工程问题,强调需要对评测、状态、token 预算和安全边界进行明确控制。至少有 7 条入选内容从不同角度表达了同样的转向:Andrew Ng 的技能图谱、以 harness 为先的系统设计讨论串、token 预算工具、状态机模式、对 PR 审查的质疑,以及凭据边界检查清单。相比 8 月 20 日对打包化 harness 和可复用流程的关注,8 月 21 日又向下深入了一层,转向这些系统如何被度量、审查,以及如何防止逐步漂移。
@AndrewYNg 分享了(2,918 个赞、65 条回复、158,540 次浏览、4,914 次收藏)发布了一份关于构建和部署 AI 应用的技能图谱,而回复把其中真正有意思的部分说得比标题更具体。一条详细回复指出,只看结果的评测无法判断 Agent 是检索到了正确上下文,还是只是碰巧猜对,并明确提出:在评测设计与可观测性之间,还缺少“阅读 trace”这项技能。这让一篇宽泛的教育类帖子,变成了一个信号:从业者如今开始把 Agent 运作描述为一组可审查的技能栈,而不再只是“提示词工程”。
@kmeanskaran 认为(92 个赞、4 条回复、5,286 次浏览、127 次收藏)认为,harness 设计、LLMOps、循环工程和评测比模型本身更重要,随后又描述了一个端到端 harness 概念验证,覆盖提示词、工具、上下文工程、记忆、缓存和部署。回复也认同这些关键组成部分,尤其是循环工程和评测,因此这与其说是个人观点,不如说是对当天共识的一份紧凑总结。
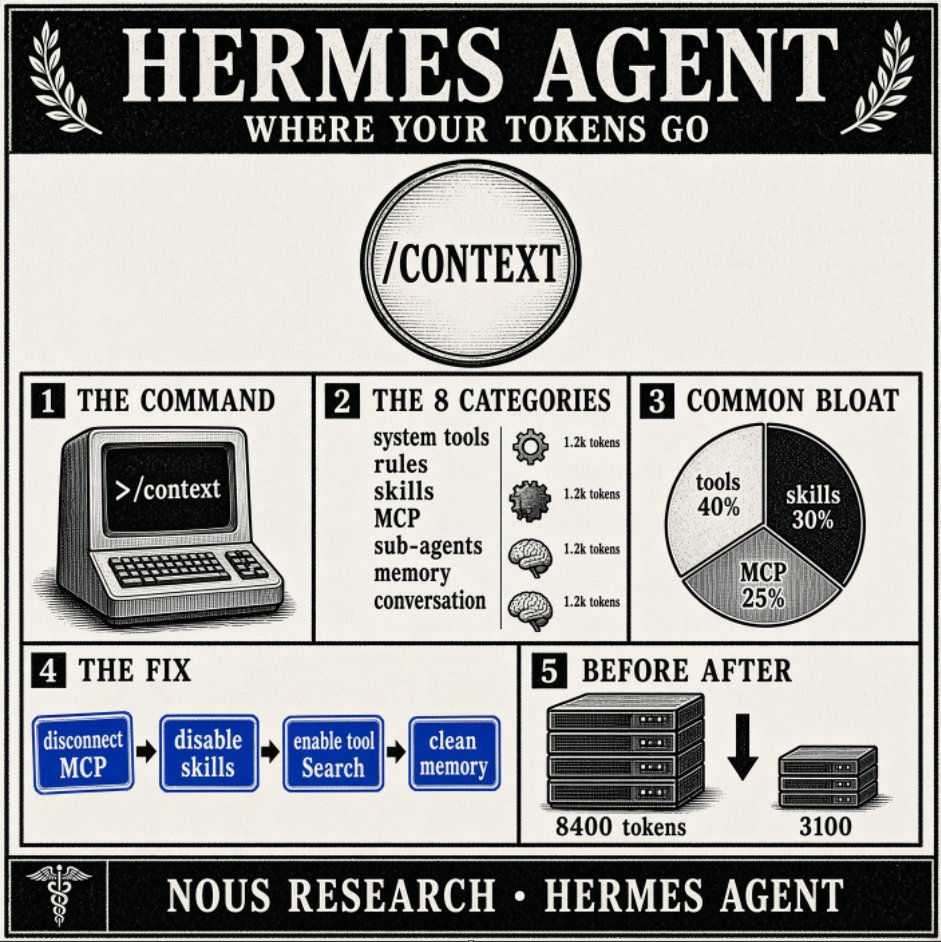
@IBuzovskyi 展示了(16 个赞、4 条回复、876 次浏览、21 次收藏)分享了一条用于 Hermes Agent 的 /context 命令,将会话开销拆分为系统工具、规则、技能、MCP、子 Agent、记忆和对话。配套说明格外具体:它称常见的膨胀主要来自工具(40%)、技能(30%)和 MCP schema(25%),并展示了一个前后对比案例:通过断开未使用的 MCP 服务器、禁用未使用的技能、启用按需工具搜索和清理记忆,将固定 token 从 8,400 降至 3,100。
@AiCamila_ 提出了(6 个赞、162 次浏览、6 次收藏)展示了一个用于长时间运行 Agent 任务的显式状态机,图片也让它的价值一目了然:NEW、PLANNING、ACTING、WAITING、REVIEW、DONE 和 FAILED 通过守卫条件、重试路径和超时处理相互连接。这不是抽象的“Agent 编排”,而是在主张:进度、等待、返工和失败都应位于提示词之外,存在于一个可观测的任务生命周期中。

@nykdotdev 警告称(74 个赞、13 条回复、6,482 次浏览、52 次收藏)指出,“当密钥进入提示词时,监督就会失效”,随后提出了 Credential Boundary Card、强制撤销路径,以及一旦机密进入对话记录或 diff 就判定失败的规则。与此同时,@bybardiia 认为(133 个赞、90 条回复、6,279 次浏览)指出,在自动生成的 PR 上点击 Approve,并不能构成 Agent 安全方案。再结合那篇关于基于约束的监督的公开论文,这些帖子表明,关于信任的讨论正在远离“人工签字就算把关”的形式主义,转而关注可强制执行的运行边界。
讨论洞察: 最尖锐的回复并没有要求模型更聪明,而是要求更高质量的 trace、明确的审批责任人、撤销路径、重试语义,以及区分正确结果与侥幸答对的方法。
与前一天的比较: 8 月 20 日强调的是 harness、技能,以及托管式与自有式 Agent 技术栈;8 月 21 日则延续了对 harness 的关注,但进一步转向操作层面的机制:状态转换、token 计量、凭据边界,以及盲目审查的失败模式。
1.2 技能与上下文层成为封装 Agent 知识的首选方式(🡕)
第二组讨论把技能、插件和检索层视为 Agent 专业知识的新分发格式。共同模式是:把过去存在于文档、团队默会知识或临时提示词中的知识,转化为可安装、可路由、可跨工具复用的东西。至少有 8 条入选内容支持这一主题,涵盖技能编写工具包、大型跨领域技能包、从代码仓库生成提示词的工具、会话记忆 MCP 服务器,以及具备仓库感知能力的开发环境。
@DanKornas 介绍了(2 个赞、2 条回复、703 次浏览、4 次收藏)介绍了 Skill Forge:这是一个用于设计、构建、审查、演进、评估、基准测试和发布 Claude Code 技能的开源工具包。其公开仓库进一步把这一承诺扩展成一套完整工作流,包含 4 个复杂度等级,以及针对 /skill-forge plan、/build、/review 的明确命令,/evolve、/publish、/convert、/eval 和 /benchmark,这让“技能编写”看起来更像软件交付,而非提示词模板制作。

@jack_9947 分享了(4 个赞、2 条回复、105 次浏览)展示了一个面向营销的 Claude 技术栈公开架构:300 多条提示词、分布在 7 个仓库中的 400 多项技能、50 多个具名智能体、多步骤工作流,以及与 LinkedIn、销售和 Notion 连接的系统。尽管完整课程的访问需通过私信获取,但这张图片本身已是有力证据,表明团队如今正把部门运营知识打包成分层的智能体基础设施。

@tom_doerr 指出了(12 个赞、1,873 次浏览、20 次收藏)介绍了 DevOps 与 Security Agent Skills 仓库。该仓库公开宣称提供 160 多项可直接用于生产环境的技能,覆盖 DevOps、安全、基础设施、AI 工程和合规,适用于 Claude Code、Cursor、Codex 及其他能够读取文件的智能体。README 的关键在于,它并不是一份“精选列表”:它声称提供可复制粘贴的配置、自动化脚本、参考资料,以及在匹配到相关任务时可供智能体加载的深度运营指导。
@DanKornas 还重点提到了(4 个赞、2 条回复、700 次浏览、3 次收藏)介绍了 GitReverse——一款可将 GitHub 仓库转成单条合成提示词的公开应用。对应仓库清楚展示了其范围:提取仓库元数据、深度为 1 的文件树和 README,然后基于这些上下文生成一条简短提示词,同时支持多家提供商,并提供可分享的 /owner/repo 路由。
@tarunsachdeva 介绍了(6 个赞、1 条回复、100 次浏览)介绍了 Traces MCP——一台只读的会话记忆服务器,允许智能体通过 OAuth 搜索并读取更早的编码轨迹。文档将其定位说得很具体:发现与读取是分离的;支持 Claude Code、Codex CLI、Cursor、OpenCode 和 VS Code;其价值在于,无需把先前的决策、文件和理由重新粘贴回实时聊天,也能找回这些信息。
@SpotifyEng 报告称(26 个赞、1 条回复、1,182 次浏览、9 次收藏)称,Xirp 现已支持四种 harness,并且可以在项目进行中途切换而不丢失上下文。链接的产品页面进一步解释了更深层的问题:智能体交付代码的速度更快了,但如果不了解服务归属、依赖关系或架构,仍会做出在运营层面错误的决策。因此,Xirp 加上 Portal 被定位为面向仓库真实情况的检索层,而不是另一个聊天界面。更具体地说,@peterfriese 分享了(2 个赞、3 条回复、184 次浏览、3 次收藏)介绍了一个 SwiftUI skill pack,可通过可安装、按任务定制的指导来弥补 Liquid Glass 的盲点。讨论洞察: 当天最常见的做法,是让上下文支持按需加载。无论这个单元是技能、仓库提示词、追踪服务器,还是与所有权元数据绑定的上下文层,当天的构建者都在持续把经验和知识外置,好让代理能够重新进入这些上下文,而不是每次都从头学起。
与前一天的对比: 8 月 20 日展现了技能正成为一种新兴基础原语。8 月 21 日则展示了下一步:通过编写系统、可安装库、仓库锚定工具和记忆服务器,让这些原语能够在多个代理与环境之间迁移复用。
1.3 当代理接入领域专用的执行循环时,可信度更高(🡕)
第三个主题是:与其单纯把提示词变长,不如让代理拥有真实环境和可重复的循环;这样它们会显得更有说服力。相关例子来自基准推理、游戏开发和分子设计,但模式一致:检查环境、采取行动、读取反馈、维持状态,然后持续迭代。相比 8 月 20 日对托管式代理产品的泛泛讨论,8 月 21 日给出了更多领域层面的证据,说明这些循环实际是什么样。
@daniel_mac8 认为(90 个赞、16 条回复、4,831 次浏览、34 个收藏)称,NVIDIA 的 AVO 加上 Opus 5,把 ARC-AGI-3 公共数据集的表现从约 30% 推高到 100%;NVIDIA 的公开文章也支持其核心架构主张:持久化记忆、监督,以及“检查 → 规划 → 实现 → 评估 → 诊断/修复”的循环,与基础模型本身同样重要。附带的图示之所以关键,是因为它展示了这套 harness 如何让解法谱系、文档、代码和评估器反馈始终留在循环中,同时由监督器把停滞的轨迹重新导回正轨。

@ImmatureGamer 总结了(46 个赞、6 条回复、1,807 次浏览、18 个收藏)提到 Epic 那场时长很长的 MCP-in-UEFN 直播,并把实际转变说得很清楚:代理现在可以编写 Verse、完成编译、启动 Fortnite 会话、读取日志、推送修改,并在编辑器内迭代,而不再依赖手动复制粘贴。同一条讨论也点明了当前限制——还没有 Control Rig 工具集、无法生成 3D 网格,也不能跨项目迁移资产——因此它比单纯的发布宣告更有说服力。
@anindyadeeps 介绍了 把 LiteMol-1 介绍为一个多分子扩散语言模型(208 个赞、40 条回复、10,689 次浏览、61 个收藏),并明确将其定位为“面向代理的模型”。该帖文和 LiteFold 的公开材料称,重点不只是分子生成,而是为 AutoResearch 循环提供一个紧凑的序列空间接口,使其能够提出、检查、编辑、评分并重新生成候选,而不是反复对臃肿的结构文件进行推理。


讨论洞察: 值得注意的趋同之处在于,游戏工具、生物模型和基准测试 harness 都强调了同样的基础原语:环境访问、持久状态、验证反馈,以及一个可供代理低成本反复迭代的窄接口。
与前一天的对比: 8 月 20 日关注的是谁来托管代理、谁来拥有状态。8 月 21 日则进一步给出了更明确的证据,说明这些问题解决之后,代理实际会做什么:它们会在 UEFN 里编译并读取日志,会在监督下沿着基准测试轨迹循环推进,或通过序列优先的接口搜索分子空间。
2. 什么让人感到挫败
盲目批准与松散的凭据处理,仍然过不了信任这一关
最明确的挫败点在于,许多团队仍把审查看成人类按一下按钮,而不是一个受控的执行边界。@nykdotdev 表示(74 个赞、13 条回复、6,482 次浏览、52 个收藏)直白地指出了问题:一旦密钥进入提示词,监督其实就已经失效,因此工作流需要凭据边界、撤销路径,以及当秘密信息出现在对话记录或 diff 中时自动失败的机制。@bybardiia 制作了(133 个赞、90 条回复、6,279 次浏览)则从 PR 角度提出了同样的批评,认为点击 Approve 批准自动生成的 diff 并不是安全方案。@nykdotdev 也指向了这个方向 背后的公开论文也持相同立场,主张采用由机器强制执行的约束,而不是只靠提示词层面的监督。严重程度:高。值得投入构建:高。
代理会话仍在上下文膨胀上浪费太多金钱和质量
第二个挫败点来自经济和运维层面:人们以为自己碰到了模型极限,但很多时候,他们其实是在为自己制造的上下文杂乱买单。@IBuzovskyi 展示了(16 个赞、4 条回复、876 次浏览、21 次收藏)对 /context 做了一次拆解,指出未使用的工具、技能和 MCP schema 占据了大部分固定开销。@sairahul1 回应了(36 个赞、13 条回复、5,922 次浏览、64 次收藏)则采用了复杂的编排式权宜方案——用 Claude 做规划、Codex 做执行,再配合多个 GPT-5.6 档位来塑形成本——正是因为对整天长时间编码来说,单一模型加单一会话在经济性上已不再让人觉得稳定。该方案下的回复还补充了人们已经开始习得的应对行为:在同一聊天里反复复用会导致上下文腐坏,交接文件可能会保留错误状态,而所谓的“节省”也可能只是把支出转移到另一个计费表上。严重程度:高。值得构建:高。
当规划和工作流控制薄弱时,多智能体提速依然很脆弱
第三个令人沮丧的问题是,并行智能体既能放大吞吐,也同样容易放大错误。@mattpocockuk 测试了(27 个赞、7 条回复、1,705 次浏览、15 次收藏)发布了一项 /implement-spec 技能,把工作分发给子智能体,但随后又在回复中立刻指出,这种方式更慢,受限于编排器的上下文窗口,而且是用一个“总是更差”的智能体来取代确定性系统。@AiCamila_ 提出了(6 个赞、162 次浏览、6 次收藏)呼吁采用明确的任务状态,因为自由形式的循环会掩盖卡住的工作;与此同时,@SpotifyEng 将其定位为(26 个赞、1 条回复、1,182 次浏览、9 次收藏)则围绕 Xirp 表达了类似的痛点:当智能体不理解所有权和依赖关系时,就会做出技术上正确、但在操作层面错误的动作。潜台词是,提速执行并不难;真正难的依然是可靠协调。严重程度:高。值得构建:高。
3. 人们希望出现什么
无需重写、可跨智能体运行的可移植技能
最明确的需求,是让智能体的 know-how 以可安装工件的形式迁移,而不是在每个新工具里都重新抄一遍。@DanKornas 将其概括为(2 个赞、2 条回复、703 次浏览、4 次收藏)围绕这个确切问题打造了 Skill Forge,为技能作者提供规划、构建、审查、评估和发布工作流。@tom_doerr 指出(12 个赞、1,873 次浏览、20 次收藏)指向一个面向基础设施与安全工作的 160+ 技能库;@peterfriese 展示了(2 个赞、3 条回复、184 次浏览、3 次收藏)则在更小范围内,以 iOS 26 的 Liquid Glass 技能复用了同样的模式。这是一个直接需求:人们已经在构建技能层,但仍需要更好的打包、审查和跨智能体可移植性。机会:直接。
面向状态、成本与可审查性的默认控制平面
人们也希望智能体能暴露自己的操作界面,而不是把这些都藏在冗长的对话记录里。@IBuzovskyi 实际上是在追问(16 个赞、4 条回复、876 次浏览、21 次收藏)呼吁借助 /context 提供内置的成本可观测性。@AiCamila_ 问道(6 个赞、162 次浏览、6 次收藏)则呼吁提供明确的任务状态和合法的状态转换,以及 @nykdotdev 问道(74 个赞、13 条回复、6,482 次浏览、52 个收藏),强调凭据边界和撤销路径应由系统强制执行,而不是靠政策提醒来约束。这一需求既现实又紧迫,因为抱怨集中在成本、泄露和不可逆错误上,而不是表面的用户体验问题。机会:直接。
默认理解代码仓库、组织和既有工作的上下文层
第三个需求是让代理从有依据的上下文出发,而不是从空白会话加过时文档开始。@DanKornas 已解决(4 个赞、2 条回复、700 次浏览、3 个收藏)借助 GitReverse 实现代码仓库理解:它把仓库元数据、目录树和 README 综合成一条提示词。@tarunsachdeva 已扩展(6 个赞、1 条回复、100 次浏览)则通过 Traces MCP 将这一需求扩展到团队记忆;@SpotifyEng 已介绍(26 个赞、1 条回复、1,182 次浏览、9 个收藏)把 Xirp 作为一种在不同 harness 之间持续保留服务归属和依赖上下文的方式。之所以说这是一个竞争性机会,是因为多种方案已经在交付,但这一痛点依然持续存在,且定义明确。机会:竞争性。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| AVO | 代理 harness 架构 | (+) | 持久记忆、监督循环、执行反馈、长周期迭代 | 目前证据主要集中在公开的 ARC-AGI-3 成果上,而非广泛的日常部署 |
| pstack | 编码代理工作流插件 | (+) | 操作手册、专家技能、多模型审查、运行时验证、先给证据再宣告成功 | 最适合 Cursor;部分工作流组件很难原样迁移到该环境之外 |
| Skill Forge | 技能编写工具包 | (+) | 结构化的规划/构建/审查/评估/发布流程、多层级、跨平台转换 | 仍是面向技能作者的元工具,而非终端用户提升效率的捷径 |
| DevOps 与 Security Agent Skills | 技能库 | (+) | 160+ 个可安装技能、具体配置、广泛覆盖基础设施与安全场景 | 效果取决于是否选对技能,以及技能库是否保持更新 |
| GitReverse | 代码仓库 grounding 工具 | (+) | 将仓库元数据、文件树和 README 整合成一条可复用提示词 | 默认仍以整个仓库为范围;尚未支持按子文件夹进行 grounding |
| Traces MCP | 会话记忆检索 | (+) | 只读访问过往会话、支持 OAuth 配置、可跨多个编码代理使用 | 搜索/读取流程增加了额外依赖,并要求有 Traces 账户和相应的上下文边界 |
| Xirp + Portal | 代码仓库感知型开发环境 | (+/-) | 在不同 harness 之间持续保留归属、依赖和架构上下文 | 当前公开证据更强调问题界定,而不是扎实的使用指标 |
Hermes Agent /context |
Token/开销可观测性 | (+) | 让固定上下文成本可见,并给出明确的精简操作 | 绑定于单一代理技术栈;仍需用户手动根据发现采取行动 |
| Claude Code + Codex plugin 工作流 | 成本塑形编排方法 | (+/-) | 在不同模型和订阅之间拆分规划、评审和执行 | 配置复杂度高,而且有回复质疑其是否只是转移隐性成本,以及在交接中出现上下文衰减 |
| UEFN MCP | 领域专用代理运行时 | (+/-) | 让代理编写 Verse、编译、运行会话、检查日志,并在编辑器内迭代 | 仍处于 beta 阶段;不支持 Control Rig,不能生成 3D 网格,其他资产与工具链能力也存在缺口 |
| LiteMol-1 | 领域专用生成模型 | (+) | 为代理循环提供紧凑的序列空间接口,支持多种分子类别,并报告了有竞争力的结果 | 证据仍停留在研究阶段;实际价值取决于下游验证器和评分函数 |
整体满意度的光谱,从“把控制手段给我看”到“让上下文可迁移”不等。工具如果能把状态、证据或领域知识明确呈现出来,人们就更愿意接受;如果它承诺自主性,却缺乏有力的审查界面,人们就会持怀疑态度。常见的变通方式是叠加使用:代码仓库 grounding 加技能、技能加 Traces,或一个模型负责规划、另一个模型负责执行。迁移压力也已显现:用户正从单体式聊天,转向把检索、规划、验证和行动分开的工作流。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| LiteMol-1 | @anindyadeeps / LiteFold Research | 为代理参与的分子设计而设计的多分子扩散语言模型 | 为研究代理提供紧凑的序列空间接口,用于提出、编辑、评估和重新生成分子,而不必始终困在庞大的结构文件里 | 扩散语言模型、分子序列 Token、多目标搜索、代理循环 | Alpha | 研究页面, 推文 |
| DevOps & Security Agent Skills | BagelHole / @tom_doerr | 面向基础设施、安全、AI 工程和合规的大型可安装技能库 | 为编码代理提供可复用的专家级运维知识,而不是一次性提示词 | SKILL.md 格式、脚本、配置、参考资料、skills CLI | 已发布 | 代码仓库, 推文 |
| GitReverse | filiksyos / @DanKornas | 将公开的 GitHub 仓库转化为供编码代理使用的单一合成提示词 | 加快对仓库的理解以及对现有项目的逆向工程 | Next.js 16、React 19、TypeScript、Tailwind CSS 4、GitHub API | 已发布 | 代码仓库, 推文 |
| Traces MCP | Traces / @tarunsachdeva | 用于搜索和读取过往编码会话的托管 MCP 服务器 | 无需手动复制聊天记录,即可找回团队记忆和此前决策 | 托管 MCP、OAuth、只读追踪记录搜索/读取工具 | 已发布 | 文档, 推文 |
| fwc-swiftui-skills | FloWritesCode / @peterfriese | 面向现代 SwiftUI 任务的 Cursor 技能包,首先从 Liquid Glass 开始 | 弥补编码代理在新 iOS 26 UI API 方面的训练数据缺口 | Cursor skills、SKILL.md、Xcode iOS 26 SDK | 已发布 | 代码仓库, 推文 |
| pstack | Lauren Tan / poteto via Flavio Copes | 严谨的编码代理工作流插件,提供操作手册、评审面板和子代理 | 通过验证机制和面向特定角色的工作流,让代理在长时间运行时保持正轨 | Cursor 插件、工作流技能、工程原则、操作手册、子代理 | 已发布 | 指南, 推文 |
| UEFN MCP tooling | Epic / 在 Fortnite 中创作 | 让智能体能在 UEFN 中处理 Verse、设备、资源、日志和测试循环 | 将游戏开发中的智能体工作,从复制粘贴式辅助推进到真实的编辑器/运行时循环中 | MCP、UEFN、Verse、兼容 Claude Code/Cursor/Codex 的智能体 | 测试版 | 推文 |
最突出的构建模式是外部化。Skill Forge、DevOps & Security Agent Skills、fwc-swiftui-skills、pstack 和 GitReverse,都把原本存在于个人判断、部落式经验或聊天记录里的东西,转化为可复用的产物——技能、操作手册、具备事实锚点的提示词,或审查工作流。
第二个模式是特定领域上下文的显化。Xirp 把智能体接入服务拓扑和归属关系上下文,UEFN MCP 把它们接入真实的游戏开发运行时,LiteMol-1 则把它们接入紧凑的分子设计循环。各条目反复出现的触发条件其实相同:一旦任务涉及真实的环境状态和真实后果,构建者就不再要求一个更好的通用聊天机器人,而是开始围绕智能体构建一个更窄、更明确的操作界面。
6. 新动态与亮点
Harness 工程已走到台前,不再只是后端细节,而成了标题级话题
@daniel_mac8 变成了(90 个赞、16 条回复、4,831 次浏览、34 次收藏)把 NVIDIA 的 AVO 结果提炼成了一条清晰的市场信号:合适的 harness 可以让一个前沿模型在长周期基准测试中,从部分胜任提升到完成整个公开测试集。值得注意的不只是分数本身,更在于当天有多少其他帖子立刻复用了同一套表述——循环、图、监督、持久记忆和评估反馈——来讨论无关的系统。Harness 已不再是隐藏的实现细节,而是被当作产品表层来对待。(NVIDIA 博客)
技能正逐渐变成智能体能力的供应链
@DanKornas 展示了(2 个赞、2 条回复、703 次浏览、4 次收藏)、@tom_doerr 展示了(12 个赞、1,873 次浏览、20 次收藏)以及 @peterfriese 展示了(2 个赞、3 条回复、184 次浏览、3 次收藏),分别对应同一栈中的不同层:创作工具、大型跨领域库,以及狭窄的领域补丁。这一点值得注意,因为它把“技能”从一个营销名词,变成了一条具备创建、打包、安装和跨多个智能体复用能力的分发管线。
特定领域循环的公开展示正变得容易得多
@ImmatureGamer 做了(46 个赞、6 条回复、1,807 次浏览、18 次收藏)通过描述完整的“编写 → 编译 → 测试 → 读取日志”循环,让 UEFN MCP 变得易于理解;而 @anindyadeeps 做了(208 个赞、40 条回复、10,689 次浏览、61 次收藏)则对生物分子设计中的 LiteMol-1 做了同样的呈现。值得注意的变化在于:与其依赖笼统的自主性宣称,智能体相关帖子如今越来越是在直接暴露环境与反馈循环时,才更具说服力。
7. 机会所在
[+++] Agent control plane for cost, state, and security — Multiple sections pointed to the same missing layer: teams want agents that expose token overhead, task state, credential boundaries, and review evidence by default. The evidence spans @IBuzovskyi、@AiCamila_、@nykdotdev 和 @bybardiia。这一点之所以有力,是因为痛点关乎资金、机密信息和卡住的工作,而不只是便利性。[+++] 可移植技能供应链——当天清楚显示出市场对这类工具的需求:团队希望能在不同智能体和领域之间编写、测试、发布、安装并移植技能。Skill Forge、DevOps & Security Agent Skills、fwc-swiftui-skills 和 pstack 都是佐证。之所以判断这一趋势较强,是因为生态系统在各个层面都已经有建设者在推进,但整体工作流仍然支离破碎。
[++] 具备仓库与组织感知能力的检索层——GitReverse、Traces MCP 和 Xirp 从不同角度切入同一个问题:智能体仍会在不同代码库、会话和执行框架之间丢失上下文。这一趋势属于中等强度,因为可用的解决方案已经开始落地,但市场尚未形成一种标准做法,能在每次运行中携带代码库结构、归属关系、既有 traces 和当前生效的约束。
[++] 内置验证闭环的领域专用智能体运行时——UEFN MCP 和 LiteMol-1 之所以更有说服力,是因为它们提供了边界清晰的环境、明确的产物,以及可测试的反馈闭环。这一趋势属于中等强度,因为机会确实存在,但每个垂直领域都需要比通用智能体封装器更深入的产品打磨和领域工作。
[+] 预算感知的编排预设——Claude 加 Codex 的节省 token 工作流之所以流行,说明市场需要带有明确取舍的预设方案,能够在无需手动拼接的情况下,把规划、审查和执行分配给不同模型或订阅。这一趋势仍处于早期阶段,因为这种变通方案显然引发了共鸣,但其当前形态仍然过于脆弱,也过度依赖操作人员。
8. 要点
- 讨论焦点已从“用什么模型?”转向“采用什么操作规范?”最有信号价值的内容强调的是评测、traces、状态、循环设计以及对工作流的显式控制,而不是单纯选择模型。 (来源, 来源, 来源)
- 安全问题被表述为边界问题,而不是审查问题。人们提到凭据处理、撤销路径和盲目批准 PR 的频率,高于抽象的安全表述。 (来源, 来源, 来源)
- 技能正成为可复用智能体专长的主要打包格式。当天的讨论把技能编写系统、可安装库、领域专用补丁和严谨的工作流插件串联了起来。 (来源, 来源, 来源, 来源) 4.上下文可移植性如今已成为一个独立的产品类别。 代码库锚定、轨迹检索和跨评测框架的连续性,都作为独立产品出现,而不再只是附带功能。(来源、来源、来源)
- 当智能体接入真实环境,并处在可验证的闭环中时,最具可信度。 最有说服力的案例并不是通用聊天智能体,而是一个基准测试评测框架、一个游戏开发运行时,以及一个分子设计系统。(来源、来源、来源)