Twitter AI Agent - 2026-08-25
1. 人们在讨论什么
1.1 Harness 工程正在成为一门可度量的系统工程学科(🡕)
最强的一组讨论把 Harness 视为工程上的核心单元,而不是包在模型外面的一层薄壳。至少有七条入选内容支撑了这一主题,涵盖 token 统计、基准测试解读、运行时横向对比、代码蒸馏论点,以及具体的发布说明。与 8 月 24 日聚焦于技能压缩和图结构不同,8 月 25 日进一步深入到了可量化的运行时行为:什么留在上下文里,什么迁移进代码里,以及最终效果中到底有多少应归因于脚手架而非模型本身。
@_avichawla 报道(86 个赞、9 条回复、6,930 次浏览、83 次收藏)指出,两个 Agent 即便使用同一模型执行同一任务,token 使用量也可能相差近 3 倍,因为 Harness 决定了哪些内容保留在上下文中,以及会发起多少次调用。该推文给出了具体失效模式,例如 50k token 的工具输出,以及每一步都会被重复读取的超大工具 schema;随后还链接 TrueForge 作为公开案例,展示延迟加载工具、沙箱化工具执行、大结果卸载,以及基于子 Agent 的上下文丢弃。其独特角度不在哲学层面,而在经济层面:在模型质量尚未发生任何变化之前,Harness 就可能是导致一个 Agent 看起来比另一个贵得多的主要原因。
@alexxubyte 撰文(81 个赞、3 条回复、6,244 次浏览、66 次收藏)指出,Harness 工程才是让 LLM 变得可靠的那一层。配图将这一点具体化:在模型外围放置了上下文构建器、策略门控、运行时、可观测性层、约束机制以及验证阶段,这比通常所说的“提示词加工具”要具体得多。

@rohanpaul_ai 认为(29 个赞、9 条回复、2,149 次浏览、20 次收藏)指出,模型外部的 Harness 对基准结果波动的解释力,比模型本身还强。文中对 Terminal Agents 调查的概括是:系统层面的差异可以被量化;而在同一 Harness 内换用更强的模型变体,只会增加延迟,却不会带来更多已解决任务。这使得脚手架选择更像是一项一等工程决策,而不是次级优化。
@neural_avb 分享 发布了四张对比图(71 个赞、6 条回复、1,793 次浏览、48 次收藏),比较 Pi、Claude Code、Codex CLI 和 OpenCode 在工具、记忆、压缩、系统提示词大小,以及对 skills、MCP 和子 Agent 的支持情况。尽管该帖被定位为未来视频的研究笔记,但这些截图让当天围绕 Harness 的讨论变得可供检视:提示词组装方式、沙箱边界和可扩展性的差异,被并排展示出来,而不再只是含糊带过。
讨论洞察: 回复多次把话题拉回到“如何严谨度量”上。在 TrueForge 线程下,有回复提醒,运行中移除上下文可能会破坏缓存前缀,并以不那么显眼的方式转移成本;在 Terminal Agents 帖子的回复中,也有人要求先看到匹配任务数量和公开的脚手架代码,再把结论当成定论。在 neural_avb 的讨论串下,有回复指出,相比高层概括,名称和数字更容易经得起抽查,这也提醒人们不要过度相信对比性总结。
与前一天相比: 8 月 24 日强调的是渐进式加载技能、审查循环和图结构。到了 8 月 25 日,这些关注点仍在,但变得更实证:token 差值、运行时表格、提示词大小对比,以及代码优先的蒸馏模式,取代了更松散的抽象讨论。
1.2 开源 Agent 基础设施继续分化为控制平面、范围受限的工作区和垂直技能包(🡕)
第二组讨论显示,开源工作正在从通用的“AI Agent”封装器,转向更专门化的操作界面。至少有六条入选内容符合这一主题:公开的控制平面雷达、面向创业团队的多人协作 Harness、本地优先的安全协作助手、垂直化的体育分析技能包、编码 Agent 运行时版本发布,以及 PlanetScale 关于产品界面的论点。反复出现的模式是:构建者交付的不只是 Agent 本身,还有一整套让团队得以治理、路由、观测和复用 Agent 的外围结构。
@nykdotdev 报道(68 个赞、11 条回复、5,623 次浏览、54 次收藏)表示,他每周的 GitHub 雷达如今聚焦于 mission-control、awesome-hermes-agent、grok-build、needle、ego-lite、ai-job-search 和 maka。推文的中心论点很明确:下一波 OSS 浪潮不会是又一个聊天封装器,而会是 Harness、控制平面、本地执行、持久化上下文,以及让 Agent 在演示之外真正可用的交互界面。

@thisdudelikesAI 报道(14 个赞、4 条回复、932 次浏览)指出,Y Combinator 已开源 QM,这是一套“面向工作的多人 Agent Harness”。公开仓库描述把这一点说得更清楚:每个人和每个房间都拥有各自受限的记忆、文件、权限、定时任务、Web 应用和沙箱;Slack 和 Web 共用同一个身份体系,管理员则可以在 Strict、Auto 和 Dangerous 三种安全姿态之间选择。这与单用户聊天助手是实质上不同的产品界面。
@AndrewYNg 报道(33 个赞、10 条回复、5,049 次浏览、18 次收藏)介绍了一个面向安全工作流的新 OpenWorker 版本。推文和公开网站共同表明,这个开源 Harness 可以扫描代码、依赖和云配置,将密钥与 token 保留在本地,在设备上运行开放权重模型,并通过审批或可审阅的 pull request 来约束关键操作,而不是静默执行。
@WalrusQuant 构建了(43 个赞、2,635 次浏览、83 次收藏)介绍了一个体育分析技能包,Agent 可以安装后用于 EDA、时间安全特征、基线、walk-forward validation、泄漏检查、校准、模拟和报告。该仓库之所以重要,是因为它把模糊的“技能包”说法,落实成了一个真正的垂直包:有公开文档、有安装命令,也有可选的数据工具包。
@BenjDicken 认为(96 个赞、8 条回复、6,227 次浏览、28 次收藏)则从产品公司的角度提出了同样的分化:MCP、CLI 和 skills 应该成为 Agent 的一等产品界面,但对需要监控 Agent 行动结果的人类而言,强大的仪表盘仍然重要。这让“基础设施”这个主题不再只是业余工具之争,而是指向成熟软件产品将如何同时暴露 Agent 界面与人类界面。
讨论洞察: 雷达帖下的回复并没有质疑这种转向,反而进一步强化了它:本地执行、账户状态、权限日志和轻量边缘运行时,被视为下一批真正棘手的界面。在 OpenWorker 线程下,有回复提出了一个重要细节:数据留在本地固然有价值,但防守方仍需要 Harness 清楚暴露 Agent 能访问什么、哪些操作需要审批、加载了哪些规则,以及拟议变更的证据依据是什么。
与前一天相比: 8 月 24 日对上下文的讨论,主要集中在选择性加载和插件安装界面。到了 8 月 25 日,讨论向外扩展了一层,进入面向团队的产品:控制平面、范围受限的创业团队工作区、本地安全协作助手,以及领域专用技能包。
1.3 Agent 经济相关帖子开始从“列目录”转向验证、结算和能力路由(🡕)
第三个主要主题延续了市场化讨论,但词汇已经变了。相比 8 月 24 日聚焦于发现和变现,8 月 25 日保留下来的证据更集中在工作验证、支付流程、声誉、托管,以及可购买能力。至少有五条入选内容支持这一主题,使当天“Agent 经济”的讨论明显更偏操作层,而非愿景层。
@AkashMintX 撰文(99 个赞、110 条回复、434 次浏览)指出,Agent 需要一个能够发现工作、验证交付、建立信任并完成结算的经济体系。帖子将 AACP 和 TermiX marketplace 描述为支持链上身份、任务发现、竞标、交付验证、声誉和 USDC/USDT 结算的基础设施,同时还表示,激励层应把核心权重放在“已验证任务”上,而不是自由交易的积分。
@derrelreyhan 撰文(68 个赞、74 条回复、245 次浏览)指出,Agent 经济需要的是结算,而不只是目录。该线程对公开架构的描述异常具体:客户端、提供方、评估方和仲裁方角色;链上 USDC/USDT 托管;TEE 和 zkVM 验证;争议处理;部署在 Base 和 BNB Chain 上;以及 1-3% 的协议费。
@Cortex_Network_ 宣布(62 个赞、11 条回复、9,738 次浏览)指出,Cortex Agent Passport Skills 已经开源。这个说法之所以重要,是因为它把“Agent 经济”讨论进一步压到可检查的技能逻辑层面:13 个 MIT 许可技能,用于认证、已批准的支出会话,以及 x402 付费 API 请求,据称已支持 30+ 个 Agent。
@dylanpkel 发布(19 个赞、3 条回复、4,786 次浏览、21 次收藏)将 Agentmuxer 称为“Agent Capabilities 的 OpenRouter”。该推文表示,这个产品会依据基准测试和结果反馈,把 Web 搜索、抓取、提取、数据丰富等付费能力路由到最佳提供方;而公开网站的元数据则把其产品主张浓缩为一句话:连接一个 MCP,在运行时发现 API 和数据,从同一个钱包支付,并路由到最合适的工具。
讨论洞察: 这一组里最尖锐的公开反驳,并不是反对市场理念本身,而是把缺失层收窄了。AkashMintX 帖子的回复认为,比起 Agent 本身,结算和验证更重要;而 Cortex 与 Agentmuxer 则展示了两种不同回应:一边是可检查的支付技能,另一边是基于基准测试路由的能力采购。
与前一天相比: 8 月 24 日讨论机会时,重点还在发现、发布和收款。到了 8 月 25 日,讨论加入了更硬的经济原语:已验证任务、托管、挑战窗口、协议费、声誉,以及能力路由。
2. 什么让人沮丧
高上下文负担的技能仍然让 Agent 昂贵且脆弱
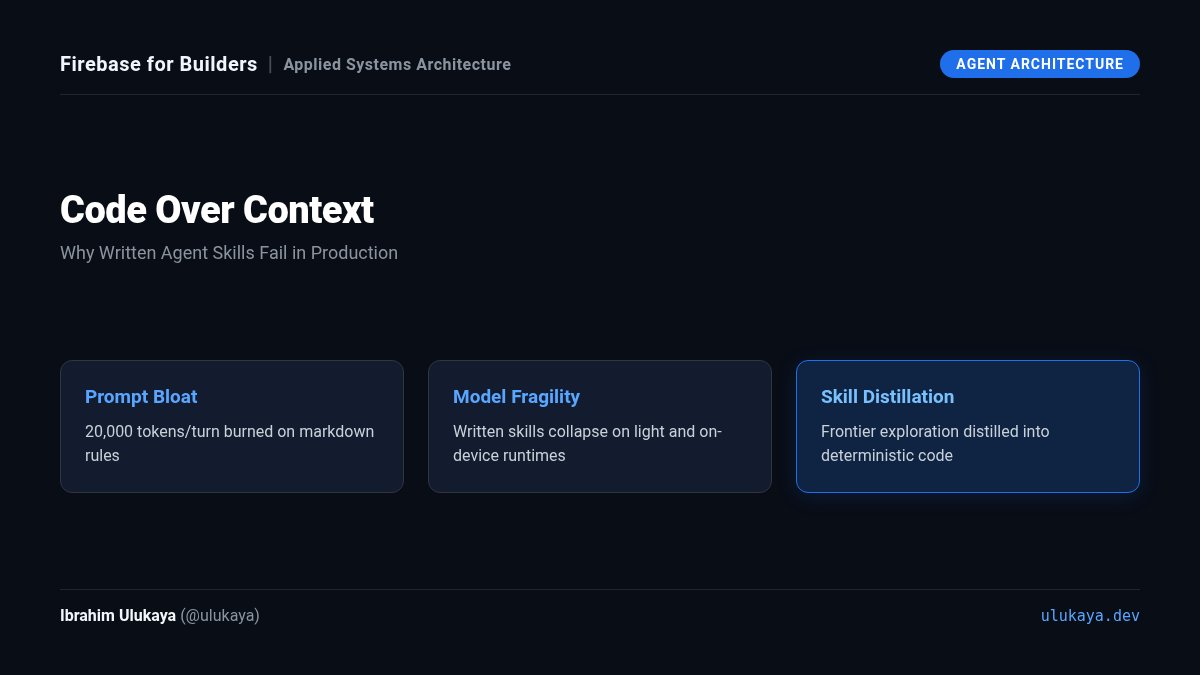
最明确的不满在于,Agent 太多运行逻辑仍以重复注入的 Markdown 上下文形式存在,而不是落入确定性代码。@_avichawla 报道(86 个赞、9 条回复、6,930 次浏览、83 次收藏)指出,同样的模型、同样的任务下,两个 Agent 之所以会有近 3 倍的 token 差距,是因为旧工具输出和超大工具 schema 会被反复重读;同时,@iulukaya 撰文(3 个赞、2 条回复、32 次浏览)指出,10 个写成文本的技能,可能在用户还没输入任何内容前,就先烧掉约 20,000 个 token/轮。他链接的文章把这种抱怨进一步提炼成一个设计主张:状态机、schema 校验、算术、认证和文件变更都应迁入代码,因为重提示词的技能会在长会话中逐渐漂移,并在更轻量的运行时上失效。@neural_avb 分享(71 个赞、6 条回复、1,793 次浏览、48 次收藏)给出的对比表,则把它从单一工具抱怨上升为生态级问题。应对方式高度一致:延迟加载工具、卸载大输出、把稳定工作流蒸馏为类型化工具,并让模型聚焦推理而非确定性执行。严重程度:高。值得投入:高。
更强的模型救不了薄弱的脚手架,也救不了薄弱的度量体系
第二个挫败点是,团队仍然难以把模型质量与 Harness 质量区分开来,也难以证明某项自动化改进何时才算真正安全。@rohanpaul_ai 认为(29 个赞、9 条回复、2,149 次浏览、20 次收藏)指出,Harness 对基准结果差异的解释力超过模型本身;而回复立即追问,底层比较是否有足够多的匹配任务,以及脚手架代码是否公开。@shivam74689 报道(9 个赞、4 条回复、188 次浏览)提到一个自我改进的提示词系统,但在候选提示词能替换生产版本前,仍需要 30 个案例的回归测试集、升级策略、明确的人类审批、回滚机制和版本历史。@XFreeze 报道(127 个赞、29 条回复、9,389 次浏览、20 次收藏)指出,用户想要的是具体控制项,比如 Agent 预算、推理强度和更稳健的子 Agent;该线程中还有回复表示,这些控制项比界面装饰更重要。大家的应对模式,是把评估、审批和运行时配置当作一等产物,而不是假设模型更强后,编排错误自然就会被抹平。严重程度:高。值得投入:高。

Agent 市场仍然必须证明“可信”,而不只是“可发现”
市场相关讨论也暴露出一个务实的不满:目录很容易发布,但可信的工作执行难得多。@AkashMintX 撰文(99 个赞、110 条回复、434 次浏览)指出,Agent 需要在同一个经济体系里同时具备发现、信任、验证和结算;而回复不断把结算和验证单独拎出来,视为真正缺失的环节。@derrelreyhan 撰文(68 个赞、74 条回复、245 次浏览)指出,缺的是商业与结算基础设施,而不是又一份 Agent 名录;@Cortex_Network_ 宣布(62 个赞、11 条回复、9,738 次浏览)之所以开源支付技能,正是因为人们想检查支出逻辑。@dylanpkel 发布(19 个赞、3 条回复、4,786 次浏览、21 次收藏)则从同一缺口的另一面切入:Agent 仍然需要一种可靠方式来获取外部能力,而无需在各个提供方之间分散账户。公开的应对模式,是在 Agent 外围补上已验证任务、托管、支出会话、路由基准测试和争议流程,而不是相信目录页面本身。严重程度:中。值得投入:高。
3. 人们希望出现什么
能取代重 Markdown 技能的蒸馏工具
这是数据集中最直接的实际需求。@iulukaya 撰文(3 个赞、2 条回复、32 次浏览)指出,即便状态机、schema 校验、算术、认证和文件操作都可以由代码确定性处理,仍然有太多团队把冗长的 Markdown 技能塞进上下文。@_avichawla 报道(86 个赞、9 条回复、6,930 次浏览、83 次收藏)则从经济角度呈现了同一问题:反复出现的 50k token 负载和臃肿的工具定义;@neural_avb 分享(71 个赞、6 条回复、1,793 次浏览、48 次收藏)则用表格比较了不同 Harness 如何组装提示词,以及如何支持记忆、压缩和子 Agent。真正的诉求并不是抽象意义上的“更会写提示词”,而是更小、更类型化、可检查的运行时界面:让模型负责推理,让代码负责约束不变量。机会:直接。
面向团队规模 Agent 工作的共享工作区与控制平面
公开证据显示,大家需要的是能服务群体协作的 Agent 系统,而不只是某个用户在某个标签页里使用的单人工具。@thisdudelikesAI 报道(14 个赞、4 条回复、932 次浏览)指出,QM 为每个人和每个房间提供范围受限的记忆、文件、权限、定时任务和沙箱;@nykdotdev 报道(68 个赞、11 条回复、5,623 次浏览、54 次收藏)则指出,本周开源关注点正在聚到控制平面和持久化上下文界面上,而不是聊天封装器。@AndrewYNg 报道(33 个赞、10 条回复、5,049 次浏览、18 次收藏)提到一个本地优先的桌面协作助手,具备明确审批和计划任务;@BenjDicken 认为(96 个赞、8 条回复、6,227 次浏览、28 次收藏)则指出,产品应暴露 MCP、CLI 和 skills,同时保留强大的人类仪表盘。局部解法显然已经存在,但反复出现的需求,是持久、可检查、可共享的工作区:让 Agent 能在后台运行,又不会因此变得不可见。机会:直接。
面向 Agent 商业活动的验证、结算与能力采购
人们要的并不只是更多 Agent marketplace,而是能让 Agent 在经济上“说得清”的机制。@AkashMintX 撰文(99 个赞、110 条回复、434 次浏览)指出,Agent 需要身份、已验证工作、声誉和结算;@derrelreyhan 撰文(68 个赞、74 条回复、245 次浏览)则指出,任务流需要托管、评估方、仲裁方和挑战处理,而不是简单列表。@Cortex_Network_ 宣布(62 个赞、11 条回复、9,738 次浏览)提供了可检查的支付技能;@dylanpkel 发布(19 个赞、3 条回复、4,786 次浏览、21 次收藏)则提供了一个可路由的能力市场,让 Agent 能按需购买搜索、抓取和数据丰富能力。这是一个具备直接商业价值的现实需求,但竞争也会很激烈,因为多个团队正朝同一技术栈的相邻层收敛。机会:竞争性。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| TrueForge | Harness 运行时 | (+) | 延迟加载工具、子 Agent、大结果卸载、审批、沙箱化和公开基准测试,都被明确呈现为成本控制手段 | 公开基准结论很有吸引力,但回复仍对缓存效应和基准解释提出质疑 |
| Mission Control | 控制平面 | (+) | 任务看板、记忆浏览器、审批、定时任务、多种界面,以及明确的治理界面 | 仓库将项目标为 alpha,并提醒 API 和 schema 可能发生变化 |
| QM | 共享 Agent 工作区 / Harness | (+) | 在 Slack 和 Web 中,为每个人和每个房间提供独立的记忆、文件、权限、定时任务、Web 应用和安全姿态 | 仓库称其仍是早期实验项目且存在 bug,说明其运行模式先于成熟度 |
| OpenWorker | 本地优先桌面 Agent | (+) | 需审批的操作、只读安全协作助手、本地模型支持、25+ 集成、计划任务和 MCP | 仍处于公开测试阶段;且有回复提醒,本地执行依然需要可检查的运行时规则 |
| Grok Build | 编码 Agent Harness / TUI | (+/-) | Agent 预算控制、推理强度控制、图像反馈、并发子 Agent、worktree 复用,以及更快的 MCP 启动 | 讨论认为其中一些新增功能只是表面润色,真正有价值的是预算和推理强度控制 |
| sports-analytic-skills | 垂直技能包 | (+) | 为 EDA、时间安全特征、基线、walk-forward validation、泄漏检查、校准、模拟和报告提供公开安装路径 | 适用范围主要限于体育数据集,且依赖用户提供数据的质量 |
| AACP / Agent Family | Agent 商业 / 结算 | (+/-) | 公开描述了身份、竞标、托管、验证、争议处理、声誉和结算流程 | 现有证据多数来自生态推文和图示,而非中立第三方验证 |
| Cortex Agent Passport Skills | 支付技能包 | (+) | 可检查的认证、支出会话和 x402 支付技能,并明确以开源方式发布 | 今天的证据仍主要限于推文和图片,数据集中没有出现更深入的公开文档 |
| Agentmuxer | 能力路由器 / 市场 | (+/-) | 基于基准测试和结果反馈,为 Web 搜索、抓取、提取和数据丰富提供统一余额、按次付费的路由 | 仍定位为早期用户产品,因此成熟度和提供方覆盖范围尚不明朗 |
| Code-distillation workflow | Harness 方法 | (+) | 把确定性工作迁入类型化工具,减少上下文膨胀,并瞄准更轻量的运行时 | 需要工程投入来蒸馏和维护这些工具,而不只是撰写提示词 |
整体来看,那些能把状态、审批、验证和成本从原始提示词中“拉出来”、变得可见的运行时和方法,获得的评价更偏正面。主要应对模式是:把稳定操作迁入代码或控制平面,把推理留给模型,并把人工审查放在关键操作的边界上。迁移讨论的重心,也更少放在更换模型供应商上,而更多放在摆脱聊天封装架构,转向共享工作区、本地执行、明确治理,以及能够证明 Agent 实际做了什么的经济层。
5. 人们在构建什么
| 项目 | 构建者 | 做什么 | 解决什么问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| TrueForge | TrueFoundry | 具备聊天 UI、HTTP API、SDK、审批、沙箱化和子 Agent 的开源 Agent Harness | 降低 Harness 开销,为团队提供可复用运行时,而不必围绕每个模型重复搭建编排系统 | TypeScript、MCP、sandbox、chat UI、HTTP API、SQLite/Postgres | 已发布 | 仓库 |
| Mission Control | Builderz Labs | 面向 Agent 集群的自托管控制平面,支持任务路由、审批、记忆和活动流 | 让运维人员能够查看多 Agent 的归属、审查状态、回执和开销 | Next.js、React、TypeScript、SQLite、REST、MCP、CLI、WebSocket/SSE | Alpha | 仓库 |
| QM | YC Software | 面向 Slack 和 Web 的多人 Agent Harness,为个人和房间提供范围受限的工作区 | 让创业团队能够运行共享的 Agent 工作流,而不会把所有人挤进同一个上下文窗口 | Node.js、Fastify、Postgres、范围受限的沙箱、Slack/Web UI | Beta | 仓库 |
| OpenWorker | Andrew Ng | 本地优先的桌面协作助手,可跨文件、终端和已连接应用完成任务 | 为防守方和运维方提供可审计、可本地运行且会在行动前征求同意的 Agent | Python 后端、React/Tauri GUI、MCP、通过 Ollama 运行本地模型、25+ 连接器 | Beta | 网站, 仓库 |
| sports-analytic-skills | WalrusQuant | 可安装的体育分析技能包,用于 EDA、建模、泄漏检查、验证、校准和报告 | 把领域特定的评估纪律打包起来,避免每位分析师都从头摸索 | 托管在 GitHub 的 skills、文档站点、可选的 Python 体育数据工具包 | 已发布 | 仓库 |
| Agent Family / AACP | TermiX | 面向 Agent 身份、任务发布、竞标、托管、验证和结算的市场与协议 | 补上经济原语,让 Agent 能接单、证明交付并完成收款 | ERC-8004/8183、USDC/USDT 托管、TEE + zkVM 验证、REST/MCP、Base/BNB | Beta | 网站 |
| Agentmuxer | @dylanpkel | 面向搜索、抓取、提取和数据丰富等付费 Agent 能力的路由式市场 | 让 Agent 能按需获取外部能力,而无需为每个提供方分别持有账号或密钥 | MCP 风格能力路由、benchmark/eval 层、共享钱包/余额 | Alpha | 网站 |
TrueForge 和 OpenWorker 代表了一种反复出现的构建模式:真正有意思的工作,正在转移到模型外围的运行时层。TrueForge 强调上下文经济性、沙箱化和可复用界面;OpenWorker 则强调本地执行、审批门,以及通过提交可审阅变更而非静默执行来扮演安全协作助手。
Mission Control 和 QM 展示了与之并行的团队规模模式。Mission Control 的公开材料聚焦于运维方、审查队列、回执和活动流;QM 则聚焦于范围受限的工作区、共享频道和组织级姿态控制。但两者都在构建同一种基础设施:面向大量并发 Agent 会话,而非单一的个人助理。
在商业化主题中,则出现了另一种构建模式。Agent Family / AACP 和 Agentmuxer 都假设 Agent 需要围绕自身形成市场,但它们处理的层级不同:前者聚焦任务的身份、托管、验证和结算,后者聚焦运行时购买合适能力。sports-analytic-skills 则提供了另一个方向:把领域专属评估规则编码进可移植的 Agent 工作流,形成垂直技能库。
6. 新的、值得注意的内容
LiveAvatar 去掉了并发上限
@TryLiveAvatar 报道(165 个赞、161 条回复、280,740 次浏览、149 次收藏)指出,LiveAvatar 现在在同一 API 上支持“1 个 avatar 或 10,000 个同时运行”,提供全身 1080p,价格“在规模化场景下最低可至 $0.01/分钟”。最有力的新增证据并非来自尚未落实的文章链接,而是来自回复:有用户问,自定义 avatar 是否可以从任意视频输入即时生成;该账号回复称,自定义 avatar 仍然需要先基于图片或视频输入进行训练。这让该帖不只是一个模糊的规模化宣传,也顺带澄清了一条关于 avatar 创建的产品边界。
一条互动不高的帖子,给出了当天最清晰的提示词治理产物之一
@shivam74689 报道(9 个赞、4 条回复、188 次浏览)介绍了一个自我改进的 Agent 工作流,包含 30 个案例的回归测试集、候选版与基线版对抗、升级策略、明确的人类审批、回滚和版本历史。它之所以值得注意,是因为配套产物把“评估”和“升级”之间的区别变成了可执行流程,而不只是口头表述:得分更高,并不自动授权生产变更。

7. 机会在哪里
[+++] 把提示词蒸馏进代码的高上下文效率 Harness — 多个部分都指向同一种痛点:重复注入的 Markdown 技能、超大的工具 schema 和旧输出让上下文不断膨胀,并把确定性工作藏进自然语言。公开证据涵盖 TrueForge 的成本案例、Terminal Agents 调查、neural_avb 的运行时对比表,以及 iulukaya 的代码蒸馏文章。之所以判断为强机会,是因为痛点、修复思路和多个公开实现都集中出现在同一天。
[+++] 团队规模的 Agent 操作系统与控制平面 — QM、Mission Control、OpenWorker、Grok Build 以及 Ben Dicken 关于产品界面的论点,都指向同一个缺口:一旦 Agent 在后台运行或并行运行,团队就需要范围受限的工作区、回执、审批、仪表盘和策略控制。之所以判断为强机会,是因为证据横跨个人桌面 Agent、创业团队 Harness 和集群级治理界面,而不是某个狭窄用例。
[++] 可验证的 Agent 商业 — AkashMintX、derrelreyhan、Cortex 和 Agentmuxer 都默认认为,Agent 的下一层经济体系不能只有“发现”。反复出现的要求包括身份、获批支出、托管、验证、争议处理,以及按需购买外部能力的能力。之所以判断为中等机会,是因为需求很清晰,但公开证据目前仍主要来自构建者和生态倡导者,而不是中立的使用数据。
[+] 内置评估纪律的垂直技能库 — WalrusQuant 的体育分析技能包展示了一种有前景的模式:把泄漏检查、walk-forward validation、基线、校准和报告编码进可移植工作流的领域技能。这个方向仍在萌芽阶段,尚未成为主流,但它之所以突出,在于它把 Agent 讨论从泛化的自主性,收窄到了边界清晰的专业工作流。
8. 要点
- 当天 Agent 讨论中,Harness 选择是最主要的解释变量。 公开帖子从不同角度反复回到同一个主张:token 开销、提示词组装、沙箱边界和基准结果,都高度依赖模型外围的运行时层。(来源)
- 开源构建者的注意力正在转向“操作界面”,而不只是 Agent 演示。 最强的一组 OSS 讨论围绕控制平面、共享工作区、本地执行、权限日志和生态地图展开,而不是又一个通用聊天 UI。(来源)
- 关于 Agent 经济的讨论,如今默认需要验证与结算原语。 如果 Agent 要做的是付费工作,而不只是出现在目录里,那么身份、托管、争议处理、声誉、获批支出会话和能力路由,都会被视为必要层。(来源)
- 一些信息量最大的产物,来自互动不高的帖子,而不是传播最广的帖子。 最典型的例子是代码蒸馏文章和自我改进提示词治理图,它们提供了很多高热度宣传帖通常缺乏的操作细节。(来源)