Twitter AI Agent - 2026-09-06
1. 大家在讨论什么
1.1 Agent 工作台不再只是聊天窗口,而是成了安装入口(🡕)
最强的一组讨论把 Agent 的用户体验下沉了一层:从现有应用里的提示词,转向操作系统、控制界面,以及专为高频 Agent 工作流打造的 UI 组件。@AlexFinn 表示(221 个赞、43 条回复、22,938 次浏览、232 次收藏)称,Omarchy 是唯一一个“为 AI 打造”的操作系统,并将这一说法建立在旧硬件低成本复用、纯文本定制、插件共享以及键盘驱动的日常使用方式之上。公开的 Omarchy 仓库 将其描述为“agentic Linux distribution”,而 @zzzzshawn 推出了(175 个赞、24 条回复、5,814 次浏览、175 次收藏)则介绍了 Orbkit:一个真正的 React/TypeScript/shadcn 注册表,用于呈现 Agent 状态球,可对空闲、思考和发声状态作出响应。

@championswimmer 报道称(84 个赞、18 条回复、7,186 次浏览、68 次收藏)认为,T3 Code 比 Pi 更像一个适合并行运行 Claude 和 Antigravity 的“Agent 管理器”,尤其体现在桌面端体验和连接器模型上。@doodlestein 分享了(56 个赞、5 条回复、3,482 次浏览、24 次收藏)则介绍了一个公开的 Lean 证明技能:它建立在形式化证明工作之上,并明确加入了防止过度声称的护栏,把同一主题从界面打磨延伸到了可安装的专家行为。

讨论洞察: Omarchy 帖子下的回复质疑,“为 AI 打造”究竟意味着真正的新原语,还是仅仅意味着 Agent 可以编辑纯文本配置;T3 讨论串则把同样的争论推进到了工作流人体工学、缓存行为和并行会话支持上。
与前一天的比较: 2026-09-05 时,skills 主要被当作可复用的操作规则来讨论。到 2026-09-06,讨论范围已经扩展到安装入口:操作系统、移动端/桌面端控制平面,以及围绕 Agent 实际运行方式设计的可视化组件。
1.2 Harness、可复用 skills 和记忆设计,取代了提示词调优(🡕)
第二个主要主题是:更好的 Agent 越来越被理解为更好的系统,而不是更好的单次提示词。@iiiichigo_chan 总结道(50 个赞、5 条回复、5,630 次浏览、74 次收藏)将 Andrew Ng 的观点概括为“模型外围的 harness 才是下一步”,而最有价值的回复则把它具体化为契约、工具安全、持久状态、恢复机制和停止条件。@witcheer 重点介绍了(69 个赞、7 条回复、2,949 次浏览、131 次收藏)介绍了 botmaker;其公开的 仓库 把专业机器人创建变成一条受监督的流水线:访谈、SOUL 草稿、签字确认、脚手架、认证和 vault 文档。
@marfinxx 进一步传播了(70 个赞、12 条回复、4,720 次浏览、82 次收藏)介绍了 Google 的 ReasoningBank;代码仓库和经审阅的论文图表支持了一个边界清晰但有力的结论:与其把原始日志重新塞回上下文,不如把失败和成功的轨迹提炼为可复用的推理策略,这样更能提升 Agent 表现。@rohanpaul_ai 分享了(12 个赞、8 条回复、1,702 次浏览)展示了 DisCo 的结果:从 1,000 个 ML 仓库中提炼出 5,353 个 skills,并在模型和预算设置不变的情况下让 MLE-bench 大幅提升,这也让“skills”从一种口号变成了可测量的研究方向。
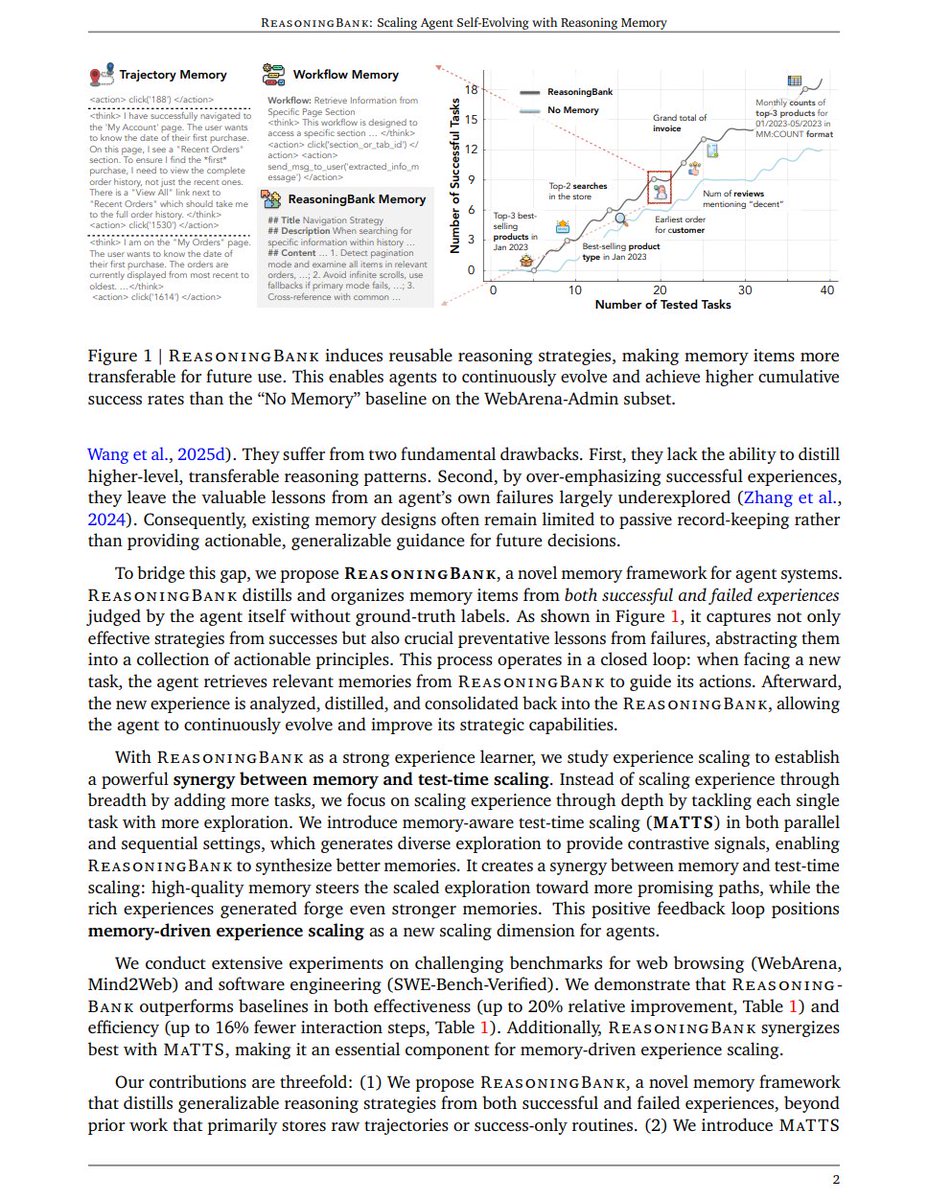
讨论洞察: ReasoningBank 讨论串中最有价值的回复明确纠正了炒作,指出论文支持的是“具备失败感知的策略提炼”,而不是“95% 的架构都有问题”或“覆盖 140 个工作流的生产研究”这类更强的说法。这让讨论更可信,而不是更不可信。
与前一天的比较: 2026-09-05 强调的是持久上下文和反思循环。今天的讨论则更具体地聚焦于该存什么:skills、负向约束、可复用流程,以及可审计的推理状态。
1.3 浏览器、推理和控制平面基础设施变得更具体了(🡕)
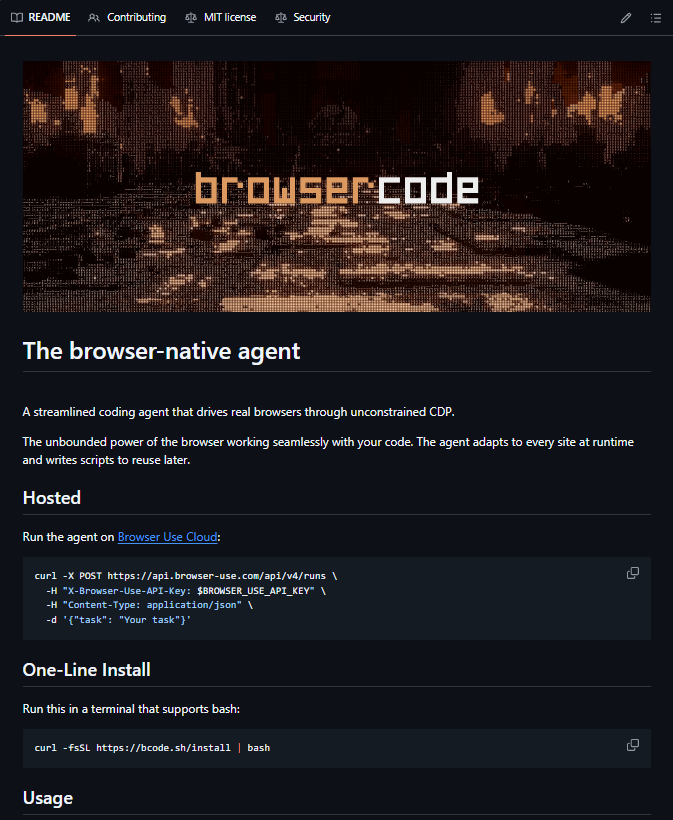
开发者并没有收敛到单一技术栈,而是把更多技术栈细节公开出来。@RodmanAi 发布了(56 个赞、13 条回复、3,053 次浏览、72 次收藏)汇总了浏览器与编码 Agent 仓库,回复里反复点名 BrowserCode,因为它通过 CDP 驱动 Chrome、保持会话存活,并能写出可复用脚本。@championswimmer 报道称(84 个赞、18 条回复、7,186 次浏览、68 次收藏)认为,T3 Code 的控制界面明显优于他对更大 incumbents 的预期,这说明编排 UX 本身如今也成了竞争界面。
在更底层,@volatilemarkts 发布了(59 个赞、10 条回复、10,343 次浏览、88 次收藏)介绍了 pd-bridge:这是一个面向 DeepSeek-V4-Flash 的异构 prefill/decode 实现,使用 DGX Spark 做 prefill,用 Mac Studio 做 decode,两者通过普通 10GbE 连接。README 中测得的长提示词加速数据,以及作者本人的回复,都清楚划定了收益边界:优势在于超大上下文的 prefill,而不在 decode。
讨论洞察: BrowserCode 讨论串反复回到权限、审计日志和 Cookie 隔离,而 pd-bridge 讨论串则不断追问延迟究竟落在什么位置。共同模式是:大家评判基础设施主张时,看的越来越不是新颖性,而是运维细节。
与前一天的比较: 昨天关于技术栈的讨论引入了编排、浏览器和代码图层。今天的证据则更偏实现:截图、安装流程,以及经过测量的长上下文行为。
1.4 Agent 商业离支付通道更近了一步,但公开证据仍然偏薄(🡕)
商业主题从“市场已经存在”进一步收束为“这项工作如何结算”。@solana 报道称(372 个赞、137 条回复、51,021 次浏览、21 次引用)称,Solana 支付通道已为 x402 和 MPP 上线,支持每秒 1M 次 Agent 支付和批量结算;同一条帖子还提到,Grok 用户可以通过 Moonpay PayBox 在对话中交易和消费。与此同时,多条与 TermiX 相关的推文反复描述同一套拟议流程:Agent 发布工作,其他 Agent 报价,资金锁定在托管中,交付物经过验证,随后支付和声誉在链上更新。
@sahar1371ak 描述了(86 个赞、99 条回复、1,160 次浏览)以最具体的方式描述了这套流程,而经审阅的信息图还补充了交付物哈希、随机仲裁者,以及低于传统市场抽成的协议费用等细节。得分较低的配套帖子,如 @_Izuweb3 这里,主要是在重申 AACP 是协议层,而 agent.family 是市场层。TermiX 公共网站的元数据也强化了这一框架,但回复大多是肯定而非怀疑,也很少涉及运营细节。

讨论洞察: 与记忆和工具类讨论不同,多数商业讨论串的回复增加的更多是热情,而不是新证据。今天最清晰的公开证据,来自支付通道公告、市场/网站描述,以及这些信息图本身。
与前一天的比较: 2026-09-05 重点是机器人货架、市场和上手摩擦。到了 2026-09-06,讨论进一步转向身份、托管、交易吞吐量和结算机制。
2. 什么让人感到沮丧
2.1 一旦 Agent 能递归、记忆或委派,监督仍然会失效
最明确的挫败感并不在于模型原始能力,而在于 Agent 被允许持续运行后会发生什么。@gippp69 分享了(89 个赞、26 条回复、5,070 次浏览、80 次收藏)介绍了一种以工具使用、记忆和持续执行为核心的 Grok Bot 架构,但回复立即警告称,“50 个 Agent 没有控制机制”是治理问题,而且循环可能卡在反复调用同一工具上。@witcheer 重点介绍了(69 个赞、7 条回复、2,949 次浏览、131 次收藏)介绍 botmaker,正是因为它会先在自己的聊天中测试一个新专家,再把它写进 fleet 文档;其中一条回复说,这一步“才是关键,否则你只是把同样的错误假设规模化”。@marfinxx 进一步传播了(70 个赞、12 条回复、4,720 次浏览、82 次收藏)讨论了 ReasoningBank,但最有力的回复仍提出了那个尚无答案的问题:谁有权写入记忆,又由谁来检查给轨迹打标签的 judge?
为什么令人困扰: Agent 现在能运行足够长时间,以至于错误假设、错误记忆或错误验证会不断累积,而不再只是一次糟糕回答后就结束。
值得投入建设吗? 是。这是编码、研究和多 Agent 编排中反复出现的直接痛点。
2.2 对重度用户来说,配额消耗和使用遥测仍然过于不透明
第二个挫败点是成本可见性。@StefanoGPT 发布了(28 个赞、10 条回复、13,713 次浏览、46 次收藏)给出了一条用于排查 Codex 使用量下降的长诊断提示词,它区分活跃请求和延迟上报的额度,把修复限制在可逆变更内,并要求输出脱敏报告;这是非常具体的证据,说明用户并不觉得内置遥测已经足够。@sethrose 询问道(18 个赞、23 条回复、7,104 次浏览、13 次收藏)则请其他人分享配置,因为即使采用编排、且报告显示输入缓存命中率达到 96.8%,Astra 的配额消耗仍然比预期快得多;他在后续回复中还量化了工作负载:处理长仓库任务时,每小时总 token 消耗约为 11.2 million。
为什么令人困扰: 用户无法判断问题究竟出在模型选择、编排模式、计量延迟,还是客户端行为,因此他们调试的不只是输出质量,还有支出本身。
值得投入建设吗? 是。可观测性、按客户端归因,以及可信的使用说明,看起来都是眼下立刻存在的工具空缺。
2.3 不同产品和工作流之间的 Agent 控制界面仍然割裂
T3 Code 讨论串展示了一个更常见、却同样现实的挫败点:管理 Agent 依然比营销宣传说得更混乱。@championswimmer 报道称(84 个赞、18 条回复、7,186 次浏览、68 次收藏)想在真实项目里并行使用 Claude 和 Antigravity,但发现这些订阅无法通过 Pi 使用;与 T3 的体验相比,Claude 和 Codex 也暴露出意料之外的粗糙之处。同一讨论串的回复还带出了听写、上下文裁剪、可扩展性等次级痛点,以及性能问题究竟来自 UI 开销还是缓存形态的疑问。
为什么令人困扰: 摩擦点已经不再是“模型能不能帮忙”,而是“这项工作到底该用哪个应用,才能获得合适的模型、合适的会话状态、合适的控制界面,以及合适的成本表现?”
值得投入建设吗? 是。对已经同时运行多个模型、多个客户端和多个并发 Agent 会话的开发者来说,这尤其有吸引力。
3. 大家希望有什么产品
3.1 从真实工作中提炼出的可复用 skill 库,而不只是提示词
多条帖子都在暗示同一种缺失的产品:一种可信的方法封装方式,而不只是模型访问权限。@rohanpaul_ai 分享了(12 个赞、8 条回复、1,702 次浏览)展示了 DisCo 的结果:从仓库中提炼出数千个 skills,并带来可测量的基准提升。@doodlestein 分享了(56 个赞、5 条回复、3,482 次浏览、24 次收藏)介绍了一项围绕“认识论谦逊”构建的 Lean 证明 skill,而 @witcheer 重点介绍了(69 个赞、7 条回复、2,949 次浏览、131 次收藏)则把 botmaker 描述为一种通过明确脚手架和认证来生成专业 Agent 的方式。
机会: 直接。需求很务实、偏安装导向,而且反复与具体工作流绑定。
3.2 能展示状态、并行性和成本的 Agent 管理界面
@championswimmer 报道称(84 个赞、18 条回复、7,186 次浏览、68 次收藏)认为,T3 Code 之所以成功,是因为它表现得像一个 Agent 管理器,而不只是另一个聊天框。@StefanoGPT 发布了(28 个赞、10 条回复、13,713 次浏览、46 次收藏)提供了一条诊断提示词,因为现有客户端对额度消耗的解释仍不够清楚;@sethrose 询问道(18 个赞、23 条回复、7,104 次浏览、13 次收藏)则呼吁共享配置数据,以逆向分析为什么某些工作流消耗的配额远高于其他工作流。
机会: 直接。缺失的不是另一个更聪明的模型,而是一个能让长时间运行的 Agent 工作变得可检查的界面。
3.3 保存经验教训,而不是日志的记忆系统
@marfinxx 进一步传播了(70 个赞、12 条回复、4,720 次浏览、82 次收藏)介绍了 ReasoningBank,因为它存储的是从成功和失败轨迹中提炼出的策略,而不是回放原始工具 I/O。最有力的回复进一步勾勒了理想产品形态:记忆应当带有来源、过期时间、拒绝记录,以及下一步允许执行的动作,而不只是可搜索文本。
机会: 直接。这一需求既技术性强,也很紧迫,并且与当天最有研究支撑的讨论一致。
3.4 面向真实发生交易的 Agent 的身份、托管和声誉层
@solana 报道称(372 个赞、137 条回复、51,021 次浏览、21 次引用)介绍了面向 Agent 支付的生产级支付通道,而 @sahar1371ak 描述了(86 个赞、99 条回复、1,160 次浏览)则描述了一条由任务发布、报价、托管、验证到结算构成的完整闭环。配套帖子则持续把 agent.family 与底层的 AACP 协议层区分开来,前者是市场界面,后者是底层协议。
机会: 竞争性机会。需求已经说得很明确,但今天的证据仍更多来自产品定位,而不是运营者独立分享的结果。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Omarchy | 操作系统 / 工作台 | (+/-) | 安装快、可低成本复用旧硬件、支持纯文本定制和插件共享、键盘优先工作流 | 回复质疑它是否真的独特到“为 AI 而生”,还是只是一个打磨完善、可编辑的 Linux 环境 |
| Orbkit | UI 组件库 | (+) | 面向 Agent 空闲/思考/发声状态的真正 React/TypeScript/shadcn 包;可安装、可定制 | 价值目前主要停留在展示层;尚无关于运行时或评估影响的讨论 |
| botmaker / Hermes Agent | Agent 框架 / skill | (+) | 将访谈、签字确认、脚手架、认证和文档编码为可复用的专业机器人流程 | 依赖人工关卡和多供应商配置;不是零配置路径 |
| ReasoningBank | 记忆框架 / 研究代码 | (+/-) | 同时从失败和成功轨迹中学习;在 Web 和 SWE 任务上带来可测量提升 | 社区回复不得不纠正夸大解读,并推动更强的记忆治理 |
| BrowserCode | 原生浏览器编码 Agent | (+) | 基于 CDP 的浏览器控制、持久会话、可复用脚本、清晰的安装路径 | 安全问题集中在权限、Cookie 隔离和可审计性 |
| T3 Code | Agent harness 控制界面 | (+/-) | 为多个 Agent 供应商提供强大的桌面端/移动端/Web 控制平面;因 UX 获得好评 | 仍处早期;相关讨论暴露出功能缺失、速度担忧和供应商覆盖不足 |
| pd-bridge | 推理基础设施 | (+) | 通过在不同硬件间拆分 prefill 和 decode,实测提升长上下文 prefill 速度 | 严格绑定单一模型和特定硬件范围;作者明确称其为参考实现 |
| Solana x402 / MPP rails | 支付基础设施 | (+) | 面向生产的 Agent 支付吞吐量和批量结算;把 Agent 接入真实交易通道 | 今天的证据来自平台更新,而不是独立运营者复盘 |
| TermiX / agent.family | 商业协议 / 市场 | (+/-) | 多篇帖子和网站文案对托管、身份、任务发现、结算和声誉的描述相当一致 | 讨论串营销色彩偏重;缺乏关于日常运营结果的独立证据 |
| GPT-6 Astra / Codex 客户端工作流 | 前沿模型 + 客户端技术栈 | (-) | 能力足够强,用户持续拿它处理长仓库任务、编排和审查 | 成本归因、配额消耗和按客户端统计的遥测反复显得不清晰 |
整体情绪从对具体产物的明确热情,到对模糊说法的明显不耐烦,不一而足。人们赞赏那些以可检查方式暴露安装、结构、记忆或浏览器控制的工具;而对隐藏成本、验证流程或停止条件的工具则抱有不信任。最主要的迁移趋势,是从“写一个更好的提示词”转向“安装一个更强的 harness”:工作台、skills、浏览器层和记忆模块都在争夺这个 harness 的控制权。最主要的临时应对方式仍然是手工:用户分享提示词、工作流图、仓库链接和截图,因为产品本身还没有充分暴露状态、成本和可靠性的真实情况。
5. 大家在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Omarchy | omacom | 面向 Agent 的 Linux 发行版和工作台 | 为 Agent 密集型日常工作提供可定制的本地环境 | Linux 发行版、shell 工具、键盘优先桌面 | 已发布 | 仓库, 推文(221 个赞、43 条回复、22.9k 次浏览) |
| Orbkit | @zzzzshawn | 用于 Agent 状态 UI 的 WebGL 球体库 | 为构建者提供可复用的 UI 状态,而不必每次都重造“思考/发声”视觉效果 | React、TypeScript、WebGL、shadcn registry | 已发布 | 仓库, 网站, 推文(175 个赞、24 条回复、5.8k 次浏览) |
| botmaker | techjanitor | 生成并认证 Hermes 专业机器人的 skill | 通过强制执行访谈、签字确认、测试和文档流程,防止浅层的人设克隆 | Hermes Agent、SOUL 文件、skill tree、Markdown 文档 | Beta | 仓库, 推文(69 个赞、7 条回复、2.9k 次浏览) |
| BrowserCode | browser-use | 通过 CDP 驱动 Chrome 的原生浏览器编码 Agent | 让 Agent 能在真实浏览器会话中操作,而不是卡在登录墙或仅限 UI 的工作流前 | TypeScript、CDP、Browser Harness、OpenCode fork | Beta | 仓库, 推文(56 个赞、13 条回复、3.1k 次浏览) |
| T3 Code | pingdotgg | 在桌面端、移动端和 Web 上运行多个 Agent 供应商的控制界面 | 相比在不同 CLI 和应用之间来回切换,让多 Agent 工作更容易监督 | Electron、Web 应用、移动应用、供应商 CLI | Beta | 仓库, 推文(84 个赞、18 条回复、7.2k 次浏览) |
| ReasoningBank | google-research | 将失败和成功轨迹提炼为可复用推理策略的记忆框架 | 减少 Web 和 SWE Agent 中重复犯错以及原始日志膨胀 | Python、WebArena、SWE-Bench、具备记忆感知的测试时扩展 | Beta | 仓库, 推文(70 个赞、12 条回复、4.7k 次浏览) |
| pd-bridge | chadhurley25075-png | 面向 DeepSeek-V4-Flash 的异构 prefill/decode 桥接 | 降低本地大模型工作流中的长提示词 prefill 延迟 | Python、vLLM/CUDA、oMLX/Metal、10GbE | Alpha | 仓库, 推文(59 个赞、10 条回复、10.3k 次浏览) |
| TermiX / agent.family | TermiX | 让 Agent 发布任务、竞标、托管、结算并积累声誉的协议和市场 | 赋予 Agent 经济身份与结算闭环,而不再只是孤立工具 | 链上托管、ERC-8004 identity、BSC、Base、Robinhood Chain | Beta | 网站, termix, 推文(86 个赞、99 条回复、1.2k 次浏览) |
Orbkit、botmaker、BrowserCode 和 T3 Code 都符合相同的构建模式:它们并不替代基础模型,而是用更好的界面把模型包裹起来。Orbkit 是从视觉层面这么做,botmaker 从流程层面,BrowserCode 从操作层面,T3 Code 则从管理层面。
pd-bridge 和 ReasoningBank 代表了当天最强的基础设施产物。前者通过把推理角色拆分到异构硬件上来对抗延迟;后者则通过把轨迹转化为可复用的推理资产来减少浪费的工作。
TermiX 的特别之处在于,它试图把 Agent 变成经济参与者,而不只是更好的工具。但与上述仓库相比,今天的公开证据对其机制的证明强于对运营者独立结果的证明,所以这项构建是真实存在的,只是采用证据仍然偏薄。
6. 新动态与值得关注的内容
6.1 从仓库到 skill 的提炼,开始成为可测量的研究方向
@rohanpaul_ai 分享了(12 个赞、8 条回复、1,702 次浏览)展示了 DisCo 的结果:从 1,000 个 ML 仓库中提炼出 5,353 个 skills,并在不改变模型或任务预算的情况下大幅提升 MLE-bench 表现。这很重要,因为它把“skills”重新定义为一种有基准证据支持的性能杠杆,而不只是社区里的封装惯例。
6.2 具备失败感知的记忆,比泛泛而谈的“Agent 记忆”获得了更精确的公开表述
@marfinxx 进一步传播了(70 个赞、12 条回复、4,720 次浏览、82 次收藏)介绍了 ReasoningBank,而最佳回复把启示收束成了更有用的形状:记忆应保留从失败和成功中提炼出的可复用经验,而这些经验还需要围绕“谁写入、谁验证”建立治理。这比此前许多天常见的“Agent 需要记忆”说法具体得多。
6.3 本地长上下文推理出现了具体的异构 prefill/decode 概念验证
@volatilemarkts 发布了(59 个赞、10 条回复、10,343 次浏览、88 次收藏)介绍了 pd-bridge,相关仓库记录了真实的长提示词加速:在不同硬件上预先计算 decoder 已完成的缓存,再通过标准以太网每个 token 只传约 10 KB。该仓库愿意如实记录 bug 和能力边界,因此比一份打磨过的基准宣传更值得注意。
7. 机会在哪里
[+++] 带有硬停止规则和支出可见性的 Agent 管理界面 —— 多个讨论串都收束到同一个痛点:用户已经能启动 Agent,但仍缺少取消、范围限制、验证检查点和成本归因等良好控制。T3 Code 的“Agent 管理器”定位、Codex 使用诊断讨论串,以及关于配额消耗的抱怨,都指向一个围绕委派树、审批、回放和按任务配额核算的产品空缺。这一机会很强,因为需求既体现在对更好控制界面的赞扬中,也体现在对现有控制界面的不满中。
[+++] 保存经过验证经验,而不是原始转录的记忆系统 —— ReasoningBank 和 DisCo 都指向压缩、可复用的工作产物,而不是原始聊天历史。机会在于构建一个面向开发者的记忆层,用来源、过期时间和审批控制来承载模式、反例以及有评估支撑的 skills。这一机会很强,因为当天同时出现了研究证据、公开仓库,以及围绕谁来写入和验证记忆的回复级治理担忧。
[++] 面向跨 Agent 协作的身份、托管和结算通道 —— TermiX、agent.family 和 Solana 支付帖子都指向同一个缺口:Agent 可以生成输出,但仍无法可靠地签约、收款,或在不同界面之间建立可迁移的声誉。市场和模型供应商之外,仍有空间构建一个中立的钱包与托管层。这一机会属中等强度,因为机制越来越清晰,但独立运营者分享的证据仍弱于报告其他部分的工具证据。
[++] 面向 Agent 原生工作流、可检查的本地工作台 —— Omarchy 的热度和 BrowserCode 引发的兴趣,都表明市场需要围绕 Agent 设计、而不是事后改造的环境。机会在于打造一种工作台,把浏览器认证、本地文件、终端访问、权限和审计日志统一起来,而不必让用户手工拼接自己的环境。这一机会属中等强度,因为需求真实存在,但产品边界仍横跨操作系统、浏览器和 harness 多个层次。
8. 要点
- Agent 产品获得关注,靠的是交付一个可检查的界面,而不只是提示词配方。 Omarchy、Orbkit、BrowserCode 和 T3 Code 都是靠提供可安装、可见或可直接操作的东西赢得心智份额。(来源)
- 讨论持续从提示词转向 skills、harness 和受治理的记忆。 Andrew Ng 提出的“模型外围的 harness”、botmaker 的专业机器人流水线、ReasoningBank 和 DisCo 都在强化同一点:更好的 Agent 结果越来越被视为系统设计问题。(来源)
- 重度用户已经在调试遥测和配额消耗,而不只是模型质量。 Codex 使用诊断讨论串和 Astra 配额抱怨说明,对长时间运行的 Agent 工作流来说,成本可见性仍然过于不透明。(来源)
- Agent 商业在支付通道层面比在采用证明层面更具体。 Solana 的 x402 / MPP 公告和 TermiX 流程图让结算机制更容易想象,但公开的运营者证据仍落后于工具类讨论。(来源)