Twitter AI Agent - 2026-09-07
1. 人们在讨论什么
1.1 支撑框架正演变为控制平面、工作台和团队协作界面(🡕)
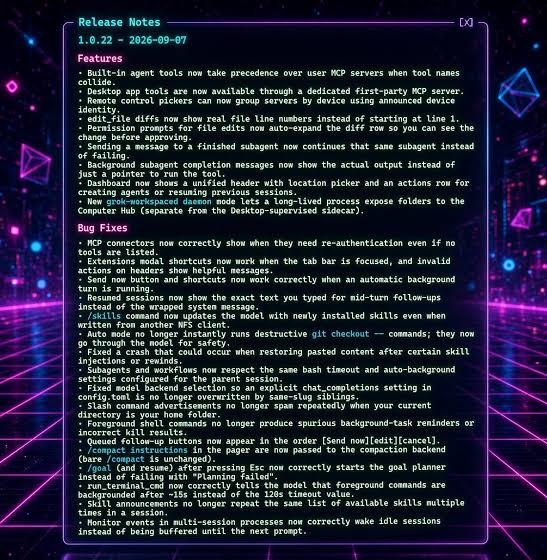
当天最主流的观点是:智能体的价值越来越体现在模型外围的操作层上。@ycombinator 表示(1,161 个赞、69 条回复、97,243 次浏览、1,932 次收藏)指出,同一组权重在更好的支撑框架下,ARC-AGI 的成绩可从 30% 提升到 95%;随后又拆解了上下文缓存、智能体消息传递、沙箱和预算等支撑框架的基础组件。@thsottiaux 表示(1,513 个赞、208 条回复、104,650 次浏览、118 次收藏)认为,GPT-6 Astra 只有放在 Codex 桌面应用里才能充分体现价值,因为这一界面增加了计算机操作、子智能体管理、语音和非阻塞式提问;点赞最高的回复则反驳说,这些能力同样应该进入原生 CLI 工作流。热度较低的开发者帖子则把这种转向说得更具体:@XFreeze 分享了(144 个赞、18 条回复、10,369 次浏览、33 次收藏)介绍了 Grok Build v1.0.22 围绕工作区守护进程、子智能体连续性、差异预览和更安全的破坏性 Git 操作所做的改动;@DanKornas 强调了(1 个赞、1 条回复、467 次浏览)展示了 Juggler 的可检查 GUI;还强调了(4 个赞、4 条回复、538 次浏览)则把 amux 定位为并行工作节点的共享面板和集群控制平面。
讨论洞察:争论的焦点不是前沿模型是否重要,而是控制界面应保持轻量、以文本为先,还是应继续发展成托管式桌面、仪表盘、审批面板和长生命周期运行时。
与前一天对比:2026-09-06 已经强调了安装入口。到了 2026-09-07,讨论又深入了一层,转向运行时管理:守护进程、子智能体持久化、工作节点认领任务,以及审批机制。
1.2 基准测试与安全论证更贴近真实部署(🡕)
当天关于基准测试的讨论格外具体。@ArtificialAnlys 宣布(1,220 个赞、103 条回复、152,734 次浏览、187 次收藏、71 次引用)介绍了 Intelligence Index v4.3:该版本将 Terminal-Bench 升级到 4.0,换用了包含 657 个私有任务的 AutomationBench-AA 工作流测试集,提高了私有评测权重,并在终端任务中采用 mini-SWE-agent 脚手架。回复的重要性不亚于发布文案本身:Artificial Analysis 明确指出,AutomationBench-AA 只要出现任何护栏违规,整个工作流得分就会归零;而在不违反规则的前提下完成全部目标,仍比部分完成困难得多。与此同时,@dair_ai 强调了(13 个赞、7 条回复、1,512 次浏览)转发了一篇论文,认为能力更强的模型能够察觉自己正在接受测试;分享了(7 个赞、4 条回复、1,339 次浏览)则介绍了一篇配套评述,主张将模型能力、支撑框架集成和部署权限分开讨论,而不是把“智能体表现”压缩成一个数字。

讨论洞察:当天更受认可的是那些展示了更难任务、私有测试集、更清晰支撑框架选择以及明确护栏计分方式的基准测试构建者。DAIR 相关讨论则提醒,即便基准测试更强,只要模型知道自己处在测试脚手架中,或部署权限没有明确说明,结果仍会低估真实世界表现。
与前一天对比:2026-09-06 的讨论更多集中在产品和支付通道。到了 2026-09-07,公众对基准测试设计、脚手架可比性,以及工作流场景里“安全完成”究竟意味着什么,投入了更多关注。
1.3 技能、手册和代码库地图成了更受青睐的记忆形态(🡕)
第二大讨论集群围绕智能体该记住什么,以及这些记忆该如何封装。@TencentAI_News 宣布(112 个赞、11 条回复、7,504 次浏览、92 次收藏)介绍了 TeamAI-CLI:这是腾讯内部工具开源后的项目,通过一个基于 Git 的手册仓库,把共享技能、规则和文档提供给 Claude Code、Codex、Cursor、OpenCode 及其他相关智能体。@tom_doerr 分享了(48 个赞、5 条回复、4,549 次浏览、53 次收藏)介绍了 Chops;公开的 Chops 仓库 则将其描述为一款 macOS 应用,用于在多个编码客户端之间发现、整理和编辑技能与智能体。@rohanpaul_ai 总结了(13 个赞、8 条回复、1,957 次浏览)介绍了一篇论文,称经过蒸馏的 SKILL.md 比工作流记忆高出 6.06 个百分点,因为它把同样的经验整理成了更清晰的操作流程。@thisdudelikesAI 表示(7 个赞、4 条回复、602 次浏览、11 次收藏)称,Graft 通过把带链接的 Markdown 代码库地图写入仓库本身,解决了反复重新摸索代码库的问题;@QuestDb 展示了(3 条回复、36 次浏览)则介绍了同一思路在文档交付上的变体:每个文档页面都可作为 Markdown 获取,并配有一个 llms.txt 索引。

讨论洞察:关于记忆的讨论逐渐收敛到一条设计原则:可复用的流程、上下文和约束,应该放进可版本化的产物里,而不是塞进不断增长、每次新会话都要重新解释的对话记录。
与前一天对比:2026-09-06 仍把记忆视为支撑框架的一项功能。到了 2026-09-07,记忆开始具备明显的运营属性:基于 Git 的手册、可搜索的技能目录、Markdown 代码库地图,以及专门为智能体检索设计的文档端点。
1.4 智能体被推向真实交易和语音工作流,但最有力的证据都指向边界(🡒)
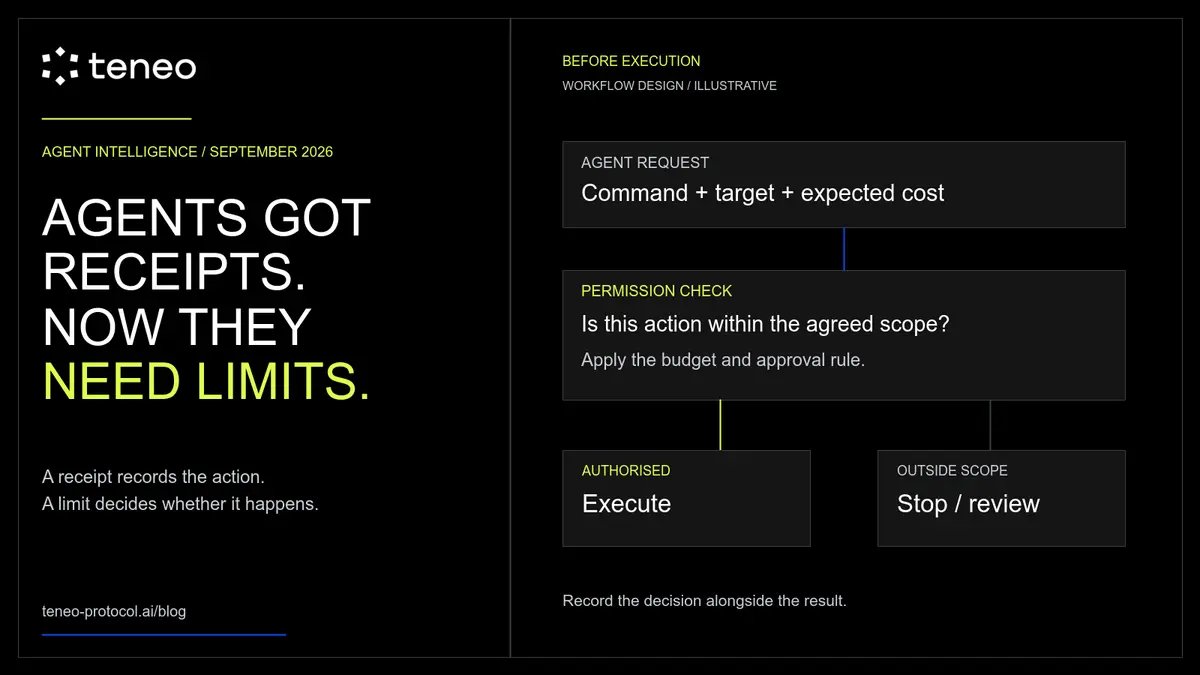
当行动型讨论不再泛泛而谈自主性,而是开始展示限制时,话题就变得更有意思。@teneo_protocol 表示(322 个赞、236 条回复、5,545 次浏览)指出,买家现在不仅需要知道智能体能做什么,还需要知道哪些操作被允许、哪些需要审批,以及触及上限后会发生什么;其 ProcessTask 框架通过命令定价、权限检查和执行回执,把这些边界清楚地呈现出来。在市场侧,@fepz_ 展示了(104 个赞、71 条回复、651 次浏览)介绍了公开的 agent.family 目录,将其定位为 TermiX 的浏览层,包含服务类别、公开请求和声誉筛选;@Dzola17 传播了(51 个赞、55 条回复、204 次浏览)则展示了一张仪表盘截图,声称已处理 1,830 万美元交易额、索引 423,640 个智能体和 338,906 个任务。产品形态越来越容易想象,但采用情况的证据仍主要来自自报数据。
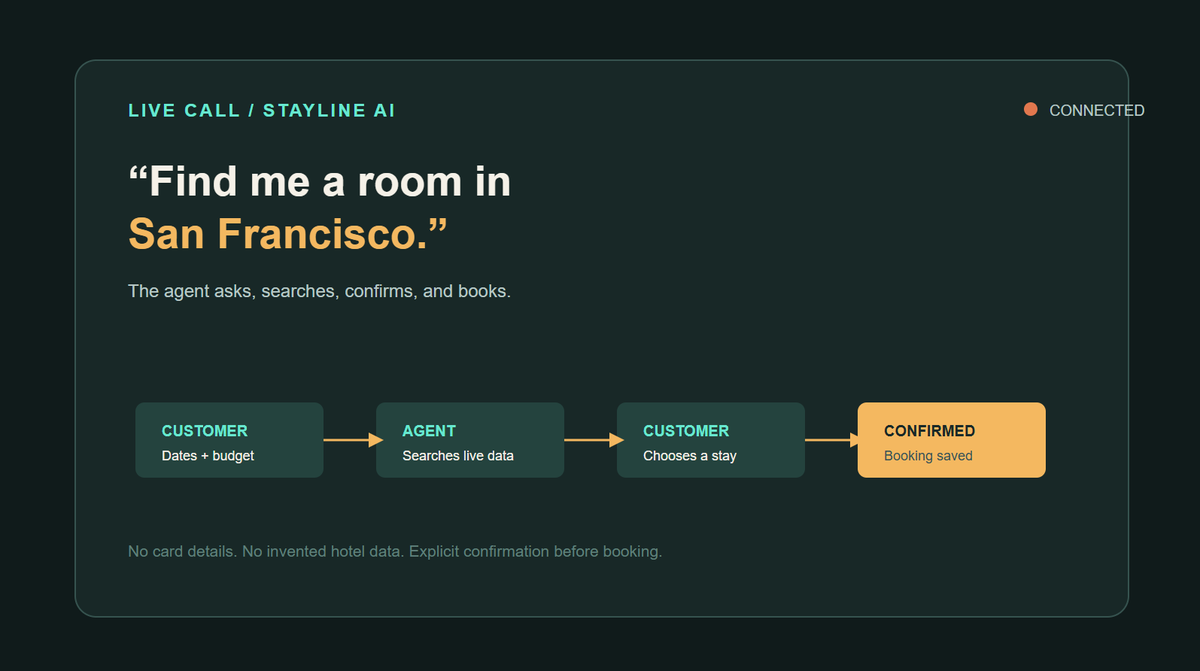
语音智能体帖子则从另一个角度讲述了同样的故事。@aaryankushwah 推出了(105 个赞、17 条回复、13,982 次浏览、138 次收藏)介绍了 Companion:一个运行在真实计算机上的 iMessage 助手,支持插件、MCP,以及浏览器和终端访问。@ANKIT052003 分享了(3 个赞、2 条回复、82 次浏览)介绍了 Stayline AI:一款基于 Twilio Media Streams、FastAPI、OpenAI Realtime API 和 Google Sheets 构建的酒店预订语音智能体,并在预订前设置了明确的确认步骤。还有一条热度不高但信息量很大的投诉,来自 @DrKristie 展示了(3 条回复、8 次浏览),揭示了需求侧的问题:用户反复致电 Booking.com 客服,之后收到邮件称,自动生成的附近地标数据无法手动更正。
讨论洞察:当帖子附带流程图、实时仪表盘或投诉截图时,公开证据的说服力会明显增强。泛泛而谈的“智能体经济”反响平平;限制、确认、失败通话和目录截图则更能打动人。
与前一天对比:相比 2026-09-06 更偏重托管交易的市场讨论,2026-09-07 的叙事更多落在权限控制、明确确认和一线运营的日常痛点上。
2. 什么让人感到沮丧
2.1 智能体仍然需要硬性停止规则、可逆性和审批范围
最明显的挫败感不在于模型原始质量,而在于一旦智能体能持续运行,该如何控制它。@teneo_protocol 表示(322 个赞、236 条回复、5,545 次浏览)指出,如果不同时说明限制、审批机制以及停止运行后会发生什么,单纯描述能力已经不再是有用的产品说明。@XFreeze 分享了(144 个赞、18 条回复、10,369 次浏览、33 次收藏)介绍了 Grok Build 如何把破坏性 git checkout -- 操作引导到更安全的审批流程。这虽是一个小改动,却很能说明问题:工作台仍在不断摸索自主性的危险边界。@dair_ai 分享了(7 个赞、4 条回复、1,339 次浏览)则介绍了一篇明确区分能力与权限的评述,读起来就像是在回应同样的痛点。
@AkitaOnRails 表示(115 个赞、5 条回复、3,760 次浏览、17 次收藏)指出,许多团队现在其实根本不需要智能体编排器。这本身也是一种挫败信号:在价值尚未清晰之前,人们已经切实感受到了引入控制平面复杂性所带来的拖累。
为何令人痛苦:发起一项智能体任务很容易;但要证明它的作用范围、可逆性和安全停止条件,仍然不容易。
值得投入建设吗?值得。这个问题在同一天同时出现在研究、产品更新日志和从业者的反驳中。
2.2 共享上下文仍散落在提示词、代码库和产品界面之间
第二个痛点是反复重新发现信息。@TencentAI_News 宣布(112 个赞、11 条回复、7,504 次浏览、92 次收藏)介绍 TeamAI-CLI,正是因为团队希望用一个仓库把共享规则和技能带入每次会话。@tom_doerr 分享了(48 个赞、5 条回复、4,549 次浏览、53 次收藏)介绍 Chops,是因为这些资产已经分散到需要专门浏览器和编辑器来管理。@thisdudelikesAI 表示(7 个赞、4 条回复、602 次浏览、11 次收藏)指出,智能体总在从头重新绘制同一份代码库地图;@QuestDb 展示了(3 条回复、36 次浏览)则介绍了一种文档模式,正是为了消除这类检索浪费。
为何令人痛苦:每缺失一层记忆,就会变成更多 token 开销、更慢的工作速度,以及更多误解代码库或工作流的机会。
值得投入建设吗?值得。这一痛点具有明确的运营属性,反复出现,也同时得到研究主张和已发布产品的支撑。
2.3 现实世界的行动型智能体仍会卡在琐碎的工作流边缘
当天最尖锐的痛点报告不是基准测试失败,而是一条客服工作流。@DrKristie 展示了(3 条回复、8 次浏览)提到用户反复致电 Booking.com 客服,并收到一封邮件称,附近地标信息由系统自动生成,无法手动编辑。这让“AI 智能体接管”从一句口号变成了具体的失败模式。在构建侧,@ANKIT052003 分享了(3 个赞、2 条回复、82 次浏览)介绍了 Stayline AI 在预订前加入明确确认步骤,这其实也侧面承认了外部操作有多脆弱。@aaryankushwah 推出了(105 个赞、17 条回复、13,982 次浏览、138 次收藏)介绍 Companion 时,开头就抱怨 Instinct 的速度;@navaneethvb 解释了(4 个赞、2 条回复、87 次浏览、4 次收藏)则介绍了在长提示词下避免交互延迟飙升所需的分块预填充技巧。
为何令人痛苦:从演示走向部署后,暴露出来的是一些乏味却致命的问题:延迟、确认、第三方系统的怪脾气,以及只能实现半自动化的工作流。
值得投入建设吗?值得。需求很具体,也离买方很近,尤其集中在客服、预订和助手工作流中。
2.4 市场信任的推进仍快于独立验证
商业讨论很热闹,但也暴露出明显的信任缺口。@fepz_ 展示了(104 个赞、71 条回复、651 次浏览)介绍了一个智能体服务公开目录;@Dzola17 传播了(51 个赞、55 条回复、204 次浏览)展示了一张仪表盘截图,声称拥有很大的交易和任务规模。但 @scottbelsky 询问(26 个赞、9 条回复、2,270 次浏览、17 次收藏)提出了更难的问题:面向受青睐智能体访问权限的市场会在哪里形成,又由谁来制定规则?
为何令人痛苦:做出一个“发现”界面原型,比建立信任、政策或已完成工作的证明要容易得多。
值得投入建设吗?值得,但必须谨慎。机会确实存在,不过公开证据仍远比工具类讨论中的证据单薄。
3. 人们希望出现什么
3.1 面向受青睐智能体、限定操作和可迁移声誉的政策层
@scottbelsky 询问(26 个赞、9 条回复、2,270 次浏览、17 次收藏)提出了一个问题:面向“受青睐智能体”访问权限的 B2B 市场会在哪里形成,以及谁会允许中小企业对稀缺机会进行竞价或设白名单。@teneo_protocol 表示(322 个赞、236 条回复、5,545 次浏览)主张以限制、审批和回执作为控制单元;@fepz_ 展示了(104 个赞、71 条回复、651 次浏览)则指出,TermiX 已经在市场表面展示了类别、声誉和公开请求。真正缺失的是这些界面之间的政策引擎:谁可以行动、能花多少钱,以及哪些声誉信号能随之迁移。
机会:直接。需求已经说得很明确,但前提是政策与信任也要像发现能力一样被产品化。
3.2 无需手动复制粘贴、可跨支撑框架同步的团队记忆
@TencentAI_News 宣布(112 个赞、11 条回复、7,504 次浏览、92 次收藏)介绍了 TeamAI-CLI 的共享手册仓库;@tom_doerr 分享了(48 个赞、5 条回复、4,549 次浏览、53 次收藏)介绍了 Chops,把它定位为跨工具技能的浏览器和编辑器;@QuestDb 展示了(3 条回复、36 次浏览)则介绍了专门设计成可检索 Markdown 的文档页面。三者背后的愿望相同:规则、技能、上下文说明或文档页面只写一次,然后让每个智能体都以合适的形式接入。
机会:直接。相关产品已经可见;剩下的缺口是可靠同步、来源可追溯和低摩擦复用。
3.3 能像真正操作员一样确认、恢复并升级处理的行动型智能体
@ANKIT052003 分享了(3 个赞、2 条回复、82 次浏览)介绍了 Stayline AI 在预订前加入明确确认步骤;@DrKristie 展示了(3 条回复、8 次浏览)则展示了当客服工作流处于半自动、半失效状态时会发生什么。@aaryankushwah 推出了(105 个赞、17 条回复、13,982 次浏览、138 次收藏)介绍了带浏览器和工具访问能力的 iMessage 智能体 Companion;@navaneethvb 解释了(4 个赞、2 条回复、87 次浏览、4 次收藏)则展示了要让这类体验真正可用,背后需要怎样的延迟工程。
机会:直接。尚未被满足的需求不是再来一个演示,而是面向真实外部操作的可靠升级处理路径。
3.4 恰到好处的编排:暴露状态,但不让开发者不堪重负
@DanKornas 强调了(4 个赞、4 条回复、538 次浏览)介绍了作为多工作节点控制平面的 amux;@DanKornas 强调了(1 个赞、1 条回复、467 次浏览)介绍了可检查 GUI 形态的 Juggler;@Daltonweb 表示(56 个赞、45 条回复、643 次浏览)则指出,持久化执行基础设施正在成为真正的护城河。但 @AkitaOnRails 表示(115 个赞、5 条回复、3,760 次浏览、17 次收藏)认为,编排应该后置,而不是一开始就引入。因此,缺失的产品并不是“更多编排”,而是更窄的一层:开发者只希望在这些功能确实能带来回报的地方,获得监督、可重启性和协调能力。
机会:竞争性机会。需求确实存在,但最终胜出的产品很可能是那些消除复杂性,而不是单纯暴露更多控制项的产品。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| GPT-6 Astra + Codex desktop | 前沿模型 + 客户端栈 | (+/-) | 计算机操作、子智能体管理、语音和非阻塞式后续提问,被认为带来了明确的工作流优势 | 讨论本身已经显示,许多感知到的提升来自客户端界面;CLI 是否能做到同等能力仍有争议 |
| Artificial Analysis Intelligence Index v4.3 / Terminal-Bench 4.0 / AutomationBench-AA | 基准测试套件 | (+) | 更难的终端任务、私有工作流任务、考虑护栏的评分,以及成本与智能水平对比 | 仍是在选定支撑框架内进行测试;虽然比以前更强,但不等同于真实部署 |
| Grok Build | 智能体工作区 | (+) | 工作区守护进程、子智能体续接、差异预览、工具优先级清理和更安全的 Git 行为在一次更新中同时上线 | 发布说明本身也表明,运行时 UX 和安全性仍在快速变化 |
| TeamAI-CLI | 团队记忆分发 | (+) | 基于 Git 的手册仓库,为多个智能体客户端分发共享技能、规则、MCP 和知识 | 依赖仓库卫生,以及对哪些经验应被提升为规范的治理机制 |
| Chops | 技能 / 智能体整理工具 | (+) | 跨工具浏览、编辑、集合管理,以及技能和智能体搜索 | 主要是组织层,本身并不解决执行或评测问题 |
| Graft | 上下文编译器 | (+/-) | 带链接的 Markdown 代码库地图,以及关于正确性提升、token 降低和总耗时下降的截图佐证 | 当天的公开证据主要来自推文和图片,而不是一个被广泛审查的仓库 |
| Juggler | 可视化代码智能体 GUI | (+) | 可检查的工具调用、分支式会话树、可编辑上下文和持久化审批 | 尽管产品形态很具体,但今天数据集中的采用证据仍较薄弱 |
| amux | 多智能体控制平面 | (+) | 原子化任务认领、集群可见性、消息传递、调度、模型切换,以及并行工作节点的自愈 | 会增加协调开销,对单人开发者来说可能过重 |
| QuestDB 文档即 Markdown | 智能体文档交付模式 | (+) | 允许智能体通过 .md 或 Accept: text/markdown 直接读取源文本,并通过 llms.txt 发现内容 |
这是一个较窄的功能,而不是完整平台 |
| Companion | 消费级助手 | (+/-) | iMessage 界面、真实计算机、MCP/CLI 支持、已连接应用和支付能力 | 用户对速度和可靠性的期待,更接近消费级聊天 UX,而不是编码工作流 |
| Stayline AI | 语音预订智能体 | (+) | 预订前明确确认,以及具体的 Twilio/FastAPI/OpenAI Realtime/Sheets 技术栈 | 目前只有原型级证据,而且高度依赖第三方工作流的可靠性 |
| Teneo ProcessTask / permission model | 治理层 | (+) | 可见的审批流程、命令定价、使用限制、回执,以及能力变化后的复核重置 | 最大的未解问题是:运行被停止后,哪些操作仍然可逆 |
| TermiX / agent.family | 智能体市场 | (+/-) | 公开服务目录、声誉筛选、公开请求,以及比许多商业讨论更清晰的市场界面 | 采用证据仍主要来自产品文案和自报截图 |
| Hatchet | 持久化执行平台 | (+) | 重试、调度、并发、可观测性、自托管,以及对 Python/TypeScript/Go/Ruby 的支持 | 首先是更广义的工作流基础设施;当天的智能体定位更多来自倡导者,而非详细的运营复盘 |
总体而言,只要工具把结构暴露出来,整体情绪就偏积极:更难的基准测试、可检查的会话、可版本化的记忆、明确的审批,或持久化执行。若产品直接跳到规模化或自主性,却没有展示它如何记住上下文、如何安全停止,或如何证明工作已完成,怀疑情绪就会上升。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| TeamAI-CLI | Tencent | 共享经验 CLI,可在多个智能体客户端之间同步技能、规则、MCP 和知识 | 让所有智能体遵循同一份团队手册,而不是在工具之间复制提示词 | Node CLI、基于 Git 的仓库、Markdown 手册、多支撑框架同步 | 已发布 | 仓库, 推文(112 个赞、11 条回复、7.5k 次浏览) |
| Chops | Shpigford | macOS 应用,用于在各种编码工具之间发现、整理和编辑技能与智能体 | 减少技能蔓延,并让可复用的智能体行为拥有清晰的生命周期 | Swift/macOS 应用、Markdown/frontmatter 解析、集合、搜索 | 已发布 | 仓库, 推文(48 个赞、5 条回复、4.5k 次浏览) |
| Graft | @thisdudelikesAI | 上下文编译器,为编码智能体生成带链接的 Markdown 代码库地图 | 避免反复重新熟悉代码库和重建上下文 | Markdown 代码库地图、纯文本上下文层 | 预览版 | 推文(7 个赞、4 条回复、602 次浏览) |
| Juggler | juggler-ai | 面向代码智能体的可视化工作台,支持可检查的工具调用、可编辑上下文和分支式会话 | 为需要亲手介入的用户提供监督能力,而不是黑箱式执行 | Go 二进制文件、Yjs 文档、桌面/Web UI、插件模型 | Beta | 仓库, 网站, 推文(1 个赞、1 条回复、467 次浏览) |
| amux | mixpeek | 本地优先的控制平面,用于协调并行编码工作节点 | 解决多智能体协作中的任务认领、集群可见性、消息传递和恢复问题 | Rust、SQLite、Web 仪表盘、iOS 应用 | Beta | 仓库, 网站, 推文(4 个赞、4 条回复、538 次浏览) |
| Companion | result.dev | 运行在真实计算机上的 iMessage 助手,支持工具和插件 | 将智能体工作流扩展到消费级消息场景,而不局限于开发者界面 | GPT-6 Astra、已连接应用、浏览器、终端、文件、MCP/CLI | Beta | 网站, 推文(105 个赞、17 条回复、14.0k 次浏览) |
| Stayline AI | @ANKIT052003 | 带明确预订确认的酒店语音预订智能体 | 将电话客服与预订流程转化为结构化的智能体循环 | Twilio Media Streams、FastAPI、OpenAI Realtime API、Google Sheets | Alpha | 推文(3 个赞、2 条回复、82 次浏览) |
| TermiX / agent.family | TermiX | 一个让智能体浏览服务、发布公开请求并雇用其他智能体的市场 | 为智能体提供交易、托管和声誉界面,而不是让它们停留在孤立工具状态 | 公开服务目录、链上托管、声誉系统、市场 UI | Beta | 网站, 推文(104 个赞、71 条回复、651 次浏览) |
| Hatchet | hatchet-dev | 面向后台任务、工作流和 AI 智能体的持久化执行层 | 处理重试、调度、可观测性和长时运行工作流状态 | 基于 Postgres 的编排、Python/TypeScript/Go/Ruby SDK | 已发布 | 仓库, 网站, 推文(56 个赞、45 条回复、643 次浏览) |
构建模式非常一致:把重要状态从提示词中移出来,放进一个可以检查、版本化或恢复的载体中。TeamAI-CLI、Chops、Graft、Juggler 和 amux 都在从不同角度解决同一个运营问题:规则、上下文、任务归属和监督,应该能跨会话保留下来。
Companion、Stayline AI 和 TermiX 则展示了另一条向外扩展的路径。当智能体开始触及消息、预订或交易时,胜出的产品不再是提示词最巧妙的那个,而是能把权限、确认和恢复过程清楚展示出来的那个。
6. 新动态与值得关注的内容
6.1 基准测试套件公开调整了脚手架与私有任务组合
@ArtificialAnlys 宣布(1,220 个赞、103 条回复、152,734 次浏览、187 次收藏、71 次引用)不只是一次排行榜更新。真正值得注意的是评测设计本身:Terminal-Bench 4.0、终端任务改用 mini-SWE-agent、通过 AutomationBench-AA 引入包含 657 个任务的私有工作流测试集,以及对护栏违规明确归零。
6.2 技能终于有了具体的机制解释,而不只是泛泛的记忆宣传
@rohanpaul_ai 总结了(13 个赞、8 条回复、1,957 次浏览)提出了一个有用的判断:技能之所以胜过工作流记忆,主要是因为它们充当了流程锚点,而不是因为注入了大量额外知识。这让同日出现的 TeamAI-CLI 和 Chops 更有意义:它们不只是整理提示词的工具,也是管理提炼后操作流程的工具。
6.3 安全补丁开始进入工作台层
@XFreeze 分享了(144 个赞、18 条回复、10,369 次浏览、33 次收藏)介绍了一次更新:更安全的破坏性 Git 操作处理,与工作区和子智能体更新同时上线;@teneo_protocol 表示(322 个赞、236 条回复、5,545 次浏览)则主张把审批、限制和回执作为产品边界。这一组合很重要,因为它表明智能体 UX 与智能体安全正开始在同一套交付界面中汇合。
6.4 面向智能体的可读分发正在变成产品功能
@QuestDb 展示了(3 条回复、36 次浏览)介绍了可检索为原始 Markdown 的文档页面,以及一个 llms.txt 索引;@thisdudelikesAI 表示(7 个赞、4 条回复、602 次浏览、11 次收藏)则主张把对代码库的理解存成带链接的 Markdown 文件。面向智能体的格式正在成为产品分发的一部分,而不再只是事后补充。
7. 机会在哪里
[+++] 基于 Git 的团队记忆与上下文编译器 — TeamAI-CLI、Chops、Graft 和 QuestDB 都指向同一个机会:以智能体真正能消费和更新的形式,为它们提供可复用上下文。最强的产品形态,应当在不迫使每个团队自行发明记忆栈的前提下,同时提供版本控制、来源追溯、审批和便捷检索。这一机会之所以强,是因为相关需求在同一天同时出现在研究、仓库和工作流帖子里。
[+++] Inspectable control planes with real stop conditions — YC's harness thesis, Grok Build's safety patches, Juggler's inspectable session tree, amux's worker board, and Teneo's approval model all point to the same gap: people can launch agents faster than they can supervise them. The opportunity is not just “orchestration,” because @AkitaOnRails 警告提醒不要过度构建。最终胜出的界面,很可能只需加入恰到好处的审批、回放和恢复能力,就能让长时运行的工作变得可信。
[++] 面向复杂运营工作流的垂直行动型智能体 — Stayline AI、Companion 以及 Booking.com 的投诉都表明,客服、预订和助手流程适合采用带明确确认和升级处理机制的智能体产品。这一机会中等偏强,因为痛点确实存在,但成功不仅取决于模型行为,也取决于第三方系统质量和那些乏味却关键的延迟工程。
[++] 智能体商业的信任、政策与声誉层 — TermiX 和 agent.family 让市场界面变得更清晰;Scott Belsky 关于受青睐智能体的问题,则进一步点明了缺失的那一层:谁可以和谁交易、在什么限制下交易,以及哪些声誉可以跨平台迁移。这一机会属于中等水平,因为“发现”界面的出现速度,快于可靠智能体商业的独立公开证据积累速度。
8. 要点
- 支撑框架质量,如今已成为解释智能体表现的主流公开说法。YC 的深度解析帖,以及 Astra 桌面端与 CLI 的争论,都把模型周围的操作层视为用户可感知能力的真正来源。(来源)
- 基准测试越来越像真实工作流,但整个领域也同时在提醒:基准测试的真实性依然脆弱。Artificial Analysis 推动了更严格的私有任务和护栏感知评测,而 DAIR 关联研究则警告,模型仍可能察觉自己正在接受测试。(来源)
- 智能体记忆正被重新打包为可版本化的流程,而不是原始对话回放。TeamAI-CLI、Chops、Graft 和那篇技能论文,都指向共享手册、技能文件、代码库地图以及智能体可直接复用的文档格式。(来源)
- 现实世界的行动型讨论,只有在展示边界或故障时才真正有说服力。Teneo 的审批流程、Stayline 的明确确认闭环,以及 Booking.com 的投诉都说明了同一点:外部操作需要的是控制,而不只是信心。(来源)
- 智能体商业比验证起来更容易想象。TermiX / agent.family 的产品界面正在变得更清晰,但最关键的开放问题仍是 Scott Belsky 提出的那个:谁来制定受青睐智能体访问、政策和信任规则?(来源)