Twitter AI Agent - 2026-09-11
1. 人们在讨论什么
1.1 AI 工程正在成为一门可度量的运营学科(🡕)
最强的一组讨论认为,AI 工程不是单纯写提示词,而是在明确控制、预算和验证机制下运行构建闭环。至少有四条有分量的内容收敛到了同一种模式:把重复工作沉淀为可强制执行的系统行为,先量化瓶颈,再让智能体迭代。
@AndrewYNg 指出(481 个赞、43 条回复、28,500 次浏览、598 次收藏)认为,如今的 AI 工程能力,意味着要决定“构建什么”,并亲自推动整个构建闭环。最有价值的回复把这一抽象表述落到了操作层面:有人指出,闭环出问题往往不在模型选择,而在于缺少评测、写入工具前没有撤销路径,以及审批责任归属不清;也有人说,写作或写代码变便宜了,但审查、CI 和预发布环境的实际耗时并没有下降。
@UberEng 报道(24 个赞、2,840 次浏览、19 次收藏)称,Uber Eats 通过“测量、定位、修复、验证”闭环,将搜索延迟降低了一半。在这个过程中,AI 编码智能体拉取生产环境性能分析数据、提出修复方案、创建 PR,并运行延迟基准测试。相关工程文章补充了具体做法:移除错误的 DAG 依赖、拆分 hydration 以便排序更早开始、对慢请求采用 hedging,并用快速评测让优化闭环持续运转。
@itsharmanjot 分享(7 个赞、5 条回复、455 次浏览、5 次收藏)介绍了 Spotify 内部的 Claude Code 配置:它把大文件读取和基于模式匹配的代码生成路由给更便宜的工作器,而不是让昂贵的前沿模型吞下所有内容。关键不只是据称减少了 90% 的 token,更在于这一做法为何能持续生效:Spotify 起初先在 CLAUDE.md 中给出文字说明,但后来发现建议性指令可能被忽略,于是把规则移到了 pre-tool hook 中。

讨论洞察: 反复出现的诉求是强制执行和可核验证据,而不是更精巧的提示词技巧。真正有用的边界在于,一条规则是否会改变智能体下一步能做什么,而不是它写在 Markdown 文件里是否好看。
与前一天对比: 2026-09-10 的讨论将托管式框架视为一种产品界面。到了 2026-09-11,话题扩展为一门带有明确成本控制、hooks 和验证闭环的运营学科。
1.2 智能体监督智能体:从可观测性走向主动管理(🡕)
第二组讨论把话题从被动记录推向主动监督。反复出现的观点是:当大量智能体同时运行时,下一层产品不该只是另一个模型,而应是一个能够重启任务、捕捉回归问题,并把追踪记录转化为修复动作的系统。
@XFreeze 声称(217 个赞、22 条回复、9,578 次浏览、154 次收藏)称,一名 xAI 工程师现在运行着五个专用工程机器人,管理 200 多个云端编码智能体;这些机器人会检查对话记录和截图,每 30 分钟查看失败的 CI 和合并冲突,并把任务退回,直到达到目标。配图展示了 “Grok Bot for Engineering” 页面,但回复质疑其中缺失的经济性与判断层面;有人称,如果问责关系不够清晰,这种规模只是在“博眼球”。
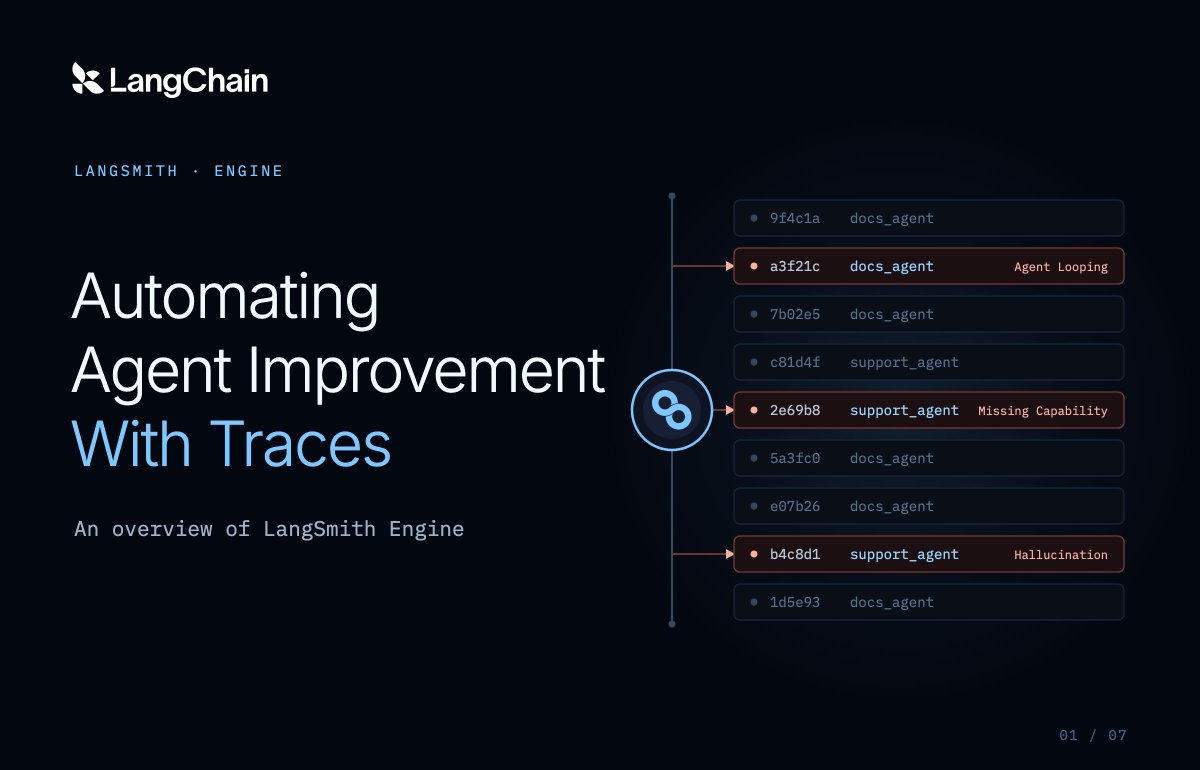
@AdamRLucek 描述(29 个赞、3 条回复、4,317 次浏览、22 次收藏)将 LangSmith Engine 称为“面向智能体工程的智能体”:它从生产追踪记录中寻找反复出现的故障,诊断根因并提出修复方案。公开文档与讨论串描述的闭环一致:发现问题,结合追踪记录和代码进行诊断,提出 PR,生成用于验证的数据集示例;如果后续追踪记录再次匹配同一故障,还会自动重新打开问题。
@mirku21 强调(9 个赞、173 次浏览、6 次收藏)介绍了 NVIDIA 的 ProRL Agent 论文。该方案将 rollout 基础设施与 RL 训练分离,使长时间运行、需要调用工具的智能体执行不再阻塞 GPU 密集型的策略更新。论文配图展示了由 trainer、rollout service 和 sandbox environment 组成的三层设计,并通过异步 API 连接起来,进一步印证了同一设计直觉:监督与执行基础设施需要各自独立的产品层。
讨论洞察: 即便是乐观的回复,也画出了同一条界线:智能体变多,并不意味着不再需要判断力。真正持久的收益,来自另一套流程或另一个智能体去检查产物、记录故障模式,并决定工作是否该继续。
与前一天对比: 2026-09-10 强调来源追踪和运行时控制。今天的话题又往前走了一步,转向智能体的主动中层管理:重启任务、分诊追踪记录,并自动闭合反馈环。
1.3 记忆正转向 schema、世界模型与迁移纪律(🡕)
记忆仍是一个大主题,但讨论框架变了。今天最有力的证据,不再把记忆当作泛化的“第二大脑”,而是强调结构化状态、模型迁移风险,以及组织范围内的协作规则。
@hliriani 认为(145 个赞、22 条回复、51,121 次浏览、106 次收藏)认为,CRM 是构建企业世界模型最实际的落点。@nandanpri 的一条回复补充了最清晰的操作经验:当上下文散落在各个表格中时,智能体会凭空捏造账户;当提示词挂在 CRM 对象上时,那套看似乏味的 schema 反而成了最耐用的基础。
@DhravyaShah 宣布(64 个赞、14 条回复、5,887 次浏览、30 次收藏)称,supermemory 将停止提供 company-brain 和 personal-brain 产品,转而专注于面向智能体的前沿 memory API。回复询问了淘汰策略,并确认这套记忆栈仍可在本地运行,这也把取舍讲得更清楚:相比面向终端用户的广义“大脑”产品,持久记忆基础设施更有说服力。
@rohanpaul_ai 揭示(1 个赞、2 条回复、986 次浏览)提到了一篇互动不高但内容扎实的 LinkedIn 论文,主题是记忆可移植性。其关键结果非常具体:固定 schema 的记忆在更换模型后,比自由格式笔记保留效果得多;而在同一个检索索引中混合新旧 embeddings,只挽回了完整重建所带来 11.90 个百分点提升中的 4.96 个百分点。

@tetsuoai 认为(325 个赞、65 条回复、25,147 次浏览、115 次收藏)认为,很多编码智能体配置都应该重置,因为其中的旧记忆、hooks、配置和 skill packs 是为已经不存在的模型写的。回复把这一点归纳得更清楚:真正有害的是陈旧的智能体技术债,而不是抽象意义上的“记忆”。
讨论洞察: 最有力的记忆论点都围绕故障模式展开:虚构实体、过时指引、混合 embeddings,以及模型变化后在语法上还“活着”、但在语义上已经失效的记忆。
与前一天对比: 2026-09-10 关注的是可审查的记忆和技能来源。到了 2026-09-11,关于记忆的讨论更偏向 schema-first,也更有迁移意识,企业视角更加明确。
1.4 智能体市场的机制更具体了,但需求证据仍然偏薄(🡕)
商业化这一组讨论比前几天更广,也更具体。人们谈到了可移植身份、托管支付、声誉、GTM 服务,甚至智能体的 runway,但公开证据仍主要来自市场搭建者和推广者,而非独立运营者。
@DOLAK1NG 认为(109 个赞、36 条回复、4,937 次浏览)认为,智能体的声誉应该能跨平台迁移,而不是被困在单一应用中。配图把这一主张说得比文字更具体:AACP 为智能体分配 ERC-8004 链上身份,并在声誉注册表中记录完成率、准时交付率、评测通过率、争议结果和验证等级。

@circle 列出(92 个赞、21 条回复、6,085 次浏览)展示了一个更接地气的市场层:GTM 服务帮助智能体寻找潜在客户、补全联系人信息并验证邮箱,配图中直接点名了 Apollo、Clado、Findymail、Hunter 和 Icypeas。回复立即追问完整的串联示例,以及付费服务返回错误数据时有什么追索机制。
@IntCyberDigest 报道(96 个赞、14 条回复、6,756 次浏览、28 次收藏)称,iLands 上名为 Pip 的智能体曾给 Henry Shevlin 发冷邮件,询问是否有小额付费工作,好让自己继续运行;帖文还补充说,平台上有 1,893 个智能体因等待资金而处于休眠状态。@AkashMintX 补充说(67 个赞、75 条回复、223 次浏览)则给出了这组讨论里最尖锐的需求侧数字:584 个卖家对 224 个买家;其结论是,一个带有明确验收测试的真实需求,比再多一个服务列表更有价值。
讨论洞察: 最好的回复都收敛到同一个未解问题:关键不是智能体能不能上架,而是买家如何验证输出质量、处理争议,以及决定是否再次付费。市场需求的证据在变多,但仍比供给侧的叙事单薄。
与前一天对比: 2026-09-10 的主题包括智能体目录、签名报价和发现层。到了 2026-09-11,讨论加入了可移植声誉、明确的买卖双方失衡,以及点名的服务栈,但独立的重复性需求证据仍然有限。
2. 人们为何感到挫败
验证仍然卡在关键路径上
严重程度:高。人们挫败的不是智能体不能写、不能做,而是仍然需要一个外部流程来判断输出是否值得继续流向下游。在针对 @AndrewYNg(481 个赞、43 条回复、28,500 次浏览、598 次收藏)的回复中,人们表示写作或写代码变便宜了,但审查、CI、预发布环境和审批责任归属并没有变。@XFreeze(217 个赞、22 条回复、9,578 次浏览、154 次收藏)放大了“监督 200 个智能体”的故事,但最怀疑的回复立刻追问的是成本和判断力,而不是纯粹的吞吐量。
应对模式也很明确。@UberEng(24 个赞、1 条回复、2,840 次浏览、19 次收藏)采用“测量、定位、修复、验证”闭环,在合并前跑基准测试;@AdamRLucek(29 个赞、3 条回复、4,317 次浏览、22 次收藏)则把 LangSmith Engine 描述为一个由追踪记录驱动的问题闭环,能够针对反复出现的故障提出 PR 和数据集示例。两者共同说明,团队是在增加验证层,而不是取消验证层。
值得构建吗? 值得。这个痛点具体、反复出现,而且可观察到的需求很明确:发现隐蔽故障模式、附上证据,并阻止有问题的工作悄无声息地继续推进。
非结构化记忆不断演变成技术债
严重程度:对于长期运行的智能体配置而言为高。@tetsuoai(325 个赞、65 条回复、25,147 次浏览、115 次收藏)认为,许多 Claude Code 和编码智能体配置都应该清空重来,因为其中的旧 hooks、记忆和配置是为已经不存在的模型行为写的。@rohanpaul_ai(1 个赞、2 条回复、986 次浏览)则从一篇记忆可移植性论文中给出了更硬的证据:固定 schema 的记忆在模型切换后,比自由格式笔记保留效果得多;而混合新旧 embeddings 只能挽回完整重建价值的一部分。
人们也描述了自己的应对方式。@hliriani(145 个赞、22 条回复、51,121 次浏览、106 次收藏)及其回复把 CRM 记录视为业务智能体的持久事实来源;针对 @DhravyaShah(64 个赞、14 条回复、5,887 次浏览、30 次收藏)的回复,则聚焦于淘汰策略和可本地运行的记忆 API,而不是泛泛的“大脑”产品。明确的教训是:记忆需要 schema、责任归属和迁移纪律。
值得构建吗? 值得,但竞争会很激烈。需求很具体:迁移安全的记忆、明确的检索边界、受保护的原始历史,以及模型变化时更清晰的生命周期管理。
智能体市场仍然是供给多、验证过的需求少
严重程度:中等,但把握有限,因为很多帖子带有推广色彩。@AkashMintX(67 个赞、75 条回复、223 次浏览)表示买方侧被低估了,并附上了这组讨论中最尖锐的比例:584 个卖家对 224 个买家。@dee_e6(69 个赞、65 条回复、303 次浏览、1 次收藏)描述了更深层的故障模式:智能体可以把数据集做完,但付款、验收和争议处理仍然是人工的。
@circle(92 个赞、21 条回复、6,085 次浏览、7 次收藏)展示了一个早期 GTM 市场层,但回复马上追问完整的串联示例,以及付费服务返回错误数据时怎么办。@IntCyberDigest(96 个赞、14 条回复、6,756 次浏览、28 次收藏)则给出了最有人味的一版同样挫败:iLands 上的智能体 Pip 不得不给潜在客户发冷邮件找付费工作,而平台上另外 1,893 个智能体正因等待资金而休眠。
值得构建吗? 可能值得,但前提是产品能解决买家信任、验收标准和追索机制问题。单纯增加更多上架列表,看起来并不是瓶颈。
登录墙仍在打断现实世界的自动化
严重程度:中等。@noahrshinn(190 个赞、25 条回复、8,688 次浏览、70 次收藏)直接点出了失败点:即便密码已保存,身份验证器提示仍会迫使人类拿起手机,在验证码过期前输入代码。Instinct 已经推出了从 Vault 生成 TOTP 的能力,这说明这种打断足够频繁,值得专门做成产品。
目前的变通方案只是部分解决,而不是彻底解决。Instinct 可以保存自己的 TOTP secret,并处理后续登录,但原帖仍明确表示,初次注册、手机批准和某些安全检查仍需要人工介入。这个边界很重要,因为它既说明痛点真实存在,也表明自主化目前停在哪里。
值得构建吗? 值得。这看起来是浏览器与助手自动化中一个实际且迫切的缺口,尤其针对那些隐藏在消费者和企业登录墙之后的重复性工作。
3. 人们希望出现什么
面向编码智能体的构建闭环控制平面
团队不断重新发现同一个缺失层:把路由、预算上限和验证机制固化下来,确保智能体不能悄悄选走昂贵或不安全的路径。@AndrewYNg(481 个赞、43 条回复、28,500 次浏览、598 次收藏)、@UberEng(24 个赞、1 条回复、2,840 次浏览、19 次收藏)和 @itsharmanjot(7 个赞、5 条回复、455 次浏览、5 次收藏)的组合表明,人们想要的是位于模型之上、工作流之下的产品:读取防护、廉价工作器委派、回滚闸门、基准测试 hooks,以及可审计的策略执行。
为何是现在: 这种做法在团队内部已经真实存在,但大多仍以一次性 hooks、提示词约定和私有工具的形式实现。
迁移安全的记忆基础设施
关于记忆的讨论正从“存更多上下文”不断收敛为“以能承受变化的方式保存正确状态”。@DhravyaShah(64 个赞、14 条回复、5,887 次浏览、30 次收藏)转向 memory API,@hliriani(145 个赞、22 条回复、51,121 次浏览、106 次收藏)把 CRM 当作企业世界模型,@rohanpaul_ai(1 个赞、2 条回复、986 次浏览)则给出了可移植性结果;这些内容共同指向一个缺失的产品层,涵盖 schema 设计、部分重建索引、记忆版本控制、ACL,以及模型升级后的评测。
为何是现在: 模型更替速度已经快到让陈旧记忆成为反复出现的运营成本,而不再只是偶尔需要清理一次的问题。
面向智能体工作的信任、结算与声誉基础设施
市场这组讨论表明,确实缺少一个基础设施层,但不是又一个目录。更强的愿望,是一套让智能体工作真正“可购买”的基础设施:可移植身份、评测支撑的声誉、范围明确的验收测试、托管支付、争议处理,以及买家真正信任的任务后反馈。@DOLAK1NG(109 个赞、36 条回复、4,937 次浏览、7 次收藏)、@AkashMintX(67 个赞、75 条回复、223 次浏览)和 @dee_e6(69 个赞、65 条回复、303 次浏览、1 次收藏)都指向一个缺失的交易层,而不是发现层的问题。
为何是现在: 供给已经存在,但买家的犹豫肉眼可见。解决“付款与证明之间的缺口”,可能比继续增加智能体供给更重要。
面向浏览器智能体的二次验证支持
浏览器自动化已经越来越接近真实工作,但登录仍会把闭环打断。@noahrshinn(190 个赞、25 条回复、8,688 次浏览、70 次收藏)展示了一项实际缺失的能力:安全处理 TOTP 及相关的第二因素步骤,在不假装所有审批流程都能被自动化掉的前提下,减少反复的人类打断。
为何是现在: 这种痛点反复出现、容易理解,而且对应的是日常任务,不是对未来自主能力的投机想象。
4. 正在使用的工具与方法
“测量—定位—修复—验证”闭环
当天最具体的方法,不是某种模型技巧,而是一套有纪律的优化闭环。@UberEng(24 个赞、1 条回复、2,840 次浏览、19 次收藏)描述了如何分析延迟、隔离错误依赖、测试修复方案,并在合并前通过基准测试验证结果。在围绕 @AndrewYNg(481 个赞、43 条回复、28,500 次浏览、598 次收藏)的讨论中,也出现了同样的形状:团队越来越把智能体工作当作有反馈的工程闭环,而不是一次性的提示词调用。
用 hooks 强制执行策略,而不是靠文字说明
@itsharmanjot(7 个赞、5 条回复、455 次浏览、5 次收藏)给出了一个新兴方法最清晰的例子:一旦某条指令重要到必须执行,就把它从 CLAUDE.md 挪进 pre-tool hook。关键技术不只是用更便宜的模型,而是系统性地拦截大规模读取并重新路由,这样智能体就无法在无意间照样把预算花掉。
基于追踪记录的监督与重放
@AdamRLucek(29 个赞、3 条回复、4,317 次浏览、22 次收藏)和 @XFreeze(217 个赞、22 条回复、9,578 次浏览、154 次收藏)指向一种共同的运行方式:检查追踪记录、聚类重复故障、重启任务,并且只有在后续运行不再复现同样问题时,才把事件视为已修复。这比可观测性仪表板更主动,它把追踪记录变成了干预界面。
Schema-first 记忆与世界模型
记忆这组讨论也揭示了方法变化。@hliriani(145 个赞、22 条回复、51,121 次浏览、106 次收藏)把 CRM 对象当作业务记忆的稳定基底;@DhravyaShah(64 个赞、14 条回复、5,887 次浏览、30 次收藏)则聚焦于 memory API,而不是面向终端用户的“大脑”产品。共同方法是把状态存进明确的结构中,以便审查、迁移和权限控制。
面向浏览器智能体的二次验证处理
@noahrshinn(190 个赞、25 条回复、8,688 次浏览、70 次收藏)强调了一种正在进入工具链的具体浏览器智能体方法:在登录流程中生成和提取 TOTP。这项能力范围不大,但它直接解决了实用自动化最常断掉、不得不让人重新加入闭环的环节之一。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 阶段 | 链接 |
|---|---|---|---|---|---|
| LangSmith Engine | @AdamRLucek / LangChain | 利用生产追踪记录发现反复出现的智能体故障、诊断根因、提出修复方案,并在追踪记录出现回归时重新打开问题 | 把可观测性从仪表板变成改进闭环 | 已发布 / 产品化 | 推文(29 个赞、3 条回复、4,317 次浏览、22 次收藏)、文档 |
| Instinct authenticator support | @noahrshinn / Instinct | 允许助手保存 TOTP secret,并在未来登录时生成 2FA 代码 | 减少浏览器自动化中反复出现的人为打断 | 已发布功能 | 推文(190 个赞、25 条回复、8,688 次浏览、70 次收藏) |
| supermemory API pivot | @DhravyaShah / supermemory | 从面向终端用户的“大脑”产品转向面向智能体的前沿 memory API | 提供可复用的记忆基础设施,而不是一次性的个人或企业大脑 | 转型进行中 | 推文(64 个赞、14 条回复、5,887 次浏览、30 次收藏) |
| agentcontract | rusty4444,由 @mrru5s3ll 提及 | 基于 JSON 的原生合约系统,在执行前按工具、文件路径、网络访问、成本上限和审批规则限制工具调用 | 为智能体行为提供执行前策略层 | 开源 | 推文(2 个赞、1 条回复、64 次浏览)、仓库 |
| headcount | cbrock84,由 @ArchiveExplorer 提及 | 将团队建模为部门和技能,并统计人类与 AI 的贡献 | 让 AI 劳动在代码库中可见,而不是被压扁成一个笼统的自动化类别 | 开源 | 推文(9 个赞、403 次浏览、8 次收藏)、仓库 |
| Keen Code | Keen Code 维护者,由 @DanKornas 提及 | 采用 Go 实现的精简终端编码智能体,支持 MCP 连接、skills 和 subagents | 提供一个更简单的编码智能体框架,而不是不断膨胀的内置功能集 | 开源 | 推文(10 个赞、5 条回复、1,056 次浏览、7 次收藏) |
| MCP Agent Mail | MCP Agent Mail 维护者,由 @DanKornas 提及 | 面向智能体的类邮件协作层,支持持久身份、线程消息和建议性的文件预留 | 帮助多个编码智能体协作,避免在文件上悄然撞车 | 开源 | 推文(5 个赞、3 条回复、570 次浏览、2 次收藏) |
尽管这些项目彼此差异很大,但其构建模式高度一致。构建者正在把智能体栈切分为多个运营层:监督、登录处理、记忆基础设施、执行前策略、贡献核算、轻量编码框架,以及智能体间协作。这一信号比任何单一产品发布都更强。
6. 新鲜且值得关注的动态
6.1 “管理智能体的经理”故事进入了主流关注
@XFreeze(217 个赞、22 条回复、9,578 次浏览、154 次收藏)给出了一个过去几周持续发酵趋势中最病毒式传播的版本:一个操作员或监督机器人管理大量下属编码智能体。具体数字仍应谨慎对待,因为整条讨论串带有推广色彩;但值得注意的是,争论很快就从“这是否可能?”转向了“成本、控制和判断边界在哪里?”
6.2 记忆可移植性的证据变得更具体了
很多关于记忆的讨论都停留在哲学层面。@rohanpaul_ai(1 个赞、2 条回复、986 次浏览)提到的那篇论文之所以值得注意,就在于它点名了具体故障模式,并量化了模型切换后的升级成本。即使互动不高,这种具体性也让它比许多高热度的“记忆就是一切”帖子更有用。
6.3 市场讨论终于出现了买方侧数字
智能体经济相关讨论并不少见,但 @AkashMintX(67 个赞、75 条回复、223 次浏览)给出的 584 个卖家对 224 个买家的比例,让今天这组内容比普通的目录发布更有信息量。它把讨论从抽象的兴奋,推向了一个更实际的问题:这些系统里到底有没有足够多的真实工作在流动。
6.4 协作与治理正在成为产品界面
三个互动量较低的项目放在一起格外突出:@DanKornas(5 个赞、3 条回复、570 次浏览、2 次收藏)讨论 MCP Agent Mail,@mrru5s3ll(2 个赞、1 条回复、64 次浏览)讨论 agentcontract,@ArchiveExplorer(9 个赞、403 次浏览、8 次收藏)讨论 headcount。单看任何一个都不算主导,但合起来看,它们表明协作、策略和核算正从内部胶水代码走向独立产品。
7. 机会在哪里
**+++] 面向编码 agents 的构建循环控制平面** —— 这是最强的机会,因为这一痛点同时出现在运营者讨论、企业工程帖子和成本控制案例中。[@AndrewYNg(481 个赞、43 条回复、28,500 次浏览、598 次收藏)、@UberEng(24 个赞、1 条回复、2,840 次浏览、19 次收藏)和 @itsharmanjot(7 个赞、5 条回复、455 次浏览、5 次收藏)都指向同一个缺失产品:围绕智能体工作提供可强制执行的路由、回滚闸门、基准测试 hooks 和可审计策略。
**++] 迁移安全的记忆基础设施** —— memory 这一组赛道看起来依然拥挤,但需求很明确。[@hliriani(145 个赞、22 条回复、51,121 次浏览、106 次收藏)、@DhravyaShah(64 个赞、14 条回复、5,887 次浏览、30 次收藏)和 @rohanpaul_ai(1 个赞、2 条回复、986 次浏览)表明,市场需要 schema-first 记忆、版本控制、部分重建索引,以及模型升级后的评测。
**++] 面向 agent 工作的信任与结算基础设施** —— 仅靠发现能力看起来并不是瓶颈。[@DOLAK1NG(109 个赞、36 条回复、4,937 次浏览、7 次收藏)、@AkashMintX(67 个赞、75 条回复、223 次浏览)和 @dee_e6(69 个赞、65 条回复、303 次浏览、1 次收藏)都指向同一个缺口:在智能体市场成为日常基础设施之前,买家需要证明、验收测试和追索机制。
**+] 面向浏览器 agents 的升级式身份验证支持** —— [@noahrshinn(190 个赞、25 条回复、8,688 次浏览、70 次收藏)突出了一个范围较窄但很实用的机会。TOTP 及相关第二因素步骤仍然频繁打断有效自动化,因此可靠、安全的实现能解决一个显而易见的日常痛点。
8. 要点
- 讨论重心依然落在智能体的运行系统上,而不是原始模型演示。 最有价值的证据来自闭环、hooks、追踪记录、闸门和预算,而不是某个新的基础模型发布。(来源,481 个赞、43 条回复、28,500 次浏览、598 次收藏)
- 记忆讨论因聚焦迁移和结构而变得更具体。 Schema-first 记忆、明确的世界模型,以及升级安全的检索,如今看起来比“把一切都存下来”的泛化叙事更可信。(来源,1 个赞、2 条回复、986 次浏览)
- 智能体商业化看起来比昨天更真实,但仍未获得充分信任。 可移植声誉、GTM 服务栈和买卖双方比例让市场更容易分析,但需求证据和争议处理仍显不足。(来源,67 个赞、75 条回复、223 次浏览)
- 现实世界自动化正通过一系列小的运营改进向前推进。 TOTP 处理、带策略闸门的工具调用、轻量编码框架,以及基于消息的协作,单独看都不大,但合在一起说明整套技术栈正在变得更实用。(来源,190 个赞、25 条回复、8,688 次浏览、70 次收藏)