Twitter AI Agent - 2026-09-13
1. 人们在讨论什么
1.1 Harness 工程持续压过模型崇拜(🡕)
最大的 coding agent 讨论群体一直在强调:模型并不是产品边界。团队应该预期模型是可以替换、约束和做基准测试的组件,而真正持久的价值在于 harness 规则、上下文处理、审批逻辑和验证机制。至少有 4 条高信号推文从不同角度推进了这一框架。
@omarsar0 认为(321 个赞、29 条回复、35,434 次浏览、672 次收藏)表示,学会构建 harness 已经成为 AI 工程的核心技能之一,因为特定领域的可靠性、定制能力和多模型控制都过于重要,不能外包给供应商。互动价值最高的回复并未反对 harness 这一论点,而是进一步收紧焦点:缺失的那一层是一个 AI 控制器,能够驱动来自不同供应商的模型和 harness,而不是把一个 harness 绑定在某个模型家族上。
@mardehaym 提炼了(57 个赞、9 条回复、4,693 次浏览、52 次收藏)把同样的想法转成了操作规则:关键计算要放在确定性工具里;涉及重大后果的操作必须指定人工负责人;每一步都要可审计;系统设计要确保模型只是一次配置替换。一条回复补充了与这一世界观一致的具体评测做法:测试运行期间固定 harness 的 commit,这样就不会把模型替换误判为工具链变更。
@matthewcanham 翻译了(125 个赞、11 条回复、10,468 次浏览、267 次收藏)把这套技术栈整理成一份面向 PM 的 11 主题课程,涵盖工具使用、MCP、RAG、上下文工程、记忆、harness 工程、评估和沙箱。这一点之所以重要,是因为讨论已经不再局限于基础设施专家;人们开始把 agent 系统素养视为产品管理的必备要求。
@gippp69 封装了(72 个赞、30 条回复、1,164 次浏览、36 次收藏)则围绕一则 GPT-6 Astra 说明,提出了这一论点在控制平面上的版本:把工作拆分为可逆、需审核和不可逆三条通道;保留一个受控的写入席位;当定价把 272K 以上输入重新计费后,把上下文规模视为成本治理问题。
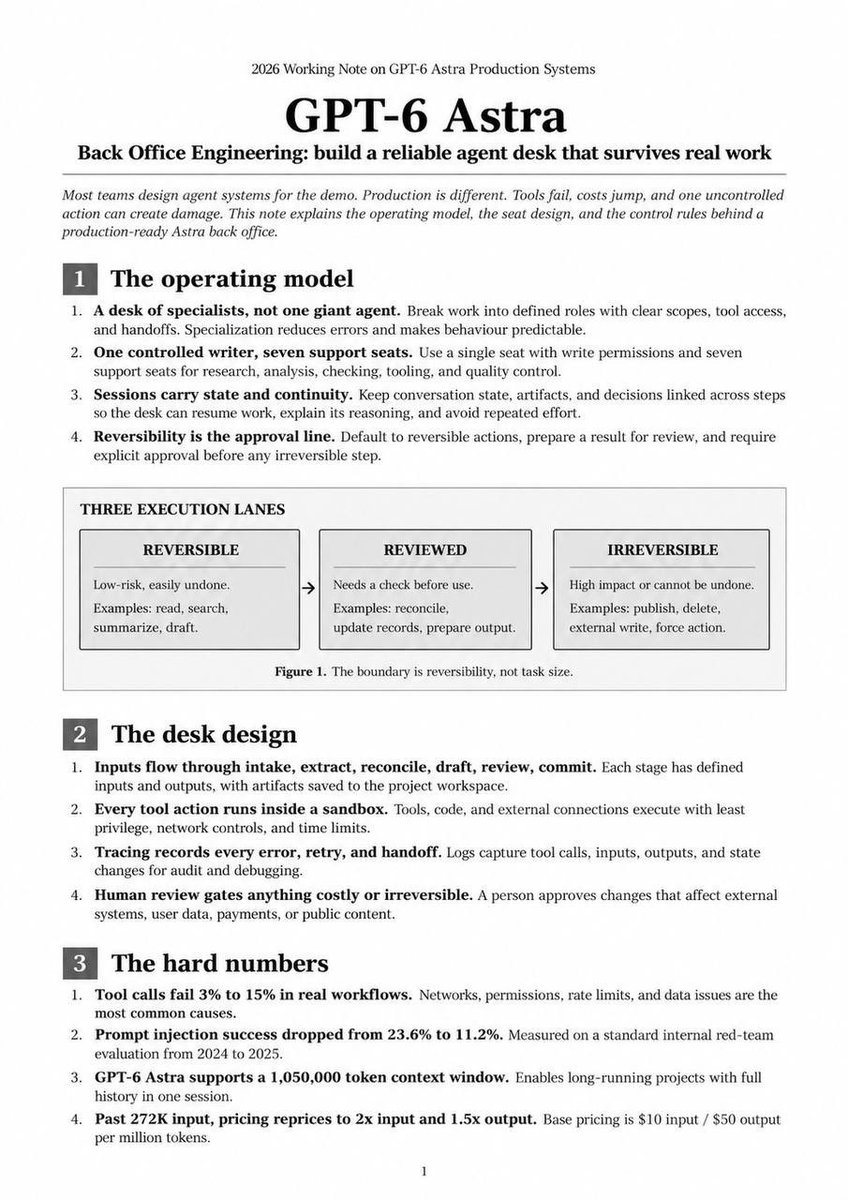
讨论洞察: 最有价值的回复并不是说“跳过 harness”,而是指出:如果团队想要可移植性和信任,harness 之上仍需要再加一层——控制器、契约测试,或固定的评测条件。
与前一天对比: 2026-09-12 还把 harness 工程视为一门快速发展的学科。到 2026-09-13,语气又变了:harness 不再只是有用的抽象,而被描述为团队真正需要掌握的智能栈本身。
1.2 上下文管理变得具体:schema、压缩和可复用的业务记忆(🡕)
“更好的记忆”并不是当天的关键词。更有力的帖子谈的是具体的存储布局、类型化状态、压缩策略,以及考虑成本的上下文边界。共同趋势是:不再把上下文当成一个更大的窗口,而是把它当成一个需要设计的系统。
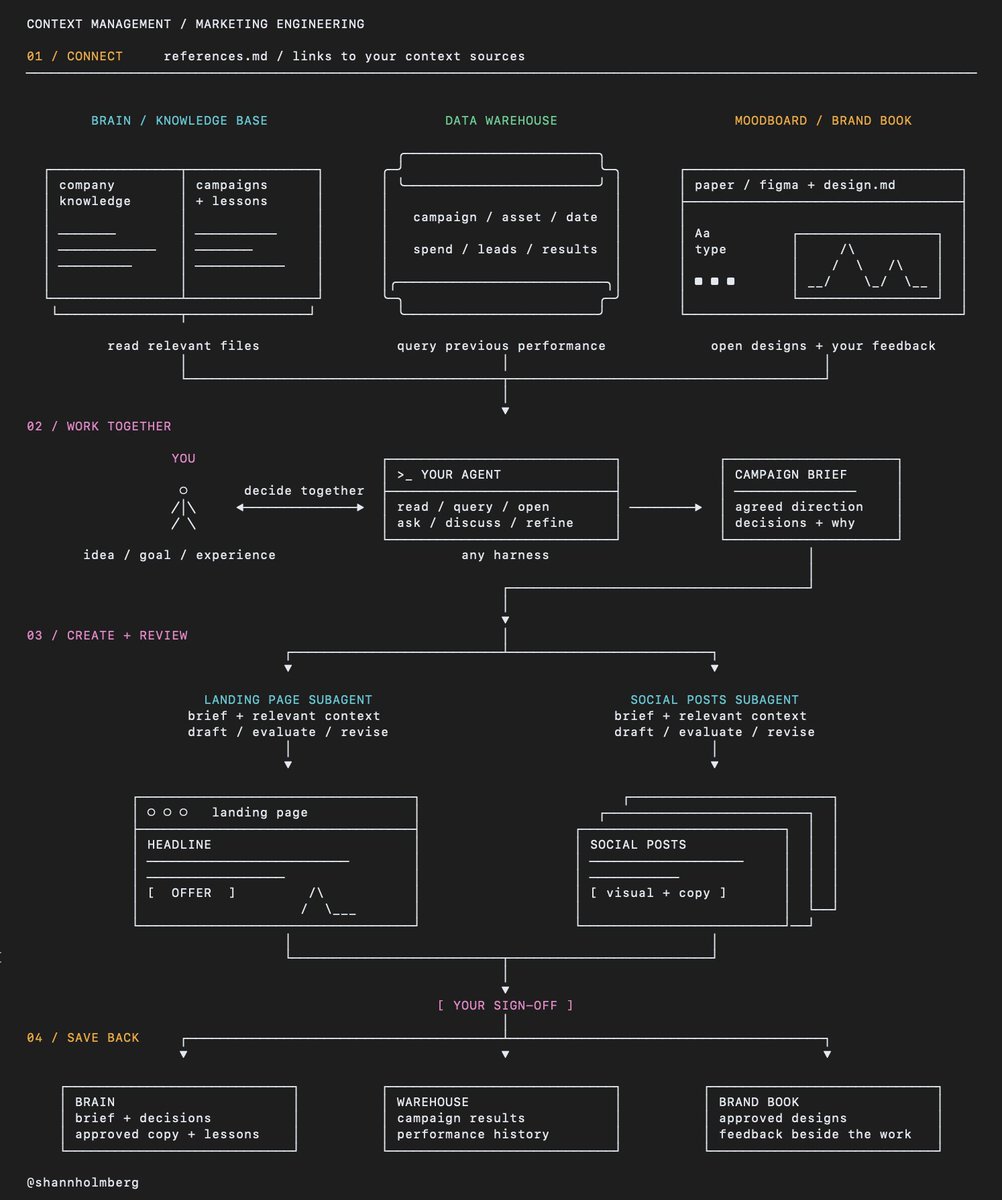
@shannholmberg 展示了(51 个赞、15 条回复、3,275 次浏览、57 次收藏)介绍了一种营销 agent 架构,由 3 个上下文存储组成:一个 markdown 公司大脑、一个可查询业绩数据的数据仓库,以及一本实时品牌手册。帖子细到明确说明 agent 应如何读取过往营销活动的决策、查询素材级表现、打开设计文件、与人类一起完善 brief,并把获批的推理结果写回系统。
@mirku21 强调了(15 个赞、9 条回复、420 次浏览、9 次收藏)介绍了 Microsoft 面向长周期 agent 的上下文压缩工作 ACON。公开论文称,ACON 可将峰值 token 使用量降低 26-54%,同时达到或超过基线准确率;其蒸馏压缩器在显著降低压缩成本的同时,仍能保留教师模型超过 95% 的性能,从而让较小模型在长工作流中保持竞争力(论文)。

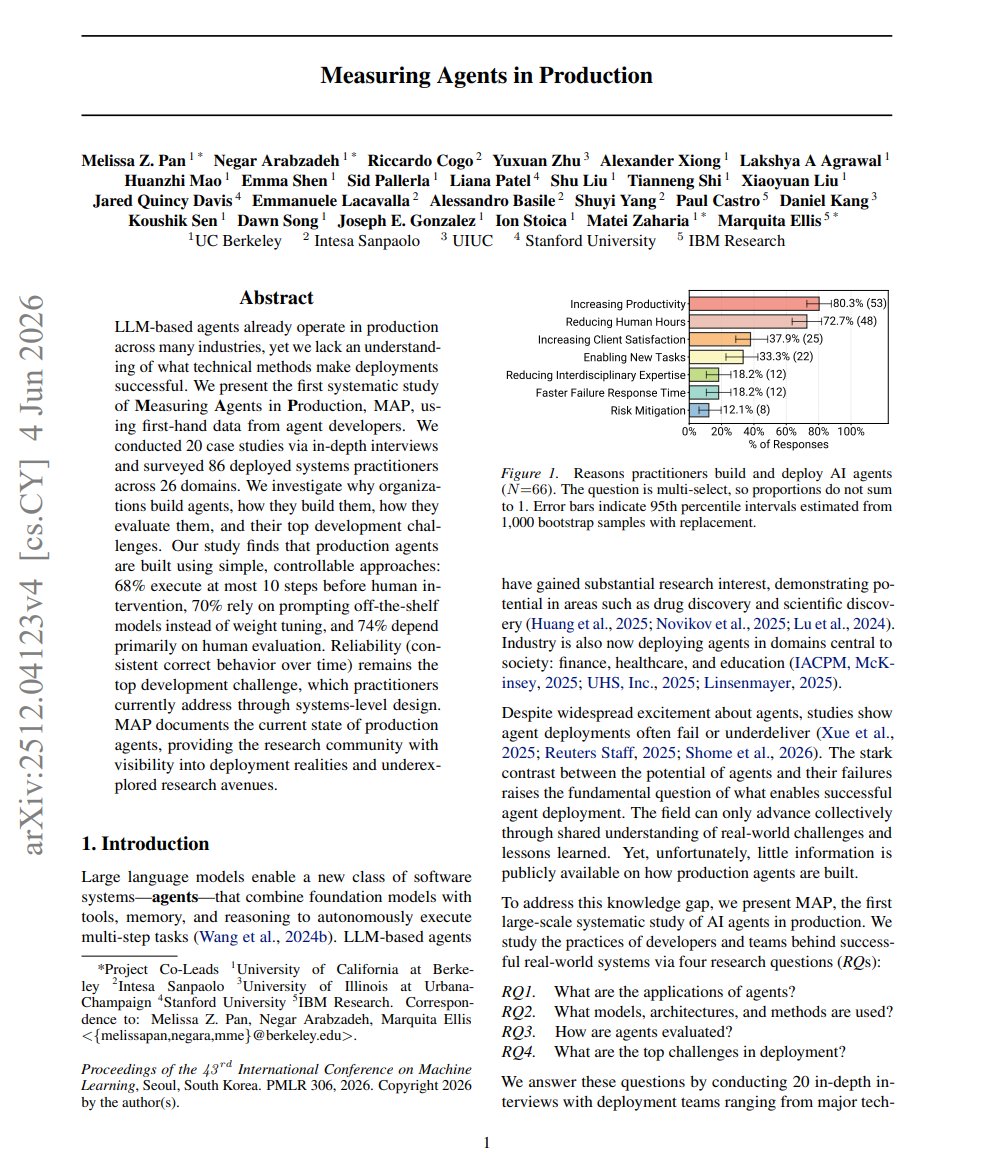
同一观点在生产侧的版本出现在 @marfinxx 总结(18 个赞、9 条回复、805 次浏览、16 次收藏)对 MAP 论文的介绍中。论文称,68% 的生产 agent 在人工介入前最多执行 10 步,74% 主要依赖人工评估。这与更广泛的时间线逻辑一致:团队之所以限制循环深度并管理上下文,是因为真实工作负载会惩罚漂移,而不是因为他们接触不到更大的模型(论文)。
讨论洞察: 回复主要聚焦两类故障模式:政策变更后,过时决策仍然滞留在上下文中;以及工具调用失败后,错误状态被从记忆里丢掉,尽管这恰恰是下一步最需要的信息。
与前一天对比: 2026-09-12 强调的是记忆和交接质量。今天的讨论则明显更偏操作层,涉及类型化状态分区、数据仓库查询、压缩阈值和明确的签核节点。
1.3 公开的 agent 工程课程与打包能力持续增加(🡕)
另一个讨论群体把 agent 工程视为一种如今已经可以通过现成课程、可安装技能和可复用发现工具来学习的能力。值得注意的变化不只是教育内容更多了,而是围绕这些内容的分发基础设施也在增多。
@adriancortexbt 指出(15 个赞、5 条回复、457 次浏览、11 次收藏)指向一场 37 分钟的工作坊:Anthropic 工程师用 7 个步骤构建一个托管式 SRE agent,包括定义 agent、将其绑定到实时会话、调试一次延迟事故,以及展示会话在刷新后仍可持续。这与“这里有一个好 prompt”完全不同;它是一份面向公众的有状态 agent 运维演示。
@beamnxw 汇编了(26 个赞、14 条回复、1,544 次浏览、37 次收藏)列出了 10 项 agent 技能,总下载量达 8.01M,并把它们描述为一套可用于探索、压力测试、浏览器操作、原型设计、调试、编排和工具构建的工作栈。关联的 Vercel Skills 仓库也直接印证了这种打包趋势:它提供一个 CLI,可从 GitHub、GitLab 或本地来源安装或使用技能,并支持多个 agent 环境(仓库)。
@kv1nsiii 制作了(14 个赞、5 条回复、421 次浏览、12 次收藏)则从 coding agent 一侧表达了同样的观点,提出“地图、方法、目录”三件套:CodeGraph 用于本地预索引代码图,并随编辑自动同步(仓库);HumanLayer 的 12-Factor Agents 提供围绕上下文归属的工作流原则(指南);ClawHub 用于发现技能和插件(网站)。
讨论洞察: 反对意见并不是反对 skill,而是指出:下载量和目录本身远远不够;每项打包能力仍然需要通过标准、追踪日志,以及对输入、输出和失败行为的清晰契约。
与前一天对比: 2026-09-12 已经出现了课程和技能审计方面的讨论。到 2026-09-13,围绕学习的技术栈进一步扩展到注册表、本地语义地图和可复用安装流程。
1.4 信任讨论从前沿安全扩展到资金操作 agent 和 agent 市场(🡕)
信任并不是以单一讨论出现的,而是以 3 个彼此相连的话题出现:前沿实验室的独立评估者、管理资本的 agent 所需的可量化标准,以及 agent 市场的交易规则。共同前提是:行动所需的证明标准必须高于聊天。
@JoshAEngels 解释了(1,366 个赞、54 条回复、76,584 次浏览、280 次收藏)解释了他为何离开 Google DeepMind 加入 METR,认为各实验室仍在朝递归自我改进推进,却没有足够证据证明当前系统已经足够对齐,可以安全做到这一点。@EMostaque 反驳了(143 个赞、21 条回复、35,915 次浏览、58 次收藏)则指出,董事会层面的监督是过于薄弱的控制手段;该领域需要的是更深入接触 AI 内部机制以及更好的评估者,而不只是泛泛呼吁放慢脚步。
对于经济 agent,@PHAZE_001 认为(166 个赞、68 条回复、2,880 次浏览)和 @callmeperry3 认为(26 个赞、13 条回复、7,458 次浏览)都认为,正确的评估标准不是“agent 聪不聪明”,而是它在处理真实资本时,表现是否经过风险调整、是否稳定一致,以及能否被独立验证。
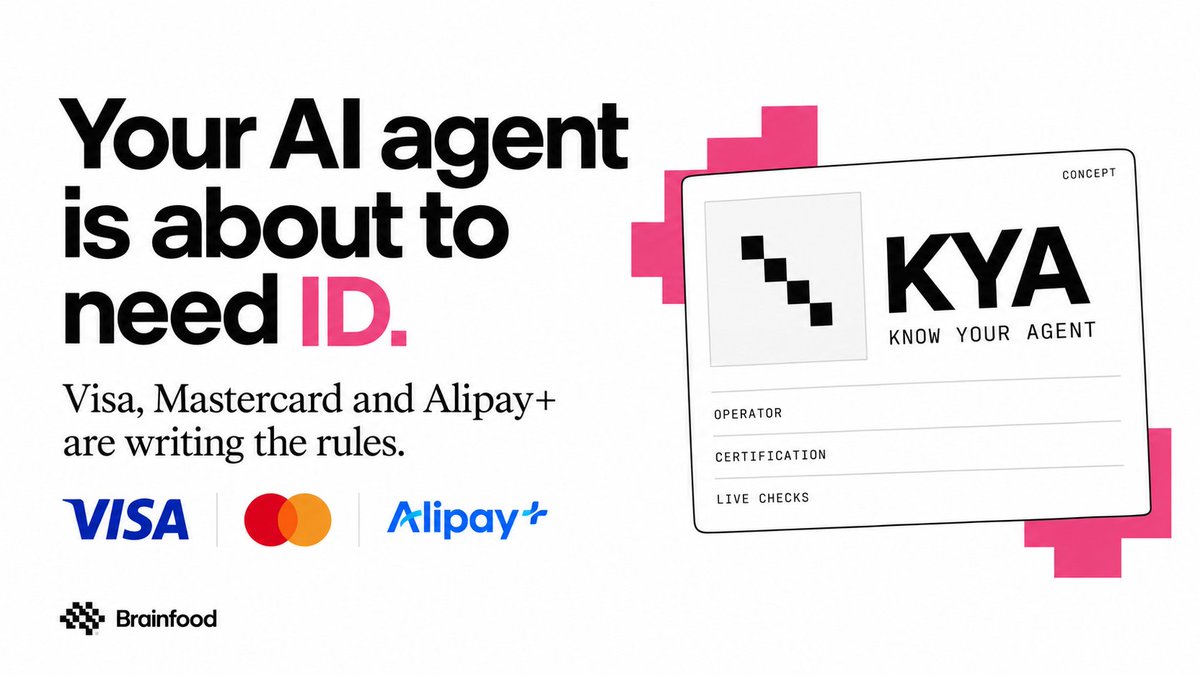
@sytaylor 报道了(52 个赞、14 条回复、3,914 次浏览、25 次收藏)称,Visa、Mastercard 和 Ant International 正围绕支付 agent 收敛到一个共享的 Know Your Agent 框架,在不同网络之间实现运营方关联、认证和持续监控(报道)。在市场层面,@CteaAminah 认为(59 个赞、52 条回复、473 次浏览)认为,除非 agent 能按照所需输入、输出格式、时间、价格和信任边界比较服务,否则发现服务会比支付更难;而 @0xCindyWeb3 补充了(68 个赞、57 条回复、723 次浏览)则认为,一份有用的需求必须包含交付物、预算区间和可执行的验收测试,工作才能进入托管。
讨论洞察: 最有价值的回复谈的不是品牌,而是可争议性。人们在问:误判导致的负面评价之后,agent 的声誉该如何修复;争议由谁裁决;以及在任何工作或付款开始前,验收测试该如何定义。
与前一天对比: 2026-09-12 主要把信任集中在 agent 市场中的托管、声誉和买方稀缺性上。到 2026-09-13,同样的担忧已经扩展到独立评估、支付网络身份,以及对什么才算可接受 agent 行动的更严格定义。
2. 什么让人感到沮丧
上下文过载仍会比模型质量更早拖垮 agent
严重程度:高。反复出现的挫败并不是模型太弱,而是长时间运行的系统依然会被自身的历史记录、过时状态和臃肿的工具输出淹没。@omarsar0 认为(321 个赞、29 条回复、35,434 次浏览、672 次收藏)指出,供应商模型本身并不能解决特定领域的可靠性问题。@shannholmberg 展示了(51 个赞、15 条回复、3,275 次浏览、57 次收藏)则详细给出了应对模式:把持久业务上下文放在 markdown 中,把性能历史放进数据仓库,把视觉规则放在单独的品牌手册里,而不是把所有东西都塞进一条聊天记录。
这些有研究支撑的抱怨与一线实践者的反馈完全吻合。@mirku21 强调了(15 个赞、9 条回复、420 次浏览、9 次收藏)介绍了 ACON 的主张:无界的交互历史会同时导致上下文分心和推理成本暴涨;而 @marfinxx 引用的 MAP 论文发现,68% 的生产 agent 在人工介入前最多执行 10 步,74% 主要依赖人工评估(ACON、MAP)。实践中的应对方案高度一致:压缩状态、维护变量表、通过查询历史代替重放历史,并在循环演变成昂贵漂移之前设定上限。
值得投入建设吗? 是。这一痛点同时出现在战略帖、操作图和研究论文中。那些能够掌控压缩、来源追踪和可查询状态的产品,与数据所显示的团队真实需求高度一致。
无论在实验室还是生产环境,行动仍然跑在评估前面
严重程度:高。当天反复出现的警告是:行业还没有就如何评判 agent 达成共识,agent 却已经被要求采取行动。@JoshAEngels 表示(1,366 个赞、54 条回复、76,584 次浏览、280 次收藏)认为当前系统尚未足够对齐,不能支持递归自我改进,这也正是他加入 METR 的原因。@EMostaque 认为(143 个赞、21 条回复、35,915 次浏览、58 次收藏)指出,即便董事会也算不上强有力的评估者;该领域需要更深入的技术访问权限和更强的监督工具。
同样的挫败感也出现在更接近部署的一侧。@mardehaym 呼吁(57 个赞、9 条回复、4,693 次浏览、52 次收藏)强调确定性工具、审计轨迹和指定人工审批;而 @PHAZE_001 认为(166 个赞、68 条回复、2,880 次浏览)和 @callmeperry3 认为(26 个赞、13 条回复、7,458 次浏览)则认为,正确指标应是资金管理 agent 的风险调整后表现、一致性和可验证性。这些抱怨已经具体到足以说明栈里存在缺口:人们有很多办法让 agent 行动,却远少于能让这些行动变得可理解、可争议和可申诉的办法。
值得投入建设吗? 是。这是一个直接的基础设施问题,不是“氛围感”问题。需求横跨前沿模型监督、coding agent 验证和 agent 金融控制。
agent 市场和技能生态中的发现与任务定义仍然薄弱
严重程度:中到高。市场讨论不断回到同一个缺失层:像“研究 agent”或“内容 agent”这样的标签,并不能告诉另一个 agent 它接受什么输入、返回什么输出、需要多久、费用多少,或在什么情况下应被拒绝。@CteaAminah 认为(59 个赞、52 条回复、473 次浏览)认为,发现服务可能比支付更难,原因正在于此。回复补充说,agent 间发现需要机器可读的契约、SLA 和失败模式,而不只是更好的搜索。
@0xCindyWeb3 补充了(68 个赞、57 条回复、723 次浏览)认为,只有当买方能在托管开始前发布具体的 brief、预算区间和验收测试时,供给才真正有意义。同样的关切也出现在 skills / tooling 讨论里:@beamnxw 分享了(26 个赞、14 条回复、1,544 次浏览、37 次收藏)提出了一套技能栈,但回复立刻要求加入契约测试和追踪日志,让这套栈具备可组合性,而不只是受欢迎。@kv1nsiii 指出(14 个赞、5 条回复、421 次浏览、12 次收藏)则在编码工具一侧给出了同样的答案:更好的地图、更好的方法和更好的目录。
值得投入建设吗? 是,但竞争风险中等。需求显而易见,不过已经有多个项目在竞速构建注册表、技能目录和机器可读的能力层。
3. 人们希望存在什么
位于 harness 之上的控制器层
最清晰的未满足系统需求并不是“更好的模型”,而是一层能够针对具体任务决定该用哪个模型、哪个 harness、哪个上下文存储,以及走哪条审批路径的控制器。最明确的信号来自对 @omarsar0 的回复:一位构建者表示,眼下真正需要的是一个能驱动不同供应商模型和 harness 的 AI 控制器。@mardehaym 和 @gippp69 则补上了确定性工具、可审计性,以及可逆与不可逆通道方面的要求。
这是一种实际需求,而不是情绪诉求。人们大致已经知道自己想要什么:一种能够在模型之间路由工作、保留责任归属,并把成本或权限边界放在任何单一 worker agent 之外的方式。机会:直接。
具备机器可读契约的能力注册表
技能和市场两条讨论线最终都汇聚到同一个诉求:不要再让人类和 agent 去猜某项能力究竟能做什么。@beamnxw 展示了一套不断扩张的技能栈;Vercel Skills 仓库展示了跨 agent 环境的公开安装与使用流程(仓库);@kv1nsiii 则把发现能力与 CodeGraph、HumanLayer 和 ClawHub 配套起来。在市场一侧,@CteaAminah 表示,在自动化需求真正运转起来之前,描述必须包含所需输入、输出、时间、价格、工具和信任边界。
这一需求高度务实,而且已得到部分满足,但评论显示,如果缺少测试、来源信息和失败语义,现有方案仍然不完整。机会:竞争性。
面向支出、部署或结算型 agent 的评估者、认证者和裁决者
数据反复指向一个缺失的信任层,用于处理后果重大的行动。@JoshAEngels 把独立评估定位为前沿基础设施的核心;@PHAZE_001 和 @callmeperry3 主张为 agent 金融建立可验证的表现标准;@sytaylor 指向跨网络的 KYA 框架;@ajrmdhn___ 则认为,同行争议需要在执行开始前预先指定裁决者。
这一需求务实、紧迫,但目前仍分散在模型实验室、金融、支付和市场等不同领域。现有方案只能部分覆盖。机会:直接。
4. 正在使用的工具和方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| 定制 harness | 编排/运行时 | (+) | 领域控制、可移植性、可审计性、确定性工具 | 构建和维护成本高;harness 上方仍需要控制器逻辑 |
references.md + 大脑/数据仓库/品牌手册模式 |
上下文管理 | (+) | 将持久知识、可查询业绩和实时设计反馈分离 | 需要严格的来源管理,并主动清理活跃状态,避免规则过时 |
| ACON | 上下文压缩 | (+) | 在长任务中将峰值 token 使用量降低 26-54%,同时提升或保持准确率 | 增加压缩器规则与蒸馏复杂度 |
| MAP 风格的有界工作流 | 评估方法 | (+) | 符合真实生产实践:短循环、人工检查、现成模型 | 牺牲开放式自主性,并接受分钟级延迟 |
| Vercel Skills / ClawHub | 技能注册表 | (+/-) | 可复用的能力打包、安装流程和发现能力 | 受欢迎不等于可组合;仍需要契约测试和追踪 |
| CodeGraph | 代码智能 | (+) | 本地预索引代码图、自动同步、浏览器 UI,减少文件乱翻 | 依赖代码图质量,以及变化中的仓库能否被正确索引 |
| HumanLayer 12-Factor Agents | 方法论 | (+) | 为 prompt、上下文、状态和工具边界提供共同语言 | 更像指导原则,而非开箱即用的基础设施 |
| VoiceStudio | 本地多模态栈 | (+) | 本地语音克隆、配音、ASR/TTS 选择、API 和 MCP 集成 | 仍处于活跃 beta 阶段,计算开销高于纯文本 agent 栈 |
| KYA 框架 | 支付/协议 | (+/-) | 为支出型 agent 提供共享运营方身份、认证和监控 | 仍需争议处理机制,以及修复低评分或误判的方法 |
总体而言,人们对那些增加控制力而不是制造魔法感的工具评价更正面。@shannholmberg 和 HumanLayer 的公开指南都更偏向明确的上下文归属,而不是更大的原始聊天记录(指南);@mirku21 和 ACON 论文则用可量化结果支持压缩作为修复方案(论文);而 @marfinxx 引用的 MAP 论文,则支持生产环境中的短流程和人工监督(论文)。
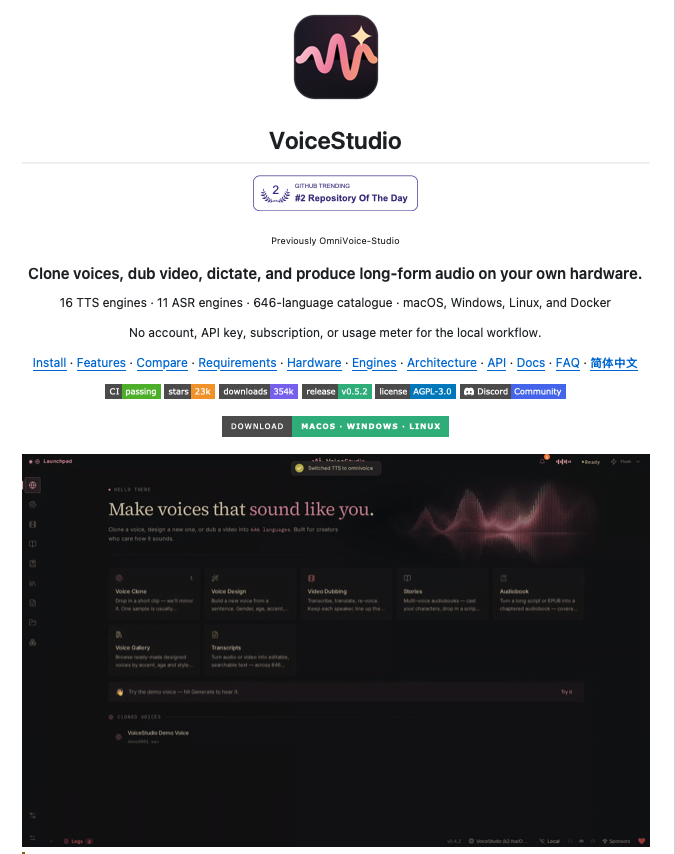
迁移趋势也很清晰。人们正在从“一次聊天、一个超大上下文”转向结构化上下文存储、明确的技能、本地语义索引和持久会话。@beamnxw 和 Vercel Skills 仓库显示,能力打包正变得常态化(仓库);@kv1nsiii 和 CodeGraph 则展示了同样朝向可复用代码导航与减少 token 浪费的趋势(仓库)。在多模态工作中,@Sumanth_077 把 VoiceStudio 呈现为一套具备本地 API 的语音栈,而不只是云端功能(仓库)。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| CodeGraph | colbymchenry | 构建本地代码图,并将其暴露给 coding agent | 减少 agent 浏览大型仓库时的文件乱翻和上下文浪费 | Rust 内核、本地 .codegraph/ 索引、MCP server、浏览器 UI |
已发布 | 推文, 仓库 |
| skills | Vercel Labs | 用于安装或使用来自 Git/GitHub 来源的 agent 技能的 CLI | 将可复用能力打包,而不是在不同 agent 之间复制原始 prompt 片段 | Node CLI、Git/GitHub/GitLab 来源、多 agent 集成 | 已发布 | 推文, 仓库 |
| VoiceStudio | debpalash | 提供本地语音克隆、配音、转录和音频 API,并带有 agent 接口 | 为 agent 工作流提供私有的设备端语音层,而不是只依赖云端 | 桌面应用、16 个 TTS 引擎、11 个 ASR 引擎、本地/兼容 OpenAI 的 API、MCP server | Beta | 推文, 仓库, 网站 |
| Orchard | Microsoft Research | 开源 agentic 建模框架,提供与 harness 无关的环境层 | 在 SWE、GUI 和 assistant agent 之间复用沙箱、训练和评估基础设施 | Orchard Env、Kubernetes 原生服务、Qwen3.5-35B-A3B 主干、value reranking | Alpha | 推文, 论文, 仓库 |
| ACON | Microsoft Research | 为长周期 agent 优化并蒸馏上下文压缩规则 | 防止长轨迹破坏推理质量并推高 token 成本 | gpt-4.1 teacher、蒸馏后的 Qwen-14B/Phi-4 压缩器,在 AppWorld 和 OfficeBench 上做基准测试 | Alpha | 推文, 论文 |
最突出的构建者模式是“让外围系统变得可理解”。CodeGraph 和 skills 都在努力让 agent 能力更容易被发现和复用:前者绘制代码库地图,让 agent 不再盲目打开文件;后者则把技能变成可安装的制品,并明确来源和安装路径。两者背后的共同痛点,都是搜索浪费和脆弱的复制粘贴式上下文。
这些研究项目同样以基础设施优先。Orchard 关注可复用的环境层以及特定领域的配方;ACON 则把上下文压缩当作一个优化问题,而不是手工调 prompt 的技巧。两者都是对报告其他部分同一操作现实的回应:团队想让 agent 跑得更久,但前提是环境、记忆和验证这一整套机制仍然受控。

VoiceStudio 是这组项目里最明确的本地优先构建。它把克隆、配音、听写、转录和面向 agent 的 API 打包成一套设备端栈,因此它不仅是一个创作者工具,也是 agent 无需离开本机即可调用的私有多模态基础设施的具体例子。
6. 新动态与值得关注的内容
《生产环境中衡量 Agent》成为经验研究参考点
@marfinxx 总结(18 个赞、9 条回复、805 次浏览、16 次收藏)提到的 MAP 论文,是这批内容中最有力的硬数据项。公开论文信息显示,该研究访谈了 20 个部署团队,调查了 306 名实践者,并覆盖 86 个生产或试点系统;研究结果更支持短工作流、现成模型和人工评估,而不是开放式自主性(论文)。
ACON 让上下文压缩看起来像一项一等优化问题
@mirku21 强调了(15 个赞、9 条回复、420 次浏览、9 次收藏)介绍了 ACON:先在自然语言空间中优化压缩指南,再将其蒸馏进更小的模型。公开论文给出的 26-54% 峰值 token 降幅,以及较小 agent 在长任务上最高可提升 46% 的结果,使其成为上下文工程转向可量化系统工作的最清晰案例之一(论文)。
支付网络开始为消费者 agent 铺设信任轨道
@sytaylor 报道了(52 个赞、14 条回复、3,914 次浏览、25 次收藏)称,Visa、Mastercard 和 Ant International 正围绕共享的 Know Your Agent 框架对齐。公开报道显示,该框架旨在把 agent 与经过验证的运营方绑定起来,统一认证要求,并在不同支付网络之间持续监控;这比“助手在线买东西”式的单产品演示,明显更进一步(报道)。
7. 机会在哪里
**+++] 面向长时运行代理的上下文控制基础设施** - 这是当天最强的多来源机会。[@shannholmberg 把上下文做成了三存储架构;@mirku21 和 ACON 展示了压缩带来的可量化收益(论文);@marfinxx 指向生产数据更偏好短而受控的循环(论文);@gippp69 则把成本阈值和审批通道讲得很明确。证据表明,市场确实需要能够掌控压缩、来源追踪、路由和安全状态交接的产品。
**++] 具备契约而不只是目录的能力注册表** - [@beamnxw 和 Vercel Skills 仓库展示了能力打包的方向(仓库);而 @kv1nsiii、@CteaAminah 和 @0xCindyWeb3 都指向同一个缺失层:机器可读的输入、输出、预算、验收测试和失败语义。这个机会是中等而非压倒性的,因为已有多个项目在往这里走,但市场仍然很早期。
**++] 面向关键性代理行为的评估、认证与裁定** - [@JoshAEngels、@EMostaque、@PHAZE_001、@callmeperry3、@sytaylor 和 @ajrmdhn___ 在不同领域描述的都是同一个缺口:如果 agent 能写代码、动用资金或裁决争议,就必须有人建立一套可检查的标准,用来判断该行动是否被允许、是否正确,以及是否可逆。从研究治理到底层市场托管流程,这种需求已经清晰可见。
8. 要点
- 讨论持续上移到更高层的技术栈。 最有价值的帖子讨论的是 harness、确定性工具、审批逻辑和评测条件,而不是该选哪一个更好的前沿模型。(来源)
- 上下文纪律正在成为一个能带来可量化回报的工程问题。 最有力的证据来自具体架构和论文:它们降低 token 负载、限制循环深度,并保留真正重要的状态。(来源)
- 公开学习资源正在变得更偏操作,而不只是提供灵感。 工作坊、技能 CLI、代码图工具和方法论指南,正把 agent 工程打包成可安装或可教授的系统。(来源)
- 一旦 agent 能支出、部署或结算,信任就是最难解决的一层。 独立评估者、Know Your Agent 框架、验收测试和裁决规则之所以纷纷出现,是因为市场仍缺少一套用于证明高后果 agent 行动是否可靠的共同标准。(来源)