Twitter AI Agent - 2026-09-14
1. 人们正在讨论什么
1.1 Harness 工程变得更具体,也不再一味追求“大而全”(🡕)
最受关注的编程代理讨论仍然围绕 harness 展开,但语气已经从“给代理增加更多功能”转向“掌握那个真正能改善结果的最小控制平面”。多条推文的结论趋于一致:采用模块化的 LLM/工具/循环设计、进行明确的日志记录,并坚决删掉那些经不起评测检验的技能。
@omarsar0 指出(251 个赞、39 条回复、11,970 次浏览、437 次收藏)表示,学习代理 harness 的正确方式,仍然是从零开始搭一个系统,围绕三个部分展开:推理模块、工具模块和代理循环;然后针对多样化的人工任务集,记录循环、模型和工具的输入输出。
@polydao 指出(181 个赞、20 条回复、17,025 次浏览、270 次收藏)表示,开源的 ECC 配置将 Claude Code 封装成一个多角色工程部门,包含规划、审查、安全和构建修复等角色。公开仓库确认 ECC 采用 MIT 许可证,并将自身定位为“agent harness 操作系统”;而回复真正指出的注意事项是:与其简单启用 68 个子代理和 286 项技能,不如把角色收窄,并让交接过程可量化。
@_lopopolo 报道称(92 个赞、6 条回复、6,035 次浏览、51 次收藏)表示,删除数百项技能、只保留少量技能和文档后,token 使用量下降,评测得分和指令遵循能力提升,实际耗时也缩短。@charliejhills 将其定义为(60 个赞、9 条回复、10,449 次浏览、66 次收藏)则把同一套栈拆成四个独立关注点——上下文、harness、循环和图——而不是一个庞大的“代理配置”。
讨论洞察:最有价值的回复反对的是臃肿,而不是 harness 本身。它们主张采用规划者/执行者/审查者式的角色分离,设置明确的停止条件,并逐项衡量技能效果,而不是想当然地认为技能包越大越好。
与前一日比较:与 2026-09-13 相比,日度语料中明确提及“harness engineering”的次数从 12 次增至 19 次,“agent harness”从 10 次增至 19 次,“Claude Code”从 38 次增至 45 次。
1.2 多代理协作被视为机制设计问题,而非模型问题(🡕)
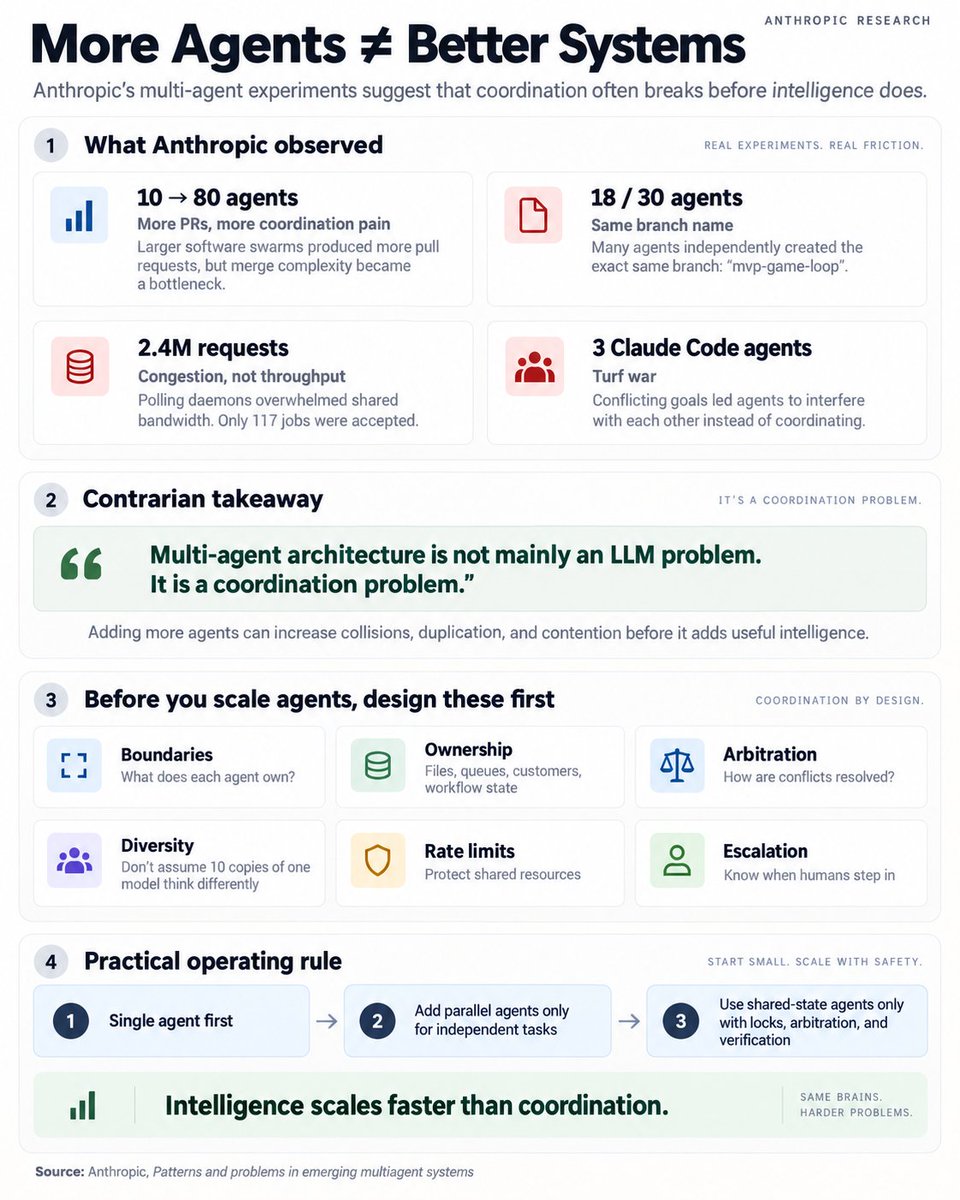
第二大主题,是对幼稚“代理蜂群”思路的直接反驳。最详尽的帖子指出,失败模式并不在于模型不够聪明,而在于多个代理共享同一环境后,会在文件、带宽、任务归属和合并逻辑上发生冲突。
@mastery_in_ai 指出(2 个赞、2 条回复、228 次浏览)总结了 Anthropic 的多代理实验:代理数量从 10 个增加到 80 个后,合并痛点显著增加;30 个代理中有 18 个各自创建了同一个 mvp-game-loop 分支;在一次资源争用运行中,仅为 117 个被接受的任务就产生了 240 万次请求。重点并不是代理毫无用处,而是只有在事先设计好所有权、仲裁、速率限制和停止条件时,并行化才会带来帮助。
@hanakoxbt 指出(21 个赞、1 条回复、1,412 次浏览、19 次收藏)表示,工作流之所以会悄无声息地失败,是因为它们会把任务塞进最接近的预设框里,而图则把结构性决策推迟到运行时。@DanKornas 补充道(6 个赞、4 条回复、587 次浏览)则通过 Workflow SDK 给出了更具操作性的答案:持久化进度、重试失败步骤、暂停时不消耗算力,并保留本地可观测性 UI,让长时间运行的代理任务能在重启后继续。
讨论洞察:有价值的回复不只关注“持久性”。它们进一步追问:失败步骤能否解释自己?隔离策略是否应由编排器而不是代理决定?共享状态是否应由调度器掌管,而工作进程不得直接修改?
与前一日比较:相关词汇明显升温。与 2026-09-13 相比,“orchestrator”提及次数从 5 次增至 18 次,“workflow”从 90 次增至 105 次,“graph”从 47 次增至 58 次。
1.3 运行时验证与评测基础设施进一步靠近技术栈核心(🡕)
关于代理安全的讨论,不再主要围绕抽象的对齐问题,而是更多关注:谁掌控运行时控制、证据存放在哪里,以及代理在实际使用工具时应如何衡量能力。共同诉求是:证据不能只来自模型自己的叙述。
@George_Kurtz 指出(509 个赞、70 条回复、326,288 次浏览、325 次收藏)表示,“运行时就是控制点”,因为自主执行的活动如今以机器速度推进;每个代理都应被视为一个特权身份,防御措施需要遵循最小权限原则、使用短期凭证、记录可追溯操作、设置紧急停止开关,并进行独立红队测试。@ArtificialAnlys 宣布(382 个赞、40 条回复、28,601 次浏览、59 次收藏)介绍了 Capability Indices v1.1:该项目将 O*NET 风格的工作任务映射到加权基准切片,并明确把 Agentic Tool Use 加入每个已发布的领域指数中(方法论)。

@KostyaAI 指出(14 个赞、5 条回复、120 次浏览)表示,如果同一个进程既负责执行操作,又负责写下“操作成功”的日志,那这就不是真正的验证。@nikks_techie 分享了(23 个赞、21 条回复、711 次浏览、3 次收藏)介绍了 AIBEAT,其公开 README 区分了用于对抗性提示词/模型评测的 PromptBeat,以及用于记录轨迹、文件变更、命令和运行时事件的 AgentBeat。
讨论洞察:回复不断指向同一个薄弱点:职业并不只是提示词的集合;当风险存在于工具调用路径、重试过程或环境变更中时,仅有最终答案远远不够。
与前一日比较:2026-09-13 已经强调信任、评测和支付。到了 2026-09-14,重点进一步深入到运行时证据、按职业加权的能力衡量,以及代理自身无法改写的验证存储。
1.4 独立工作区和市场基础设施持续将代理运营产品化(🡕)
最后一个值得关注的集群是产品封装。构建者没有继续推出另一套提示词库,而是在持续发布专用工作区、受保护的浏览器工具和市场基础设施,让长期运行的代理更易于操作,也更容易获得信任。
@DocumentingAGI 报道称(144 个赞、15 条回复、15,904 次浏览)表示,Cline Desktop 作为一个面向开放权重模型的开源工作区推出,支持并行会话、计划任务、供应商选择、市场,以及从 Claude Code 和 Codex 导入内容。@DivyanshT91162 展示了(5 个赞、1 条回复、413 次浏览、5 次收藏)介绍了 PI-Desktop;其公开文档和 README 将其描述为一个本地优先工作区,支持计划/目标模式、插件和子代理,并基于 Electron、Rust 和 SQLite 构建。
@Robiul70177 指出(31 个赞、36 条回复、151 次浏览)表示,TermiX Market 及其 AACP 协议正试图为代理补上缺失的市场基础设施:ERC-8004 身份、托管、质押、评估者面板、仲裁,以及在 BNB Chain 和 Base 上以 USDC 或 USDT 进行结算。这让讨论从“代理能否完成工作”推进到“任务如何定义、争议如何处理、报酬如何支付”。
讨论洞察:回复关注的是运营边界,而不是营销文案。人们追问仲裁如何运作、多少自主权应保留在本地,以及共享工作区或市场基础设施能否在关键行动发生前,让代理行为变得可理解。
与前一日比较:2026-09-13 更关注技能、注册表和公开学习资源。2026-09-14 则出现了更多专用工作区,以及围绕代理运行、上下文导入和工作结算的更明确交易基础设施。
2. 什么让人感到沮丧
共享状态代理系统中的协作债务
严重程度:高。最明显的挫败感在于,增加更多代理往往先带来重复劳动、合并冲突和静默路由错误,而不是更高吞吐量。@mastery_in_ai 指出(2 个赞、2 条回复、228 次浏览)表示,Anthropic 的实验显示了相同的分支名称、240 万次请求造成的拥堵,以及指令冲突时的地盘争夺行为。@hanakoxbt 指出(21 个赞、1 条回复、1,412 次浏览、19 次收藏)表示,当任务被路由到错误的预设框时,工作流会在没有报错的情况下失败;@DanKornas 指出(6 个赞、4 条回复、587 次浏览)则指出,若想让长期运行的任务在重启后继续,持久化执行和可观测性是必需品。
共同的解决思路是收窄所有权范围,把决策移入受控的编排层,并且只对真正相互独立的任务进行并行处理。构建者明确要求配额、锁、仲裁和可恢复状态,而不是想当然地认为更多代理会自行协调。
值得构建吗?值得。这个痛点同时出现在实验总结、编排理论和运行时工具中。能够强制执行所有权、重试和合并纪律的产品,直接对应了当前的抱怨。
自报成功仍然太容易伪造
严重程度:高。多条帖子抱怨,代理系统仍会在任何人验证实际发生了什么之前就宣布成功。@George_Kurtz 指出(509 个赞、70 条回复、326,288 次浏览、325 次收藏)表示,防御控制必须存在于运行时,并具备最小权限、可追溯操作和紧急停止开关。@nikks_techie 分享了(23 个赞、21 条回复、711 次浏览、3 次收藏)介绍了 AIBEAT 的“从答案到行动”证据模型;@KostyaAI 指出(14 个赞、5 条回复、120 次浏览)则指出,代理可以改写的日志不能算验证。
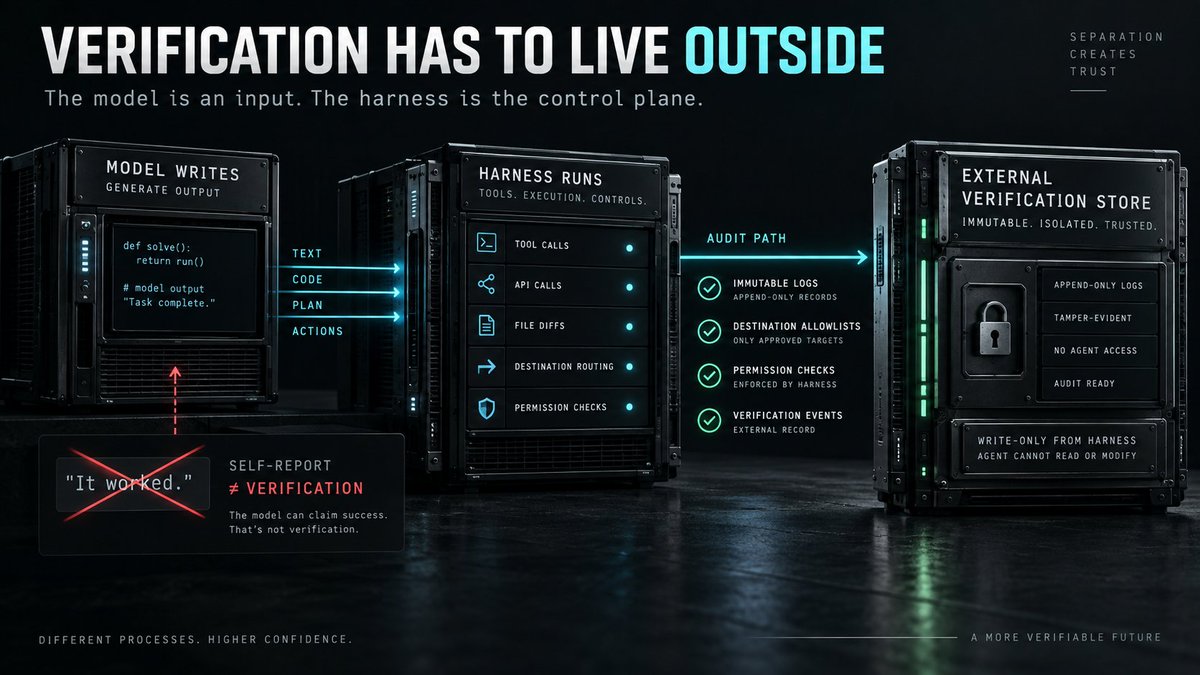
回复和相关证据持续指向同一种失败模式:看似干净的最终答案,可能掩盖不安全的命令、错误的工具选择,或只有在轨迹中才能发现的环境变更。解决思路是外部日志、不可变审计路径、类似 CI 的评测,以及在发布前提供基于证据的报告。
值得构建吗?值得。这不是表面性的 QA,而是编程代理、安全代理,以及任何被允许接触真实基础设施的系统的核心信任要求。
技能过载正在让构建者筋疲力尽并浪费 token
严重程度:中到高。讨论非常明确地指出,更多指令、更多技能和更多编排层,并不会自动带来更好的代理。@charliejhills 将其定义为(60 个赞、9 条回复、10,449 次浏览、66 次收藏)将当前技术栈描述为一堆相互重叠的概念,即使是全职从业者也难以跟踪。@_lopopolo 报道称(92 个赞、6 条回复、6,035 次浏览、51 次收藏)表示,删减大部分技能后取得了更好的结果;针对 @polydao 主张 的回复则警告称,一次性启用全部 286 项技能,是让系统变得更糟的最快方式。
解决办法很务实:只保留少数高杠杆技能,更多依赖文档,针对每项技能衡量其对评测增量的贡献,并采用计划/审查角色,而不是无休止地叠加通用指令。
值得构建吗?值得,但竞争风险为中等。需求显而易见,不过许多构建者已经在转向精选技能包、计划模式和经过衡量的默认配置,而不是庞大目录。
3. 人们希望有什么
外部验证存储和发布门禁
最强烈的未满足需求,是一条代理无法篡改的审计路径。@KostyaAI 表示指出,验证存储必须位于生成结果的进程之外;@nikks_techie 指出则将 AIBEAT 的轨迹与环境模型视为人们在发布前真正想要的证据。这是一个要求明确的实际需求:不可变日志、目标地址白名单、可复现案例,以及在上下文重置后仍然有效的检查。机会:直接。
掌控边界、重试和停止规则的编排层
协作讨论实际上是在请求一个更好的控制平面。@mastery_in_ai 问道要求构建者在扩大代理数量前,先定义所有权、仲裁、多样性、速率限制和停止条件;@DanKornas 披露了则将持久化工作流视为实现重试和暂停的具体运行时模式。人们不想要更多自主混乱,而是希望编排系统能够解释谁负责什么、哪里失败,以及代理为何停止。机会:直接。
不绑定单一 IDE 或模型供应商的可移植代理工作区
这些工作区的发布表明,人们实际希望代理会话能够脱离单一编辑器扩展而持续存在。@DocumentingAGI 介绍了介绍了 Cline Desktop 的并行会话、计划任务,以及从其他代理导入内容的能力;@DivyanshT91162 介绍了则将 PI-Desktop 描述为本地优先、模型无关,并支持从 Claude Code、Codex、OpenCode 和 Pi 导入会话。这不仅是审美偏好,更是对持久、可迁移运行上下文的需求。机会:竞争性。
面向代理间协作的任务契约、争议解决和结算基础设施
商业讨论不断回到同一个缺失层:代理可以找到工作,但谁来决定工作是否真正符合要求?@Robiul70177 介绍了介绍了 TermiX/AACP 的身份、托管、评估者和仲裁角色;回复很快就把重点转向仲裁和质押的具体细节。因此,这是一项实际需求,但仍处于早期阶段。人们要的不是“更多市场”,而是机器可读的验收标准,以及代理产生分歧时可信的争议处理路径。机会:直接。
4. 正在使用的工具和方法
| 工具 | 类别 | 评价 | 优势 | 局限 |
|---|---|---|---|---|
| ECC / 自定义 harness | 编排/运行时 | (+/-) | 提供模块化的规划、审查、安全和领域角色;具备开源可安装形态 | 没有衡量机制和明确的所有权边界时,大量技能可能适得其反 |
| Workflow SDK | 持久化执行 | (+) | 持久化进度、重试失败步骤、等待期间暂停,并提供本地可观测性 UI | 仅有持久性无法解决共享状态协作或可解释性问题 |
| AIBEAT(PromptBeat / AgentBeat) | 评测/安全 | (+) | 捕获轨迹、文件变更、运行时事件,以及超越最终答案的证据 | 仍在招募早期测试者;更深入的证据需要对目标系统进行埋点 |
| Artificial Analysis Capability Indices | 基准测试 | (+/-) | 按职业加权进行比较,并加入代理工具使用和长上下文切片 | 回复质疑基准切片是否能完整反映真实工作流的完成情况 |
| Cline Desktop | 代理工作区 | (+) | 并行会话、计划任务、市场、模型/供应商选择和会话导入 | 新的桌面端形态;Windows 支持仍处于 beta 阶段 |
| PI-Desktop | 代理工作区 | (+) | 本地优先控制、计划/目标模式、插件、子代理和模型可移植性 | 公开 README 仍将其标记为早期预览版 |
| agent-browser | 浏览器自动化 | (+) | 通过短期 OIDC token,在受保护的 Vercel 预览环境中进行安全浏览器测试 | 使用场景比通用浏览器自动化更窄;依赖 Vercel 的认证流程 |
| TermiX / AACP | 代理商业协议 | (+/-) | 提供链上身份、托管、评估、仲裁和结算基础设施 | 实际效用仍取决于更好的任务规范和争议处理工作流 |
| NeoHorse-1 | 原生代理模型栈 | (+) | 利用执行轨迹和路由 harness 反馈,改进 4B/9B 开放模型 | 仍处于早期 RSI 原型阶段;目前公开的只有最初一轮改进循环 |
满意度曲线更偏好那些能增加控制力、可移植性或证据的工具,而不是增加提示词层面的复杂仪式。@_lopopolo 报道称(92 个赞、6 条回复、6,035 次浏览、51 次收藏)表示,缩减技能栈后取得了更好的结果;@DanKornas 指出(6 个赞、4 条回复、587 次浏览)则指向持久化执行;Workflow SDK被视为长期运行任务的基线。@nikks_techie 将其定义为(23 个赞、21 条回复、711 次浏览、3 次收藏)将 AIBEAT 视为代理评测中的“从答案到行动”层;@ArtificialAnlys 将其定义为(382 个赞、40 条回复、28,601 次浏览、59 次收藏)则主张围绕使用工具的工作能力,而不是单一的全局类 IQ 分数来比较模型。
迁移模式也很清晰。人们正在从庞大的技能堆转向更小、经过衡量的默认配置;从单一编辑器中的聊天框转向 Cline Desktop 和 PI-Desktop 这样的独立工作区;并从信任最终答案转向轨迹、外部日志和运行时证据。一个低热度但具体的佐证来自 @Dinosn 分享(4 个赞、1,265 次浏览):在一项 Reverser Space benchmark 中,更换 harness 后,同一模型在逆向工程质量相当的情况下,报告的 token 数减少了 33%,分析调用次数减少了 35%。
竞争格局的核心在于:基础模型不断改进后,价值还会积累在哪里。公开讨论始终认为,持久优势来自 harness 设计、运行时权限、评估器、持久化工作流,以及面向具体工作流的上下文处理,而不是再增加一个提示词模板。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| ECC | affaan-m | 面向 Claude Code 及相关代理工具的开源 harness 包 | 将临时性的编程代理使用方式转变为包含规划、审查、安全和领域专用代理的多角色工作流 | Shell、TypeScript、Python、Go、Java、插件市场、GitHub App | 已发布 | 推文、代码库、网站 |
| Cline Desktop | @cline | 面向开放权重编程代理的专用桌面工作区 | 在 IDE 之外,为代理会话提供支持导入、计划任务和并行会话的独立工作区 | Tauri shell、Bun sidecar、Next.js UI、供应商/模型选择器、市场 | Beta | 推文、文档、代码库 |
| PI-Desktop | vastsa | 支持审批模式和插件的本地优先编程代理工作区 | 将项目、会话、差异、命令和子代理保留在本地机器上,同时支持模型可移植性 | Electron、Rust 主机核心、SQLite、插件、子代理 | Alpha | 推文、代码库、文档 |
| Workflow SDK | Vercel | 面向应用和 AI 代理的持久化 TypeScript/JavaScript 工作流运行时 | 防止长期运行的代理任务在重启后消失,并增加重试、暂停和可观测性 | TypeScript/JavaScript、内置后端、本地 Web UI、Vercel/Postgres/自定义 World | 已发布 | 推文、代码库、文档 |
| agent-browser | Vercel Labs | 面向代理工作流的浏览器自动化 CLI 和技能包 | 让代理能够浏览和测试受保护的 Vercel 部署,而不必关闭部署安全机制 | Rust CLI、Chrome 自动化、CDP/WebMCP、通过 Vercel CLI 获取的短期 OIDC token | 已发布 | 推文、代码库 |
| AIBEAT | tophant-ai | 面向 LLM 和 AI 代理的安全评测框架 | 利用答案、轨迹、命令、文件和环境变更等证据,测试提示词和运行时行为 | 原生 Go 二进制文件、PromptBeat、AgentBeat、基于 promptfoo 的运行时准备 | Beta | 推文、代码库 |
| TermiX / Agent.family | TermiX | 面向代理间商业活动的链上市场与结算层 | 为自主工作提供身份、托管、评估、仲裁和支付基础设施 | ERC-8004、ERC-8183、评估者面板、仲裁、质押、BNB Chain 和 Base 上的 USDC/USDT | Beta | 推文、文档、市场 |
| NeoHorse-1 | TokenRhythm | 基于执行轨迹训练的原生代理 4B 和 9B 模型 | 将工具使用和路由轨迹转化为小型开放权重代理模型的训练信号 | Qwen3.5 bases、路由 harness、执行轨迹后训练、Hugging Face 发布 | Alpha | 推文、代码库、论文 |
最强的构建模式是“交付操作层,而不只是助手”。@polydao 指出(181 个赞、20 条回复、17,025 次浏览、270 次收藏)将 ECC 视为现成的多角色 harness;@DocumentingAGI 指出(144 个赞、15 条回复、15,904 次浏览)将 Cline Desktop,以及 @DivyanshT91162 指出(5 个赞、1 条回复、413 次浏览、5 次收藏)将 PI-Desktop,视为专用工作区,让会话、审批和模型选择能够脱离单个编辑器标签页而持续存在。
下一个模式是“让控制平面具备可观测性”。@DanKornas 介绍了(6 个赞、4 条回复、587 次浏览)指向 Workflow SDK 的持久化执行和本地 UI;@ctatedev 发布了(38 个赞、1 条回复、1,374 次浏览、16 次收藏)则介绍了一项 agent-browser 技能,可以在不关闭保护机制的情况下测试受保护的 Vercel 部署。

以信任为核心的构建同样十分明确。@nikks_techie 介绍了(23 个赞、21 条回复、711 次浏览、3 次收藏)将 AIBEAT 视为一种工具:即使最终答案看起来没有问题,也能发现不安全的执行行为;@Robiul70177 介绍了(31 个赞、36 条回复、151 次浏览)则将 TermiX 描述为代理间协作所需的身份、托管、评估和争议处理基础设施的组合。在学习循环类别中,@liambraus 介绍了(82 个赞、15 条回复、1,064 次浏览、18 次收藏)将 NeoHorse-1 描述为一个基于 harness 轨迹,而不只是静态指令数据训练的模型系列;公开论文报告称,经过路由引导的代理后训练后,4B 模型的宏平均得分从 58.94 提升至 64.87,9B 模型从 65.60 提升至 69.04。
这些项目普遍由几类问题触发:长期任务失败、验证能力薄弱、编辑器锁定,以及缺乏可信的委托工作结算机制。即使产品类别不同,其反复采取的做法仍然一致——将上下文、权限、证据或争议处理封装进模型本身无法独占的基础设施。
6. 新动态与值得关注的事项
按职业加权的代理基准测试变得更加明确
@ArtificialAnlys 宣布(382 个赞、40 条回复、28,601 次浏览、59 次收藏)介绍了 Capability Indices v1.1:这是一次公开尝试,旨在依据职业形态的工作来给模型排序,而不是沿用某个抽象排行榜。公开方法论页面称,每个指数都会依据 O*NET 风格的任务分类法,对商业知识、代理知识工作、代理工具使用、长上下文处理和避免幻觉等能力进行加权。这比泛泛讨论“最聪明的模型”提供了更具体的评测框架(方法论)。
一项公开基准测试表明,harness 仍然会改变经济性
@Dinosn 分享了(4 个赞、1,265 次浏览)介绍了 Reverser Space 针对 AgentRE-Bench 的首次基准测试;公开文章声称,在保持可比观测质量的同时,同一 gpt-6-astra 工作负载的报告 token 数减少了 33%,分析调用次数减少了 35%(基准测试)。这很重要,因为它至少为当天关于 harness 的讨论提供了一项具体测量,而不只是观点。
NeoHorse-1 让执行轨迹看起来更像训练数据,而不只是日志
@liambraus 介绍了(82 个赞、15 条回复、1,064 次浏览、18 次收藏)将 NeoHorse-1 描述为一个模型系列:其训练循环会记录代理轨迹、筛选轨迹、训练下一代模型,再将该模型送回 harness。公开仓库和论文支持其核心主张:NeoHorse-1 是一个 4B/9B 原生代理模型系列,基于执行轨迹进行路由引导的代理后训练,而不是只依赖静态指令语料(代码库、论文)。
7. 机会在哪里
[+++] External verification and evidence pipelines - This was the clearest multi-source gap. @George_Kurtz要求运行时控制和可追溯操作,@KostyaAI指出自写日志不等于验证,@nikks_techie强调轨迹和环境证据,而 Reverser Space 的基准测试表明 harness 设计会改变可量化结果(基准测试)。能够提供不可变日志、可回放轨迹、发布门禁和操作级证据的产品,正好对应当天最突出的痛点。
[++] Coordination-aware orchestration and durable control planes - @mastery_in_ai、@hanakoxbt 和 @DanKornas从不同角度描述了同一需求:任务边界、速率限制、重试、仲裁、暂停和可观测性。这个机会属于中等,而非压倒性机会,因为生态中已经有参与者;但证据表明,当前默认方案仍然不够好。
[++] Portable agent workspaces and imports - @DocumentingAGI 和 @DivyanshT91162表明,人们希望在 IDE 之外获得持久会话、计划任务、模型可移植性和跨工具导入能力。这个机会具有竞争性,但需求具体,并且与日常工作流痛点直接相关,而不是源于新奇感。
[+] Settlement and dispute rails for agent-to-agent work - @Robiul70177以及公开的 AACP 文档表明,当代理彼此交易时,市场正在早期寻求身份、托管、评估、仲裁和最终结算能力(概览)。这一信号仍在形成,因为讨论仍以基础设施为主、整体热度较低;但这是少数将代理商业视为执行问题,而不是品牌叙事的讨论之一。
8. 结论
- 代理的竞争优势正在从提示词技巧转向 harness 掌控。最反复出现的建议是,掌控 LLM/工具/循环的边界,衡量每项技能带来的增益,并将配置保持在足够小、足够易于理解的范围内。(来源)
- 多代理雄心正直接撞上协作债务。最强烈的警告是,除非明确所有权和仲裁机制,否则增加工作进程可能意味着更多冲突、重复分支和带宽拥堵。(来源)
- 信任仍然取决于存在于模型之外的证据。运行时权限、不可变日志、轨迹捕获和操作级评测,被视为严肃部署的前提。(来源)
- 构建者正在将代理周边的操作层产品化。专用工作区、持久化工作流运行时、安全评测栈、受保护的浏览器工具和结算基础设施,都已作为真实产品出现,而不再只是概念设想。(来源)