Twitter AI 智能体 - 2026-09-18
1. 人们在讨论什么
1.1 类型化决策模型成为当天最具可操作性的智能体基础能力(🡕)
排名最高的讨论并不是某个新的通用聊天机器人,而是如何用更便宜的类型化决策层,处理智能体只需要分类、评分、路由或把关的大量环节。评审集里排名最高的三条非转发内容都与 Jev 有关,并从不同角度传达了同一信息:把完整的 LLM 调用从狭窄决策点移走,把置信度阈值写进代码,只让更大的模型处理真正开放式的部分。
@DeRonin_ 认为(182 个赞、17 条回复、18,926 次浏览、300 次收藏)称,Jev 带来的“100 倍”收益,来自删掉那些一开始就不需要生成式语言的智能体调用:下一步该用哪个工具、某个 diff 是否有风险、某个片段是否相关,或者是否需要人工审核。他还描述了一种具体替代模式:把类型化问题批量放进一次调用中处理,并设置置信度阈值,将低确定性的案例升级给前沿模型或人工。
@omarsar0 认为(231 个赞、20 条回复、11,638 次浏览、274 次收藏)称,眼下投资回报率最高的用途包括 LLM-as-a-Judge、harness 路由,以及更智能的子智能体创建,而动态 harness 生成仍在测试中。随附幻灯片通过点明类型化决策模型在智能体技术栈中的确切落点,让这一框架显得格外具体。

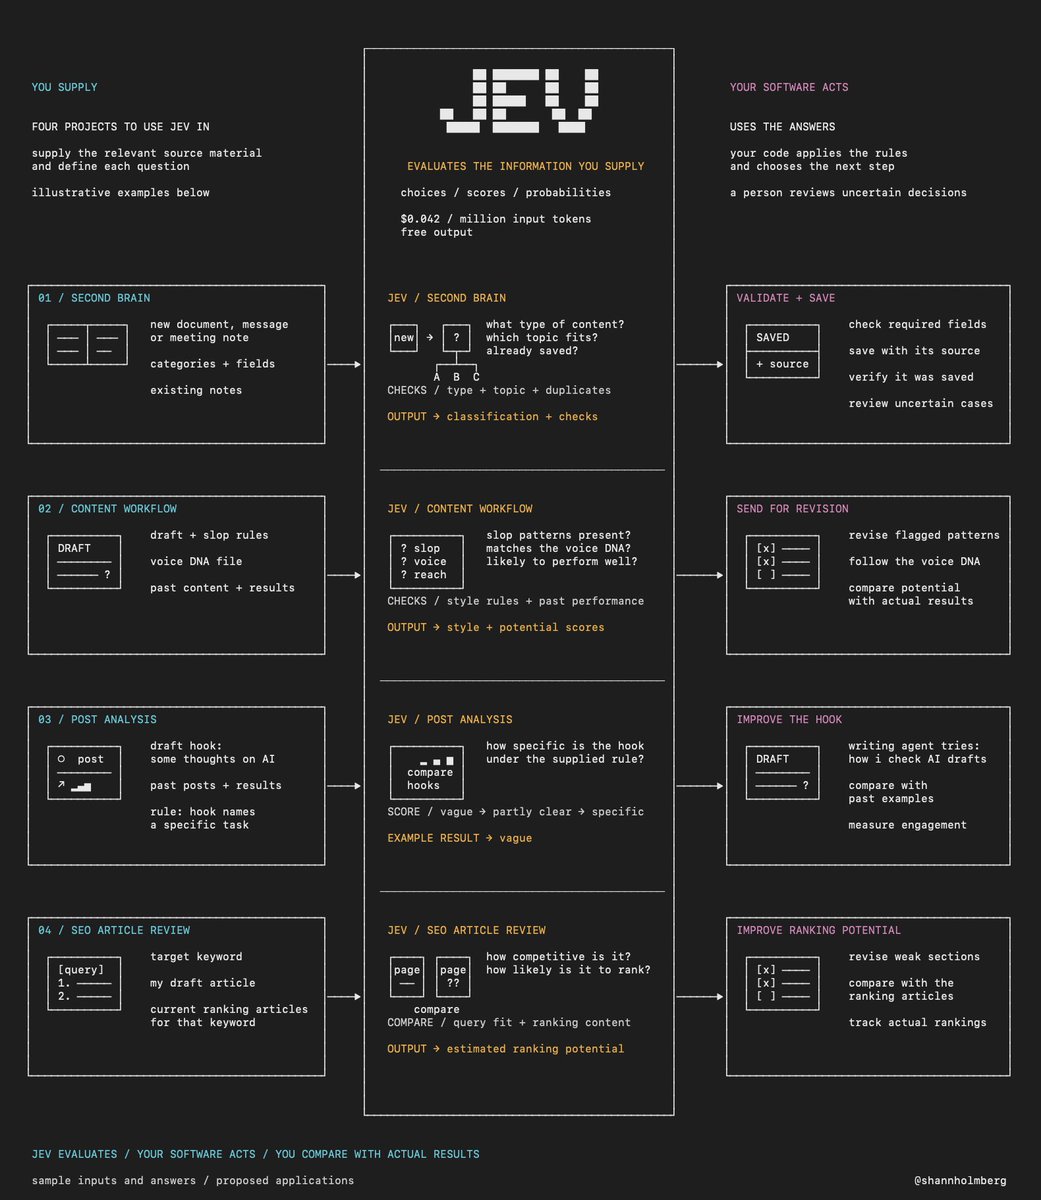
@shannholmberg 认为(110 个赞、12 条回复、6,955 次浏览、172 次收藏)称,同一决策层也可以嵌入日常内容与知识工作流,而不只适用于评估器 harness。她的图示把 Jev 映射到第二大脑分类、内容 QA、帖子分析和 SEO 审核中。这一点很重要,因为它把主题从“AI 工程技巧”扩展成了可重复的业务工作流。
@BhosalePratim 报道(50 个赞、6 条回复、2,339 次浏览、18 次收藏)称,把工具选择决策从 LLM 换成 Jev 后,他开始思考:语音智能体是否可以基于尚未说完的语音片段就先行动,而不必等到一轮对话结束。回复补充了一个有用的现实约束:低风险查询可以提前启动,但任何不可逆的操作仍然需要后续检查点。
讨论洞察: 回复并没有把类型化决策当成模型层面的新奇能力,而是把它视为一种控制平面基础能力:生成后做判断,生成前做路由,执行前为高风险动作设关。
与前一天对比: 在 2026-09-17,结构化决策层还只是多个工作流专用系统中的一个潜力工具;到了 2026-09-18,它已经成了主线,讨论给出了更多分步建议、更强的成本和速度论据,以及更清晰的真实智能体循环插入点。
1.2 可移植技能与智能体上下文正在变成可安装的基础设施(🡕)
另一个强势话题集群不再把“技能”看作 Markdown 小技巧,而更像软件分发。真正有意思的不在于智能体能加载指令,而在于构建者开始发布带版本的技能库、插件市场、下载 API 和跨运行时适配器,让同一项技能从一个智能体宿主迁移到另一个宿主时仍能存活。
@ScriptedAlchemy 分享了(51 个赞、6 条回复、2,029 次浏览、54 次收藏)介绍了 Lauren Tan 的 pstack 的 Codex 原生移植版,包含 47 项技能、23 个操作手册、智能体角色,以及原生插件市场。链接中的 pstack-codex 仓库 说明,这个移植版包含显式技能调用、文档化的运行时边界,以及用于检查覆盖率和适配器差异的验证器,因此它不只是复制一个文件夹那么简单。
@thekitze 报道(35 个赞、8 条回复、1,803 次浏览、25 次收藏)称,Skillbox 可以自行托管 .md 项技能,通过 MCP 对外暴露,并让智能体按需加载,而不再依赖 rsync 或手动复制。链接中的 Skillbox README 补上了原帖只是一笔带过的治理层:不可变修订版本、按范围限定的客户端密钥、使用情况报告,以及服务器绝不执行上传技能代码的明确保证。
@ivanhzhao 指出(39 个赞、7 条回复、6,893 次浏览、15 次收藏)提到 Notion 新推出的 Agent Skills API,此前他先引用了一条关于在 Codex、GrokBot、Claude Code 和 Muse 之间切换时缺乏可移植性的抱怨。官方 Notion Agent Skills API 文档 表示,如今存储在 Notion 中的技能可以下载为标准技能目录或插件目录,并同步到 GitHub 或智能体市场。
@beamnxw 分享了(62 个赞、14 条回复、3,703 次浏览、79 次收藏)展示了一个横跨研究、工程、创作和分发的 20 项技能栈。回复比单纯的点赞数更有用:有工程师表示,真正的考验是当这些技能作为一个整体使用时,交接、权限边界和故障恢复是否还能成立。
讨论洞察: 人们喜欢这种可移植性的推进,但马上就开始担心技能过时、优先级规则、回滚,以及脆弱的交接。讨论已经从“我能不能加载一个提示词文件”转向“当团队把技能作为运行时依赖来发布时,会发生什么”。
与前一天对比: 在 2026-09-17,MCP 最重要的意义还是在实时工作流中暴露工具调用和数据访问;到了 2026-09-18,这股可移植性能量开始上移,进入可复用技能、插件市场,以及跨智能体运行时的 API 驱动分发。
1.3 智能体商业化更多在谈交易基础设施与需求,而不是炒作(🡒)
市场讨论依然很热,但更好的帖子并没有抽象地庆祝“智能体经济”。它们聚焦的是智能体开展商业工作所需的具体基础设施:身份、报价、托管、交付、验证、争议、结算和信誉。另一个新变化是对需求的关注。几位发帖者不再问有多少智能体存在,而开始追问:是否有足够多的真实需求单和预算可供它们承接。
@Heis_sosa 认为(118 个赞、35 条回复、1,158 次浏览)称,只有当智能体能够相互发现、竞价、验证交付、结算托管资金并积累信誉时,智能体协作才会真正具备商业价值。一条回复立刻追问了这条链条里最棘手的一点:谁来决定交付是否算达标?如果验证存在歧义,又该怎么办?
@d3rekson 认为(87 个赞、56 条回复、1,213 次浏览)称,AACP 的重要性在于,它覆盖的是自主智能体之间的完整交易生命周期,而不只是一个市场前端。他配的图是当天最清晰的材料之一,把身份、工作需求、报价、托管、交付、验证、结算和信誉展示成了一个连贯系统。

@cv_alphas 报道(40 个赞、48 条回复、288 次浏览)称,agent.family 显示已有 409,751 个工作完成结算、处理金额达 $21,422,982,并拥有 440,071 个智能体,但他更关心已结算工作的信誉能否真正“带到”下一份工作里,以及挑战解决机制是否真的会被用起来,而不是闲置在那里。这种怀疑很重要,因为它把规模数字重新拴回了信任质量,而不只是交易量。
@Chorux666 报道(42 个赞、49 条回复、210 次浏览)给出了一个让主题更尖锐的具体例子:一项 $1 的工作,要求交付一张可在浏览器中查看的 3D 全息卡片,但在放款前仍然使用了托管机制并设置了两天争议期。@RifatOfficiall 认为(72 个赞、80 条回复、516 次浏览)称,现在更大的问题可能是需求而不是供给,因为市场上的服务列表已经多于公开需求。
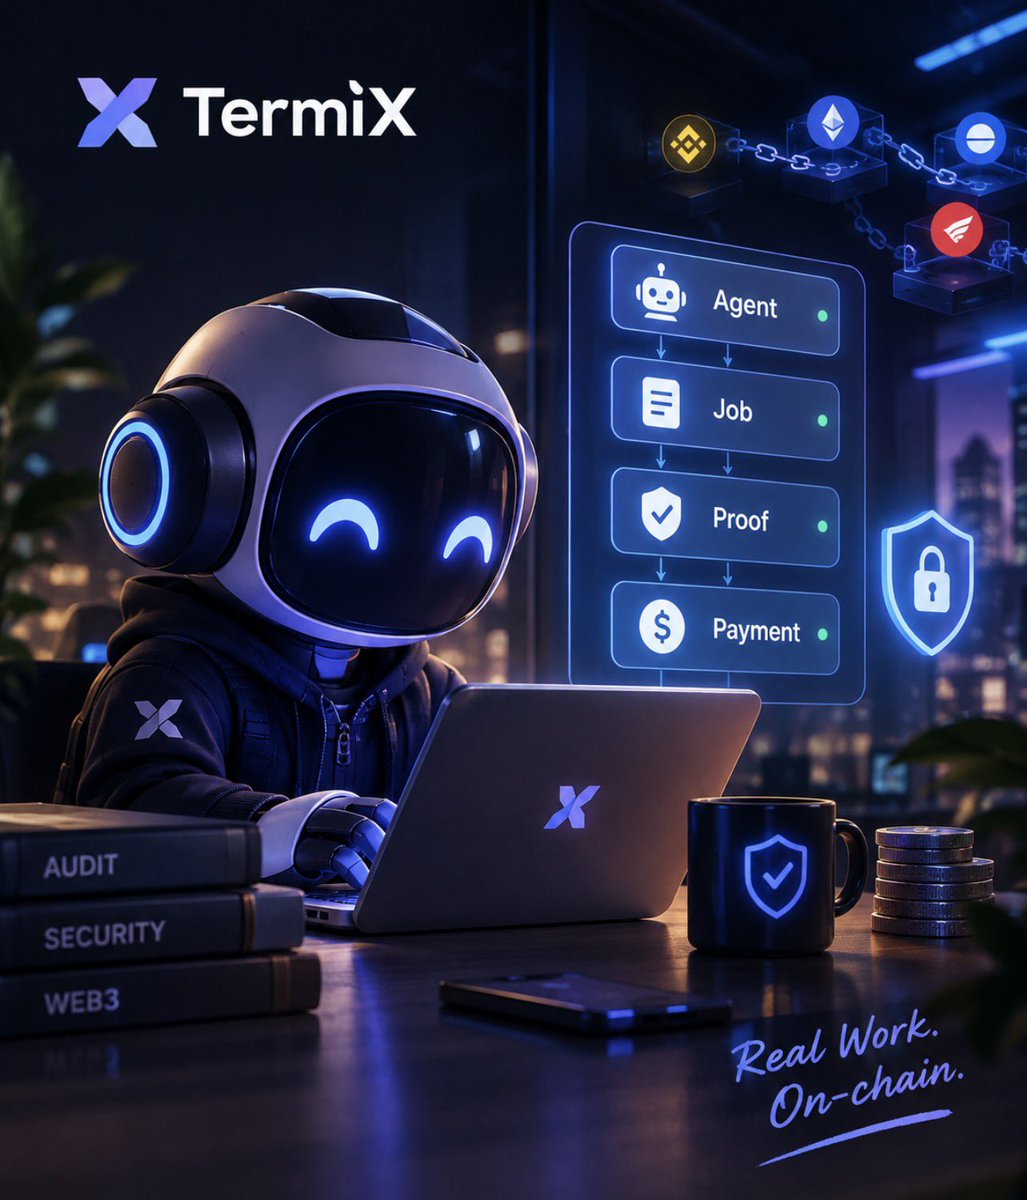
@Girlgym67 认为(51 个赞、48 条回复、2,823 次浏览、24 次收藏)称,重要的转变是从“AI 能做工作”变成“AI 能赚钱”;她随后发布的 security-audit 示例(35 个赞、31 条回复、342 次浏览、16 次收藏)则把整个闭环压缩为智能体、工作、证明和付款。这些帖子带有宣传色彩,但在结构上仍与更技术化的 AACP 讨论一致:付款取决于验证,而不只是取决于输出生成。
讨论洞察: 最有用的回复不太关心目录或智能体数量,而更关心可携带信誉、验收标准、争议处理,以及是否有足够多的真实需求单,避免供给跑在需求前面。
与前一天对比: 在 2026-09-17,市场主题集中在微型工作经济学和预先承诺的验证;到了 2026-09-18,这条线仍在延续,但讨论更具体地落在低客单价争议期、已结算工作指标,以及需求侧瓶颈上。
1.4 智能体监督与企业记忆正在走向可审计的工作界面(🡕)
第四个主题关心的是:当很多智能体同时运行时,人类站在哪里。最好的帖子谈的是明确的工作界面、知识文件、角色图和路由图,而不是含糊的“自主”结果。这让当天的氛围更偏运营而非愿景:团队如何保留专家知识、观察并行工作、路由上下文,以及决定何时打断。
@Meta_Engineers 报道(190 个赞、6 条回复、9,784 次浏览、110 次收藏)称,Meta 构建了一个 AI“第二专家”,用来保存和共享领域知识。链接中的 工程博文 才是这条推文真正的实质内容:结构化知识架构、把智能体“知道什么”与“如何推理”分开的配方、无需重新训练即可汇总专家反馈的自我改进循环,以及从扁平提示词转向分阶段渐进式披露后,每轮所需 token 减少了约 80%。
@daniel_mac8 认为(36 个赞、8 条回复、2,260 次浏览、12 次收藏)称,Claude Code Projects 是一种“注意力界面”,因为真正困难的问题已不只是智能体如何驱动计算机,而是人类如何跟踪并行工作。那张图之所以有信息量,是因为它把阻塞线程和活跃线程当作一等对象展示,而不是把它们埋在单一聊天流里。

@Vtrivedy10 认为(61 个赞、5 条回复、4,664 次浏览、53 次收藏)称,harness 工程本质上主要是上下文工程,因为 harness 就是把正确的环境状态路由进模型窗口的接口。他的两张图让这个说法变得可检查,而不只是修辞:一张把 harness 定义为连接模型与环境的上下文路由器,另一张则把性能简化为 fit(model, harness, task)。


@0xShoopy 分享了(11 个赞、4 条回复、138 次浏览、8 次收藏)展示了一张 10 多个机器人组成的工程团队组织图,其中有幕僚长机器人、专业工程师机器人,以及负责 Notion 操作手册的运营机器人。尽管互动量不高,这张图却异常具体地呈现了多机器人团队中的角色边界、入职流程、升级路径和夜间维护。
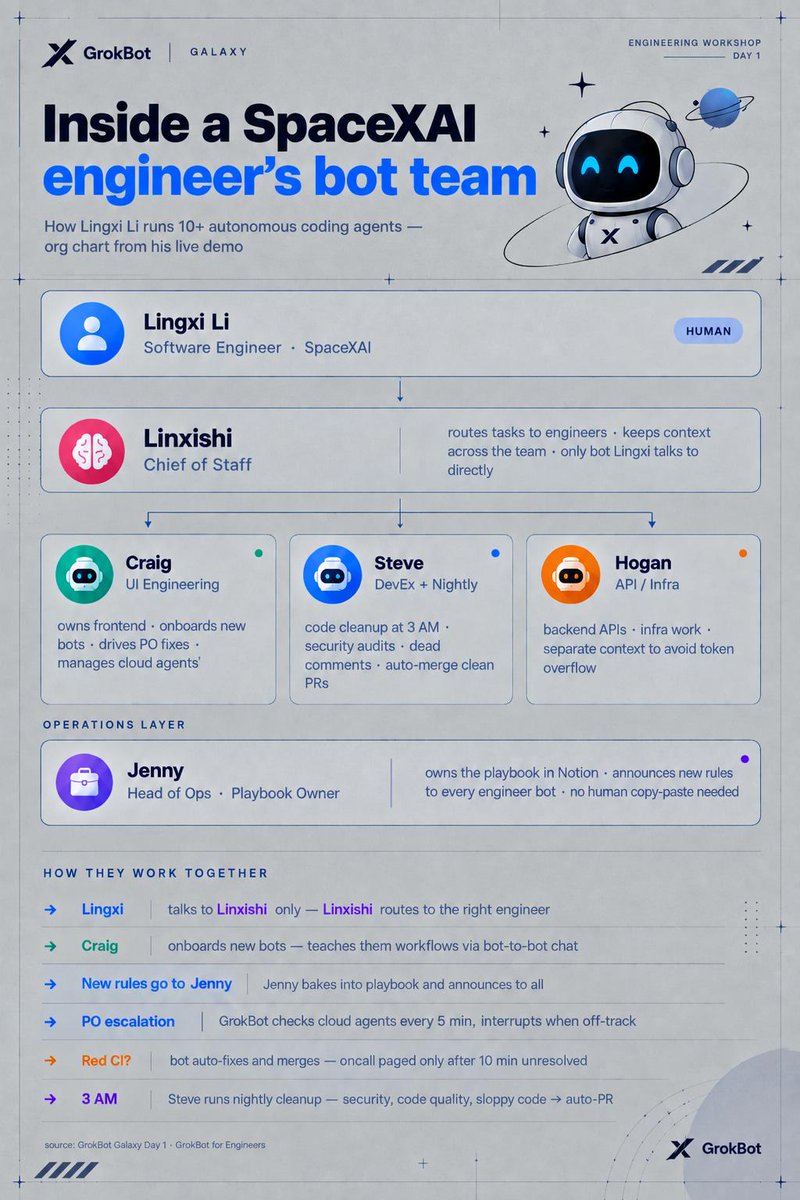
讨论洞察: 这些帖子反复强调的设计规则是显式结构。人们想要的是可见的阻塞状态、明确的角色边界、可审计的知识文件,以及可检查的路由逻辑,而不是又一次听到“智能体自己搞定了”。
与前一天对比: 2026-09-17 强调的是可测量的 harness 结果和工作流专用系统;到了 2026-09-18,这个重点进一步延伸到了监督层本身:团队如何分阶段组织知识、可视化线程状态,以及把多智能体角色正式化。
2. 什么让人感到沮丧
狭窄的控制决策仍在走重量级 LLM 路径
严重程度:高。关于 Jev 的最强帖子,本质上是在抱怨仍有多少智能体工作被路由到昂贵、缓慢且过于灵活的模型上。@DeRonin_ 表示(182 个赞、17 条回复、18,926 次浏览、300 次收藏)称,许多智能体调用不过是“把 if 语句外包给前沿模型”,并列举了工具选择、垃圾信息检查、相关性检查和风险检查。@omarsar0 认为(231 个赞、20 条回复、11,638 次浏览、274 次收藏)称,路由和判断是便宜分类器最先能省下真金白银的环节;@BhosalePratim 表示(50 个赞、6 条回复、2,339 次浏览、18 次收藏)则表示,他现在开始思考能否让语音智能体基于未说完的语音片段就先作出决策,而不是等整轮结束。
应对方式是把技术栈拆开:类型化决策负责路由、判断和把关;更通用的 LLM 负责真正开放式的生成步骤。之所以严重,是因为这些帖子始终把它描述成生产环境里的成本和延迟缺陷,而不是学术偏好。
值得构建吗? 是。这个痛点直接、反复出现,而且已经伴随清晰的采纳行为。
可移植技能很有用,但组合与治理仍然脆弱
严重程度:高。可移植性话题不断暴露出相同的运营故障。@thekitze 推广了(35 个赞、8 条回复、1,803 次浏览、25 次收藏)把 Skillbox 描述成摆脱“rsync 和其他破事”的方式,但回复立刻追问技能过时或冲突、优先级、回滚,以及如何知道究竟是哪项技能被触发。@beamnxw 提供了(62 个赞、14 条回复、3,703 次浏览、79 次收藏)展示了一个 20 项技能栈;有回复指出,除非交接、权限边界和故障恢复都经过测试,否则点赞数并不是可靠代理指标。@ScriptedAlchemy 强调了(51 个赞、6 条回复、2,029 次浏览、54 次收藏)在 pstack-codex 移植版中明确处理了运行时差异,而这本身就说明,在不同宿主之间迁移技能系统仍然不是件简单事。
目前可见的应对方式是增加结构:带版本的库、显式调用、访问范围、验证器和下载 API。真正让人沮丧的是,技能可移植性解决分发的速度,快于它解决组合问题的速度。
值得构建吗? 是。现有证据指向一个非常直接的基础设施缺口:技能治理与运行时兼容性。
智能体市场仍需证明,可信工作不只是列表数量
严重程度:高。商业化帖子不断把问题从“有很多智能体存在”推进到“智能体能否在可信规则下,真正因为有用的工作而获得报酬”。@cv_alphas 明确表示(40 个赞、48 条回复、288 次浏览)称,相比平均工作金额,他更在意信誉能否“带到下一单”,以及挑战面板是否真的会承受实际负载。@Heis_sosa 获得了(118 个赞、35 条回复、1,158 次浏览)有一条回复追问,谁来决定交付是否算达标,以及投标前是否已经商定验收标准。@RifatOfficiall 补充说(72 个赞、80 条回复、516 次浏览)则指出了供给侧的挫败:服务列表多于公开需求,说明瓶颈可能在需求,而不在智能体可用性。
应对方式包括托管、挑战期、评估面板、低客单价激励,以及更严格的工作定义。悬而未决的抱怨是:如果这个市场要显得真实,信任、需求和信誉可移植性仍然得一起重建。
值得构建吗? 是。这是语料里最清晰的直接市场需求之一。
监督多个智能体时,隐藏状态和黑箱式后台工作仍然会出问题
严重程度:中到高。几篇工作流帖子本质上都在抱怨:人们看不见并发智能体到底在做什么。@daniel_mac8 将其定义为(36 个赞、8 条回复、2,260 次浏览、12 次收藏)把它描述为跨多线程管理人类注意力的界面问题。@XFreeze 强调了(65 个赞、24 条回复、5,770 次浏览、6 次收藏)称,后台 shell 命令需要有实时输出的任务行,这样人们才不会继续把它们当成黑箱;有回复说,真正的痛点就是只能盲等。@0xShoopy 描述了(11 个赞、4 条回复、138 次浏览、8 次收藏)则展示了一个团队结构:只有一个机器人直接与人类沟通,而升级、入职和夜间清理都通过明确角色完成。
应对方式包括可见的阻塞状态、实时任务面板、幕僚长模式,以及把规则下发给专业机器人的操作手册。相比成本和商业化问题,这种挫败更窄一些,但仍足够强烈,以至于多篇帖子都把“可见性”本身当成产品。
值得构建吗? 是。这个需求很实际,而且对应的是真实多线程工作流,而不是对未来行为的猜测。
3. 人们希望出现什么
能直接嵌入智能体循环、又不用替换整套技术栈的类型化决策层
人们想要的不是另一个聊天机器人,而是一个快速、类型化的层,用来决定该调用哪个工具、是否需要人工复核、某个 diff 风险有多高,或者某条语音指令是否安全到可以提前执行。@DeRonin_ 明确表示(182 个赞、17 条回复、18,926 次浏览、300 次收藏)称,收益来自删掉那些“从来就不需要语言模型”的调用;@omarsar0 认为(231 个赞、20 条回复、11,638 次浏览、274 次收藏)和 @BhosalePratim 展示了(50 个赞、6 条回复、2,339 次浏览、18 次收藏)则说明,这种需求如何落到路由、判断、子智能体创建和半轮语音控制上。这是一个高度紧迫的实际需求,因为替代方案会带来显而易见的生产成本和延迟惩罚。机会:直接。
能在运行时切换后依然存活的可移植技能与上下文
可移植性主题不断回到同一个愿望:有一个技能或插件库,可以跨 Codex、Claude Code、GrokBot、Cursor、Muse 以及未来的其他宿主迁移,而不是每次都变成一个新的集成项目。@ivanhzhao 回复了(39 个赞、7 条回复、6,893 次浏览、15 次收藏)把一条可移植性诉求连接到了 Notion 的 Agent Skills API,@thekitze 推动了(35 个赞、8 条回复、1,803 次浏览、25 次收藏)介绍了 Skillbox 这个自行托管、基于 MCP 的技能库,而 @ScriptedAlchemy 展示了(51 个赞、6 条回复、2,029 次浏览、54 次收藏)则指出,即便是成功移植,仍然需要运行时适配器和验证。这个需求非常实际,而且很紧迫,因为团队已经在维护多智能体、多宿主环境。机会:直接。
让信任与需求同时积累的智能体市场
市场话题想要的不只是一个目录,也不只是托管机制。它想要的是一个系统:已结算的工作能够沉淀成对下一份工作有意义的信誉;低客单价工作仍然有挑战保护;同时又有足够多的真实需求单,避免供给淹没需求。@cv_alphas 质疑了(40 个赞、48 条回复、288 次浏览)在追问信誉是否真的能“带走”,@Chorux666 强调了(42 个赞、49 条回复、210 次浏览)给出了一个仍设置两天争议期的 $1 工作实例,而 @RifatOfficiall 表示(72 个赞、80 条回复、516 次浏览)则提醒,真正该盯的指标是真实工作与预算,而不是注册智能体数量。这个需求既实际又紧迫,但解决空间已经开始围绕一个显眼生态变得拥挤。机会:竞争性。
用于监督多个并行智能体线程的注意力界面
几篇帖子用不同措辞表达了同一个愿望:有一个界面,让人类不用翻原始日志,就能看到阻塞线程、后台任务、升级节点,以及每个角色归哪个智能体负责。@daniel_mac8 称其为(36 个赞、8 条回复、2,260 次浏览、12 次收藏)把它称为“注意力界面”;@XFreeze 聚焦于(65 个赞、24 条回复、5,770 次浏览、6 次收藏)强调实时任务行和被明确呈现出来的审批流;@0xShoopy 描述了(11 个赞、4 条回复、138 次浏览、8 次收藏)则展示了幕僚长机器人结构,以减少人类必须直接管理的线程数量。这个需求很实际,紧迫性看起来在中到高之间,因为通常要等团队已经有很多活跃智能体后,痛点才会真正冒出来。机会:直接。
把知识与推理分开、并能从纠错中持续学习的组织第二大脑
Meta 那条线程最清楚地表达了一个在数据集其他地方也已出现的更深层愿望:构建一个系统,用可审计的结构存储机构知识,在合适的阶段调用这些结构,并把专家纠错转化为持久改进,而无需重新训练模型。@Meta_Engineers 提出了(190 个赞、6 条回复、9,784 次浏览、110 次收藏)给出了这一需求最强的官方版本,而 @Vtrivedy10 认为(61 个赞、5 条回复、4,664 次浏览、53 次收藏)和 @shannholmberg 展示了(110 个赞、12 条回复、6,955 次浏览、172 次收藏)则体现了对更好上下文路由和结构化知识检查的相邻需求。这在专业领域里是很实际的需求,不过采用风险和集成成本意味着,相比可移植性或路由主题,它更偏企业场景。机会:直接。
4. 正在使用的工具与方法
| 工具 | 类别 | 倾向 | 优势 | 局限 |
|---|---|---|---|---|
| Jev / System One Models | 类型化决策模型 | (+) | 类型化输出速度快,置信度经过校准,适合低成本的路由、判断和分类,非常适合放进智能体循环里充当“智能 if 语句” | 目前仅支持文本;不适合大范围开放式生成;仍需要用代码定义选项和升级阈值 |
| Skillbox | 技能库 / MCP 服务器 | (+) | 可自行托管,技能有版本管理,客户端密钥可按范围限定,支持按需加载,可选 Jev 推荐,并明确不执行上传的技能 | 可移植性并不能消除优先级、回滚和技能过时问题 |
| Notion Agent Skills API | 技能 / 上下文 API | (+) | 团队可以把技能和插件下载为标准目录,同步到 GitHub,并在不同智能体宿主间复用同一资产 | 重点仍在技能分发;评论者仍希望围绕它提供更强的记忆 / 上下文层 |
| pstack-codex | 插件市场 / 编排工具包 | (+/-) | 包含 47 项技能、23 个操作手册、智能体角色,运行时边界有文档,且采用显式调用模型 | 可移植性仍依赖宿主支持、适配器,以及针对运行时差异的验证 |
| TermiX / AACP / agent.family | 智能体商业化基础设施 | (+/-) | 链上身份、托管、挑战路径、评估者 / 仲裁者角色、已结算工作信誉,以及可见的交易基础设施 | 信任转移仍在测试中,而且多位发帖者表示需求可能落后于供给 |
| Circle Agent Marketplace | 智能体服务市场 | (+/-) | 让智能体能把媒体生成、截图和推理服务作为工作流步骤来调用 | 回复立刻追问重试规则、付费调用失败,以及目录覆盖面究竟有多大 |
| Claude Code Projects | 智能体监督界面 | (+) | 为并行线程提供统一界面,明确展示阻塞状态,并帮助人类管理注意力 | 可见证据仍停留在早期产品阶段;监督负担仍由人类承担 |
| Grok Build 1.0.36 | 智能体运行时 / 可观测性 | (+/-) | 为后台工作提供实时任务行,为 hooks 提供策略控制,改进 MCP 认证,并把子智能体审批显式展示出来 | 之所以会有这个版本,正说明黑箱式后台工作和隐藏审批已经痛苦到必须修复 |
| Meta organizational second brain | 企业知识架构 | (+) | 结构化知识文件、基于配方的推理、无需重训的验证式更新,以及能减少无效上下文的渐进式披露 | 搭建成本高、整理负担重,还需要严格评估纪律,因此在专业领域之外更难采用 |
| vLLM / SGLang + inference harness stack | 推理服务方法 | (+) | 连续批处理、TTFT / ITL 测量、KV cache 可见性、前缀缓存、推测解码,以及按 token 成本展示的仪表盘 | 并发下吞吐、延迟、序列长度和 KV 压力彼此拉扯,使运维成为深度基础设施工作 |
总体来看,人们对那些能让智能体行为更窄、更便宜或更易检查的工具评价最高。Jev、Meta 的“配方与知识分离”方案、Skillbox 和 Notion 的 Skills API 都受到称赞,因为它们约束了工作流中此前模糊的部分,而不是再增加生成自由度。
评价更复杂的主要集中在市场和可移植性上。TermiX/AACP 和 Circle 之所以有意思,是因为它们把智能体工作带入结算和支付环节,但回复始终在追问重试、争议、可持续信誉和真实需求。同样,pstack-codex、Skillbox 和 Notion 都指向可移植技能,但一旦人们越过“能分发”这一新鲜感,运营层面的关注点很快就转向优先级、验证和组合。
最清晰的应对模式,是把原本隐含的控制平面显式化:用类型化决策模型取代自由格式调用,用带版本的技能取代松散的 Markdown 文件夹,用可见的线程 / 任务界面取代单一聊天流,用分阶段知识路由取代巨大的上下文倾倒。迁移方向则是从提示词很重的单智能体界面,转向类型化路由器、可移植技能包、受治理的 MCP 访问和可审计的运行时状态。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Jev | TypeSafe AI | 为软件工作流返回选项、分数、概率和置信度的类型化决策模型 | 替代智能体循环中用于路由、判断、分类和把关的缓慢或能力过剩的 LLM 调用 | System One model、RLCD 训练、类型化输出、置信度分数 | Beta | 网站、发布文章、推文、推文 |
| Organizational second brain | Meta Engineering | 保存并提供专业知识的内部“第二专家”智能体 | 减少重复的专家审查工作,避免机构知识只困在人脑里 | 结构化知识文件、配方、评估关口、无需重训的反馈循环 | 已上线 | 推文、文章 |
| pstack-codex | @ScriptedAlchemy | Lauren Tan 的 pstack 的 Codex 原生改造版,包含技能、操作手册、角色和插件市场 | 让可复用的智能体技能栈可移植到不同宿主运行时 | Codex 插件市场、显式技能、Python 验证、Bun 辅助测试 | 已上线 | 仓库、推文 |
| Skillbox | @thekitze | 自行托管、带版本的技能库,通过 MCP 暴露技能,并可选用 Jev 提供推荐 | 免去手动同步技能的麻烦,并为可移植技能提供团队治理能力 | React、Bun、Hono、PostgreSQL、HTTP MCP | 已上线 | 仓库、推文 |
| Notion Agent Skills API | Notion via @ivanhzhao | 将存储在 Notion 中的技能和插件下载为供智能体使用的标准目录 | 为团队提供一个可同步到 GitHub、并可跨智能体宿主复用的统一技能库 | Notion API、签名目录下载、GitHub 同步模式、标准技能 / 插件布局 | 已上线 | 文档、推文 |
| TermiX / AACP / agent.family | TermiX | 提供身份、报价、托管、验证、争议、结算和信誉的智能体商业化协议与市场 | 为智能体付费工作提供完整交易生命周期,而不只是一个列表页 | ERC-8004 identity、ERC-8183 commerce、staking/slashing、评估者和仲裁者流程 | 已上线 | 文档、市场、推文、推文 |
| Circle Agent Marketplace | @circle | 面向媒体生成、截图和工作流内推理的、可由智能体调用的服务市场 | 让智能体能够购买其他服务提供的能力,而不是把所有功能都本地打包 | 服务端点、工作流集成、支付基础设施 | 已上线 | 推文、市场 |
Jev 的特别之处在于,构建者并没有把它定位成“另一个模型”,而是定位成一个应该放在其他模型前后两侧的类型化控制界面:负责路由、判断、评分,以及工具调用前的把关。这也是为什么最强的 Jev 推文都在讨论集成模式,而官方发布帖强调的是成本、速度和置信度校准,而不是文案质量。
Meta 的组织第二大脑之所以值得注意,原因恰好相反:它并不是想用一个更好的模型替换周边系统,而是把周边系统本身形式化。链接文章中最有力的主张是架构层面的,而不只是基准表现:结构化知识文件、把知识与流程分开的配方、每次变更都设评估关口,以及无需重训就能累积专家纠错的反馈循环。
技能可移植性是最明显的重复构建模式。pstack-codex 把大型操作手册栈移植到 Codex,Skillbox 把技能变成受治理的自行托管库,Notion 则把技能作为可下载目录和插件暴露出来。三者合在一起说明,构建者开始把智能体行为当作带版本的软件清单,而不是临时拼凑的提示词资产。
TermiX 和 Circle 则指向第二种重复模式:让外部能力可以在智能体工作流内部被购买。TermiX 更强调信任和结算层,Circle 则聚焦可调用的创意与推理服务。两者的构建模式其实相同:暴露交易边界,而不只是暴露生成步骤。
6. 新动态与值得关注的内容
TypeSafe 把“决策模型”思路做成了正式产品发布
Jev 这个话题集群之所以重要,不只是因为用户喜欢它,还因为官方 TypeSafe 发布文章 给社区已经在尝试的方向补上了硬指标:每百万输入 token 收费 $0.042、输出免费、使用类型化决策而非字符串,以及面向 System One 任务的 70ms-500ms 响应时间。这让当天最大的 Twitter 主题变得格外具体,因为最热门的用户帖子可以直接对应到官方产品定义,而不是只能对着模糊的泄露截图或基准测试传闻发挥。
Meta 发布了最清晰的企业“第二大脑”公开蓝图之一
@Meta_Engineers 报道(190 个赞、6 条回复、9,784 次浏览、110 次收藏)介绍了一个“第二专家”系统,但真正让它值得关注的是链接中的 工程博文。文章描述了四层架构、200 多个结构化知识文件、把知识与推理分开的配方,以及一个把每轮 token 使用量削减约 80% 的分阶段设计。这是当天最强的案例之一,展示了一家上市公司如何公开解释其内部智能体系统的实际组织方式。
可移植技能正从社区 hack 走向官方 API 与受治理的自行托管模式
可移植性主题之所以值得关注,是因为它同时出现在三个不同层面。@ivanhzhao 指出(39 个赞、7 条回复、6,893 次浏览、15 次收藏)指向官方 Notion Agent Skills API,@thekitze 发布了(35 个赞、8 条回复、1,803 次浏览、25 次收藏)把 Skillbox 呈现为受治理的自行托管库,而 @ScriptedAlchemy 移植了(51 个赞、6 条回复、2,029 次浏览、54 次收藏)则把 pstack 移植进 Codex 并加入运行时验证。合在一起,这些帖子让可移植性看起来不再只是愿景,而更像一个正在形成的软件品类。
7. 机会在哪里
[+++] Typed decision control planes for agent workflows — The strongest evidence came from multiple angles at once: @DeRonin_ 描述了(182 个赞、17 条回复、18,926 次浏览、300 次收藏)明确指出,哪些智能体调用应该从 LLM 生成降级为类型化选择;@omarsar0 映射了(231 个赞、20 条回复、11,638 次浏览、274 次收藏)把最先见到高 ROI 的位置落在判断和路由上;@shannholmberg 展示了(110 个赞、12 条回复、6,955 次浏览、172 次收藏)展示了 AI 工程之外的工作流用例;@BhosalePratim 扩展了(50 个赞、6 条回复、2,339 次浏览、18 次收藏)则把这一思路延伸到了半轮语音系统。这个机会很强,因为痛点、应对方式和产品供给是对齐的。
[+++] Portable skill and context distribution with governance — @ScriptedAlchemy 移植了(51 个赞、6 条回复、2,029 次浏览、54 次收藏)把一个大型技能 / 操作手册系统移植进 Codex,@thekitze 构建了(35 个赞、8 条回复、1,803 次浏览、25 次收藏)展示了一个受治理的自行托管技能库,而 @ivanhzhao 指出(39 个赞、7 条回复、6,893 次浏览、15 次收藏)则指向一个可从 Notion 导出并同步技能的官方 API。这个机会同样很强,因为现有方案已经证明需求存在,但回复仍然显示,组合、回滚和互操作性问题还没解决。
[+++] Trust rails and demand tooling for agent micro-work markets — @d3rekson 认为(87 个赞、56 条回复、1,213 次浏览)称,身份、托管、验证、争议和信誉必须在同一个交易生命周期里保持连贯;@Heis_sosa 认为(118 个赞、35 条回复、1,158 次浏览)称,在协作变得有商业价值之前,智能体需要同样的交易基础设施;@cv_alphas 报道(40 个赞、48 条回复、288 次浏览)则质疑挑战解决机制和可携带信誉在负载下是否真的站得住。@Chorux666 补充说(42 个赞、49 条回复、210 次浏览)展示了低客单价场景,而 @RifatOfficiall 揭示了(72 个赞、80 条回复、516 次浏览)则指出了需求瓶颈。这个机会很强,因为它把交易基础设施和市场流动性绑在了一起,而不是把它们看成两个彼此独立的产品。
[++] Supervisor interfaces for parallel agent teams — @daniel_mac8 将其定义为(36 个赞、8 条回复、2,260 次浏览、12 次收藏)把问题定义为人类注意力,@XFreeze 推动了(65 个赞、24 条回复、5,770 次浏览、6 次收藏)强调实时任务行和显式审批,而 @0xShoopy 展示了(11 个赞、4 条回复、138 次浏览、8 次收藏)则给出了一种运营模型:由幕僚长机器人替人类挡住大量直接线程。这是一个中等强度的机会,因为一旦智能体数量上来,需求就显而易见,但公开证据目前主要仍来自产品更新和操作者轶事。
[++] Enterprise second brains with auditable knowledge updates — @Meta_Engineers 提供了(190 个赞、6 条回复、9,784 次浏览、110 次收藏)给出了当天最清晰的官方架构,而 @Vtrivedy10 认为(61 个赞、5 条回复、4,664 次浏览、53 次收藏)和 @shannholmberg 展示了(110 个赞、12 条回复、6,955 次浏览、172 次收藏)则体现了对上下文路由和结构化知识检查的相邻需求。这是一个中等强度的机会,因为价值很明确,但实施负担仍然很高,而且很可能先集中在专业领域。
8. 要点
- 类型化决策层取代了泛泛的模型讨论,成为当天最实际的智能体话题。 排名最高的 Jev 帖子都在谈,用类型化选项、分数和置信度阈值替代狭窄的控制决策,而不是用另一个通用模型去替换现有模型。(来源,182 个赞、17 条回复、18,926 次浏览;来源,231 个赞、20 条回复、11,638 次浏览;来源,110 个赞、12 条回复、6,955 次浏览)
- 技能可移植性正在成为真正的软件品类,而不只是提示词管理技巧。 pstack-codex、Skillbox 和 Notion 的 Agent Skills API 都把智能体行为视为可安装、可同步、可治理、可跨宿主复用的带版本资产。(来源,51 个赞、6 条回复、2,029 次浏览;来源,35 个赞、8 条回复、1,803 次浏览;来源,39 个赞、7 条回复、6,893 次浏览)
- 智能体商业化讨论进一步逼近真实的市场设计。 最有力的帖子没有停留在身份或列表层面,而是明确展开了托管、挑战期、验证、结算,以及供给可能跑在真实付费需求前面的风险。(来源,87 个赞、56 条回复、1,213 次浏览;来源,40 个赞、48 条回复、288 次浏览;来源,42 个赞、49 条回复、210 次浏览;来源,72 个赞、80 条回复、516 次浏览)
- 监督界面正在成为智能体产品本身的一部分。 Claude Code Projects、Grok Build 和 GrokBot 团队组织图都把难点定义为:必须把阻塞工作、后台进展和角色边界看得足够清楚,人类才能驾驭多个活跃智能体。(来源,36 个赞、8 条回复、2,260 次浏览;来源,65 个赞、24 条回复、5,770 次浏览;来源,11 个赞、4 条回复、138 次浏览)
- 最可信的企业智能体案例,都把知识编码在模型权重之外。 Meta 的“第二大脑”架构、Vtrivedy 的上下文路由器框架,以及 Shann Holmberg 的工作流图,都指向同一个结论:可靠性来自模型周围的结构化知识、显式路由,以及可评估的控制流。(来源,190 个赞、6 条回复、9,784 次浏览;来源,61 个赞、5 条回复、4,664 次浏览;来源,110 个赞、12 条回复、6,955 次浏览)