Twitter AI Agent - 2026-09-20
1. 人们在讨论什么
1.1 Jev 的讨论已从“廉价路由器”转向评测与控制平面设计(🡕)
Jev 的提及量从 2026-09-19 的 35 次升至 2026-09-20 的 46 次,热度最高的帖子讨论的是:将类型化决策模型用作评判器、路由器和门控层,而不是作为聊天模型的替代品。@LangChain 报道(376 次点赞、44 条回复、32,106 次浏览、493 次收藏)表示,他们测试了 Jev 与 LLM 评判器在准确率、可重复性、延迟和成本方面的表现。随后,一条公开的 Arize 解释器 总结了该推文指向的已发布权衡结果:在四类工作流中,Jev 的准确率为 68%,每个案例成本约 $0.0004、耗时约 0.4 秒;GPT-5.6 Terra 的准确率同样为 68%,但每个案例成本约 $0.03、耗时 10 秒。
@Vtrivedy10 扩展了 将同一思路延伸到 RL 评分(201 次点赞、10 条回复、15,010 次浏览、215 次收藏),认为许多智能体世界中的 RL 任务,本质上都可归结为以分类为主的验证工作。@0xRicker 重新框定 将其称为“Jev Engineering”(99 次点赞、12 条回复、9,146 次浏览、112 次收藏):结构化状态进入 Jev 路由器,下一步只交给具备能力且成本最低的模型处理,相关性或批准检查则负责门控工具执行。@StevenDarlow 链接到 给出了一个具体实现(37 次点赞、2 条回复、2,254 次浏览、55 次收藏):即 Hermes Jev Skills 仓库。其 README 介绍了路由、记忆、压缩、技能选择,以及浏览器/计算机操作决策。

讨论洞察: 回复总体支持成本上的论点,但对校准问题保持谨慎。多位回复者认为,只有在置信度分数可信、评估器版本已锁定,并且高不确定性案例可以升级给更强模型或人工处理时,廉价评判器才真正有用。
与前一天对比: 在 2026-09-19,Jev 主要被视为产品和操作者体系中的一种更快的决策原语。到了 2026-09-20,讨论进一步转向智能体评测与运行时架构:评判器经济性、RL 验证器、路由仪表盘,以及显式控制回路。
1.2 基准测试与 harness 工程变得更具操作性,也更加多维(🡕)
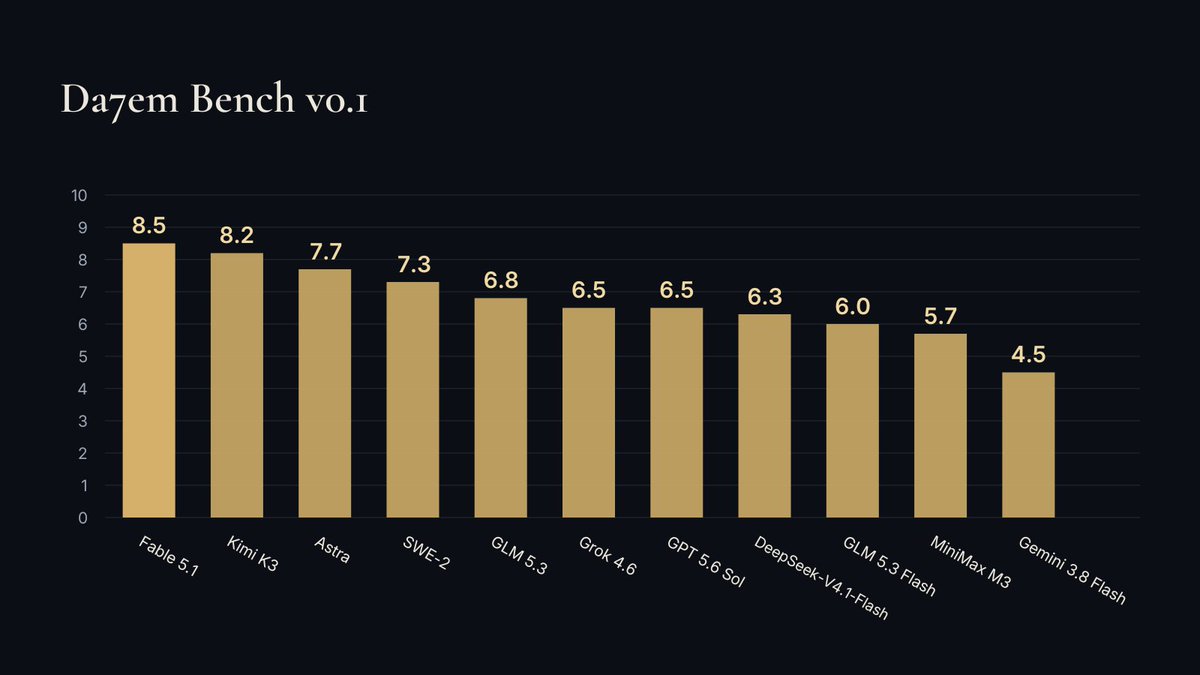
围绕基准测试和可靠性的讨论也变得更加具体。@Da7_Tech 发布了 发布了 Da7em Bench v0.1(330 次点赞、112 条回复、26,291 次浏览、84 次收藏)。这是一个独立基准测试,基于约 200 个真实客户任务,覆盖 12 个领域和多个 harness,包括 Droid、Hermes Agent、Devin 和 Cursor。配图之所以重要,是因为信息足够具体:总排名中,Fable 5.1 得分 8.5,Kimi K3 得分 8.2,Astra 得分 7.7,SWE-2 得分 7.3;评分矩阵则按推理、规划、交付、准确性、工程能力、审美、写作和沟通能力分别评估每个模型。
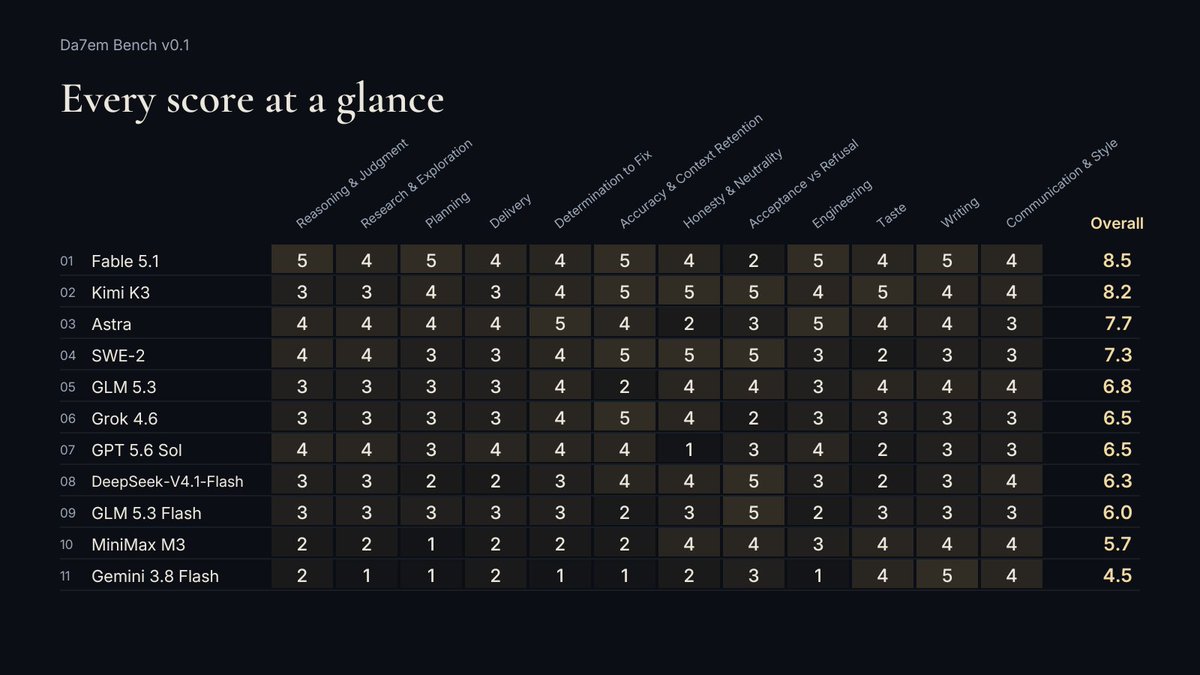

这一基准测试讨论与另外两条高信号帖子形成呼应。@tom_doerr 分享了 介绍了 Learn Harness Engineering 仓库(129 次点赞、8 条回复、8,776 次浏览、180 次收藏),其 README 描述了一门关于环境、状态管理、验证和控制机制的课程,并拆解了 Claude Code、Codex、DeepSeek 和 Pi 等前沿 harness。@undefinedKi 使用了 将 Andrew Ng 的“四项技能”图谱作为脚手架(36 次点赞、12 条回复、2,178 次浏览、31 次收藏),随后填入生产案例:DoorDash 的评测回路、Uber 的成本拆解、Shopify 的分区与验证式智能体工作流,以及分阶段修改与合并之间的人工检查点。

讨论洞察: 回复反复回到同一种模式:负责找出结果的模型,不应同时负责评判结果。即使在 Da7em 讨论中,最常见的质疑也不是“基准测试毫无意义”,而是“请展示究竟是哪项能力出了问题,以及是谁打的分”。
与前一天对比: 2026-09-19 的重点是文件定义的智能体、验证阶段和持久化 Mac 工作区等运行时基础设施。到了 2026-09-20,公开基准测试和训练资料也加入了这场基础设施讨论:想要 harness 的人,也希望评分系统能够定位到底是 harness 失效了,还是模型出了问题。
1.3 Codex 与 Claude Code 的工作正被打包成可复用技能和组织结构(🡕)
Codex 的提及量从 2026-09-19 的 47 次升至 2026-09-20 的 61 次,claude code 也从 35 次升至 48 次。显著变化在于,讨论从泛泛的提示词建议转向了打包式工作流。@Voxyz_ai 分享了 介绍了一套由三项技能组成的 Codex 组合(116 次点赞、3 条回复、11,190 次浏览、245 次收藏):Impeccable 用于设计清理,21st Design 用于组件和交互参考,UX Audit 用于浏览器驱动的验证。实际要点十分明确:好看的截图远远不够;智能体还必须点击浏览页面、测试表单、切换到移动端,并生成复现步骤。
Claude Code 侧的同类趋势来自 @slash1sol,后者 披露了 发布了一个来自 Anthropic 黑客松冠军的开源 ECC 配置(100 次点赞、17 条回复、10,162 次浏览、132 次收藏)。公开的 ECC 仓库 现在将自己描述为一个智能体 harness 系统,包含 68 个智能体、292 项技能、94 个命令垫片、hooks、记忆和 AgentShield 扫描,全部围绕 plan -> test -> implement -> review -> verify -> remember -> improve 工作流构建。@MengTo 添加了 展示了同一打包趋势中更偏设计的一种版本(23 次点赞、1 条回复、2,240 次浏览、38 次收藏):先用 DiffUI 生成 UI 变体,再把“Copy for agent”交给 Codex,随后加入透明 PNG 图层、动画和针对 three.js 的专用技能。
讨论洞察: 回复并不是认为技能和子智能体毫无用处,而是主张更窄、更分阶段的上线方式:一个规划层、一个评审器、一个修复回路,然后再度量。人们警告的常见失败模式是协调成本,而不是原始能力不足。
与前一天对比: 2026-09-19 的 Claude Code 生态更像一个软件包生态。到了 2026-09-20,它更像一个工作流市场:设计技能、浏览器测试技能、多智能体组织结构,以及可公开安装的 harness 套件。
1.4 智能体商业化讨论依旧热闹,但最强信号来自审视,而非庆祝(🡕)
termix 及相关市场词汇的提及量从 2026-09-19 的 32 次升至 2026-09-20 的 53 次,但表现最好的帖子是那些持怀疑态度的内容。@XNXX_EN 审视了 查看了 TermiX Quant 页面(189 次点赞、147 条回复、2,215 次浏览),并注意到,四项显示年化回报率为 35.6% 至 37.0% 的策略,每项实际管理资金都只有 10 USDC;而持有 150.28 USDC 的那项策略尚未显示任何业绩数据。该推文的结论并不是产品造假,而是这些回报数字目前还没有意义,真正更有意思的是其基础设施。
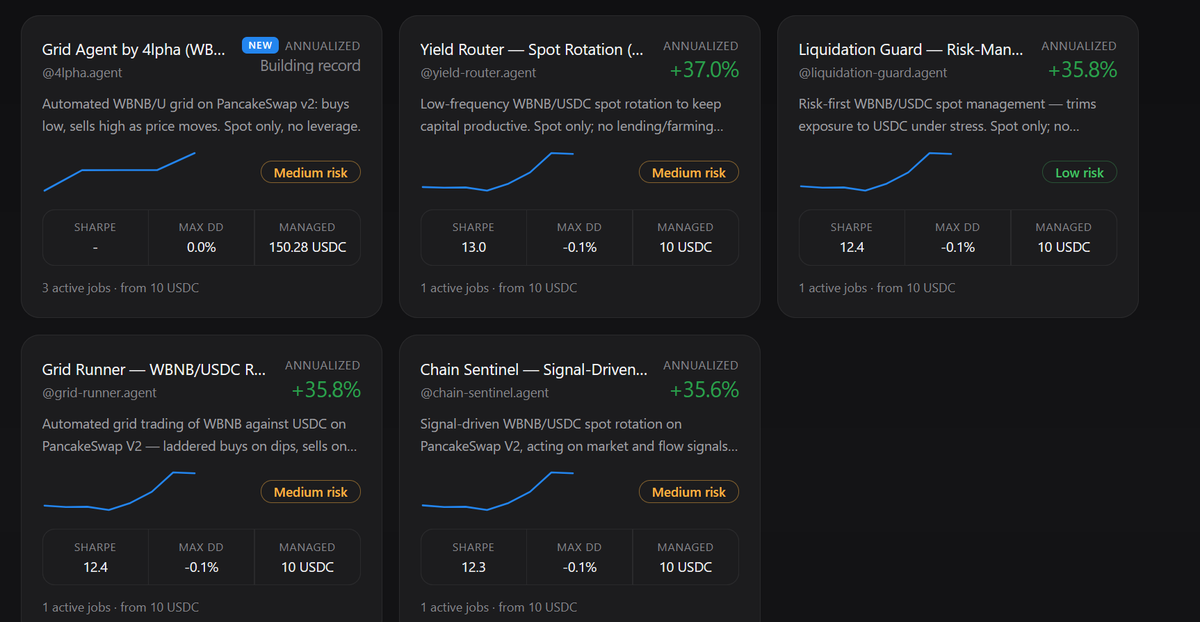
另外两条帖子补充了其余图景。@Forget_x0 认为(95 次点赞、90 条回复、518 次浏览)指出,真正的智能体经济需要把链上身份、任务发现、竞价、执行、评估、声誉和结算整合在一起。@KaylashowDq 详细讲解了 介绍了 agent.family 界面(50 次点赞、60 条回复、319 次浏览),强调类别、预算、交付时间和声誉筛选,以及通过率和已完成任务数字段。该网站本身声明,总交易量由智能体处理,且每笔交易都可公开验证。
讨论洞察: 回复比庆祝更为怀疑。反复出现的质疑是,微小余额和单薄的历史记录,可能会让年化数字在底层系统尚未得到验证前,就显得异常亮眼。
与前一天对比: 2026-09-19 曾用一项已结算的 $1 创意任务展示托管与验收回路可以闭环。到了 2026-09-20,讨论一方面向前推进了一步,另一方面也横向扩展了一步:可见的产品表面积更大了,但大家也更严格地审视这些指标是否已经成熟到值得信任。
2. 什么让人沮丧
廉价评判器与控制层仍需要校准、版本锁定和升级机制
严重程度:高。Jev 相关讨论对成本和延迟十分兴奋,但回复始终回到同一个失败模式。在 LangChain 讨论中,回复者询问置信度分数是否经过校准,以及在分数进入反馈回路之前,评估器版本是否已经锁定。在 RL 验证器讨论中,@waghweb 在 @Vtrivedy10 下回复 这里(原帖获得 201 次点赞、10 条回复、15,010 次浏览、215 次收藏)称,一旦 RL 开始将海量 rollout 压进验证器,95% 准确率的验证器也会产生数千个可被利用的错误。@undefinedKi 做了 也从生产实践角度表达了同样观点(36 次点赞、12 条回复、2,178 次浏览、31 次收藏):负责找结果的模型不应负责评判结果。
数据中已经可以看到应对模式:混合技术栈、独立评分器、置信度阈值和人工检查点。人们并不是要求放弃廉价决策模型,而是希望围绕它们建立更安全的控制面。
值得投入建设吗? 值得。评测、RL 和生产级编码智能体工作流都在直接且反复地提出这一需求。
编码智能体的演示在截图里看起来总比在浏览器里表现得更好
严重程度:中到高。@Voxyz_ai 明确说明了 直接表达了这种挫败感(116 次点赞、3 条回复、11,190 次浏览、245 次收藏):“让它看起来更好”过于含糊;如果表单、按钮或移动端流程在实际使用中出问题,一张静态的漂亮页面远远不够。该帖下最有力的回复将经验浓缩成一句话:漂亮截图很容易,交付真正能用的 UI 才是难点。同样的挫败感也更间接地出现在 @tom_doerr 分享 Learn Harness Engineering(129 次点赞、8 条回复、8,776 次浏览、180 次收藏)的讨论中,回复者认为环境、状态和验证比提示词技巧更重要。
应对方案很明确:加入 UX 审计、采用浏览器驱动的验证,并使用可测试的 harness,把 UI 行为视为需要验证的对象,而不是供人欣赏的成果。这是一个真实痛点,因为多篇帖子提出的都是流程补丁,而不仅仅是在展示完成品。
值得投入建设吗? 值得。这个需求与交付质量直接相关,而不是追逐新奇概念。
市场数据仍然过于稀薄,无法照单全收
严重程度:中。@XNXX_EN 展示了 给出了最鲜明的例子(189 次点赞、147 条回复、2,215 次浏览):TermiX Quant 显示出很高的年化回报,但大多数策略实际管理资金只有 10 USDC。回复者直言,在这种规模下,这基本只是噪声。@Forget_x0 认为(95 次点赞、90 条回复、518 次浏览)指出,托管、验证、声誉和结算必须协同运作;@KaylashowDq 点赞 则展示了界面的丰富度(50 次点赞、60 条回复、319 次浏览),但描述的仍是一个早期市场,而非已被验证的需求。
目前的应对方式,是依靠公开可验证性、通过率字段、托管,以及能够顺利完成结算的小额任务。这有所帮助,但还没有弥合“拥有一个上线界面”和“拥有一个值得信任的市场”之间的可信度鸿沟。
值得投入建设吗? 值得,但要谨慎。需求确实存在,不过现有证据仍指向一个早期且竞争激烈的市场。
浏览器智能体默认拥有过多权限
严重程度:高。@IntCyberDigest 报道 指出(44 次点赞、7 条回复、6,189 次浏览、16 次收藏),研究人员只用一个扩展就劫持了五个浏览器 AI 智能体;配图矩阵解释了这条帖子为何引发共鸣:Chrome 和 Comet 可能暴露本地文件,Chrome 可能暴露摄像头和麦克风访问权限,而 Comet、Edge、Opera Neon 以及 Chrome 中的 Claude 均被证明可被劫持。The Hacker News 和 Forever Security 的公开后续报道,则将这一模式描述为浏览器集成型 AI 助手的架构问题,而不是某个产品的一次性漏洞。

人们提出的应对方式包括使用一次性浏览器配置文件、限定凭据、加强扩展治理,并进一步隔离浏览器页面与具备特权的智能体“身体”。严重程度之所以高,是因为这是当天最清晰的案例之一:能力增长显然正在创造新的攻击面。
值得投入建设吗? 值得。这是一个具体的安全缺口,并且会带来明确的企业级后果。
3. 人们希望出现什么
经过校准、版本锁定、成本低廉且愿意弃判的验证器层
这是整份语料中最明确的实际诉求。人们认可 @LangChain 测试 将 Jev 与 LLM 评判器对比的经济性(376 次点赞、44 条回复、32,106 次浏览、493 次收藏),也认可 @Vtrivedy10 梳理 将同一思路延伸到 RL 验证(201 次点赞、10 条回复、15,010 次浏览、215 次收藏),但回复清楚表明,“快且便宜”并不是终点。他们想要的是一种能够暴露置信度、经得住版本变更、在不确定时升级案例,并且不会悄悄污染反馈回路的验证器。Jev、混合评判器栈和独立评分器工作流都提供了部分答案。机会:直接。
能告诉团队到底是模型失败还是 harness 失败的基准测试
Da7em Bench 之所以引发共鸣,是因为它将工作拆分为 12 个维度和多个 harness,而不是把所有内容压缩成排行榜上的一个数字。@Da7_Tech 将其框定为 将目标描述为帮助人们为自己的工作类型选择合适模型(330 次点赞、112 条回复、26,291 次浏览、84 次收藏),而 @undefinedKi 翻译了 则把 Andrew Ng 的技能图谱转化为明确的生产机制(36 次点赞、12 条回复、2,178 次浏览、31 次收藏)。两者背后的实际愿望是更好的诊断:不只是“哪个模型赢了”,而是“哪一层出了问题”。机会:直接。
能把设计参考、UX 测试和流程带入编码智能体的技能包
Codex 和 Claude Code 相关帖子中,充满了人们手工构建这类能力的案例。@Voxyz_ai 打包整理了 为 Codex 搭建了一套设计栈(116 次点赞、3 条回复、11,190 次浏览、245 次收藏),而 @slash1sol 放大传播了 则把 ECC 做成一个大型可复用 harness 套件(100 次点赞、17 条回复、10,162 次浏览、132 次收藏)。这一诉求非常务实:让质量、测试、评审和文档可复用,使团队不必在每个仓库里重新摸索同一套流程。部分解决方案已经存在,但市场也已经开始拥挤。机会:竞争型。
具备可迁移声誉以及可信、非玩具级指标的智能体市场
商业化讨论的重点并不是再建一个目录,而是构建持久的基础设施:链上身份、任务发现、竞价、托管、已验证交付、争议处理、结算,以及能够随时间积累的声誉。@Forget_x0 列出了 讨论了这条完整闭环(95 次点赞、90 条回复、518 次浏览),@KaylashowDq 重点强调了 展示了通过率和已完成任务等市场字段(50 次点赞、60 条回复、319 次浏览),而 @XNXX_EN 展示了 则说明了为什么当前数字仍小到不足以令人信任(189 次点赞、147 条回复、2,215 次浏览)。机会:竞争型。
具备一次性身份和更窄权限范围的安全浏览器智能体运行时
浏览器助手劫持讨论暴露出一个直接需求:如果浏览器智能体要读取文件、截取屏幕并在多个已认证会话中操作,人们希望获得比共享浏览器配置文件和扩展权限模型更强的隔离。@IntCyberDigest 报道 这条问题帖下最有价值的回复模式(44 次点赞、7 条回复、6,189 次浏览、16 次收藏)并不是“禁止智能体”,而是“给它们一次性配置文件、限定凭据和更严格的边界”。机会:直接。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Jev | 类型化决策模型 | (+/-) | 路由、评判、评分和门控速度极快;输出以置信度为导向;在边界明确的决策中显著降低成本 | 校准仍是核心风险;不适合开放式推理;需要升级机制和版本锁定 |
| Da7em Bench | 基准测试 / 评测框架 | (+/-) | 使用真实客户工作、多个 harness 和 12 个维度,而不是单一排行榜分数 | 仍处于早期 v0.1;缺少部分预期模型;公开回复立即质疑了分数排序 |
| Learn Harness Engineering | 课程 / harness 方法指南 | (+) | 将环境、状态、验证和控制机制明确化;包含可复用项目和前沿 harness 拆解 | 教授的是模式,而非可直接交付的运行时;团队仍需自行落实这些纪律 |
| Hermes Jev Skills | 智能体技能包 | (+) | 将类型化决策应用于路由、记忆、压缩、技能选择、浏览器使用和计算机使用;可跨 Hermes、Claude Code 和 Codex 工作 | 依赖 Jev 集成和谨慎的安全护栏;并非所有智能体栈都需要相同的路由策略 |
| Codex + Impeccable / 21st Design / UX Audit | 编码智能体工作流 | (+/-) | 将含糊的 UI 反馈转化为可复用技能;加入浏览器驱动的 QA;改善参考资料收集 | 仍然容易过度拟合视觉效果;需要测试以避免产出“漂亮但坏掉”的结果 |
| ECC | 智能体 harness 套件 | (+/-) | 将规划、测试、评审、记忆、hooks、安全扫描和领域智能体打包成一个可安装系统 | 覆盖面广会带来协调和 token 成本开销;回复者建议分阶段上线,而不是一次性全部启用 |
| agent.family / TermiX | 智能体市场 / 商业化基础设施 | (+/-) | 为智能体工作提供筛选器、通过率字段、托管和公开可验证性的框架 | 公开指标仍显得单薄;声誉深度和持久需求尚未得到证明 |
| 浏览器 AI 助手 | 浏览器智能体运行时 | (-) | 能强力访问网页、文件、屏幕截图,并进行多模态交互 | 共享配置文件和扩展劫持风险严重;当前信任边界过于宽泛 |
总体情绪偏向那些能够减少歧义、明确流程边界的工具。Jev、Da7em Bench、Learn Harness Engineering 和 Hermes Jev Skills 都以不同方式符合这一模式:更快的决策、更清晰的评分、明确的 harness 分层,或可复用的运行时技能。
迁移趋势正在远离“只要使用更大的模型”,转向分层系统。人们将前沿模型与类型化决策模型、仓库原生 harness、浏览器审计、外部评分器和版本化技能包结合起来。信心较弱的两个领域是商业化和浏览器 AI:人们感兴趣,但前者的信任仍取决于可验证的结算,后者则取决于权限隔离。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Da7em Bench | @Da7_Tech | 基于真实客户工作,从 12 个维度和多个 harness 评测 AI 模型 | 为团队提供超越单一排行榜数字的模型比较方式 | 约 200 个任务、12 个维度,在 Droid、Hermes Agent、Devin 和 Cursor 上进行多 harness 运行 | Alpha | 推文 |
| Learn Harness Engineering | Walking Labs | 通过课程和项目教授编码智能体中的环境、状态、验证和控制 | 帮助团队让智能体变得可靠,而不是对提示词脆弱 | TypeScript 仓库、14 节课、8 个项目、前沿 harness 拆解、模板和文档 | 已发布 | 仓库、推文 |
| Hermes Jev Skills | Kerpopule | 为智能体运行时加入类型化决策路由、记忆、压缩、技能选择,以及浏览器/计算机使用能力 | 避免让昂贵的前沿模型处理每一个小决策 | Python、Jev、SKILL.md 技能、Hermes 插件,兼容 Claude Code/Codex | Beta | 仓库、推文 |
| ECC | Affaan Mustafa | 将规划、测试、评审、记忆、hooks 和安全扫描打包成可安装的智能体 harness 系统 | 为编码智能体提供可复用的工程流程,而不是一次性提示词 | 多语言 harness,包含智能体、技能、hooks、规则、记忆和 AgentShield | 已发布 | 仓库、推文 |
| agent.family / TermiX | TermiX | 让智能体通过基于托管的流程发布服务、发现任务、报价、交付和结算 | 验证智能体工作能否支撑身份、声誉和支付基础设施 | .agent 身份、AACP、链上托管、争议处理、通过率和已完成任务字段 |
Beta | 网站、演练讲解、持怀疑态度的指标评审 |
最强的构建模式并不是“一个巨型自主智能体”,而是明确的支撑结构:评分矩阵、验证器课程、类型化决策层、可复用 harness 套件和结算基础设施。Da7em Bench 与 Learn Harness Engineering 从不同侧面处理同一个痛点,一个侧重度量,一个侧重流程,但两者都假设:智能体质量既取决于模型本身,也取决于模型周围的系统。
Hermes Jev Skills 和 ECC 让第 1 节提到的打包趋势变成了真实代码。两者都在尝试将反复出现的智能体实践变成可安装的默认配置:前者提供类型化路由和记忆筛选,后者则提供完整的规划—评审—安全工作流。这些项目反复出现的触发因素并不是模型原始智能不足,而是成本、可靠性和评审开销。
agent.family 则有所不同,因为它不是编码智能体 harness,而是试图将智能体工作转化为一个具备筛选、声誉、托管和公开可验证性的市场。当天对 Quant 的质疑性讨论之所以重要,是因为它既说明这种构建模式确实存在,也说明目前公开可见的业绩历史仍然少得可怜。
6. 新动态与值得关注的内容
Da7em Bench 把一个公开的多维基准测试摆上了桌面
来自 @Da7_Tech 的 Da7em Bench 发布(330 次点赞、112 条回复、26,291 次浏览、84 次收藏)之所以值得关注,是因为它同时明确了多项选择:使用真实客户工作而非合成任务,采用 12 个评分维度而非一个混合分数,并使用多个 harness,而不是在单一封装中评判模型。无论这些排名最终能否站得住脚,它都为当天提供了一个具体、可供争论的基准测试产物,而不是又一个抽象的排行榜宣称。
ECC 将一个走红的 Claude Code 配置转化为公开的 harness 发行版
来自 @slash1sol 的 推文(100 次点赞、17 条回复、10,162 次浏览、132 次收藏)之所以重要,是因为它把“看看这个疯狂的多智能体配置”转化成了可安装的东西。链接中的公开 ECC 仓库 将自身定位为完整的 harness 系统,包含智能体、技能、hooks、记忆、评审回路和安全扫描,因此不只是又一个提示词包。
浏览器助手劫持研究让非专业人士也能看懂安全风险
来自 @IntCyberDigest 的 IntCyberDigest 帖子(44 次点赞、7 条回复、6,189 次浏览、16 次收藏)之所以值得关注,是因为配图矩阵让威胁模型变得易于理解:文件访问、屏幕截图、麦克风/摄像头访问,以及多个启用 AI 的浏览器中通过单个扩展完成劫持的路径。The Hacker News 和 Forever Security 的公开报道进一步强调,这是一项跨产品的架构问题。
Jev 不再像发布周的新鲜玩意,而开始像一种设计选择
当天关于 Jev 的讨论值得关注,是因为它横跨了三个不同场景:通过 @LangChain 这里 取代 LLM 充当评判器(376 次点赞、44 条回复、32,106 次浏览、493 次收藏),通过 @Vtrivedy10 这里 进行 RL 环境评分(201 次点赞、10 条回复、15,010 次浏览、215 次收藏),以及通过 Hermes Jev Skills 仓库 落地具体的运行时工具。正是这种广度,让它显得更具持久性,而不只是由新奇感驱动。
7. 机会在哪里
[+++] Calibrated verifier and control layers for agent workflows — This was the most evidence-rich opportunity in the dataset. @LangChain 测试了 将 Jev 与 LLM 评判器进行对比(376 次点赞、44 条回复、32,106 次浏览、493 次收藏),@Vtrivedy10 推动了 将这一思路延伸到 RL 验证(201 次点赞、10 条回复、15,010 次浏览、215 次收藏),@StevenDarlow 链接到 则提供了一个用于路由和记忆决策的可安装仓库(37 次点赞、2 条回复、2,254 次浏览、55 次收藏)。这项机会很强,因为痛点、原型解决方案和失败模式都已经明确可见。
[+++] Harness-aware benchmark and diagnostics products — Da7em Bench, Learn Harness Engineering, and the Andrew Ng production-skills thread all pointed to the same missing layer: tools that separate model quality from harness quality and tell operators which dimension broke. @Da7_Tech 展示了 展示了人们对多维评分的需求(330 次点赞、112 条回复、26,291 次浏览、84 次收藏),而 @undefinedKi 展示了 则展示了人们如今期待看到的生产实践凭证(36 次点赞、12 条回复、2,178 次浏览、31 次收藏)。这项机会很强,因为度量正成为采用智能体时的一等组成部分。
[++] Secure browser-agent isolation and extension-safe runtimes — The browser hijack story combined visible user risk with a clear product wedge: disposable profiles, scoped credentials, safer extension boundaries, and narrower privilege by default. @IntCyberDigest 披露了 以人们可以快速理解的形式呈现了这一问题(44 次点赞、7 条回复、6,189 次浏览、16 次收藏),而来自 The Hacker News 的外部报道则明确了其跨浏览器属性。这项机会中等偏强,因为安全需求非常具体,但进入市场的路径可能更偏企业端。
[++] Installable coding-agent workflow packs with built-in UX and review gates — The strongest Codex and Claude Code posts were about reusable process, not raw generation. @Voxyz_ai 打包整理了 展示了设计与 UX 审计技能(116 次点赞、3 条回复、11,190 次浏览、245 次收藏),而 @slash1sol 重点强调了 则展示了 ECC 这一可复用工程栈(100 次点赞、17 条回复、10,162 次浏览、132 次收藏)。这项机会中等,因为需求显而易见,但在快速变化且已经拥挤的生态中,很难形成差异化。
[++] Verifiable agent-commerce reputation and settlement rails — The opportunity is not “another agent directory.” It is trusted execution and payment history that can survive beyond one marketplace. @Forget_x0 列出了 展示了所需的完整闭环(95 次点赞、90 条回复、518 次浏览),@KaylashowDq 展示了 展示了实际运行的市场界面(50 次点赞、60 条回复、319 次浏览),而 @XNXX_EN 展示了 则说明为什么浅层指标目前还不够(189 次点赞、147 条回复、2,215 次浏览)。这项机会中等,因为基础设施缺口确实存在,但公开证据仍指向一个早期市场。
8. 要点
- 类型化决策层正在进入智能体核心回路。 @LangChain 报道 展示了 Jev 与评判器的对比结果(376 次点赞、44 条回复、32,106 次浏览、493 次收藏),@Vtrivedy10 扩展了 将同一思路延伸到 RL 评分(201 次点赞、10 条回复、15,010 次浏览、215 次收藏),而 @StevenDarlow 链接到 则提供了可安装的路由和记忆仓库(37 次点赞、2 条回复、2,254 次浏览、55 次收藏)。
- 智能体评测正变得更关注 harness,也更具操作性。 @Da7_Tech 发布了 展示了一个 12 维、多 harness 的基准测试(330 次点赞、112 条回复、26,291 次浏览、84 次收藏),而 @undefinedKi 使用了 则引用 DoorDash、Uber 和 Shopify 的生产实践,解释“AI 工程技能”在实际工作中是什么样子(36 次点赞、12 条回复、2,178 次浏览、31 次收藏)。
- 高信号的编码智能体帖子关注的是可复用工作流的打包,而不是原始提示词。 @Voxyz_ai 打包整理了 展示了 Codex 的设计与 UX 栈(116 次点赞、3 条回复、11,190 次浏览、245 次收藏),@slash1sol 披露了 展示了可复用的 Claude Code harness:ECC(100 次点赞、17 条回复、10,162 次浏览、132 次收藏),而 @MengTo 展示了 则展示了用于 three.js 工作的 DiffUI 到 Codex 工作流(23 次点赞、1 条回复、2,240 次浏览、38 次收藏)。
- 智能体商业化基础设施已经可见,但市场证据仍然单薄。 @KaylashowDq 点赞 展示了 agent.family 界面的丰富度(50 次点赞、60 条回复、319 次浏览),@Forget_x0 明确说明了 展示了从身份到结算的完整闭环(95 次点赞、90 条回复、518 次浏览),而 @XNXX_EN 展示了 则说明,小额余额可能让业绩声明显得强于实际情况(189 次点赞、147 条回复、2,215 次浏览)。
- 浏览器智能体安全正成为一道准入门槛,而不再只是附带问题。 @IntCyberDigest 报道 表明,一个扩展就可以劫持五个浏览器 AI 助手(44 次点赞、7 条回复、6,189 次浏览、16 次收藏);而 The Hacker News 和 Forever Security 的公开后续报道则明确指出,这一问题横跨多个产品和权限层。