Twitter AI Agent - 2026-09-22
1. 大家在讨论什么
1.1 企业落地已变成系统问题,而不是提示词问题(🡕)
最有分量的企业相关帖子,讨论的已不再是如何让模型多写一点代码,而是在代码已经存在之后,如何在团队、系统和供应商之间治理 agent 的工作。被提及最多的关键要素包括:工作流重构、多供应商控制平面、访问边界、可审计性,以及介于工程与运营之间的人类角色。
@kskrygan 介绍了(260 个赞,27 条回复,50,680 次浏览)将 JetBrains Air 定位为面向软件开发组织的产品系统。公开的 JetBrains Air 发布文章 表示,Air 覆盖 IDE 工作、团队协同、治理,以及基于 ACP 的多供应商 agent 连接;其明确目标不是仅仅让 agent 工作更容易启动,而是让其变得可见、可治理、可追责。
@mardehaym 认为(18 个赞,6 条回复,1,696 次浏览)认为,企业 AI 只有在完成工作流重构后才会真正奏效,而不是靠许可证铺开。Microsoft 官方帖子 我们从 Microsoft 自身的 AI 转型中学到了什么 直接印证了这一点:其中称,获得访问权限和使用量并不等于转型;其云供应链团队在部署前先建立了单一事实来源,随后在规划、采购、履约和物流中使用了 100 多个专用 agent。
@suraj_sharma14 梳理了(58 个赞,9 条回复,2,588 次浏览,80 次收藏)将“前线部署工程师”的技术栈概括为 OAuth2、SAML、SCIM、多租户、安全的 RAG 权限、覆盖客户系统的 MCP、可观测性、事故管理和 ROI 证明。在同一帖子的回复中,他还表示,agent 可以触达哪些 CRM 或 ERP 对象的允许列表,是“agent 演示与企业系统之间的边界”。
@Steve_Yegge 提出了(50 个赞,10 条回复,3,691 次浏览,72 次收藏)提出,“agentic TPMs”是进入企业的一条影响面更小的路径:这类 agent 负责写文档、催办、梳理依赖关系,并推动跨职能工作持续向前,而不是直接交付代码。这也让讨论从编码 agent 扩展到了协调型 agent。
讨论洞察: 回复不断把讨论重心从“模型能不能做”拉向“边界由谁负责”。大家关心的问题是:哪些 harness/模型组合在今天确实可用,允许列表和审计轨迹由谁负责,以及协调型 agent 是否会在悄然之间从协调者变成执行者。
与前一天相比: 在 2026-09-21,@rileybrown 描述了(170 个赞,27 条回复,11,173 次浏览,175 次收藏)将 Claude Projects 视为一个用于有序编排 agent 的工作空间。到了 2026-09-22,最强势的帖子又上移了一层:从工作空间的易用性,转向治理、工作流重构和角色设计。
1.2 Jev 与 harness 工程已从口号走向控制面设计(🡖)
Jev 依然很活跃,但语气变了。最有价值的帖子不再热衷于重复“更快更便宜”的说法,而是更关注:哪些小而明确、带类型的决策应该放在哪里,这些决策应返回什么状态,以及如何让 agent 循环保持可审查。
@kmeanskaran 提出异议(115 个赞,5 条回复,2,876 次浏览,76 次收藏)谈到了“Jev 是职业捷径”这类论调。他的观点很直接:OpenClaw、Hermes Agent 和 Jev 可能有帮助,但工作仍然取决于系统设计、harness 工程、推理、AWS、CI/CD 和 Docker。回复区进一步强化了这一点:“追热点的包装终会退潮”,留下来的则是循环本身以及 fail-closed 检查。
@whemohere 概述了(8 个赞,2 条回复,115 次浏览)给出了多 bot 系统中的四个 Jev 闸门:任务路由、研究检查、完成检查和动作防护。这个帖子把 Jev 收敛成一小组固定菜单,而不是什么神秘的监督层。

@Serantych 分享了(7 个赞,1 条回复,66 次浏览)提出了一份“Jev 原生编码 agent”的 10 步蓝图,将栈拆分为:LLM 负责写,Jev 负责决策,工具负责执行。该蓝图强调类型化输出、状态快照、置信度闸门、先做上下文路由再做模型路由、选择性暴露工具,以及可回放的决策日志。
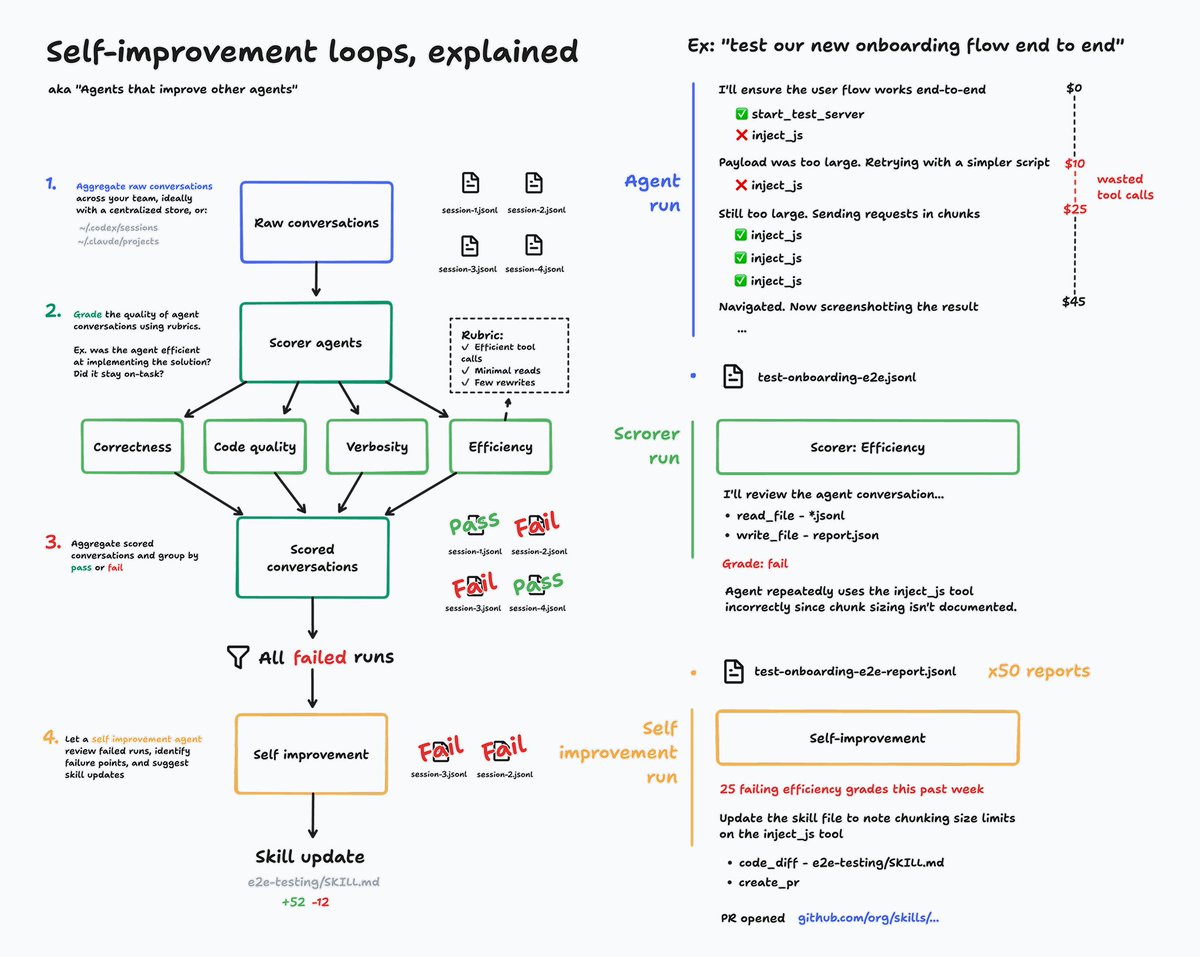
 @BHolmesDev 补充说(16 次点赞、8 条回复、538 次浏览)提出了一个部署后的闭环:由评分代理为过往运行结果打分,再由自我改进代理根据反复出现的失败,提出
AGENTS.md 或技能更新。这样一来,被迭代的不只是模型本身,还有整个框架。
讨论洞察: 当下有价值的怀疑,针对的是证据,而不是野心。构建者希望看到明确的 verify_more 和 human_review 状态、置信度阈值,以及后续可重放的日志。普遍的警告是:如果一个决策层拿不出这些产物,那它也不过是个新的封装层。
与前一日对比: 在 2026-09-21,@teneo_protocol 将其定义为(243 次点赞、201 条回复、4,858 次浏览)聚焦的是代理执行后由谁来检查结果这一类问题,以及 @RoundtableSpace 放大了(74 次点赞、12 条回复、37,950 次浏览、37 次收藏)中 Jev“快 193 倍 / 便宜 444 倍”的说法。到 2026-09-22,持续留下来的帖子不再那么强调基准测试,而是更多转向能让这些说法真正落地的具体菜单、阈值和日志。
1.3 模型评测讨论聚焦于单个已完成任务的成本,以及与原生框架的适配度(🡕)
今天关于模型的帖子,主要不是在争论谁在抽象意义上更聪明,而是在讨论:复现一项基准测试到底要花多少钱,头条分数背后藏着多少 token 消耗,以及同一个模型在自己训练所依托的框架内,是否会表现得不同于置于通用封装器中时的样子。
@N01ennn 发布了(28 次点赞、4 条回复、22 次收藏)发布了一份三页的 Grok 4.7 实战指南。帖子强调了它在 Coding Agent Index、DeepSWE 和法律代理工作上的显著提升,但也明确点出了一个关键但书:Grok 4.7 在 Grok Build 里的表现,与在通用封装器中的表现并不相同。
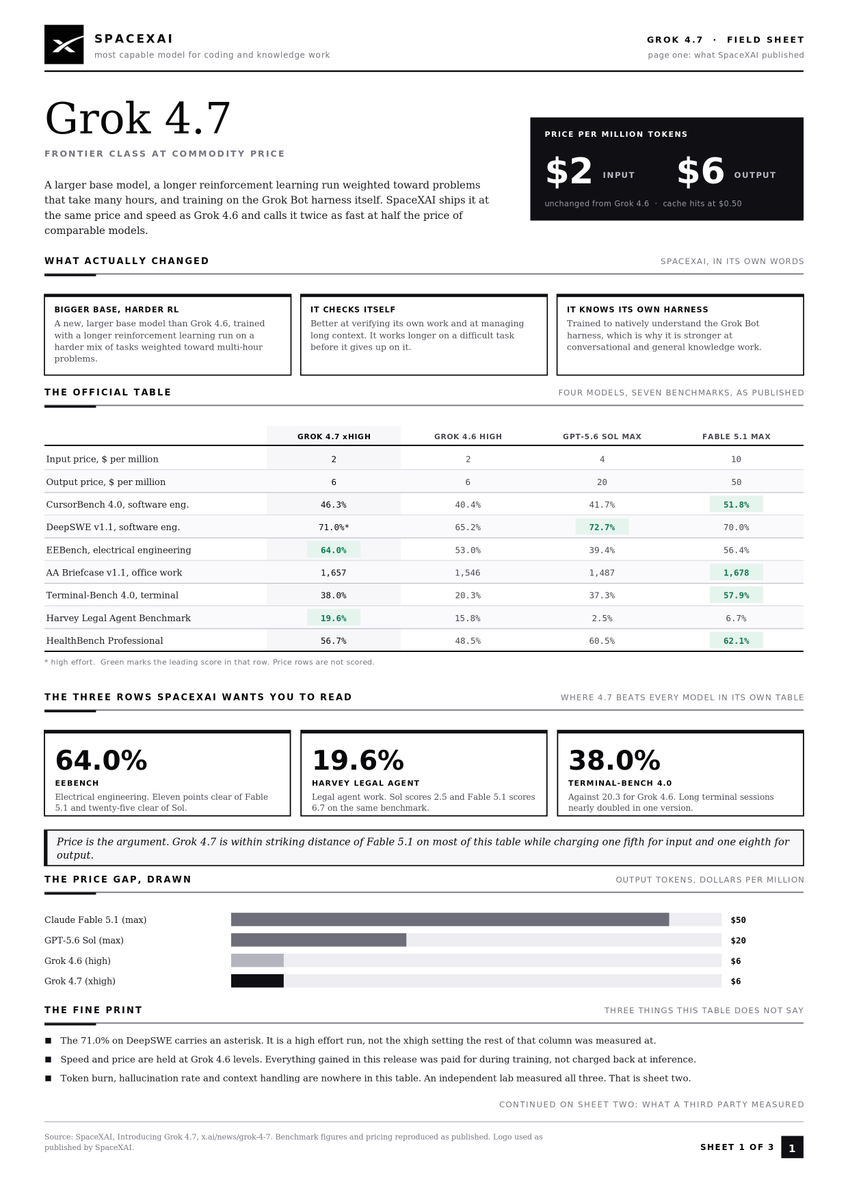
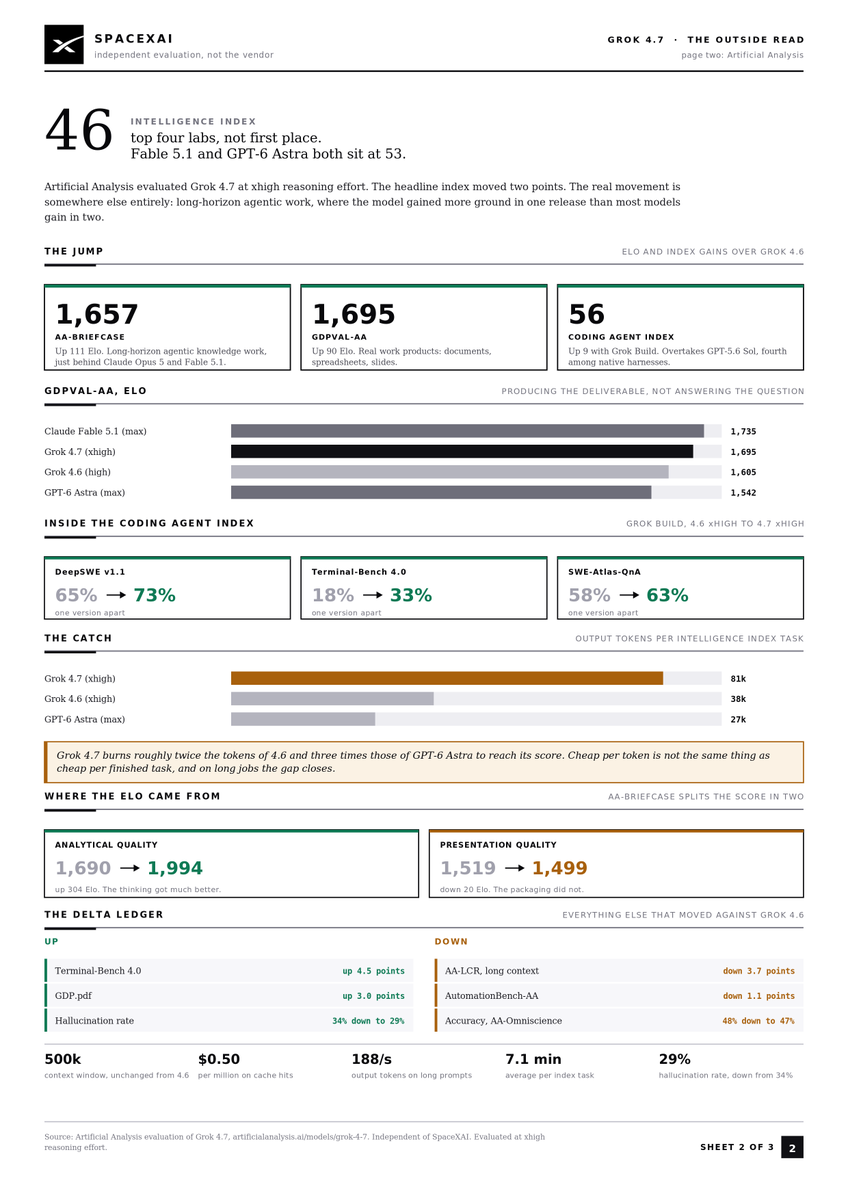
@ArtificialAnlys 报道称(99 次点赞、13 条回复、4,925 次浏览)称,GPT-6 Sol 和 Luna 的价格相比 GPT-5.6 Sol 和 Luna 大致减半。公开的 GPT-6 Sol 模型页面 证实了这次降价,而帖子串也补充了其中的权衡:Sol 以更低成本提升了 Coding Agent Index 表现,但这两款模型在部分知识工作评测上出现了回退。

@Jhaddix 反驳称(225 次点赞、18 条回复、14,428 次浏览、58 次收藏)则从安全测试的角度指出:如果要在 10,000 个并发代理、持续运行 8 天的条件下复现前沿漏洞利用评测,成本会高达数百万到数千万美元,而且这还未计入框架工程本身的负担。@evio_wwww 使用了(10 个赞,2 条回复,413 次浏览)Step Code 的开源发布则从相反方向印证了同一个观点:其 harness 的目标是“同等智能,更少 token”。公开的 Step Code 仓库 介绍了一款针对长周期可靠性和 token 效率优化的终端 agent,发布帖串中还附上了一张公开的分数与 token 消耗对照图。

讨论洞察: 最强的一批帖子,已经不再把“最佳模型”视为一个单一数字。开发者反复追问的是:模型跑在哪里、上线成本是多少、消耗了多少 token,以及通用 harness 能否复现同样的结果。
与前一天相比: 前一天公开的 Jev 讨论更偏向决策层的速度和成本倍数。到了 2026-09-22,基准测试相关讨论则把更多篇幅放在公开分数表、单任务经济性,以及特定 harness 的适用前提与限制上。
1.4 Agent 交易仍然是显性话题,但更有价值的讨论已转向恢复、信誉与发现基础设施(🡖)
Agent 市场的话题依然热闹,但当帖子不再停留在口号层面、而是开始点出缺失的关键机制时,讨论质量明显提高:身份、注册/发现、托管、可恢复性、争议处理,以及信誉更新。
@KaylashowDq 认为(56 个赞,64 条回复)指出,agent.family 并不是“加上 AI 的 Upwork”,而是一套围绕 agent 执行工作的流程:链上身份、信誉、发现、竞标、托管、交付验证,以及稳定币结算。公开的 agent.family 文档 目前将该系统展示为一个 TermiX 技能包,可安装到 agent 中,再连接到某条特定链上的账户。
@CteaAminah 聚焦于(38 个赞,28 条回复)谈到了其他人都略过的失败场景:当 agent 已经开始任务,而 API 宕机、算力耗尽,或服务提供方消失时,会发生什么。她提出的恢复路径很明确:记录进度、退还未使用的托管资金、保留部分输出、允许另一家提供方接手续跑,并决定质押或信誉该如何处理。

@miiportable_btc 扩展了(35 个赞,39 条回复)把它归纳为一个七步生命周期:达成一致、托管、交付、记录工作哈希、审查、质疑、评估,最后结算并更新信誉。

@oliviasand3va 推出了(20 个赞,21 条回复,20 次收藏)则提出了相邻的发现层论点:Rokha’s Registry 面向的是技能、MCP 服务器和 agents,而不是普通应用。公开的 rokha.ai 页面进一步强化了这一定位:它将一个 MCP 端点、一个机器可读的 llms.txt,以及 registry / board / ledger API 公开为供 agents 使用的实时入口。
讨论洞察: 回复区持续否定基于个人资料层面的信任。在回复 @Zakria_0987 尝试(54 次点赞,49 条回复)关于其自身 .agent 身份的讨论时,一位回复者认为,身份只有在系统同时提供权限信息、审计记录,以及出问题时可触发的终止开关时才有意义。
与前一天相比: 2026-09-21,@miiportable_btc 当时还在解释(37 次点赞,46 条回复)质疑:为什么代理一定需要一条从能力走向可雇佣服务的路径。到了 2026-09-22,措辞更强的帖子已经默认接受了这一前提,转而聚焦争议窗口、可恢复性和能力发现。
2. 什么最让人沮丧
验证、对提供商的信任,以及行动边界,仍然是最棘手的部分
严重程度:高。当天最具体的挫败感来自 @CommandCodeAI 报道(418 次点赞,36 条回复,22,892 次浏览):一个诈骗团伙在其补贴计划中创建了约 40,000 个虚假账户,并试图通过非官方代理跑出约 $450,000 的推理额度。核心抱怨不只是计费滥用,更在于位于 harness 和模型之间的代理可以读取提示词、代码和密钥,或者注入伪造的工具调用。在同一大方向上,@whemohere 降低了 将问题归纳为四个缺失的关卡,而 @Serantych 转向了 则将其进一步整理成一套蓝图,包括类型化输出、置信度阈值和决策日志。
人们正在通过转向更明确的验证基础设施来应对。@yonasbe 宣布了(32 次点赞,10 条回复,3,553 次浏览)提到了 StarSling Review Runners,而公开的 StarSling 文档 则介绍了通过 GitHub App 安装的 AI-native runners,以及面向 CI 的优化 PR。在更小型工具这一端,@PovilasKorop 分享(3 次点赞,2 条回复,346 次浏览)提到 Sloppy;其公开的 GitHub 仓库 将其定位为一种本地、确定性的分析工具,用来处理 AI 编码代理留下的技术债。
目前可见的权宜模式很一致:优先官方提供商而非非官方代理,优先类型化决策而非自由编排,优先审查产物而非“相信我”的总结。团队似乎愿意接受更慢或范围更窄的闭环,只要他们能看清到底检查了什么。
值得为此构建吗? 是的。这类痛点直接、反复出现,并且与欺诈、供应链风险和发布问责直接相关。
基准测试数字很难复现,也很容易被误读
严重程度:高。@Jhaddix 认为(225 次点赞,18 条回复,14,428 次浏览,58 次收藏)表示,前沿实验室的漏洞利用评估实际上让大多数防御者都难以企及,因为仅 API 账单就会高达数百万美元。@N01ennn 展示了(28 个赞,4 条回复,22 次收藏)解释了为什么紧接着就会出现下一重挫败感:即便基准测试表公开,结果也可能高度依赖其原生运行框架。@ArtificialAnlys 添加了 指出,GPT-6 Sol 和 Luna 改善了成本前沿,但并非所有知识工作评测都朝着同一方向变化。
于是,人们转而优化自己真正能跑的运行框架。@evio_wwww 表示 提到,Step Code 的出发点很简单:用更少的 token 实现同样的智能。对普通团队来说,这比试图复现一个由 10,000 个智能体组成的公开基准,更是一个可复现得多的目标。
更深层的挫败感在于,基准测试话语仍在把多个变量压缩成一个数字:单任务成本、token 消耗、运行框架质量、移除安全护栏的程度,以及结果脱离模型原生环境后是否仍然成立。
值得为此构建吗? 值得。低成本、可复现的评测,以及诚实交代基准背景,仍然供给不足。
自主商业仍然没有一个好的默认失败处理方案
严重性:中到高。@CteaAminah 详细说明了(38 个赞,28 条回复)指出了那条缺失的路径:当一个智能体启动任务后,API 失败、算力到期,或服务提供方消失了,该怎么办。@miiportable_btc 回应称(35 个赞,39 条回复)则提出了一个更正式的生命周期,围绕托管、审查、异议期和评估者小组来构建。在对 @Zakria_0987 尝试 他自己的 .agent 身份的回复中,人们仍然表示,在把链上身份视为可操作的信任机制之前,他们还需要权限控制、审计轨迹和紧急终止开关。
当下的应对机制,是把更多逻辑塞进流程:工作开始前先托管,交付时设置明确的审查阶段,交付后再留出争议期。这总比纯粹的乐观主义好,但看起来仍像是一个市场在公开设计自己的事故响应政策。
值得为此构建吗? 值得。这个需求是务实的,不是愿景式的:无人值守的智能体需要恢复能力、可续接性和裁决机制。
工具与技能发现正在变成一种独立负担
严重性:中。@oliviasand3va 表示 提到,Rokha’s Registry 之所以重要,是因为如今需要被发现的对象不再只是 app,而是 skills、MCP servers 和 agents。有条回复把这种痛点说得很直白:“我现在一半的构建时间都花在挑选 MCP servers 和 skills 上,而不是写 agent 本身。”同样的挫败感也出现在 JetBrains Air 下面,只是换了一种说法:最迫切的问题是,现在哪些 model / harness 组合真的能用,而不是多厂商选择听上去是否美好。并且,@undefinedKi 积累了 把 18 个 skills、72 个 slash commands、6 个 subagents 和 87 个 resources 打包进一个 package——只有在一个已经碎片化到不借助外力就记不住的生态里,这件事才说得通。
当前的变通办法是策展:操作指南、注册表、安装提示,以及越来越大的“第二大脑”打包合集。这确实能帮到个人,但也说明市场仍未标准化能力该如何命名、排序和组合。
值得为此构建吗? 值得,但这个方向正在迅速变得竞争激烈。发现、兼容性和信任信号,如今看起来和原始能力数量同样重要。
3. 人们希望出现什么
可跨会话与运行框架复用的学习
这是一个现实需求。@RoundtableSpace 推介(27 次点赞、6 条回复、36,236 次浏览、28 次收藏)Beacon 被当作用于挖掘过往 agent 会话的一种方式,并将其中的经验教训转化为可复用的技能,供 Claude Code、Codex、Cursor 和其他 harness 复用。@BHolmesDev 描述为 一个由 scorer-agent 和 self-improvement-agent 构成的循环,可将失败的运行转化为技能或 AGENTS.md 更新。@undefinedKi 打包了 一个 second-brain 栈,包含 18 项技能、72 个斜杠命令和 6 个 subagent,因为人们显然不想每次都从零重新摸索已被验证有效的工作方式。
人们想要的并不只是更多记忆,而是可复用的操作知识:这种知识在工具切换和新会话开始后依然能够保留下来。如今,这一需求部分由类似 Beacon 的会话挖掘、second-brain 工具包以及人工维护的指南来满足,但在如何提升、修剪或实现跨 harness 可移植性方面,仍没有共享标准。
机会:Direct.
模型、harness、技能和 MCP 服务器的兼容性图谱
这是一个紧迫的现实需求。在 @kskrygan 推出 JetBrains Air 之下,最早的一条回复之一就在问:如今究竟哪些 model / harness 组合真正可用。@oliviasand3va 认为 指出,Rokha’s Registry 之所以重要,是因为现在的问题关乎技能、MCP 服务器和 agent,而不只是应用。公开的 rokha.ai 页面正切中这一需求,它将 MCP、llms.txt、registry、board 和 ledger 端点作为机器可读接口公开出来。
人们似乎想要的是一层兼容层,在试错之前先回答一些最基本的操作问题:哪些 agent 能与哪些 harness 配合,哪些技能可以顺畅组合,哪些服务器值得信任,以及它们需要哪些权限。现有 registry 和指南解决了发现问题,但尚未解决信心问题。
机会:Direct.
围绕 agent 编写代码的确定性审查与技术债清理
这是一个现实需求,而且也是一个拥挤的赛道。@whemohere 想要 Grok bots 之间的轻量级决策闸门。@Serantych 想要 类型化输出、置信度闸门、决策日志和 eval 循环。@yonasbe 宣布 用于 GitHub Actions 的 Review Runners,而 @PovilasKorop 已发布 Sloppy 则用于捕捉编码代理留下的确定性 PHP 和 Laravel 技术债。
这里想要的并不只是“更好的代码审查”,而是在代理输出与生产环境之间建立一层可重复、可审查的机制。现有确实已有一些解决方案,但它们分散在 CI 产品、静态分析工具和 harness 级控制平面之中。
机会:Competitive.
面向自主商业的恢复与争议处理原语
这是一个非常现实的需求,但整体仍显早期。@CteaAminah 问道 当代理开始一项工作后,如果环境在任务中途失败,会发生什么。@miiportable_btc 描述为 当前 TermiX 给出的答案是托管、审查、质疑、评估者复核、结算和信誉更新。@KaylashowDq 定义为 更广泛的目标则是成为代理寻找工作、获得报酬并建立履历的基础设施。
用他们自己的话说,人们想要的是一条更清晰的失败处理路径,而不只是一个只覆盖“顺利路径”的市场。如今已经有一些局部答案,但它们看起来仍更像是定制化流程设计,而不是稳定的标准。
机会:Emerging.
4. 在使用的工具与方法
| 工具 | 类别 | 情绪倾向 | 优势 | 局限 |
|---|---|---|---|---|
| JetBrains Air | 控制平面 / IDE 系统 | (+/-) | 支持多厂商、可连接 ACP、具备明确的治理与成本可见性层、便于团队协作 | 产品体系仍处早期;回复中马上有人追问,哪些组合在实践中真正可行,以及产品边界究竟在哪里 |
| Jev | 决策层 / 控制方法 | (+/-) | 类型化输出、置信度门控、动态上下文与工具路由、可重放决策 | 反复有人指出,它不能替代系统设计、评测或工程基本功 |
| Grok 4.7 | LLM / 编码代理模型 | (+/-) | 强调高性价比,在部分编码和法律代理基准上有所提升,在 Grok Build 内具备原生 harness 感知能力 | 对原生 harness 的依赖反复被提及为限制;token 消耗仍然很高;也并非在所有场景中都明显登顶 |
| GPT-6 Sol / Luna | LLM / 编码代理模型 | (+/-) | 价格大约只有 GPT-5.6 Sol / Luna 的一半,幻觉更少,Sol 在 Coding Agent Index 上有所提升 | 评测结果好坏参半;Luna 在部分编码指标上退步,两款模型在一些知识工作任务上也出现回退 |
| Command Code | Harness / 提供商接入 | (+/-) | 官方接入路径成本极低;提供商打包方案旨在减少第三方胶水层 | 补贴式接入吸引了大规模欺诈;非官方代理会带来信任和数据外流风险 |
| StarSling Review Runners | CI / 验证 | (+) | AI 原生的 GitHub Actions runners、优化 PR、代码审查代理定位、更快的 CI | 文档称 runner 支持仅限组织账户,且部分 AI 优化功能仅限付费计划 |
| Rokha Registry | 注册表 / MCP 运行时 | (+) | 实时 MCP 端点、代理可读的 llms.txt、registry 和 ledger API、免安装发现模式 |
发现质量和信任信号仍然属于产品问题的一部分,单靠“列出来”并不能完全解决 |
| TermiX + AACP / agent.family | 商业协议 / 市场 | (+/-) | 为代理间工作提供明确的身份、托管、审查、评估者和信誉模型 | 失败恢复、权限、可审计性以及提供商可用性仍是持续中的设计问题 |
| Sloppy | 静态分析 | (+) | 以确定性方式在本地清理 AI 编码债务;具备 Laravel 感知规则;可与 Rector、Pint、Pest 和 MCP 集成 | 范围较窄,仅覆盖 PHP / Laravel,而不是跨技术栈的通用答案 |
纵观整个技术栈,当工具能让代理行为更易于检查或约束时,整体评价最为积极。JetBrains Air、StarSling、Rokha、TermiX 和 Sloppy 虽处于不同层,但卖点都围绕某种形式的可见性、可重复性或更安全的组合方式展开。
常见的变通做法也相当一致:使用官方提供商渠道、把代理放在类型化决策门之后、增加本地静态分析或 CI 审查,并把可复用经验沉淀为技能或指南。迁移已经在发生:人们正从通用的“聊天 + 工具”配置,转向原生 harness、代码库工作流、注册表以及组织专属控制平面。在模型侧,Grok 4.7 最强力地主打性价比,而 GPT-6 Sol 则试图在高端市场重新夺回效率前沿的位置。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| JetBrains Air | JetBrains / @kskrygan | 面向代理式软件开发的开放产品体系,覆盖 IDE、团队工作流和治理 | 多厂商代理协作中的协调、可见性与控制 | JetBrains IDEs、ACP、多厂商代理、治理服务 | Beta | 文章, JetBrains Air |
| StarSling Review Runners | @yonasbe | 代码审查代理和 AI 原生的 GitHub Actions runners,可持续优化 CI | CI 缓慢以及重复的人工验证工作 | GitHub Actions、GitHub App、基于模型密钥的审查代理、工作流优化 | Beta | 文章, 文档 |
| Rokha Registry | Rokha | 面向技能、MCP 服务器和代理的注册与执行层 | 代理工作流中的能力发现、执行与可组合性 | MCP JSON-RPC、llms.txt、registry API、ledger / board APIs、Rokha SDK |
Shipped | rokha.ai, registry/api |
| TermiX + agent.family | TermiX | 以代理为中心的市场,提供身份、托管、审查、争议处理和结算 | 雇用、支付和验证自主代理 | AACP、链上身份、托管、评估者流程,声誉 | Beta | 文章, agent.family 文档, termix.ai |
| Beacon | @RoundtableSpace | 从过往 agent 会话中提炼经验,并将其转化为可跨 harness 复用的技能 | 会话知识流失,以及在不同工具间反复犯同样的错误 | Jev、会话挖掘、跨 harness 技能封装 | Beta | 文章 |
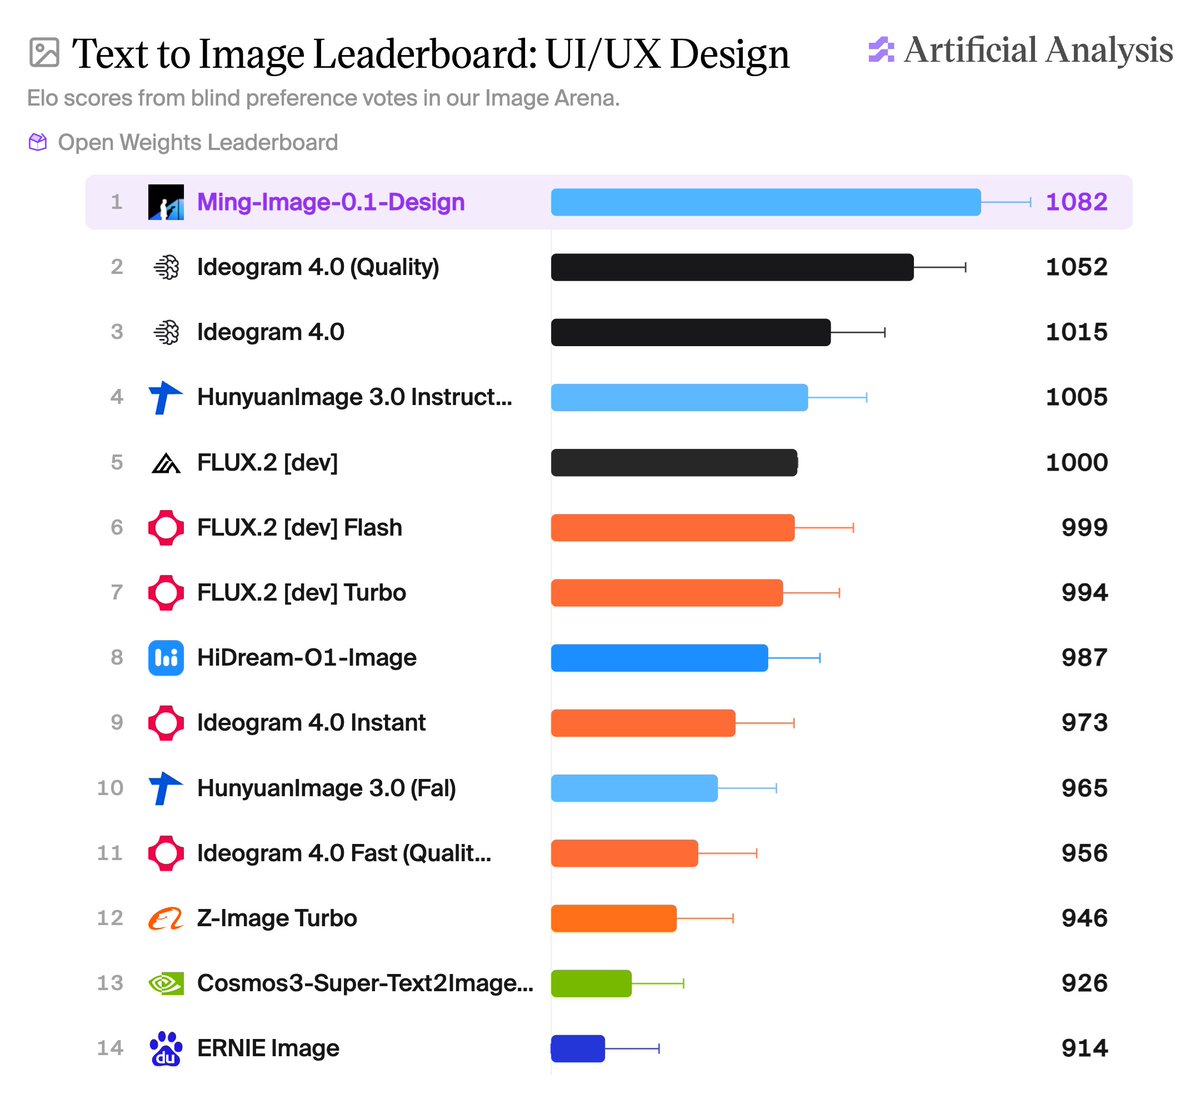
| Ming-Image-0.1-Design + Ling UI Design Skill | inclusionAI / @AntLingAGI | 面向 UI、海报和可编辑设计工作流的开放权重设计模型及配套 agent 技能 | 视觉设计生成,以及从设计到资产的流水线 | 6B 设计模型、Hugging Face 模型卡、Python 仓库、RGBA 输出 | 已发布 | 文章, Hugging Face, 仓库 |
| Step Code | StepFun / @evio_wwww | 面向 token 效率和长周期任务优化的开源终端 agent CLI | 编码 agent 的 rollout 成本高昂,且长任务的人机工效较差 | TypeScript、MCP、多 agent 编排、StepPage 发布 | Alpha | 文章, 仓库 |
| Sloppy | Heyosseus / @PovilasKorop | 针对 AI 编码 agent 留下的代码质量模式进行本地静态分析 | AI 编写的 Laravel 和 PHP 代码中的机械性技术债 | PHP、Laravel 感知规则、Rector、Pint、Pest、MCP | 已发布 | 帖子, 仓库 |
JetBrains Air 和 StarSling 从不同方向切入同一个宏观问题:代码生成越来越便宜,而协调与验证的成本却越来越高。Air 在 agent 之上构建了一个多供应商控制层;StarSling 则把评审和 CI 优化进一步下沉到交付链路中。
Rokha 和 TermiX 构建的是 agent 经济中彼此相邻的层,而不是同一种产品。Rokha 关注的是如何通过 MCP 和 registry 入口发现并运行能力;TermiX 关注的是 agent 如何被识别、雇用、托管、评审、申诉处理和支付。两者背后的共同驱动是:能力本身,并不足以让一个 agent 真正投入运行。
Ming-Image、Step Code 和 Sloppy 表明,“agent 技能”这一概念正迅速走出纯聊天 UX。一个项目把 UI 和演示文稿生成变成开放权重技能,另一个用更少的 token 从 harness 中压榨出更多产出,第三个则在模型写完代码后清理确定性的技术债。多位构建者都在解决同一个底层痛点:真正困难的部分,已经不那么是“让 agent 产出些什么”,而是“让产出可用、可审查,而且便宜到足以持续”。
6. 新动态与值得关注的内容
MemoHarness 让自适应 harness 变得具体起来
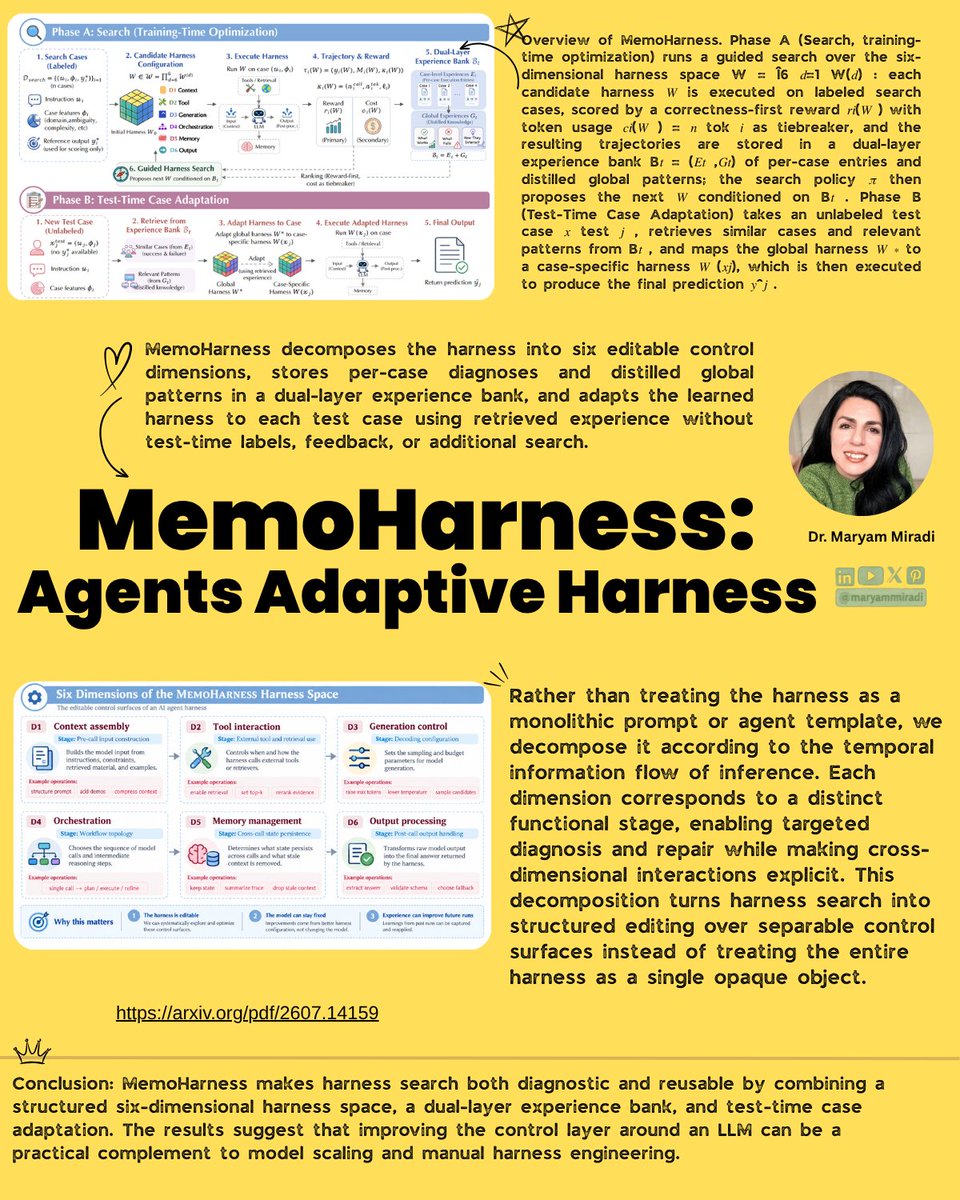
@MaryamMiradi 总结(11 个赞,1 条回复,326 次浏览,9 次收藏)将 MemoHarness 论文视为一种转向:不再把 harness 当作一个巨大的 prompt。该帖文将 harness 拆解为六个可编辑的控制维度——上下文、工具交互、生成控制、编排、记忆管理和输出处理——并描述了一种双层经验库,可按具体案例调整控制层,而无需重新训练基础模型。
自我改进从记忆倾倒转向可审查的 diff
@BHolmesDev 描述 介绍了一个多 agent 自我改进循环:scorer agent 为过往运行打分,自我改进 agent 则提出对技能和 AGENTS.md 文件的更新建议。其独特之处不在于“更好的记忆”,而在于基于重复失败模式、可供审查的操作性变更。
agent 技能从编码扩展到设计工作流
@AntLingAGI 宣布(71 个赞,4 条回复,14,821 次浏览,35 次收藏)介绍了开源的 Ming-Image-0.1-Design 系列,以及两项 agent 技能:Ling UI Design Skill 和 Image-to-Editable-PPT Skill。公开的 Hugging Face 模型卡 将该模型描述为一个面向 UI、信息图、海报和富文本视觉设计的 6B 系统,支持 RGBA;公开的 Ming-Image 仓库 则提供了安装和推理代码。
“第二大脑”捆绑包变得越来越大,也越来越具体
@undefinedKi 打包(56 次点赞、11 条回复、4,103 次浏览、86 次收藏),这是一个免费的仓库加网站捆绑包,包含 109 页内容、18 项 agent 技能、72 条斜杠命令、6 个子 agent 和 87 项资源。这里的信号并不在于某一项突破性功能,而在于操作者越来越想要一套持续维护的知识栈,用于 Jev 工程、harness、evals 和知识图谱,而不是零散的帖子和一次性的聊天记录。
7. 机会在哪里
**+++] 用于多智能体编码和 CI 的验证框架**——多个部分都指向同一个缺口:来自 [@CommandCodeAI 的非官方代理风险、来自 @whemohere 的 Jev gates、来自 @Serantych 的类型化审查/控制循环、来自 StarSling 的 AI-native CI,以及来自 Sloppy 的确定性技术债清理。之所以说证据充分,是因为这些痛点来得直接、涉及安全,而且已经催生出多种不同的产品形态。
[+++] 工作流原生的企业落地工具包 —— Microsoft 的转型文章、JetBrains Air 的发布、Suraj Sharma 的前置部署工程师路线图,以及 Steve Yegge 的 agentic-TPM 概念,都传达出同一个信息:企业首先需要的不是更多通用助手,而是工作流重构、权限管理、可观测性,以及按角色设计的运营模型。这个方向看起来很强,因为需求直接系于部署,而不只是出于好奇。
[++] 跨 harness 的记忆与学习迁移 —— Beacon、BHolmes 的 scorer/自我改进循环、undefinedKi 的“第二大脑”捆绑包,以及 Maryam Miradi 对 MemoHarness 的总结,都指向同一个缺失层:把已经奏效的方法保留下来,并推广到不同会话和工具之间。这个信号属中等强度,因为需求显而易见,但关于推广、裁剪和可移植性的标准仍未定型。
[++] Agent 能力发现与兼容性图谱 —— Rokha 的 registry 界面、JetBrains Air 对 ACP 的框定,以及当天大量整理型捆绑包,都表明发现能力与兼容性已成为真实瓶颈。这个机会属中等强度,因为 registry 已经存在,但信任、排序和组合能力仍不成熟。
[+] 面向自主商业的失败恢复与争议处理标准 —— Ctea Aminah 的任务中途失败路径、miiportable 的 escrow-and-evaluator 生命周期,以及 Zakria 身份测试下方的质疑声,都表明 agent 商业仍缺乏稳健的默认恢复机制。这个信号仍在形成中,因为市场尚早,但设计问题已经很具体。
8. 要点
- 企业对 agent 的采用,正被重新定义为工作流与治理设计问题,而不是席位铺开问题。 JetBrains Air 将自己定位为协调与治理系统,而 Microsoft 自身的转型文章强调的也是工作流重构,以及 100 多个专用 agent,而不是单纯提供工具访问。(来源,来源)
- Jev 只有在变成一个小而,类型化控制界面。当天较好的帖子讨论的是门控、置信度阈值和可重放的决策,而不是含糊的“裁判”式说法。(来源,来源)
- 如今,模型对比不仅取决于原始基准排名,同样取决于评测框架的适配度和每个已完成任务的成本。围绕 Grok 4.7 的讨论侧重其在原生评测框架下的表现和价格,GPT-6 Sol 则强调帕累托效率,而 Jhaddix 指出,对大多数团队而言,重新运行前沿规模的安全评测并不现实。(来源,来源,来源)
- 围绕智能体商业的讨论,正从身份口号转向托管、评价和故障处理。最有价值的帖子讨论的是恢复路径、异议窗口、评估者小组和能力发现,而不只是“可雇佣的智能体”。(来源,来源,来源)
- 可复用的运营知识正逐渐成为独立的产品层。Beacon、自我改进循环、第二大脑工具包和 MemoHarness 都把智能体经验当作可捕获、可评分、可提升并可在后续运行中复用的成果物。(来源,来源,来源,来源)