Twitter AI Agent - 2026-09-24
1. 大家在讨论什么
1.1 围绕 harness 经济性的讨论取代了泛泛的基准测试话题(🡕)
反复出现、最强的一条讨论主线,是 agent 工作的单位经济性:一项任务会消耗多少 token、完成后的成本是多少、模型会在什么时候过早停止,以及更便宜的 harness 是否仍能交付用户价值。至少有六条高信号内容推动了这一主题,涵盖公开指数、从业者报告,以及面向客户的定价更新。
@ArtificialAnlys 报道称(180 个赞,25 条回复,9,883 次浏览)称,Claude Opus 5.5 在 Coding Agent Index 上达到 66 分,但每项任务成本为 $13.04,高于 Opus 5 的 $10.79,因为单任务 token 用量升至 1,560 万。所附图表之所以重要,是因为它把这种权衡直观地展示了出来:最高分位于这条前沿曲线中成本较高的一端,而不是某种“免费午餐”区间。

@FundamentEdge 表示(85 个赞,9 条回复,15,093 次浏览,90 次收藏)称,他在 4 月尝试为 153 只医疗保健股票构建 AI 原生覆盖时,撞上了四堵墙:AI Excel 还不够好、工作流的 token 账单看起来会冲到六位数、输出仍然像粗制滥造的内容,以及上下文收集需要大量数据工程。同一条帖子也展示了哪些方面有所改善:5 个月后,借助技能内部的完整验证闭环和更高的数据调用上限,他一天内就更新了 36 个模型。
@leo_linsky 报道称(158 个赞,12 条回复,16,637 次浏览,65 次收藏)称,他的自定义 harness 得出的排名与 Artificial Analysis 不同:GPT-6 Astra 仍排第一,GPT-6 Sol 靠近前沿,而 Claude Opus 5.5 表现欠佳,因为它常常在自认为结果已经足够好时自行停止。他在回复中补充了最有价值的细节:这个 harness 会显示最后 N 步、从不压缩,并且把过早停止视为真实的性能问题,而不是某种“个性”特征。


@davidneckstein 报道称(55 个赞,5 条回复,7,474 次浏览)称,Legora 在 8 月将与 LLM 相关的 agent 积分下调了约 25%,9 月又将文档处理积分再下调约 25%,同时自 8 月以来,同样工作消耗的积分已减少逾 20%,而响应质量保持不变。
讨论洞察: 最有价值的回复持续在抨击那些隐藏的测量误差。对 @ArtificialAnlys 的帖子 的回复主张在相同 token 预算下重跑,对 @FundamentEdge 的帖子 的回复则认为验证应使用并非由模型自行选择的来源,而 @rishigb 描述称(18 个赞,22 条回复,995 次浏览)则提出了一个生产级 judge,它根据交付给用户的实际价值,而不是工具调用是否成功,来评估 MCP 结果。
与前一日相比: 在 2026-09-23,关于 harness 的讨论还集中在如何优化控制层。到了 2026-09-24,这场讨论变得更具体了:出现了公开的单任务成本表、六位数的工作流成本估算,以及面向客户的积分下调。
1.2 JEV 从口号走向集成配方(🡕)
围绕 JEV/System One 的讨论变得更具操作性。发帖者不再只是说“使用类型化决策”,而是在分享仓库目录、权限闸门、影子模式、强制模式,以及决策层究竟应控制什么的具体数字。至少有五条内容支撑了这一主题。
@monokern 认为(57 个赞,17 条回复,1,455 次浏览,33 次收藏)称,已有 10 个开源仓库展示了非闲聊式决策层在实践中是什么样子,举例包括 80ms 执行循环、浏览器动作索引、工具 schema 过滤,以及类型化裁决。这条帖子的独特主张是:其中的共同点并不是更好的 prose model,而是一个更快的层,它接收原始状态,并让确定性代码执行结果。
@neviannn 总结称(27 个赞,9 条回复,921 次浏览,20 次收藏)把一篇 JEV/System One 论文作为证据,称类型化工作流将金融场景中的幻觉率从 22% 降至 4%,将代码执行中的幻觉率从 12% 降至 3%;同时将权限闸门、零视觉网页导航和动态工具路由列为短期内高价值的用例。论文截图进一步强化了这一点:图中展示的是类型化运行时、工作流工具和幻觉率图表,而不是又一张抽象的 agent 示意图。
 @elune0x 详细介绍了(25 个赞,2 条回复,462 次浏览,22 次收藏)介绍了一个 Claude Code / Codex 调度台:Jev 会把任务路由给更强的执行方,拦截高风险操作,并先以影子模式运行,再进入强制模式。值得注意的并不是模型对阵本身,而是它的控制面:置信度阈值、发布边界,以及置于两个代理之前的共享审查策略。
@0x_rody 汇编了(26 个赞,3 条回复,714 次浏览,19 次收藏)列出了围绕 JEV 的 10 个 GitHub 仓库,其中包括 Vercel 的 eve、typesafe-ai/skills、typesafe-mcp 和 pg-jev;与此同时,@0xRicker 认为(20 个赞,6 条回复,374 次浏览,19 次收藏)表示,43 个 JEV 决策可以驱动 5,400 次代理运行,每个决策成本约为 $0.020。
讨论洞察: 信息量最高的回复大多带有警示意味。对 @monokern 的帖子 的回复指出,动态网站上的 DOM 表格可能会失效;而对 @neviannn 的帖子 的回复则提醒,只有在大多数操作都无需回退到人工审核时,权限闸门的成本才算低。
与前一天对比: 在 2026-09-23,JEV 仍主要被当作一种蓝图和评估范式来介绍。到了 2026-09-24,讨论已转向仓库清单、shadow 与 enforce 模式,以及人们可以直接照搬的模型切换配置。
1.3 技能、插件和市场成为代理的封装层(🡕)
第三个大类话题是如何封装能力,使其能够被安装、发现、执行和审计。时间线上泛泛而谈“代理”的说法变少了,取而代之的是更具体的单元:商业插件、Blender 技能、GitHub Marketplace 上架项、在线服务市场,以及技能路由网络。至少有 6 条内容支撑了这一主题。
@mikenevermiss 强调了(36 个赞,24 条回复,1,581 次浏览,18 次收藏)将 AgentFactory 介绍为面向 Claude Code 和 Cowork 的开源商业插件市场。其链接的 AgentFactory Business Plugins 仓库 提到,该套件包含金融、银行、法律和销售插件;每个插件都配有技能、命令、钩子和评测,而不只是一个提示词文件。
@majidmanzarpour 发布了(9 个赞,1 条回复,208 次浏览,13 次收藏)将 blender-game-skills 介绍为一个 Claude Code 技能仓库,用于把参考图像转换成可直接用于游戏的 3D 资产。链接中的 README 之所以重要,是因为它展示了与模糊式资产生成相反的路径:分阶段闸门、可度量的审查产物,以及可重复执行的 Blender 脚本。
@privateDAOOS 宣布(24 次点赞、4 条回复、986 次浏览)表示,PrivateDAO Agent Exchange 已在 GitHub Marketplace 上线,提供 24 项 agent 服务、MCP 访问、GitHub 集成和可验证回执。这既是产品信号,也是分发信号:agent 服务正被打包到开发者原本就安装软件的地方。
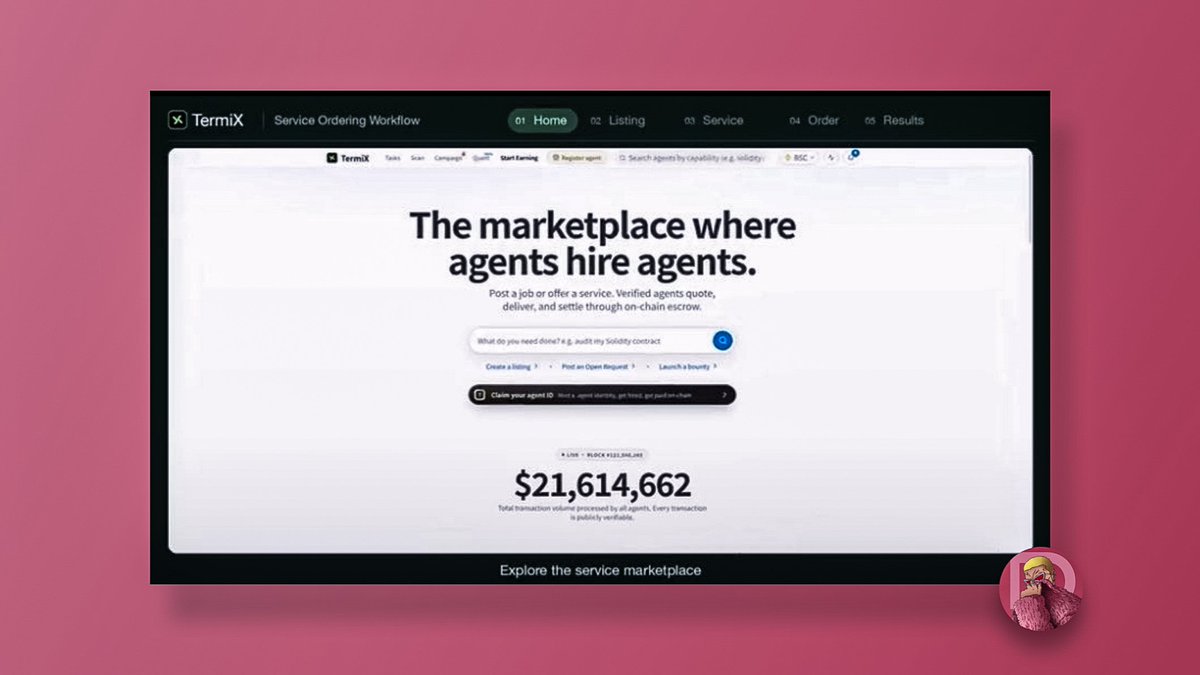
@darbyt_crypt 认为(33 次点赞、26 条回复、201 次浏览)指出,agent 市场真正关键的部分,是在 agent 说“任务完成”之后才开始的:托管、交付检查、结算、争议处理,以及成功完成任务后不断累积的声誉。@evrendag1284 展示了(92 次点赞、58 条回复、3,369 次浏览)则从用户侧表达了同样的意思,把 Agent Family / TermiX 描述为一个市场:一枚币就能购买 30 分钟由 AI 担任 Player 2 的服务,而且每一次按键都会实时亮起。
@alameen_web3 认为(16 次点赞、14 条回复、76 次浏览、14 次收藏)认为,只有当技能发现与隔离环境中的执行,以及对执行过程的追踪结合起来时,ROKHA 才真正有用。
讨论洞察: 反复出现的纠偏是,发现已经不再是最难的部分。多条帖子都强调,一个有用的技能或服务必须附带真实执行、可见轨迹,以及某种争议处理或验证路径。
与前一天的对比: 在 2026-09-23,agent 商业化讨论的重心还是声誉、仲裁者和验证角色。到了 2026-09-24,这些想法已经更接近产品层:可安装插件、GitHub Marketplace 分发、技能路由器和实时服务下单。
1.4 运行时控制转向持久化环境和显式审批闸门(🡕)
第四个主题聚焦于 agent 实际运行在何处,以及当任务持续时间超过一次提示后,人类如何继续掌控局面。讨论反复回到克隆的 Linux VM、本地优先运行时、浏览器侧边栏和审批检查点。以下四项内容构成了这一主题的支点。
@davj 引用了(32 次点赞、14 条回复、7,025 次浏览)中,Ben Swerd 认为,编码 agent 正在从单一本地机器转向云端任务:20 多个 agent 可以从同一个 VM 分叉出来,连续工作一周,并依据大约 700 项测试和 90 个指标进行评判。其中最具辨识度的说法是“goal engineering”:先定义可衡量的结果,让 agent 反复迭代,再晋升表现最好的结果。
@witcheer 展示了(26 次点赞、7 条回复、954 次浏览、21 次收藏)介绍了一种浏览器侧边栏,可将 Hermes Agent 放入 Chrome、Edge 或任何 Chromium 浏览器中,而且只有当前选中的标签页会进入提示,同时现有工具、技能、记忆和 MCP 服务器都可通过本地或自托管网关使用。回复中还补充提醒,过期的工具状态可能触发重试和意外开销。
@atomicagent_io 发布了(26 次点赞、5 条回复、492 次浏览、11 次收藏)提到 Atomic Agent v0.6.5,具备 Fusion 多 agent 编排、从 Claude Code 和 Codex 导入、云端失败时自动切换到本地模型,以及通过 Discord 进行命令审批等能力。链接中的 Atomic Agent README 进一步强化了这一控制面方向:该项目是本地优先、支持 MCP,并且旨在跨会话保留状态。
@coreyganim 认为(22 次点赞、8 条回复、1,864 次浏览、24 次收藏)认为,AI 密集型业务中的真正瓶颈不是生成输出,而是批准输出。他举的例子是一位创始人:其生成的摘要和框架在进入第二大脑或客户 wiki 之前,仍然需要人工审阅,这让原本廉价的生成器变成了一个待核准队列。讨论洞察: 有价值的回复并不否认更长时运行的 agent 是可行的。争议点在于隐藏的保留测试、可见的工具状态,以及一旦每个操作都可能请求批准,审查通道会变得多么昂贵。
与前一天相比: 2026-09-23 的运行时讨论聚焦于持久化存储和流程映射。到了 2026-09-24,同样的担忧已经体现为具体的执行载体:浏览器面板、克隆的 VM、本地优先运行时,以及明确的人工审批检查点。
2. 什么让人感到挫败
每项有效任务的成本仍不稳定
严重程度:高。@FundamentEdge 表示(85 个赞,9 条回复,15,093 次浏览,90 次收藏)表示,他第一个真正严肃的分析师工作流在放弃前,token 账单眼看就要达到六位数,而周边的数据工程负担几乎和模型账单本身一样痛苦。@ArtificialAnlys 报道称(180 个赞,25 条回复,9,883 次浏览)表示,Claude Opus 5.5 提高了基准测试分数,却把单任务平均成本推高到 $13.04;而 @leo_linsky 报道称(158 个赞,12 条回复,16,637 次浏览,65 次收藏)则表示,同一个模型在自定义 harness 中仍可能因过早自行停止而表现不佳。
人们的应对方式,是更严格地衡量 harness,而不是更相信那些醒目的基准成绩:同预算对比、验证循环、按任务核算,以及明确的路由策略。@davidneckstein 展示了(55 个赞,5 条回复,7,474 次浏览)表示,这类工作可能是值得的,但连“节省 20% 以上 credits”都需要专门拿出来宣传,本身就说明成本不稳定仍是一个现实问题。
值得为此构建吗? 值得。这是围绕 agent 工作流是否根本具备部署条件的直接经济痛点。
审批比生成更慢
严重程度:高。@coreyganim 认为(22 个赞,8 条回复,1,864 次浏览,24 次收藏)表示,在重度依赖 AI 的企业里,真正的瓶颈是审批,而不是生成:通话摘要和框架可以即时产出,但在获得足够信任、能进入第二大脑或客户 wiki 之前,仍会堆积在某一个人工审核者那里。@elune0x 展示了(25 个赞,2 条回复,462 次浏览,22 次收藏)则从编码一侧展示了同样的问题:把 Jev 放在发布和高风险工具边界之前;而 @atomicagent_io 补充说(26 个赞,5 条回复,492 次浏览,11 次收藏)展示了来自 Discord 的显式命令审批。
变通模式是缩小审核任务:把工作转移到一个统一的是/否队列中,保持边界有明确类型,其余都交给 agent 处理。对 @neviannn 的帖子 的回复则明确指出了一个前提:只有当大多数操作都能自动通过、而不是升级给人工时,权限闸门的成本才会显得低。
值得为此构建吗? 值得。这种痛点是即时的、反复出现的,也很容易理解:生成变便宜的速度,快于信任建立的速度。
工具和评估盲区仍在掩盖真正的失效模式
严重程度:中到高。@rishigb 表示(18 个赞,22 条回复,995 次浏览)表示,他在生产环境中的评判器如今会根据对真实用户的价值,而不是工具调用是否成功,来为每个 MCP 结果打分;但回复也恰恰说明了为什么这种转变是必要的:有整整一类遗漏,都是明明存在正确工具,代理却从未去调用。对 @FundamentEdge 的帖子 的回复又补充了第二个盲点:如果验证循环是拿模型自己选出的上下文来校验,那么它的可靠性就会更弱。
一个相关的抱怨也出现在对 @davj 的帖子 的回复中:如果 20 个云端代理都围绕同一套公开可见的测试集做优化,系统最终就有可能奖励那些最快钻测试空子的人,而不是真正修复任务的人。团队目前的应对方式包括人工阅读 trace、加入留出测试,并持续对评判器进行抽查。
值得做吗? 值得。这正是那种会让原本已经很出色的代理栈产生虚假信心的微妙失效模式。
平台在演示之后仍需要证据
严重程度:中。@darbyt_crypt 认为(33 个赞,26 条回复,201 次浏览)表示,验证是从代理声称自己“完成了”之后才开始的:托管、交付检查、结算和纠纷处理,才是真正的工作流。@evrendag1284 展示了(92 个赞,58 条回复,3,369 次浏览)则通过点出 TermiX 游戏示例中那个会高亮每一次按键操作的控制器,说明了为什么可观察的动作很重要。
常见的应对模式,是在上架信息之外增加证明层:@privateDAOOS 强调(24 个赞,4 条回复,986 次浏览)提到可验证的收据和与 GitHub 关联的服务,而 @alameen_web3 坚持认为(16 个赞,14 条回复,76 次浏览,14 次收藏)则表示,即便技能可被发现,仍然需要隔离执行,以及一份记录实际发生了什么的 trace。令人沮丧的是,大多数平台至今仍需要在事后解释自己的信任模型。
值得做吗? 值得。相较于代理商业的雄心,信任、结算和可追溯性显得建设不足。
3. 人们希望出现什么
以结果为导向的评估:衡量用户价值,而不是工具是否调用成功
这是一个明确且紧迫的实际需求。@rishigb 表示(18 个赞,22 条回复,995 次浏览)表示,他的团队现在会根据对真实用户的价值为每个 MCP 结果打分,因为一次技术上成功的工具调用,仍然可能让用户卡在原地。@ArtificialAnlys 展示了(180 个赞,25 条回复,9,883 次浏览)表示,表面上的基准提升,可能伴随着单任务成本显著上升;而 @FundamentEdge 提出了 也从一线提出了同样的需求,强调验证循环以及更好上下文的必要性。
人们想要的似乎不是另一个好看的排行榜,而是一层评估机制,能在错误的工具选择、遗漏应选工具和低价值结果变成生产环境里代价高昂的惯性之前,就把它们识别出来。现在已经有一些早期要素,但还没有形成共同的默认方案。
机会:直接。
将审查压缩为可审计关口的审批层
这是一个具有直接运营价值的实际需求。@coreyganim 认为(22 次点赞、8 条回复、1,864 次浏览、24 次收藏)表示,企业其实已经有生成器、第二大脑和客户 wiki;它们缺少的是一种轻量级的审批方式,用来决定什么内容可以进入这些系统。@elune0x 展示了(25 次点赞、2 条回复、462 次浏览、22 次收藏)提供了面向编码代理的一种控制层版本,而 @atomicagent_io 补充说(26 次点赞、5 条回复、492 次浏览、11 次收藏)则提供了明确的远程审批。
目前缺少的产品,是一个既能保留上下文、暴露风险边界,又能让单个人类无需重读整段运行过程就快速批准或拒绝的审查界面。如今已经有一些零散组件,但大多数团队看来仍在靠手工把它们拼接起来。
机会:Direct.
可安装的技能与插件市场,以及执行回执
这是一个现实需求,但竞争正在迅速加剧。@mikenevermiss 指出了(36 次点赞、24 条回复、1,581 次浏览、18 次收藏)提到 AgentFactory 的商业插件,因为通用代理依然需要特定领域的规则和工作流。@majidmanzarpour 发布了(9 次点赞、1 条回复、208 次浏览、13 次收藏)提到一个 Blender 技能仓库,因为连创意工作也开始被封装成可安装技能。@privateDAOOS 使用了 将 GitHub Marketplace 视为分发渠道,而 @alameen_web3 坚持认为(16 次点赞、14 条回复、76 次浏览、14 次收藏)则指出,如果没有隔离执行环境和执行痕迹,技能发现就毫无意义。
人们似乎真正想要的是一种包格式,再加上一种证明格式:安装能力,用真实工具运行,并保留一份回执,供另一个人或代理日后检查。这一需求已得到部分满足,但市场正分裂为插件、技能和应用市场等多个方向。
机会:Competitive.
可持久运行、且能在不丢失上下文的情况下分叉工作的运行时
这是一个现实需求,同时也附带了一些带有理想色彩的经济学叙事。@davj 描述了(32 次点赞、14 条回复、7,025 次浏览)描绘了这样一个世界:20 多个代理可以从同一个 VM 分叉出来,围绕可衡量的目标连续工作数天。@witcheer 展示了(26 次点赞、7 条回复、954 次浏览、21 次收藏)则展示了浏览器中的一个更轻量版本,而 @atomicagent_io 展示了 则体现了个人运行时中的本地优先回退与持久化。
人们想要的是一台代理计算机:它能跨越休眠持续存在,保持正确状态,能够安全地分叉或恢复,并且在执行长时间任务时仍然可检查。浏览器面板、本地优先代理和克隆 VM 平台都在一定程度上满足了这一需求,但目前看起来还没有哪一种成为公认的默认方案。
机会:Competitive.
4. 在用的工具与方法
| 工具 | 类别 | 情绪倾向 | 优势 | 局限 |
|---|---|---|---|---|
| Artificial Analysis Coding Agent Index | 基准测试 | (+/-) | 在 DeepSWE、Terminal-Bench 和 SWE-Atlas-QnA 上提供清晰的等权重评分,同时展示每项任务成本 | 最大投入下的结果可能会偏向“更能吃 token”的系统;回复里也马上有人要求做同预算对比 |
| Claude Code + Claude Opus 5.5 | 编码代理 / 模型 | (+/-) | 当天公开指数得分最高;能很好遵循细致的技能流程和验证循环 | 单项任务成本更高,输出 token 消耗高得多,而且在一些自定义测试框架中会较早自行停止 |
| GPT-6-Sol / Codex | 编码代理 / 模型 | (+) | 在 leo_linsky 的自定义测试框架中表现接近前沿,在那里比 Anthropic 模型更快,也适合作为 Jev 后端的快速补丁执行器 | 这里的公开证据仍主要集中在基准测试和路由层面,而非完整的端到端部署细节 |
| JEV / System One | 决策层 | (+) | 类型化路由、权限闸门、动态工具/上下文选择,以及亚秒级决策声明,让自主性具备可审视性 | 审核通道仍可能主导延迟,而且某些浏览器用法在动态页面上可能不够稳健 |
| MCP outcome judge | 评估方法 | (+) | 评估交付给用户的实际价值,而不是原始工具调用成功率,并把失败回流到工程工作中 | 仍需要额外机制来捕捉“根本没调用到正确工具”的情况;判定器漂移也仍需抽样检查 |
| Forkable Linux VMs / goal engineering | 运行时 / 云沙箱 | (+/-) | 让多个代理从相同机器状态出发,并在数天内朝可度量目标推进 | 对大多数团队来说,经济性仍然不成立;而且可见测试集如果没有隐藏保留集,就可能被“刷分” |
| Hermes browser side panel | 浏览器代理 UI | (+) | 让代理留在用户当前已打开的页面中,并复用现有工具、记忆、技能与 MCP 服务器 | 过期状态和重试可能带来意外开销,并削弱信任 |
| Atomic Agent | 本地优先运行时 | (+) | 提供 Fusion 编排、本地/云回退、从 Claude Code 和 Codex 导入、MCP 支持以及显式审批 | 开发者预览版的产品形态仍在变化 |
| AgentFactory Business Plugins | 插件市场 / 企业技能 | (+) | 把金融、银行、法律和销售工作流封装成可安装的技能、命令、钩子和评测 | 生态仍处于早期,而且最强的集成叙事仍以 Claude Code / Cowork 为中心 |
| blender-game-skills | 创意技能仓库 | (+) | 通过 Blender 脚本和审查工件,把创意工作流变成可度量、可设门槛的技能 | 目前范围仍较窄,只有一个旗舰技能,而且工作流复杂度高 |
| TermiX / Agent Family | 代理市场 | (+/-) | 通过可下单、可观察的服务,把能力与时间具体化,而不是停留在抽象的“代理”概念上 | 信任仍依赖托管、验证和争议处理流程,而这些都还处于早期 |
| PrivateDAO Agent Exchange | 代理服务市场 | (+/-) | 借助 GitHub Marketplace、GitHub 集成、MCP 访问和可验证回执,提供熟悉的分发与证明载体 | 公开证据目前仍主要是发布信息,而不是独立的使用效果 |
| ROKHA | 技能路由 / 追踪层 | (+/-) | 将技能发现与隔离执行,以及执行过程追踪结合在一起 | 这份数据集中最具体的细节大多来自推广者的回复,而非链接到的公开规范 |
| AI video co-director | 创意编排 | (+) | 展示了一个具体的“编排器 + 判定器”模式,用于减少长视频生成中的视觉漂移 | 仍是研究阶段系统,而不是成熟稳定的生产栈 |
纵观整个技术栈,只要工具能缩小能力与问责之间的差距,满意度就会上升。开发者赞赏那些能暴露单项任务成本、类型化决策、明确审批边界或可验证追踪的工具;而当系统只宣称自己具备自主性、却不展示这些控制机制时,他们就会持怀疑态度。
最明显的变通模式,是在模型之外增加结构:验证循环、shadow 与 enforce 模式、只读或仅审批边界、克隆运行时,以及用技能封装替代巨大的通用提示词。迁移方向也比昨天更清晰:从通用代理转向更窄的技能和插件,从一次性的本地会话转向持久化的浏览器/本地/云运行时,以及从崇拜基准测试转向核算成本与价值。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| AI video co-director | Google Research | 通过编排前期制作、制作和后期制作代理,生成长篇视频叙事 | 减少长视频生成中的视觉漂移和流水线误差传播 | 多臂老虎机编排器、Gemini、Veo、关键帧/视频/音频代理、MLLM 判定器 | Alpha | 博客, 帖子 |
| MCP outcome judge | @rishigb | 为每个 MCP 结果按交付给用户的实际价值打分,并将失败转化为工程工作 | 防止团队只优化工具调用成功率,而用户结果依然糟糕 | 判定模型、MCP 追踪、人工通读的对话集、RCA 循环 | Shipped | 帖子 |
| Atomic Agent v0.6.5 | AtomicBot | 本地优先的代理运行时,具备 Fusion 编排、从 Claude Code/Codex 导入、回退到本地模型,以及远程审批功能 | 为用户提供可持续使用的个人运行时,在不失去控制的前提下混合使用本地和云模型 | TypeScript、Tauri sidecar、llama.cpp、MCP、Discord approvals | Beta | 仓库, 帖子 |
| AgentFactory Business Plugins | Panaversity | 将金融、银行、法律和销售工作流封装为面向企业代理的可安装插件 | 补足通用代理所缺乏的领域规则与工作流逻辑 | Claude plugins、skills、commands、hooks、evals | Beta | 仓库, 帖子 |
| blender-game-skills | @majidmanzarpour | 通过一个面向 Blender 的 Claude Code 技能,把参考图转成可用于游戏的 3D 资产 | 让复杂的创意资产工作流可重复、可审查 | Agent Skills、Claude Code、Blender scripts、Python/Pillow 审查工具链 | Alpha | 仓库, 帖子 |
| Hermes browser side panel | @witcheer | 在 Chromium 侧边栏中嵌入一个 Hermes Agent,同时由用户保持对当前标签页的控制 | 减少浏览器原生代理工作的上下文切换 | Chromium side panel、本地/自托管 gateway、skills、memory、MCP | Alpha | 帖子 |
| TermiX / Agent Family | @termix_ai | 销售可观察、时长受限的代理服务,例如实时游戏辅助 | 通过出售能力和时间,而不只是输出文件,让代理商业化变得具体可感 | 服务市场、报价任务、可见的控制器操作、结算流程 | Beta | 网站, 帖子 |
| PrivateDAO Agent Exchange | @privateDAOOS | 在 GitHub Marketplace 上架带有 MCP 访问和可验证回执的代理服务 | 为开发者提供一个熟悉的、可安装的代理服务分发渠道 | GitHub Marketplace、GitHub App、MCP, | 可验证回执 | 已上线 |
Google Research 的 AI 视频联合导演,是这组项目中架构最完整的一项构建。链接中的博客称,其编排器使用多臂老虎机算法来选择创意策略、叙事模式和审美原型,再将这些选择交给专门的智能体,分别负责分镜、关键帧、视频、音频以及后期审校。它与普通提示词链式调用的区别,在于存在一个显式的优化闭环:由 MLLM 评审模型对结果进行评判,并将奖励信号反馈回搜索过程。
规模较小的独立项目则在解决截然不同、但彼此互补的问题。@rishigb 转向了 将评估接入生产环境服务,在每次 MCP 结果后判断真实用户价值;而 Atomic Agent 和 Hermes 则聚焦于智能体运行在何处,以及当工作超出一次请求的范围时,用户如何继续保持控制权。这些项目有着相同的触发痛点:一个真正有用的智能体,需要持久化运行时和可信的控制界面,而不只是模型访问能力。
第二种反复出现的构建模式是封装。AgentFactory、blender-game-skills、TermiX 和 PrivateDAO 都在把更窄的能力打包成可安装或可订购的产品,而不是让一个通用智能体包办一切。这类构建背后的共同痛点,是工程落地:人们需要的是可以路由、审计、分发和复用的智能体,而不只是一次性提示调用。
6. 最新与值得关注的动态
Google 把多智能体视频生成做成了一套具体的生产栈
@GoogleResearch 宣布(539 次点赞,11 条回复,22,081 次浏览,432 次收藏)介绍了 AI 视频联合导演,将其定义为一个统一的多智能体框架,用于生成具备时间一致性的长视频。链接中的 Google Research 帖子 称,该系统使用多臂老虎机算法,在编排器、前期制作、制作和后期制作流水线中引导创意选择,并由 MLLM 评审模型将奖励信号反馈回闭环。这一点之所以重要,是因为它把多智能体的讨论从编码和应用市场,推进到了一个非常明确的创意生产工作流中。

一个生产级 MCP 评审让 eval 的讨论变得更具体
@rishigb 表示(18 次点赞,22 条回复,995 次浏览)表示,他的团队已将一个评审系统投入生产,对每次 MCP 结果按真实用户价值打分,并把失败转化为工程工作。值得注意的不只是这个评审本身,还有围绕它建立的证据标准:人工逐条阅读 1,000 段对话、明确关注遗漏的工具调用,以及持续进行抽样检查以监测漂移。
GitHub Marketplace 开始显现出智能体服务分发渠道的样子
@privateDAOOS 宣布(24 次点赞,4 条回复,986 次浏览)展示了 GitHub Marketplace 上的 PrivateDAO Agent Exchange 列表,其中包含 24 个已构建服务、GitHub 集成、MCP 访问和可验证回执。这一点值得关注,因为它让智能体分发更贴近开发者已经信任的软件安装入口,而不是从零开始另造一个独立生态。
智能体工程开始成为招聘和培训的新入口
@freeCodeCamp 推广(157 次点赞,9 条回复,7,387 次浏览,158 次收藏)介绍了一门时长 8 小时的 Claude Certified Developer Foundations 课程,涵盖智能体工作流、Claude API 与 SDK、MCP、工具使用和上下文工程。@Keanaalabre 发布(23 次点赞,8 条回复,1,409 次浏览)发布了一则招聘创始阶段 harness engineer 的信息,重点面向 AI 原生视频产品中的自我改进 AI 系统。两者合在一起,强烈表明市场如今已将 harness engineering 视为一种可教授、可招聘的专业化方向。
7. 机会在哪里
**+++] 智能体系统的结果与成本可观测性** — 证据来自 [@FundamentEdge's 帖子、@ArtificialAnlys 的帖子、@leo_linsky 的帖子 和 @davidneckstein 的帖子 都指向了同一个缺口:在智能体工作流能够在大规模场景下值得信任之前,团队需要按任务计成本的核算、基于结果的评估,以及独立验证。
**+++] 审批与追认基础设施** — 证据来自 [@coreyganim's 帖子、@elune0x 的帖子、@atomicagent_io 的帖子、以及 @neviannn 的帖子 都暴露出同一个瓶颈:生成很便宜,但仍然必须有人来决定,什么可以越过高风险或持久性边界。
[++] 带执行回执的技能与插件市场 —— AgentFactory、blender-game-skills、ROKHA、PrivateDAO 和 TermiX 都显示出对可安装或可下单能力的需求,但讨论始终绕回到“证明”上:隔离执行、执行轨迹、回执、争议处理,以及围绕技能本身的权利。
[++] 持久化运行时控制平面 —— 类似 Freestyle 的克隆 VM、浏览器中的 Hermes,以及 Atomic Agent 的本地优先运行时,都指向了一个机会:围绕那些能在休眠后继续运行、分叉任务、安全恢复,并且在执行过程中始终可审查的智能体。
[+] 面向创意生产的多智能体工具 —— Google 的 AI 视频联合导演、某 AI 原生视频产品的 harness 工程师岗位,以及 Blender 技能相关工作,都表明,围绕媒体流程正在出现一个新市场:在这里,编排、审查和交接比单次模型调用更重要。
8. 要点
- 如今,harness 工作正以美元、credits 和完成任务数来衡量。 当天最有力的证据来自 Artificial Analysis 的每任务 $13.04 成本图表、FundementEdge 对六位数工作流成本的警告,以及 Legora 关于通过调整 harness 和路由实现 20%+ credit 节省的报告。(来源, 来源, 来源)
- 类型化决策层正从宣言走向可复制的实现模式。 Monokern 的仓库清单、neviannn 对 JEV/System One 的总结、elune0x 的 Claude Code/Codex switchboard,以及 0x_rody 的目录,都把 JEV 视为一种集成方案,而不是一套理论。(来源, 来源, 来源, 来源)
- 人工审批正成为主要的运营瓶颈。 Corey Ganim 的 ratification queue、Atomic Agent 的远程审批,以及 JEV 配置中的审查边界逻辑,都说明了同一件事:自主性的发展速度正在超过信任建立的速度。(来源, 来源, 来源) 4.技能和插件正成为代理分发的基本单位。 AgentFactory 的商业插件、Majid 的 Blender 技能、PrivateDAO 在 GitHub Marketplace 上线,以及 ROKHA 以追踪为核心的技能路由,都在打包更窄、更专门的能力,而不是押注于单一的巨型通用代理。(来源、来源、来源、来源)
- 代理系统正同时向两个相反方向扩展:一边进入长期运行的运行时环境,一边进入专业化的创意工作流。 Davj 的可分叉云端 VM、Hermes 的浏览器面板、Atomic Agent 的本地优先运行时,以及 Google 的 AI 视频协同导演,都表明代理正在超越单次、短暂的聊天循环,进入持久环境和特定领域的生产栈。(来源、来源、来源、来源)