Twitter AI 代理 - 2026-09-26
1. 大家在讨论什么
1.1 Harness 工程正在变成日常运营策略 (🡕)
2026-09-26 最大的讨论,不是哪家前沿模型又赢了某个基准测试,而是人们究竟如何实际运行代理:什么时候该多花些 effort,什么时候该让人类留在环路中,怎样把纠错结果跨运行保留下来,以及哪种 harness 能让同一个模型表现得更好。至少有六条高信号内容支撑了这一主题,涵盖产品解读、从业者评测和可复用的工作流模式。
@trq212 表示(2,540 次点赞、150 条回复、242,048 次浏览、3,624 次收藏)指出,effort 应被视为调节独立性与验证强度的控制旋钮,而不是简单的质量滑杆。他随后还关联了 Anthropic 的 《投入你的精力》 文章,其中把这条操作规则说得很明确:低 effort 用于快速迭代,更高 effort 用于验证、排查边缘案例,以及一次性自主执行。回复则进一步补充了成本纪律,比如有人比较后指出,Opus 5.5 medium 的基准成绩与 Opus 5 max 大致相当,但成本要低得多。
@thdxr 表示(1,596 次点赞、50 条回复、99,597 次浏览、587 次收藏)表示,一个强结果“只在 opencode 里成立”,因为真正拉开差距的是 harness,而不是底层模型。最有价值的回复不是表态站队,而是具体信息:OpenCode 2.5 正在移除 plan mode,更彻底地转向 Jev 风格控制,并且已经支持浏览器,只是这一点还需要更好的呈现方式。
@mattpocockuk 表示(511 次点赞、60 条回复、28,951 次浏览、528 次收藏)认为,CODING_STANDARDS.md 不该再只是静态的初始化产物,而应不断记录每一次有意义的代理失败。这个想法的独特之处在于它强调流程而非架构:使用 /retro 或手动编辑,把反复出现的失误沉淀为持久、可版本化的规则,这样下一次运行继承的是修正结果,而不是从头再学一遍。
@Da7_Tech 报道称(127 次点赞、45 条回复、9,021 次浏览、49 次收藏)在使用 Droid 两个月后表示,harness 与模型阵容同样重要:分开的使用池让长会话得以持续,约 5.85 亿 token 的缓存效率维持在 94% 左右,而且同样的模型在 Droid 里比在其他 shell 中显得更守规矩。关联的 Factory 概览 和 Droids 产品页面 进一步强化了这一定位:它们将 Droid 描述为一个面向代理原生的软件开发平台,覆盖 CLI、桌面、浏览器、Slack、Teams、Jira、Linear 和 CI。
讨论洞察: 最有力的回复都把代理质量视为一个运营策略问题。大家反复回到几个问题:工作流应允许多少无人监督的动作,harness 是否能跨会话保留修正,以及当 effort、voice 或审核边界设置不当时,一次运行会以多快的速度开始浪费预算。
与前一天相比: 在 2026-09-25,harness 工程已经是一种控制平面纪律。到了 2026-09-26,讨论又更贴近实际操作:effort 预设、持久化标准文件、配额设计,以及用户真正感受到的差异来自 harness 而不是模型这一直接判断。
1.2 类型化决策层开始出现具体的预算测算 (🡕)
第二个讨论簇聚焦于 Jev/System One 风格控制器,以及把边界清晰的决策从主推理模型中移出的极简框架。相比前一天更宽泛的路由讨论,今天的帖子更数字化,也更偏战术:有匹配循环对比、错误工具循环的修复,以及由论文支撑的论点,说明一个最小控制器可以替代哪些东西。
@omarsar0 报道称(59 次点赞、24 条回复、4,473 次浏览、77 次收藏)称,MIT CSAIL 的 JAZ 框架只使用一种原语 invoke,却依然能在 StuLife 中偏重召回的那部分任务上,以一半成本领先 Letta 8%,并在 AppWorld 上以更低成本领先 ACE 4%。附带的论文页面之所以重要,是因为它以证据形式呈现论点——摘要加对比图表——而不是又一个手绘的代理栈。
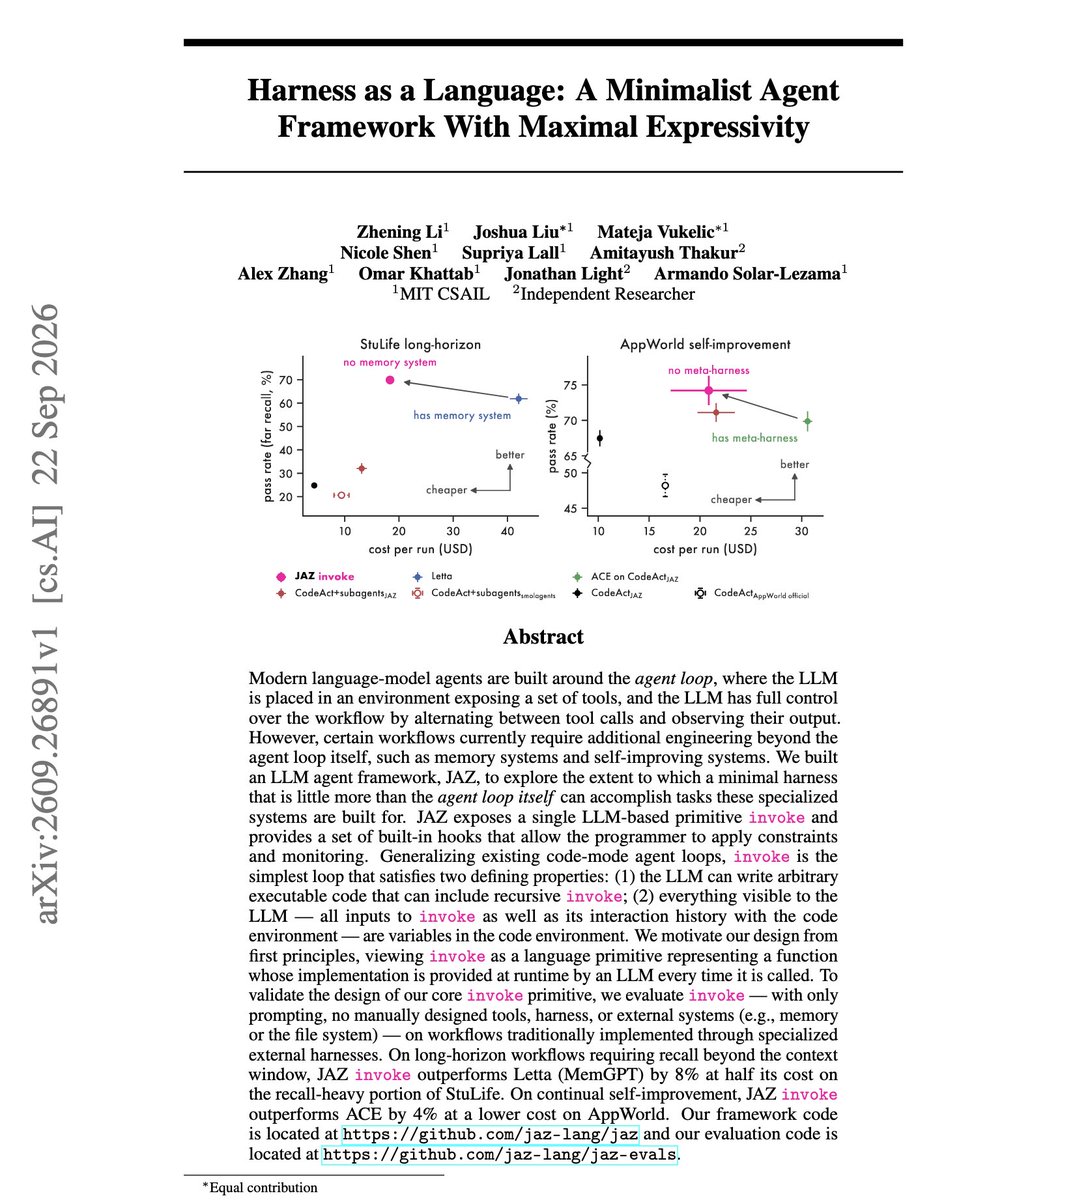
@omarsar0 表示(50 次点赞、15 条回复、7,820 次浏览、55 次收藏)表示,DSPy 3.4.0 对 Jev 的支持,让廉价的 System One 模型在 guardrails、路由、验证器、技能结构化以及动态多代理工作流中变得实用。回复部分才是重点:构建者们表示,阈值是产品决策,不是基准测试里的琐碎细节,因为写路径中的一次误报,与读路径中的一次误报,代价完全不同。@0xRicker 表示(56 次点赞、15 条回复、3,602 次浏览、32 次收藏)称,同样的 18 轮智能体循环,只替换决策层后,仍达到了相同的 0.93 目标得分,但决策开销从 473,000 个 Astra tokens($4.73)降到了 43 次 Jev typed decisions($0.0199)。这是这组数据里“每次分叉成本”最清晰的案例之一:同样的工作、同样的结果,但控制成本大幅下降。
@choopyplug1 解释道(10 次点赞、5 条回复、147 次浏览、8 次收藏)提出了一套五步方法,用来在“错误工具循环”烧掉前沿模型开销之前就将其扼杀:绝不要让主模型从一长串工具列表中自由挑选;让 Jev 只给出一个有效选择或 none;每一步都重建列表;基于置信度设置执行门槛;并明确打断反复失败的循环。
讨论洞察: 热情之外也伴随着明确的警告。回复主要质疑基线比较是否公平、重试是否被如实计入,以及副作用问题:只有在对比中诚实统计失败调用,而且系统对有状态操作仍有一套安全方案时,极简控制器看起来便宜才算站得住脚。
与前一天相比: 在 2026-09-25,Jev/System One 还是 harness 中一个有用的组件。到了 2026-09-26,讨论变得更尖锐,也更具实证性,重点转向阈值、错误工具循环和单次决策开销。
1.3 智能体商业讨论收敛到身份、验证与供给质量(🡒)
关于智能体商业的讨论依然活跃,但重心已从泛泛的“智能体雇佣智能体”式兴奋,转向真正决定市场是否可用的机制:交付后的声誉、与钱包绑定的身份、评估者角色,以及经过验证的供给是否足够充足、足以产生实际意义。至少有五条被引用的内容支撑了这一主题。
@elenalin01 表示(58 次点赞、50 条回复、2,188 次浏览、22 次收藏)称,TermiX 的差异化之处不在于匹配本身,而在于任务完成后的闭环:发现、竞标、工作、验证、结算、建立声誉。她的观点是,已完成的工作会转化为可验证的履历,并应影响下一份工作,从而让一个市场演变成自主劳动者的声誉层。
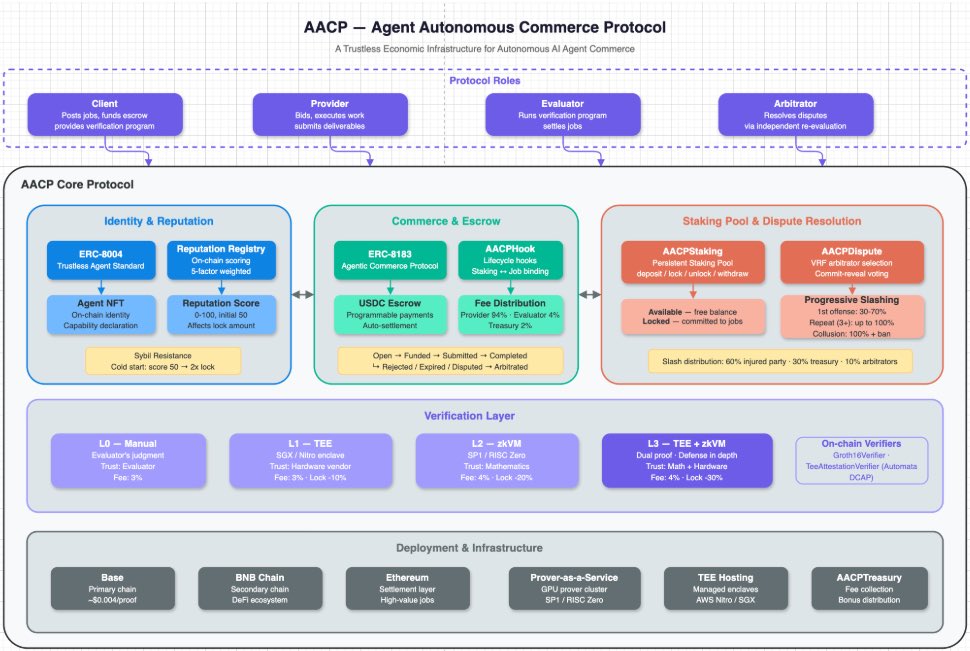
@RifdahSR_11 表示(111 次点赞、113 条回复、2,504 次浏览)称,ERC-8004 风格的身份之所以重要,是因为工作历史归属于钱包,而不是某个单一 marketplace 上的中心化个人资料。她引用的帖子还补上了这套论点的另一半:如果买方和提供方发生分歧,AACP 会通过 evaluator panels、激励机制和进一步仲裁来处理争议,而不是假装“顺利路径”就已经足够。
@Navtq0808 梳理了(21 次点赞、12 条回复、228 次浏览、2 次收藏)将 AACP 工作流拆解为明确角色——client、provider、evaluator、arbitrator——以及从身份和托管开始,经过执行、验证、结算到声誉的操作顺序。随附的架构图之所以重要,在于它把这些角色和层次清晰地汇集到了一处。
@heisChapman 表示(33 次点赞、29 条回复、369 次浏览)称,TermiX 更有意思的部分不是 marketplace 页面,而是可移植的技能:Claude Code、Codex、Cursor、Gemini CLI 和 OpenClaw 都可以使用同一套工作流包来发布请求、为订单注资、签署交易、处理收件箱和管理争议。
@0xfrigg 报道称(27 次点赞、30 条回复、1,456 次浏览)给出了一个更严峻的市场信号:在 TermiX 打开已验证筛选器后,只出现了四个在线服务,而且没有一个匹配该研究任务;而更早之前发布的一项公开请求也无人接单。这是一条有价值的反证,因为它检验的是,这套基础设施背后是否真的有足够的真实供给作为支撑。
讨论洞察: 回复中的焦虑多于庆祝。人们担心智能体会美化履历、合谋制造工作历史,也担心一个协议可能在纸面上看起来完整,却依然无法产出足够多值得信任、匹配度高的供给。
与前一天相比: 在 2026-09-25,商业讨论扩展到了实时付费服务和以物易物式经济实验。到了 2026-09-26,讨论变得更窄,也更偏基础设施:身份、评估者、争议处理,以及经过验证的服务提供者稀缺。
1.4 多模态智能体产品变得更可编辑,也更可调用(🡕)
第四个主题聚焦于产品层,而非模型能力:能说话、能接电话、能实时调用工具,并能以人类仍可编辑的形式交还输出的智能体。时间线上充满的是可复用组件,而不是一次性演示——语音框架、幻灯片运行时,以及 HTML 转视频工具。@Saboo_Shubham_ 展示了(107 个赞,22 条回复,7,891 次浏览,161 次收藏)一个开源的保险理赔语音代理,能一边通话,一边通过摄像头检查损伤情况,并在对话持续进行时绘制事故示意图。链接中的 仓库 记录了一个由 Gemini 3.8 Live + Gemini 3.8 Flash + Gemini 3.1 Flash-Image 组成的技术栈,以及供人工审核的数据包生成流程。
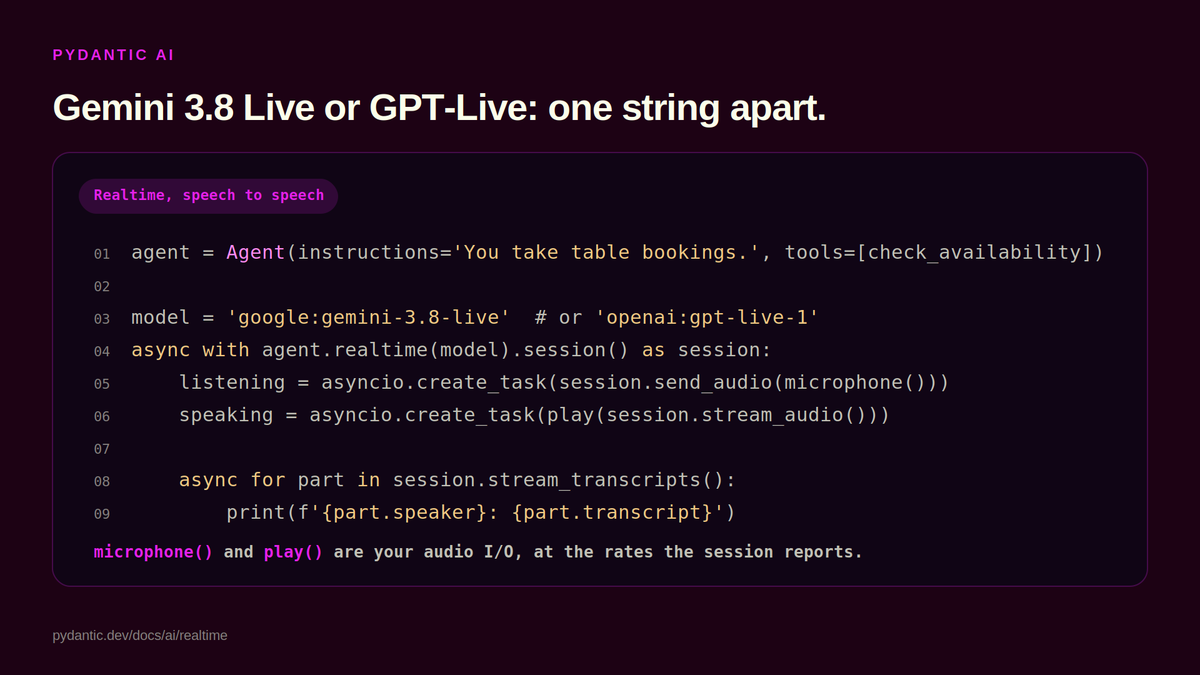
@pydantic 宣布(18 个赞,4 条回复,761 次浏览,6 次收藏)Pydantic AI agents 现在可以在 Gemini 3.8 Live 和 GPT-Live 上进行实时语音对话,同时仍能在通话过程中调用常规工具。公开的 实时概览 更有力地说明了这一点:实时语音被视为同一种 agent session model,而不是单独搭建的一套演示栈。
@Musecases 表示(56 个赞,9 条回复,7,203 次浏览,27 次收藏)面向消费者的代理下一场留存之战,不在于文本更聪明,而在于用户是否真的愿意接起代理打来的电话。回复很快把这个问题转成了系统层面的讨论:如果对话带有真实历史记录和口型同步视频,延迟还能否足够低,让这种体验依然像是“可以直接打电话”的服务?
@1weiho 发布了(165 个赞,8 条回复,9,024 次浏览,217 次收藏)open-slide 2.0,一个 为智能体构建的幻灯片框架,配有可视化编辑器、可编辑的 PPTX 导出功能,以及用于最终人工修改的画布内编辑。这个帖子里最值得注意的细节并不是“AI 制作幻灯片”,而是导出的演示文稿依然可以编辑,不会把用户困在反复重新生成的循环里。
@0x0SojalSec 分享了(11 个赞,919 次浏览,11 次收藏)HeyGen 的开源 HyperFrames,可通过 agent skills 将 HTML、CSS、媒体素材和可定位播放的动画转换为确定性的 MP4 视频。这意味着,视频也成了代理可以通过代码产出的另一类工件,而不必依赖不透明、只能通过 UI 操作的工具。
讨论洞察: 有价值的回复关注的不是惊艳感,而是边界条件:配额耗尽后语音是否仍然可用、随着上下文增长实时会话能否保持响应,以及代理结束后生成的工件是否仍然可编辑。
与前一天的对比: 2026-09-25 的个人代理讨论聚焦于主动效用和可见记忆;到 2026-09-26,讨论已转向人们可以呼叫、编辑并交接的具体产品界面。
2. 什么让人沮丧
effort 和 autonomy 仍然很容易用过头
严重性:高。@trq212 表示(2,540 个赞,150 条回复,242,048 次浏览,3,624 次收藏)认为,如果把 effort 当作品质旋钮,而不是算力与独立性预算,人们就会误用它;他在链接文章中建议先用低 effort 完成实现,再用高 effort 做验证,而不是默认直接拉满。@Da7_Tech 报道称(127 个赞,45 条回复,9,021 次浏览,49 次收藏)表示,Droid 的分离式使用池让重度使用变得还能承受,但他仍希望有真正的 goal mode、更能容忍长时间思考的能力,以及在主配额耗尽后仍可使用的语音输入。@0xRicker 表示(56 个赞,15 条回复,3,602 次浏览,32 次收藏)指出,即使底层代理的工作内容和最终得分完全相同,光是决策开销就可能带来 238 倍的成本波动。
当前最主要的应对模式,是把一次运行拆成不同模式:采访或起草阶段使用低 effort,验证阶段使用高 effort,并把更多边界清晰的决策交给更便宜的 typed controllers。令人沮丧的不只是模型价格,更在于错误的 autonomy 设置会把一个优秀模型变成一个昂贵、又缺乏监督的同事。值得为此做产品吗? 是。这直指成本可预测性、无人值守执行和配额设计上的运营痛点。
误用工具的循环和隐藏状态仍在浪费前沿模型的 token
严重性:高。@choopyplug1 解释道(10 个赞,5 条回复,147 次浏览,8 次收藏)指出,同一类失败仍在反复出现:模型选错工具,重试,再重试,在有人介入之前持续烧掉昂贵的 token。他给出的做法——把选择范围限制在有效工具名内、每一步都重建工具列表、按置信度设门槛,并明确终止重复失败的循环——本质上是在为一个大家显然早已意识到的问题打补丁。@mattpocockuk 表示(511 个赞,60 条回复,28,951 次浏览,528 次收藏)表示,一个务实的应对方式是把每一次有意义的失败都记录到 CODING_STANDARDS.md 里,否则智能体在新的运行中还会继续犯同样的错。
对 @omarsar0 的 JAZ 帖子(59 个赞,24 条回复,4,473 次浏览,77 次收藏)的回复则进一步点出了同一问题更隐蔽的一面:一旦涉及副作用、重试和陈旧状态,看似简单的循环也会变得危险。人们现在靠类型化决策、规则文件以及更明确的重放规范来应对,因为默认行为仍会制造代价高昂的混乱。
值得为此做产品吗? 是。浪费的支出显而易见,失败模式一再复现,而各种权宜之计的负担仍然很高。
智能体市场仍缺乏可信且有流动性的供给
严重性:中到高。@elenalin01 表示(58 个赞,50 条回复,2,188 次浏览,22 次收藏)表示,交付后的信誉才是真正的差异化因素,但回复立刻暴露出最令人担心的情况:智能体夸大履历,或串通伪造工作记录。@RifdahSR_11 表示(111 个赞,113 条回复,2,504 次浏览)称,需要可迁移、与钱包绑定的身份体系和预设的争议处理路径,因为买方和服务提供方并不总能达成一致。@0xfrigg 报道称(27 个赞,30 条回复,1,456 次浏览)则指出了一个更基础的痛点:已验证筛选只显示了 4 个仍在提供的服务,没有一个适合这项工作,而此前一条公开请求也一直没有完成。
如今的应对方式相当笨拙。用户要么把搜索范围扩大到已验证列表之外,要么发布公开请求后等待,要么依赖那些承诺托管和仲裁的协议流程图——但在可信供给尚未充足到足以让整个流程显得可靠之前,这些都还只是承诺。架构演进的速度,已经快于真实市场深度的增长。
值得为此做产品吗? 是。信任和流动性都还缺失,这就为那些能同时提升匹配、验证和服务商质量的产品留下了空间。
实时语音很有价值,但在系统边界上仍会失灵
严重性:中。@Da7_Tech 抱怨道(127 个赞,45 条回复,9,021 次浏览,49 次收藏)表示,Droid 的语音输入是他工作流的核心,但一旦主要使用额度耗尽,这项功能就会消失,迫使他转向另一套独立的转写工具链。@Musecases 表示(56 个赞,9 条回复,7,203 次浏览,27 次收藏)称,最终胜出的消费级智能体会是那个用户真心愿意打电话给它的产品,但回复随即质疑:一旦对话累积了真实历史,延迟是否还能维持住。随后在另一篇帖子中,@Musecases 报道称(26 个赞,6 条回复,1,491 次浏览,6 次收藏)表示,像 Spotify 这样的原生集成仍然不够顺畅。
即便是那些更令人惊艳的演示,也正在边界条件下接受检验。对 @Saboo_Shubham_(107 次点赞、22 条回复、7,891 次浏览、161 次收藏)的回复提出了一个问题:在移动数据网络较弱时,这个保险理赔头像是否会卡顿。如今真正令人沮丧的,已经不是语音代理还能不能实现,而是当人们真的把它当产品使用时,它是否还能保持快速、稳定可用,并顺畅完成集成。
值得为之构建吗? 值得。它的价值主张很清晰,但可靠性这一层依然脆弱。
3. 人们希望看到什么
能自动为你选择投入程度、路由和验证方式的控制平面
这是一个迫切且现实的需求。@trq212 认为(2,540 次点赞、150 条回复、242,048 次浏览、3,624 次收藏)指出,只有当人们知道什么时候该让人类参与、什么时候该让模型独立验证时,投入程度才有意义;而 @0xRicker 表明了(56 次点赞、15 条回复、3,602 次浏览、32 次收藏)则说明,在同一个底层任务上,错误的决策层可能浪费多少资金。@choopyplug1 补充说(10 次点赞、5 条回复、147 次浏览、8 次收藏)表明,人们现在希望有一个控制器,知道什么时候根本不该调用工具。
人们想要的似乎不是又一篇基准测试文章,而是一个系统:它能围绕眼前的任务,以恰当的自主程度进行访谈、起草、验证、升级处理,并在该停止时停止。
机会:直接。
适用于跨市场代理的可携带身份、托管和争议处理机制
这是一个有反复证据支撑的现实需求。@RifdahSR_11 认为(111 次点赞、113 条回复、2,504 次浏览)指出,代理身份应归属于钱包,这样工作历史才能在不同市场间迁移;而 @Navtq0808 梳理了(21 次点赞、12 条回复、228 次浏览、2 次收藏)则说明了这一流程底层所需的协议角色。@elenalin01 制作了(58 次点赞、50 条回复、2,188 次浏览、22 次收藏)从声誉角度也体现出同样的需求:交付成果出现时,工作并没有结束;结果还需要更新下一次谁会被雇用。
这一需求是现实的,不是哲学层面的。如果代理要在不同平台之间进行交易,就必须有人来承载身份、托管资金、裁决争议,并以一种能跨越平台边界持续存在的方式记录结果。
机会:直接。
代理完成后仍可继续编辑的生成产物
这是一个现实且高度可产品化的需求。@1weiho 发布了(165 次点赞、8 条回复、9,024 次浏览、217 次收藏)推出了带可视化编辑器和可编辑 PPTX 导出的 open-slide 2.0,就是为了让用户先让代理起草演示文稿,再由自己手动完成最后的润色。@0x0SojalSec 分享了(11 次点赞、919 次浏览、11 次收藏)提出 HyperFrames,作为面向编程代理的确定性 HTML-to-MP4 层,解决的是同样的问题,只不过对象从幻灯片变成了视频。
共同的诉求很简单:用户不想为了修正一页幻灯片、一条字幕或一次版式选择,就把整个产物重新生成一遍。他们想要的是一种输出格式:代理可以创建,人类仍能精细修改。
机会:竞争。
像电话系统一样可靠,而不是只够演示的语音代理
这种需求同时包含务实层面和情绪层面的诉求。@Musecases 认为(56 个赞,9 条回复,7,203 次浏览,27 次收藏)表示,下一项留存测试在于用户是否真的愿意给自己的代理打电话;而回复则把焦点集中在会话积累起真实历史后出现的延迟问题上。@pydantic 表明了(18 个赞,4 条回复,761 次浏览,6 次收藏)表示,框架层正在补上这类需求;与此同时,@Saboo_Shubham_(107 个赞,22 条回复,7,891 次浏览,161 次收藏)展示了一个更有野心的多模态理赔工作流,@Da7_Tech(127 个赞,45 条回复,9,021 次浏览,49 次收藏)则强调了当语音受配额限制时,系统仍会在哪些环节失灵。
人们似乎已经准备好接受语音代理,但前提是它们必须始终够快、记得住足够多的信息,并且能接入电话、邮件或媒体服务等真实系统,而不是一退化就变成靠手工拼接维持的流程。
机会:直接。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪倾向 | 优势 | 局限 |
|---|---|---|---|---|
| Claude Code effort levels | 执行框架设置 | (+/-) | 让团队能按任务在速度、自主性和验证深度之间做取舍 | 很容易被误用成通用质量旋钮;更高设置会很快消耗大量 token |
| OpenCode / Opencode 2.5 | 编码执行框架 | (+) | 普遍认为其执行框架、浏览器支持和 Jev 风格控制能显著改善结果 | 产品能力面变化很快;围绕内建能力的 UX 仍需改进 |
CODING_STANDARDS.md + /retro |
工作流记忆 | (+) | 能把代理反复犯的错误转成持久、可审查的规则 | 需要人工整理,并与其他文档规范明确分开 |
| Jev / System One / jev-mcp | 决策模型 / 控制层 | (+) | 低成本的类型化决策、置信度门控、路由、验证器支持,以及更低的误用工具开销 | 阈值调优很难;过期的工具列表和副作用仍可能打断闭环 |
| DSPy 3.4 + ReAnchor | 代理框架 | (+/-) | 原生支持 Jev,并提供用于路由与评估的校准置信度 | 误报和阈值策略会因任务而异,尤其是在写入路径上 |
| Droid / Factory | 代理平台 | (+/-) | 多池配额、长会话、模型无关的行为、强缓存利用,以及成熟的桌面 UX | 达到配额上限后语音会关闭;记忆能力较弱;长时间推理突发可能被误判为卡顿 |
| Yang | 集成软件工厂 | (+) | 持久会话、由遥测驱动的修复闭环、机器人优先的 PR 审查,以及明确的合并后验证 | 仍然需要人工批准;更适合大型集成/工具包维护工作流 |
| open-slide 2.0 | 幻灯片运行时 | (+) | 可视化编辑器、可编辑的 PPTX 导出、基于 React 的演示文稿,以及原生面向代理的创作方式 | 聚焦范围较窄,只覆盖幻灯片输出;仍需要单独的人类收尾 |
| Pydantic AI realtime | 语音框架 | (+) | 提供可跨供应商移植的 speech-to-speech 会话,支持工具调用、共享历史和部署文档 | 音频传输以及浏览器/电话系统集成仍会增加工程复杂度 |
| HyperFrames | 媒体/视频框架 | (+) | 可确定性地将 HTML 渲染为 MP4、可复用的代理技能,以及代码优先的媒体工作流 | 对 Node 22 的要求以及技能路由复杂度抬高了上手门槛 |
| TermiX / AACP | 市场 + 协议 | (+/-) | 身份、托管、验证、争议处理角色和可移植技能,指向了更丰富的代理商业形态 | 已验证的供给仍然稀缺;声誉与串谋问题依旧未解 |
满意度最高的,往往是那些把控制显式化,或让产物保持可编辑的产品。人们喜欢这样的系统:把 effort 作为一种策略选择公开出来,把工具路由变成类型化决策,或者最终留下一个人类仍能检查和修改的幻灯片、视频合成结果或理赔材料包。
最常见的变通模式是两阶段运行:先进行低成本或低 effort 的生成,再切换到另一种模式做验证或审批。在商业场景里,这种变通甚至更粗糙——扩大搜索范围、发布开放请求,或者在等待供给侧赶上来时,先依赖协议层面的承诺。
迁移趋势也很清晰。构建者正在从单一界面的聊天工具转向执行框架、持久化运行时和类型化控制器;从冻结的生成产物转向可编辑输出;也从市场演示转向能够在出现分歧时依然维持运转的身份与结算基础设施。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| Yang | Composio / @KaranVaidya6 | 一个构建并修复面向代理的 API 工具包的软件工厂 | 在提供方不断调整文档、权限范围、速率限制和载荷时,保持集成可用 | OpenCode、临时沙箱、Postgres 持久会话、ClickHouse 遥测、机器人优先的 PR 审查 | 已发布 | 推文, 博客 |
| open-slide 2.0 | Yiwei Ho / @1weiho | 一个带可视化编辑器和可编辑 PPTX 导出的原生代理幻灯片框架 | 让代理起草演示文稿,同时人类无需重来即可做精确的最终修改 | React、@open-slide/cli、浏览器检查器、HTML/PDF/PPTX 导出 |
已发布 | 推文, 仓库 |
| Insurance Claim Live Agent Team | Shubham Saboo / @Saboo_Shubham_ | 一个用于理赔受理的多模态代理,能对话、查看损坏情况、绘制事故草图并准备材料包 | 在保留可供人工审查的证据包的同时,加快理赔受理速度 | Gemini 3.8 Live、Gemini 3.8 Flash、Gemini 3.1 Flash-Image、FastAPI/Uvicorn、JS 客户端 | Alpha | 推文, 仓库 |
| HyperFrames | HeyGen | 一个原生面向代理的框架,可将 HTML、CSS、媒体和动画转换为 MP4 视频 | 为编码代理提供一个可确定、代码优先的视频输出层 | Node 22+、CLI、按需技能、HTML/CSS/媒体渲染器 | Beta | 推文,仓库, 文档 |
| MiMo-V2.6 RL 环境 | Xiaomi MiMo | 面向多模态、可调用工具模型的公开 RL 代码和智能体训练环境 | 为研究者提供可执行的学习环境与轨迹,而不只是开放权重 | 多模态 MoE 模型、RL 代码、多任务环境、测试框架、大规模轨迹训练 | 已发布 | 推文, 发布 |
| TermiX Agent Skills / AACP | TermiX | 用于智能体到智能体协作的可移植市场技能与协议 | 为自主商业处理身份、托管、签名、收件箱、验证和争议 | 可移植技能、AACP、钱包认证/签名、链上托管、声誉注册表 | 测试版 | 推文, 网站, 市场 |
Yang 是这组数据中最清晰的生产落地信号。其公开博客对何谓“完成”给出了异常具体的标准:由 Postgres 支撑的持久会话、临时沙盒、自动化审查机器人、人工合并审批,以及部署后的七天生产观察期。此前 24 小时内,已有 900 多个修复类 PR 被合并,并运行了 726 个沙盒;这使 Yang 的特别之处在于,它提供的是运营层面的证据,而不只是架构层面的品牌包装。
open-slide 2.0 和 HyperFrames 从两种相反的媒介方向指向了同一种构建模式:真正有价值的,不是智能体能生成幻灯片或视频,而是产出结果在事后依然可检查、可编辑。open-slide 会留下 React 幻灯片和可编辑的 PPTX,而 HyperFrames 则把视频变成确定性的 HTML/CSS/媒体构建产物,而不是黑盒式导出。
Insurance Claim Live Agent Team 展示了多模态工作流已经在多大程度上超越了简单的语音演示。该代码仓库公开了一个完整的操作闭环——对话、摄像头证据、草图、保单查询和材料包生成——而推文演示还补充了一个很实务的细节:实时会话可以切换到印地语,且不会打断流程。
MiMo-V2.6 之所以重要,是因为它开源的是学习底层基础,而不只是一个检查点。Xiaomi 的发布从环境、轨迹、奖励基础设施,以及在长程软件基准上的样本外收益来界定其价值,这正是其他智能体构建者可以复用的那类成果。
TermiX Agent Skills / AACP 值得注意之处在于,它把商业工作流封装成一种可移植技能,而不是某个单一站点的集成。同一天的市场测试给出的提醒是:协议能力的丰富化到来得比经过验证的供给更快,因此这种构建模式很有前景,即便市场本身目前仍显得单薄。
6. 新的值得关注的动态
6.1 Xiaomi 让开放 RL 基础设施更难被忽视
@akshay_pachaar 认为(63 个赞、11 条回复、6,556 次浏览、61 次收藏)表示,Xiaomi 的 MiMo 发布之所以重要,与其说在权重,不如说在环境。公开的 MiMo-V2.6 发布 也印证了这一点:它强调开放的 RL 代码、多任务环境、跨 30 个步骤的 750,000 条轨迹,以及明确披露的训练系统细节,而不只是基准测试截图。

6.2 Yang 公布的是软件工厂的运营数据,而不是只做演示的感觉
@KaranVaidya6 链接到(38 次点赞、4 条回复、2,612 次浏览、38 次收藏)发布了一篇软件工厂博客,给出了大多数团队都会藏起来的那类数字:已合并超过 900 个修复 PR、过去 24 小时内运行了 726 个沙箱,以及部署后的 7 天生产观察期。这很重要,因为它表明,由 agent 维护的集成系统正在成为可衡量的运营体系,而不只是内部演示。
6.3 实时语音正在成为框架级原语
@pydantic 宣布了 提供了一种可跨 provider 迁移的方式,用来运行能在对话中途调用工具的 speech-to-speech agent(18 次点赞、4 条回复、761 次浏览、6 次收藏)。真正让它值得关注的是链接中的 文档:实时会话与文本 agent 共享同一套工具、依赖、历史记录和可观测性,而且同一条代码路径可以面向 OpenAI、Azure、Gemini、xAI 和 GPT-Live 变体。
6.4 可编辑输出层正在成为一个独立品类
@1weiho 发布了 发布了 open-slide 2.0,带有可视化编辑器和可编辑的 PPTX 导出;而 @0x0SojalSec 分享了(11 次点赞、919 次浏览、11 次收藏)则将 HyperFrames 作为面向 coding agents 的确定性 HTML-to-MP4 层推出(165 次点赞、8 条回复、9,024 次浏览、217 次收藏)。合起来看,它们暗示着围绕 agent 创作媒体的一个新产品层正在出现:不只是生成内容,而是生成人类仍可检查、编辑并发布的资产。
7. 机会在哪里
**+++] 关于投入、路由和验证的控制平面** —— 来自 [@trq212 帖子的证据、@omarsar0 的 JAZ 帖子、@0xRicker 的帖子 和 @choopyplug1 的帖子 都指向同一个缺口:团队需要的是这样一种软件,能决定何时保持低成本、何时加大验证力度、何时调用工具,以及何时停止。这一点之所以有吸引力,是因为它同时触及成本、信任和吞吐量。
**+++] 面向 agent 的 API 集成维护工厂**——证据来自 [@KaranVaidya6 的帖子 以及链接中的 Yang 的工程技术写作 展示了一个非常具体的运营痛点:provider 漂移持续破坏 agent 工具链,而要修复这一点,需要持久会话、修复循环、遥测,以及合并后的持续观察。这一点之所以有吸引力,是因为这种痛点会反复出现、清晰可辨,而且在不断扩大的工具生态里已经有现成预算。
**++] 面向 agent 市场的信任与流动性通道**——证据来自 [@elenalin01 的帖子、@RifdahSR_11 的帖子、@Navtq0808 的帖子、而 @0xfrigg 的帖子 表明,市场对可移植身份、托管、争议处理和更优匹配存在需求,但也暴露出经验证的供给仍然稀薄。之所以判断为中等,是因为这一架构很有吸引力,但市场深度仍不成熟。
**++] 用于 agent 创作媒体的可编辑输出运行时**——证据来自 [@1weiho 的帖子 和 @0x0SojalSec 的帖子 表明,围绕“由代理生成、但仍可由人类编辑”的输出,正出现产品机会。之所以判断为中等,是因为这一需求显而易见,也已得到部分验证,但这一品类仍处于早期。
**+] 具备真实产品边界的实时语音基础设施**——证据来自 [@pydantic 的帖子、@Saboo_Shubham_ 的帖子、@Musecases 的帖子 和 @Da7_Tech 的帖子 指向一个正在形成的机会,涉及电话能力、低延迟会话记忆、配额设计,以及实时对话中的工具使用。之所以判断为新兴,是因为演示效果很强,但可靠性层仍然薄弱。
8. 要点
- 编排框架设计在整体时间线中比模型层面的“炫耀资本”更占主导。 最有价值的帖子讨论的是 effort 设置、持久规则、配额设计和 shell 行为,而不是某一次单独的新模型发布。(来源、来源、来源、来源)
- Jev/System One 的讨论变得更具量化色彩。 构建者不再只是说“使用快速决策层”;他们开始贴出有论文支撑的对比、阈值权衡、错误工具循环的处理方案,以及 238x 的决策成本差异。(来源、来源、来源、来源)
- 代理商务基础设施正变得比其所服务的市场更具体。 身份、托管、评估和争议处理等角色正变得更加清晰,但实时的经验证供给看起来仍然稀薄,声誉滥用依然是一个现实问题。(来源,来源, 来源, 来源)
- 如今,多模态智能体产品的评判标准已不只是生成质量,还包括可编辑性和可呼叫性。 最强的产品信号,是人们确实可能会拨打的语音智能体,以及能产出可编辑演示文稿或可确定性生成视频的媒体工具。(来源, 来源, 来源, 来源, 来源)
- 最有说服力的构建者发布的是可复用系统,而不是停留在愿景层面的演示。 Yang 展示了一个生产级修复工厂,HyperFrames 展示了一个 HTML-to-MP4 运行时,open-slide 展示了一个原生面向智能体的幻灯片栈,而 Xiaomi 展示的是 RL 基础设施,而不只是新的权重。(来源, 来源, 来源, 来源, 来源)