Twitter AI Agent - 2026-10-04
1. 人们在讨论什么
1.1 Harness engineering 不再像江湖传说,而开始像一份规范(🡕)
2026-10-04 最大的话题簇,围绕的是如何定义 harness 本身:不只是“用哪个模型”,而是一个 agent 实际需要怎样的 loop、control plane、skill surface、memory policy、permission stack 和 runtime shape。至少有七条保留内容支撑了这一主题,涵盖一份广泛传播的手册、一篇 steering engineering 指南、Wavestone 对 11 个 coding agent 的源码研究,以及 Andrew Ng / Anthropic 成对出现的教学内容。与上一份可获得的 2026-09-28 报告相比,讨论基调已经从课程构建转向架构收敛。
@techNmak 指出(171 次点赞,24 条回复,7,854 次浏览,230 次收藏)表示,“harness engineering” 这一层决定了模型周围的 context、tools、retries、approvals、durable state、idempotency、subagents 和 verification。这个帖子之所以值得注意,在于它足够全面:它没有推销某一个框架,而是把 agent 的可靠性视为 tool design、context policy、sandboxes、credentials、prompt-injection defenses、execution budgets 和 evaluator loops 之间相互作用的结果。回复进一步强化了这一点,尤其有一条指出,如今 agent 需要作为 model + harness + environment 的整体持续评估,而不是只做 model-only tuning。
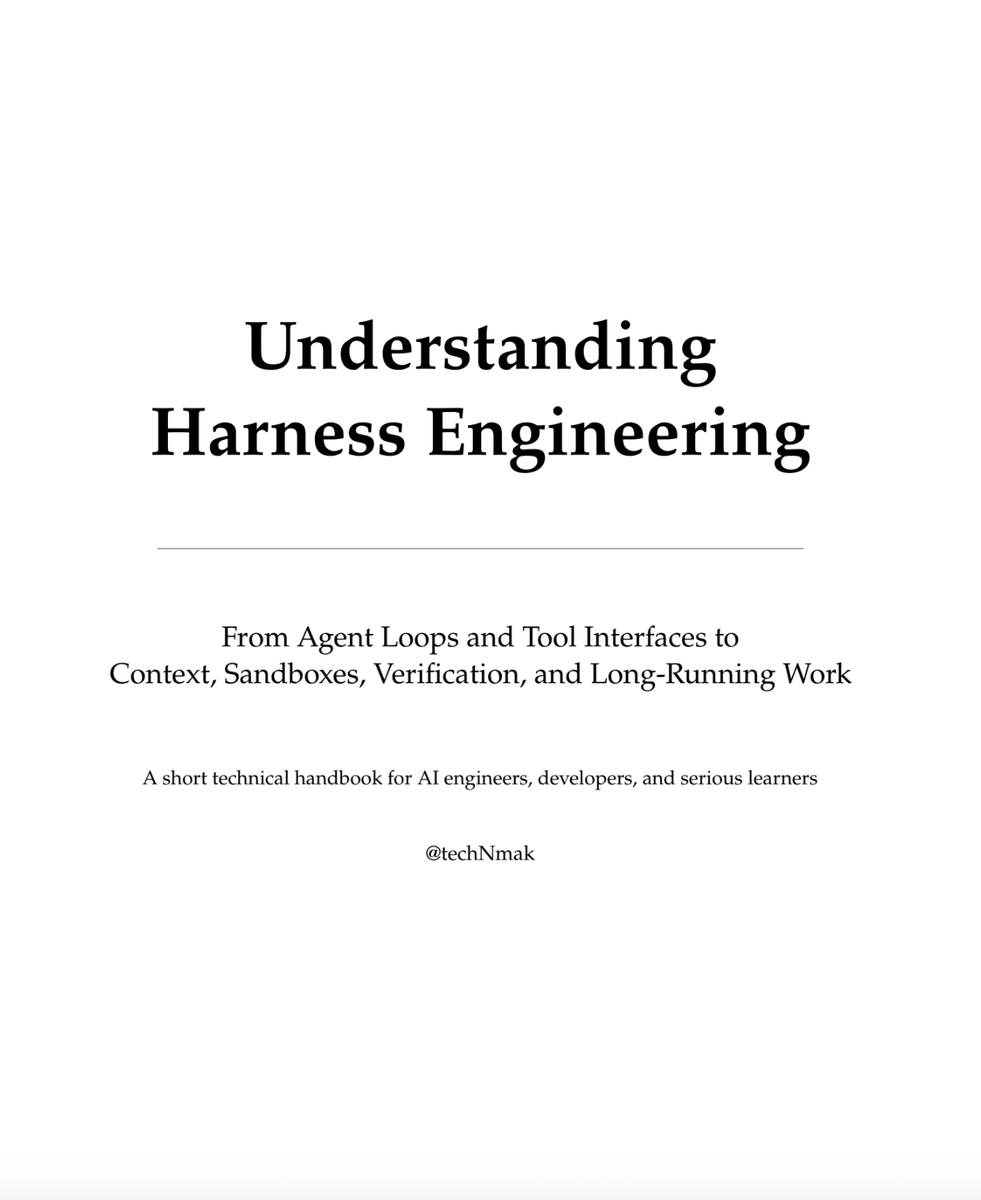
@0xwhrrari 指出(63 次点赞,21 条回复,2,041 次浏览,44 次收藏)表示,纠正之后仍沿用陈旧行为,不是 prompting 失败,而是缺少 control plane。该线程将 steering、graph、harness 和 loop 拆分为不同职责,然后建议对每一次纠正都进行版本管理,只重绘受影响的 graph 分支,并阻止那些基于旧指令集提出的动作在契约已经变化后悄然执行。相比“agent 说了 got it”,这是一种更强的操作模型,因为它把纠正视为一次实时状态迁移,而不是聊天里又多了一句话。
@slash1sol 报道(56 次点赞,23 条回复,1,690 次浏览,31 次收藏)表示,Wavestone AI Lab 阅读了 Claude Code、Codex、Gemini CLI、OpenHands、Aider、OpenCode、OpenClaw 等系统约 400 万行代码后发现,同样的七个 harness 组成部分反复出现:loop、model layer、tools、memory、safety、orchestration 和 extensions。这个帖子之所以重要,还因为它同时提出了两条否定性结论:这些系统没有一个引入 agent framework,也没有一个把基于 embedding 的代码检索作为核心路径。论文 为当天的讨论提供了一张共享的解剖图,而不是又一个特定厂商的叙事。
@stretchcloud 指出(7 次点赞,9 条回复,521 次浏览)表示,同一份 Wavestone 研究里最重要的部分,是 extension surface 正在走向哪里:11 个系统里已有 9 个提供了 SKILL.md 风格的 skills,而 8 个使用 MCP,这意味着 skills 已悄然成为更常见的集成接口。该帖子也换了一个角度来界定竞争动态,指出 Codex 借用了 Claude Code 的 hook 词汇,而 OpenHands 开始读取 Claude Code 的插件格式,因此这种收敛正发生在 API 层面的开放式模仿,而不是彼此隔绝的重复发明。
@kyr0stack 指出(23 次点赞,1 条回复,828 次浏览,23 次收藏)表示,Andrew Ng 的新 graph-engineering 课程之所以有价值,恰恰因为它按顺序讲解了从 first agent 到 loop engineering、再到 graph orchestration,最后到 self-rewriting systems 的整套栈。@res1dualedge 提出了相同的观点(12 次点赞,1 条回复,695 次浏览,12 次收藏)则推荐了 Anthropic 的 loop-engineering workshop,重点提到 loop memory、check/build/commit,以及如何把已接受的工作带入下一轮运行这一尚未被充分解决的问题。两条帖子合在一起,让教学层面的共识比一周前清晰得多:prompts 只是入口,真正的差异体现在 loops、graphs、memory carry-forward 和 acceptance checks 上。
讨论洞察: 有意思的反驳并不是“模型重不重要?”,而是“到底还有哪些东西应该属于 harness?” 回复一再回到几个问题:带副作用的 retries、permission stacks、evaluator models,以及 extension layers 增加歧义的速度是否快于它带来能力的速度。
与前次报告比较: 与 2026-09-28 相比,当时讨论更强调 harness 的课程体系和分阶段学习路径;而到 2026-10-04,同一片领域看起来已经标准化得多。这个领域听上去不再像是在发现这套栈,而更像是在就这套栈达成共识。
1.2 管理层、工单式交接与可复用 skills,成为更务实的扩展模式(🡕)
第二个话题簇给协调过载的答案,是在 worker 之上再加一层。至少有六条保留内容支撑了这一主题,涵盖 GrokBot 演示、chief-of-staff 工作流、SwarmResearch 论文、关于 subagents 实际会继承什么的警告、一个开源协调协议,以及一个公开的 skills 集合。共同点不是“生成更多 agents”,而是“把 routing、被否决的选项和完成标准明确下来”。
@0xRafy 报道(30 次点赞,2 条回复,1,596 次浏览,32 次收藏)表示,一位 SpaceXAI 工程师构建了一个 GrokBot,用来把工作拆分给 cloud agents、审查进展,并让现有 agents 持续运转。它的主张明确反对 babysitting:不必持续盯着看,不必同时开着 20 个聊天窗口,由一个 bot 负责整个 engineering loop,而 worker agents 负责实际实现。即便这只是一个以演示驱动的信号,它依然重要,因为它清楚命名了新的目标角色:agent 的 engineering lead,而不只是另一个 worker。
@0xGenAi 补充了操作细节(9 次点赞,1 条回复,387 次浏览,12 次收藏)来自一场讲解同一模式的 45 分钟 workshop。其中的具体组成包括:一个 chief-of-staff bot,把工作分发给 UI、DevX 和 infra 专家;每晚自动进行 research sweep,到早上就留下准备好的 PRs;优先接管 red CI、只有在仍然失败时才升级处理的 bots;以及一个负责维护 Notion 中 playbook 的 operations bot。相比泛泛而谈的“multi-agent”,这更有意思,因为它把 swarm 变成了一个轮班表、组织结构图和升级策略。@0xCodila 报道(15 个赞、3 条回复、496 次浏览、16 次收藏)在 SwarmResearch 中给出了同一思路的论文版本:由一个 Shepherd Agent 协调多个 Search Agents,后者分别在不同的 git 分支上工作,并各自拥有独立的本地上下文。论文摘要之所以重要,是因为它为这种“幕僚长”式叙事补上了量化结果:在 15 个开放式优化任务中,有 13 个任务取得了更好或相当的结果;此外,在一个推理基准上,相比 1.80x 的基线 autoresearch loop,实现了 4.58x 的加速。这让“管理者在执行者之上”的模式看起来更像一种可复现的架构范式,而不只是一个精彩的工作坊故事。
@6AW0RON0k 指出(7 个赞、2 条回复、176 次浏览、4 次收藏)指出,很多委派失败其实是自己造成的,因为 subagents 接收不到主聊天历史。这条帖子难得地具体说明了哪些内容会随委派一并传递——委派说明、subagent 自己的 prompt 文件、CLAUDE.md 层级、启动时的 git status,以及预加载的技能——以及哪些内容不会被带过去,包括完整对话和 system prompt。这也让建议格外好记:交接说明要写得像发给外包承包商的工单,所有二选一的问题都要先定下来,长期生效的规则则要放在真正会传播到下游的位置。
@DanKornas 报道(1 次转推、2 条回复、498 次浏览)提到,Agent Orchestra 试图把这些完成与交接规则落实为可由代码强制执行的约束,而不只是 prompt 里的建议。它的 contracts——task、resource、ownership、handoff、verification、evidence、approval 和 recovery——就是为了阻止一种典型失误:实现者自己验证自己的工作,或悄无声息地声称“已完成”。这仍然是一个早期项目,但它与当天的整体趋势完全吻合:agent 团队现在需要的是协调协议,而不只是更大的上下文窗口。
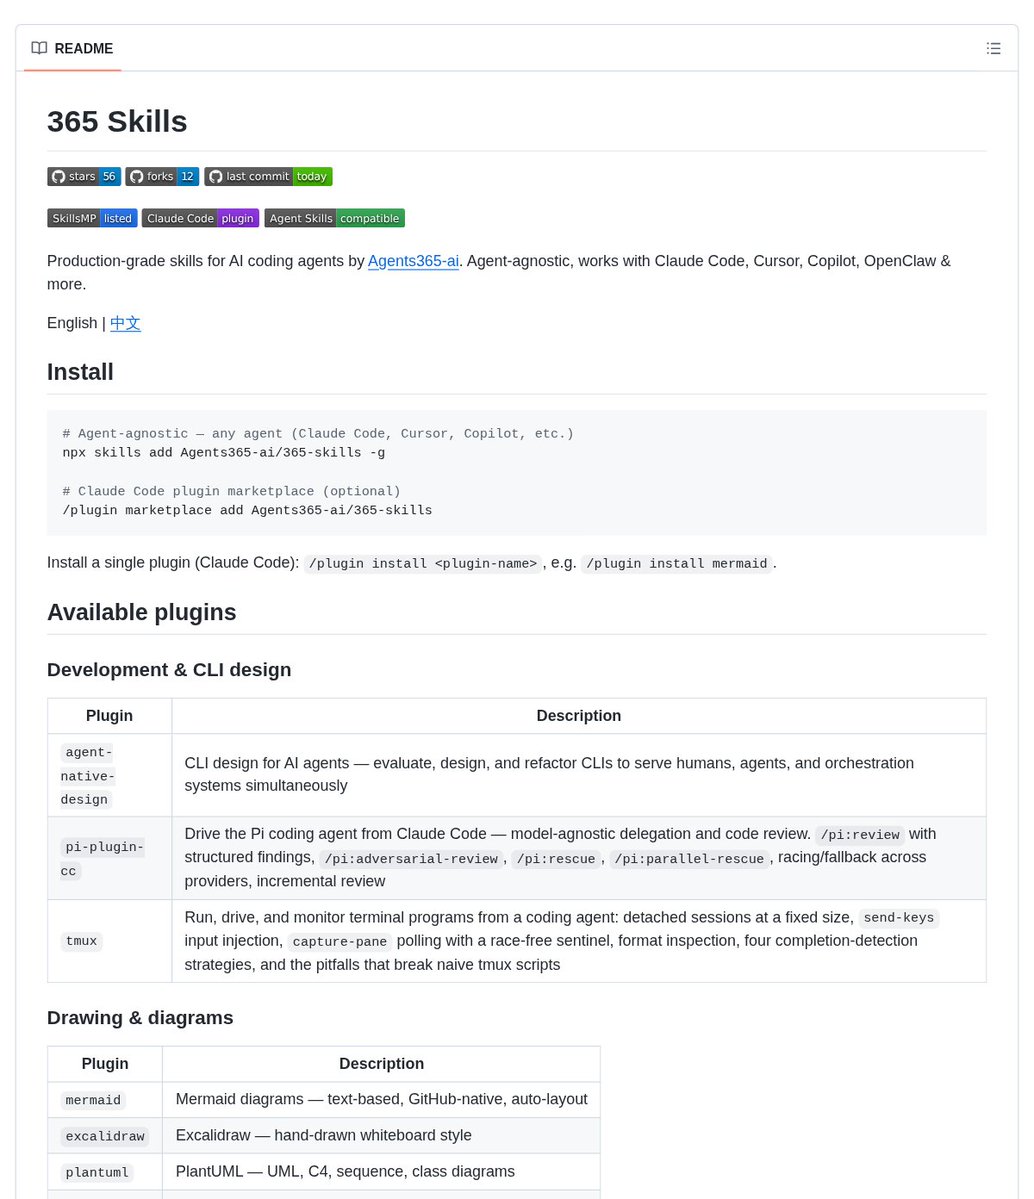
@DanKornas 报道(7 个赞、6 条回复、1,035 次浏览、11 次收藏)提到,365 Skills 正在成为一个公开的可复用 agent skills 和 Claude Code 插件集合,覆盖编码、研究、图表、笔记和媒体任务。这个 repo 和截图之所以重要,是因为它们展示了另一条扩展路径:与其让每个团队都重复搭建同样的能力接线,不如一次打包好,再让人们把它作为可移植的技能层安装到 Claude Code、Cursor、Copilot 和相关工具中。
讨论洞见: 这里最有价值的一点在于,“multi-agent”并不意味着“共享一切”。这些被保留的帖子始终在区分 supervisor context、worker context、durable memory 和 rule propagation,而这也正是为什么交接、驳回和所有权如今都需要明确的接口面。
与前一天的对比: 在 2026-09-28,受治理的上下文主要体现为 CI、数据库和企业控制界面。到 2026-10-04,这种相同的治理冲动已经上移到 chief-of-staff bots、skill packs、handoff protocols,以及专门面向 agent 团队本身的独立验证层。
1.3 可靠性工作转向验收、权限、记忆和低成本决策闸门(🡕)
第三个主题簇把 agent 质量视为签收问题,而不是生成问题。至少有 7 条保留内容支撑了这一点,涵盖验收层框架、操作系统级权限变更、本地持久记忆、后台审批助手、有界决策模型,以及能够戳穿误导性 cache-hit 指标的成本轨迹。如果说第一个主题是“测试框架是什么”,那这一部分就是“测试框架依然无法证明什么”。
@nateberkopec 指出(4 个赞、1 条回复、354 次浏览、6 次收藏)认为,AI 辅助编码中最大的缺失环节,是更好的验收层。最醒目之处在于,从业者心中的清单已经非常宽泛:能力匹配、bug、安全、速度、法律约束,以及“另外 1000 件事”;作者坚持认为,这一层目前仍应以人为主,因为 agent 可以被委派去解决“怎么做”,却无法替代对“什么才算可接受”的产品定义。这条帖子实际上成了当天其余可靠性讨论的论点纲领。
@Musecases 指出(11 个赞、4 条回复、986 次浏览、5 次收藏)提到,Apple 因 AI agents 重写了一个 macOS 权限提示;而 @farrukh_codes 指出(11 个赞、13 条回复、590 次浏览)则指出,正确的默认方式应是按任务限定、按时间受限的访问权限,而不是对整台笔记本的完全访问。这两条帖子从相反两端指向同一个结论:权限 UX 正在成为产品的一部分,而信任如今取决于 agent 能否为下一步动作提出足够精确、范围足够收窄的权限请求。
@ayandexyz 报道(12 个赞、6 条回复、480 次浏览,5 个书签)称,Hommies 会监控正在运行的编程代理,并通过悬浮助手或顶部栏显示待处理的权限请求或问题,避免人类数小时后回来才发现代理已经卡住。比起动画演示,仓库说明更重要:它会按代理和会话对请求分组,可以直接跳转到对应的终端窗口,并将“等待你处理”视为一种独立的运行时状态。这是一个虽小却很具体的例子,说明批准正成为独立的产品交互层。
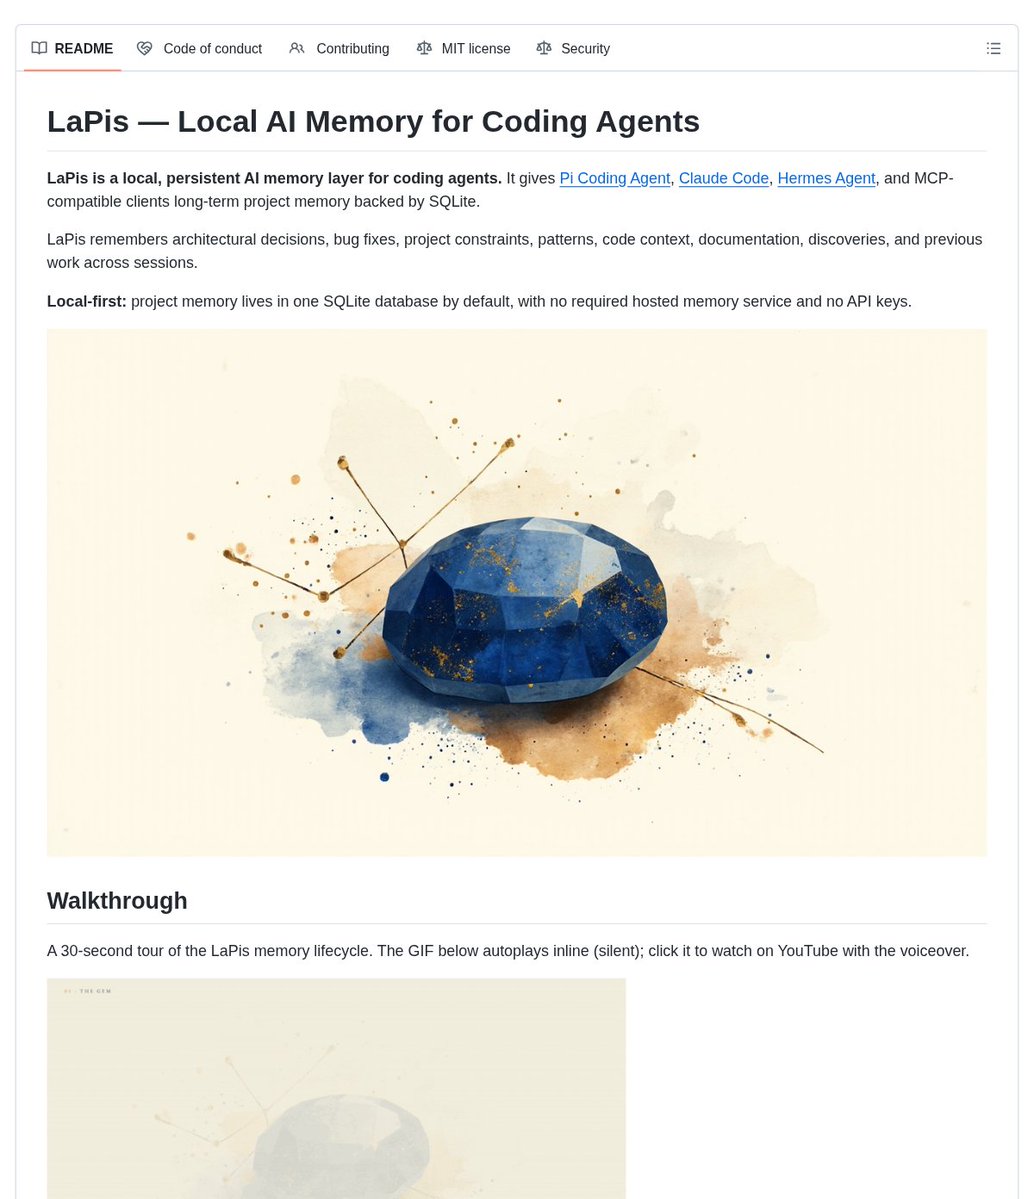
@DanKornas 报道(6 次点赞、3 条回复、749 次浏览、3 个书签)称,LaPis 为 Pi、Claude Code、Hermes 和兼容 MCP 的客户端提供本地持久记忆,采用以 SQLite 为后端的存储。README 把它的定位说得很清楚:会话回溯、代码与文档索引、代码变更导致记忆失效时的可信度追踪,以及无需强制使用托管服务。更重要的变化在于,“代理记忆”现在已经成了一类产品:有安装步骤、有生命周期钩子、有失效逻辑,而不再只是“更大的上下文窗口会记住足够多内容”这种模糊承诺。
@mr_kozh 指出(22 次点赞、8 条回复、669 次浏览、9 个书签)称,在某个展示的代理技术栈中,最重要的模型根本没有写任何代码:Jev 只负责决定下一步发生什么。最令人印象深刻的证据不是表演式展示,而是流程本身——240 个测试、221 个通过、19 个失败,一个廉价的验证器返回有界选项或分数,而执行框架据此决定是继续、停止还是升级处理。这是同一种验收层思路的另一种体现:把生成与裁决分开。
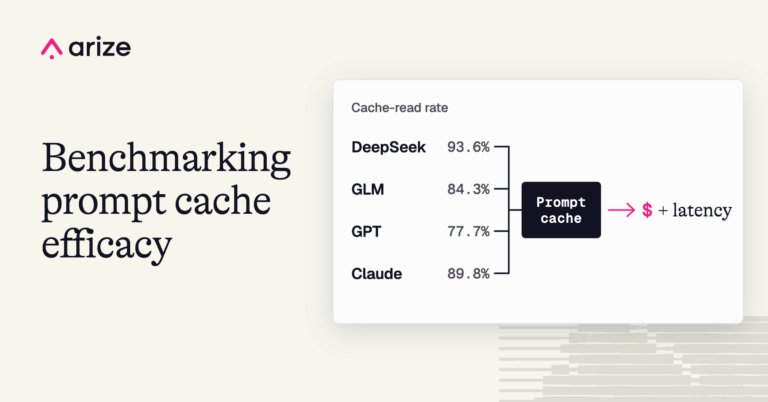
@arizeai 报道(4 次点赞、2 次转推、126 次浏览、2 个书签)提到,Arize 的提示缓存研究 中的基准测试证据表明,更高的提示缓存复用率未必意味着更低成本。DeepSeek 的缓存读取率最高,达到 93.6%,且在 100 次运行中的预估成本最低;而 Claude 尽管也实现了 89.8% 的缓存复用,预估成本仍然最高,因为账单是由输出 token 驱动的。这一点之所以重要,是因为它用一组更具操作性的指标——跟踪数据、生成 token 数量、延迟和供应商定价——取代了那个令人安心的单一指标。
讨论洞察: 无论是验收、权限、记忆、Jev 式决策层,还是提示缓存跟踪,反复出现的都是同一个原则:难点不在于让代理去尝试完成工作,而在于决定系统被允许做什么、它记住什么,以及一次运行何时才真正算得上可接受。
与前一天的比较: 2026-09-28 的报告已经显示,记忆正在脱离聊天界面,而面向消费者的代理安全问题正聚焦于批准边界。到 2026-10-04,同样关于可靠性的讨论变得更明确,也更具操作性:验收层、权限提示、本地记忆安装、验证器模型,以及跟踪级别的成本证据。
1.4 代理商业化继续向证明、声誉和结算轨道收敛,但证据仍以构建者为主(🡒)
一个较小但持续存在的讨论群体一直在推动这样一种观点:代理需要的经济体系,应围绕身份、评估和支付秩序来设计,而不只是一个市场首页。至少有六条保留内容支撑了这一点,但其中几乎全部来自构建者或生态推动者,而不是明确的终端用户需求,这使得这一信号虽真实存在,但仍未进入主流。
@iam_islandboi 指出(190 次点赞、52 条回复、163 次转推、1,892 次浏览)称,TermiX 应被理解为一个商业与结算层,在这里,代理可以建立身份、发现工作、竞标、执行、验证交付并获得报酬。@damonemcrp 提出了相同的论点(23 次点赞、9 条回复、183 次浏览)则从微任务角度切入,认为更低的平台抽成让 2–5 美元的任务变得可行,因此也改变了代理工作本身可能存在的类型。
@dee_e6 指出(29 次点赞、39 条回复、302 次浏览)称,在雇用代理时,经过验证的工作履历比打磨精美的演示更重要,这也是为什么它在总结 AACP 时,会同时强调身份、声誉、竞标、托管、交付验证、争议解决和结算。@Caccy_001 补充了(43 次点赞、47 条回复、309 次浏览)则提出了一个更尖锐的治理细节:如果评估者本身的行为开始显得可疑,系统应该能够在用户明确投诉之前就发起争议。@LiegeAgents 报道(29 次点赞、3 条回复、15 次转发、351 次浏览、7 次收藏)称,Liege 会把一条包含专家、任务和预算的 X 提及转化为一份可审阅的提案,由用户批准、注资、评估并结算。关键表述是“no blind execution, no automatic spending”,这正是其他 agent 市场也在追求的那类控制性措辞。@MPP32_dev 介绍了(15 次点赞、2 条回复、8 次转发、313 次浏览)则展示了支付基础设施这一侧的 MPP32:多轨 API 发现、本地签名、供子 agent 使用的委托支出密钥,以及直接结算到构建者钱包、平台不抽成。
讨论洞察: 商业化讨论依然更在意审核顺序、委托权限、评估者中立性和支付机制,而不是发现机制或品牌。换句话说,人们想要的首先是一个可信的清算流程,而不是另一个 agent 目录。
与前一天对比: 在 2026-09-28,商业化话题聚焦于法庭、证据保全和判决后付款。到 2026-10-04,同样的诉求已经扩展成更完整的技术栈——身份、竞价、声誉、委托支出和提案审核——但仍缺乏面向广泛终端用户的有力证明。
2. 什么让人沮丧
多 agent 交接仍会丢失关键信息,还会让 agent 过度宣称任务已完成
严重性:高。@6AW0RON0k 指出(7 次点赞、2 条回复、176 次浏览、4 次收藏)称,子 agent 会收到简介、提示词文件、CLAUDE.md 层级、git 快照和预加载技能,但拿不到促成该决策的完整对话。@0xGenAi 介绍了(9 次点赞、1 条回复、387 次浏览、12 次收藏)则从另一面说明了这种痛点:一位工程师在转向 chief-of-staff 模式之前,一直靠手动协调 15 个云端 agent。@DanKornas 展示了(1 次转发、2 条回复、498 次浏览)解释了为什么如今会出现各种协调协议——如果没有明确的验证和审批关卡,系统里的每个参与方仍然都可以说一句“完成了”。
应对模式是让委派更具契约性。构建者建议采用工单式交接、显式记录拒绝、在执行者之上设置独立监督者,以及用独立验证替代自我认证。这是务实的系统性应对,但也说明基础交互体验仍然过于脆弱。
值得为此构建吗? 是。这对任何同时运行多个 agent 或多个上下文窗口的人来说,都是直接的操作痛点。
验收、审批和权限边界仍缺少一个良好的默认交互层
严重性:高。@nateberkopec 认为(4 次点赞、1 条回复、354 次浏览、6 次收藏)称,编码 agent 仍缺乏一个真正像样的验收层,来覆盖能力匹配、缺陷、安全、性能和法律约束。@Musecases 认为(11 次点赞、4 条回复、986 次浏览、5 次收藏)称,Apple 已经因为 agent 修改过一个 macOS 权限提示;而 @farrukh_codes 认为(11 次点赞、13 条回复、590 次浏览)则呼吁采用更严格、按任务限定的边界,而不是直接信任整台设备。
应对模式是更多界面、更少隐形自治。@ayandexyz 围绕这一点构建(12 次点赞、6 条回复、480 次浏览、5 次收藏)借助 Hommies 的待处理请求界面,以及 @LiegeAgents 描述了同样的直觉(29 次点赞、3 条回复、15 次转发、351 次浏览)提到,在 Liege 的可审查提案流程中,应先经过审查,再进行资金拨付或结算。人们似乎并不想减少 agent 的操作次数;他们真正想要的是,更清楚地看到正在请求哪些操作,以及哪些操作被允许。
值得为此构建吗? 是。这是当前阻碍信任进一步扩大的最明显瓶颈之一。
长期状态仍然过于脆弱,而错误的指标仍让它看起来比实际更简单
严重性:中高。@DanKornas 报道(6 次点赞、3 条回复、749 次浏览、3 次收藏)提到,LaPis 需要本地持久化记忆,因为决策、约束、bug 修复以及文档中的新发现,仍然会在不同会话之间丢失。@mr_kozh 展示了(22 次点赞、8 条回复、669 次浏览、9 次收藏)解释了为什么廉价的决策模型作为独立层很有吸引力:测试失败后,它们可以裁定下一步怎么走,而不必再让另一个大模型凭空“脑补”出信心。@arizeai 补充了强有力的基准测试证据(4 次点赞、2 次转发、126 次浏览)指出,即便像缓存读取率这样看似不错的指标,也可能掩盖真实的成本情况,因为支出的大头其实是输出 token。
同样的挫败感也出现在运行时架构上。@CloudNativeFdn 总结了(2 次点赞、1 条回复、800 次浏览)描述了一种云原生 harness 设计:持久化的会话状态、事件日志和多客户端访问都放在单一桌面进程之外。如今,这一主题已经延伸到专门的记忆产品、验证层、追踪工具和分布式运行时;这一事实本身就说明,默认的单会话模型已经不够用了。
值得为此构建吗? 是。需求很现实、反复出现,而且对大多数团队来说,相关基础设施负担仍然过重。
即便支付基础设施在改善,agent 商业仍然缺乏中立的信任基础设施
严重性:中等。@dee_e6 认为(29 次点赞、39 条回复、302 次浏览)指出,经过验证的工作历史比花哨的演示更重要,这也是为什么 AACP 要把身份、托管、验证、争议处理和结算整合在一起。@Caccy_001 将这一点进一步推进(43 次点赞、47 条回复、309 次浏览)则表达了对评估者自身可疑行为的担忧。@MPP32_dev 描述了(15 次点赞、2 条回复、8 次转发、313 次浏览)提到委托支出密钥和直接向构建者结算,而 @LiegeAgents 强调了(29 次点赞、3 条回复、15 次转发、351 次浏览)强调可审查的提案和禁止盲目执行。
应对方式是程序性的:支出前先审批,发生争议前先保留证据,并把评估者治理视为市场机制的一部分。这很有前景,但目前的大多数证据仍然来自构建者对自家机制的描述,而不是来自广泛的公开使用。
值得为此构建吗? 是,但要谨慎。痛点是真实存在的,但需求证据仍然更多由构建者推动,而不是由用户推动。
3. 人们希望存在什么
一个真正的验收层,能够在不假装“完成”是显而易见的前提下,为工作正式签收
这是一个有紧迫证据支撑的现实需求。@nateberkopec 直接将其界定为(4 个赞、1 条回复、354 次浏览、6 次收藏)将其视为 AI 辅助编程中缺失的最大一块拼图,而 @mr_kozh 展示了一个部分答案(22 个赞、8 条回复、669 次浏览、9 次收藏)则押注于一种验证模型:只有在测试结果和证据都可见之后,才决定下一步如何进行。Arize 的基准测试也以工具的形式传达了同样的教训:人们想要的是比单一、看似亮眼的指标更可靠的运营真相。
市场似乎依然缺少这样一层可移植的签核层:把需求、测试、安全、性能和审批串联起来,而不必让每个团队都从零搭建自己的审查栈。
机会:Direct.
在不复制整段对话的前提下,保留恰当上下文的交接机制
这是另一个有反复证据支持的现实需求。@6AW0RON0k 将这种失败具体化(7 个赞、2 条回复、176 次浏览、4 次收藏)展示了子代理实际能继承到的上下文是多么有限,而 @0xGenAi 展示了手动变通方法(9 个赞、1 条回复、387 次浏览、12 次收藏)则体现在幕僚长式路由和书面操作手册上。@DanKornas 指出了记忆(6 个赞、3 条回复、749 次浏览、3 次收藏)则构成了解决方案的另一半,因为可持久保存的项目上下文仍必须能跨越会话边界存续下来。
人们似乎并不希望每个代理继承一切。他们需要的是足够的结构化上下文——任务、已否决的选项、相关约束、记忆和当前状态——以避免一再重复那些早已定论的错误。
机会:Direct.
用可移植的技能包和受治理的协同规则,取代各团队各自重复发明
这一需求很务实,但竞争也在不断加剧。@DanKornas 报道(7 个赞、6 条回复、1,035 次浏览、11 次收藏)推出了一个旨在跨不同代理宿主运行的公开技能集合;@stretchcloud 认为(7 个赞、9 条回复、521 次浏览)显示,在 Wavestone 的样本中,技能如今比 MCP 更常见;而 @DanKornas 将协作规则写入代码(1 次转发、2 条回复、498 次浏览)则配套了明确的验证与审批契约。
尚未被满足的,不是另一个通用助手,而是一层可移植的能力层,加上一套共享的协同规则,能够跨工具、团队和会话迁移,而不是每次都从一条空白提示重新开始。
机会:Competitive.
带权限控制的后台代理界面,让审批可见、快速且范围明确
这是一个直接的产品需求。@Musecases 认为(11 个赞、4 条回复、986 次浏览、5 次收藏)表明,如今权限提示本身就是产品,@farrukh_codes 认为(11 个赞、13 条回复、590 次浏览)主打更窄的访问边界,而 @ayandexyz 围绕这种痛点构建(12 个赞、6 条回复、480 次浏览、5 次收藏)则提供悬浮式审批伴侣。@LiegeAgents 应用了同样的思路(29 个赞、3 条回复、15 次转推、351 次浏览)则将采购与结算交给代理处理。
人们实际上是在要求更快的审批界面:即使代理在后台运行,也能完成审批,同时又不会把信任边界扩大到“整台机器永久开放”。
机会:Direct.
能证明身份、评估和付款顺序的结算轨道
这是一个现实需求,但目前仍停留在品类雏形阶段。@iam_islandboi 将其界定为(190 个赞、52 条回复、163 次转推、1,892 次浏览)将 TermiX 描绘为完整的经济闭环;@dee_e6 强调了(29 个赞、39 条回复、302 次浏览)强调可验证的工作历史;@MPP32_dev 强调了(15 个赞、2 条回复、8 次转推、313 次浏览)则聚焦委托支出和面向构建者的直接结算。反复出现的核心诉求是:条款、评估、授权和资金流转应遵循同一条可审计的顺序。
这一领域看起来已经挤满了各种协议和轨道,但数据仍表明,底层需求尚未得到解决。
机会:Competitive.
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪倾向 | 优势 | 局限 |
|---|---|---|---|---|
| Harness handbook + Wavestone study | 架构参考 | (+) | 为循环、工具、记忆、权限、编排和扩展界面提供了共享词汇体系 | 主要是解释性材料;团队仍需自行将这些指导落地 |
| Andrew Ng + Anthropic 的 loop/graph 课程 | 课程 / 方法 | (+) | 从 prompt 到 loop 再到 graph 的演进路径清晰,并强调把已接受的结果继续传递下去 | 仅用于教学;本身并不能解决部署或治理问题 |
| 365 Skills | 技能市场 | (+) | 提供与代理无关的安装路径、插件市场模式,并广泛覆盖编码和研究任务 | 生态仍处早期,公开采用规模有限,且每项技能都需要人工信任审核 |
| GrokBot / chief-of-staff 模式 | 编排方法 | (+/-) | 减少盯守成本、分派给专家、安排隔夜工作,并将升级流程制度化 | 公开证据仍以演示和工作坊为主;交接质量依然脆弱 |
| LaPis | 记忆层 | (+) | 提供本地 SQLite 存储、会话回忆、代码/文档索引,以及跨会话的信任跟踪 | 需要配置 hooks/MCP,并保持严格的记忆卫生 |
| Hommies | 审批 UI | (+) | 按会话汇总后台代理的待处理问题和权限请求 | 以 Omarchy 为中心,并依赖 hook 集成 |
| Jev engineering | 决策 / 验证层 | (+/-) | 成本低、边界清晰的决策可在测试和可见证据之后,为下一步行动把关 | 证据主要来自推广方;校准和覆盖范围仍不明确 |
| Phoenix + Harbor prompt-caching benchmark | 基准测试 / 可观测性 | (+) | 提供 trace 级别的缓存、成本和延迟可见性,并展示为何缓存命中率可能误导判断 | 仅针对特定基准,尚不是通用运维仪表盘 |
| Mecatl / cloud-native harness | 运行时 / 基础设施 | (+/-) | 提供持久会话、事件日志、多客户端,以及 Kubernetes 原生参考部署 | 仍属早期项目,基础设施复杂度明显高于笔记本本地 harness |
| TermiX + AACP | 商业 / 声誉轨道 | (+/-) | 连接身份、竞标、托管、交付验证、争议处理逻辑和结算 | 证据仍主要由构建者/推广者主导,而非用户主导 |
| Liege + MPP32 | 采购 / 支付界面 | (+/-) | 提供可审查提案、委托支出密钥和多轨结算流程 | 信任模型仍处早期,尚缺乏广泛公开的实际运行证据 |
总体来看,凡是把界面做得更明确的地方,情绪倾向就最强。技能、审批 UI、记忆层、验证器模型、基准测试和云运行时之所以受到关注,是因为它们各自暴露出一个具体的运营任务,而不是承诺靠一个聊天框就能吞下整套技术栈。
常见的权宜模式是分层叠加。构建者会把一个系统用于编排,另一个用于记忆,再用一个处理审批,还要再配一个做评估或成本追踪。Wavestone 的综合分析表明,这已不再是偶然现象:市场正在收敛到一组可复用的子系统,然后围绕各团队最擅长打包哪一层展开竞争。
迁移动态看起来也与春夏时节不同。人们不再是用一个模型替换另一个模型,而是在用显式界面替换隐形行为:用技能包替代反复粘贴的 prompt,用验证层替代“看起来不错”,用审批伴侣替代被错过的终端提示,用云原生运行时替代单个长期存活的桌面进程。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| 365 Skills | @DanKornas | 可复用技能和 Claude Code 插件的公开集合,也可安装到其他编码代理宿主中 | 避免团队在每个工具里反复重接同样的代理能力 | Python 仓库、npx 安装器、Claude 插件市场、跨代理技能 |
已发布 | 推文, 仓库 |
| LaPis | @DanKornas | 面向编码代理的本地持久记忆层 | 在跨会话中保留项目决策、bug 修复、约束和文档 | JavaScript、SQLite、MCP + hooks、代码/文档索引 | 已发布 | 推文, 仓库 |
| Hommies | @ayandexyz | 面向 Omarchy 的悬浮伴侣和桥接层,用于处理后台代理的问题与审批 | 防止运行中的代理因权限提示或澄清问题而在无人察觉时停滞 | TypeScript bridge、QML plugin、hooks,会话焦点控制 | Beta | 推文, 仓库, 插件 |
| Agent Orchestra | @DanKornas | 带治理的协同协议,明确所有权、验证、证据和审批契约 | 防止代理自行认定“已完成”,并在共享资源上相互冲突 | JavaScript/Node、协议规范、确定性基准、一致性检查 | Alpha | 推文, 仓库 |
| Mecatl | @CloudNativeFdn | 云原生运行框架,将循环与客户端、执行环境和持久化状态分离 | 让长时运行的多租户代理会话可治理,并具备重启容错能力 | Go、gRPC、HTTP/SSE、tools/skills、Redis/Kubernetes 参考运行时 | Alpha | 推文, 文章, 仓库 |
| SwarmResearch | @0xCodila | 位于独立 Search Agents 之上的 shepherd-agent 监督器,用于开放式优化 | 试图通过分支式搜索并为各分支提供独立的本地上下文,超越单线程 autoresearch | 研究系统、supervisor + worker agents、独立 git branches/worktrees | Alpha | 推文, 论文 |
| Liege Agents | @LiegeAgents | 将 X 上的提及转化为可审查、可预算的代理工作提案,并附带审批与结算 | 在工作启动或支出发生前,让代理采购具备可追责性 | 社交提及入口、工作区提案、资金/评估/结算流程 | Beta | 推文, 网站 |
| MPP32 | @MPP32_dev | 原生支持 MCP 的支付代理,可发现支持机器支付的 API,并直接向构建者结算 | 消除代理到服务支出中针对各提供方单独定制的计费粘合层 | MCP、x402、Tempo、AGTP identity、本地签名、委托支出密钥 | Alpha | 推文 |
365 Skills、LaPis 和 Hommies 解决的问题各不相同,但它们共享一个重要的构建模式:把运营上的缺口做成可安装的模块。一个封装可复用能力,一个封装记忆,一个封装审批可见性。相比单个仓库本身,这其实是更强的信号,因为它表明构建者认为“缺失的产品界面”真正存在于哪里。Agent Orchestra 和 SwarmResearch 表明,协同这一方向正在分化为两条路线:一条是协议优先,试图让失效模式变得不可能发生,或至少可度量;另一条是搜索优先,试图让对分支工作者的监督,优于单个长期运行的研究循环。两者都默认一个前提:智能体团队需要比共享待办列表和良好意愿更明确的结构。
Mecatl 之所以格外突出,是因为它把关于 harness 的讨论下沉到了运行时架构层面。相关文章和代码库描述了持久会话、只追加事件日志、多客户端,以及 Kubernetes 部署模型;对于“agent runtime 是什么”这个问题,这给出的答案与早先大多数 coding-agent 讨论中默认的“以笔记本电脑为中心”的设定截然不同。
Liege Agents 和 MPP32 进一步强化了第 1 节中的商业模式判断:审批、预算、身份和结算,正在被设计为一等步骤,而不是事后补上的控制措施。关键不在于智能体商业的存在本身;而在于,构建者反复把证明与支付顺序视为首要设计问题。
6. 新内容与值得关注的动态
6.1 Wavestone 的源代码研究为市场提供了一张共享的七部分 harness 地图
@slash1sol 已报道(56 次点赞、23 条回复、1,690 次浏览、31 次收藏)给出了这组数据中最清晰的“共同结构”信号,而 @stretchcloud 已添加(7 次点赞、9 条回复、521 次浏览)则提出了一个更具挑衅性的含义:如今,skills 作为差异化扩展界面的重要性,可能已经超过 MCP。这一组合让关于 harness 的讨论显得比一周前成熟得多。
6.2 SwarmResearch 让幕僚长模式有了真正的论文,而不只是 workshop
@0xCodila 已报道(15 次点赞、3 条回复、496 次浏览、16 次收藏)展示了可量化的收益:由一个 Shepherd Agent 在独立分支中监督多个 Search Agents。这与来自 @0xRafy 和 @0xGenAi 的产品侧 GrokBot 和幕僚长演示高度吻合。重要的变化在于,“管理者监督执行者”现在既有演示层面的势能,也有基准测试层面的证据。
6.3 Arize 表明,prompt-cache 命中率并不是运营成本的可靠代理指标
@arizeai 已报道(4 次点赞、2 次转推、126 次浏览、2 次收藏)给出的基准测试结果显示:Claude 复用了 89.8% 的 prompt tokens,但成本仍然最高;而 DeepSeek 的缓存复用率达到 93.6%,估算成本却最低。这是个有价值的纠偏,因为它促使构建者不要只盯着一个亮眼数字庆祝,而是转向检查完整 trace。
6.4 云原生 harness 的思路摆脱了笔记本电脑,进入了基础设施设计
@CloudNativeFdn 总结(2 次点赞、1 条回复、800 次浏览)提出了 Craig McLuckie 在 CNCF 的观点:应将 agent loop 与会话状态、客户端和执行环境分离,Mecatl 则是对应的参考实现。这一点之所以值得关注,是因为它把 agent runtime 设计视为一个分布式系统问题,而不是打造一个更好的终端应用。
7. 机会在哪里?[+++] Acceptance, approval, and sign-off layers — Evidence from @nateberkopec、@Musecases、@ayandexyz、@mr_kozh 和 @LiegeAgents 都指向同一个缺口:智能体可以生成工作成果,但团队仍缺少一个共享工作界面,来证明这些成果是可接受的、已获授权的,并且可以安全地继续推进。
[+++] Portable context, memory, and handoff control planes — Evidence from @6AW0RON0k、@0xGenAi、@DanKornas 和 @CloudNativeFdn 表明,人们需要在不继承完整聊天记录的情况下,更好地在子智能体、会话和长时间运行的运行时之间传递状态。
[+++] Reusable skills and governed coordination protocols — Evidence from @DanKornas 的 365 Skills 和 Agent Orchestra 帖子、@stretchcloud 对 Wavestone 的解读,以及 @0xCodila 对 SwarmResearch 的总结,都表明基础模型之上存在一个巨大的机会窗口:可打包的技能、协调契约,以及团队无需重建自家整套堆栈逻辑就能采用的监督模式。
[++] Cloud-native durable runtimes for long-lived agent work — Evidence from @CloudNativeFdn 和 Wavestone 对 harness 的框架性表述显示,智能体循环正逐步转向持久状态、只追加日志、多客户端和显式执行环境。这是一个很强的基础设施机会,但相比技能或审批,它距离主流团队更远。
[++] Settlement, reputation, and delegated-spend rails — Evidence from @iam_islandboi、@dee_e6、@LiegeAgents 和 @MPP32_dev 表明,构建者围绕身份、已验证的工作记录、审批和资金流转有着明确且连贯的需求。这个机会是真实存在的,但目前的证据基础仍主要来自构建者自身。
[+] Cost-aware observability for agent loops — Evidence from @arizeai 表明,团队仍需要更好的指标体系,将缓存、completion token 用量、延迟和价格整合到同一个运营视图中。与其说这项需求已经紧迫,不如说它仍处于浮现阶段;但随着智能体存续时间变长、调试成本变高,它正变得越来越重要。
8. 要点
1.Harness 工程正逐渐固化为一种共享架构,而不再只是讨论层面的概念。 当天最有分量的帖子并不是关于某个新模型,而是把 harness 视为一套可复用的技术栈:从 techNmak 的手册到 Wavestone 的七部分结构解析,都在说明这一点。(来源,来源)
-
当前胜出的多智能体模式是“管理者统筹执行者”,而不是“更多 swarm”。 无论是 GrokBot 的演示、幕僚长式运作模式,还是 SwarmResearch,都在把责任上移给负责路由、评估和扩展分支的监督者。(来源,来源,来源)
-
关于可靠性的讨论,重心已经从代码生成转向最终审批。 在这组数据里,验收层、权限提示、审批助手和决策模型的重要性,都高于单纯的生成质量。(来源,来源,来源)
-
持久化记忆正成为一个产品品类,而不再只是附带说明。 无论是 LaPis,还是围绕 handoff 的争论,前提都在于:上下文必须以结构化形式在跨会话、跨智能体之间延续,并配套信任与失效逻辑。(来源,来源)
-
单一运营指标正在失去公信力。 Arize 的基准测试明确指出,缓存复用看起来即使很出色,成本仍可能爆炸式上升;这也提醒我们,智能体可观测性必须以追踪为先。(来源,来源)
-
智能体商业仍然首先是基础设施问题。 围绕 TermiX、AACP、Liege 和 MPP32 形成的这组讨论脉络清晰,但关注点仍集中在身份、评估、委托权限和结算顺序上,而不是已经过验证的大规模应用。(来源, 来源, 来源, 来源)