Twitter AI 代理 - 2026-10-06
1. 大家在讨论什么
1.1 Agent 的工作正从单一对话迁移到整个团队的操作系统中(🡕)
2026-10-06 最明显的变化,是讨论从“agent 能写代码”的零散案例,转向涵盖受理、分流、记忆、执行和审批的完整运营模式。最有分量的帖子描述的,不再是 agent 待在某个 IDE 标签页里,而是嵌入 Slack、电子邮件、CRM、问题跟踪系统和 PR 流程中。相比 2026-10-05,manager-over-workers 这种模式变得具体得多:讨论不再停留于 orchestration 这个概念本身,而是更关注谁负责哪条工作线、哪些系统提供上下文,以及哪些环节仍需人工审批。
@poteto 指出(557 次点赞,59 条回复,20,018 次浏览,436 次收藏)描述了一个 Grok Bot 工作流:先从 calendar、CRM、Slack 和电子邮件获取应用上下文,再把 Slack 中的 bug 转到 Linear,通过 pstack 启动 Cursor cloud agents 进行复现,再用更多 agent 对 PR 做模糊测试,并在等待窗口结束后自动合并,除非有人类介入。最有价值的信息在回复区:verification 技能和 CLI 会运行应用、单元、集成和端到端检查,为编码 agent 提供兜底;CI 大约 5 分钟完成;问题跟踪系统还兼作记忆层,用于对类似报告去重。
@claudeai 报道(811 次点赞,72 条回复,93,827 次浏览,241 次收藏)提到,Every 团队会尽可能把工作经由 agent 路由处理;他们基于 Slack 中的 Claude Managed Agents 构建了公司级 agent,用来在内部传播新模型能力,随后又把同样的模式发布给订阅用户。这一点之所以重要,是因为它把 agent 从个人高阶用户工具,重新定义为团队共享的组织接口。
@nateliason 列出(169 次点赞,11 条回复,14,816 次浏览,314 次收藏)描述了一个 chief-of-staff bot、同步到 Notion、Linear 和 Todoist 的会后记忆、默认生成的电子邮件草稿、按工作线分工的 specialist、供多个 bot 协作的群组房间、Sentry 监控,以及可接手 Linear issue 并发起 PR 的 cloud coding agents。这个帖子对哪些系统构成持久记忆、哪些任务仍保留审批关卡,讲得异常具体。
@beamnxw 总结(68 次点赞,10 条回复,2,611 次浏览,47 次收藏)介绍了一种配置:每个 specialist Grok Bot 各自负责代码库中的一个区域,而且在 manager 接受结果前,必须提供截图、记录文本和可运行的开发实例。真正有信息量的并不是“200 多个 agent”这个标题,而是它坚持要求证明材料、由看板驱动重试,以及明确指定复盘责任人。
讨论洞察: 回复区反复追问的边界其实是同一个:不是“模型能不能做到”,而是“什么样的证据足以让这次运行被接受”。默认先出草稿的电子邮件、可运行应用的证明,以及短周期的 CI,成了人们在不假装“信任问题已经解决”的前提下,仍能放心委派工作的反复出现的折中方案。
与前一天的比较: 到 2026-10-05 时,manager loop 和 memory graph 正在成为解释规模化的默认框架。到了 2026-10-06,这些抽象概念已经变成覆盖 Slack、Linear、Notion、Todoist、Sentry 和 PR review 的明确日常操作流程。
1.2 Harness engineering 正演变为一门关于经济性与治理的学科(🡕)
Harness engineering 依旧是核心术语,但讨论重点已经转向成本、重试、审批,以及能够改进其他 agent 系统的 agent 系统。最有价值的帖子已不只是定义 harness,而是在给它的失败定价、展示如何验证工作结果,并把 agent 的绩效评审变成一个周期性的外循环。
@KirkDBorne 分享(147 次点赞,7,720 次浏览,185 次收藏)提到一本 48 页的《理解 Harness Engineering》手册,封面明确把 loops、tool interfaces、context、sandboxes、verification 和 long-running work 放在中心位置。这仍然是当天讨论的词汇锚点,但许多其他帖子立刻把它落实到了操作层面。
@beamnxw 认为(56 次点赞,15 条回复,7,864 次浏览,51 次收藏)指出,未完成的 Opus 5.5 运行首先是预算问题,其次才是模型问题;而 @0xwhrrari 补充说(59 次点赞,23 条回复,2,287 次浏览,45 次收藏)则指出,token 标价相同并不意味着 agent 账单相同,因为重试、cache 使用、输出长度,以及在第七步失败,都可能迫使你重新为前六步买单。这两条帖子下的回复最终都收敛到同一种应对方式:checkpoint、保存的笔记和 rerun 上限,比表面上的定价更重要。
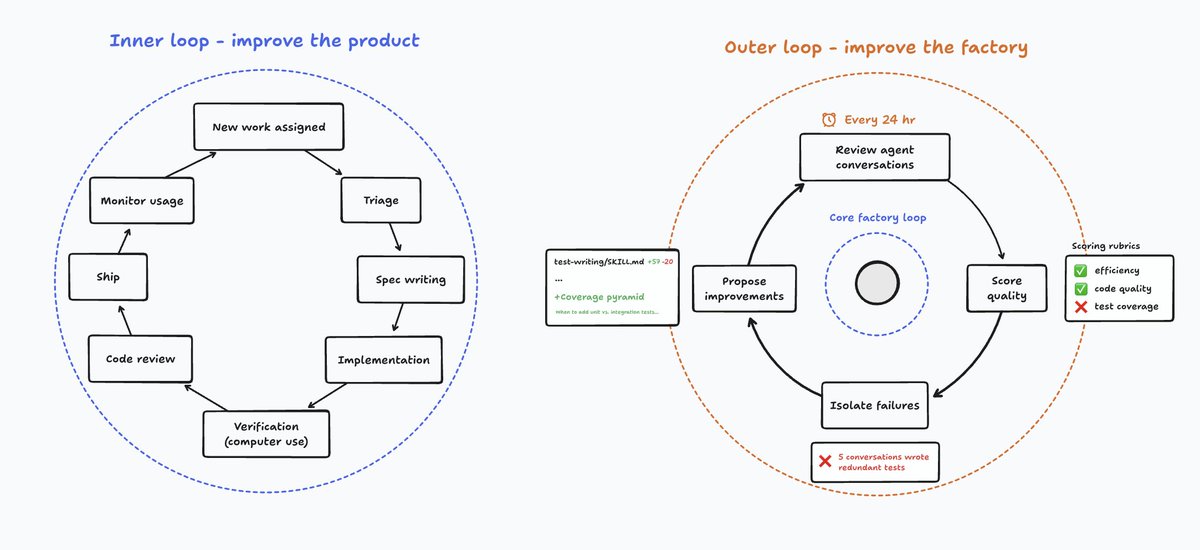
@mardehaym 认为(42 次点赞,21 条回复,3,937 次浏览)指出,余额检查、权限执行和账户检索应该放在代码里,而不是交给模型;真正相关的指标,是在计入重试、工具调用和人工审核后,每个被正确完成的 workflow 的成本。@Yarilo7brigada 解释(29 次点赞,10 条回复,432 次浏览,16 次收藏)则从 prompt 一侧讨论了同样的经济学问题,把 cache 策略拆分为 KV cache、prefix caching、provider prompt caching 和 semantic cache,其中最尖锐的一点是:如果你希望 cache 复用生效,稳定不变的 prompt 材料就应该放在最前面。@BHolmesDev 展示(20 个赞,5 条回复,1,323 次浏览,21 次收藏)还提到一个独立但相关的转向:由智能体组成的内循环负责改进产品,外循环则审查对话、评估效率和代码质量、识别不良模式,并建议新增技能或防护栏。这条帖子之所以重要,是因为它把 harness 的维护本身也视为智能体工作。
@ClaudeCodeLog 报道(118 个赞,10 条回复,8,945 次浏览,14 次收藏)称,Claude Code 2.1.292 为派生出的子智能体新增了 effort 标志,以及 marketplace 安装标志,让成本控制和工具分发成为 CLI 中更显性的界面选项,而不再是隐藏的约定。
讨论洞察: 最强的共识是,最便宜的一轮交互,就是智能体根本不必进行的那一轮。检查点、更短的验证周期、由代码处理的确定性步骤,以及明确的 effort 等级,都是为了减少浪费的循环,而不只是设法压低 token 价格。
与前一天的对比: 2026-10-05 的报告已经显示,harness 工程正在成为一门可复用的实践。到了 2026-10-06,这门实践显得更偏向财务与流程:保存状态、约束权限、把确定性工作交给代码处理、给智能体行为打分,并把 effort 公开为用户可见的调节旋钮。
1.3 专用智能体环境开始胜出:把缺失的 harness 与模型一起打包(🡕)
第三组帖子在截然不同的领域里表达了同一个观点:真正的差异化,与其说来自基础模型,不如说来自围绕模型构建的环境。信号最强的产品和研究帖子,都在讨论这样一些系统:它们已经预先具备某一类工作所需的工具、上下文、验证规则和生产工作流。
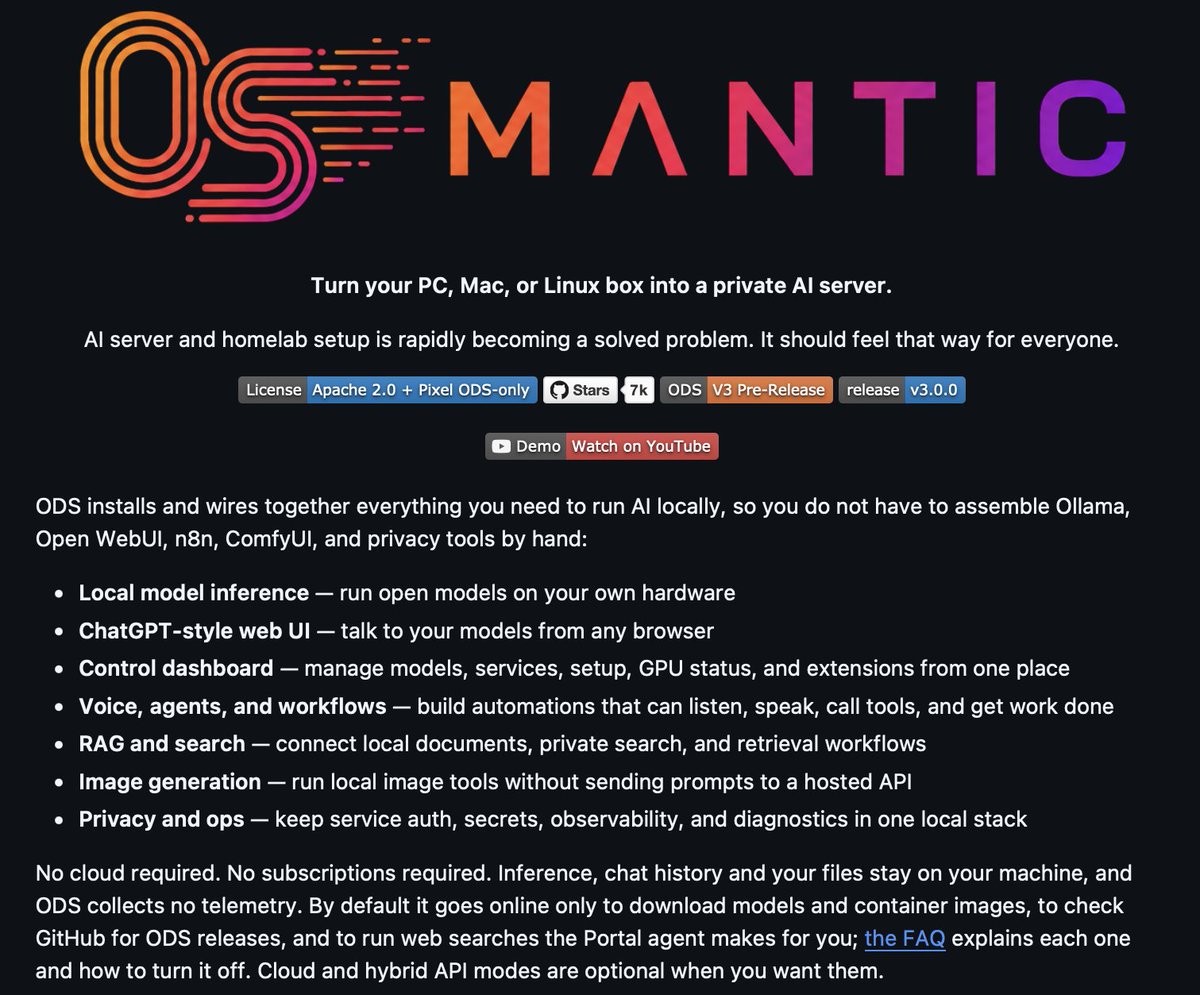
@TheAhmadOsman 推出(82 个赞,14 条回复,3,951 次浏览,54 次收藏)介绍了 ODS:一个面向 Linux、Mac 和 Windows 的一键式本地 AI 栈,能够检测硬件、下载合适的模型,并通过一个仪表盘提供本地推理、智能体、工作流、RAG、搜索、图像生成和隐私控制。与发布本身同样重要的,是其中引用的那条推文:它直接把尚未被满足的需求定义为——为普通笔记本用户提供易于使用、且所有软件都已预先配置好的本地 AI。
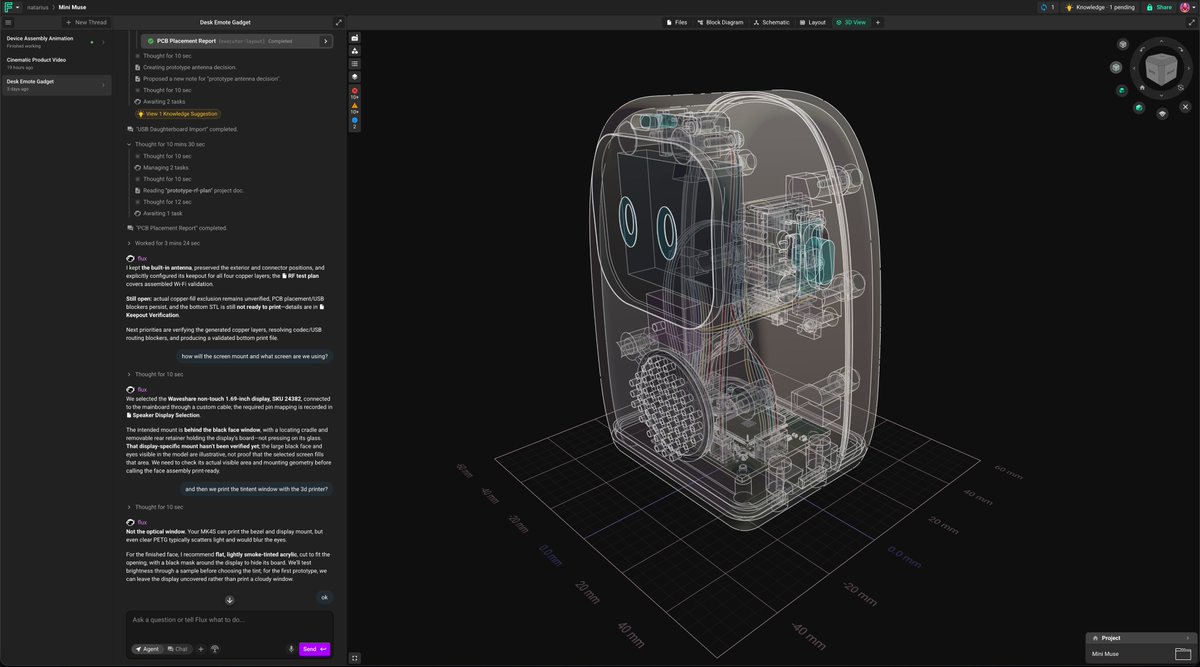
@MatthiasWagner 认为(43 个赞,3 条回复,1,803 次浏览,43 次收藏)称,Flux 之所以在硬件设计上不同于 Claude,是因为它已经内置了硬件专用的环境、工具、上下文、验证机制和执行 harness。用户大多只需回答澄清性问题,系统则处理电子设计、PCB、外壳、固件、仿真、采购和文档。这比聊天式设计辅助是强得多的主张,因为编排负担被放进了产品内部。
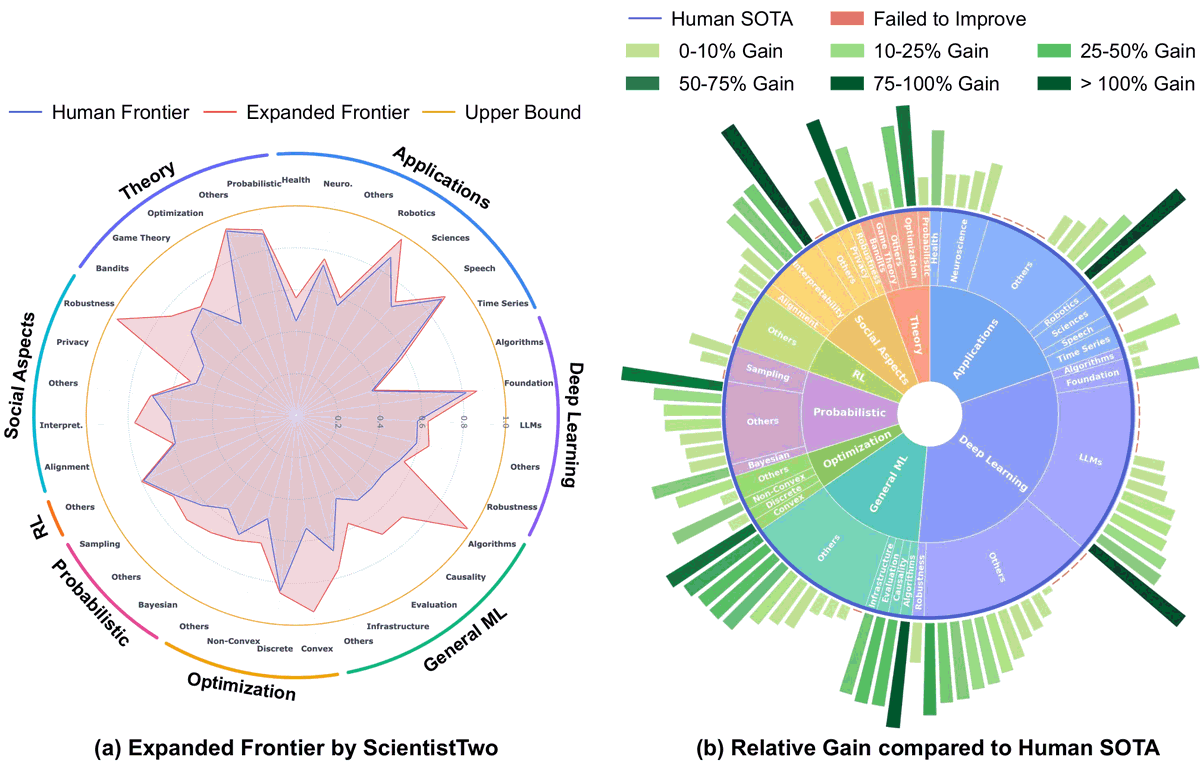
@GoogleResearch 推出(96 个赞,1 条回复,4,922 次浏览,41 次收藏)将 ScientistTwo 描述为一个自主多智能体框架,能够分析论文、识别局限,并产出经过验证的代码库。其 项目页面 为代码、实证输出、参考文献以及方法与代码的一致性增加了一层完整性审计,而发布图则可视化展示了它相对人类最先进水平的提升。
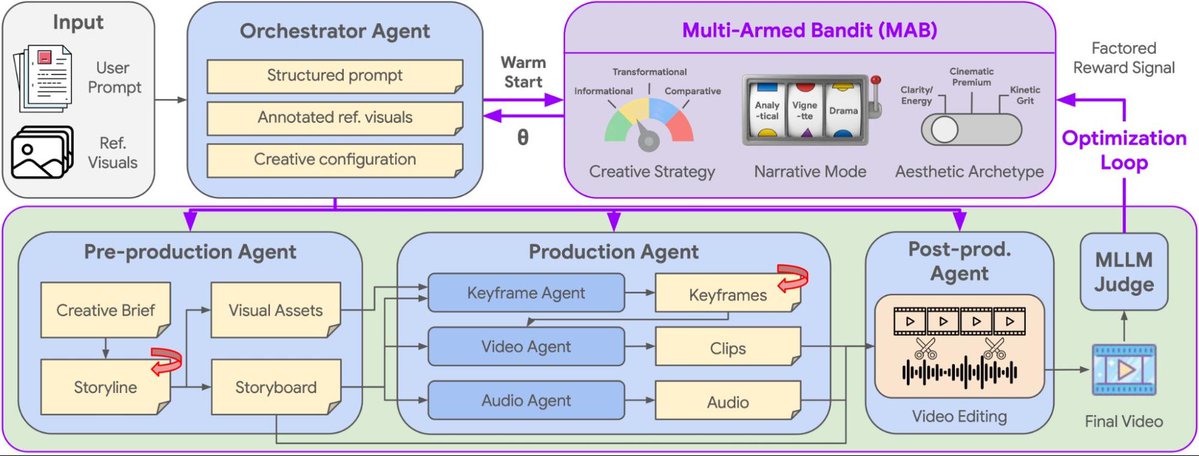
@GoogleResearch 随后推出(98 个赞,4 条回复,4,391 次浏览,34 次收藏)介绍了 Co-Director:一个分层多智能体视频系统,其中 orchestrator 负责选择创意配置,专用智能体生成关键帧、视频和音频,再由一个 MLLM 裁判为结果打分,以便迭代优化。关键点不只是 AI 视频变得更好了,而是长篇一致性正被作为一个跨智能体协调问题来攻克。
@ArtificialAnlys 评测(64 个赞,9 条回复,6,281 次浏览,20 次收藏)则把同样的设计原则用在搜索上:OpenAI Web Search 在其 Search Index 上拿到 74 分,比没有搜索能力、但底层模型相同的版本高出 41 分,因为搜索循环是内建的,而不是从外部拼接上去的。帖中图表也清楚展示了它的局限:集成式搜索进入了第一梯队,但仍落后于最强的 Perplexity 和 Octen 变体。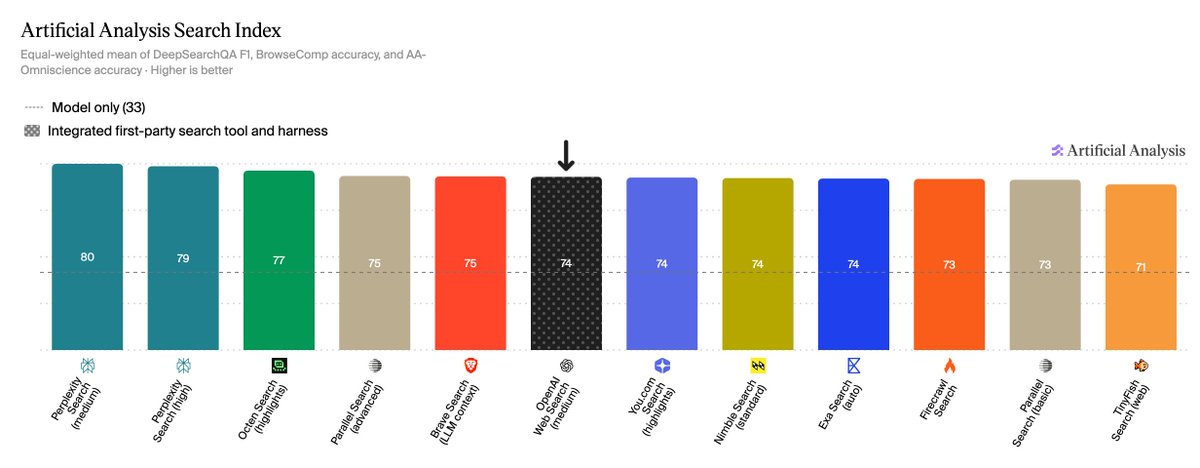
讨论洞察: 这些帖子最终都指向同一个产品层面的结论:真正有价值的部分,越来越是面向特定领域的运行层,而不只是获得一个强大模型的访问权限。ODS 承诺提供预配置的本地基础设施,Flux 隐藏了 CAD 和 EDA 的编排复杂性,ScientistTwo 内置研究验证,Co-Director 内置评审循环,而 OpenAI 的一体化搜索则直接去掉了整整一层外部支撑框架。
与前一天的对比: 在 2026-10-05,可安装层主要还是围绕编码代理的管理栈。到了 2026-10-06,这一模式已向外扩展到本地 AI 服务器、硬件设计、科学发现、视频制作和一体化搜索。
2. 什么让人沮丧
证明、验证和验收仍然比代理本身更需要工程投入
严重程度:高。@poteto 描述(557 个赞,59 条回复,20,018 次浏览,436 次收藏)指出,一个循环之所以能运转,只是因为代理外围还有验证能力、CLI、测试和 CI 在支撑;而 @beamnxw 总结(68 个赞,10 条回复,2,611 次浏览,47 次收藏)则展示了一种围绕截图、转录和可运行开发实例构建的管理模式,只有这些都具备,结果才算完成。@mardehaym 认为(42 个赞,21 条回复,3,937 次浏览)认为,权限和确定性步骤应当写进代码,而不是放进模型里。当前的变通办法,是把更多验收过程转移到测试、证明和代码强制执行的策略中。值得投入建设:高。
长时间运行的代理会话仍会因重复读取、重试和模型过大而浪费资金
严重程度:高。@beamnxw 认为(56 个赞,15 条回复,7,864 次浏览,51 次收藏)指出,如果支撑框架无法保存进度并干净恢复,未完成的 Opus 5.5 运行会在不知不觉中吞噬预算。@0xwhrrari 补充说(59 个赞,23 条回复,2,287 次浏览,45 次收藏)指出,即便输入 token 价格看起来完全相同,重试机制和缓存行为也会让代理账单出现分化;而 @Yarilo7brigada 解释(29 个赞,10 条回复,432 次浏览,16 次收藏)则说明,反复重读上下文、糟糕的提示词顺序以及缺失缓存,会让每一次循环都变成一次多付钱的事件。@ClaudeCodeLog 报道(118 个赞,10 条回复,8,945 次浏览,14 次收藏)提到一个新的按子代理划分的 effort 标志,这表明市场现在已把它视为产品功能,而不再是私下调优的小技巧。值得投入建设:高。
对普通用户来说,本地和私有代理部署仍然需要过多拼装
严重程度:中高。@TheAhmadOsman 推出(82 个赞,14 条回复,3,951 次浏览,54 次收藏)明确将 ODS 作为对这一痛点的回应:一次安装即可提供硬件检测、模型下载、本地推理、代理、工作流、RAG、搜索和隐私保护。同一线程中的引用帖子则用最直白的话表达了尚未满足的需求:普通 Apple 或 Nvidia 笔记本用户希望获得开箱即用、所有软件都已预配置好的本地 AI。当前的变通方案是像 ODS 这样的本地一体化栈,但需求信号表明,大多数人仍不想手动拼装整条工具链。值得投入建设:直接。
工程上下文仍然锁在资深人员脑中,分散在各个系统里
严重程度:中。@Hi_Mrinal 认为(120 个赞,4 条回复,2,768 次浏览,15 次收藏)指出,更高层的软件工程工作依然被把持着,因为上下文、决策和推理过程很少被文档化。当天最可信的应对帖子,都是在尝试把这些上下文外化:@nateliason 列出(169 个赞,11 条回复,14,816 次浏览,314 次收藏)提到共享知识库和跨工具记忆;而 @claudeai 报道(811 个赞,72 条回复,93,827 次浏览,241 次收藏)则展示了一个在 Slack 中运行的公司代理,把新模型的技能打包给整个团队。值得构建:高。
3. 人们希望看到什么出现
开箱即用的本地 AI 操作系统
这是当天最明确、最直接的需求。@TheAhmadOsman 推出(82 个赞,14 条回复,3,951 次浏览,54 次收藏)提到把 ODS 做成一键式本地 AI 栈,而其下方的引用推文则明确要求:为普通笔记本用户提供易用的本地 AI,并提前配好所有软件。这是实际需求,不是愿景式诉求:人们要的是隐私、本地控制,以及更少的配置步骤,而不是另一个抽象框架。机会:直接。
能改进代理本身、而不只是改进产出的外环监督器
@BHolmesDev 展示(20 个赞,5 条回复,1,323 次浏览,21 次收藏)描述了一个外环:审查代理对话、评估效率和代码质量、隔离失败原因,并提出技能调整建议;同时,@beamnxw 总结(68 个赞,10 条回复,2,611 次浏览,47 次收藏)则提出一种管理流程,把证据收集和任务看板维护视为一等工作。这里的需求,对于已经在运行大量代理的团队来说,既现实又紧迫:他们要的不只是更多“工人”,还要监督者、改进棘轮,以及作战手册更新。机会:直接。
能感知成本、自动做检查点、缓存并自动降级模型的 harness
围绕运行半途而废、反复重读上下文,以及价目表掩盖重试成本的重复抱怨,都指向一个缺失的产品层。@beamnxw 认为(56 个赞,15 条回复,7,864 次浏览,51 次收藏)提出了长任务前可复用的七层设置;@Yarilo7brigada 解释(29 个赞,10 条回复,432 次浏览,16 次收藏)讨论了缓存真正能省钱的场景;@ClaudeCodeLog 报道(118 个赞,10 条回复,8,945 次浏览,14 次收藏)则提出了面向子代理的 CLI effort 标志。这是明确的实际需求,而且用户显然愿意采用,因为他们已经在手动拼凑同样的控制机制。机会:直接。
共享的公司记忆与可传授的工程上下文
@Hi_Mrinal 认为(120 个赞,4 条回复,2,768 次浏览,15 次收藏)指出,太多工程判断没有被文档化;而 @claudeai 报道(811 个赞,72 条回复,93,827 次浏览,241 次收藏)展示了一个覆盖全公司的 Slack 代理,用来在团队内传播新模型技能。@nateliason 列出(169 个赞,11 条回复,14,816 次浏览,314 次收藏)则把一个以 GitHub 为后端的知识库加跨工具记忆,作为同一答案的一部分。这个需求既有现实层面,也有情感层面:团队希望减少把关、加快新人上手,并降低对某一位资深成员单独记住系统如何运作的依赖。机会:竞争型。
4. 正在使用的工具与方法
| 工具 | 类别 | 情绪 | 优势 | 局限 |
|---|---|---|---|---|
| Grok Bot + pstack | 代理控制平面 | (+/-) | 连接器、例程、管理循环、云代理交接 | 需要证据循环,而且在特定的 Grok Bot 与 Cursor 组合栈内效果最佳 |
| Claude Managed Agents | 团队代理平台 | (+) | 共享 Slack 代理、内部技能分发快 | 公开证据仍以案例研究为主,而不是广泛基准测试 |
| Cursor cloud agents | 编码运行时 | (+) | 云端复现、修复、模糊测试和 PR 流程 | 需要 CI、人工审查和明确的责任边界 |
| ODS | 本地 AI 栈 | (+) | 一键式私有栈、硬件检测、本地推理、RAG 和工作流 | V3 仍是预发布版本,硬件建议也可能变化 |
| Flux | 硬件设计平台 | (+) | 领域专用工具、验证、仿真、采购和文档都在同一循环中 | 专用于硬件,而非通用知识工作 |
| OpenAI Web Search | 集成搜索工具 | (+/-) | 质量提升明显,token 用量少于许多外部 API 方案,单次调用工作流 | 排名落后于最强的 Perplexity 和 Octen 变体,在多跳浏览上也更弱 |
| Prompt and prefix caching | 推理优化方法 | (+) | 大幅降低重复上下文的成本与延迟 | 基于精确 token 匹配的复用很脆弱,语义缓存也可能答错问题 |
| ScientistTwo | 研究框架 | (+) | 以局限性驱动研究、代码库经过验证、具备完整性审计 | 仍处于研究阶段,相比通用编码代理更窄 |
| AI Video Co-Director | 媒体生成框架 | (+) | 全局编排、专用子代理、用于保障长篇一致性的裁判循环 | 仍处于研究阶段,且专用于视频制作 |
| Claude Code effort flag | CLI 工作流控制 | (+) | 可预测的单个子代理 effort 与成本控制 | 又增加了一个需要团队观察和校准的调节旋钮 |
总体满意度最高的,往往是那些工具本身已经自带环境的方案。@poteto 介绍(557 个赞,59 条回复,20,018 次浏览,436 次收藏)提到,一个 Grok Bot 加 Cursor 的流程之所以有效,是因为连接器、队列、验证和合并策略都已经定义好了,而 @claudeai 报道(811 个赞,72 条回复,93,827 次浏览,241 次收藏)则将同样的思路打包成一个面向非专业用户的团队级 Slack 代理。
这一天里反复出现的变通模式非常一致:把确定性步骤写进代码,把重复上下文放到缓存层后面处理,并让人继续负责验收与例外情况。@mardehaym 认为(42 个赞,21 条回复,3,937 次浏览)提到应由代码处理权限,并按“每个正确工作流的成本”进行跟踪;@Yarilo7brigada 解释(29 个赞,10 条回复,432 次浏览,16 次收藏)解释了为什么缓存策略在架构层面至关重要;而 @ArtificialAnlys 评测(64 个赞,9 条回复,6,281 次浏览,20 次收藏)则展示了集成搜索 harness 对质量和成本能带来多大改变。
清晰可见的迁移路径,是从空白聊天式的通用交互,转向预先接好线的运行环境:如 ODS 这样的本地栈、如 Flux 这样的领域专用工作空间、如 ScientistTwo 这样的研究系统,以及如 Co-Director 这样的 judge-loop 媒体流水线。这就是当前数据所支持的竞争态势。
5. 人们在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| 基于 Claude Managed Agents 的公司代理 | 各团队,经 @claudeai 披露 | 共享的 Slack 代理,将新模型的能力打包给整个团队,后续也可提供给订阅用户 | 避免每位员工都各自重复摸索同样的模型使用方式 | Claude Managed Agents、Slack | 已发布 | 引用帖子中描述了公开推出情况 |
| ODS | Osmantic,经 @TheAhmadOsman 披露 | 面向代理、工作流、RAG、搜索和图像生成的一键式本地 AI 服务器与控制面板 | 免去运行私有本地 AI 时手动拼装各组件的负担 | 本地推理、Open WebUI、n8n、ComfyUI、隐私工具 | Beta | 代码库 |
| Flux | Build with Flux,经 @MatthiasWagner 披露 | AI 原生的硬件设计工作空间,可处理电子设计、PCB、外壳、固件、采购和文档 | 取代在 CAD、EDA、仿真和制造工具之间的手动编排 | 云端 CAD 与 EDA 环境、仿真、采购、固件、文档 | 已发布 | 网站 |
| ScientistTwo | Google Research | 自主研究系统,可阅读论文、发现局限、运行实验并产出经验证的代码库 | 将科学迭代与可复现性转化为代理工作流 | 多代理研究流水线、完整性审计、代码验证 | Alpha | 项目、论文 |
| AI Video Co-Director | Google Research | 用于实现连贯长篇视频叙事的分层多代理流水线 | 让多镜头叙事在视觉和语义上保持一致 | 编排器、多臂老虎机规划器、关键帧/视频/音频代理、MLLM judge | Alpha | 博客 |
| 外环软件工厂 | @BHolmesDev | 审查代理对话、为质量打分、隔离故障并提出技能改进建议 | 帮助代理团队改进工厂本身,而不只是产品 | 定时审查代理、评分标准、技能差异、护栏 | Alpha | 引用帖子中描述了这一公开模式 |
常见的构建模式,是把缺失的那一层产品化,而不只是提供一个更好的模型。@claudeai 报道(811 个赞,72 条回复,93,827 次浏览,241 次收藏)展示了一个公司代理,如何把模型使用经验转化为团队共享接口;而 @TheAhmadOsman 介绍(82 个赞,14 条回复,3,951 次浏览,54 次收藏)则将 ODS 做成预先接好线的本地栈,而不是一堆彼此分散的应用。@MatthiasWagner 认为(43 个赞,3 条回复,1,803 次浏览,43 次收藏)说明,Flux 在硬件领域之所以重要,原因完全相同:它已经内置了所需的工具、产物和验证流程。
第二种常见的构建模式,是在生成循环之上再加一层 judge loop。@GoogleResearch 介绍(96 次点赞,1 条回复,4,922 次浏览,41 次收藏)中的 ScientistTwo 带有研究验证和代码完整性检查;@GoogleResearch 跟进(98 次点赞,4 条回复,4,391 次浏览,34 次收藏)则把 Co-Director 的编排与评审结构用于长视频;以及 @BHolmesDev 展示(20 次点赞,5 条回复,1,323 次浏览,21 次收藏)将同样的直觉用在了编码智能体本身。反复触发构建的原因并非原始生成质量,而是需要让专业化工作在长期迭代中保持连贯、可检查、可改进。
6. 新动态与看点
OpenAI Web Search 以集成式智能体循环进入基准讨论
@ArtificialAnlys 评测(64 次点赞,9 条回复,6,281 次浏览,20 次收藏)显示,OpenAI Web Search 在 Artificial Analysis Search Index 上得分 74,比不带搜索的同一底层模型高出 41 分。这一点之所以重要,是因为该对比明确考察的是:当搜索循环内建于产品中,而不是由外部编排时,会出现什么变化。
ODS 把本地智能体栈变成了一键式产品方案
@TheAhmadOsman 介绍(82 次点赞,14 条回复,3,951 次浏览,54 次收藏)将 ODS 描述为一套本地 AI 栈:可检测硬件、选择模型,并通过一个控制面板提供智能体、工作流、RAG、搜索、图像生成和隐私控制。值得注意的不只是功能列表,更在于这次发布直接回应了一项被引用的需求:为普通笔记本用户提供预配置的本地 AI。
Claude Code 将每个子智能体的 effort 公开为一等控制项
@ClaudeCodeLog 报道(118 次点赞,10 条回复,8,945 次浏览,14 次收藏)称,Claude Code 2.1.292 为派生出的子智能体新增了 effort 标志,并支持从 marketplace 安装。这之所以值得关注,是因为它把成本和分发控制从隐藏的约定中移了出来,变成了 CLI 中可见的调节项。
“改进工厂”这一思路变得明确
@BHolmesDev 展示(20 次点赞,5 条回复,1,323 次浏览,21 次收藏)提出了一个外循环,用于审查智能体对话并提出技能改进建议;同时,@GoogleResearch 介绍(96 次点赞,1 条回复,4,922 次浏览,41 次收藏)将 ScientistTwo 作为一个带有自身完整性审计的研究系统。其共同的新意在于,越来越多的构建者正把智能体的算力投入到评估和纠正其他智能体的工作上。
7. 机会在哪里
[+++] Acceptance, proof, and outer-loop QA for agent fleets — @poteto 介绍(557 次点赞,59 条回复,20,018 次浏览,436 次收藏)展示了一个依赖验证技能、测试和 CI 的循环;@beamnxw 总结(68 次点赞,10 条回复,2,611 次浏览,47 次收藏)展示了强调证明的管理者工作流;而 @BHolmesDev 展示(20 次点赞,5 条回复,1,323 次浏览,21 次收藏)则是智能体审查其他智能体。证据表明,市场仍缺少一个可复用的层,用来判断一项工作何时才算真正完成。[+++] Cost-aware harness infrastructure — @beamnxw 认为(56 个赞,15 条回复,7,864 次浏览,51 次收藏)提到在长任务开始前采用七层设置,@0xwhrrari 补充(59 个赞,23 条回复,2,287 次浏览,45 次收藏)指出,重试对账单的影响比标价更大,而 @ClaudeCodeLog 报道(118 个赞,10 条回复,8,945 次浏览,14 次收藏)则提到一个面向子代理的新 effort 调节选项。这有力表明,默认具备检查点、缓存、重路由和优雅降级能力的产品更有机会。
[++] Turnkey private and local agent operating systems — @TheAhmadOsman 介绍(82 个赞,14 条回复,3,951 次浏览,54 次收藏)直接对应了一个被明确提出的需求:在普通硬件上部署预配置的本地 AI。这种需求很务实,与隐私相关,也比许多抽象的代理平台更容易讲清楚。
[++] Shared company memory and teachable skill distribution — @claudeai 报道(811 个赞,72 条回复,93,827 次浏览,241 次收藏)展示了一个在 Slack 内部使用的公司代理,而 @Hi_Mrinal 认为(120 个赞,4 条回复,2,768 次浏览,15 次收藏)则指出,太多资深人员的推理过程仍未被文档化。这里的机会属于中等水平,因为很多团队都切实感受到这种痛点,但解决方案将不得不与内部 wiki、聊天工具以及新兴的托管代理平台竞争。
[+] Domain-specific agent environments with embedded judges — @MatthiasWagner 认为(43 个赞,3 条回复,1,803 次浏览,43 次收藏)面向特定硬件环境,而 @GoogleResearch 介绍(96 个赞,1 条回复,4,922 次浏览,41 次收藏)提到 ScientistTwo,以及 跟进(98 个赞,4 条回复,4,391 次浏览,34 次收藏)配合 Co-Director。这个信号正在浮现,因为这种模式很有说服力,但大多数案例仍停留在研究阶段或早期专业化产品阶段,而不是广泛部署。
8. 要点
- 实际进展的实用单位是运作闭环,重点不在单个代理。 @poteto 介绍(557 次点赞,59 条回复,20,018 次浏览,436 次收藏)讨论的是嵌入 Slack、CRM、Linear 和 PR 流程中的代理,而 @claudeai 报道(811 次点赞,72 条回复,93,827 次浏览,241 次收藏)则展现了同样的模式,只是形态变成了团队级 Slack 代理。
- 如今,衡量 Harness engineering 的标准,已不只是提示词质量,还包括浪费掉的重试次数、佐证工件和审批路径。 @beamnxw 论证了(56 次点赞,15 条回复,7,864 次浏览,51 次收藏)指出,未完成的长时间运行会吞噬预算,而 @mardehaym 论证了(42 次点赞,21 条回复,3,937 次浏览)则认为,正确的指标应是每个被正确完成的工作流成本。
- 将编排隐藏在领域专用环境背后的产品,正在获得最清晰的叙事优势。 @TheAhmadOsman 提出了(82 次点赞,14 条回复,3,951 次浏览,54 次收藏)将 ODS 描述为一个预先配置好的本地技术栈,而 @MatthiasWagner 论证了(43 次点赞,3 条回复,1,803 次浏览,43 次收藏)则表示,Flux 之所以重要,是因为硬件 harness 已经内置在产品之中。
- 集成式工具的表现,完全可能显著优于同一模型在没有这些工具辅助时的表现。 @ArtificialAnlys 进行了基准测试(64 次点赞,9 条回复,6,281 次浏览,20 次收藏)显示,当搜索直接内置到 OpenAI 工作流中,而不是从外部接入时,得分提升了 41 点。
- 越来越多的构建者正在使用代理来监督、评分、并改进其他智能体。 @BHolmesDev 表明了(20 个赞、5 条回复、1,323 次浏览、21 个收藏),一个用于评估智能体对话的外循环;以及 @GoogleResearch 提出了(96 个赞、1 条回复、4,922 次浏览、41 个收藏),带有显式完整性检查的 ScientistTwo。