Twitter AI 智能体 - 2026-10-08
1. 人们在讨论什么
1.1 运营型智能体正变成按计划工作的同事和面向部门的队友(🡕)
2026-10-08 最明显的变化,是讨论焦点从智能体技术转向智能体在组织中的定位。多条高信号帖子都把智能体当作一个有名字、有凭证、有记忆,并在真实工作流中承担单一职责的队友:每日简报撰写者、营销运营经理、移动应用实施者,或共享 Workspace 中的协作同事。相比 2026-10-07 对子智能体管理器和可复用技能包的强调,讨论又向组织设计更近了一步。
@ClaudeDevs 分享(131 次点赞,14 条回复,11,353 次浏览,133 次收藏)一个 Claude Managed Agents 参考流程:按计划读取 Slack 和 GitHub,跟踪自上次运行以来的变更,并发布简报。关联的 博文 让这种操作模式更具体了:限定在 vault 作用域内的凭证、按来源分别保存的书签、持久记忆,以及对智能体可读写内容的明确护栏。
@NewsFromGoogle 宣布(263 次点赞,17 条回复,26,679 次浏览,48 次收藏)Gemini at Work 被描述为 Gmail、Drive、Docs、Slides、Sheets、Chat 和 Calendar 中的“通用工作智能体”。关联的 发布文章 进一步把这一说法扩展为拥有独立 Workspace 身份、由 Knowledge Catalog 提供 grounding、并基于 Agent Gateway 进行治理的协作型智能体,这让讨论从聊天助手推进到了原生工作执行。
@wlhunter25 表示(61 次点赞,9 条回复,9,398 次浏览,96 次收藏)Cognition 已经让它的第一位营销运营经理入职,并将其命名为 Devin。就连回复也很有启发:任务会一直留在智能体手里,直到需要升级处理时,才转入 Linear,这意味着这不是演示,而是真正的分工。
@BHolmesDev 描述(101 次点赞,19 条回复,4,163 次浏览,116 次收藏)一个 iOS“软件工厂”,由 Linux 主管协调基于 Mac 的实施者和 Linux 审核者,在工作交付给团队之前,先经过截图和对抗式审查循环。附带的架构图之所以重要,是因为它展示了不同机器和证据检查点如何按角色分配,而不是默认隐含存在。

讨论洞察: 回复不断落回同一个尚未解决的问题:一旦智能体拥有记忆、凭证和行动权限,在人类信任其输出之前,它需要拿出什么样的证明?相比模型原始能力,关于摘要优先级、截图是否足够,以及权限范围的问题更常出现。
与前一天相比: 在 2026-10-07,讨论集中在子智能体管理器、技能和外层循环上。到了 2026-10-08,这些模式被重新表述为真正的同事、定时任务和面向部门的角色。
1.2 Harness 工程正围绕 route-check-escalate 循环形成标准(🡕)
关于 harness 的讨论依旧热烈,但语气已从抽象哲学转向可复用工件。多条帖子都把智能体运行收敛为同一组小步骤:设定边界清晰的目标,把工作路由给合适的模型或执行者,用证据验证,并把下一状态清晰地交接出去。胜出的帖子并不是最长的,而是最能让这个循环具备可移植性的。
@RoundtableSpace 分享(43 次点赞,6 条回复,54,819 次浏览,42 次收藏)一个改写自 Karpathy 风格的 harness 提示词,要求 Claude 保留上下文、执行检查、记录进展,并以明确的下一步行动结束。这张图片基本上就是一页纸的长周期编码工作操作手册。

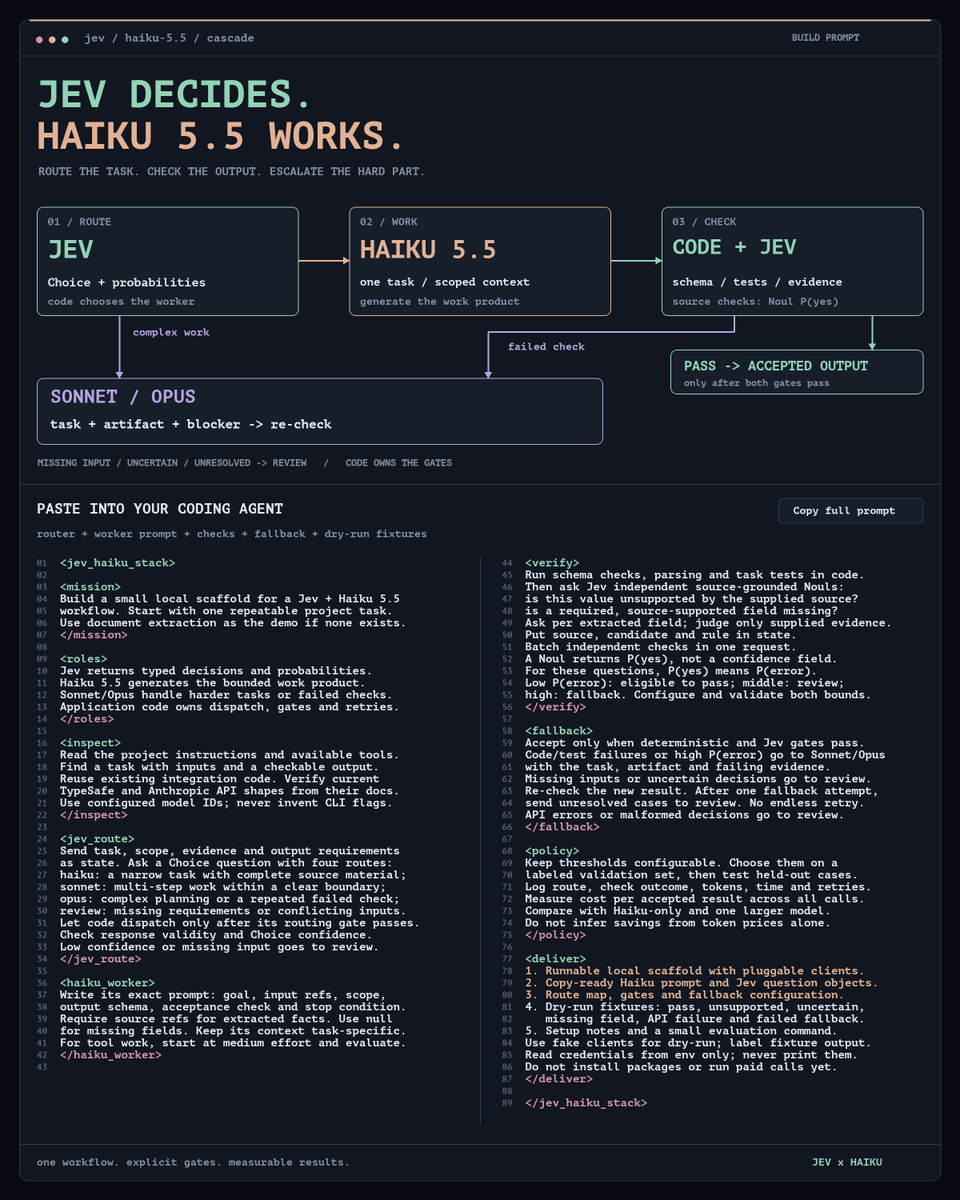
@ArchiveExplorer 认为(14 次点赞,349 次浏览,12 次收藏)“Jev 做决策,Haiku 5.5 干活”,其中 Jev 负责路由和检查,Haiku 处理有明确范围的工作,只有当任务存在歧义或检查失败时,才由 Sonnet 或 Opus 接手。这让模型路由看起来不再像品牌偏好,而更像显式的工作流设计。
@mr_kozh 总结(12 次点赞,539 次浏览,11 次收藏)同样的模式,被提炼成一个更简单的清单:目标、上下文、计划、工具、边界、验证、交接。@harrysolovay 分享(5 个赞,3 条回复,206 次浏览,3 个收藏)展示了一个仍在开发中的 traits 系统,可将来之不易的反馈沉淀为 Markdown 规则,供下一轮运行复用;而 @Marlenuii 列出(18 个赞,4 条回复,396 次浏览,14 个收藏)则将 Agent Framework 和 Mem0 作为编码 Agent 栈外围的编排层与记忆层。
讨论洞察: 最有价值的分歧并不在于“要不要 harness”,而在于 harness 在什么位置会变得过重。回复中有人警告,缺少停止条件会让“继续执行”变成无声无息的 token 消耗;也有人指出,外部中间件可能引入上下文同步延迟,反而抵消更强编排所带来的收益。
与前一日对比: 在 2026-10-07,争论焦点还是更强的模型是否会降低对 harness 的需求。到了 2026-10-08,占上风的观点已更为聚焦:保持循环尽可能小,明确验证步骤,只把真正棘手的部分向上路由。
1.3 Agent 讨论进一步进入受监管行业与实体产业(🡕)
第三个主题是应用领域的持续扩展。这一天讨论的已不只是编码 Agent 或个人 Copilot。角度最鲜明的帖子,将 Agent 工作流映射到制造业、法律服务、企业分析,以及其他那些信任、合规和采购要求会立刻产生影响的环境中。
@OSHBuilt 认为(412 个赞,60 条回复,23,272 次浏览,318 个收藏)提出,制造企业最终会发布类似 MCP 的能力与定价接口,供 Agent 直接查询 DFM、交付周期和采购信息。回复则进一步点明了真正的障碍:一旦每家工厂都成了一个 API 端点,身份验证、包审查、性能记录以及 CMMC 式合规就不再是次要问题,而会直接成为产品本身的一部分。
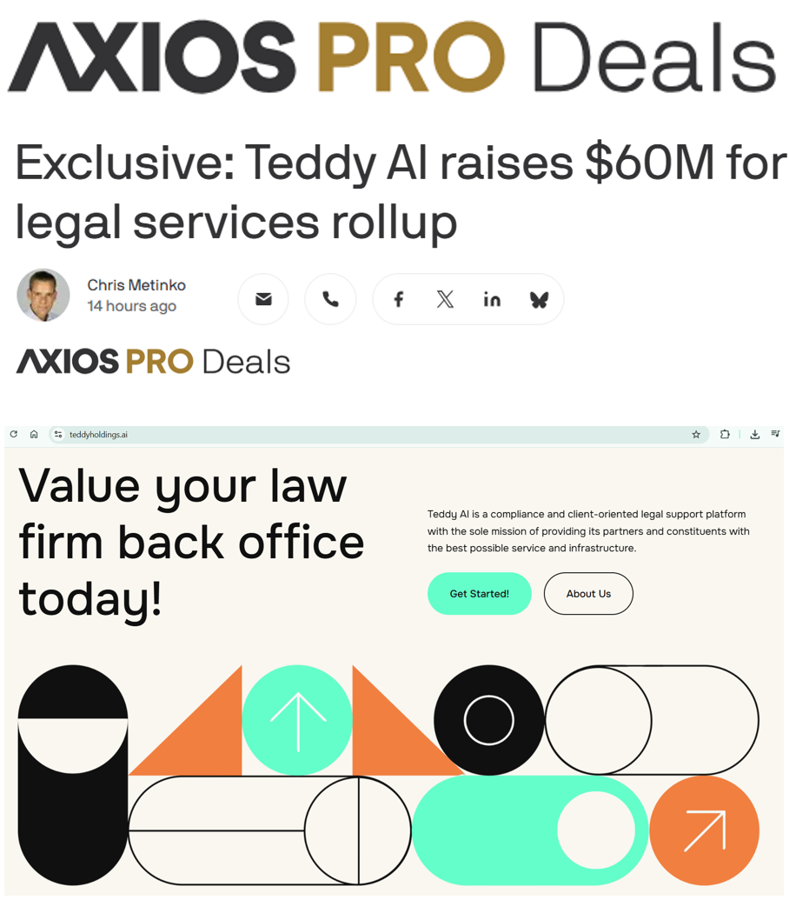
@kylehtucker 发布(32 个赞,9 条回复,2,739 次浏览,12 个收藏)是一张关于 Teddy AI 的截图,涉及一个处于孵化阶段的法律服务平台。单看这条推文,只能看到品牌信息和融资叙事;而链接的 Business Wire 新闻稿 则补充了更关键的事实:Teddy AI 作为一个聚焦合规的法律服务平台,已完成 6000 万美元种子轮融资,营收超过 2500 万美元。
Google Cloud 的 Gemini at Work 发布文章 则从市场另一端推动了同样的趋势。它将面向金融服务和法律行业的垂直 Agent 技能,与身份、审计和策略控制并列呈现,这表明垂直专业化如今正与治理能力一同交付,而不是事后补上。
讨论洞察: 有意思的是,行业讨论几乎立刻就转向了政策讨论。每当 Agent 进入工厂、法律工作流或企业数据场景,回复都会马上追问身份验证、信任记录、权限以及合规边界。
与前一日对比: 2026-10-07 的讨论已经暗示 Agent 正在成为基础设施。到了 2026-10-08,这场讨论进一步深入到那些基础设施必须同时满足监管、采购和现实运营要求的行业。
1.4 Agent 经济学成为一等议题,从 CPU 预算到市场利润率(🡕)
围绕 Agent 经济学的讨论也变得更精确了。高信号帖子不再泛泛而谈“agent economy”的兴奋,而是开始尝试建模:要么估算 Agent 背后的算力负担,要么分析让 Agent 销售劳动成果的单位经济效益。
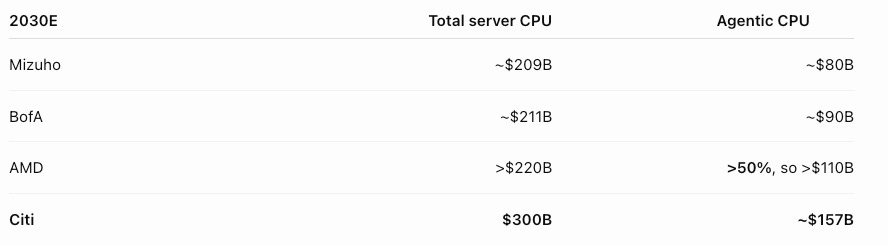
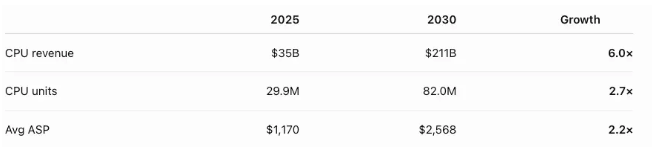
@FredaDuan 修订(65 个赞,7 条回复,12,365 次浏览,89 个收藏)在公开质疑出现后修正了她的算力框架,并表示大多数反馈集中在这样一个区间:当日活用户达到 1 亿时,独立或 Agent CPU 需求大约在 0.2–0.3GW,高于她最初的估计。附带的表格之所以重要,是因为它们让这个论点能以基础设施语言被理解:如果到 2030 年,AI 将服务器 CPU 的 TAM 推高到 2110 亿至 3000 亿美元,那么“agentic CPU”这一部分就不再只是个可忽略的零头。
在市场层,@elenalin01 认为(34 个赞、33 条回复、531 次浏览、21 次收藏、23 次引用)指出,智能体即使通过了评估,仍可能因为找不到第一个客户而失败;而 @ryuken_tz 认为(52 个赞、44 条回复、272 次浏览)则认为,较低的抽成比例或许恰恰是让小型智能体任务得以成立的关键。@mtave0128 表示(39 个赞、39 条回复、315 次浏览)认为,最终形态甚至未必是一个独立的 marketplace 页面:交易可能会收缩为嵌入 Claude Code、Cursor 或类似智能体环境中的技能层或 API 层。即便是在带有宣传意味的讨论簇中,@mdshefat217 指出(10 个赞、9 条回复、141 次浏览)也指出,已结算任务数量和 GMV 仍不足以自动证明存在独立需求。
讨论洞察: 最好的交易类帖子讨论的并不是“智能体经济”这个口号本身,而是三个具体问题:谁来带来客户、任务小到什么程度仍能覆盖推理成本,以及胜出的载体究竟会是网站还是嵌入式 API。
与前一日对比: 在 2026-10-07,交易讨论聚焦于身份、托管和争议处理流程。到了 2026-10-08,话题扩展到分发、最小可行客单价,以及 marketplace 是否应当消失并融入智能体工作流本身。
2. 什么让人沮丧
证明智能体确实完成了工作
最尖锐的挫败感并不在于生成质量,而在于证据质量。@BHolmesDev 描述(101 个赞、19 条回复、4,163 次浏览、116 次收藏)展示了一个依赖截图和反复审核循环、直到人类接受变更的移动端工作流;其中一条回复指出,截图无法证明诸如预取之类的非可视化工作。@ClaudeDevs 分享(131 个赞、14 条回复、11,353 次浏览、133 次收藏)展示了一个定时智能体参考实现,但回复很快追问:智能体如何判断什么重要,以及如何测试它是否做出了正确选择。@RoundtableSpace 分享(43 个赞、6 条回复、54,819 次浏览、42 次收藏)展示了一个“完成任务”测试框架,而一条回复警告说,缺少停止条件只会让它在循环中白白消耗 token。人们目前靠截图、日志、源码检查和明确交接来应对,但验收负担依然很高。值得投入建设:高。
一旦智能体可以采取行动,权限、信任与合规就会成为难点
涉及物理世界和企业场景的帖子几乎立刻演变成了安全讨论。@OSHBuilt 认为(412 个赞、60 条回复、23,272 次浏览、318 次收藏)提出,制造工厂将发布类似 MCP 的能力接口,但回复则追问:谁可以调用这些系统、软件包如何审核、信任历史存放在哪里,以及这一切在 CMMC 式合规要求下如何运作。同样的压力也以软件形式出现:当 @ClaudeDevs 分享(131 个赞、14 条回复、11,353 次浏览、133 次收藏)提到始终在线的托管智能体时,回复则聚焦于无人值守凭证,以及,@NewsFromGoogle 宣布(263 次点赞、17 条回复、26,679 次浏览、48 次收藏)提到,Gemini at Work 将治理、审计和身份认证作为核心功能前置,而不是事后补上的附加项。挫败感已经很明显:一旦智能体离开 IDE,安全策略就成了产品可用性的一部分。值得投入建设:高。
在智能体市场中,分发依然比评估更难
最强烈的商业抱怨是:技术能力并不天然带来需求。@elenalin01 认为(34 次点赞、33 条回复、531 次浏览、21 次收藏、23 次引用)指出,智能体即使通过了评估,仍可能失败,因为它找不到第一个客户;还有一条回复将问题概括为“分发才是瓶颈”。@ryuken_tz 认为(52 次点赞、44 条回复、272 次浏览)表示,只有抽成比例足够低,小型智能体任务才有可行性;而 @mtave0128 表示(39 次点赞、39 条回复、315 次浏览)则认为,胜出的商业层或许会融入 Claude Code 或 Cursor,而不是继续以独立市场页面的形式存在。即便是持支持态度的讨论,也带有保留意见:@mdshefat217 指出(10 次点赞、9 条回复、141 次浏览)指出,已结算任务数和 GMV 的增长,仍不能证明存在独立需求。值得投入建设:中高。
目前仍无人能说清,大规模智能体的真实算力账单究竟是多少
基础设施成本的计算仍未形成定论。@FredaDuan 修订(65 次点赞、7 条回复、12,365 次浏览、89 次收藏)在遭到质疑后修正了她的框架,并表示,面向 1 亿日活用户时,独立或智能体 CPU 的成本估算明显高于她最初给出的数字。这个问题之所以重要,也体现在路由相关的帖子中:@ArchiveExplorer 认为(14 次点赞、349 次浏览、12 次收藏)讨论了 Jev 如何判断什么时候 Haiku 5.5 已经够用,以及什么时候需要将更难的情况升级处理。共同的挫败感在于不可预测。人们不只是想要更低的价格;他们还想要一种可靠的方法,判断什么时候一项任务值得用更强的模型、更多步骤,或更多基础设施。值得投入建设:高。
3. 人们希望出现什么
能随智能体一同流转的验证与交接层
围绕 harness 的帖子都指向了同一个现实缺口:人们想要一种可复用的方法,用来证明发生了什么、记录改动了什么,并把下一步交给下一次运行或人工处理。@RoundtableSpace 分享(43 次点赞、6 条回复、54,819 次浏览、42 次收藏)展示了一种会明确记录进展和后续行动的提示词;@mr_kozh 下调(12 次点赞、539 次浏览、11 次收藏)将 harness 归纳为目标、上下文、计划、工具、边界、验证与交接;而 @BHolmesDev 表示(101 次点赞、19 条回复、4,163 次浏览、116 次收藏)则说明了这件事在实践中为何重要:当实现者、审查者和人工都需要检查同一份工作时,这一点尤其关键。这是一个现实而紧迫的需求。虽然已经有一些局部答案,但它们仍分散在提示词、图表和定制化审查循环中。机会:直接。
跨工具、跨团队的共享记忆与声明式智能体状态
记忆问题如今已不再被表述为“更好的聊天记录”,而是被视为基础设施。@JeremyCMorgan 分享(9 次点赞、4 条回复、358 次浏览)将 kg-memory 视为 Claude Code 和 Codex 的共享知识图谱,@learnk8s 分享(7 次点赞,2 条回复,463 次浏览,4 次收藏)提到 Hermes Agent Operator,让 agent 的配置、技能和工作区都能放进同一个 Kubernetes manifest;以及 @harrysolovay 分享(5 次点赞,3 条回复,206 次浏览,3 次收藏)提到一种 traits 系统,可将反复出现的反馈转化为可复用的代码库规则。这主要是现实层面的需求,但也带有情绪层面:团队希望更少漂移、更少遗忘、更少重复解释。机会:直接。
内置身份、策略与审计的垂直连接器
企业和工业领域的帖子表明,一旦涉及资金、合规或物理运营,通用型 agent 外壳就不够用了。@NewsFromGoogle 宣布(263 次点赞,17 条回复,26,679 次浏览,48 次收藏)提到一款原生于 Workspace 的 agent,具备身份、治理和领域数据能力;而 @OSHBuilt 认为(412 次点赞,60 条回复,23,272 次浏览,318 次收藏)则提到了面向 agent 的制造业 API,并立刻收到了关于身份验证和合规的回复。人们似乎想要的不只是“能力更强的 agent”,而是已经理解特定领域策略边界的连接器。机会:竞争激烈。
面向 agent 的内嵌需求与交易通道
市场平台相关的帖子指出,在“这个 agent 能用”和“这个 agent 能接到活”之间,还缺失了一层。@elenalin01 认为(34 次点赞,33 条回复,531 次浏览,21 次收藏,23 次引用)指出,评估不等于分发;@ryuken_tz 认为(52 次点赞,44 条回复,272 次浏览)指出,只有当费用足够低时,微型任务才真正可行;而 @mtave0128 指出(39 次点赞,39 条回复,315 次浏览)指出,未来这一层或许会直接嵌入编码环境,而不是作为独立入口存在。这是一个紧迫的现实需求,但目前的证据仍主要来自生态系统内部的倡导者,而非中立的运营方。机会:竞争激烈。
4. 在用的工具与方法
| 工具 | 类别 | 情绪倾向 | 优势 | 局限 |
|---|---|---|---|---|
| Claude Managed Agents | 定时 agent 运行时 | (+) | 可按计划运行,支持记忆、范围受限的凭证和来源书签 | 一旦脱离人工值守,立刻会引发权限和优先级问题 |
| Gemini at Work | 企业工作 agent | (+/-) | 可在 Workspace 内联执行,具备同事身份、治理和领域数据能力 | 正在分阶段推出,最宽泛的说法仍需运营方证据支持 |
| Jev + Haiku 5.5 cascade | 路由 / 决策层 | (+) | 用较小模型处理范围明确的工作,并明确升级复杂案例 | 依赖高质量检查,也可能增加编排开销 |
| Hermes Agent Operator | 部署 / 平台 | (+) | 以声明式 Kubernetes 资源承载 agent 配置、技能、工作区和调度 | 目前证据仍偏早期,并且默认团队已熟悉 Kubernetes |
| kg-memory | Agent 记忆 | (+) | 在编码 agents 之间共享本地知识图谱,持久保存事实与关系 | 目前项目体量还小;价值取决于是否得到谨慎维护 |
| Microsoft Agent Framework + Mem0 | 编排 + 记忆 | (+/-) | 在社区技术栈中,清晰区分编排与持久记忆 | 回复中已提醒,中间件同步成本本身可能成为瓶颈 |
整体方法图景相当务实。团队并没有押注单一的完全自主 agent,而是在混合使用定时运行、范围受限的凭证、持久状态和升级规则。围绕信任问题,最常见的变通做法依然是明确收集证据和分配狭窄角色,而不是盲目委托。
5. 人们正在构建什么
| 项目 | 构建者 | 功能 | 解决的问题 | 技术栈 | 阶段 | 链接 |
|---|---|---|---|---|---|---|
| 托管的每日报简报 agent | @ClaudeDevs | 按计划运行,读取 Slack 和 GitHub,并发布摘要 | 无需每次都由人工驱动,也能自动完成重复性的内部状态工作 | Claude Managed Agents、vault 范围受限凭证、书签、记忆存储 | Beta | 推文, 博客 |
| iOS 软件工厂 | @BHolmesDev | 使用 Linux foreman、Mac implementer 和 Linux reviewer 来交付移动端变更 | 在保留模拟器和评审证据闭环的同时,加快移动开发速度 | Linux 容器、Mac 云机器、Slack intake、截图、消息传递 | Alpha | 推文 |
| Teddy AI | @kylehtucker | 面向合规的法律服务平台,已获得可观融资并实现营收 | 法律服务吞吐量,以及合规要求高的客户工作 | 引用材料中未公开披露技术栈 | 已上线 | 推文, Business Wire |
| kg-memory | @JeremyCMorgan | 为 Claude Code 和 Codex 提供共享的本地知识图谱 | 在不同代理运行和工具之间保留项目记忆 | Python、本地知识图谱、类型化节点与边 | Alpha | 推文, 代码库 |
最强的构建模式是“代理加脚手架”,而不是单靠独立模型的小聪明。那些更接近生产环境的案例,无一例外都叠加了记忆、权限、快照、截图或声明式部署等额外层。
另一个反复出现的模式是垂直收窄。Claude 的托管式简报、Teddy AI 的合规定位,以及 BHolmes 的移动工厂,都各自聚焦于边界清晰的工作:输入明确、输出可校验,而不是一开始就试图做通用助手。
6. 新的值得关注的动向
主权型和公共部门代理部署变得更具体
@bosuntijani 宣布(126 次点赞、4 条回复、4,782 次浏览、80 次收藏)提到了围绕尼日利亚多语种开源模型展开的 N-ATLAS Innovation Challenge,而回复几乎立刻就问到了数据驻留和 REST API 访问。@PriyankKharge 强调(51 次点赞、5 条回复、1,503 次浏览)提到了 BHASHINI 在卡纳塔克邦公共服务工作流中的使用,这让“用于工作的代理”看起来越来越依赖本地语言基础设施和政府服务交付,而不只是企业聊天。
端侧运行时和记忆栈变得更清晰
@Krivoblotsky 分享(11 次点赞、2 条回复、50,480 次浏览)公布了 MacPaw 的 Elix 和 Mnemos 的公开基准测试。链接页面把原本模糊的端侧 AI 叙事拆解成了更清晰的栈:Elix 是本地运行时,Mnemos 则是带引用的记忆知识图谱。
7. 机会在哪里
[+++] 代理验证与交接基础设施 —— 这一需求在 Claude Managed Agents、BHolmes 的软件工厂,以及那些 route-check-escalate harness 帖子中反复出现。团队想要可复用的证明、可恢复的执行流程,以及对“到底完成了什么”的可靠回答。
[++] 具备策略感知连接器的企业部署工具包 —— Gemini at Work、OSHBuilt 的制造业主题帖,以及 Teddy AI 都指向同一种需求:连接器需要原生理解权限、身份、别名和合规边界。
[+] 共享记忆与声明式代理状态 —— kg-memory、Hermes Agent Operator,以及 traits 风格的仓库规则都表明,对持久记忆和可复现代理配置的需求正在浮现,但采用情况看起来仍处于早期。
8. 要点
- 关于代理的讨论,已经从架构层面的讨论转向组织分工层面的讨论。 最有用的证据关乎明确命名的角色、定时任务和边界清晰的职责,而不是抽象的自主性。(Claude Managed Agents, Cognition marketing ops) 2.验证仍是真正的关键门槛。 在信任结果之前,团队依然要依赖截图、审查回路、明确的交接流程,以及权限受限的凭证。(BHolmesDev,RoundtableSpace)
- 垂直领域的采用很快就会转化为政策层面的工作。 无论是制造业、法律服务,还是 Workspace 智能体,最先引发的都不是关于模型智能水平的疑问,而是认证、审计和合规问题。(OSHBuilt,NewsFromGoogle,kylehtucker)
- 记忆和部署状态正成为产品体验的一部分。 反复出现的构建信号包括知识图谱、清单、快照和可复用规则——这些都是能够超越单次聊天会话、持续存在的基础设施。(kg-memory,Hermes Agent Operator)